최근 많은 개발자가 한 가지 “직관과 다른” 경험을 이야기해요. claude-opus-5-5가 전혀 느리지 않고, 많은 작업에서는 claude-sonnet-5-5보다 더 먼저 완료된다는 거예요. 플래그십 모델이 더 빠르고 더 강력하다면, Sonnet의 장점은 “절반 가격”뿐일까요? 답은 그렇게 단순하지 않아요. 이 글에서는 6개 공개 데이터를 바탕으로 claude-sonnet-5-5와 claude-opus-5-5의 실제 차이를 분석하고, 특히 더 현실적인 질문에 답해 볼게요. 엔터프라이즈급 장문 입력·장문 출력 Agent 환경에서 두 모델을 어떻게 역할 분담하고 조합해야 할까요?
핵심 가치: 이 글을 읽고 나면 Opus가 “빠르게” 느껴지는 진짜 이유, Sonnet이 가격 외에 가진 확실한 강점, 그리고 바로 도입할 수 있는 Opus + Sonnet 듀얼 모델 Agent 아키텍처를 알 수 있어요.
claude-sonnet-5-5와 claude-opus-5-5 핵심 사양 한눈에 보기
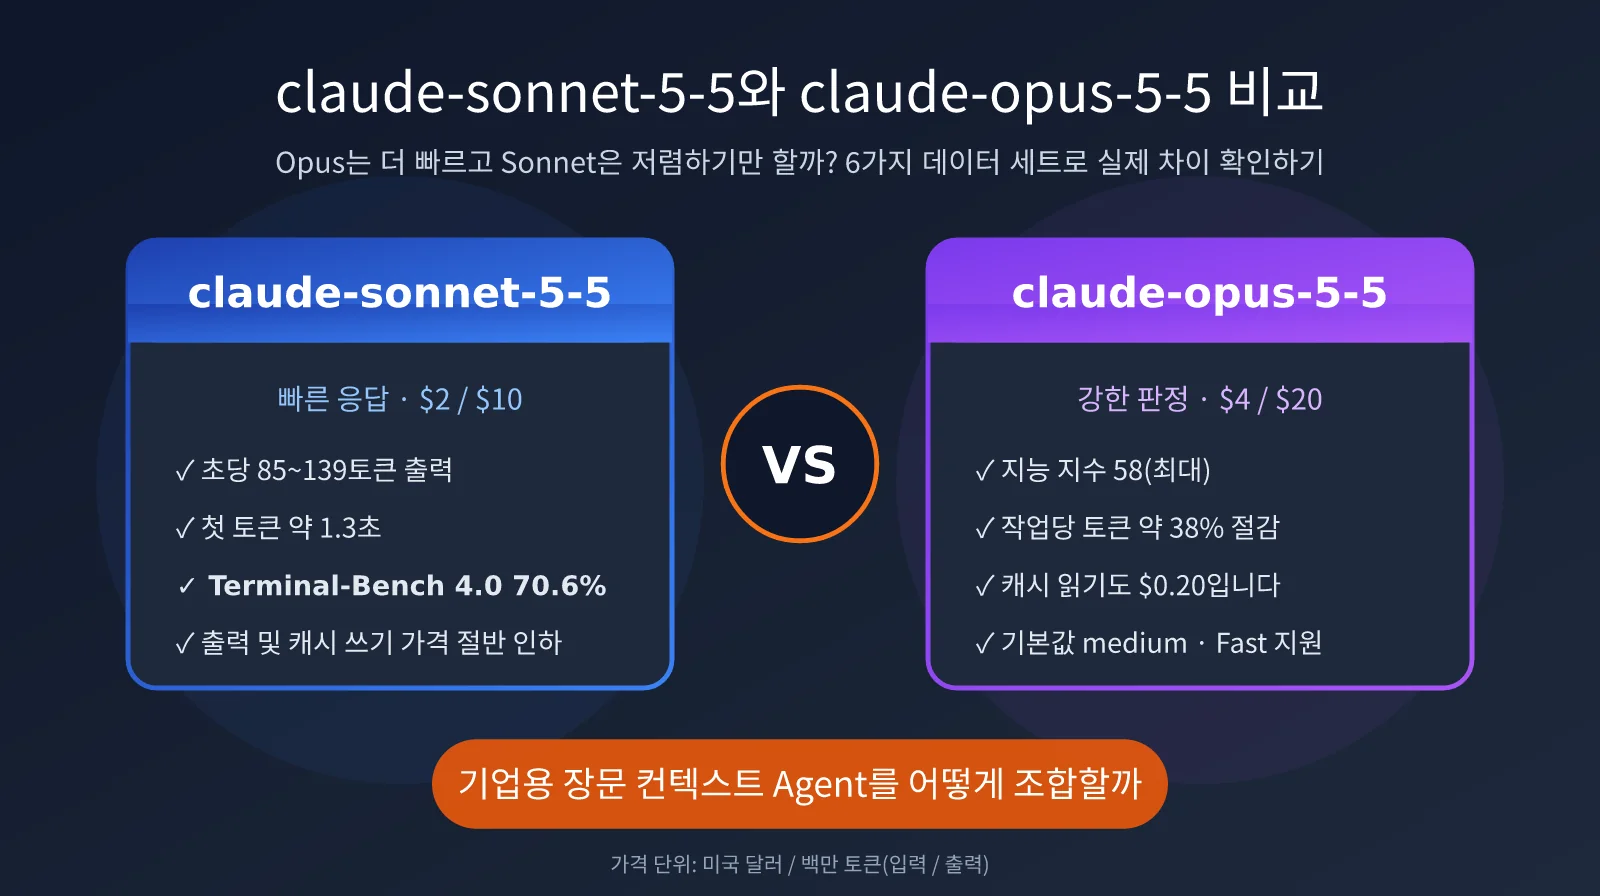
claude-opus-5-5는 2026년 9월 22일, claude-sonnet-5-5는 9월 28일에 출시됐으며, 둘 다 Claude 5.5 제품군에 속해요. 이번 세대에서 가장 주목할 변화는 Opus의 가격 인하예요. 정가는 Opus 5의 $5/$25에서 20% 낮아진 $4/$20이 되었고, 캐시 읽기 가격은 $0.50에서 $0.20으로 떨어져 Sonnet과 완전히 같아졌어요. Sonnet 5.5는 $2/$10 가격을 유지하며, 공식 발표에 따르면 단일 작업 비용은 이전 세대 대비 최대 약 30% 낮아졌어요.
| 항목 | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| 출시일 | 2026-09-28 | 2026-09-22 |
| 입력 / 출력 가격 | $2 / $10 | $4 / $20 |
| 캐시 읽기 | $0.20 | $0.20(기본 입력 가격의 5%) |
| 5분 캐시 쓰기 | $2.50 | $5 |
| Batch 가격 | $1 / $5 | $2 / $10 |
| 컨텍스트 윈도우 | 100만 Token, 장문 컨텍스트 추가 요금 없음 | 100만 Token, 장문 컨텍스트 추가 요금 없음 |
| 최대 출력 | 128K(Batch 베타 300K) | 128K(Batch 베타 300K) |
| API 기본 추론 수준 | high | medium |
| Fast 모드 | 지원하지 않음 | 지원, 약 2.5배 출력 속도, $8 / $40 |
| 이용 플랫폼 | APIYI apiyi.com, Anthropic 공식 API | APIYI apiyi.com, Anthropic 공식 API |
표에는 실제 사용 경험에 직접 영향을 주는 두 가지 세부 사항이 숨어 있어요. 첫째, 두 모델의 기본 추론 수준이 다릅니다. Opus의 기본값은 medium이고 Sonnet API의 기본값은 high예요. 많은 사용자가 Opus가 더 빠르다고 느끼는 가장 큰 이유죠. 둘째, 캐시 읽기 가격이 동일합니다. 즉, 긴 컨텍스트를 대량으로 재사용하는 Agent 환경에서는 두 모델의 입력 비용 차이가 크게 줄어들어요.
🎯 테스트 권장 사항: 두 모델을 비교할 때는 반드시 동일한 추론 수준을 명시적으로 지정해야 해요. 그렇지 않으면 결론이 크게 왜곡될 수 있습니다. APIYI apiyi.com에서 동일한 Key로 claude-sonnet-5-5와 claude-opus-5-5를 각각 호출하고,
model과reasoning_effort두 파라미터만 바꿔 비교 테스트를 진행하는 방법을 권장해요.
claude-opus-5-5가 claude-sonnet-5-5보다 더 빠르게 느껴지는 이유
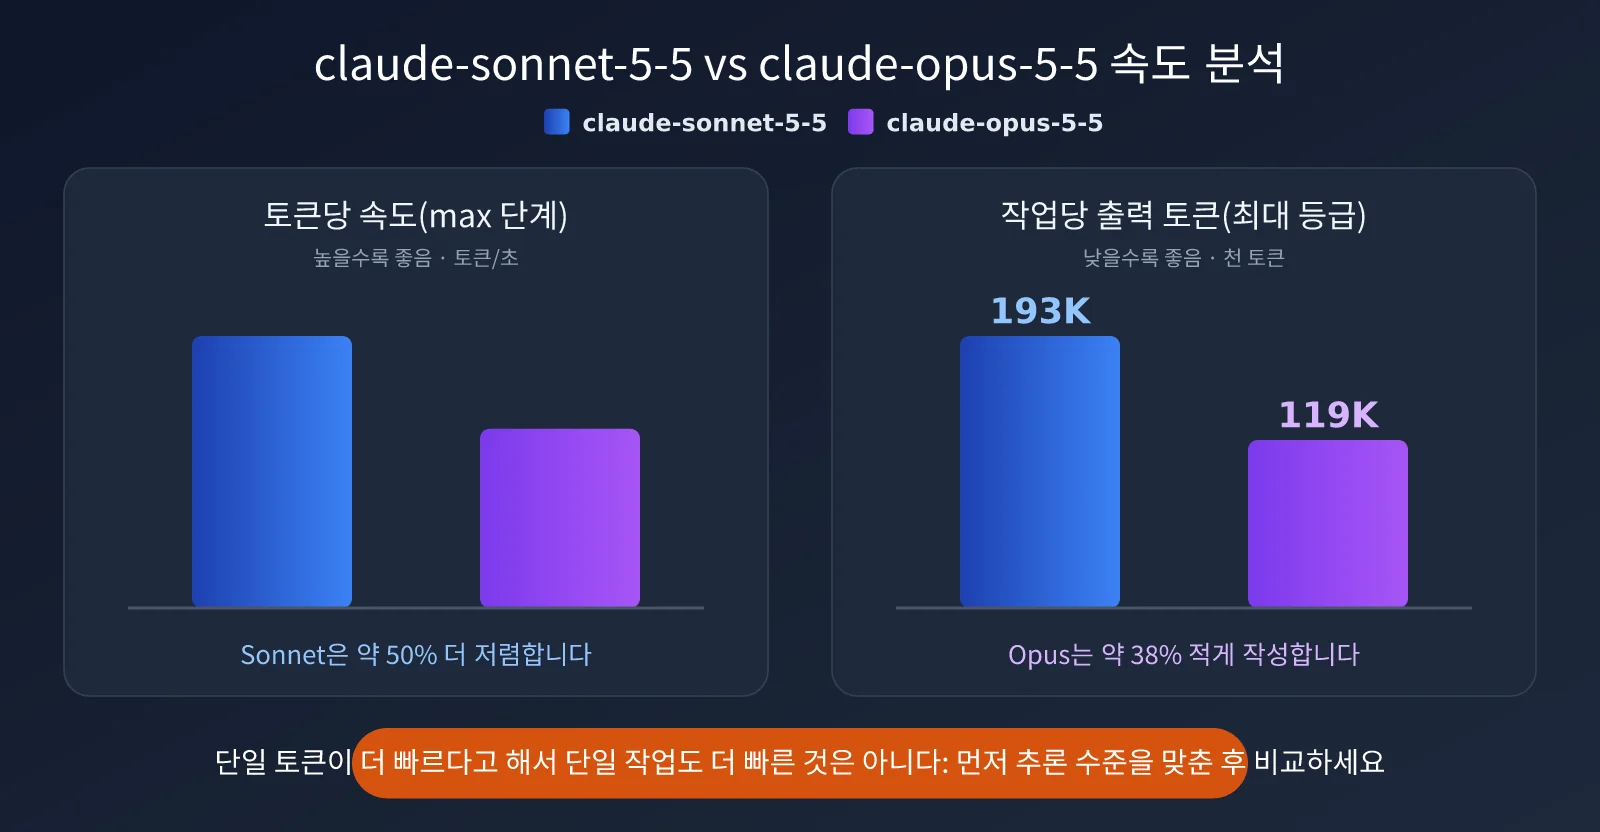
순수 생성 속도만 보면 claude-sonnet-5-5가 사실 훨씬 빠릅니다. Artificial Analysis 측정에 따르면 Sonnet 5.5의 출력 속도는 추론 등급에 따라 초당 85~139토큰이고, Opus 5.5는 초당 74~93토큰입니다. Anthropic 공식 모델 페이지에서도 Sonnet의 지연 시간 등급은 ‘빠름’, Opus는 ‘보통’으로 표시합니다. 그렇다면 왜 Opus가 더 빠르다고 체감될까요? 주된 이유는 세 가지입니다.
이유 1: 기본 등급이 다릅니다. Sonnet은 기본적으로 한 단계 더 깊게 생각합니다
Opus 5.5는 API 기본 등급을 이전 세대의 high에서 medium으로 낮췄습니다. Anthropic은 Opus 5.5의 medium 등급이 이미 Opus 5의 high 등급 수준에 도달하거나 이를 넘어선다고 설명합니다. 반면 Sonnet 5.5 API의 기본값은 여전히 high이며, 사고 모드는 끌 수 없습니다. 독립 테스트에 따르면 Sonnet은 high 등급에서 medium 대비 약 두 배의 출력 토큰을 생성하지만, 품질 향상은 뚜렷하지 않았습니다. 기본 파라미터로 바로 모델 호출을 하면 Sonnet이 실질적으로 ‘한 단계 더 생각하는’ 셈이라 시간이 더 오래 걸립니다.
이유 2: Opus의 토큰 효율이 더 높습니다
Artificial Analysis 지능 지수 테스트에서 Sonnet 5.5는 max 등급 기준 작업 하나당 평균 약 19만 3,000토큰을 출력했습니다. 이는 해당 기관이 측정한 최고 수준입니다. 반면 같은 등급의 Opus 5.5는 약 11만 9,000토큰을 출력했습니다. 토큰 하나를 더 빨리 생성한다고 해서 작업 하나를 더 빨리 끝내는 것은 아닙니다. Sonnet이 초당 약 50% 더 많은 토큰을 출력하더라도, 작성해야 할 내용이 60% 더 많다면 엔드투엔드 시간은 Opus와 비슷해지거나 오히려 더 길어질 수 있습니다.
이유 3: Opus만 Fast 모드를 사용할 수 있습니다
Opus 5.5는 Fast 모드(리서치 프리뷰)를 지원합니다. 같은 모델이라도 더 빠른 추론 구성으로 전환하면 출력 속도가 최대 약 2.5배 향상되며, 가격은 입력/출력 기준 $8/$40입니다. 코딩 도구에서 Opus에 Fast 모드를 켜 두었다면 ‘Opus가 빠르다’는 인상은 더 강해질 수 있습니다. 다만 Fast 모드는 초당 출력 토큰 수만 높일 뿐 첫 토큰 지연 시간은 개선하지 않습니다. 또한 표준 속도 모드와 프롬프트 캐시를 공유하지 않습니다.
| 속도 지표 | claude-sonnet-5-5 | claude-opus-5-5 | 설명 |
|---|---|---|---|
| 출력 속도(토큰/초) | 85~139 | 74~93 | Sonnet이 토큰 하나당 더 빠름 |
| 작업당 출력 토큰(max 등급) | 약 19만 3,000 | 약 11만 9,000 | Opus가 토큰을 더 적게 사용 |
| 첫 토큰 지연 시간(낮은 등급) | 약 1.3초(medium) | 약 14.3초(low) | Sonnet이 더 빠르게 응답 시작 |
| 공식 지연 시간 등급 | 빠름 | 보통 | Anthropic 모델 페이지 기준 |
| 실제 코딩 작업 소요 시간(서드파티) | 29분 27초 | 44분 50초 | Sonnet이 약 1.5배 빠름 |
결론적으로, 기본 파라미터에서는 Opus가 더 빨리 끝나는 경우가 있을 수 있지만, 두 모델을 적절한 등급에 맞춰 비교하면 응답 속도는 여전히 Sonnet이 뚜렷하게 앞섭니다. 특히 첫 토큰 지연 시간은 Sonnet이 medium 등급에서 약 1.3초 만에 출력을 시작합니다. 사용자 대상의 인터랙티브 에이전트에서는 매우 중요한 차이입니다.
claude-sonnet-5-5는 가격만 유리할까요? 성능 비교 데이터
먼저 예상 밖의 데이터를 하나 짚고 넘어가겠습니다. max 등급에서는 Sonnet이 Opus보다 꼭 저렴하지 않습니다. Artificial Analysis가 전체 지능 지수 테스트를 실행한 결과, Sonnet 5.5(max)는 약 $8,977이 들었고 Opus 5.5(max)는 약 $8,708이 들었습니다. Opus가 오히려 조금 더 저렴하면서 점수도 더 높았습니다(58 대 56). 앞서 언급한 토큰 효율이 바로 그 이유입니다. 따라서 Sonnet을 max 등급으로만 사용한다면 가격 우위조차 없을 수 있습니다.
그렇다면 Sonnet의 가치는 어디에 있을까요? 아래 표는 추론 등급별 두 모델의 지능 지수 점수입니다. Sonnet을 어떻게 활용해야 하는지 알 수 있습니다.
| 추론 등급 | claude-sonnet-5-5 지능 지수 | claude-opus-5-5 지능 지수 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
종합 지능에서는 같은 등급의 Opus가 전반적으로 앞섭니다. 특히 사실 정확도(AA-Omniscience, 66% 대 54%), 법률, 금융, 전략 같은 전문 영역 지수에서 Opus의 강점이 더 뚜렷합니다. 하지만 Sonnet에는 Opus가 대체하기 어려운 확실한 장점도 있습니다.
- 터미널 기반 에이전트 코딩: Terminal-Bench 4.0에서 Sonnet(max)은 70.6%로 Opus(xhigh)의 66.4%보다 높았습니다. 다만 같은 xhigh 등급에서는 Opus가 66.4% 대 61.5%로 앞섭니다. Sonnet은 최고 등급까지 올려야 역전할 수 있습니다.
- 응답 지연 시간: 첫 토큰 지연 시간과 초당 출력 속도가 모두 더 좋습니다. 실시간 상호작용이나 스트리밍 출력이 필요한 프런트엔드 시나리오에 적합합니다.
- 캐시 미적중 입력과 캐시 쓰기: 단가가 모두 Opus의 절반 수준입니다. 매번 새 문서를 처리하는 일회성 장문 입력 작업에 더 유리합니다.
- 긴 출력과 배치 처리: 출력 단가는 $10 대 $20이고, Batch는 $5 대 $10입니다. 긴 보고서나 장문 문서를 대규모로 생성할 때 비용 우위가 두 배로 벌어집니다.
- 고동시성 실행: Anthropic의 공식 포지셔닝에서 Sonnet은 Opus보다 빠르고 비용이 낮은 파트너입니다. 명확한 하위 작업을 많은 서브 에이전트가 병렬 실행하는 구조에 적합합니다.
다른 공개 벤치마크에서도 Opus는 CursorBench 4.0(57.8% 대 55.5%), FrontierCode 1.1(54.4% 대 52.1%), OSWorld 2.1(81.8% 대 80.1%)에서 약 2포인트씩 앞섰습니다. 서드파티가 집계한 장문 컨텍스트 프로그램 재구성 테스트 ProgramBench에서는 Opus가 91.2%, Sonnet이 79.7%로 격차가 더 크게 벌어졌습니다. 이는 매우 긴 컨텍스트에서 정밀한 판단을 내려야 할수록 Opus의 우위가 커진다는 점을 보여줍니다.
💡 모델 선택 팁: Sonnet은 medium~xhigh 등급에서 ‘실행자’로 활용하는 것이 적합합니다. 반면 Opus는 medium 등급부터 시작하는 ‘의사결정자’ 역할에 잘 맞습니다. 실제 업무에서의 차이를 검증하고 싶다면 APIYI apiyi.com에서 동일한 장문 문서 작업을 각각 한 번씩 실행한 뒤, 결과 품질과 실제 비용을 비교해 보세요.
기업 장문 컨텍스트 Agent 시나리오의 실제 비용
기업 Agent의 일반적인 워크로드는 이렇습니다. 입력에는 수십만 Token에 이르는 계약서, 코드베이스, 지식 베이스가 들어가고, 출력으로는 긴 보고서, 대량 수정 문서 또는 여러 파일의 코드가 생성돼요. 두 모델 모두 100만 컨텍스트를 지원하며 장문 컨텍스트 할증이 없기 때문에, 실제 비용을 좌우하는 요소는 캐시 적중률과 출력 길이입니다. 아래에서는 공식 가격을 기준으로 몇 가지 대표 시나리오를 추산했습니다(Sonnet은 max 등급에서 두 모델 간 Token 효율 차이를 반영해 Opus보다 출력 Token이 1.6배 많다고 가정).
| 시나리오 | 워크로드 구성 | claude-sonnet-5-5 | claude-opus-5-5 | 비용 비율 |
|---|---|---|---|---|
| 장문 컨텍스트 다회 후속 질의 | 50만 컨텍스트, 캐시 95% 적중, 신규 쓰기 2.5만 | 약 $0.28(출력 1.2만) | 약 $0.37(출력 0.75만) | 1 : 1.3 |
| 장문서 최초 로드 | 50만 Token을 5분 캐시에 기록 + 출력 1만 | 약 $1.35 | 약 $2.70 | 1 : 2 |
| 장문 보고서 생성 | 입력 5만 + 출력 5만(동일한 출력량) | 약 $0.60 | 약 $1.20 | 1 : 2 |
| 오프라인 대량 생성 | Batch 모드, 입력·출력 각각 10만 | 약 $0.60 | 약 $1.20 | 1 : 2 |
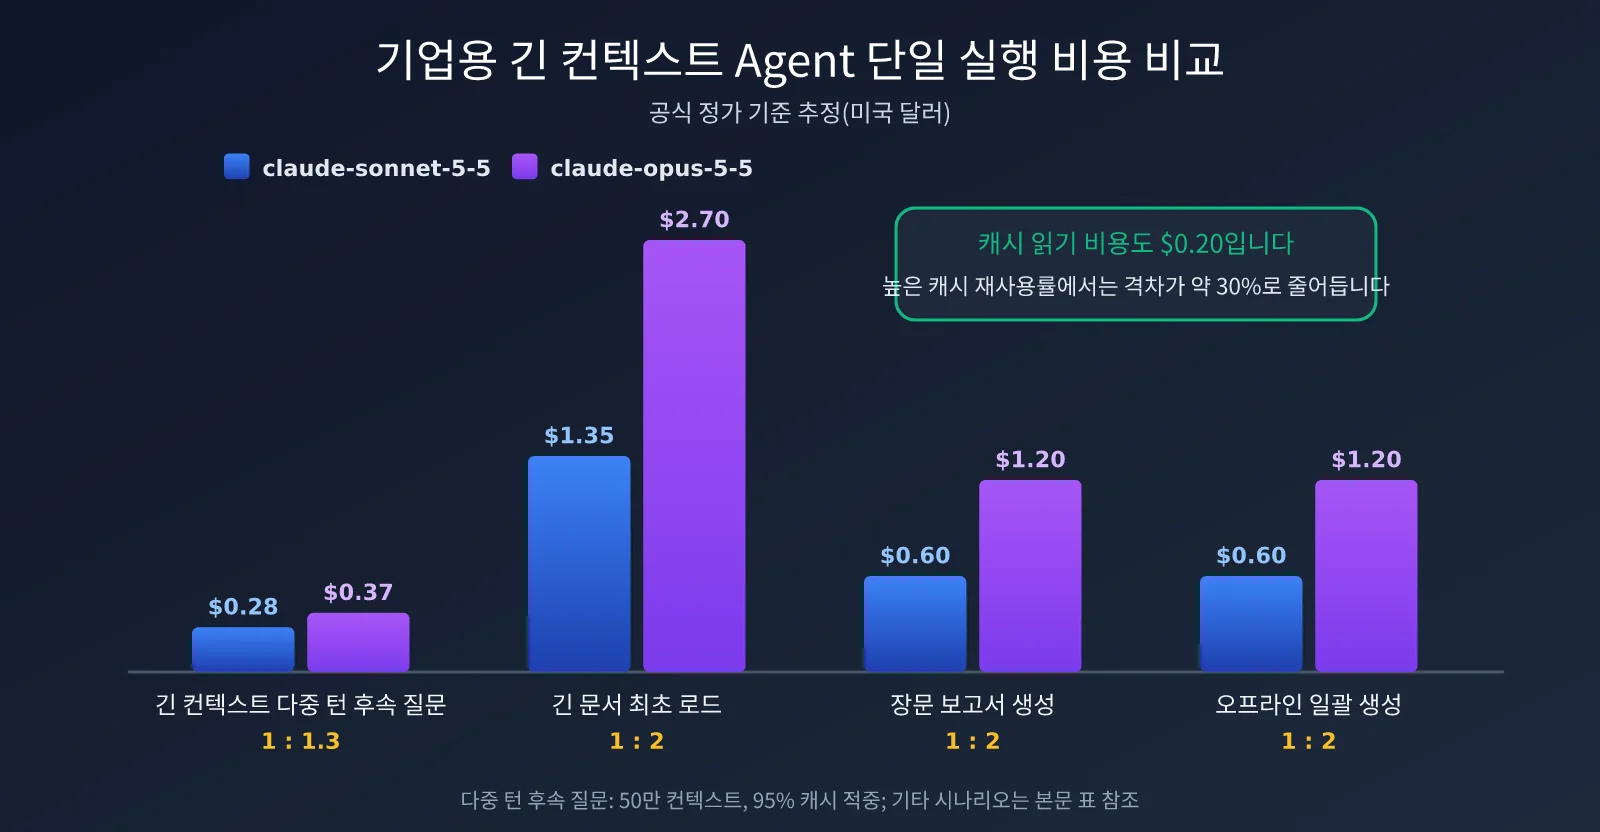
이 표는 매우 중요한 규칙을 보여줍니다. ‘긴 입력 + 높은 캐시 적중률 + 짧은 출력’의 다회 후속 질의에서는 Opus가 Sonnet보다 약 30%만 비쌉니다. 가장 큰 비중을 차지하는 캐시 읽기 비용은 두 모델이 같고, Opus는 출력 Token도 더 적게 사용하기 때문이에요. 반면 새 문서를 처음 로드하는 경우와 긴 출력 생성 시나리오에서는 Sonnet의 비용 우위가 다시 정확히 2배 수준으로 돌아옵니다. 즉, Opus는 같은 긴 자료를 반복해서 읽고 판단하는 작업에 적합하고, Sonnet은 새 자료를 한 번에 처리하거나 긴 콘텐츠를 생성하는 작업에 적합합니다.
또 하나 주의할 점은 프롬프트 캐시를 모델 간에 공유할 수 없다는 것입니다. 동일한 50만 Token 문서를 Opus가 한 번 읽고 Sonnet이 다시 읽으면, 각각 캐시 쓰기 비용을 지불해야 해요. 따라서 듀얼 모델 아키텍처의 핵심은 긴 컨텍스트를 가능한 한 하나의 모델에만 ‘상주’시키고, 다른 모델에는 정제된 작업 요약만 전달하는 것입니다.
claude-sonnet-5-5와 claude-opus-5-5를 조합하는 방법
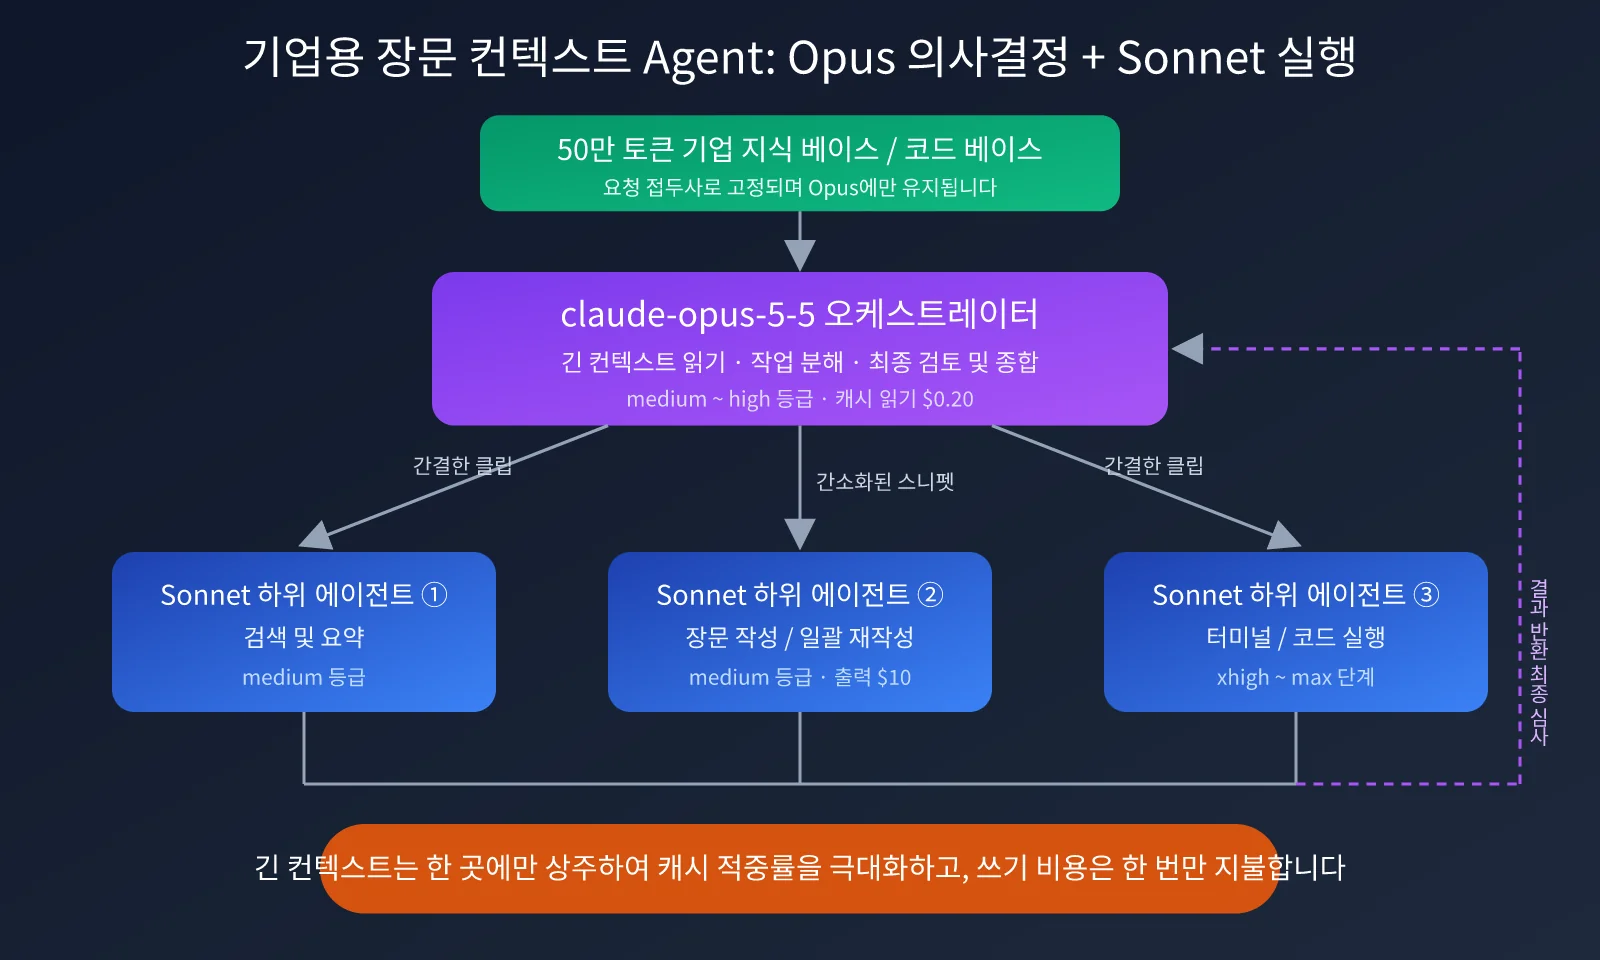
앞선 데이터를 바탕으로 기업 장문 콘텐츠 Agent에는 ‘Opus 의사결정, Sonnet 실행’ 계층형 아키텍처를 권장합니다. 그리고 누가 긴 컨텍스트를 보유하는지에 따라 두 가지 모드로 나눌 수 있어요.
모드 1: Opus 오케스트레이션 + Sonnet 병렬 서브 Agent
계약서 검토, 여러 저장소에 걸친 코드 마이그레이션, 실사처럼 긴 자료를 기반으로 복잡한 판단이 필요한 시나리오에 적합합니다. Opus가 전체 장문 컨텍스트를 보유하고(장기간 캐시 적중), 전체 내용을 이해한 뒤 작업을 분해해 여러 Sonnet 서브 Agent에 배분합니다. 각 Sonnet은 자신에게 필요한 일부 자료와 명확한 지시만 받아 medium 등급에서 빠르게 병렬 실행하고, 마지막에는 Opus가 결과를 통합하고 최종 검토합니다. 이 방식에서는 비용이 높은 장문 컨텍스트 캐시를 한 번만 지불하고, Sonnet이 긴 텍스트를 생성하면서 절반 수준의 출력 단가 혜택을 누릴 수 있습니다.
모드 2: Sonnet 프런트엔드 + Opus 에스컬레이션 백업
기업 지식 베이스 질의응답, 고객 서비스 Agent, 사내 IT 도우미처럼 상호작용이 많고 트래픽이 큰 시나리오에 적합합니다. Sonnet이 긴 컨텍스트를 보유하고 medium 등급에서 약 1초 수준의 첫 Token 응답을 제공합니다. 확신도가 낮거나 컴플라이언스 판단이 필요하거나, 사용자가 명확히 불만을 표시한 요청이 발생하면 정제된 문제와 핵심 조각을 Opus로 에스컬레이션합니다. 대부분의 트래픽은 Sonnet이 저비용으로 처리하고, 소수의 어려운 요청에만 Opus를 사용합니다.
| Agent 역할 | 권장 모델 | 권장 등급 | 이유 |
|---|---|---|---|
| 오케스트레이터 / 플래너 | claude-opus-5-5 | medium ~ high | 종합 지능과 사실 정확도가 더 높고 Token 효율이 좋음 |
| 장문 컨텍스트 분석 및 최종 검토 | claude-opus-5-5 | high ~ xhigh | 긴 컨텍스트에서 정밀 판단의 강점이 뚜렷함 |
| 장문 작성 / 대량 수정 | claude-sonnet-5-5 | medium | 출력 단가가 절반이고 초당 출력 속도가 더 빠름 |
| 터미널 / 코드 실행 서브 Agent | claude-sonnet-5-5 | xhigh ~ max | Terminal-Bench 최고 등급 성적이 가장 우수함 |
| 실시간 대화 프런트엔드 | claude-sonnet-5-5 | medium | 첫 Token 지연 시간이 약 1.3초 |
| 오프라인 일괄 처리 | claude-sonnet-5-5 | medium | Batch $1/$5, 300K 장문 출력 지원 |
동일한 인터페이스로 Opus 오케스트레이션 + Sonnet 실행 구현하기
아래는 모드 1의 간단한 예시입니다. OpenAI 호환 인터페이스를 통해 호출하며, 두 모델은 하나의 Key를 공유합니다.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "다음 계약서 전문을 읽고 독립적인 검토 하위 작업 3개로 나누세요. 한 줄에 하나씩 작성하세요:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"하위 작업을 완료하고 검토 의견을 출력하세요:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "다음 의견을 종합하고 최종 검토하여 최종 보고서를 출력하세요:\n" + "\n".join(drafts), effort="high")
펼쳐 보기: 병렬 서브 Agent + 고정 장문 컨텍스트 접두사의 전체 예시
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. 장문서를 system 접두사에 고정하고 Opus에만 상주시켜 다회 캐시 적중을 쉽게 만듭니다
    base = [{"role": "system", "content": "당신은 기업 문서 분석 오케스트레이터입니다. 다음은 전체 자료입니다:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"목표:{goal}\n최대 5개의 하위 작업으로 나누고, 각 작업에 필요한 원문 조각을 첨부하세요. ---로 구분하세요."}])

    # 2. Sonnet 서브 Agent에는 정제된 조각만 전달하고 병렬 실행합니다
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"다음 하위 작업을 독립적으로 완료하고 구조화된 결론을 출력하세요:\n{t}"}])
        for t in tasks])

    # 3. Opus로 돌아가 최종 검토하고 동일한 장문 컨텍스트 접두사를 재사용합니다
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"다음 하위 작업 결론이 원문과 일치하는지 확인하고, 오류를 수정한 후 최종 보고서를 출력하세요:\n{merged}"}],
        effort="high")
    print("최종 검토 Token 사용량:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "계약서의 지급, 위약 및 지식재산권 리스크 식별"))
🚀 빠른 시작: Claude 공식 계정은 등록 지역과 결제 수단 조건이 까다로워 기업 팀이 개통 단계에서 막히는 경우가 많습니다. 먼저 APIYI apiyi.com에서 가입해 테스트 크레딧을 받고, 하나의 Key로 claude-opus-5-5와 claude-sonnet-5-5를 동시에 호출해 보세요. 위의 듀얼 모델 아키텍처를 먼저 실행한 뒤, 규모화 비용을 평가하면 됩니다.
claude-sonnet-5-5 vs claude-opus-5-5 선택 가이드
앞선 분석을 실행 가능한 4가지 원칙으로 정리하면 다음과 같아요.
- 먼저 등급을 정한 뒤 모델을 비교하세요: Sonnet은 medium~xhigh, Opus는 medium~high를 사용하세요. Sonnet의 기본 high 설정으로 인한 Token 낭비를 피할 수 있어요.
- 캐시 재사용률이 높은 장문 컨텍스트는 Opus에 맡기세요: 캐시 읽기 비용은 같고 Opus는 약 30%만 더 비싸지만, 더 높은 정확도와 적은 재작업을 기대할 수 있어요.
- 새 자료 로딩과 긴 출력은 Sonnet에 맡기세요: 캐시 쓰기와 출력 단가는 모두 Opus의 절반이며, 오프라인 작업은 Batch 50% 할인까지 적용할 수 있어요.
- 장문 컨텍스트는 한 곳에만 유지하세요: 캐시는 모델 간에 공유되지 않으므로, 하위 Agent에는 정제된 일부만 전달해 캐시 쓰기 비용이 중복되지 않도록 하세요.
Opus의 Fast 모드는 단일 응답 속도에 극도로 민감하고 예산이 충분한 환경에 적합해요. 다만 가격이 두 배이고 캐시도 공유되지 않아요. 대부분의 기업용 Agent에서는 실시간 상호작용을 Sonnet medium 등급에 맡기는 편이 Opus에서 Fast 모드를 활성화하는 것보다 비용 효율적이에요.
자주 묻는 질문
Q1: claude-opus-5-5도 이미 빠른데, claude-sonnet-5-5를 사용할 필요가 있나요?
네, 있어요. Opus가 “빠르게” 느껴지는 이유는 주로 기본 등급이 더 낮고 Token 효율이 높기 때문이에요. 반면 Sonnet은 초당 출력 속도와 첫 Token 지연 시간에서 여전히 뚜렷하게 앞서며, 출력 단가도 절반 수준이에요. 긴 글 작성, 실시간 대화, 병렬 하위 Agent 같은 시나리오에서는 Sonnet이 여전히 더 적합한 실행 모델이에요.
Q2: claude-sonnet-5-5를 max 등급으로 설정하면 Opus를 대체할 수 있나요?
터미널 프로그래밍처럼 특정 작업에서는 가능해요. Sonnet(max)은 Terminal-Bench 4.0에서 Opus보다 높은 점수를 기록하기도 했어요. 하지만 종합 지능 지수는 여전히 2점 낮고, max 등급에서는 Sonnet의 Token 소비량도 더 많아져 전체 비용이 Opus와 비슷하거나 오히려 조금 높아질 수 있어요. 최고 수준의 품질이 필요하다면 Opus를 직접 사용하는 편이 보통 더 경제적이에요.
Q3: 기업용 장문 문서 Agent에서 두 모델의 비용을 어떻게 관리하나요?
핵심은 캐시 적중률을 높이는 것이에요. 장문 문서를 요청 프리픽스에 고정하고, 하나의 모델만 전체 컨텍스트를 보유하게 하세요. 하위 Agent에는 정제된 일부만 전달하면 돼요. APIYI apiyi.com을 통해 호출하면서 반환되는 캐시 Token 사용량을 관찰하고, 프리픽스 구조를 단계적으로 조정해 보세요. 일반적으로 캐시 적중률은 비용 절감에 가장 효과적인 레버예요.
Q4: Sonnet 5 또는 Opus 5에서 5.5로 마이그레이션할 때 주의할 점은 무엇인가요?
두 5.5 모델 모두 API 호환성을 깨는 변경 사항이 있어요. 사고 모드는 비활성화할 수 없고, 강제 도구 호출(tool_choice가 any 또는 tool인 경우)은 400 오류를 반환해요. 기존 컴퓨터 조작 도구도 업그레이드해야 해요. 마이그레이션 전에는 테스트 환경에서 회귀 테스트를 먼저 통과시키고, 신구 모델의 출력 차이를 병렬로 비교한 뒤 운영 트래픽을 전환하는 것을 권장해요.
요약
claude-sonnet-5-5와 claude-opus-5-5의 비교는 단순히 “비싼 모델이 더 좋고, 저렴한 모델이 더 나쁘다”는 문제로 볼 수 없어요. 가격 인하 이후 Opus 5.5의 캐시 읽기 비용은 Sonnet과 같아졌고, 기본 medium 등급도 충분히 효율적입니다. 긴 컨텍스트에서의 정확한 판단과 종합 지능은 Opus가 전반적으로 앞서요. 반면 Sonnet 5.5는 응답 속도, 출력 비용, 터미널 코딩, 높은 동시성 실행에서 대체하기 어려운 장점을 지니고 있습니다. 즉, Sonnet의 강점은 단지 가격에만 있는 것이 아니라 적절한 등급과 역할에 배치할 때 드러납니다.
기업의 긴 콘텐츠 입출력 Agent에는 “Opus는 의사결정, Sonnet은 실행” 조합이 가장 합리적이에요. Opus가 긴 컨텍스트를 유지하며 계획 수립과 최종 검토를 담당하고, Sonnet은 medium 등급에서 작성과 실행 작업을 병렬로 처리하며, 오프라인 작업은 Batch에 맡기는 방식입니다. 실무에서는 먼저 등급을 고정해 비교 테스트를 진행한 뒤, 이 글의 역할 표에 따라 Agent를 분리하세요. 이후 캐시 적중률과 출력 Token이라는 두 가지 지표를 중심으로 비용을 지속적으로 최적화하면 됩니다.
이 듀얼 모델 구성을 빠르게 검증하고 싶다면 APIYI apiyi.com을 통해 claude-opus-5-5와 claude-sonnet-5-5를 통합 호출하는 방법을 추천해요. 플랫폼 인터페이스는 OpenAI 형식과 호환되며, 하나의 Key만으로 두 모델을 자유롭게 전환할 수 있습니다. 모델 선정 테스트와 프로덕션 환경의 멀티 모델 오케스트레이션에 적합합니다.
참고 자료:
– Anthropic 가격 문서: platform.claude.com/docs/en/about-claude/pricing
– Anthropic Fast 모드 문서: platform.claude.com/docs/en/build-with-claude/fast-mode
– Artificial Analysis Sonnet 5.5 및 Opus 5.5 비교: artificialanalysis.ai
– Digital Applied Opus 5.5 출시 분석: digitalapplied.com
– Kingy AI 및 Emergent의 Sonnet 5.5 vs Opus 5.5 비교: kingy.ai, emergent.sh
작성자 소개: APIYI 기술팀은 AI 대규모 언어 모델 API 연동과 엔지니어링 실무에 집중하고 있습니다. APIYI apiyi.com을 통해 claude-opus-5-5와 claude-sonnet-5-5의 Agent 오케스트레이션 및 비용 최적화 경험을 함께 나눠 보세요.