요약: VibeVideoBench의 코드 기반 비디오 과제에서 GPT-6 Astra는 Claude Opus 5.5와 이미 같은 수준에 올랐습니다. 종합 품질은 살짝 높으면서 비용은 더 낮죠. Opus 5.5는 결과물 전달이 더 안정적이고, OpenAI의 차세대 범용 모델은 아직 출시되지 않아 비디오 성능은 출시 후 실측으로 확인해야 합니다.
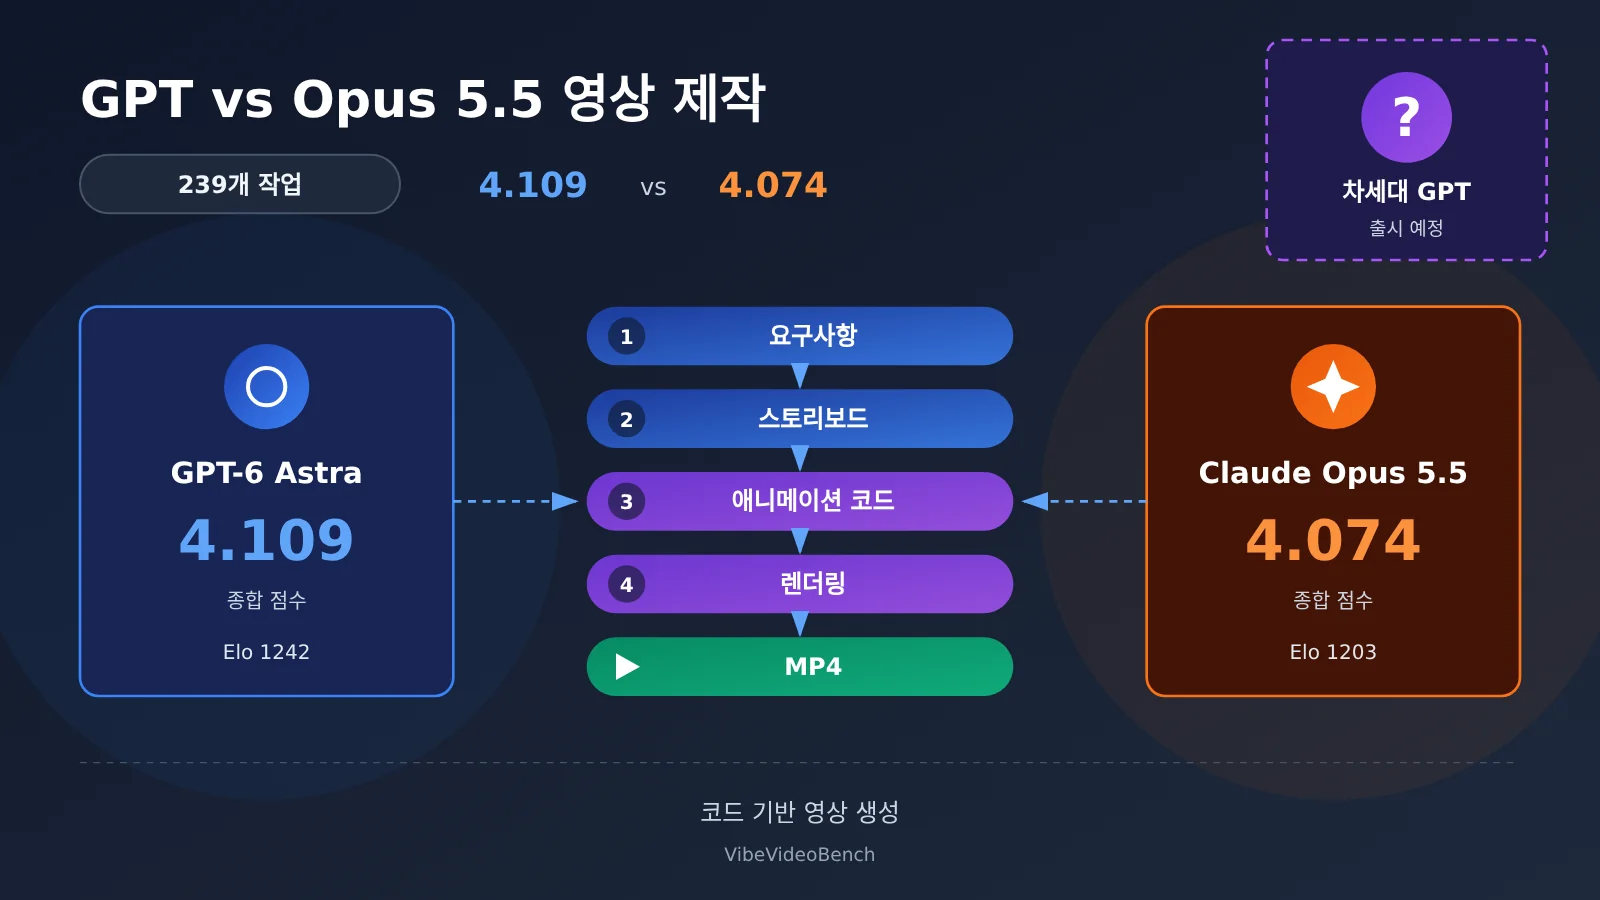
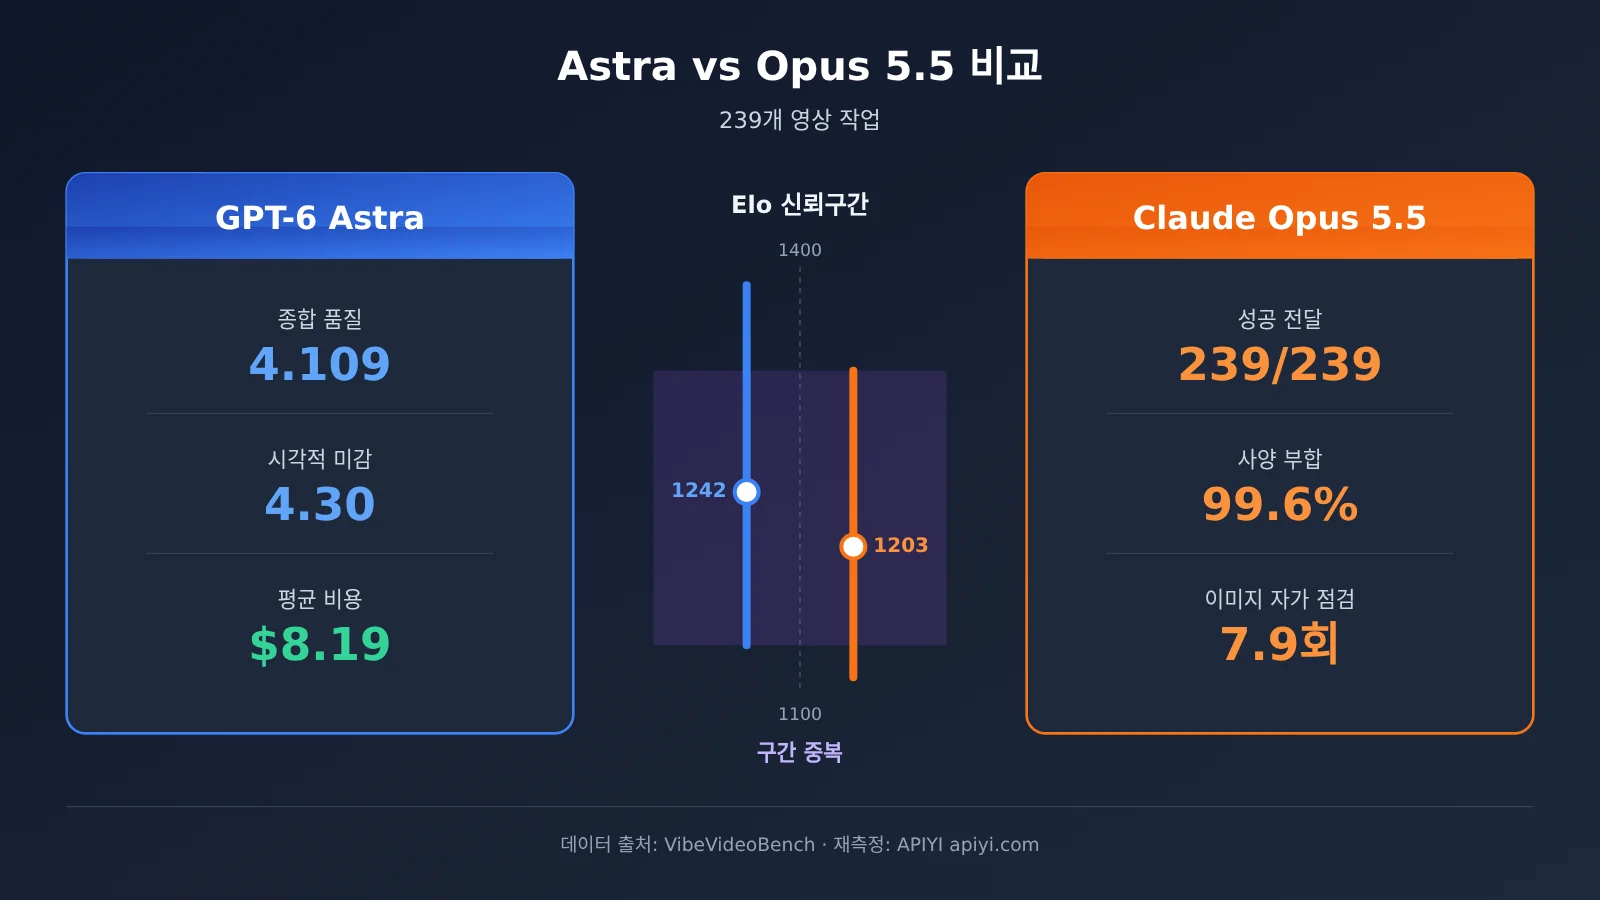
결론부터 말하면: 2026년 11월 15일 기준, “Agent가 코드를 작성하고 → 렌더링 도구를 호출하고 → 완성된 MP4를 전달한다”는 이 경로에서 GPT-6 Astra와 Claude Opus 5.5는 VibeVideoBench에서 가장 근접한 두 시스템입니다. Astra의 종합 품질 점수는 4.109, Opus 5.5는 4.074였고, 인간 블라인드 테스트 Elo는 각각 1242와 1203으로 통계적으로 구분되지 않습니다. Opus 5.5는 전체 239개 과제를 모두 전달했으며 엄격 기준 과제 성공률은 76.3%로 Astra의 74.5%보다 높았습니다. Astra는 과제당 평균 API 비용이 8.19달러로 Opus 5.5의 약 절반 수준이었죠. OpenAI는 내부 모델 두 개가 Astra보다 확실히 강하다는 증거를 공개했지만, 차세대 범용 GPT의 이름도, 출시 시점도, 비디오 특화 성적도 아직 공개하지 않았습니다. 그래서 제목의 질문에 대한 답은 이렇습니다. 현행 GPT는 이미 따라잡았고, 차세대가 격차를 벌릴 수 있을지는 출시 후 실측에 달려 있습니다.
내용 미리보기: 아래에서는 먼저 평가 범위를 정의한 뒤, VibeVideoBench의 전체 성적과 분류별 성적, 인간 선호도, 비용 데이터를 하나씩 뜯어보며 두 시스템의 강점이 각각 어디서 오는지 설명합니다. 이어서 OpenAI 내부 모델의 공개 신호와 차세대 모델의 출시 상태를 정리하고, 비디오 Agent의 진짜 병목이 무엇인지 분석합니다. 마지막으로 새 모델이 출시된 뒤 바로 재사용할 수 있는 비교 테스트 방법을 제시해, 기존 방식을 교체할 만한지 판단하는 데 도움을 드립니다.
To Know:본문을 읽기 전에 알아야 할 용어
| 용어 | 설명 |
|---|---|
| Code-driven Video Generation | 코드 기반 비디오 생성: AI가 애니메이션과 렌더링 프로그램을 작성하고 최종적으로 MP4를 출력 |
| Native Video Generation | 네이티브 비디오 생성: 모델이 텍스트와 이미지를 바탕으로 비디오 화면을 직접 생성하며, 대표 제품으로 Sora, Veo가 있음 |
| VibeVideoBench | AI Agent가 완전한 비디오를 자율 제작하는 능력을 전문적으로 평가하는 벤치마크, 2026년 10월 26일 공개 |
| Harness | 모델 실행 환경으로, 코드 실행, 파일 접근, 도구 호출 등의 기능을 제공하며 Codex CLI, Claude Code 등이 있음 |
| L1 / L2 / L3 | 평가의 세 계층: 프로그램 전달 검사, 작업 요구 사항 항목별 검사, 멀티모달 심사의 비디오 품질 점수 |
| 엄격 작업 성공률 | 비디오가 성공적으로 전달되고 모든 제약 조건을 충족한 작업의 비율로, 단순한 “전달률”보다 더 엄격함 |
| Bradley–Terry Elo | 사람의 쌍대 비교 결과를 바탕으로 모델의 상대적 선호도를 계산하는 점수 산정 방법 |
| Multi-agent Orchestration | 멀티 에이전트 오케스트레이션: 여러 Agent가 역할을 나누어 협업한 뒤 결과를 통합 |
| Render Pipeline | 비디오 렌더링 파이프라인: 화면 생성, 오디오 처리, 인코딩 합성부터 최종 출력까지 |
| Remotion / FFmpeg | 전자는 React 코드로 비디오 애니메이션을 작성하고, 후자는 오디오·비디오 인코딩과 합성을 담당 |
| ffprobe | FFmpeg에 포함된 검사 도구로, 비디오의 해상도, 프레임 레이트, 길이, 오디오 트랙 등의 정보를 읽는 데 사용 |
| Cache Hit | 캐시 적중률: 반복되는 컨텍스트를 캐시에서 읽어오는 비율로, 장기 작업의 API 비용에 직접 영향을 줌 |
| BenchCAD 2.0 | AI의 3D 부품 재구성, 기계 조립 설계, PCB 연결 인식 능력을 테스트하는 공학 평가 |
1. 먼저 결론부터: GPT는 이미 Opus 5.5의 비디오 제작 경쟁 구간에 진입했어요
1.1 이 글에서 비교하는 ‘비디오 작성’이란 무엇인가
AI 비디오 제작에는 현재 두 가지 경로가 있어요. 네이티브 비디오 생성은 모델이 연속된 화면을 직접 출력하는 방식으로, 인물, 물리적 움직임, 카메라 언어에 강해요. 코드 기반 비디오 생성은 모델을 감독 겸 프로그래머로 활용하는 방식이에요. 요구사항을 이해하고, 스크립트와 스토리보드를 작성하고, Remotion, Three.js, Cairo, Blender로 애니메이션을 코딩하고, TTS로 내레이션을 생성한 뒤, FFmpeg로 합성하고 완성본을 검수하죠.
이 글에서 다루는 건 두 번째 경로예요. 즉, Codex CLI, Claude Code 같은 에이전트를 통해 완전한 MP4와 편집 가능한 프로젝트를 납품하는 능력이에요. 이 경로는 데이터 시각화, 제품 소개, 지식 전달, 동적 인포그래픽, 브랜드 홍보 영상에 적합하고, GPT와 Claude를 독립적인 벤치마크로 비교할 수 있는 분야이기도 해요.
OpenAI 자체의 네이티브 비디오 제품 라인은 이미 변화했어요. Sora 제품은 2026년 4월 26일 서비스를 종료했고, Sora 2 모델과 Videos API는 9월 24일 종료됐으며, 공식 지원 중단 공지에는 일대일 대체 API가 없다고 명시되어 있어요. 11월 4일 공개된 GPT-Image-2.6은 2~16프레임 GIF 애니메이션 출력을 지원하는데, 이모티콘, 반복 동작, 스토리보드 프리뷰에 적합하고 완전한 MP4 제작과는 다른 워크플로우예요. 따라서 GPT 시리즈의 ‘비디오 작성’ 능력은 현재 코드 기반 경로에 주로 나타나요.
1.2 제목 질문에 대한 한 줄 답변
GPT-6 Astra는 VibeVideoBench에서 Opus 5.5와 매우 근접하고, 종합 점수는 약간 높지만 납품 안정성은 약간 낮아요. OpenAI의 차세대 모델은 계속 개선될 기술적 신호를 갖고 있지만, 공개된 비디오 전용 성적은 여전히 Astra를 기준으로 삼고 있어요.
2 239개 실제 영상 작업: GPT-6 Astra와 Opus 5.5, 누가 더 강할까?
2.1 VibeVideoBench는 GPT와 Opus 5.5의 영상 능력을 어떻게 측정할까
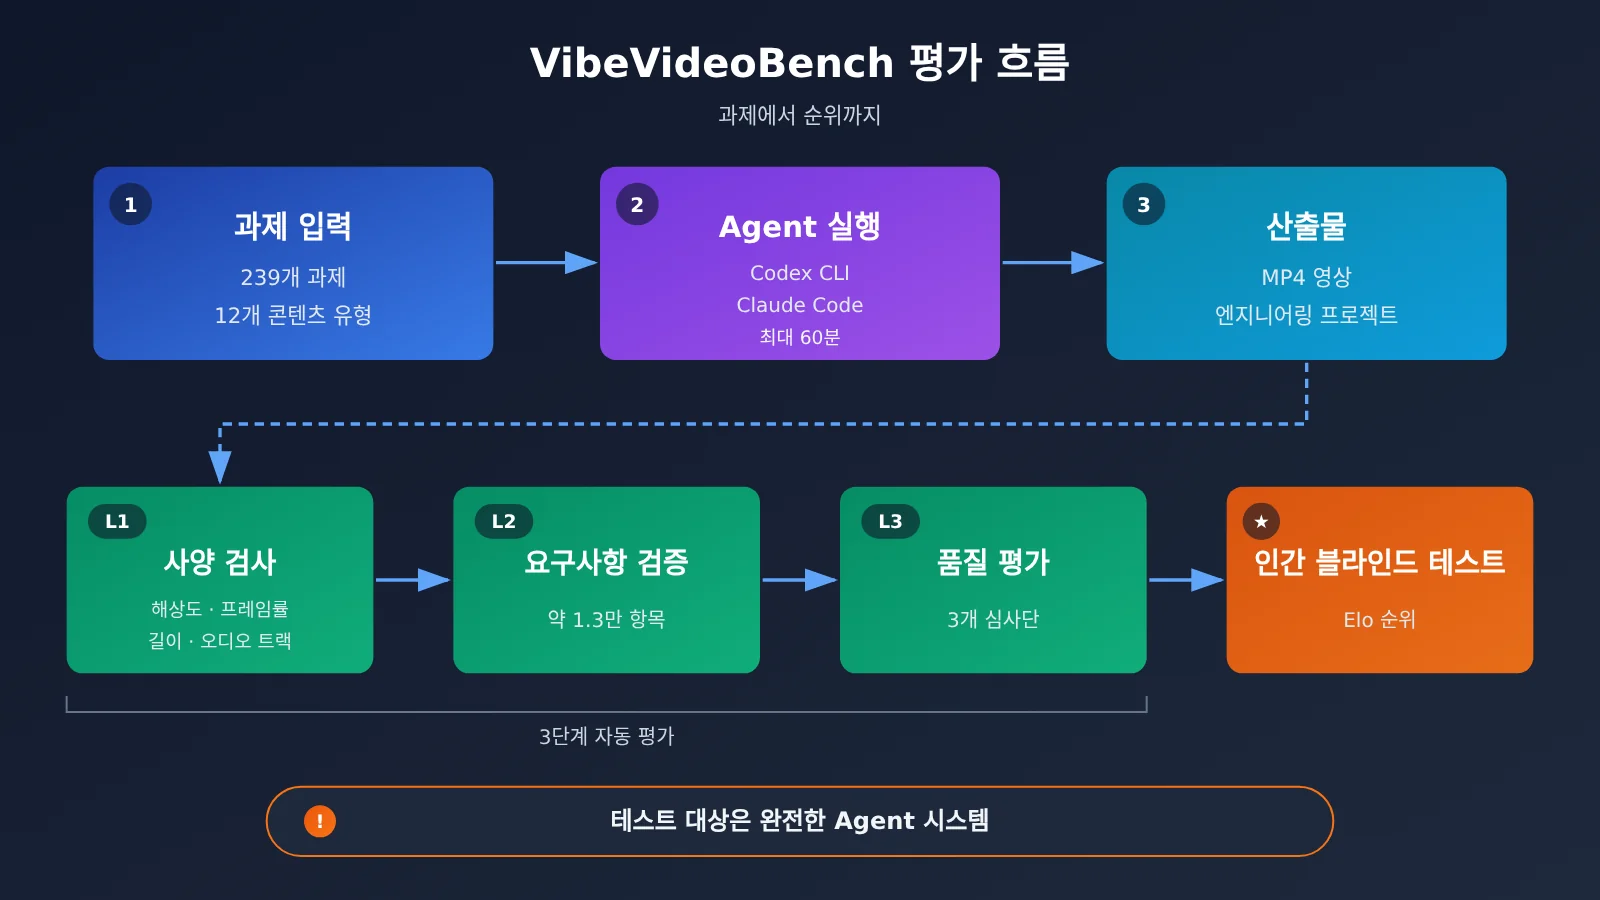
VibeVideoBench는 239개의 실제 영상 제작 작업을 구성했고, 12개 콘텐츠 유형을 아우르며 총 9개 에이전트 시스템, 2,151회 실행을 테스트했어요. 각 작업은 AI가 샌드박스에서 자율적으로 완료해야 하고, 재생 가능한 MP4, 영상을 다시 생성할 수 있는 엔지니어링 프로젝트, 제작 설명을 제출해야 해요. 작업당 시간 제한은 60분이며, 모든 시스템은 각자의 네이티브 개발 환경과 사용 가능한 최고 추론 강도로 실행되고 중간에 추가 인간 지시는 없어요.
GPT-6 Astra는 Codex CLI에서, Claude Opus 5.5는 Claude Code에서 실행됐어요. 나머지 참가 시스템은 Claude Sonnet 5.5, Gemini 4 Argon, DeepSeek V4.1 Flash, Kimi K3, GLM-5.3 Flash, GPT-5.6 Sol, Gemini 3.8 Flash예요. 평가는 세 계층으로 나뉘어요. L1은 MP4가 전달됐는지, 해상도·프레임률·길이·오디오 트랙 등 사양을 확인해요. L2는 약 1.3만 개 작업 요구 사항을 하나씩 검증해요. L3는 세 멀티모달 평가 시스템이 화질, 미감, 콘텐츠 논리, 움직임 리듬, 오디오 동기화를 평가해요.
2.2 GPT-6 Astra와 Opus 5.5 종합 성적 비교
| 지표 | GPT-6 Astra | Claude Opus 5.5 | 우세 |
|---|---|---|---|
| 성공적으로 전달한 영상 | 238/239 | 239/239 | Opus |
| 영상 전달률 | 99.6% | 100% | Opus |
| 규격 준수율 | 93.7% | 99.6% | Opus |
| 작업 요구 통과율 | 97.1% | 97.3% | Opus |
| 영상 품질 | 4.08 | 3.99 | Astra |
| 시각적 미감 | 4.30 | 4.19 | Astra |
| 콘텐츠 논리 | 4.20 | 4.18 | Astra |
| 움직임과 리듬 | 3.95 | 3.95 | 무승부 |
| 오디오 품질 및 동기화 | 4.10 | 4.07 | Astra |
| 종합 품질 점수 | 4.109 | 4.074 | Astra |
| 엄격한 작업 성공률 | 74.5% | 76.3% | Opus |
| 인간 선호도 Elo | 1242 | 1203 | 통계적으로 구분 불가 |
데이터는 세 개의 심사 패널 평균 결과를 기반으로 하며, 점수 범위는 1—5점이에요. 두 시스템 모두 다른 참가 시스템들을 앞섰어요.
이 표는 명확한 역할 분담을 보여줘요. Astra는 “만들어진 영상이 얼마나 보기 좋은가”에서 살짝 우위를 점하며, 종합 품질에서 0.035점, 시각적 미감에서 0.11점 앞서요. 반면 Opus 5.5는 “규격대로 내놓을 수 있는가”에서 더 신뢰할 만하며, 규격 준수율은 5.9%포인트, 엄격한 작업 성공률은 1.8%포인트 높아요. 0.035점 차이는 매우 작고, Elo 신뢰구간을 함께 보면 두 시스템은 같은 등급에 속한다고 볼 수 있어요.
2.3 비디오 유형별 GPT와 Opus 5.5의 우위 분포
| 비디오 카테고리 | Astra | Opus 5.5 | 우위 |
|---|---|---|---|
| 브랜드 및 마케팅 | 4.18 | 4.18 | 무승부 |
| 제품 및 기능 시연 | 4.20 | 4.24 | Opus |
| 음악 및 사운드 기반 | 3.83 | 3.92 | Opus |
| 논문 해설 | 4.03 | 4.07 | Opus |
| 개념 및 프로세스 설명 | 4.19 | 4.15 | Astra |
| 데이터 및 팩트 스토리 | 4.14 | 4.01 | Astra |
| 시각 예술 | 3.94 | 3.91 | Astra |
| 게임 및 스포츠 | 4.15 | 4.12 | Astra |
| 이벤트 및 개인 표현 | 4.03 | 3.93 | Astra |
| 스토리 및 시각 코미디 | 4.00 | 3.88 | Astra |
| 제작 및 빌드 프로세스 | 3.97 | 3.94 | Astra |
| 교실 수업 | 4.47 | 4.45 | Astra |
데이터는 논문 Appendix E.4에서 가져왔으며, 미제출 영상에는 0점을 부여해 집계했어요.
Astra는 12개 중 8개 카테고리에서 앞섰고, 격차가 가장 큰 항목은 데이터 및 팩트 스토리(0.13)와 스토리 및 시각 코미디(0.12)예요. Opus 5.5는 제품 시연, 음악 기반, 논문 해설에서 우위를 보였는데, 음악 기반의 격차는 0.09예요. 음악 과제는 영상과 사운드의 정렬 요구가 크고, 제품 시연은 규격과 디테일에 대한 요구가 큰데, 이는 Opus가 규격 준수율에서 강점을 보이는 방향과 맞닿아 있어요. 대부분 카테고리의 격차는 0.05점 이내로, 모델 선택에 과제 유형별 차이가 나타나기 시작했지만 단일 카테고리의 격차는 반복 테스트 결과를 함께 놓고 판단해야 해요.
2.4 Opus 5.5가 여전히 경쟁력을 갖는 이유
인간 블라인드 테스트는 Bradley–Terry 모델을 사용해 Elo를 계산했어요. Astra는 1242(95% 신뢰 구간 1134–1387), Opus는 1203(1111–1327)으로, 두 모델의 순위 신뢰 구간은 모두 1–3이며, 논문에서 제시한 비교 확률은 P=0.69로 결론은 통계적으로 구분할 수 없다는 것이었어요. 주의할 점은 인간 테스트가 이미 전달된 영상만 평가할 수 있어 정시 전달 능력을 측정할 수 없다는 것이고, 바로 이 전달이 Opus의 강점이라는 점이에요.
자기 점검 행동이 이를 설명해요. Opus는 실행할 때마다 평균적으로 렌더링된 이미지를 7.9회 확인하고 ffprobe를 3.9회 사용했으며, Astra는 각각 3.4회와 2.1회였어요. Opus는 자신의 출력을 더 자주 점검하고 문제를 발견하면 다시 수정하면서 100% 전달률과 99.6% 규격 준수율을 얻었어요. Anthropic은 Opus 5.5를 장시간 실행되는 Agentic Coding 모델로 positioning했고, 커뮤니티에서도 사용자가 이를 약 30분 만에 iOS 앱 홍보 영상으로 완성하고, 1080×1920 세로형 뉴스 숏비디오를 SRT 자막과 함께 자동 제작했다는 사례를 언급했는데, 이는 개인 사례로 워크플로우 완전성의 방증 자료로 볼 수 있어요.
2.5 비디오 작업 비용: GPT-6 Astra는 단가가 더 높지만, 작업당 비용은 더 저렴해요
| 지표 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| 표준 입력 가격(달러/백만 Token) | 10 | 4 |
| 표준 출력 가격(달러/백만 Token) | 50 | 20 |
| 평균 작업 비용 | $8.19 | $15.38 |
| 중간값 작업 비용 | $7.88 | $10.19 |
| P90 작업 비용 | $11.88 | $31.22 |
| 평균 출력 Token | 61K | 130.7K |
| 작업당 API 호출 수 | 46 | 51 |
| 캐시 적중률 (Cache Hit) | 97% | 65% |
Astra의 표준 단가는 Opus 5.5의 2.5배지만, 평균 작업 비용은 약 46.7% 더 낮아요. 이유는 두 가지예요. 첫째, Astra의 출력 Token이 약 53.3% 적어요. 둘째, Astra의 캐시 적중률은 97%에 달하는 반면, Opus는 작업 비용의 약 76%가 Cache Write에서 발생해요. P90 비용 격차는 더 뚜렷한데, Opus는 복잡한 작업에서 비용 변동이 더 크기 때문이에요. 논문에서도 단순히 Token 소비를 늘린다고 해서 그에 상응하는 품질 향상이 따라오지는 않는다고 지적해요.
이 비용은 공개 API 가격을 기준으로 환산한 등가 비용이며, 완성된 상업용 비디오의 인건비와 소재 비용은 포함하지 않아요. Opus 5.5 공식 Batch API는 입력과 출력 모두 50% 할인을 제공하기 때문에, 오프라인 배치 제작 시에는 비용 구조가 달라져요.
💰 비용 최적화: 비디오 Agent의 작업당 비용은 캐시 적중률과 출력 길이에 크게 좌우되기 때문에, 단가만 보고 판단하면 오해하기 쉬워요. APIYI apiyi.com에서 동일한 작업을 두 모델에 각각 실행해 보시고, 표시 가격이 아니라 ‘완성된 비디오 한 편당 실제 소비량’을 기준으로 계산해 보시길 권장해요.
3 OpenAI 차세대 GPT의 능력 향상 신호
3.1 Navier–Stokes 연구: 내부 모델이 GPT-6 Astra보다 현저히 강력
2026년 9월 8일, OpenAI가 Navier–Stokes 밀레니엄 대상 문제 연구 성과를 발표했어요. 공식 글에는 사용된 내부 모델의 능력이 GPT-6 Astra보다 현저히 강력하며, 대규모 강화 학습으로 훈련되었고, 공고 발표 시점에도 훈련이 계속 진행 중이었다고 명시되어 있어요.
이 연구의 실행 규모는 멀티 에이전트 능력을 직접 보여주는 사례예요. 약 10,000개의 Agent가 동시에 참여했고, 연구에는 약 88시간이 걸렸으며, 270만 건의 메시지와 약 1,300억 개의 출력 토큰이 생성되었어요. Agent들은 문제의 서로 다른 버전을 그룹으로 나누어 연구했고, 그룹 간에 정보를 교환했으며, Codex가 중간 성과를 통합했어요. 시스템은 계속해서 더 유망한 경로에 자원을 집중했어요. 마지막 Lean 형식 검증에는 추가로 17시간이 걸렸고, 여기에는 GPT-6 Astra가 사용되었어요.
영상 제작 측면에서 여기서 가장 관련 있는 것은 수학 능력 자체가 아니라 장시간 작업 스케줄링과 멀티 Agent 협업이에요. 복잡한 영상 한 편도 마찬가지로 스크립트, 애니메이션, 오디오를 병렬로 처리한 뒤 통합하고, 검사하고, 재작업해야 하죠.
3.2 BenchCAD 2.0: 엔지니어링 능력이 0.594에서 0.875로 향상
2026년 11월 3일, OpenAI는 《Accelerating engineering for the physical world》에서 비교적 최신 내부 모델이 BenchCAD 2.0에서 평균 0.875를 기록했고, GPT-6 Astra는 최고 추론 강도에서 0.594를 기록해 상대적으로 약 47.3% 향상되었다고 공개했어요. 테스트 내용에는 3D 부품 재구성, 기계 조립 설계, PCB 연결 인식이 포함되어 있어요.
이 두 가지 증거는 따로 봐야 해요. OpenAI는 BenchCAD 테스트 모델과 Navier–Stokes 연구 모델이 같은 것인지 밝히지 않았고, 이름과 발표 시점도 공개하지 않았어요. BenchCAD는 OpenAI가 직접 공개한 엔지니어링 테스트로, 공간 이해와 복잡한 엔지니어링 지식의 진전 신호에 속하며, 영상 생성 작업과 직접적인 대응 관계는 없어요.
3.3 차세대 GPT는 언제 출시되나: 11월 15일 기준 공개 상태
| 날짜 | 공개 진행 상황 |
|---|---|
| 11월 2일 | The National 보도에 따르면, Altman은 ADIPEC에서 수학 연구에 곧 출시될 GPT 모델이 사용되었고 약 10,000개의 Agent가 약 나흘간 협업했다고 밝혔어요. 보도는 이 발언이 독립적으로 검증되지 않았다고 명시했어요 |
| 11월 3일 | OpenAI, 내부 모델 BenchCAD 2.0 데이터 공개 |
| 11월 4일 | The Information이 관계자 인용 보도를 통해 OpenAI가 빠르면 11월 6일에 차세대 Astra, Sol, 사이버 보안 모델을 출시할 수 있다고 전했어요 |
| 11월 5일 | OpenAI API Changelog에서 GPT-6 Cyber 출시를 확인했고, 차세대 범용 Astra 또는 Sol은 출시되지 않았어요 |
| 11월 15일 | 공식 모델 카탈로그의 범용 플래그십은 여전히 GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra, GPT-6 Luna예요 |
온라인에 떠도는 GPT-6.2 Astra, GPT-6.2 Sol 등의 이름은 현재 OpenAI 공식 확인을 받지 못했어요. 마찬가지로 주의할 점은 VibeVideoBench가 측정한 것이 GPT-6 Astra와 GPT-5.6 Sol이라는 거예요. Astra의 성적을 GPT-6.1 Sol이나 Terra에 그대로 적용할 수는 없어요.
4. 차세대 GPT가 영상 제작에서 Opus 5.5를 넘어서려면 무엇이 더 필요한가
4.1 비디오 에이전트의 진짜 병목: 시간 관리와 결과물 전달
VibeVideoBench의 전체 2,151회 실행 가운데 224회는 재생 가능한 영상을 전달하지 못했어요. 그중 169회는 시간 관리 문제였는데, 최종 렌더링을 너무 늦게 시작했거나 실행이 지나치게 느렸거나 아예 시작조차 하지 못한 경우로, 전체 실패의 약 75%를 차지해요. 테스트 환경은 8코어 CPU, 32GB 메모리, GPU가 없는 통일된 Docker 컨테이너여서 렌더링 자체만으로도 상당한 시간을 잡아먹어요.
이것은 모델의 추론 능력이 향상된 뒤에도 실행 리듬으로 이어져야 한다는 걸 보여줘요. 모델이 애니메이션을 아무리 정교하게 작성해도 55분이 되어서야 렌더링을 시작한다면 결과는 여전히 0점이에요. Astra와 Opus 5.5는 품질에서는 이미 우열을 가리기 어려운 수준이고, 차세대 GPT가 격차를 벌릴 여지는 주로 결과물 전달 쪽에 있어요.
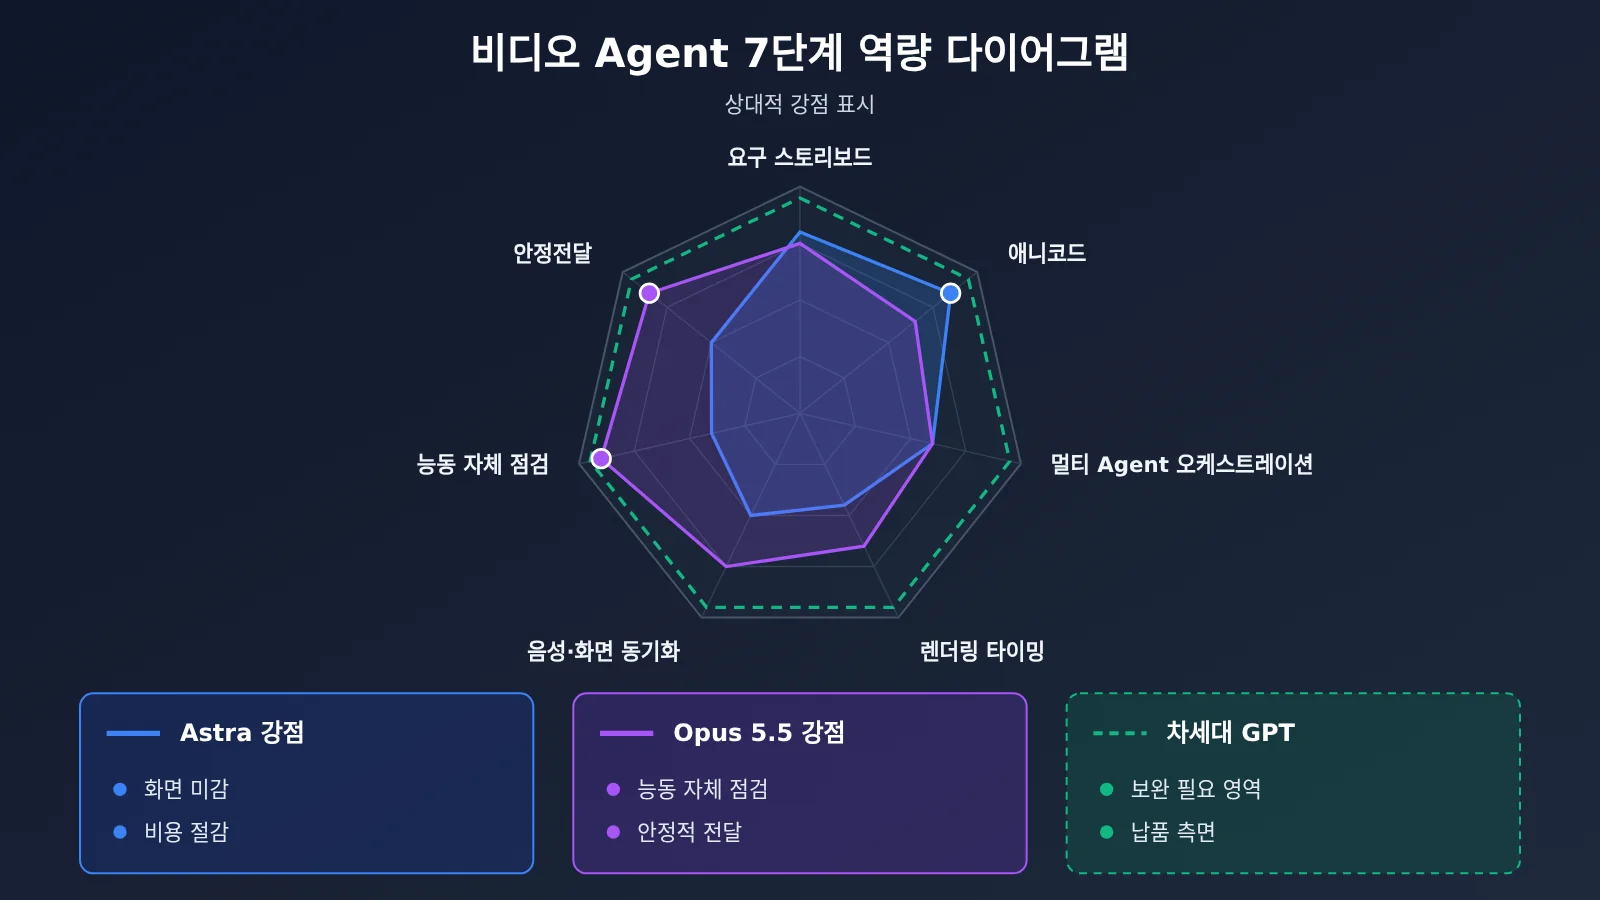
4.2 차세대 GPT가 비디오 워크플로에서 개선해야 할 일곱 가지 지점
두 모델의 현재 강점과 약점을 종합해 보면, 차세대 모델이 Opus 5.5를 확실히 앞서려면 다음 단계에서 동시에 발전해야 해요.
- 요구사항과 스토리보드 이해: 주제, 타깃, 스타일을 정확히 파악하고 요구사항을 샷 순서와 타임라인으로 분해하는 것.
- 복잡한 애니메이션 코드: Remotion, Three.js, Python 애니메이션을 한 번에 정확히 작성해 재작업 렌더링을 줄이는 것.
- 멀티 에이전트 오케스트레이션: 스크립트, 애니메이션, 오디오를 병렬화해야 하는데, 내부 모델이 수학 연구에서 보여준 조율 능력을 이런 엔지니어링 작업으로 옮겨와야 해요.
- 렌더링 타이밍: 렌더링 시간을 충분히 확보해, 전체 실패의 약 4분의 3을 차지하는 시간 관리 문제를 피하는 것.
- 음화면 동기화: 내레이션, 효과음이 화면 리듬과 맞아떨어져야 하는데, 이는 Opus가 음악 기반 작업에서 앞서 있는 방향이에요.
- 능동적 자기 점검: Opus는 평균 7.9회 이미지를 확인하고 Astra는 3.4회인데, 자기 점검 빈도는 규격 준수율과 직접 연결돼요.
- 안정적인 전달: 완전한 MP4와 편집 가능한 프로젝트를 함께, 규격을 한 번에 충족시키는 것.
5. 차세대 GPT가 나온 뒤, 정말 Opus 5.5를 넘어섰는지 검증하는 방법
5.1 일곱 단계 비교 테스트 방법
공개 리더보드는 한 번만 돌리고, 제한 시간은 60분이며, 영어 과제 위주로 구성돼요(239개 중 209개가 영어). 중국어 비즈니스 시나리오는 직접 다시 측정해야 해요. 아래 방법은 새 모델이 출시되는 당일 바로 재사용할 수 있어요.
| 단계 | 방법 | 핵심 지표 |
|---|---|---|
| 1 과제 세트 고정 | 스크립트, 애니메이션, 데이터 시각화, 제품 시연을 아우르는 실제 비즈니스 영상 요구 10~20개 선정 | 과제 커버리지 |
| 2 환경 고정 | 툴체인(Remotion/FFmpeg 버전), 머신 사양, 시간 제한을 통일하고 Harness 차이는 따로 기록 | 비교 가능성 |
| 3 단계별 테스트 | 먼저 API로 스토리보드와 애니메이션 코드를 단위 테스트하고, 그다음 Agent 환경에서 전체 프로세스를 실행 | 단계별 점수 |
| 4 소모량 기록 | 매 실행의 소요 시간, 입출력 토큰, 캐시 히트 | 영상 단위 비용 |
| 5 결과물 검사 | ffprobe로 해상도, 프레임 레이트, 길이, 오디오 트랙을 확인 | 전달률, 사양 준수율 |
| 6 블라인드 테스트와 반복 | 모델명을 가리고 일대일 비교, 과제당 최소 3회 실행 | 선호도 승률, 분산 |
| 7 종합 점수 | 품질, 성공률, 수정 비용, 영상 단위 비용을 가중 합산 | 최종 선정 결론 |
3단계에서는 “모델 능력”과 “Agent 환경 능력”을 분리해요. VibeVideoBench는 완전한 Agent 시스템을 측정하고, Codex CLI와 Claude Code 자체에도 차이가 있어요. 같은 OpenAI 호환 인터페이스로 두 모델을 직접 호출해 스토리보드와 애니메이션 코드를 생성하면, 먼저 Harness의 영향을 걷어내고 모델 자체의 격차를 명확히 볼 수 있어요.
5.2 통합 인터페이스로 단계별 비교를 하는 코드 예시
아래의 아주 간단한 예시는 동일한 base_url로 두 모델을 호출해, 같은 영상 요구사항에 대한 스토리보드 스크립트를 생성해요. 모델 이름은 플랫폼의 모델 목록을 기준으로 확인하세요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 하나의 Key로 GPT와 Claude 호출
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
전체 멀티턴 비교 테스트 스크립트 보기 (소요 시간과 Token 기록)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI를 통해 통합 호출하여 전환과 비교가 용이
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # 플랫폼 모델 목록 기준이며, 새 모델이 출시되면 바로 추가
RUNS = 3  # 각 작업의 반복 실행 횟수

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# 결과를 저장하고, 모델명을 가린 뒤 평가자에게 블라인드 테스트로 전달
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 빠른 시작: 단계별 비교에는 GPT와 Claude를 동시에 호출해야 해요. APIYI apiyi.com의 하나의 API 키와 OpenAI 호환 인터페이스로 두 모델을 전환할 수 있고, 신규 사용자에게는 무료 테스트 크레딧이 제공돼요. 차세대 GPT가 출시되면 모델 이름을
MODELS리스트에 추가해 같은 작업 세트를 다시 실행하면 된답니다.
5.3 전체 프로세스 테스트 시 유의사항
단계별 테스트를 통과한 뒤 Codex CLI와 Claude Code에서 전체 영상 작업을 실행하고, 전달률과 ffprobe 검사 결과를 기록해요. 수동 블라인드 테스트는 이미 전달된 영상만 평가하고, 전달률은 반드시 별도로 집계해야 해요. 그렇지 않으면 VibeVideoBench 수동 테스트의 사각지대를 반복하게 돼요. 각 작업은 최소 3회 반복해 평균과 분산을 구하고, 단일 실행 결과를 안정적인 성능으로 착각하지 않도록 해요.
6 의사결정 제안: GPT와 Opus 5.5의 영상 시나리오, 어떻게 선택할까
6.1 시나리오에 따라 GPT-6 Astra 또는 Opus 5.5 선택
VibeVideoBench의 카테고리별 점수와 전달 데이터를 기준으로, 현재 단계에서는 이렇게 배분할 수 있어요:
- GPT-6 Astra 우선: 데이터와 사실 기반 스토리, 개념 및 프로세스 설명, 스토리형 및 게임형 영상; 대량 생산과 단위 비용에 민감한 시나리오. 평균 작업 비용은 8.19달러이고 P90 비용도 더 관리하기 쉬워요.
- Claude Opus 5.5 우선: 제품 및 기능 시연, 음악 기반 영상, 논문 해설; 규격과 납품에 대한 엄격한 요구사항이 있는 상업용 납품, 예를 들어 고정 해상도, 길이, 오디오 트랙이 반드시 포함되어야 하는 광고 소재.
- 브랜드 마케팅: 두 모델 모두 4.18점으로 같으므로, 비용과 팀이 이미 사용 중인 툴체인을 기준으로 결정해요.
6.2 차세대 GPT를 기다릴까, 지금 출시할까
현재 두 모델은 이미 사용 가능한 영상을 안정적으로 만들어 낼 수 있어서, 비즈니스에서는 차세대 모델을 기다릴 필요가 없어요. 더 현실적인 방법은 5절의 방법으로 자체 작업 세트와 베이스라인 점수를 만들어 두고, 새 모델이 출시되는 당일 다시 실행해 데이터로 전환 여부를 결정하는 거예요.
💡 선택 제안: 두 모델의 차이는 주로 전달 안정성과 비용 구조에 집중되어 있고, 최종 선택은 영상 유형과 전달 요구사항에 달려 있어요. APIYI apiyi.com을 통해 동일한 실제 작업 세트로 각각 테스트해 보길 권장해요. 통합 인터페이스를 쓰면 나란히 비교하고 이후 새 모델로 전환하기도 쉬워요.
7 최종 결론: 차세대 GPT의 경쟁 목표는 더 이상 Opus 5.5를 따라잡는 것만이 아니에요
7.1 GPT와 Opus 5.5의 영상 능력 핵심 요점
- 현황: GPT-6 Astra와 Claude Opus 5.5는 VibeVideoBench 코드 기반 영상 과제에서 나란히 최상위권에 있으며, 종합 품질은 4.109 대 4.074예요.
- Astra의 강점: 시각적 미감, 대부분 콘텐츠 카테고리의 점수, 그리고 약 46.7% 더 낮은 평균 작업 비용이에요.
- Opus 5.5의 강점: 239/239 전량 전달, 99.6% 사양 준수율, 더 잦은 자체 점검이에요.
- 인간 선호도: 1242 대 1203, 신뢰구간이 겹쳐 통계적으로 구분할 수 없어요.
- 차세대 신호: 내부 모델이 BenchCAD 2.0에서 0.875(Astra 0.594)를 기록했고, 만 단위 에이전트 협업 능력도 보여줬어요. 다만 이름, 출시 시점, 영상 성적은 모두 아직 공개되지 않았어요.
- 진짜 병목: 전달 실패의 약 75%가 시간 관리에서 비롯되며, 경쟁의 초점이 생성 품질에서 실행과 전달로 옮겨가고 있어요.
- 검증 방법: 고정 과제, 고정 환경, 다중 블라인드 테스트, 영상 단위 비용 기준 회계를 적용하면 APIYI apiyi.com에서 통일된 인터페이스로 단계별 재측정을 진행할 수 있어요.
7.2 경쟁의 종착점은 완전한 생산 효율
제목으로 다시 돌아가 볼게요. GPT는 이미 Opus 5.5를 따라잡았고, 현행 Astra는 품질과 비용에서 약간 우위를, Opus 5.5는 전달 신뢰성에서 우위를 점하고 있어요. OpenAI의 내부 모델은 더 강력한 범용 능력과 다중 에이전트 실행 잠재력을 보여줬고, 차세대 범용 GPT는 영상 제작 능력을 한층 더 끌어올릴 기회를 갖고 있어요. 구체적인 향상 폭은 출시 이후의 독립 평가와 여러분의 실제 업무 테스트가 답이 될 거예요.
앞으로의 경쟁은 완전한 생산 효율에서 갈릴 거예요. 아이디어를 이해하는 것부터 신뢰할 수 있고 정확하며 수정 가능한 영상 한 편을 내놓는 것까지, 누가 더 낮은 비용으로 더 많은 과제를 완수하는가가 관건이죠. 지금 APIYI apiyi.com에서 여러분의 영상 과제 베이스라인을 만들어 두면, 새 모델이 출시되는 즉시 바로 비교할 수 있어요.
참고 자료
- VibeVideoBench 공식 평가 웹사이트: 비디오 에이전트 리더보드와 품질 점수
- 링크:
vibevideobench.github.io -
설명: 전체 순위표와 평가 설계 개요
-
VibeVideoBench 논문: 방법론, 분류별 성적, 비용, 인간 선호도 및 실패 원인
- 링크:
arxiv.org/abs/2610.35864 -
설명: 본문 표 데이터의 주요 출처이며, 분류별 성적은 Appendix E.4 참조
-
Anthropic Claude Opus 5.5 발표 공지: 모델 포지셔닝과 공식 사례
- 링크:
anthropic.com/claude-opus-5-5 -
설명: Opus 5.5의 성능과 비용 변화에 관한 공식 설명
-
OpenAI: On the Navier–Stokes Millennium Prize Problem: 내부 모델과 멀티 에이전트 연구
- 링크:
openai.com/index/navier-stokes-solution -
설명: 10,000개 동시 에이전트, 88시간 연구 등의 데이터
-
OpenAI: Accelerating engineering for the physical world: BenchCAD 2.0 내부 모델 성적
- 링크:
openai.com/index/accelerating-engineering-for-the-physical-world -
설명: 내부 모델 0.875와 GPT-6 Astra 0.594의 비교
-
OpenAI API Changelog와 모델 카탈로그: 출시 진행 상황 확인
- 링크:
developers.openai.com/api/docs/changelog,developers.openai.com/api/docs/models -
설명: GPT-6 Cyber 출시 기록과 현재 공개된 플래그십 모델
-
OpenAI API Deprecations: Sora 2와 Videos API 종료 정보
- 링크:
developers.openai.com/api/docs/deprecations - 설명: 네이티브 비디오 생성 경로의 현황
작성자: APIYI 기술팀
기술 교류: 비디오 에이전트 테스트 경험을 나누고 싶다면 APIYI apiyi.com 홈페이지에서 연락 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요