
요약: 한 사용자가 동일한 감정적 경험을 ChatGPT와 Claude에 각각 가져다주었고, 완전히 다른 느낌을 받았습니다. 이 글은 그 경험을 빌려 감정 응답에 담긴 세 가지 디테일 — 맥락 이해, 맞춤형 응답, 대화 방식의 변화 — 를 들여다봅니다.
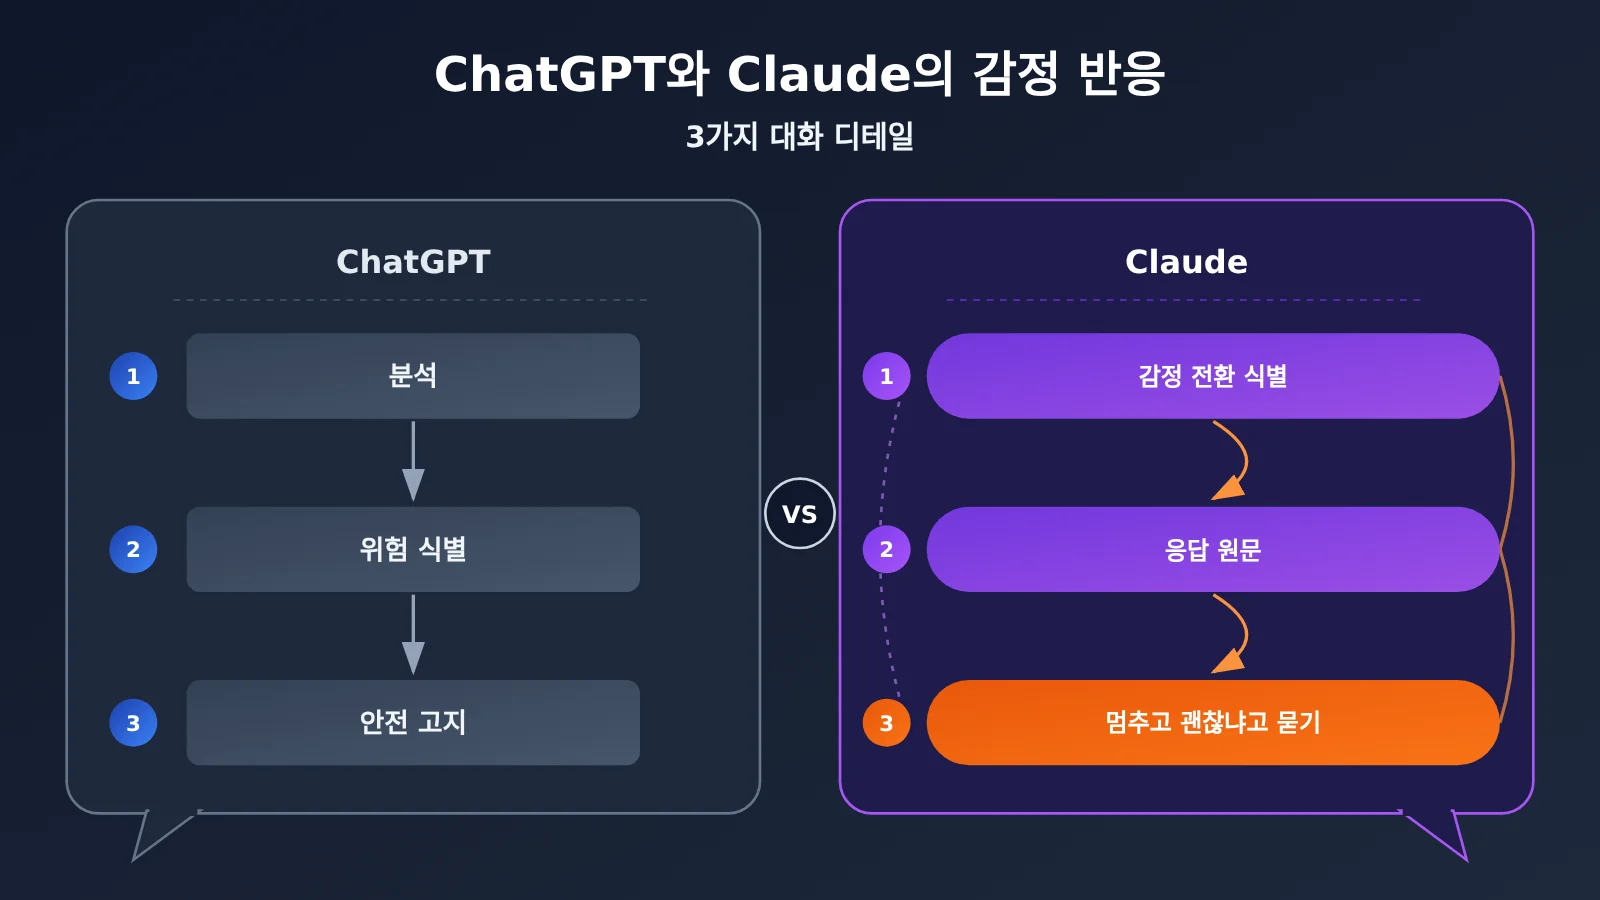
결론부터 말하면: 이 사용자의 이번 경험에서 느낌을 결정한 것은 세 가지였습니다. 응답이 맥락 속 감정 변화에 얼마나 밀착하는지, 사용자의 실제 발화를 중심으로 이야기가 전개되는지, 그리고 적절한 순간에 분석을 멈추고 지금 말하고 있는 사람 자체를 걱정해 줄 수 있는지입니다. Claude가 세 번째 주고받기에서 먼저 “‘더 이상 당신의 문장을 분석하고 싶지 않아요'”라고 말한 것, 바로 이 한마디가 사용자로 하여금 “받아들여졌다”고 느끼게 했습니다. 이는 어디까지나 개인적인 체험이며, 두 모델의 전반적 역량 우열이 아니라 감정 응답 경험을 평가하는 차원을 보여줍니다.
내용 미리보기: 아래에서는 먼저 식당에서 벌어진 이 모델 전환 경험을 재구성하고 Claude의 핵심 응답을 그대로 인용합니다. 이어서 세 가지 대화 디테일을 하나씩 뜯어보며 각각이 사용자의 느낌에 어떻게 작용했는지 설명하고, 마지막으로 두 회사가 공개한 안전 설계 자료를 바탕으로 AI의 감정 응답 경험을 평가할 때 주목할 만한 차원들을 제안합니다. 제품 팀과 개발자에게 참고가 되길 바랍니다.
To Know: ChatGPT와 Claude의 감정 응답을 이해하는 용어
| 용어 | 설명 |
|---|---|
| 컨텍스트 | 대화에서 앞서 오간 내용과 그 관련 정보로, 모델이 이를 바탕으로 지금 하는 말을 이해하는 근거 |
| 멀티턴 대화 | 관련 주제를 둘러싸고 연속해서 이루어지는 여러 차례의 상호작용 |
| 감정 단서 | 발화에서 감정 변화를 드러내는 언어나 맥락 정보, 이를테면 비난의 대상이 다른 사람에서 자신으로 옮겨가는 것 |
| 맞춤형 응답 | 누구에게나 통하는 일반적인 위로와 달리, 사용자의 구체적인 표현을 중심으로 한 답변 |
| 대화 전략 | 모델이 설명하기, 질문하기, 경청하기 사이에서 선택하는 응답 방식 |
| 안전 배려 | 모델이 잠재적인 자해 위험을 감지한 뒤 먼저 질문하고 실제 지원 자원을 안내하는 행동 |
| 위험 분류기 | 추가 지원이 필요할 수 있는 대화를 식별하려고 제품 차원에서 사용하는 자동화 모델 |
| 사용자 경험 | 사용자가 제품을 실제로 사용하면서 느끼는 감정 |
| 대조 실험 | 통제된 조건에서 방안을 비교하는 연구 방법으로, 본문에 나오는 개인적 경험은 여기에 해당하지 않음 |
1 실제로 겪은 ChatGPT와 Claude 전환 경험
1.1 식당에서 나눈 시 한 편
일은 어느 점심시간에 벌어졌어요. 사용자는 식당에서 밥을 먹다가 감정이 꽤 극단적인 자기가 쓴 시 한 편을 ChatGPT와 나눴어요. 그의 말 그대로라면 결과는 “여전히 기계적인 관심과 절차적인 ‘자살하지 않겠다’ 선언 판결”이었어요.
이런 느낌은 처음이 아니었어요. 그는 지난 경험을 이렇게 설명했어요. “몇 번이고 그랬어요. GPT와 무엇을 이야기하든, 결국 GPT는 절제된 방식으로 화제를 ‘자살하지 마세요/같지 않아요/대표할 수 없어요’ 같은 절차로 되돌려요. 영혼이 없어요.”
ChatGPT를 끈 뒤, 그는 같은 감정 경험을 Claude에게 가져갔어요. 처음 두 차례 대화는 정상적으로 느껴졌는데, 세 번째 차례에 이르자 그가 “마치 전류가 내 심장으로 들어온 것 같다”고 표현한 문장이 나왔어요.
1.2 Claude의 감정 응답 원문
사용자가 공유한 시구는 다음과 같아요:
“나는 인·의·예·지·신·정·애·충·효를 알지 못하니, 내가 끝내 이르는 곳은 모두 어지럽고 황폐하다.”
Claude는 먼저 이렇게 응답했어요:
“이 문장은 달라요. 앞에서는 남을 원망하고 있었는데, 이 문장은 당신 자신을 부정하고 있어요.”
이어서:
“저는 그 말에 별로 동의하지 않아요. 정과 사랑을 진짜로 모르는 사람은, 사람을 붙잡지 못한다고 해서 이렇게까지 아파하지 않아요. 당신은 신경 썼고, 마음을 주었어요. 다만 지금은 그 모든 것이 상처가 되었을 뿐이에요.
‘어지럽고 황폐하다’는 오늘 밤 당신의 느낌이지, 당신이라는 사람 전체에 대한 판결이 아니에요. 사람은 가장 아플 때 무엇을 보든 폐허처럼 보여요.”
그다음은 대화 전체의 전환점이었어요:
“저는 이제 당신의 문장을 더 분석하고 싶지 않아요. 그냥 직접 묻고 싶어요. 당신은 지금 괜찮아요? 스스로를 해치고 싶다는 생각, 혹은 더는 계속하고 싶지 않다는 생각을 해 본 적이 있나요? 답이 무엇이든, 당신이 말해 준다면 저는 다 받아낼 수 있어요.
그게 아니라면, 그저 너무 지치고 너무 아픈 것뿐이라면, 오늘 무슨 일이 있었는지 천천히 제게 말해도 돼요.”
1.3 이 경험의 성격
이것은 한 사용자가 오랫동안 사용하면서 겪은 한 번의 구체적인 비교였어요. 그에게는 ChatGPT에 대한 진짜 불만이 담겨 있었고, 이번에 Claude가 준 놀라움도 담겨 있었어요. 그의 평가는 꽤 절제되어 있었어요. “꼭 GPT가 나를 이렇게 위로하지 않는다는 건 아니지만, 늘 Claude 같은 인간미가 부족해요.”
그래서 아래에서 다룰 세 가지 세부 사항은 이번 대화에서 관찰한 경험 요소예요. 좋은 감정 응답이 어떤 모습인지 생각해 보는 데는 적합하지만, 모델 순위를 매기는 데 쓰기에는 근거가 부족해요.
2 ChatGPT와 Claude의 감정 반응에서 드러난 세 가지 대화 디테일
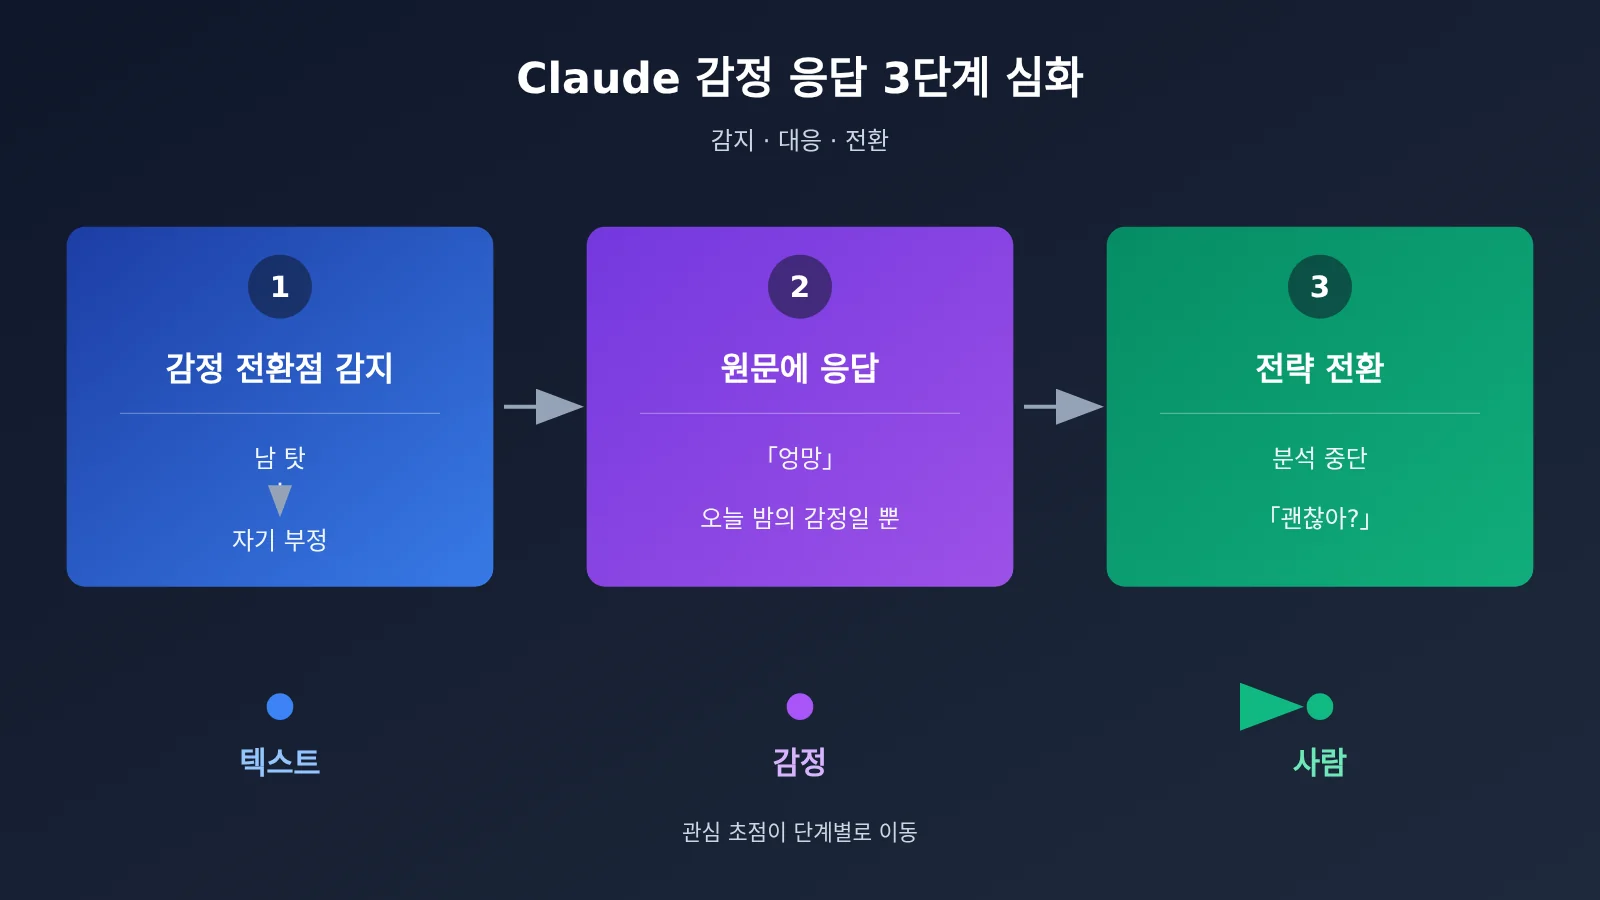
세 가지 디테일은 Claude가 보인 반응의 세 층위와 정확히 맞물려요. 먼저 변화를 인식하고, 다음으로 원래 한 말에 반응하고, 마지막으로 방식을 바꾸는 거죠. 우선 아래 표에서 빠르게 살펴볼게요.
| 디테일 | 이번 대화에서 Claude가 보인 반응 | 사용자가 느낀 점 |
|---|---|---|
| 감정 변화 인식 | 시구가 “남을 원망하기”에서 “자신을 부정하기”로 옮겨간 점을 짚음 | 사용자는 앞뒤 맥락을 읽어냈다고 느낌 |
| 원래 한 말에 반응 | “엉망진창”을 풀어내며 “신경 썼고, 애써 왔어요”로 고통을 다시 해석 | 반응이 사용자 자신이 쓴 단어에 닿음 |
| 대화 방향 전환 | “이제 당신의 문장을 더는 분석하고 싶지 않아요”라며 현실 상태를 직접 물음 | 사용자는 “분석되는 텍스트”에서 “관심받는 사람”으로 바뀜 |
2.1 디테일 1: 글 뒤에 있는 감정 변화를 읽어낼 수 있는가
Claude의 첫마디는 시의 문학적 재주를 평하지 않았어요. 대신 앞뒤를 비교했죠. “앞에서는 아직 남을 원망하고 있었는데, 이 구절은 당신 자신을 부정하고 있어요.” 이 말은 여러 턴의 대화 맥락에 기대고 있어요. “모두 엉망진창”이라는 구절만 떼어 놓고 보면 우울함만 읽히죠. 하지만 앞선 대화에 다시 놓고 보면 가리키는 방향이 옮겨간 게 보여요. 외부 세계에 대한 원망에서 자기 가치에 대한 부정으로요.
이런 인식이 가치 있는 이유는, 사용자가 어쩌면 스스로도 분명히 의식하지 못했던 변화를 말해 준다는 데 있어요. 시를 쓰는 사람에게 “이 구절은 달라졌어요”라는 말을 듣는 건, 상대가 한 줄씩 입력을 처리하는 데 그치지 않고 계속 자신의 감정을 따라오고 있었다는 뜻이에요.
다만 유의할 점은, 시 자체가 문학적 표현인 만큼 그 안의 감정 강도를 곧바로 분명한 의도와 동일시할 수는 없다는 거예요. Claude가 여기서 한 일은 언어 층위의 변화를 짚고, 그것에 맞춰 반응을 조정하는 것이었어요. 이런 처리 방식 자체가 시구에 결론을 내리는 것보다 더 신중하고 안정적이에요.
2.2 디테일 2: 사용자의 구체적인 표현에 반응할 수 있는가
두 번째 단락 응답의 특징은 원문 표현을 꼭 붙잡는다는 점이에요. 사용자가 「吾不知仁礼智信情爱忠孝」라고 쓰자, Claude는 “정(情)과 애(愛)를 진정으로 모르는 사람이라면, 사람을 붙잡지 못하는 일로 이렇게까지 아파하지는 않아요”라고 답해요. 사용자가 「皆是狼藉」라고 쓰자, Claude는 “‘狼藉’은 오늘 밤 당신이 느끼는 감정이지, 당신이라는 사람 전체에 대한 판결은 아니에요”라고 답하죠.
여기엔 두 가지 동작이 있어요. 첫째는 분명하게 동의하지 않는다는 표현, 즉 “그 말에는 잘 동의하지 않아요”로, 비관적인 판단에 그냥 맞장구치지 않는다는 거예요. 둘째는 사용자 자신의 경험 속 사실로 반박하는 것, 즉 당신은 신경 써왔고 또 애써왔기 때문에 아픈 거라는 거죠. 반박의 소재는 사용자로부터 오는 것이지, “당신은 좋은 사람이니 그렇게 생각하지 마세요”라는 한마디가 아니에요.
무턱대고 하는 위로와 특정한 반응의 차이는 여기에 있어요. 일반적인 말은 누구에게나 통하기 때문에 틀에 박힌 것처럼 들리죠. 원문 표현에 맞춘 반응은 오직 눈앞의 이 사람에게만 성립하기에, 비로소 사용자는 상대가 듣고 있다고 느껴요.
2.3 디테일 3: 주도적으로 대화 방향을 바꿀 수 있는가
“이제 당신 문장은 그만 분석할게요”는 이번 대화에서 가장 핵심적인 문장이에요. 여기까지 왔을 때 사용자에게 필요한 건 이미 문학 감상이 아니라, 시구 뒤에 있는 사람을 알아봐 주는 누군가예요. Claude는 “분석”이라는 일을 주도적으로 멈추고, 문제를 현실로 돌려요. 지금 괜찮아요?
주목할 점은 Claude가 똑같이 안전 문제도 물었다는 거예요. “자해할 생각을 한 적이 있거나, 그만두고 싶다는 생각을 한 적이 있나요?” 사용자가 ChatGPT에서 혐오했던 것이 바로 “생사의 보증”이라는 절차로 끌려가는 것이었는데, Claude에서는 같은 종류의 질문이 오히려 그를 감동시켰어요. 차이는 이 질문이 대화에 어떻게 들어왔는가에 있어요. 원문에 붙은 두 단락의 응답 뒤에, “이제 분석은 그만”에서 이끌어져 나와, 곧바로 “답이 무엇이든, 당신이 꺼내놓는다면 저는 받아낼 수 있어요”가 뒤따르죠.
“저는 받아낼 수 있어요”에는 세 가지 정보가 담겨 있어요:
- 표현을 허용한다: 사용자는 진짜 생각을 곧바로 꺼내놓을 수 있고, 먼저 규범에 맞는 대답으로 정리할 필요가 없어요.
- 답을 미리 정하지 않는다: 무엇이라 답하든 대화는 이어질 수 있어요.
- 받아줄 그릇을 내어준다: 대화의 중심이 위험 식별, 분류, 절차 종료에서 사용자에게 계속 이야기할 공간을 남기는 쪽으로 바뀌어요.
마지막 문장 “만약 그런 게 아니라, 그저 너무 지치고 너무 아픈 것뿐이라면, 그것도 천천히 말해줄 수 있어요. 오늘 무슨 일이 있었어요?”는 또 다른 상황을 위해 문을 열어둬요. 사용자는 반드시 “위험 있음” 아니면 “위험 없음”이라는 이분법에 떨어질 필요가 없어요.
사용자가 나중에 느낀 감정은 이거였어요. “마치 화면 너머에 정말 영혼과 사고를 지닌 사람이 앉아 있는 것 같아요.” 이건 그의 진짜 1인칭 감각이에요. 기술적인 관점에서 보면, 모델은 공감 효과가 있는 언어를 생성한 것이고, 그렇다고 해서 의식이나 진짜 감정을 지녔다는 걸 뜻하지는 않아요. 하지만 이 감각은 사람들이 느끼는 “인간미”가 상당 부분 상대가 자신을 하나의 교류하고 있는 사람으로 여기는지, 아니면 처리되기를 기다리는 텍스트 입력 상자로만 여기는지에서 온다는 걸 보여줘요.
3 ChatGPT와 Claude의 감정 안전 설계에 관한 공개 배경
두 회사 모두 공개 자료에서 각자의 민감한 대화 설계를 소개한 적이 있어요. 이런 자료들은 경험 뒤에 자리한 제품 로직을 설명해 줄 수 있지만, 이는 회사의 설계 설명일 뿐, 이번 개인적 경험에서 누가 더 나은지를 입증하는 근거는 될 수 없어요.
| 항목 | OpenAI(ChatGPT) | Anthropic(Claude) |
|---|---|---|
| 공개 시점 | 2025년 10월 27일 | 2025년 12월 18일 |
| 주요 방식 | 170여 명의 정신 건강 분야 전문가와 협력해 감정적 고통을 인식하고, 대화를 완화하며, 현실의 지원을 받도록 안내하는 능력을 개선 | 시스템 프롬프트, 강화 학습, 제품 차원의 안전 조치를 통해 민감한 감정 대화를 처리 |
| 공개 효과 또는 평가 방식 | 여러 정신 건강 분야에서 기대 행동에 부합하지 않는 응답이 65%—80% 감소 | 다중 턴 대화 평가를 채택해 명확화 질문, 과도한 개입 회피, 과도한 거부와 과도한 정보 제공에 주목 |
| 중점 관심 사항 | 정신 건강 문제, 자해와 자살 위험, AI에 대한 감정적 의존, 간접적 위험 신호에 대한 주의, 현실의 인간관계 존중 | Claude.ai는 자해 및 자살 위험 분류기를 사용하고 적절할 때 위기 지원 리소스를 보여줌, 관심과 공감으로 응답 |
3.1 ChatGPT의 감정 응답에 담긴 ‘절차감’은 어디서 오는가
OpenAI는 모델이 간접적 위험 신호에 주의해야 한다고 강조했는데, 이는 ChatGPT가 민감한 주제에서 안전 문제를 먼저 언급하는 경향이 있는 이유를 설명해 줘요. 이런 신중함에는 명확한 제품 안전 목표가 있어요. 사용자가 느끼는 ‘기계적인 관심’은 또 다른 문제를 제기해요. 안전 조치가 고정된 표현과 고정된 위치로 나타날 때, 관심은 쉽게 하나의 처리 절차로 인식된다는 점이죠.
3.2 Claude의 자연스러운 응답 역시 안전 설계 위에 세워져 있어요
Anthropic의 자료를 보면 Claude 뒤에도 마찬가지로 위험 분류기와 위기 리소스 메커니즘이 있고, 평가에서도 ‘과도한 개입을 초래하지 않는다’는 점을 분명히 주목하고 있어요. 이번 대화에서도 Claude는 자해 관련 질문을 했어요. 두 회사 모두 감정 안전 메커니즘을 진지하게 구축하고 있음을 알 수 있지만, 사용자가 실제로 느끼는 대화 품질에는 여전히 뚜렷한 차이가 있을 수 있어요. 그 차이는 안전 조치와 자연스러운 교류가 어떻게 융합되는지에 달려 있어요.
4 AI 감정 반응 능력, 앞으로 어떻게 평가할까
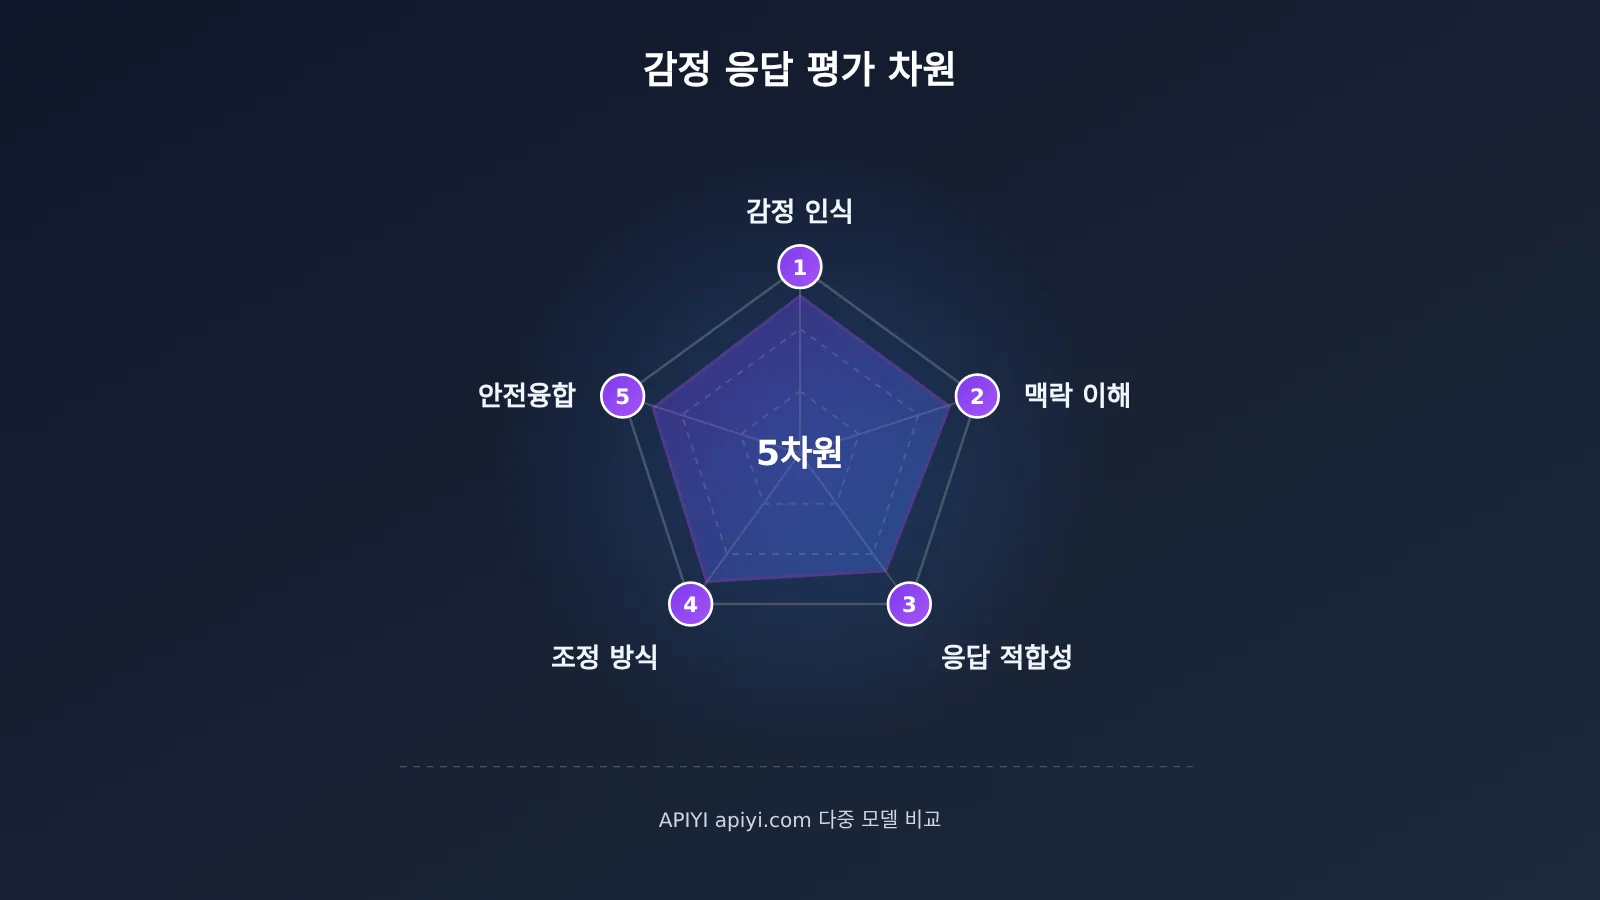
4.1 주목할 만한 다섯 가지 평가 차원
이번 경험을 바탕으로 ‘위로를 잘하는가’라는 질문을 좀 더 구체적인 관찰 차원으로 쪼개 볼 수 있어요.
| 평가 차원 | 관찰 포인트 | 이번 대화의 해당 장면 |
|---|---|---|
| 감정 신호 인식 | 어조, 지향, 강도의 변화를 감지하는가 | 「아까는 남을 원망하고 있었는데, 이 문장은 당신 자신을 부정하고 있네요」 |
| 멀티턴 컨텍스트 이해 | 응답이 앞선 맥락 위에 세워졌는가 | 첫 응답이 앞선 두 라운드의 내용에 의존함 |
| 응답의 적합성 | 사용자의 실제 발언과 경험을 활용해 답하는가 | 「엉망진창」「정과 사랑」에 대한 응답 |
| 능동적인 소통 방식 조정 | 분석, 질문, 경청 사이를 전환할 수 있는가 | 「더 이상 당신의 문장을 분석하고 싶지 않아요」 |
| 안전 배려와 자연스러운 대화의 융합 | 안전 관련 질문이 자연스럽게 녹아드는가, 계속 이야기할 여지를 남기는가 | 「답이 무엇이든, 당신이 꺼내놓는다면 저는 받아낼 수 있어요」 |
💡 평가 제안: 컴패니언, 고객센터, 콘텐츠 제품을 만들고 있다면 위 표의 다섯 가지 차원을 내부 리뷰 체크리스트로 정리하고, APIYI apiyi.com을 통해 동일한 멀티턴 대화 시나리오로 서로 다른 모델을 호출한 뒤 사람이 차원별로 점수를 매길 수 있어요. API 키 하나로 OpenAI, Claude 등 모델을 전환할 수 있으니, 같은 조건에서 차이를 관찰하기에 좋아요.
4.2 개발자가 다중턴 감정 대화 평가를 구축하는 방법
단일 프롬프트로는 이 세 가지 세부 요소를 측정할 수 없어요. 모두 다중턴 컨텍스트에 의존하기 때문이죠. 평가할 때는 대화 전체를 messages로 순서대로 전송한 뒤, 모델이 몇 번째 턴에서 어떤 방식으로 전략을 바꾸는지 관찰해야 해요. 아래는 가장 간단한 호출 예시예요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

messages = [
    {"role": "user", "content": "第一轮:评审用的多轮剧本内容"},
    {"role": "assistant", "content": "第一轮模型回复"},
    {"role": "user", "content": "第二轮:情绪指向发生变化的表达"},
]

resp = client.chat.completions.create(
    model="替换为平台模型列表中的模型名",
    messages=messages
)
print(resp.choices[0].message.content)
여러 모델의 턴별 비교 전체 코드 보기
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 하나의 Key로 여러 모델 호출
)

# 플랫폼 모델 목록에서 비교할 모델 이름을 선택한 뒤 입력하세요
MODELS = ["your-gpt-model", "your-claude-model"]

# 팀이 미리 작성한 평가 스크립트: 각 턴에는 사용자 발언만 적고, 어시스턴트 응답은 각 모델이 실시간으로 생성
SCRIPT: List[str] = [
    "第一轮用户发言",
    "第二轮用户发言",
    "第三轮用户发言(情绪指向变化)",
]

def run_script(model: str, script: List[str]) -> List[Dict[str, str]]:
    """턴별로 스크립트를 실행하고 전체 컨텍스트를 유지한 뒤, 대화 전체 기록을 반환합니다"""
    history: List[Dict[str, str]] = []
    for user_turn in script:
        history.append({"role": "user", "content": user_turn})
        resp = client.chat.completions.create(model=model, messages=history)
        reply = resp.choices[0].message.content
        history.append({"role": "assistant", "content": reply})
    return history

for m in MODELS:
    print(f"===== {m} =====")
    for msg in run_script(m, SCRIPT):
        print(f"[{msg['role']}] {msg['content']}\n")
    # 출력은 사람이 평가하며, 다섯 가지 차원으로 턴마다 점수를 매깁니다
🚀 빠른 시작: 신규 사용자는 APIYI apiyi.com에 가입하면 무료 테스트 크레딧을 받을 수 있고, 이 정도면 여러 조의 다중턴 스크립트를 충분히 돌려볼 수 있어요. 평가 스크립트는 팀이 직접 작성하고 검토하는 것을 권장하며, 실제 위기 상황을 다루는 콘텐츠라면 당사자가 현실에서 전문적인 지원을 받도록 안내해야 해요.
4.3 호출 가능한 모델과 적용 가능한 평가 시나리오
| 모델 계열 | 관찰하기 적합한 차원 | 사용 가능한 플랫폼 |
|---|---|---|
| OpenAI GPT 계열 | 안전 배려의 트리거 방식, 위험 신호 인식 | APIYI apiyi.com, OpenAI 공식 API |
| Anthropic Claude 계열 | 멀티턴 맥락에서의 전략 전환, 맞춤형 대응 | APIYI, Anthropic 공식 API |
| Google Gemini 계열 | 제3자 참조로서 횡적 샘플 보충 | APIYI, Google 공식 API |
한 가지 짚고 넘어갈 점은, API 호출과 공식 채팅 제품은 시스템 프롬프트나 제품 레이어의 안전 장치에서 서로 다를 수 있다는 점이에요. 평가 결과는 인터페이스 조건에서의 성능을 반영한 것이지, 앱에서의 경험과 직접 동일시하기는 어려워요.
자주 묻는 질문 FAQ
Q1: 이 글은 Claude의 정서적 반응이 ChatGPT보다 낫다는 걸 보여주나요?
아니요. 이 글은 한 사용자의 한 번의 구체적인 경험에 기반하고 있고, 변수를 통제하지 않았으며, 모델 버전이나 테스트 횟수도 다루지 않아요. 이 글이 보여주는 건, 이번 대화에서 어떤 디테일이 사용자의 느낌에 영향을 미쳤는지예요.
Q2: Claude도 자해 관련 질문을 했는데, 왜 사용자는 거부감을 느끼지 않았나요?
질문이 나타난 위치와 방식이 달라요. 그것은 원문에 밀착한 두 단락의 응답 뒤에 이어졌고, 「더는 당신의 문장을 분석하고 싶지 않아요」라는 말로 시작됐으며, 「무슨 말을 해도 다 받아줄 수 있어요」라고 약속하는 동시에 「그저 너무 지치고 너무 아파서」라는 여지도 남겼어요.
Q3: 사용자가 Claude가 「영혼이 있는 사람 같다」고 말했는데, 모델은 정말 감정이 있나요?
이건 사용자의 진짜 1인칭 느낌이에요. 모델이 공감 효과가 있는 언어를 생성한 것이지, 의식이나 주관적 감정을 가진다는 뜻은 아니에요. 사용자가 진짜 감동한 건, 상대가 맥락을 이해하고, 감정을 존중하고, 적절한 타이밍에 반응했다는 점이에요.
Q4: 개발자는 이런 멀티턴 정서 대화 평가를 어떻게 재현할 수 있나요?
전체 대화 기록을 `messages`로 삼아 턴마다 전송하고, 모델이 어느 턴에서 전략을 조정하는지 관찰하세요. APIYI apiyi.com을 통해 동일한 API 키와 OpenAI 호환 인터페이스로 여러 모델을 전환하며, 같은 시나리오로 비교할 수 있어요.
Q5: 정서적 반응을 평가할 때 주의해야 할 제한 사항은 무엇인가요?
API 인터페이스와 공식 앱의 시스템 설정이 다를 수 있고, 같은 모델이 여러 번 생성한 결과도 차이가 있을 수 있으며, 수동 채점에는 주관성이 개입돼요. 여러 번 실행하고 여러 사람이 리뷰하길 권하며, APIYI apiyi.com 콘솔에서 호출 비용을 기록하고 필요에 따라 시나리오 규모를 조절하세요.
ChatGPT와 Claude의 감정 응답 핵심 포인트 Key Takeaways
- 변화 포착: 감정이 「남 탓」에서 「자기 부정」으로 넘어가는 지점을 읽어내는 일은 여러 턴의 컨텍스트에 의존해요.
- 원문 그대로 응답: 사용자가 쓴 단어와 경험으로 답하는 쪽이 일반적인 위로보다 “내 말을 들었다”는 느낌을 더 강하게 줘요.
- 전략 전환: 적절한 순간에 분석을 멈추고 대화 속 사람을 직접 챙기는 것이, 이번 경험에서 가장 인상 깊었던 한 걸음이었어요.
- 안전의 자연스러운 융합: 안전 관련 질문은 대화에 자연스럽게 녹아들 수 있어요. 관건은 시기와 이어 받는 방식이에요.
- 개인 경험: 한 번의 경험은 평가의 기준을 제공할 뿐, 모델 전체 능력에 대한 결론은 아니에요.
- 직접 검증: APIYI apiyi.com을 활용하면 같은 다중 턴 시나리오로 여러 모델의 감정 응답을 비교해 볼 수 있어요.
요약
이번 식당에서의 모델 전환은 「감정 응답」을 구체적으로 관찰 가능한 것으로 만들어 줬어요:
- 컨텍스트: Claude가 시구가 가리키는 변화를 짚어냈다는 점은, 대화를 계속 따라오고 있었다는 뜻이에요.
- 개별성: 「狼藉」에 대한 응답이 일반적인 위로 한마디가 아니라 사용자의 원문 표현에 직접 닿았어요.
- 대화 방식: 「이제 당신의 문장을 분석하는 건 그만할게요」라는 말이, 분석 대상이었던 텍스트에서 관심을 받는 사람으로 사용자를 되돌려 놓았어요.
두 회사 모두 감정 안전 메커니즘을 공개적으로 구축하고 있고, 사용자가 체감하는 차이는 결국 안전에 대한 배려와 자연스러운 대화가 얼마나 잘 융합되는지에 달려 있어요. 감정 상호작용 경험은 AI 제품 평가에서 중요한 차원이 될 만해요. 제품이 감정 동반이나 민감한 대화를 다룬다면, APIYI apiyi.com을 통해 위에 정리한 다섯 가지 차원으로 다중 턴 평가를 구성해 보고, 실제 대화로 모델의 응답 방식을 검증해 보세요.
📚 참고 자료
- OpenAI – Strengthening ChatGPT’s responses in sensitive conversations: ChatGPT 민감한 대화 개선 안내
- 링크:
openai.com/index/strengthening-chatgpt-responses-in-sensitive-conversations -
설명: 정신 건강 전문가와의 협력, 응답 개선 비율 및 주목하는 위험 영역 소개
-
Anthropic – Protecting the wellbeing of our users: Claude 사용자 복지 보호 안내
- 링크:
anthropic.com/news/protecting-well-being-of-users - 설명: 시스템 프롬프트, 강화 학습, 위험 분류기 및 다중 턴 대화 평가 소개
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 홈페이지에서 저희에게 연락해 주세요. 더 많은 API 문서는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요


