著者注:DeepSeekがSearch & Fetch APIを公開し、APIYIでもdeepseek-searchおよびdeepseek-fetchの提供を同期して開始しました。本記事では、公式ガイドの重要ポイントを整理し、RAG、Agent、Web検索連動型Q&Aの開発者に与える影響を分析するとともに、APIYIでの料金プランや利用方法について解説します。
DeepSeekの公式ドキュメントに先日「Searchガイド」が追加され、ニュース欄でもアナウンスが掲載されました。Search & Fetch APIが開発者向けに正式公開された形です。これにより、DeepSeekの大規模言語モデルをモデル呼び出しする際、サードパーティの検索サービスを自前で組み合わせることなく、公式機能だけで「Web検索+ページ内容のスクレイピング・取得」を完結できるようになりました。
これは単なる噂ではありません。公式ドキュメントのSearchガイドページやニュースリリースはすでに公開されており、Hacker Newsでも専用のスレッドが立つなど、海外の開発者コミュニティからも大きな注目を集めています。なお、公式機能に関する記述は公開情報に基づいた解説であり、詳細なリクエストパラメータ等は公式ドキュメントをご確認ください。APIYIプラットフォーム側の提供状況や利用料金については、後述の専用セクションで詳しくご紹介します。
この記事のポイント:DeepSeek Search & Fetch APIの基本情報、各機能の役割分担、そしてRAGやAgent、Web検索連動型Q&Aプロダクトへの実際の影響について、3分でわかりやすく把握できます。
APIYIで提供開始:APIYIでは新たにdeepseek-searchとdeepseek-fetchを追加しました。成功リクエスト回数に応じた従量課金制で、トークンは消費しません。プラットフォーム内では1回あたり$0.0009で、大口チャージの20%ボーナス適用時は1,000回あたり$0.75となり、公式サイトと同等の価格でご利用いただけます。
DeepSeek Search & Fetch APIの基本情報まとめ
まずは、現在確認できている情報を表にまとめました。ここでは公式の公開チャネルで確認可能な内容のみを記載しており、未公開の価格やベンチマークデータなどは含めていません。
| 項目 | 詳細 |
|---|---|
| 提供元 | DeepSeek 公式 |
| 情報源 | 公式APIドキュメント(Searchガイドページ)、公式ニュースリリース |
| コア機能 | Search(Web検索)およびFetch(Webページコンテンツの取得)の2つの機能を公開 |
| 対象ユーザー | DeepSeek APIを使用してWeb検索連動型Q&A、RAG、Agentなどを構築する開発者 |
| コミュニティの反応 | Hacker Newsでも専用スレッドが立ち上がり、高い関心が寄せられている |
| 価格とクォータ | 公式の価格・クォータは公式ドキュメントおよびコンソールに準拠。APIYIでの料金は後述の専用セクションを参照 |
DeepSeek Search & Fetch:2つの機能の役割分担
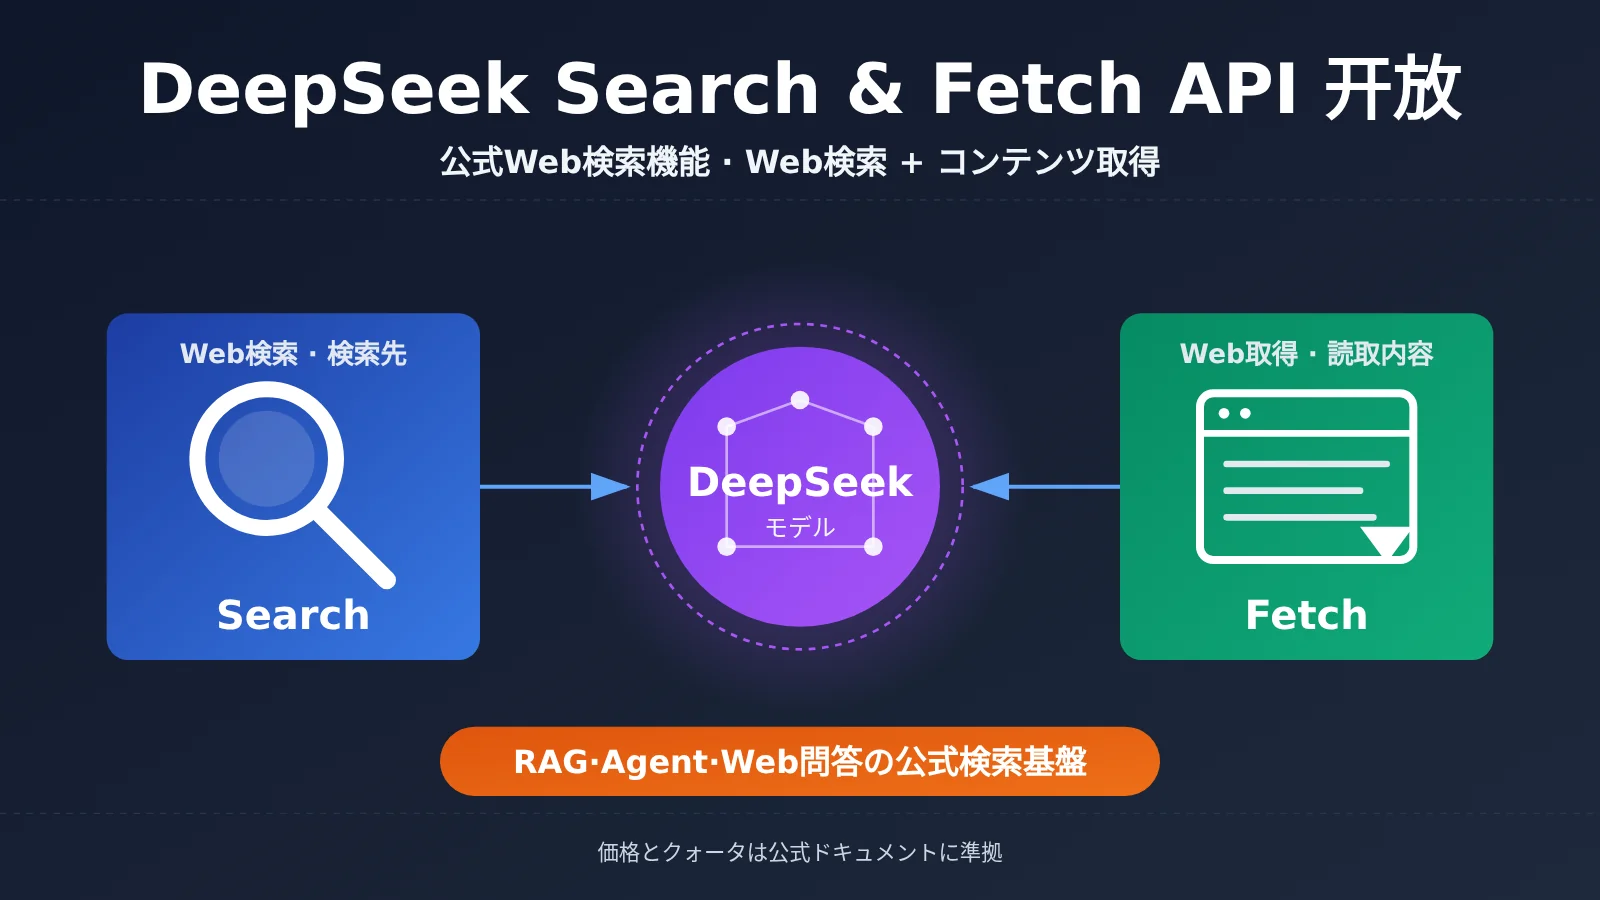
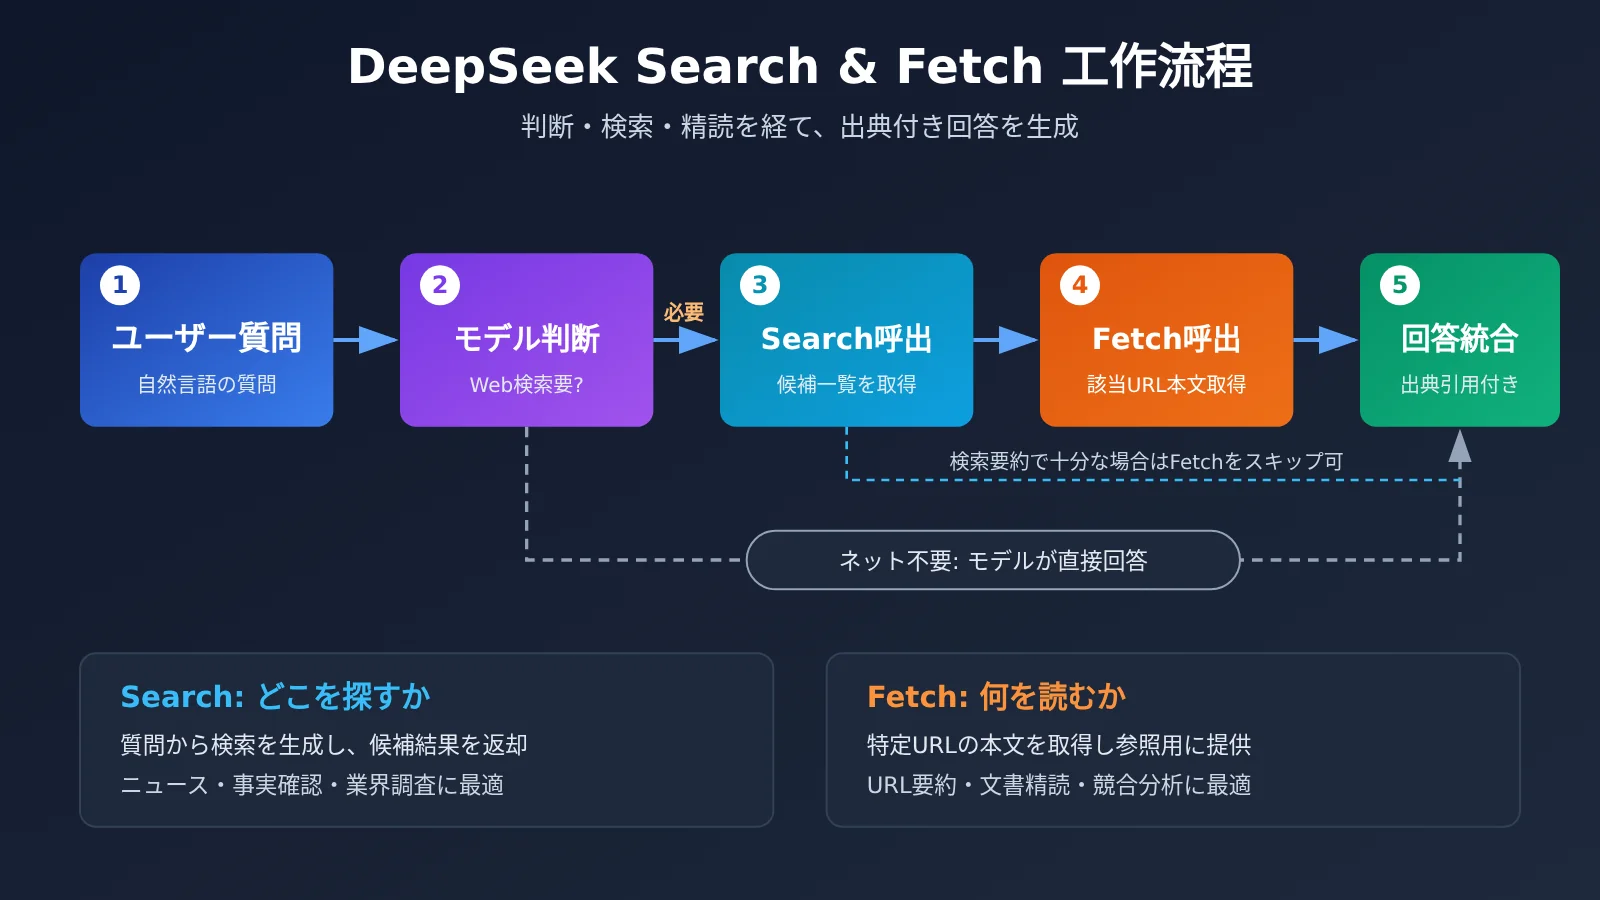
名称からもわかる通り、今回公開されたのは強力な「コンビネーション」機能です。Searchは「どこを探すか」を解決し、モデルがユーザーの質問に基づいて検索クエリを生成して候補となる結果一覧を取得します。一方のFetchは「何を読むか」を解決し、特定のURLからページの本文テキストを取得して、モデルが閲覧・引用できるようにします。
これら2つを分離して設計したメリットは、高いコントロール性にあります。多くのユースケースでは検索スニペット(概要)だけで回答を作成するのに十分であり、すべてのページを個別にスクレイピングする必要はありません。また、ユーザーが特定のURLを直接提示して質問してくるようなケースでは、Searchを行わずにFetchだけを実行すれば済みます。2つの機能に分かれていることで、開発者は必要に応じて組み合わせることができ、精度とコストの最適なバランスを見つけることが可能です。
| 機能 | 解決する課題 | 代表的な入力 | 代表的な出力 | 最適なユースケース |
|---|---|---|---|---|
| Search | どこに情報があるか探す | 自然言語での質問やキーワード | 候補となるWeb検索結果のリスト | ニュースQ&A、ファクトチェック、業界リサーチ |
| Fetch | どのような内容かを具体的に読む | 明確なWebページのURL | ページの本文テキスト | リンクの要約、ドキュメントの読み込み、競合分析 |
| Search + Fetch | 探してから深掘りして読む | 複雑なリサーチ型の質問 | 複数ソースを統合した結論 | Deep Research、Agentによる自動リサーチ |
なぜ DeepSeek Search & Fetch API が注目されているのか
大規模言語モデルの「知識のカットオフ」に対する公式の解決策
どんな大規模言語モデルにもトレーニングデータのカットオフ日があり、モデル自身は「今日何が起きたか」を知りません。これまで開発者が DeepSeek に最新の時事問題へ回答させようとする場合、通常は検索エンジン API を別途連携させ、スクレイパーを書いて本文を取得し、その内容をコンテキストウィンドウに詰め込む必要がありました。これでは処理フロー(パイプライン)が長く、メンテナンスコストも高くなります。
公式が Search & Fetch を提供したことで、このパイプラインを大幅に短縮できるようになりました。自社モデルのツール呼び出しの特性を最もよく理解しているのはモデルベンダー自身です。公式に統合された検索機能は、呼び出し形式や結果の構造化がモデルに最適化されていることが多く、「検索はできたものの、うまく活かせない」といった問題の軽減に大きく貢献します。
「Q&Aモデル」から「Agentインフラ」への進化
もう1つの注目すべきシグナルは、その方向性にあります。検索とWebページの取得(フェッチ)は、Agentにとって最も基本的な2つのツールであり、自動リサーチ、ブラウザAgent、Deep Research系ツールのほぼすべてがこれらに依存しています。DeepSeek がこれら2つの機能を公式 API として提供したことは、モデルを単なる対話インターフェースから、Agentのワークフローを直接支えるインフラへと進化させようとしていることを示しています。
これは開発者にとっても非常に実用的なメリットがあります。すでに多くのチームが DeepSeek を主力モデルとして採用しています。Webアクセス能力(検索機能)も同一のエコシステム内で完結できれば、技術スタックがシンプルになり、トラブルシューティング時のサードパーティ依存を1つ減らすことができます。
DeepSeek Search & Fetch API の連携方法を解説
シンプルな例:まずは DeepSeek の基本呼び出しを動かしてみる
Webアクセス機能を連携する前に、まずは基本的なモデル呼び出しが正常に動作することを確認することをお勧めします。以下のコードは OpenAI 互換インターフェースを使って DeepSeek モデルを呼び出すもので、約10行で実行できます:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統一インターフェースを使用
)

response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": "Web検索が大規模言語モデルにとってどのような意味を持つか、3文で説明してください"}]
)
print(response.choices[0].message.content)
なお、公式 Search & Fetch の具体的なリクエストフィールド、パラメータ、レスポンス構造については、DeepSeek 公式の Search ガイドをご参照ください。以下の完全な実装例では、汎用的な Function Calling パターンを採用し、「モデルが検索すべきタイミングとページを取得すべきタイミングを自律的に判断する」全体的なフローをデモしています。仕組みを理解しやすく、公式パラメータが確定した後でもネイティブ呼び出しへ容易に移行できるよう設計されています。
完全な実装コードを見る:Function Calling で Search + Fetch フローをシミュレート
import json
import openai
import requests

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 互換インターフェース
)

# 2つのツールを定義:検索とページ取得(デモ用。公式のネイティブ機能に置き換え可能)
tools = [
    {
        "type": "function",
        "function": {
            "name": "web_search",
            "description": "キーワードに基づいてWeb検索を行い、候補となるWebページのリストを返します",
            "parameters": {
                "type": "object",
                "properties": {"query": {"type": "string"}},
                "required": ["query"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "fetch_page",
            "description": "指定されたURLのWebページ本文を取得します",
            "parameters": {
                "type": "object",
                "properties": {"url": {"type": "string"}},
                "required": ["url"]
            }
        }
    }
]

def web_search(query: str) -> str:
    # ここに独自の検索ロジックを実装、または公式の Search 機能に置き換えます
    return json.dumps([{"title": "サンプルの検索結果", "url": "https://example.com"}])

def fetch_page(url: str) -> str:
    # 簡易的なスクレイピング実装。本番環境ではエンコーディング、本文抽出、タイムアウト処理が必要です
    try:
        resp = requests.get(url, timeout=10)
        return resp.text[:4000]
    except Exception as e:
        return f"取得失敗: {e}"

TOOL_MAP = {"web_search": web_search, "fetch_page": fetch_page}

def ask(question: str, max_rounds: int = 4) -> str:
    messages = [
        {"role": "system", "content": "最新情報が必要な場合はまず検索し、次に重要なページを取得して、情報源を明記して回答してください。"},
        {"role": "user", "content": question}
    ]
    for _ in range(max_rounds):
        resp = client.chat.completions.create(
            model="deepseek-chat",
            messages=messages,
            tools=tools
        )
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return msg.content
        messages.append(msg)
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = TOOL_MAP[call.function.name](**args)
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result
            })
    return "最大試行回数に達したため、回答を完了できませんでした"

print(ask("DeepSeek Search API に関する最近の議論の要点をまとめてください"))
🚀 クイックスタート:まずは APIYI (apiyi.com) でテスト用クレジットを取得し、DeepSeek の基本呼び出しと Function Calling のフローを通してみることをお勧めします。APIYI ではすでに
deepseek-searchとdeepseek-fetchが利用可能になっており、動作確認後はサンプルのシミュレーションツールをこれら2つのネイティブインターフェースにそのまま置き換えることができます。連携方法の詳細は次節をご覧ください。
APIYIでDeepSeek SearchおよびFetchが提供開始:料金体系と導入方法
APIYI(apiyi.com)にて、これら2つの機能が新たにリリースされました。対応する新しいモデル名は deepseek-search と deepseek-fetch です。これらは対話型モデルではなくツール型APIであり、AgentやRAGがWebから情報を取得するために特化して設計されています。リクエスト時にトークンは消費されず、呼び出し回数に応じた従量課金となります。
| 項目 | deepseek-search | deepseek-fetch |
|---|---|---|
| エンドポイントパス | /v1/tools/search |
/v1/tools/fetch |
| 機能 | Web検索を実行し、候補となるWebページを返却 | 指定したURLのWebページコンテンツを取得(フェッチ) |
| 課金方式 | 成功回数に応じた課金(トークン消費なし) | 成功回数に応じた課金(トークン消費なし) |
| プラットフォーム内価格 | $0.0009 / 回 | $0.0009 / 回 |
| リクエスト失敗時 | 課金なし | 課金なし |
| 利用可能グループ | default、svip | default、svip |
価格面については、少し計算してみる価値のあるポイントがあります。プラットフォーム内の定価は1回あたり $0.0009 ですが、大口チャージの20%ボーナスを適用すると、実質 $0.75 / 1,000回 となり、DeepSeek公式サイトの価格と同等(税込)になります。つまり、APIYI経由で呼び出す場合でも割高なプレミアムを支払う必要がなく、検索、Web取得、対話型モデルを同一のアカウント、同一の請求書でまとめて管理できるメリットがあります。
使い方は公式サイトと共通しており、リクエストURLのルートドメインをAPIYIのドメインに置き換えるだけです。リクエストパラメータやレスポンスの構造は公式ドキュメントに準拠しています。詳細な仕様については、APIYIのドキュメント(docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview)をご確認ください。
導入にあたって、2点ほど注意点があります。第1に、検索および取得API自体はトークンを消費しませんが、取得した本文を対話型モデルに入力する際には、コンテキストウィンドウを消費し、対話型モデル側のトークン料金が発生します。そのため、「ターン数の制限や本文のトリミング」といった対策は引き続き有効です。第2に、失敗時の課金なしによって、ネットワークのタイムアウトや対象ページにアクセスできない場合でも無駄なコストは発生しませんが、システム側でリトライ上限やフォールバック処理を実装しておくことをおすすめします。
🔗 導入窓口:APIYIのコンソールでアカウントのグループが「default」または「svip」であることを確認すれば、すぐにdeepseek-searchおよびdeepseek-fetchを利用できます。更新情報や最新の仕様はドキュメントセンターにて随時更新されています。
DeepSeek Search & Fetch APIと他のWeb連携ソリューションの比較
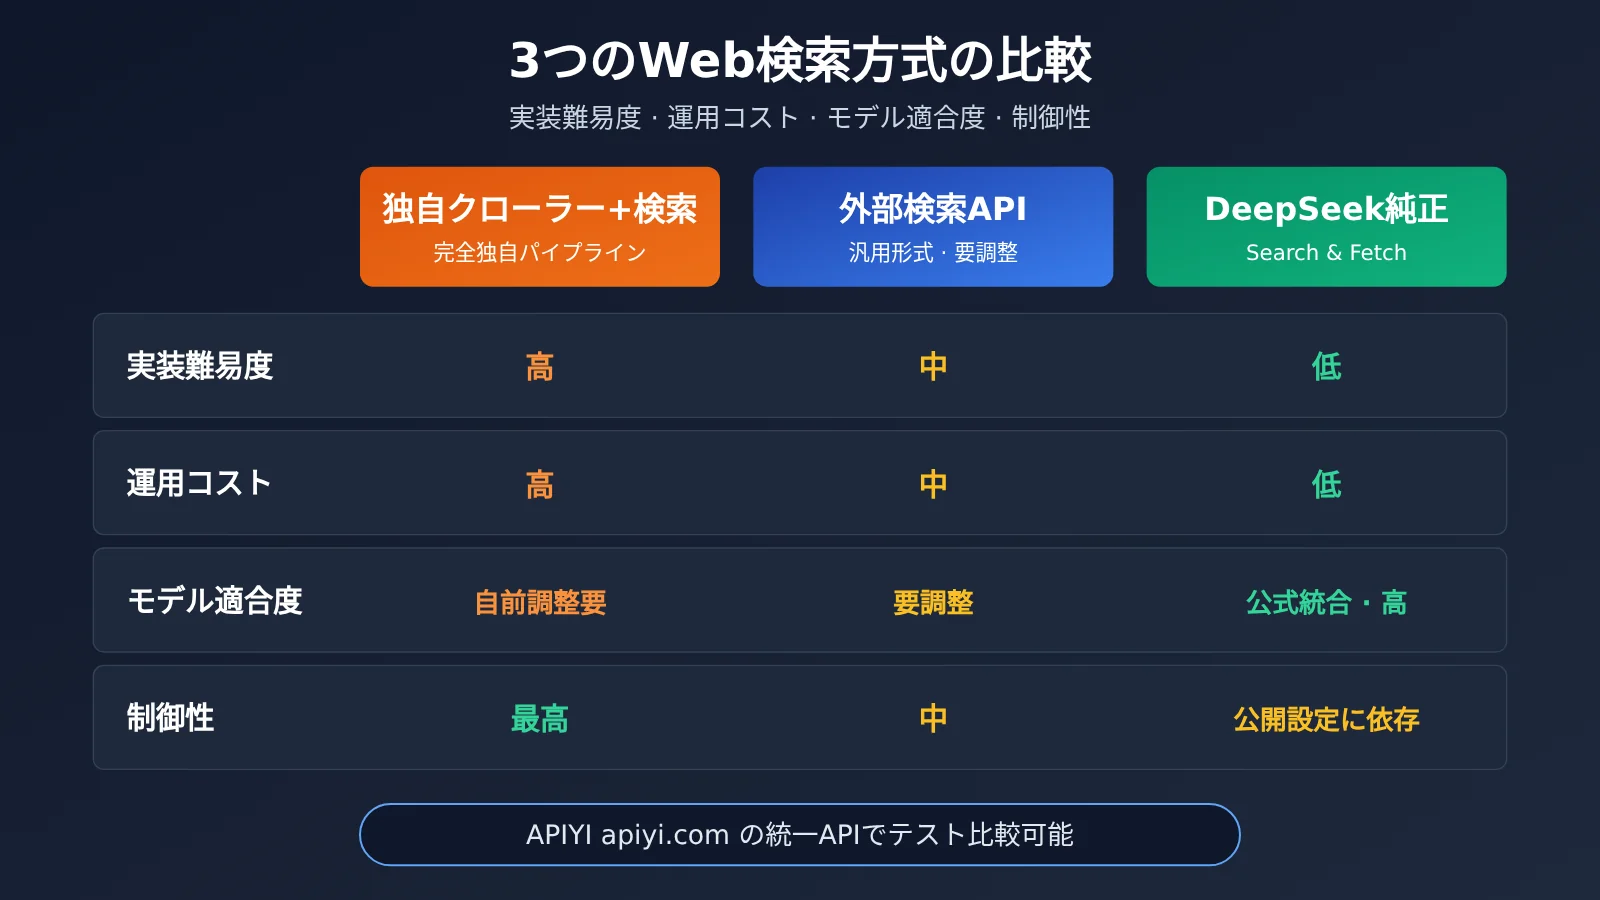
公式機能が登場する前は、開発者には主に2つの選択肢がありました。自前で検索パイプラインを構築するか、サードパーティの検索APIを導入するかです。以下の表では、エンジニアリングの観点から定性的な比較を行っています(具体的な価格については各サービスの公式ドキュメントをご参照ください)。
| ソリューション | 導入難易度 | 運用コスト | モデルとの親和性 | コントロール性 | 利用可能プラットフォーム |
|---|---|---|---|---|---|
| 自前クローラー + 検索 | 高 | 高 | 独自チューニングが必要 | 最も高い | 自社サーバー |
| サードパーティ検索API | 中 | 中 | 汎用フォーマット(アダプター対応が必要) | 中 | 各検索プロバイダー |
| DeepSeekネイティブ Search & Fetch | 低 | 低 | 公式統合済みで親和性が高い | 公式の提供パラメータに依存 | DeepSeek公式API、APIYI(apiyi.com)にて提供中(deepseek-search / deepseek-fetch) |
比較のポイント
自前構築ソリューションの分析:自前でクローラーや検索システムを構築する場合、コントロール性の面で最も優れています。どのサイトを巡回するか、本文をどのようにクリーニングするか、どのようにランキング付けするかを自由に制御できます。しかし、開発および運用コストが最も高く、スクレイピング対策への対応、文字コード処理、本文抽出ロジックの改善など、長期的なメンテナンスが必要です。これに対し、DeepSeekネイティブ機能は、クローラーを運用する手間をかけずに素早くサービスを立ち上げたいチームに最適です。
サードパーティ検索APIの分析:サードパーティの検索サービスは、検索結果のカバレッジや成熟度に優れており、エコシステムも充実しています。ただし、返却されるデータは汎用的なフォーマットであるため、大規模言語モデルに入力するにはデータ変換レイヤーを挟む必要があります。また、プロバイダーが1つ増えることは、請求書の管理や障害発生ポイントが増えることも意味します。DeepSeekをメインモデルとして採用しているユーザーにとっては、ネイティブ機能の方がパイプラインをシンプルに保てるという大きなメリットがあります。
💡 選定のアドバイス:すべてのケースで完璧な選択肢というものはありません。コンプライアンス要件が厳しく、参照元を厳密に指定する必要があるユースケースでは、依然として自前構築が適しています。一方で、開発スピードを最優先する場合は、ネイティブ機能の活用が適しています。まずはAPIYI(apiyi.com)の統一インターフェースを活用して、各種モデルや構成の実効性をテスト・比較した上で、最適な手法を選択することをおすすめします。
DeepSeek Search & Fetch APIが開発者に与える影響
主な4タイプの開発者への直接的な影響
プロジェクトの性質によって、今回のAPI公開がもたらす影響の度合いは異なります。ここでは、よくある4タイプの開発者に整理して見ていきましょう。
| 開発者タイプ | 主な影響 | 推奨されるアクション |
|---|---|---|
| Web検索連動Q&A・検索系プロダクト | 自前の検索パイプラインを置き換えることができ、アーキテクチャを大幅にシンプル化可能 | 少量のトラフィックでカナリアリリースを実施し、回答の品質とレイテンシを比較検証する |
| RAGナレッジベースアプリケーション | プライベートな社内ナレッジに加え、リアルタイムな公開Web情報をシームレスに補完可能 | 内部ナレッジとWebソースを明確に区別し、情報の混同を避ける仕組みを整える |
| AIエージェント開発者 | 公式提供の基礎ツールが手に入り、独自ツールの開発・保守コストを削減可能 | 検索やスクレイピング(Fetch)の呼び出しターン数に上限をあらかじめ設計しておく |
| コンテンツ作成・リサーチツール | URLの要約や競合リサーチなどのワークフローが一段とスムーズに | 出典の明記ルールや著作権コンプライアンス要件をしっかり確認する |
業界の構図への影響
- Webアクセス機能が大規模言語モデルAPIの標準装備に:主要なモデル提供企業が、検索やWebページ取得を公式機能として相次いで取り込んでいます。「モデル+ツール」をワンストップで提供するスタイルが主流になりつつあり、単純な対話インターフェースのみを提供するサービスの競争力は低下していくと考えられます。
- サードパーティ製検索サービスの差別化・分化:汎用的な検索APIにも依然として需要はあるものの、今後は専門的な情報源、特定業界向けバーティカル検索、あるいはエンタープライズ向けの制御可能な検索へとシフトし、モデルのネイティブ機能と相互補完の関係を築いていくことになります。
- エージェントプロダクトの開発ハードルが一段と低下:基礎的なツール群がモデルベンダーから提供されることで、スタートアップや開発チームは「車輪の再発明」にリソースを割くことなく、ワークフローの設計やユーザー体験の磨き込みに集中できるようになります。
DeepSeek Search & Fetch導入時に注意すべきポイント
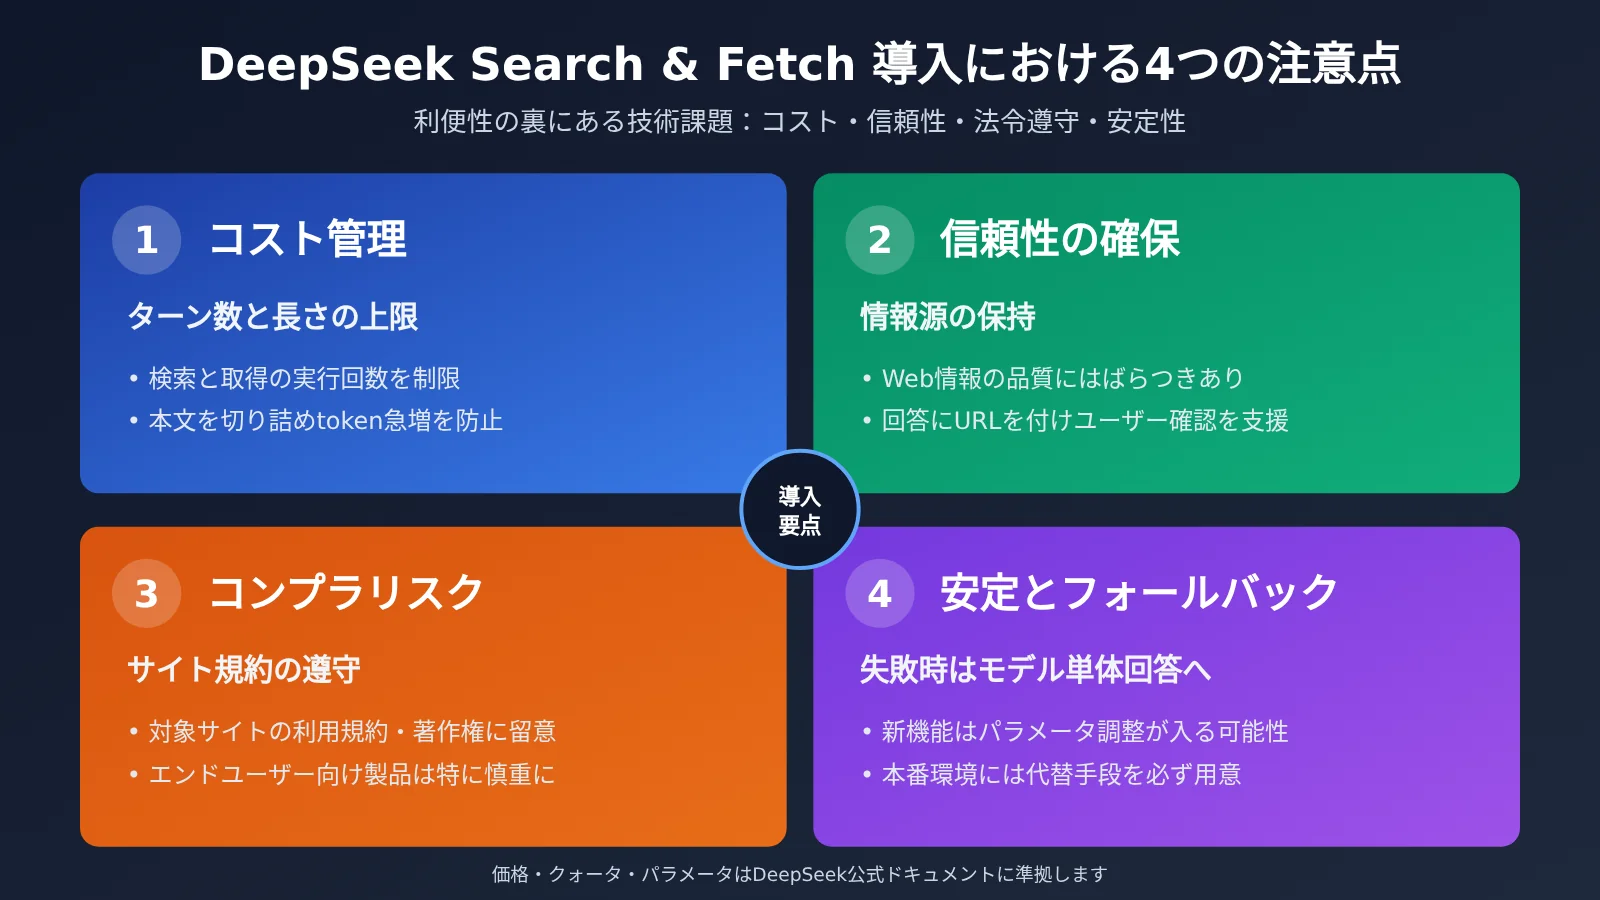
Webアクセス機能は大きな利便性をもたらす一方で、エンジニアリング上の新たな課題も生み出します。
第1にコストコントロールです。検索やWebコンテンツの取得はコンテキスト長を大幅に増加させがちで、結果として対話モデル側のトークン消費量を大きく押し上げます(なお、SearchとFetchのAPI自体はリクエスト回数課金であり、トークンは消費しません)。そのため、呼び出しターン数や取得するテキスト長に上限を設ける設計にしておくことを強く推奨します。
第2に検索結果の信頼性です。公開Web上のコンテンツは玉石混交です。生成された回答の中には必ず情報源(ソースリンク)を残し、ユーザー自身がファクトチェックを行えるように配慮しましょう。
第3にコンプライアンス(規約・著作権)です。Webページの内容を取得する際は、対象サイトの利用規約(ToS)や著作権の取り扱いに十分注意を払う必要があります。特にエンドユーザー向けのサービスでは慎重な運用が求められます。
第4にシステムの安定性とフォールバック設計です。リリースされたばかりの機能は、パラメータの調整や仕様変更が行われる可能性があります。本番環境で運用する場合は、Web検索や取得に失敗した際に通常のモデル単体回答へ自動で切り替わるフォールバック(縮退運転)の仕組みを用意しておくのが安心です。
よくある質問(FAQ)
Q1:DeepSeek Search & Fetch API とは何ですか?
DeepSeek 公式が提供する Web 検索・取得機能の組み合わせです。Search は質問に基づいて Web 検索を行い候補結果をリストアップし、Fetch は指定された Web ページの本文コンテンツを取得(スクレイピング)します。この2つを連携させることで、DeepSeek モデルはリアルタイム性の高い質問に回答し、実際の Web ページコンテンツに基づいた情報源付きの回答を出力できるようになります。
Q2:DeepSeek Search & Fetch と自前で検索 API を連携させる違いは何ですか?
自前で検索 API を連携させる方が柔軟な制御が可能ですが、検索結果のパース処理や本文スクレイピング、複数のプロバイダー管理などを自分で行う必要があります。DeepSeek のネイティブ機能は公式に統合されているため、モデルとの連携がよりスムーズで処理フローも短縮されます。一方で、カスタマイズできる範囲は公式が提供するパラメータに依存します。
Q3:DeepSeek Search & Fetch API はいつから利用できますか?
公式ドキュメントの Search ガイドとニュースアナウンスがすでに公開されており、機能はすでに利用可能です。APIYI でも deepseek-search および deepseek-fetch がすでにリリースされており、default および svip グループで利用できます。サイト内価格は1回あたり $0.0009 で、失敗時は課金されません。公式経由の価格やクォータについては、公式ドキュメントおよびダッシュボードをご確認ください。
Q4:API 経由で DeepSeek の Web 検索関連機能を素早く試すにはどうすればよいですか?
以下の手順で準備することをおすすめします:
1. APIYI(apiyi.com)にアクセスしてアカウントを登録し、APIキーを取得します。
2. 本記事のシンプルなサンプルコード(base_url を `https://api.apiyi.com/v1` に設定)を使って、DeepSeek の基本的なモデル呼び出しを確認します。
3. APIYI のドキュメントを参考に、`/v1/tools/search` および `/v1/tools/fetch`(モデル名:deepseek-search、deepseek-fetch)を呼び出します。
4. 完全なサンプルの Function Calling フローを使い、モックのツールをこれら2つのネイティブ API に置き換えます。
Q5:DeepSeek Search & Fetch にはどのような制限事項がありますか?
現時点で公開されている情報は限られていますが、以下の点を客観的に把握しておく必要があります:検索や取得するコンテンツ量に応じて呼び出しコストが増加すること、公開 Web の情報品質にはばらつきがあるため検証用に情報源を保持しておく必要があること、Web スクレイピングにおけるサイト利用規約や著作権の遵守が必要なこと、新機能のリリース初期はパラメータが調整される可能性があるため、本番環境ではフォールバック(縮退運転)の仕組みを用意しておくべきであることなどが挙げられます。
DeepSeek Search & Fetch API の重要ポイント(Key Takeaways)
- 主要な情報:DeepSeek 公式が Search と Fetch の2つの Web 検索・取得機能を公開。ドキュメントおよびアナウンスはすでにリリース済みです
- 機能の役割分担:Search は「情報を見つける」、Fetch は「Web ページを読み取る」を担当し、ニーズに応じて個別または組み合わせて使用できます
- 最大のメリット:Web 検索の処理フローを短縮し、自前のスクレイピング構築やサードパーティ製ツールの調整にかかる工数を削減できます
- 主な対象者:Web 検索連携 Q&A、RAG、AI エージェント、コンテンツリサーチ系プロダクトの開発者
- APIYI で提供開始:deepseek-search と deepseek-fetch はリクエスト成功数ベースで課金され、トークンは消費しません。サイト内料金は1回あたり $0.0009、失敗時の課金はありません
- 価格の比較:大口チャージの 20% 増量特典を適用すると 1,000回あたり $0.75 となり、公式サイトと同等かつ税込み価格となります
- 導入時の注意点:リクエストパラメータは公式ドキュメントに準拠し、コスト、コンプライアンス、フォールバックの準備に留意してください
- 始め方:default / svip グループですぐに利用可能。公式サンプルのルートドメインを APIYI のドメインに差し替えるだけで利用できます
まとめ
DeepSeek Search & Fetch API の重要ポイントは以下の通りです:
- 公式によるWeb検索機能の補完:SearchとFetchの2つの機能により、DeepSeekモデルがリアルタイムのWeb情報を直接取得できるようになりました。
- AIエージェントのインフラ化:検索とWebページの取得はAIエージェントにとって不可欠な基礎ツールです。公式から直接提供されることで、開発のハードルがさらに下がります。
- 慎重な検証を経てからの導入:コスト、信頼性、コンプライアンス、安定性の4つの観点から十分に対策を立てた上で、既存のパイプラインを段階的に移行していくのが賢明です。
APIYI ではすでに deepseek-search および deepseek-fetch の提供を開始しており、リクエスト成功時のみ課金(失敗時はノーカウント)の安心設計となっています。すでにDeepSeekを導入しているチームにとって、今は新機能を検証する絶好のタイミングです。まずは少量のトラフィックで回答精度やコストを検証し、その上で全面移行するかどうかを判断することをおすすめします。手軽に検証を進めたい方は、ぜひ APIYI(apiyi.com)をお試しください。OpenAI互換の統一インターフェースを提供しているため、DeepSeekと他の主要モデルとの比較や切り替えもスムーズに行えます。
📚 参考資料
- DeepSeek 公式ドキュメント – Searchガイド:Search & Fetch 機能の公式仕様
- リンク:
api-docs.deepseek.com/guides/search/ -
概要:リクエスト方法、パラメータ、レスポンス構造の公式リファレンス
-
DeepSeek 公式アナウンス:機能公開に関する公式リリース
- リンク:
api-docs.deepseek.com/news/news261017/ -
概要:リリースの背景と公式の位置づけの確認
-
Hacker News コミュニティディスカッション:海外開発者によるディスカッションスレッド
- リンク:
news.ycombinator.com/item?id=50138531 - 概要:コミュニティでのフィードバックや注目トピックの参考に
執筆:APIYI 技術チーム
技術ディスカッション:DeepSeekのWebアクセス機能の実装経験など、ぜひコメント欄でお気軽にお聞かせください。詳しい連携ドキュメントは APIYI ドキュメントセンター(docs.apiyi.com)にてご確認いただけます。