筆者注:同じ成果水準における成功タスクコストで、ChatGPT Dotsサブスクリプションと自前構築Agentの支出を、モデル・インフラ・保守・人的レビューに分けて比較します。
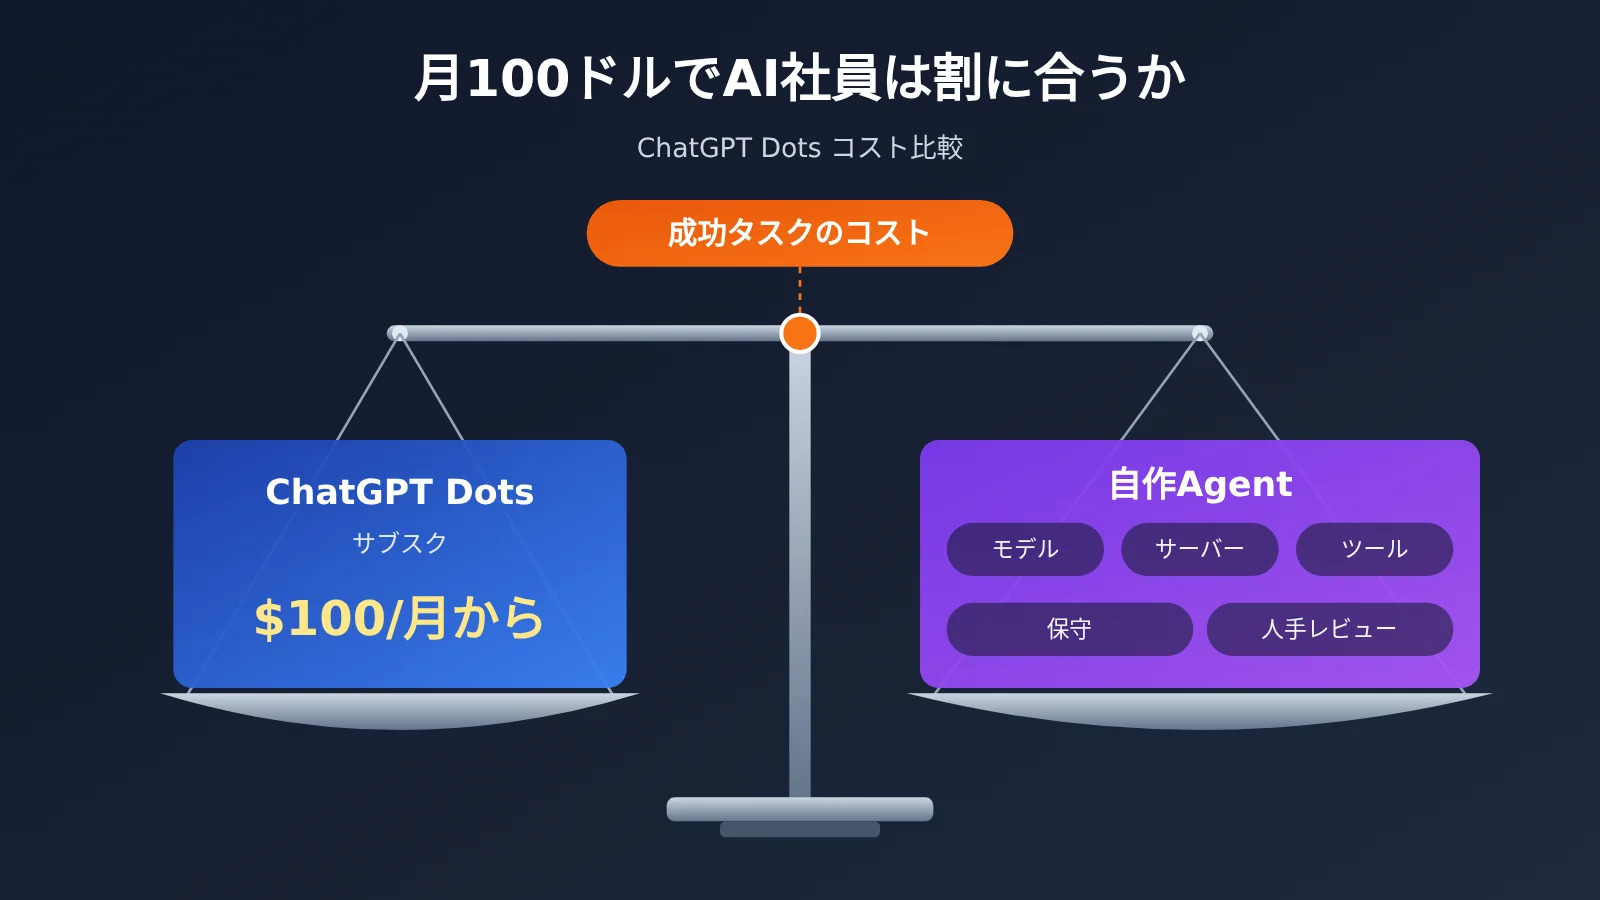
核心結論:月100ドルでAI従業員を1人維持するのが割に合うかどうかは、同じ成果水準の下で、合格タスク1件を完了するまでの総コストで判断すべきです。月額料金やToken単価は、その一部にすぎません。2026年11月16日時点の公式資料によると、個人ユーザーがChatGPT Dotsを利用する際の最低ラインはPro 100(月額100ドル)で、サブスクリプションにはクラウドコンピューター、長期コンテキスト、タスク調整、アプリ連携が含まれています。ある仮定のサンプルでは、自前構築Agentが月300タスクをこなす場合のモデル費用は約33〜66ドルですが、これにはサーバー、ツール、開発・保守、失敗時のリトライ、人的レビューが含まれていません。どちらのルートが安いかは、同じタスク群で実測したうえで判断する必要があります。
本文ではまず、Dotsサブスクリプションの料金体系と機能範囲を分解します。次に、自前構築Agentのコストをモデル、インフラ、ツール、開発、保守の5種類に分類し、APIYIのClaude料金を使って単一タスクあたりのToken費用の計算方法を示します。続いて、Dots、単一モデルAgent、マルチモデルAgentを6つの観点で比較し、「成功タスクコスト」を中心にした比較実験の方法を提案します。最後に、個人ユーザー、ヘビーデベロッパー、企業の3種類のニーズ別に選択肢を提示し、サブスクリプションとAPIの併用によるコスト管理の考え方を紹介します。
To Know:AI社員のコストを理解するための8つの用語
| 用語 | 解説 |
|---|---|
| Pro サブスクリプション | 月額課金の ChatGPT プラン。対応する特典と利用枠が含まれ、Pro 100、Pro 200、Pro 500 のいずれでも Dots を利用できます |
| Dot | ChatGPT Dots 内に常駐するパーソナル Agent。独自のクラウドコンピュータとブラウザを持ち、委任されたタスクを継続的に進められます |
| Token | モデルが入力・出力内容を計量する単位。API は100万 Token あたりで課金されます |
| キャッシュ読み取り | リクエスト内で繰り返し現れるプレフィックス部分(システムプロンプトやツール定義など)について、既存の処理結果を再利用する仕組み。単価は通常の入力よりはるかに低くなります |
| キャッシュ書き込み | 再利用可能なプレフィックスを初回に保存し、以降のリクエストで読み取れるようにするもの。課金ルールはプラットフォームのコンソールに準拠します |
| インフラコスト | Agent を自前で構築するために必要なサーバー、コンテナ、データベース、ストレージ、実行環境の費用 |
| タスク成功率 | 統一された合格基準のもとで、1回または複数回の実行を経て合格として納品されたタスクの割合 |
| 成功タスクコスト | すべての実行(失敗した再試行を含む)、インフラ、人によるレビューの総支出を、合格して納品されたタスク数で割ったもの |
1 月額100ドルの ChatGPT Dots で何が手に入るのか
ChatGPT Dots の個人向け Pro と企業向けの料金体系
ChatGPT Dots は、2026年9月29日に OpenAI から正式リリースされました。その位置づけは常駐型のパーソナル AI Agent です。ユーザーが目標を委託すると、Dot はユーザーが離席したり、コンピューターの電源を切ったりしている間もクラウド上で作業を進め、判断が必要になった時点でその事項をユーザーに戻します。
Dots の料金について述べる際は、個人向け Pro と企業向け Dot を分けて考える必要があります。以下の表は OpenAI の公式ヘルプドキュメントに基づいて整理したもので、参照日は2026年11月16日です。
| 対象 | 料金体系 | 適用条件 | 別途課金される部分 |
|---|---|---|---|
| ChatGPT Pro 100 | 月額 $100 | 18歳以上;欧州経済領域、英国、スイスを除く;段階的に提供 | 委託した Work/Codex タスクは、対応製品の利用枠を消費 |
| ChatGPT Pro 200 | 月額 $200 | 同上 | 同上 |
| ChatGPT Pro 500 | 月額 $500 | 同上 | 同上 |
| Enterprise ワークスペース | 作業タイプ別の固定料金、または利用量に応じた課金。金額はワークスペースの契約または見積もりに準拠 | 2026年11月4日から11月18日までは管理者向けの無料プレビュー期間。11月18日以降に有効化された Dot から課金開始。各メンバーは個人用 Dot を1つ作成可能 | Work または Codex に委託されたタスクは、それぞれの基準で別途課金 |
個人向け Pro の Dots に関する説明には、Dot 単体の月額サブスクリプション料金は記載されていません。Pro の月額料金が利用条件となります。公式説明では同時に、Dot が委託した ChatGPT Work または Codex のタスクは、対応製品の利用枠ルールに従って計算され、消費量はモデル、コンテキスト、推論、ツール呼び出し、検索などの要素によって決まるとされています。したがって、月額 $100 は上限のある利用枠のセットに対応しており、公式資料では個人向け Pro の Dot によるディープワークが何回分のタスクに相当するかも公表されていません。
1.2 Dots サブスクリプションにパッケージされた AI 社員機能
Dots と API 呼び出しを並べて比較すると、「モデル」だけに目が行きがちです。実際には、サブスクリプションには実行環境一式がパッケージされており、自前で構築する場合はこれらをすべて自分で実装する必要があります。
- クラウドコンピュータとブラウザ:各 Dot には専用のクラウドコンピュータがあり、Web サイトを開いたり、文書を整理したり、レポートを作成したりできます。ユーザーはいつでも操作を確認し、引き継ぐことができます。
- 長期的なコンテキスト:ChatGPT Memory、Dot 自身のノート、現在のタスク資料、許可済みアプリのデータを組み合わせます。
- 複数プロジェクトの調整:複雑なタスクを分割し、バックグラウンドのリサーチエージェントを起動して並行処理し、結果を集約し、停滞時にはユーザーの介入を求めます。
- 継続的な作業モード:定期タスクとイベント監視に対応します。たとえば、毎週競合他社をチェックしたり、Slack に出現する新しいバグを監視したりできます。
- 能動的リサーチ:新しいメッセージがないときに、許可済みのデータソースを調査します。このプロセスは読み取り専用で、後続のアクションは通常の承認フローを経る必要があります。
- アプリ連携とコミュニケーションチャネル:公開時の公式説明では、連携可能なプラグインエコシステムは 4,000 以上のアプリを擁し、ChatGPT、Slack、Microsoft Teams などのチャネルから連絡できます。
- 権限とセキュリティの仕組み:Custom Rules で実行の境界を設定し、Auto-review はメール送信などの操作の前にチェックします。パスワード変更や資金移動などの操作は、必ずユーザーが引き継ぐ必要があります。
サードパーティによる実測結果は、能力の境界を判断する参考になります。Axios が 2026 年 10 月 20 日に行ったテストでは、Dots が 38 ページの WNBA 記念プログラム冊子を作成し、47 秒で 12 ページの写真記念アルバムを生成しました。しかし、プログラム冊子には疑問の余地がある統計データが含まれており、買い物のパートもユーザーが Target アプリに移動して自分で完了する必要がありました。筆者の結論は、この種のエージェントは調査や準備作業を担うのに向いているものの、結果には依然として人による編集とファクトチェックが必要だというものです。この結論は、後述するコストモデルに人によるレビューを必ず組み込むべきだという点を直接導きます。
2 自前構築する AI 社員エージェントの全コスト
2.1 自前構築エージェントの5種類のコスト
API で継続的に稼働できるエージェントを構築すると、請求額はモデル呼び出しだけでは収まりません。コストは次の5つに分類できます。
- モデルコスト:入力、出力、キャッシュの読み書き、推論消費。タスク量に応じて線形に変化します。
- インフラコスト:クラウドサーバー、コンテナ、データベース、ストレージ。一部は固定の月額料金、一部は負荷に応じて変動します。
- ツールコスト:検索 API、ヘッドレスブラウザ、サードパーティのデータインターフェース。通常は呼び出し回数に応じた課金です。
- 開発コスト:初回開発、システム統合、権限設計。初期に集中して発生します。
- 保守コスト:監視アラート、障害調査、モデルアップグレード後の回帰テスト。継続的に発生します。
式にまとめると:
$$C_{self}=C_{API}+C_{infra}+C_{tools}+C_{dev}+C_{maintenance}$$
サブスクリプション方式のコスト構造は:
$$C_{subscription}=C_{plan}+C_{extra\ usage}+C_{human\ review}$$
どちらの方式でも人による作業時間を計上する必要があります。自前構築方式の人による作業時間は、開発、保守、レビューに分布します。サブスクリプション方式の人による作業時間は、主にタスクの委任、結果確認、承認に分布します。
2.2 自前構築する AI 社員エージェントの設計案
以下はコスト試算用の設計案です。自前構築エージェントにどのようなコンポーネントが必要かを示すためのもので、各コンポーネントの費用は、実際に利用するクラウドサービスの見積もりに置き換えてください。本記事ではこの設計案のデプロイ検証は行っていません。
- スケジューリング層:定期トリガーまたはメッセージキュー。「毎朝8時に情報を生成する」といった定期タスクを担当します。
- オーケストレーション層:エージェントフレームワークがステップの計画、ツール呼び出し、中間状態の保存(LangGraph の Checkpointer や OpenAI Agents SDK のワークフローなど)を担当します。
- モデル層:OpenAI 互換インターフェース経由でモデルを呼び出し、タスクの難易度に応じて異なるモデルへルーティングします。
- ツール層:検索、Web スクレイピング、ヘッドレスブラウザ、ファイル生成。
- 状態層:データベースにタスク記録、長期ノート、重複排除情報を保存します。
- 承認層:外部送信、支払い、削除を伴う操作は人による承認キューに入ります。
- 観測層:各呼び出しの Token、所要時間、失敗理由を記録し、コスト計算のデータソースとします。
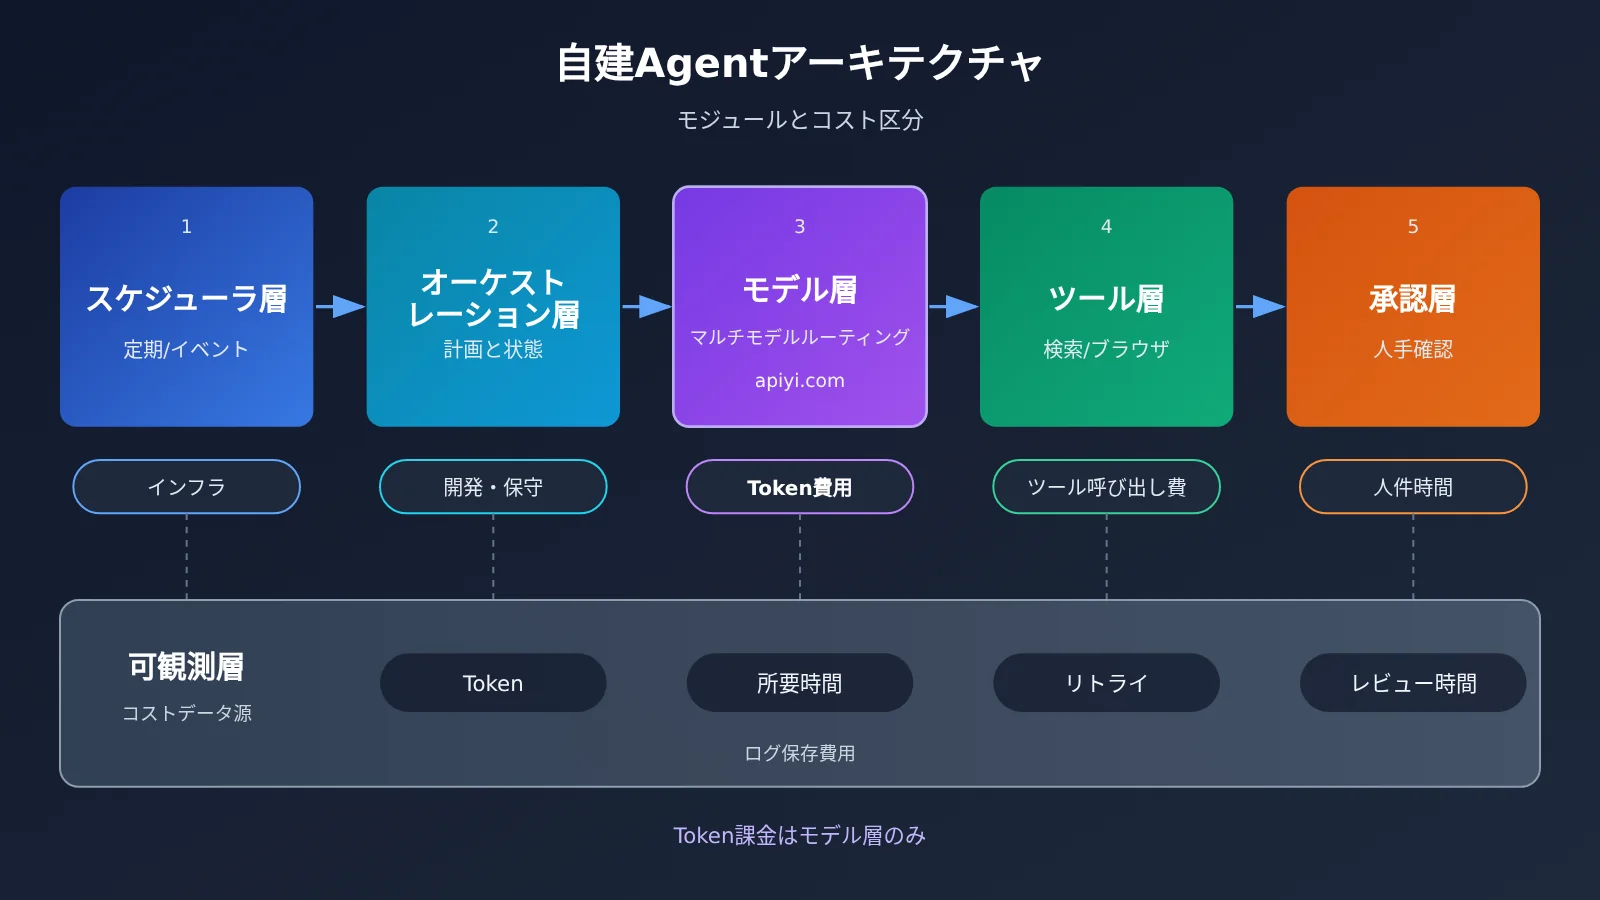
この図に対応する7つのコンポーネントのうち、費用を Token 価格から直接計算できるのはモデル層だけです。その他のコンポーネントの費用は、アーキテクチャの選択とチームの能力に依存します。これが、Token 費用が自前構築コストの一部しか表さない理由です。
3 AI従業員の1タスクで消費するToken量
3.1 入力・出力・キャッシュの課金差
Agentの1タスクは通常、複数回のモデル呼び出しを含みます。計画を1回、各ツール呼び出しの後に推論を1回、最後にまとめを1回といった流れです。各ラウンドでは、システムプロンプト・ツール定義・過去のステップが改めて入力として送信されるため、Agentの入力Tokenは出力Tokenよりはるかに多くなるのが一般的です。
ここでキャッシュが生きてきます。システムプロンプトとツール定義は複数回の呼び出しを通じて変わらないため、キャッシュにヒットするとキャッシュ読み取り価格で課金され、単価は通常入力の約20分の1になります。キャッシュ書き込みは初回にプレフィックスを保存する時点で発生し、その価格はプラットフォームのコンソールに従います。本記事の例ではこれを含めていません。
3.2 APIYIの価格で単一タスクのモデル費用を計算する
以下の価格は、APIYIが2026年11月13日に公開したClaudeモデルの価格に基づいています。実際の料金は、呼び出し時のコンソールおよびモデル一覧を基準とします。タスク使用量は、アルゴリズムをデモするための仮定のサンプルです。各タスクの入力は30,000トークン、出力は5,000トークンで、月間300タスクとしています。このサンプルは、Dotsやその他のプラットフォームにおける実際の平均使用量とは関係ありません。
| 計算項目 | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| 入力価格 / 出力価格 / キャッシュ読み取り価格(100万トークンあたり) | $4 / $20 / $0.20 | $2 / $10 / $0.10 |
| 単一タスクの費用(キャッシュなし) | 30,000×$4/10⁶ + 5,000×$20/10⁶ = $0.22 | 30,000×$2/10⁶ + 5,000×$10/10⁶ = $0.11 |
| 300タスクの月額費用(キャッシュなし) | $66 | $33 |
| 単一タスクの費用(20,000入力トークンがキャッシュ読み取りにヒットすると仮定) | $0.04 + $0.004 + $0.10 = $0.144 | $0.02 + $0.002 + $0.05 = $0.072 |
| 300タスクの月額費用(キャッシュ読み取りの仮定を含む) | $43.2 | $21.6 |
| 利用可能なプラットフォーム | APIYI、公式API | APIYI、公式API |
この仮定では、モデル利用そのものの費用はPro 100の月額$100を下回ります。ただしこの結果はモデル層の費用が安いことを示すだけであり、インフラストラクチャ、ツール、開発・保守、人によるレビューは含まれていません。失敗時の再実行も考慮していません。
3.3 コードで AI 従業員タスクの実際の Token 使用量を記録する
コスト試算では、仮の値ではなく実際の使用量に置き換える必要があります。次の最小限のサンプルは、モデルを1回呼び出して、返された usage フィールドを読み取ります:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="claude-sonnet-5.5",  # APIYI のモデル一覧にある実際の名称に準拠
    messages=[{"role": "user", "content": "汇总今天的 AI 行业新闻要点"}]
)
print(resp.usage)  # 入力・出力 Token 数。コスト計算に使用
完全な実装を見る:毎回の実行を記録し、成功タスクのコストを算出する
import time
import openai
from dataclasses import dataclass, field

# 100万 Token あたりの価格(米ドル)。呼び出し時点のコンソール表示に準拠
PRICES = {
    "claude-opus-5.5":   {"input": 4.0, "output": 20.0, "cache_read": 0.20},
    "claude-sonnet-5.5": {"input": 2.0, "output": 10.0, "cache_read": 0.10},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class RunRecord:
    task_id: str
    model: str
    input_tokens: int
    output_tokens: int
    cached_tokens: int
    seconds: float
    cost: float
    passed: bool = False          # 統一した受け入れ基準による人手判定
    review_minutes: float = 0.0   # 人手による確認・修正の時間

@dataclass
class Ledger:
    runs: list = field(default_factory=list)

    def call(self, task_id: str, model: str, messages: list) -> str:
        start = time.time()
        resp = client.chat.completions.create(model=model, messages=messages)
        usage = resp.usage
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        p = PRICES[model]
        uncached_input = usage.prompt_tokens - cached
        cost = (uncached_input * p["input"]
                + cached * p["cache_read"]
                + usage.completion_tokens * p["output"]) / 1_000_000
        self.runs.append(RunRecord(task_id, model, usage.prompt_tokens,
                                   usage.completion_tokens, cached,
                                   time.time() - start, cost))
        return resp.choices[0].message.content

    def cost_per_success(self, hourly_rate: float, fixed_cost: float = 0.0) -> float:
        """(全実行コスト + 固定コスト + レビュー人件費) / 合格タスク数"""
        api = sum(r.cost for r in self.runs)
        review = sum(r.review_minutes for r in self.runs) / 60 * hourly_rate
        passed_tasks = {r.task_id for r in self.runs if r.passed}
        if not passed_tasks:
            return float("inf")
        return (api + fixed_cost + review) / len(passed_tasks)

ledger = Ledger()
text = ledger.call("news-1116", "claude-sonnet-5.5",
                   [{"role": "user", "content": "汇总今天的 AI 行业新闻要点"}])
ledger.runs[-1].passed = True
ledger.runs[-1].review_minutes = 8
print(ledger.cost_per_success(hourly_rate=30, fixed_cost=0))
🚀 すぐに始めるためのヒント:コスト比較の実験を行うときは、まず APIYI apiyi.com で同じ APIキーを使って Opus と Sonnet をそれぞれ呼び出し、上記の Ledger をお使いの Agent に組み込んで、1週間分の実際のタスクを走らせてから台帳を確認してみましょう。プラットフォームは従量課金制で、新規ユーザーには無料のテスト枠があります。開発に着手する前に実際の Token データを取得するのに向いています。
4 AI社員のコストがモデルによって差が広がる理由
第3節の仮定サンプルでは、Opus 5.5の1タスクあたりのモデル費用はSonnet 5.5の2倍です。この列だけを見れば、Sonnetは月額$33を節約できます。ただし、エージェントタスクの最終コストは成功率と人手によるレビューの影響も受けます。以下では仮定のパラメータを使って、この影響を説明します。
Opusの1回の実行で合格率が90%、Sonnetが60%と仮定し、不合格のタスクは合格するまで再実行するとします。期待値で計算すると、合格タスク1件あたりのモデル費用はそれぞれ約 $0.22÷0.9 ≈ $0.24 と $0.11÷0.6 ≈ $0.18 になります。成功率の差で、単価の優位性はすでに大半が失われています。
人手をかける時間の影響はさらに大きくなります。レビュー担当者の時給を$30、1分あたりの人件費を約$0.5と仮定します。Sonnetの出力が1タスクあたり平均1分の修正を必要とするだけで、増加する$0.5は両モデルの単価差全体を上回ります。データを1件ずつ照合する必要がある情報収集やレポート作成のようなタスクでは、レビュー時間が数分単位になることが多く、こうした場合はより安定したモデルを選ぶほうがかえって総コストを下げられます。
逆に、形式が固定され、自動検証しやすい単純なタスク(分類、要約、フィールド抽出など)では、低価格モデルの成功率が高価格モデルに近い可能性があり、こうしたタスクにはSonnetやより安価なモデルのほうが合理的です。この両方向の判断は、実際のタスクで成功率を測定したうえでなければ実運用に落とし込めません。
5 Dots、単一モデルAgent、マルチモデルAgentによるAI従業員の6次元比較
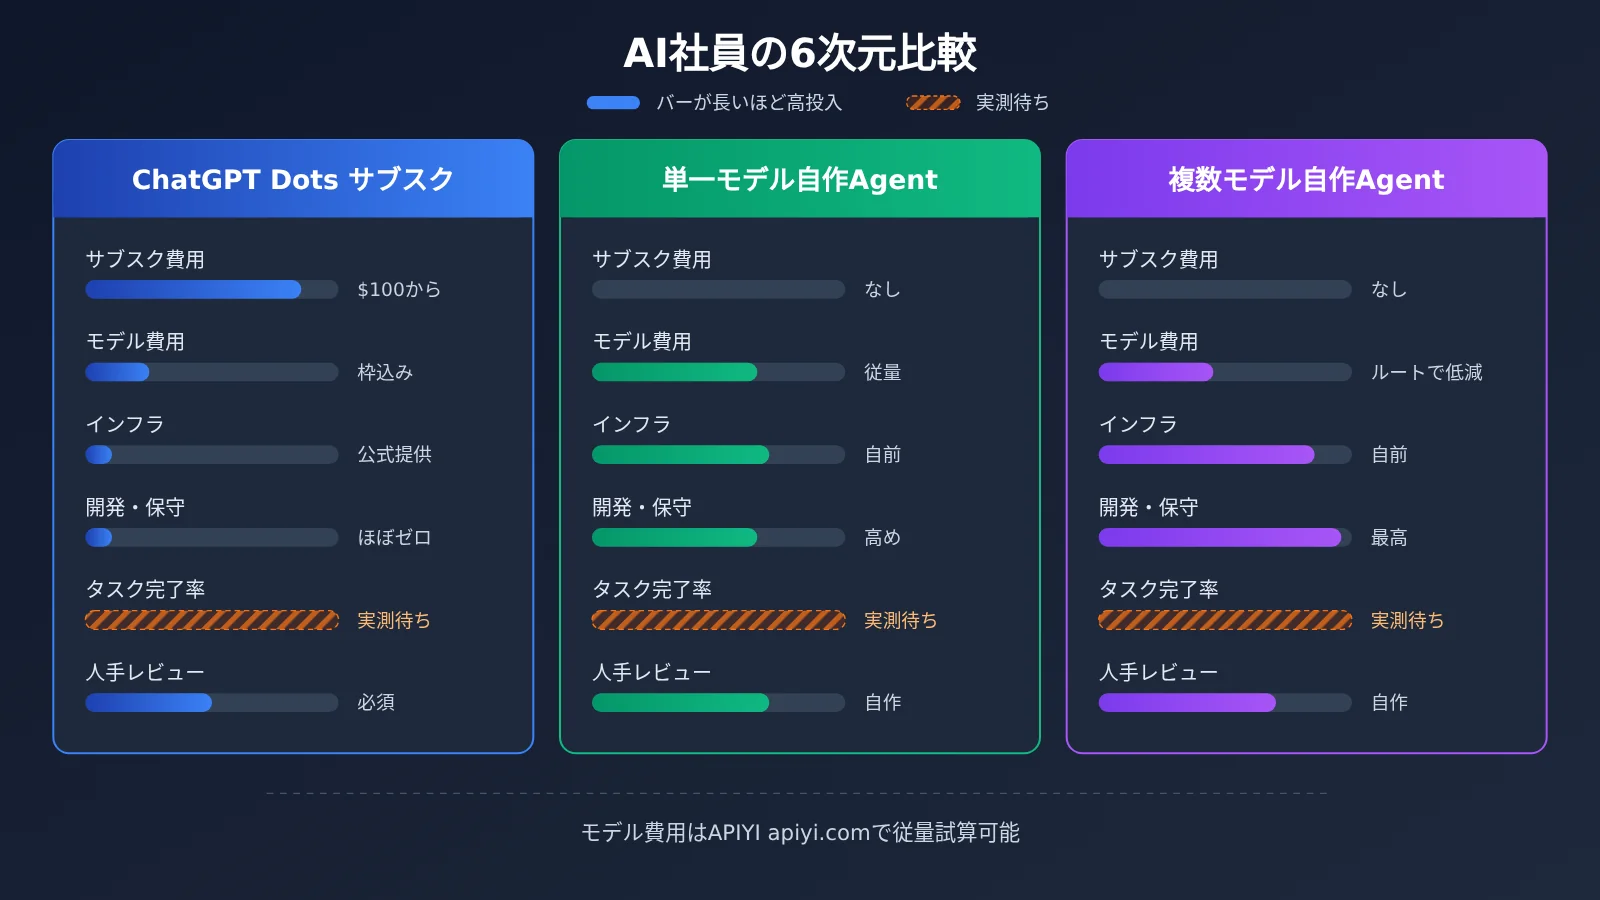
| 次元 | ChatGPT Dots | 単一モデルAgent(自建) | マルチモデルAgent(自建) |
|---|---|---|---|
| サブスクリプション費用 | 個人Proは月額$100から、企業は契約ベース | なし | なし |
| モデル費用 | サブスクの枠内に含まれる。Work/Codexへの委任は別枠 | Token課金で、タスク量に応じて線形に増加 | Token課金で、難易度に応じたルーティングにより平均単価を抑えられる |
| インフラストラクチャ | 公式がクラウドコンピュータとブラウザを提供 | サーバー、データベース、ブラウザ環境を自前で用意 | 単一モデルと同じだが、さらにルーティングと評価ロジックが必要 |
| 開発・保守 | 開発はほぼゼロで、主にルールと権限の設定 | 初期開発の投資が大きく、継続的な保守が必要 | 開発・保守の複雑さが最も高い |
| タスク完了率 | 自身のタスクで実測が必要。第三者の実測では依然として人手による確認が必要とされる | モデルと実装品質に依存し、実測が必要 | ルーティング戦略に依存し、実測が必要 |
| 人手によるレビュー | 必須。Auto-reviewと承認メカニズムが補助 | 必須。承認フローは自前で構築が必要 | 必須。承認フローは自前で構築が必要 |
| モデル接続 | OpenAI製品に組み込み済み | APIYIの統一インターフェース経由で可能 | APIYIの1つのKeyで複数社のモデルを呼び出せる |
Dotsのベンチマーク分析:Dotsはすぐに使える点、アプリ間連携、長期的なコンテキストにおいて明らかな優位性を持ち、クラウドコンピュータ、4,000以上のアプリエコシステム、複数チャネルのコミュニケーションはいずれも開発不要です。その限界は、クォータ規則がタスク回数まで不透明であること、実行ロジックを深くカスタマイズできないこと、個人Proが地域と年齢の制限を受けることです。
単一モデルAgentのベンチマーク分析:単一モデルAgentはコスト構造が最も明確で、各呼び出しのTokenと費用を正確に記録でき、実行ロジックを完全に制御できます。その代価として、ブラウザ、スケジューリング、状態、承認を自前で構築する必要があり、タスク完了率はチームのエンジニアリング能力に完全に依存します。
マルチモデルAgentのベンチマーク分析:マルチモデルAgentは、簡単なステップを低価格モデルに、重要な推論を高性能モデルに任せることで、タスク量が多いときに成功タスクのコストを抑える最も大きな可能性を持ちます。評価体系への要求が最も高く、各モデルが各ステップ種別でどれだけ成功率を出しているかを継続的に監視する必要があります。
6 成功タスクコストでAI従業員の採算性を評価する
6.1 成功タスクコストとROIの計算式
統一した評価指標は次のとおりです。
$$C_{successful\ task}=\frac{C_{all\ runs}+C_{infrastructure}+C_{review}}{N_{successfully\ completed\ tasks}}$$
分子にはすべての実行(失敗や再試行を含む)、その期間に按分したインフラ費用、人手によるレビュー費用が含まれます。分母には、合格として納品されたタスクだけを計上します。Dotsの場合、分子の「実行費用」をサブスクリプション月額と追加利用量に置き換えます。
このうえで、投資対効果(ROI)を計算できます。
$$ROI=\frac{V_{time\ saved}-C_{total}}{C_{total}}$$
時間節約分は、人が本来このタスクを完了するのに要する実時間に、妥当な人件費を掛けて算出します。モデルが数十秒で文書を1件生成できることは生成速度を示すだけであり、節約できる人件費からは確認と修正に要する時間を差し引く必要があります。
6.2 3種類のタスクにおけるAI従業員コスト比較実験
代表的な継続タスクを3種類選ぶことを推奨します。毎日のAIニュース情報、毎週の競合モニタリング、毎月の資料分析レポートです。同一の入力資料と同一の納品基準を用い、それぞれChatGPT Dots、APIYI + シングルモデルエージェント、APIYI + マルチモデルエージェントに実行させ、各実行について次の表の項目を記録します。
| 記録項目 | 記録方法 | 用途 |
|---|---|---|
| 開始・完了時刻 | タスクログのタイムスタンプ | 実際の納品サイクルを計算 |
| モデル呼び出し回数 | オーケストレーション層のカウント | ループや過剰な呼び出しを特定 |
| 入力 / 出力 / キャッシュToken | APIが返すusageフィールド | モデル費用とキャッシュ効果を計算 |
| ツール呼び出し回数 | ツール層のカウント | 検索、ブラウザなどの費用を計算 |
| 失敗と再試行 | 失敗原因の分類 | 追加消費を計算 |
| 人手による修正時間 | レビュー担当者の計測 | 実際の人件投入を計算 |
| 最終検収結果 | 事前に定義したチェックリストで合格 / 不合格を判定 | タスク成功率と分母を計算 |
Dots側ではTokenの内訳を取得できません。そのため、サブスクリプション料金、利用枠の消費状況、完了時間、人手による修正時間、検収結果を記録できます。3つのルートはいずれも最終的に「合格タスク1件あたりにいくら費用がかかり、何分の人手を要したか」に換算します。実験期間は、少なくとも1か月のレポートサイクル全体をカバーすることを推奨します。サンプル数が少なすぎると、個々の失敗が結果を大きく歪めます。
7 Dots サブスクリプションを選ぶべき時と、AI 従業員 Agent を自前で構築すべき時
7.1 個人ユーザー:まず Dots サブスクリプションを検討
- 日常タスクの委任:スケジュールの整理、会議の準備、メールの分類、旅行の計画といったアプリをまたぐタスクは、Dots のアプリ連携とクラウドコンピュータですぐに使えます。
- システムを運用したくない:自前構築の Agent は継続的な障害対応やアップグレードが必要で、個人ユーザーにとっては時間コストがサブスクリプション料金を上回ることが一般的です。
- 前提条件:年齢・地域の要件を満たし、Pro の利用枠ルールに同意する必要があります。月間のタスク量がごく少ない場合は、$100 というハードルを実際の利用頻度と照らし合わせて評価してください。
7.2 ヘビーな開発者:自前構築やハイブリッドが向く
- 実行ロジックをカスタマイズしたい:固定フォーマットの情報収集、特定データソースの監視、社内システムとの深い統合など。
- コストを細かく管理したい:ステップごとにモデルを選び、キャッシュを活用し、呼び出し記録ごとにコストを精算する。
- すでに技術力がある:スケジューリング、状態管理、承認フローを自分で構築でき、開発コストを長期的なタスクに分散できます。
7.3 企業チーム:契約見積もりとコンプライアンス要件を確認
- Enterprise ワークスペースをすでに利用している:Dots は管理者が一括設定でき、Business、Enterprise、Edu ワークスペースのデータはデフォルトでモデルトレーニングに使用されません。課金はワークスペースごとの見積もりで計算する必要があります。
- 社内システムやプライベートなプロセスへの接続が必要:自前構築の Agent は、実行環境、データフロー、監査ログの面で制御性が高くなります。
- 大規模な標準化タスク:タスク量が十分に多く、プロセスが十分に安定していれば、マルチモデルの自前構築 Agent は単一タスクのコストをより抑えられる可能性があります。ただし、対照実験で検証することが前提です。
8 AI社員のハイブリッド構成:サブスクリプションとAPI従量課金の組み合わせ
サブスクリプションとAPIは、タスクの特性に応じて役割を分担させ、それぞれが得意な部分を担うことができます。
- 日常的なやり取りや、人間の判断が必要な作業:Dots または既存の ChatGPT サブスクリプションに任せ、長期的なコンテキストと承認の仕組みを活用します。
- 安定していて自動検証できるバッチ処理:APIの従量課金で、低価格モデルに処理させます。
- 難易度の高い推論と重要な結論:より高性能なモデルを呼び出し、単価が高くても手戻りの少なさと引き換えます。
- タスクのピーク時:サブスクリプションの枠がひっ迫したら、外部に出せるタスクを従量課金に切り替えます。
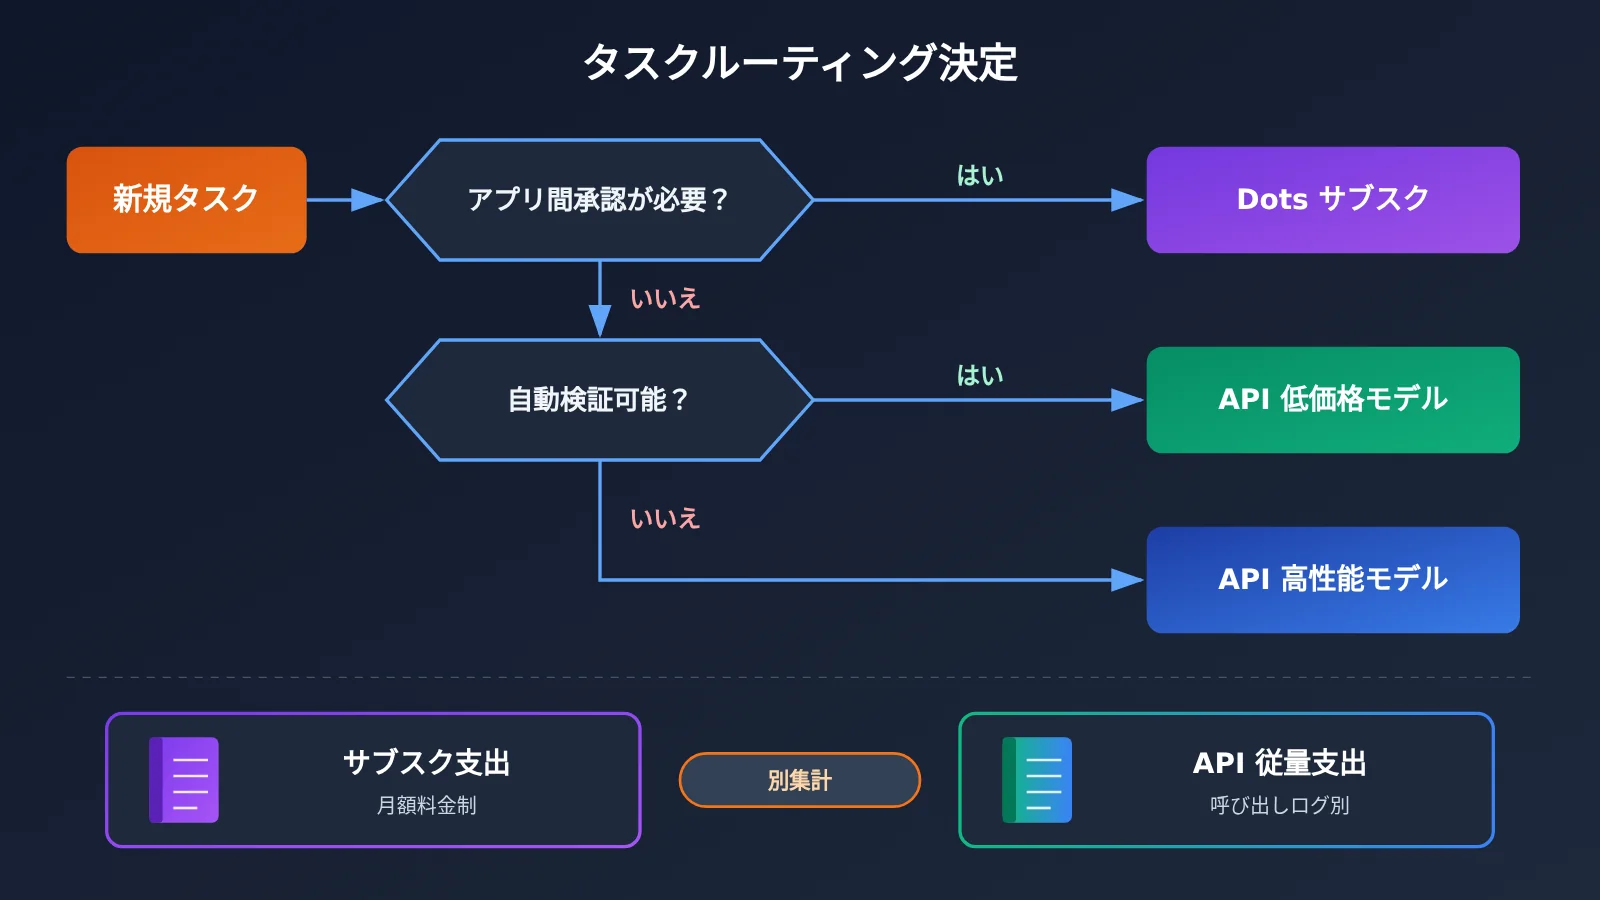
ハイブリッド構成のポイントは、会計を分けることです。サブスクリプションの支出は月額料金として計上し、APIの支出は呼び出しログとして計上します。同じタスクは、実際にそれを実行したルートにだけ計上し、二重計上を避けます。
💡 判断のヒント:まず Dots や既存のサブスクリプションで日々の業務を引き受けつつ、標準化されたタスクを1〜2種類選び出し、APIYI apiyi.com 経由で複数のモデルに接続して比較実験を行います。1か月分の成功タスクのコストデータをもとに、どのタスクをAPIへ移し、どれをサブスクリプションに残すかを決めるほうが、最初から全体を二択にしてしまうより確実です。
よくある質問(FAQ)
Q1:ChatGPT Dots とは何ですか?
ChatGPT Dots は、OpenAI が 2026 年 9 月 29 日に発表した常駐型のパーソナル AI エージェントです。専用のクラウドコンピュータとブラウザを備えており、セッションやアプリをまたいで委任されたタスクを継続的に進め、ユーザーの判断が必要な場面では自発的に処理を差し戻します。
Q2:個人で Dots を使う場合、月額いくらかかりますか?
2026 年 11 月 16 日時点では、個人ユーザーは ChatGPT Pro のサブスクリプションが必要です。Pro 100、Pro 200、Pro 500 の月額はそれぞれ $100、$200、$500 で、3 つのプランすべてで Dots を利用できます。公式に Dot 単体の月額は別途記載されていません。Dot が委任した Work や Codex のタスクは、対応する製品の利用枠で計算されます。
Q3:企業版 Dots の課金体系はどうなっていますか?
条件を満たす企業ワークスペースは、作業タイプごとの固定料率か従量課金を選択できます。具体的な金額は、そのワークスペースに適用される契約や見積もりに基づきます。2026 年 11 月 4 日から 18 日までは無料の管理者プレビュー期間で、11 月 18 日以降に有効化された Dot から課金が始まります。Work や Codex に委任されたタスクは別途課金されます。
Q4:自社構築 Agent のモデル費用が $100 未満なら、Dots より安いのでしょうか?
サーバー、データベース、検索・ブラウザツール、開発・保守、そして人手によるレビューのコストも加えたうえで、失敗による再実行の影響も差し引く必要があります。同一のタスク群・同一の受け入れ基準のもとで成功タスクあたりのコストを比較して初めて、どちらのルートが安いか結論が出ます。
Q5:API を使って自社構築 Agent のモデルコストを手早く試算するには?
次の手順で行えます:
1. APIYI apiyi.com に登録して APIキーを取得し、新規ユーザー向けのテスト枠を受け取ります。
2. 本文のコードにある base_url を `https://api.apiyi.com/v1` に設定し、Ledger を接続して各呼び出しの Token を記録します。
3. 実際のタスクで Opus 5.5 と Sonnet 5.5 をそれぞれ呼び出し、受け入れ結果と人手による修正時間を記録して、成功タスクあたりのコストを算出します。
Q6:キャッシュは Agent のコストにどれほど影響しますか?
Agent のマルチターン呼び出しでは、システムプロンプトとツール定義が繰り返し送信されます。キャッシュにヒットすると、キャッシュ読み取り価格で課金されます。Claude 5.5 シリーズのキャッシュ読み取り価格は、通常入力のおよそ 20 分の 1 です。本文の想定サンプルでは、入力の 3 分の 2 がキャッシュにヒットした場合、タスク 1 件あたりのモデル費用は約 3 分の 1 下がります。キャッシュ書き込みの価格はコンソールでご確認ください。
Q7:Dots は人手を完全に代替できますか?
公式資料も第三者の実測も、Dots の結果には人手による確認が必要だと示しています。Axios のテストでは、Dots が作成した番組冊子に疑わしいデータが現れました。アカウントや資金に関わる操作は依然としてユーザーが引き継ぐ必要があるため、人手レビューのコストは常に総コストに計上すべきです。
Q8:Dots は無制限にタスクを並列処理できますか?
Dots は複数プロジェクトとバックグラウンド Agent の並列実行に対応していますが、実行環境と利用枠には限界があります。ある Reddit ユーザーの自述によると、独立したタスクを起動した際に実行環境が利用できず、ローカルの Linux マシンに接続してから続行できたとのことです。同氏は、各実行パスの利用枠がどのように計算されるかは確認できなかったとも述べています。
AI社員のコストに関する要点(Key Takeaways)
- 比較の基準:同じ納品基準のもとでの「成功したタスク1件あたりのコスト」で測ります。月額料金やトークン単価は、そのうちの一部にすぎません。
- 個人と法人は分けて計算:個人向けの Pro は月額 $100 から。法人向けの Dot は作業タイプまたは利用量に応じた課金で、実際の条件は契約によります。
- サブスクリプションには環境も含まれる:クラウドマシン、長期コンテキスト、アプリ連携、承認の仕組みなどは、自社で構築する場合に補う必要があるコストです。
- モデル費用は一つの層にすぎない:試算サンプルでは月300回のタスクでモデル費用が $33〜$66。ここにはインフラ費用も人件費も含まれていません。
- 成功率が実際のコストを決める:手作業での修正が1分増えるだけで、2つのモデルの単価差をすべて帳消しにし得ます。
- 組み合わせて使うほうが柔軟:日常的なタスクの委任はサブスクリプションで、標準化されたバッチ処理は APIYI 経由で従量課金の呼び出しを行い、コストを個別に記録します。
まとめ
月100ドルをかけて AI社員を1人“育てる”のが割に合うかどうかは、任せるタスクと検収基準によって変わります。
- Dots の価値は「すぐ使える継続的な作業能力」にある:クラウドマシン、アプリをまたいだ連携、長期コンテキストによって開発・保守の手間が省け、個人ユーザーや保守負担を抑えたいチームに向いています。
- 自作 Agent の強みは「制御しやすさ」と「コストを把握しやすさ」:実行ロジックをカスタマイズでき、呼び出しごとに課金と追跡が可能で、安定した技術力があり、タスクの標準化が進んだチームに適しています。
- 最終的な判断は対照実験で:3種類の実タスクでトークン数、リトライ回数、手作業での修正時間を記録し、合格したタスク1件あたりの総コストを比較します。
まずは既存のサブスクリプションを日常業務用に残しつつ、標準化されたタスクを1種類選んで API との比較テストを行うことをおすすめします。APIYI apiyi.com なら、1つの APIキーで複数のモデルに接続でき、従量課金で実際の使用量を記録できます。どのタスクを移行する価値があるかは、データで判断しましょう。
📚 参考資料
-
OpenAI:Introducing dots:Dots の発表告知、製品ポジショニング、クラウドコンピュータとアプリエコシステム
- リンク:
openai.com/index/introducing-dots - 説明: 2026-09-29 に公開された公式の一次資料
- リンク:
-
ChatGPT Learn:Meet dots / Tasks and memory:製品概要、購読資格、長期タスクとメモリの仕組み
- リンク:
learn.chatgpt.com/docs/dots - 説明: バックグラウンド Agent、プロアクティブな調査、スケジュールタスクを理解するための信頼できるドキュメント
- リンク:
-
ChatGPT Learn:Enterprise Dots 管理者ガイド:エンタープライズワークスペースの開通と課金方式
- リンク:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - 説明: 企業向けの固定料金と従量課金に関する現行の説明
- リンク:
-
OpenAI Help Center:About ChatGPT Pro tiers:Pro 100 / 200 / 500 の価格と割り当てルール
- リンク:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - 説明: 個人サブスクリプション価格の公式根拠
- リンク:
-
OpenAI Help Center:Dots privacy, security, and safety FAQs:権限、承認、Auto-review とデータポリシー
- リンク:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - 説明: 人手によるレビューとセキュリティコストを評価する際の必読資料
- リンク:
-
Axios:I tested Dots and Muse:Dots と Meta Muse の第三者による実測
- リンク:
axios.com/2026/10/20/battle-of-bots-openai-meta-ai-agents-test - 説明: 具体的なタスクでの性能と失敗事例
- リンク:
-
APIYI:Token パッケージの枠は単純比較できない:サブスクリプションと従量課金を比較する5ステップの試算方法
- リンク:
help.apiyi.com/token-plan-quota-subscription-vs-pay-as-you-go.html - 説明: タスクあたりの実効コストを計算するフレームワーク
- リンク:
-
APIYI モデル価格表:Claude などのモデルの現行価格
- リンク:
docs.apiyi.com/models - 説明: 実際に呼び出す際は、このページとコンソールの表示を基準にしてください
- リンク:
著者: APIYI 技術チーム
技術交流: APIYI ウェブサイトのトップページからお気軽にお問い合わせください。モデルの接続や課金に関する資料は、docs.apiyi.com のドキュメントセンターもご覧ください