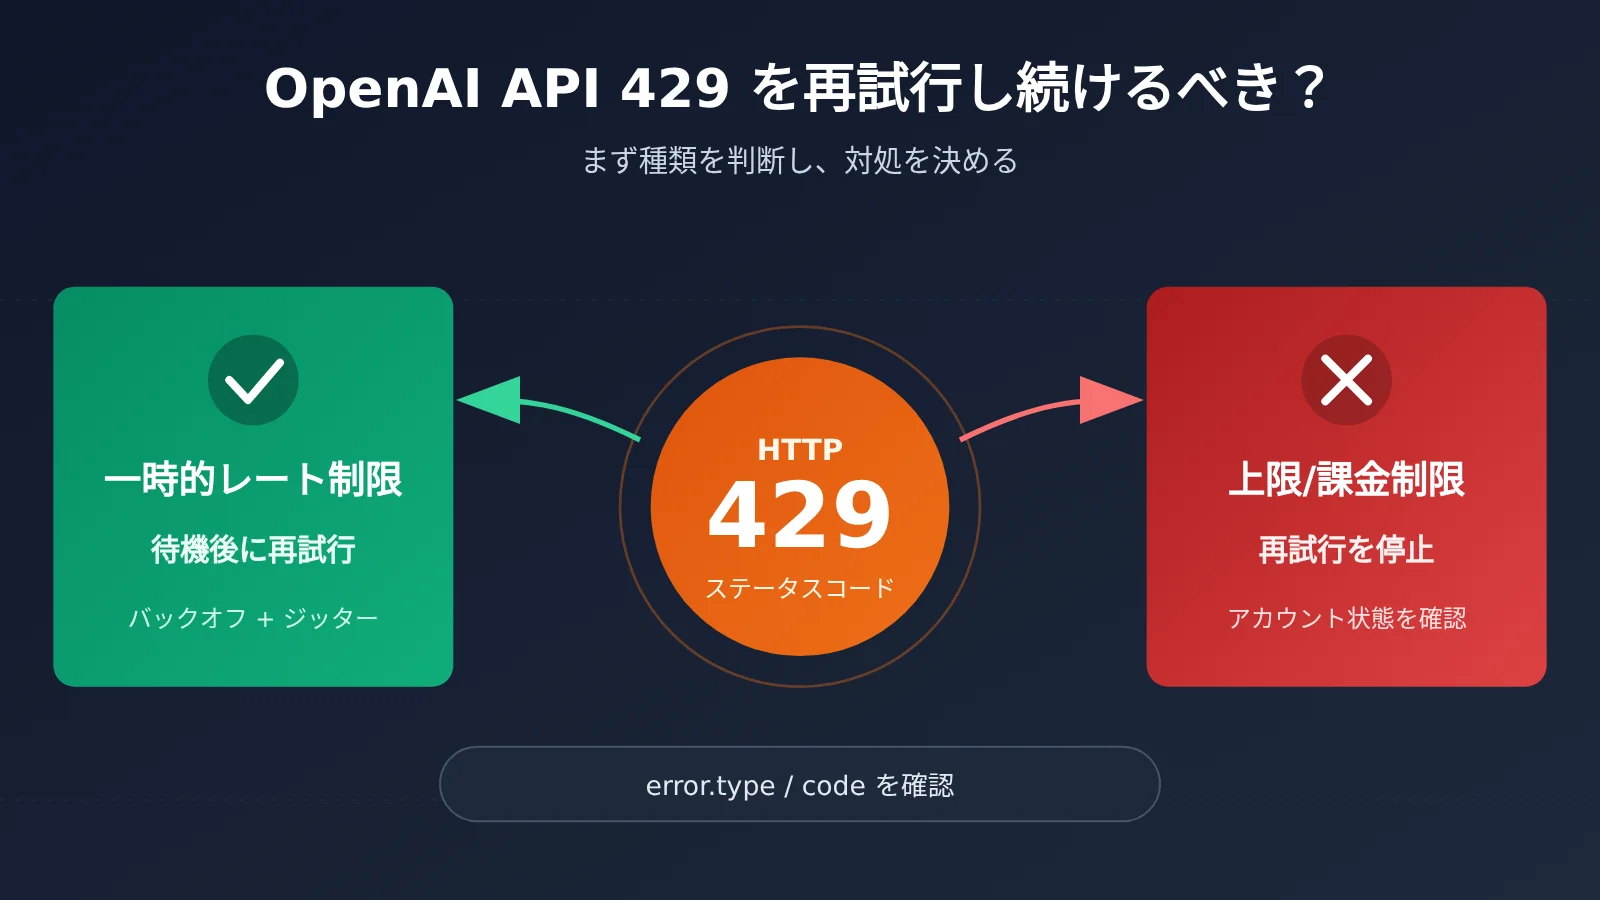
ずっとリトライし続けてはいけません。 OpenAI API が 429 を返すことは、「少し待てば大丈夫」という意味ではありません。待ってからリトライするのが適切なのは、一時的なレート制限だけです。クォータの枯渇、課金の異常、あるいは組織レベルの利用制限は、何度リトライしても回復せず、むしろキューを詰まらせてしまいます。
正しい進め方は、まずエラーメッセージ、error.type、そして取得できる場合は error.code を確認し、どの種類の 429 なのかを判断することです。一時的なレート制限であれば、有効な Retry-After があればそれに従って待ち、なければランダムジッター付きの指数バックオフを使い、試行回数に上限を設けます。
この記事を読み終えると、次のことがわかります。
- OpenAI API の 429 が少なくともどのようないくつかの種類に分かれ、それぞれどう対処すべきか。
Retry-After、指数バックオフ、ランダムジッターの 3 つの関係と、それぞれをいつ使うか。- 公式 SDK の自動リトライ、タスクキュー、人手による「リトライ」ボタンが重なると、なぜ 429 が増幅されるのか。
- リクエスト数がボトルネックの場合とトークンがボトルネックの場合の異なる解決策、そしてストリーミングリクエストの途中でエラーが起きたときの注意点。
索引: 本文の前に、概念表を 1 枚と影響サマリー表を 1 枚用意し、用語を揃えながら、ご自身に関係する部分を見つけられるようにします。「客観的事実」のパートでは、OpenAI 公式ドキュメントにおける 429 の記述を整理します。エラーの分類、リトライのルール、SDK の挙動を含みます。「分析・判断」のパートでは、実装に落とし込む際の話をします。ボトルネックの種類に応じた戦略の調整、キューの状態設計、リトライの重なりの調査、そして他のゲートウェイへ移行するときに注意すべきセマンティクスの違いなどです。
To Know:OpenAI API 429 を理解するために必要な概念
| 概念 | 簡単な説明 |
|---|---|
| HTTP 429 | 「Too Many Requests」ステータスコード。OpenAI API ではレート制限を示すだけでなく、クォータ(利用枠)や使用量の制限を示すのにも使われます |
| レート制限(Rate Limit) | 一定時間内に送信できるリクエスト数の上限。OpenAI はリクエスト数と token 量をそれぞれ別々にカウントします |
| RPM / TPM | 1分あたりのリクエスト数と1分あたりの token 数。どちらか一方が上限に達するだけでも 429 が発生する可能性があります |
error.type / error.code |
エラーレスポンス本文中の構造化フィールド。429 の具体的な原因を区別するのに使われ、ステータスコードだけを見るより信頼できます |
| Retry-After | レスポンスヘッダーのフィールドで、サーバーが「この時間後に再試行するよう」推奨する値を示します。値が有効な場合はこれに従うのが優先です |
| 指数バックオフ(Exponential Backoff) | 失敗するたびに待ち時間を倍数的に増やす方式。例えば 1 秒、2 秒、4 秒…とし、上限を設けます |
| ランダムジッター(Jitter) | バックオフ時間にランダムな要素を加え、多数のクライアントが同じタイミングに一斉リトライするのを避けます |
| ストリーミング出力(Streaming) | モデルが生成しながら内容を返す方式。一度出力が始まると、途中でエラーが起きた場合は単純に全体を再生(リプレイ)できません |
| リトライの重複 | SDK、業務キュー、ユーザーの手動操作がそれぞれリトライし、実際のリクエスト量が何倍にも膨らむ現象 |
影響早見表:OpenAI API 429 は役割ごとに何を意味するか
| 役割 | 主な影響 | 注目すべき点 |
|---|---|---|
| バックエンド開発者 | リトライロジックを誤ると、一時的なレート制限が持続的な障害に拡大する | 429 の種類を区別し、リトライを一つの層で一元管理する |
| バッチ処理・データタスク責任者 | 大量タスクはリクエスト数と token の2つの制限に同時にぶつかりやすい | 送信ペース、コンテキストのサイズ、キュー状態の設計 |
| プロダクト・フロントエンド | ユーザーが何度も「リトライ」を押すと、新たな 429 を生み続ける | 次回の試行時刻を伝えるか、アカウントが原因であることを説明する |
| 運用・アカウント管理者 | クォータ・課金系の 429 はコードでは自己回復できない | アカウント状態を早期に発見・処理し、自動リトライを放置しない |
客観的事実:OpenAI 公式ドキュメントは 429 をどう説明しているか
本セクションは、OpenAI が公開・保守しているエラーコードガイド、レート制限ガイド、ヘルプセンターの 429 トラブルシューティング記事に基づいており、確認日は 2026-11-17 です。これらは継続的に更新される保守ドキュメントであり、本記事では関連内容がいつ最初に公開されたかを確認できません。そのため当日のニュースとして扱わず、現時点で有効なルール説明として扱います。
OpenAI API 429 のさまざまな発生源
公式ドキュメントの核心的な立場は、同じ 429 でも意味が異なる場合があり、エラーメッセージ、error.type、そして利用可能な場合は error.code を組み合わせて判断する必要があるというものです。一時的なレート制限と、クォータ・課金・組織の利用制限とでは、対処方法が異なります。
前者は「現在のウィンドウ内でリクエストが速すぎる、または多すぎる」状態で、しばらくするとウィンドウがリセットされて回復します。後者はアカウント自体の状態に関わるもので、例えばクォータの枯渇、支払いの問題、組織レベルの利用上限などです。こうした問題は時間が経っても自動的には解消されません。
| 429 の種類 | 典型的なシグナル | 待機で解決できるか | 推奨される対応 |
|---|---|---|---|
| リクエスト数制限 | エラーメッセージがリクエスト数上限を示し、よくある code は rate_limit_exceeded |
通常は可能 | Retry-After に従う、またはジッター付き指数バックオフを使用する |
| token 量制限 | エラーメッセージが token 上限を示す | 通常は可能だが、繰り返し発生しやすい | バックオフしつつ、1回のリクエストの token 量を減らす |
| クォータ/課金/組織制限 | エラーメッセージがクォータや請求を示し、よくある code は insufficient_quota |
不可 | 自動リトライを停止し、担当者にアカウント対応を通知する |
強調しておきたいのは、error.code の具体的な値は実際のレスポンス内容と公式ドキュメントに基づくべきだということです。上表の code はあくまでよくある例であり、コード内ではハードコードされた文字列だけに頼って判断しないようにしましょう。同時に、エラーメッセージの原文をログ調査用に保持しておくことも大切です。
リクエスト数とトークン量は別々に制限される可能性がある
レート制限ガイドでは、制限は複数の軸で計測され、その中でもよく遭遇するのがリクエスト数とトークン量であり、両者は独立して適用されると説明しています。つまり、リクエスト数がまだ上限にはほど遠い場合でも、各リクエストが長いコンテキストを伴うことで、先にトークン制限に達することがあります。逆に、多数の非常に小さなリクエストによって、先にリクエスト数を使い果たすこともあります。
OpenAI はレスポンスヘッダーで、レート制限に関する情報(残りのリクエスト数、残りのトークン数、それぞれのリセット時刻など)を提供しています。これらのヘッダーフィールドは、実際に 429 が発生する前に、どちらの上限に近づいているかを判断するのに役立ちます。
OpenAI API 429 の公式推奨リトライ方法
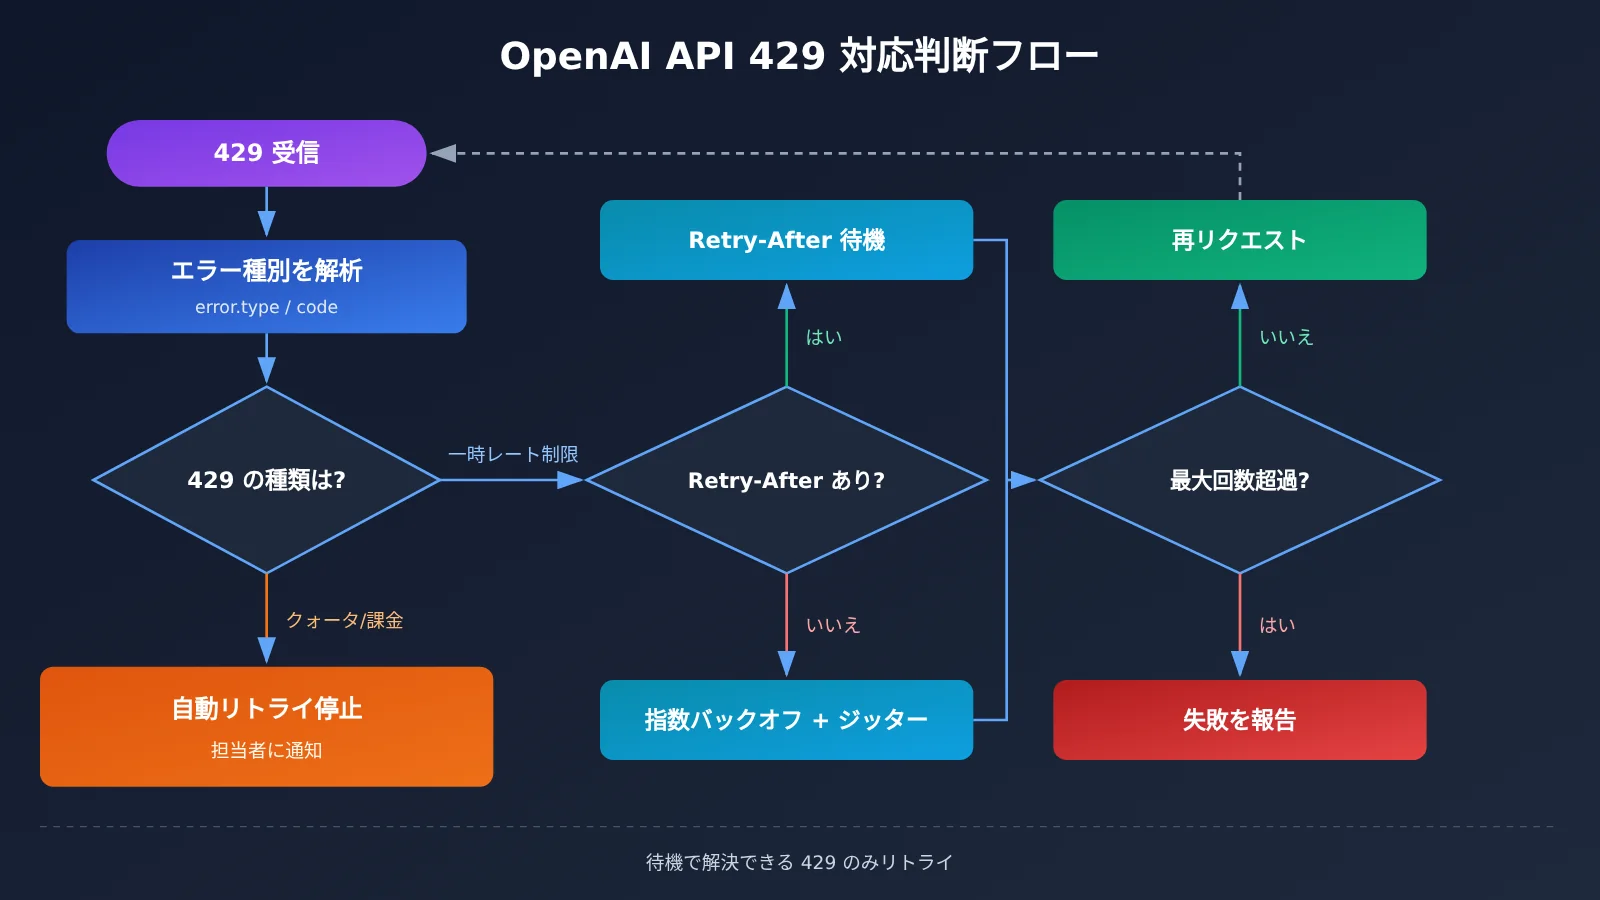
再試行に適した一時的なレート制限については、公式の推奨事項を次の2つにまとめられます。
- 有効な Retry-After が存在する場合は、それに従います。 これはサーバー側が示す最も直接的なシグナルであり、クライアント側が独自に推測するより正確です。
- Retry-After がない場合は、ランダムジッター付きの指数バックオフを使用します。 待機時間は失敗回数に応じて増加し、さらにランダムな量を加えることで、すべてのクライアントが同じタイミングで一斉に再試行するのを避けます。
これら2つのルールの前提は、「今回の 429 が待機によって解決できる種類である」ということです。クォータや課金の問題であれば、どれほど正確なバックオフアルゴリズムも空回りするだけです。
公式SDKの自動リトライ動作
OpenAI公式SDKは、条件を満たすレート制限エラーに対して自動的にリトライします。具体的な動作はクライアントの設定によって変わります。たとえばPython SDKでは、max_retries パラメータで調整でき、0に設定すれば自動リトライを無効にできます。
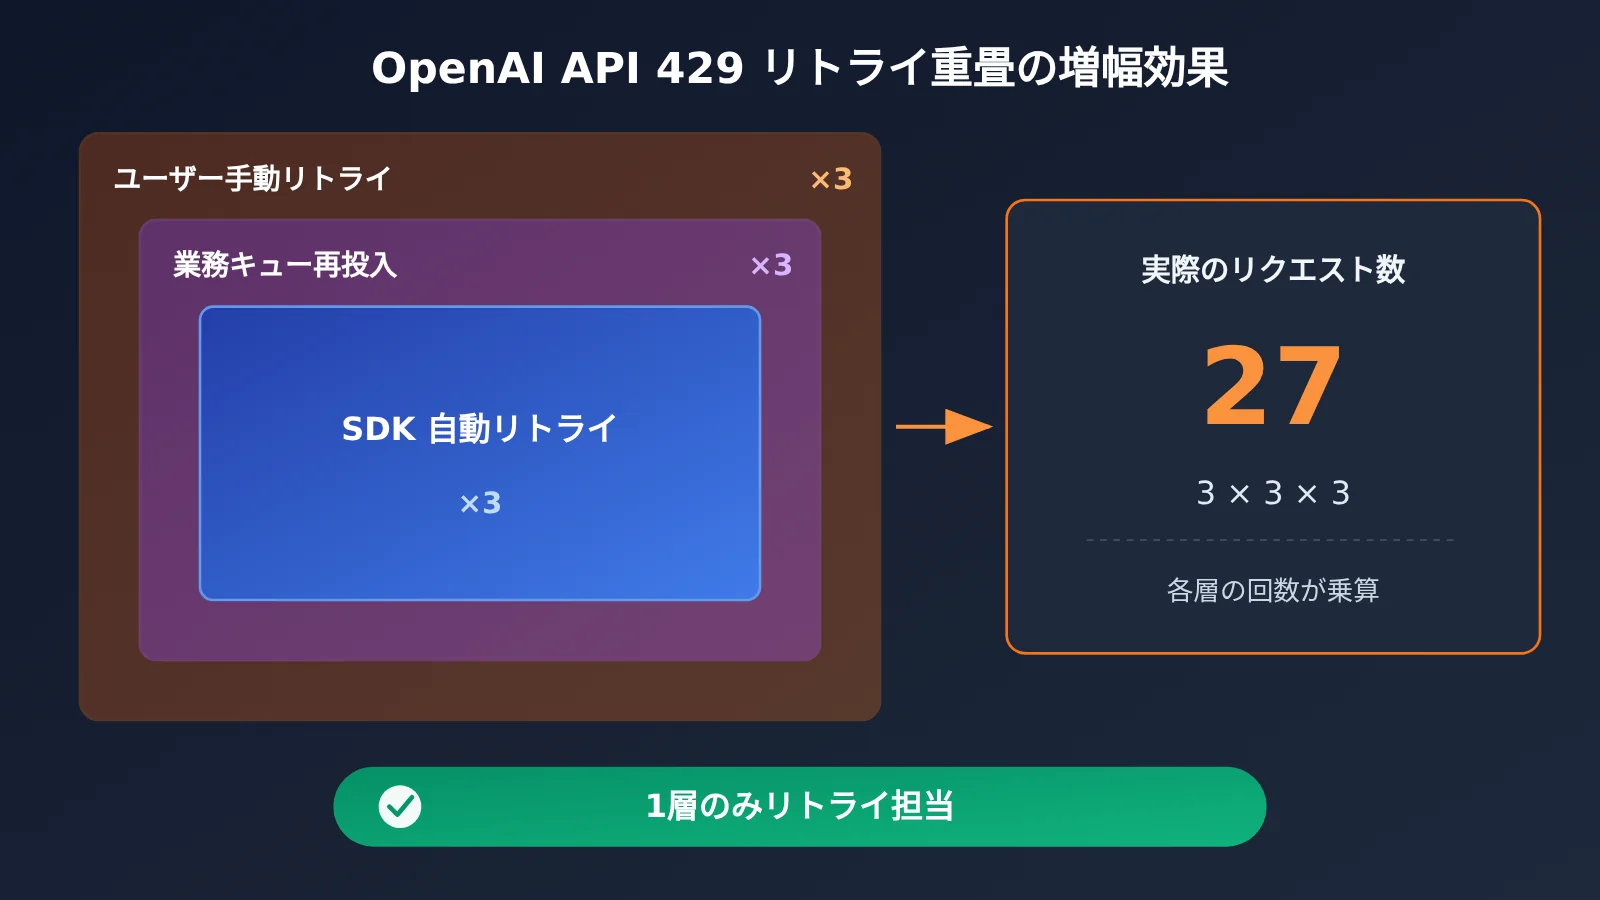
つまり、ビジネスコードにリトライ処理を一行も書いていなくても、リクエストがすでに数回リトライされている可能性があるということです。さらにビジネス層でリトライを一層かぶせると、実際のリクエスト回数は両者の積になります。
ストリーミングリクエストの途中エラーは一律にリプレイできない
公式ドキュメントでは、見落とされがちな境界条件についても言及しています。ストリーミング出力が一度始まってしまった後に発生したエラーは、リクエスト全体をリプレイすることで一律に対処することはできません。 ユーザーがすでに一部の内容を目にしている可能性もあり、下流システムもすでに一部のデータを消費しているかもしれません。そのままリプレイすると内容の重複や前後の不整合が生じるうえ、tokenも二重に消費してしまいます。
分析と判断:OpenAI API 429 を実務でどう扱うか
以下の内容は上記の事実に基づくエンジニアリング上の判断であり、OpenAI 公式の見解ではありません。
そのまま改修して使える OpenAI API 429 バックオフのサンプル
下のサンプルは、いくつかの原則を体現しています。SDK の自動リトライを無効にして、ビジネス層が一元管理する。クォータ系のエラーはそのまま例外を投げる。Retry-After を優先的に守る。それが無い場合はフルジッター付きの指数バックオフを使う。最大試行回数を制限する。
import random
import time
from openai import OpenAI, RateLimitError

# SDK の自動リトライを無効化し、以下のカスタムリトライとの二重実行を避ける
client = OpenAI(max_retries=0)

# 待機では解決できない 429 の種類(実際のレスポンスと公式ドキュメントに基づく)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """Retry-After の秒数を解析する。無効な場合は None を返す。HTTP 日付形式は必要に応じて解析を追加する。"""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # クォータ/課金系の問題。アカウント側の処理フローに委ねる
            if attempt == max_attempts - 1:
                raise  # 上限を超えた。キューやアラートに委ねる
            wait = parse_retry_after(e.response)
            if wait is None:
                # フルジッター:[0, 指数上限] の範囲でランダムに値を取る
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
サンプル内の max_attempts、base、cap はあくまで出発点であり、推奨値ではありません。アカウントごとにレート制限の階級が異なり、タスクの形態も違います。すべてのアカウントに当てはまる統一的な同時実行数やリトライ回数は存在しません。自分の監視データに合わせて調整してください。
ボトルネックの種類に応じた調整:リクエスト数とトークンでは解決策が異なる
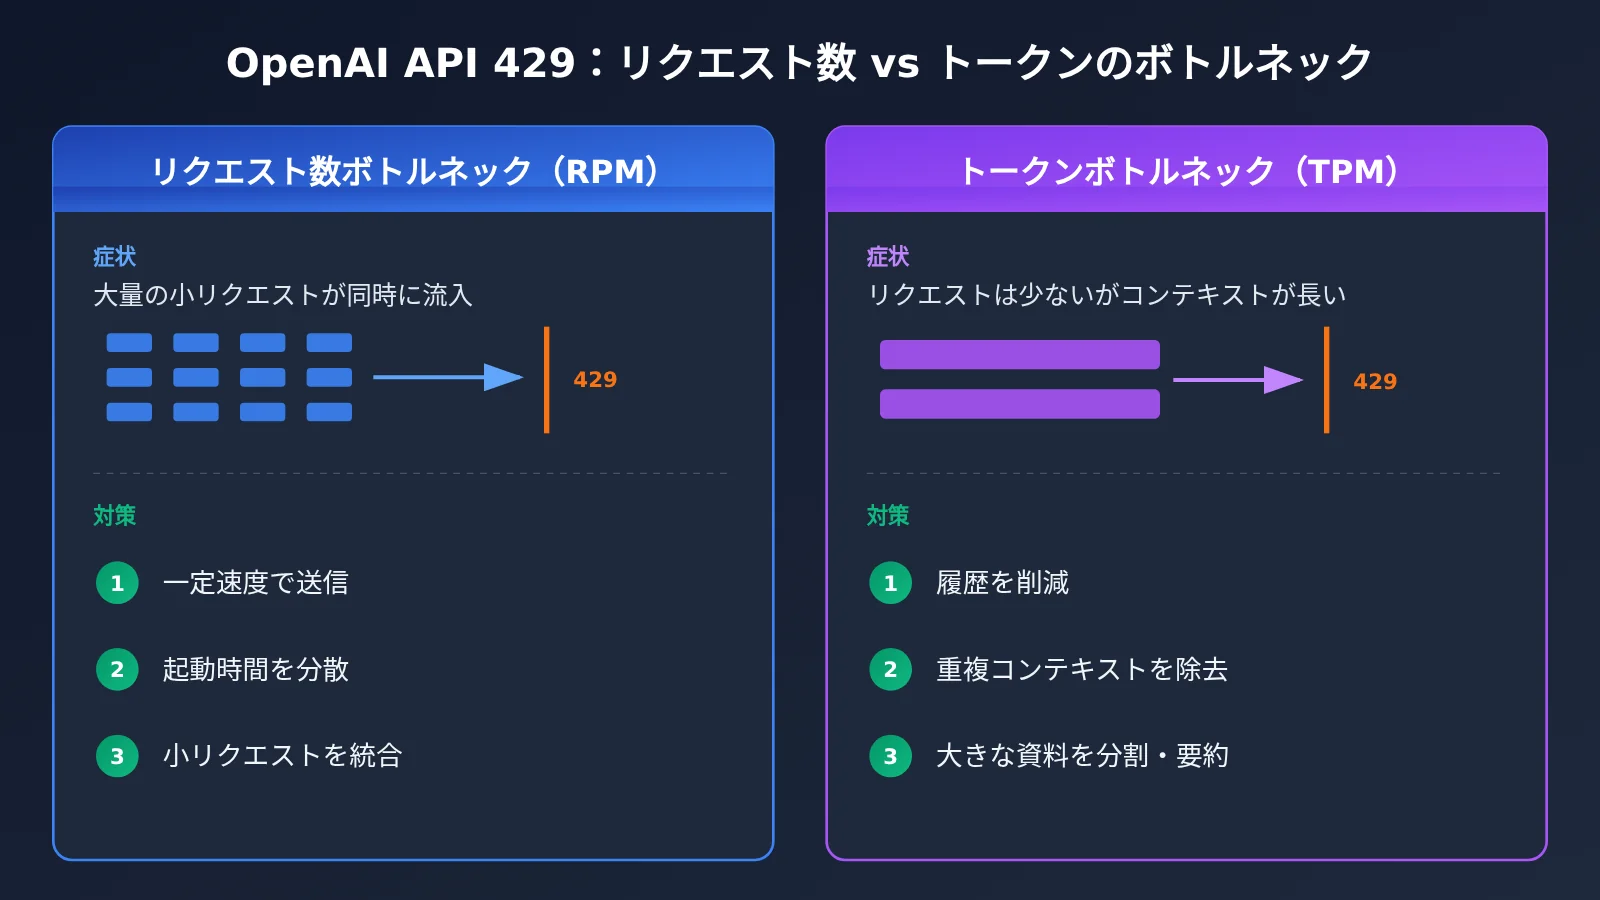
バックオフは「今回どう待つか」を解決するだけで、「なぜいつも上限にぶつかるのか」は解決できません。429を減らすには、まずどの上限に引っかかっているのかをはっきりさせる必要があります。
リクエスト数ボトルネックのカギは、送信のテンポを分散させることです。キューの入口で均等に放出する仕組み、たとえばトークンバケットや一定間隔での払い出しを導入し、大量のタスクが同じ1秒に一斉に流れ出さないようにします。バッチ処理の開始時も時間をずらし、定刻にまとめてトリガーしないようにしましょう。
トークンボトルネックのカギは、1回のリクエストのサイズを小さくすることです。よくある無駄としては、毎ターンの会話で長いシステムプロンプトと履歴を丸ごと含めてしまう、同じ大きな文書を複数のリクエストで繰り返し送ってしまう、実際には一部だけ必要なのに資料全体をモデルに渡してしまう、といったものがあります。まずトリミング・要約・検索を行ってから送信するほうが、リトライ回数を増やすよりもはるかに効果的なことが多いです。
キュー状態は「リトライ待ち」と「アカウントブロック」を区別する
多くのシステムには「キュー待ち」と「失敗」の2つの状態しかありません。429 に遭遇すると、これが2種類の誤判定を引き起こします。一時的なレート制限を失敗とみなしてタスクを破棄してしまい、クォータの問題をキュー待ちとみなして延々と待ち続けてしまうのです。
より合理的なのは、2種類の 429 を別々の状態に分け、それぞれ異なる表示を行うことです。
| キュー状態 | トリガー条件 | 表示すべき情報 | 後続の処理 |
|---|---|---|---|
| リトライ待ち | 一時的なレート制限 | 次回試行予定時刻、試行回数 | 時刻が来たら自動リトライ、上限到達で失敗へ |
| アカウントブロック | クォータ、課金、組織の利用制限 | ブロック理由(例:クォータ不足) | 同一アカウントの後続タスクを一時停止し、責任者に通知 |
| 失敗 | リトライ上限超過やその他の回復不能なエラー | エラー種別と元の情報 | 人手による介入または業務の縮退運転 |
「アカウントブロック」には連鎖的な効果もあります。同じアカウント配下の他のタスクも高い確率で同じ 429 に遭遇するため、この場合は個々のタスクがそれぞれ一度ずつ失敗するのを待つのではなく、全体をまとめて一時停止すべきです。
リトライの重層化を調査する:SDK、キュー、手動ボタン
429 がリトライするほど増えていく場合は、まず複数の層でリトライが同時に有効になっていないかを確認しましょう。典型的な経路はこうです。SDK が自動で数回リトライし、業務キューがタスク失敗後に再び数回再投入し、さらにフロントエンドのユーザーがエラーを見て手動で「リトライ」ボタンを押す。この3層が掛け合わさると、1つの元のリクエストが十数回の実リクエストに膨らむことがあり、しかもそれらはレート制限の時間枠に集中しがちで、まさに制限を悪化させてしまいます。
調査の際は、層ごとに順番に確認することをおすすめします。
- SDK 層:
max_retriesの実際の値を確認し、記憶の中のデフォルト値に頼らないこと。 - キュー層:タスク失敗後に自動で再投入されるかどうか、また再投入にバックオフがあるかどうかを確認すること。
- インタラクション層:「リトライ」ボタンが待機中に無効化されているか、次回試行時刻が表示されているかを確認すること。
- ログ層:元のタスクごとに一意の ID を割り当て、実際に何回リクエストを発行したかを集計すること。
原則はシンプルです。同じ経路の中では、リトライを担当する層を1つだけに絞り、他の層は状態を伝える役割だけにとどめることです。
ストリーミングでは OpenAI API 429 の復旧戦略を個別に設計する
ストリーミングリクエストが接続を確立し、まだ何も出力していない段階で 429 に遭遇した場合は、通常のリクエストと同様に扱えます。一度出力が始まったら、「リプレイするかどうか」は業務側の判断に委ねるべきです。たとえば、生成が中断されたことをユーザーに明示し、ユーザーが再生成を選べるようにする。あるいは、出力済みの部分を破棄して全体を置き換える。バックグラウンドで黙ってリプレイし、画面上に同じ内容が二重に表示されるようなことは避けてください。
他のプラットフォームへ移行する際は、OpenAI の 429 セマンティクスをそのまま流用しない
本記事で説明しているエラー分類、error.code の値、Retry-After の動作、レスポンスヘッダーは、いずれも OpenAI 公式 API のセマンティクスです。サードパーティのゲートウェイ、API中継サービス、アグリゲーションプラットフォーム(たとえば APIYI)経由でモデルを呼び出す場合、相手側のエラーコード、レート制限の単位、再試行の推奨事項は、そのプラットフォーム自身のドキュメントに従う必要があります。必ず別途確認し、OpenAI の動作をそのまま流用してはいけません。比較的安全な方法は、接続レイヤーでエラー正規化の層を設け、異なるソースの 429 を本記事で述べた「再試行待ち / アカウントブロック / 失敗」の3つの状態にマッピングしてから、共通の再試行モジュールに渡して処理することです。
継続的に注目すべき変化
OpenAIのエラーコードドキュメントとレート制限ドキュメントは、どちらも継続的にメンテナンスされています。制限の階層、計測の単位、レスポンスヘッダーのフィールドが調整される可能性は十分にあります。コード内にはエラー原文のログを残しておき、定期的に公式ドキュメントと照らし合わせて判定ロジックを見直すことをおすすめします。あわせて、「429はすべて待てば解決する」という前提をデフォルト設定に書き込まないでください。この仮定がクォータ枯渇時に有効になってしまうと、その代償は一晩中空回りし続けるタスクキューです。
429は本質的に、サーバー側が「もう少しゆっくり」と言っているものです。時には「この経路は今は通れない」と言っていることもあります。どちらなのかを見分けたうえで、待つのか、変えるのか、止めるのかを決めることこそ、どんなに精巧なリトライアルゴリズムよりも重要です。『論語・子路』が言うように:
「速やかならんことを欲するなかれ、小利を見るなかれ。速やかならんことを欲すれば則ち達せず、小利を見れば則ち大事成らず。」