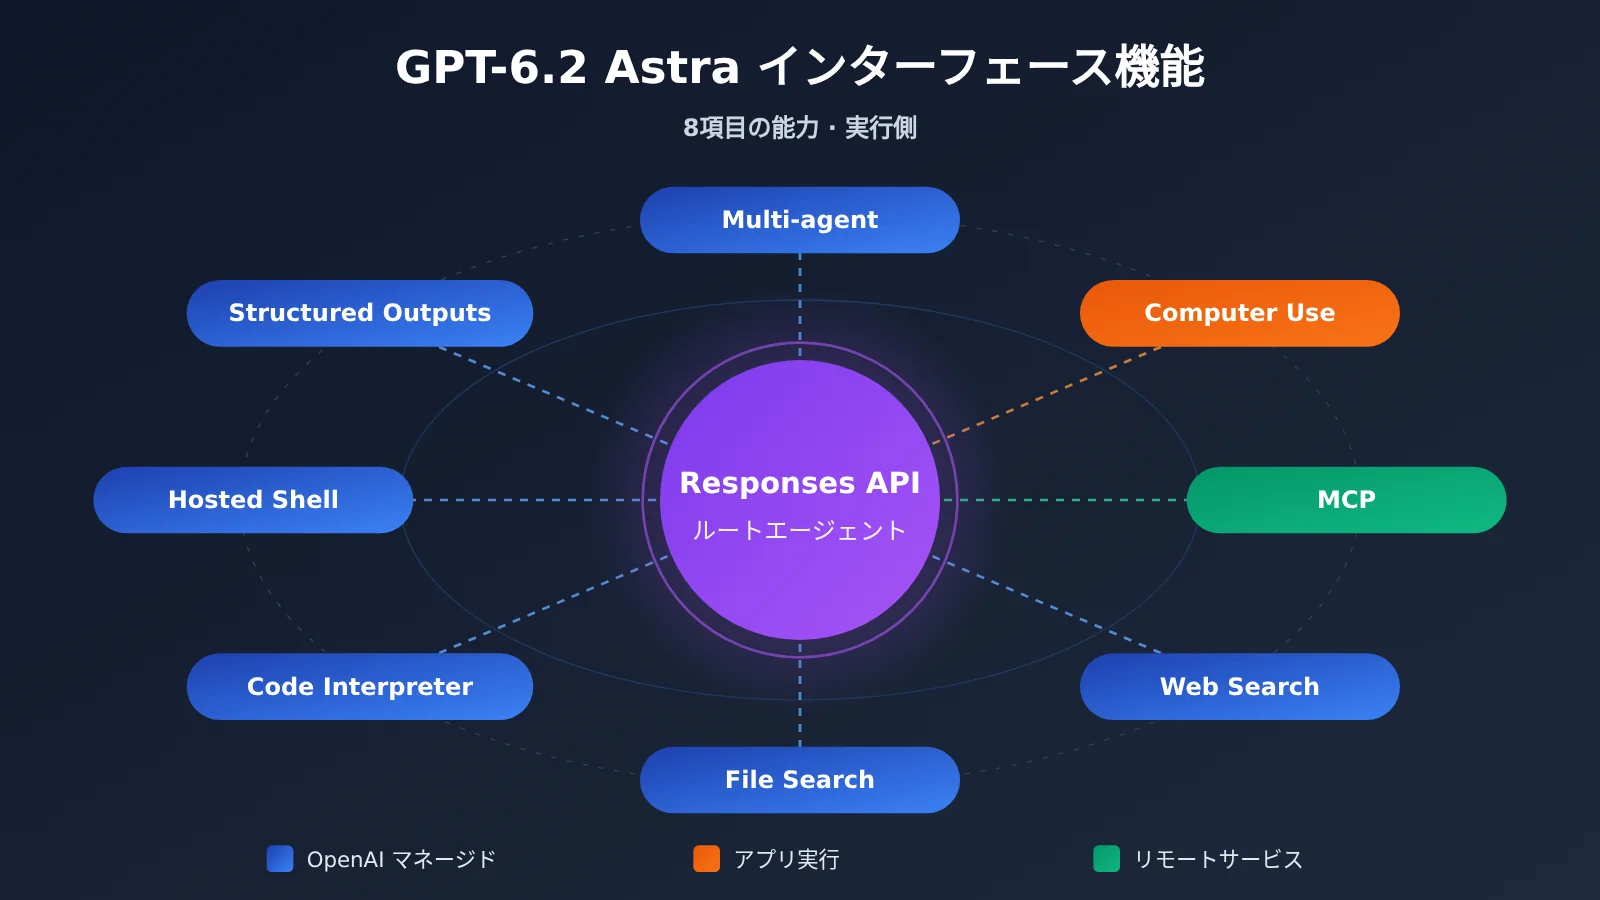
直接的な回答: GPT-6.2 Astra は Responses API 上でサブタスクを並列に委任でき(Multi-agent)、スクリーンショットを使ってブラウザやデスクトップ UI を操作でき(Computer Use)、リモート MCP サービスに接続してチームの業務ツールを呼び出すこともできます。ただし、これら3つの機能では実行主体がそれぞれ異なります。委任は API がホストし、UI 操作の実行環境はあなたのアプリケーションが提供し、MCP 呼び出しの対象はあなたが設定したリモートサービスです。
核心的な結論: エンジニアリング上の難しさは、モデルそのものの能力よりもオーケストレーションにあります。実際に導入できる業務エージェントでは、次の3点を事前に明確にする必要があります。各ツールを誰が実行するのか、データの認可をどこまで許すのか、最終結果を誰が検証するのか。
この記事を読むと、次のことがわかります。
- GPT-6.2 Astra が Responses API でサポートする6種類の組み込みツールと Structured Outputs、およびそれぞれの実行主体と利用条件;
- Multi-agent beta の有効化方法、デフォルトの同時実行数、そして並列実行に向くタスクと順次実行が必要なタスク;
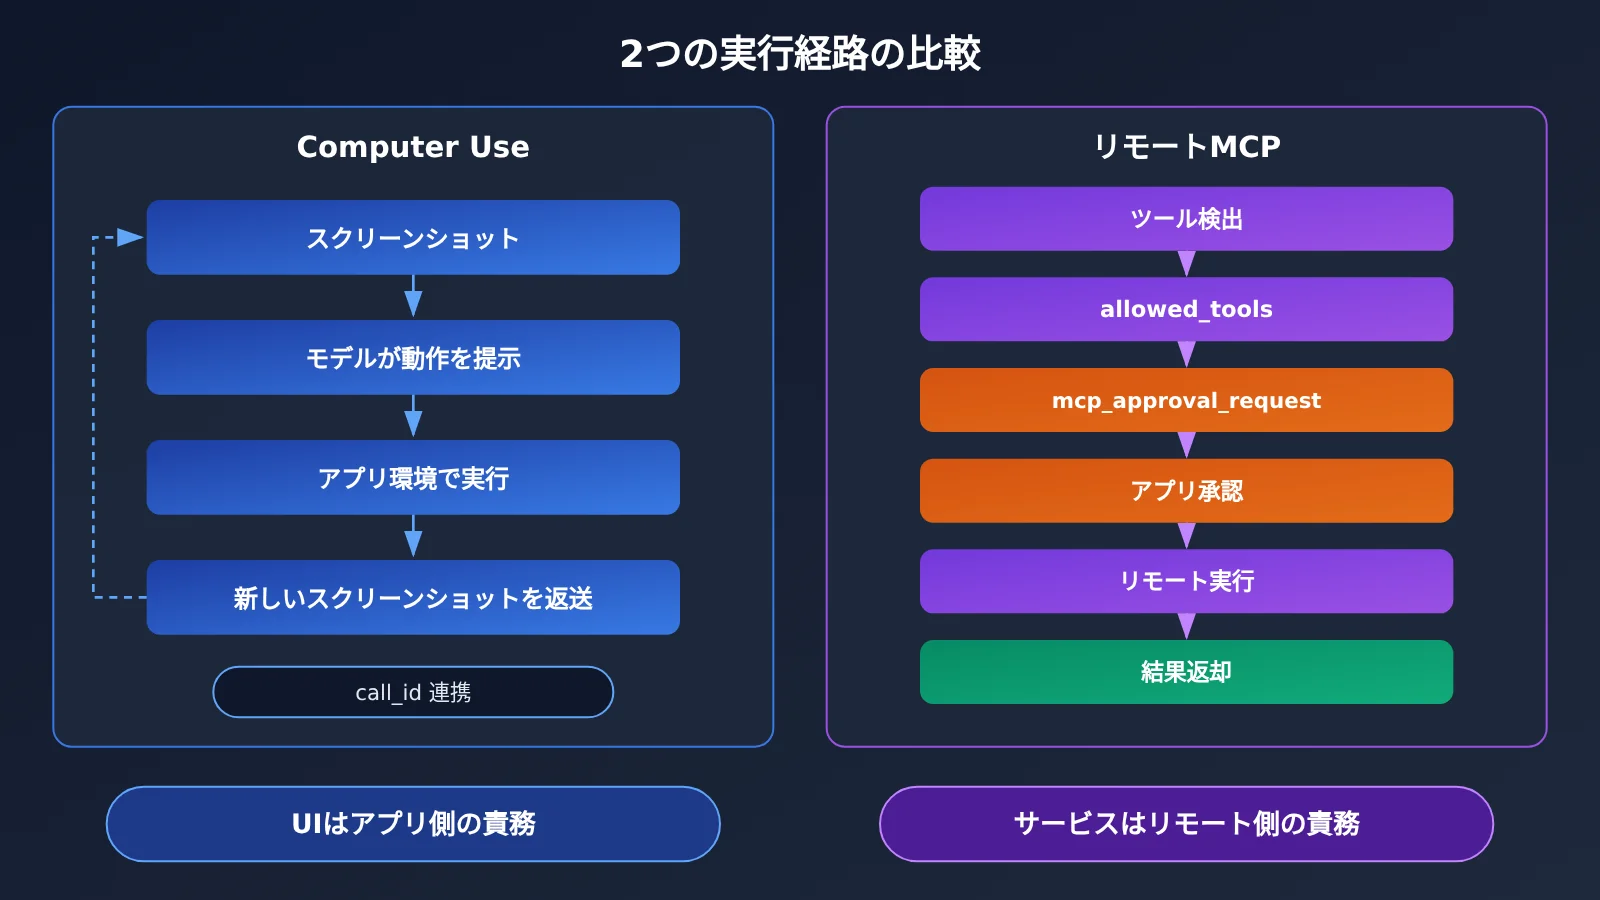
- Computer Use とリモート MCP という2つの実行経路の違い(承認、権限範囲、責任分担を含む);
- 検索、計算、構造化出力をどのようにつなげて、検証可能な調達チェック結果を納品するか。
索引: 本文ではまず、OpenAI が11月17日に発表したモデルの位置づけ、仕様、価格をまとめます。続いて、8項目の機能の実行主体を1つの表で比較し、「読み取り専用の調達チェック」という設計例に沿って、Multi-agent の並列処理の境界、Computer Use と MCP の実行経路、検索から構造化出力への引き継ぎ方法を順に説明します。最後の分析パートでは、開発者とプロダクト責任者が今まず何をすべきかを示します。
GPT-6.2 Astra To Know:概念の解説
| 概念 | 簡単な説明 |
|---|---|
| Responses API | OpenAIがモデルの応答とツール呼び出しに用いるインターフェース。本記事で扱う組み込みツールとMulti-agentは、いずれもこれを前提としています |
| Multi-agent | サポート対象のResponsesリクエスト内で、複数の協調エージェントを有効化するベータ機能 |
| サブエージェント | 独立したコンテキストで委譲されたタスクを処理し、完了後にルートエージェントへ結果を報告する作業単位 |
| Computer Use | モデルがスクリーンショットからUI要素を特定し、ブラウザやデスクトップの操作実行を要求する機能 |
| MCP | モデルクライアントが外部サービスのツールを検出し、呼び出す方法を規定するプロトコル |
| Web Search | 公開インターネット上で情報を検索し、応答内に出典を付けて返せるツール |
| File Search | 指定したベクターストア内で、アップロード済みのファイルを検索するツール |
| Code Interpreter | Pythonを実行してデータを分析し、ファイルを生成するマネージドサンドボックス |
| Hosted Shell | OpenAIがホストし、ターミナルコマンドを実行できる隔離環境 |
| Structured Outputs | JSON Schemaで応答のフォーマットを制約する出力機能 |
| ツール呼び出しID | ある呼び出しリクエストとその実行結果を対応付ける識別子(call_id など) |
GPT-6.2 Astra 影響の概要
- 業務エージェントエンジニア:1回のリクエストの中で、委譲・検索・リモートツール・構造化出力を組み合わせられるようになり、オーケストレーションのコードは減ります。ただし、関数の結果を返す処理、Computer Useの実行環境、MCPの承認といった部分は、引き続きアプリ側で実装する必要があります。
- プロダクト責任者:「エージェントが自分でシステムを操作できる」という事実に、公式インターフェースの裏付けが生まれました。権限の範囲、書き込み時の確認、人によるレビューの責任は、プロダクト設計の段階でフローに組み込んでおく必要があります。
- コストを重視するチーム:公式の単価は前世代より引き下げられています。ただしMulti-agentの並列実行によってトークン使用量が増える可能性があるため、予算はタスク構造に合わせて再試算する必要があります。
GPT-6.2 Astra の客観的事実:リリース、仕様、ツール一覧
GPT-6.2 Astra のリリースとモデル識別情報
OpenAI は 2026 年 11 月 17 日に GPT-6.2 Astra と GPT-6.2 Sol を同時にリリースしました。公式は Astra を複雑な推論、コーディング、専門業務向けのモデルと位置づけており、API モデル ID は gpt-6.2-astra、前世代は GPT-6 Astra(gpt-6-astra)です。API 更新ログには同日、モデルのリリースとバックグラウンドの完了ウィンドウに関する項目が記録されています。
モデルカードに記載された仕様は、コンテキスト 1,050,000 token、最大入力 922,000 token、最大出力 128,000 token です。モデルはテキストと画像を入力として受け取り、テキストを出力します。Responses API と Chat Completions API の両方に対応しています。注意が必要なのは、モデルカードで reasoning.effort を none に設定したリクエストは拒否されると説明されている点です。既存コードを移行する際はこのパラメータを必ず確認してください。
価格については、OpenAI が公表している標準的な短コンテキスト・純テキストの単価が 100 万 token あたり、通常入力 $8、キャッシュヒット入力 $0.40、出力 $40 です。前世代と比較して、公式発表では通常入力と出力の単価が 20% 低下し、キャッシュヒット入力の単価が 60% 低下しています。この数値は公式直結 API での試算にのみ適用されます。サードパーティ評価における問題ごとの費用は別の価格体系を採用しているため、直接比較することはできません。
🚀 クイックスタート:GPT-6.2 Astra が自社の業務データでどれだけ性能を発揮するかをまず検証したい場合は、APIYI(apiyi.com)から 1 つの APIキーで OpenAI 互換の呼び出しを開始できます。新規ユーザーには無料のテスト枠があり、本格導入前の小規模な検証に適しています。beta ツールの利用可能範囲は、プラットフォームの実際のサポート状況に準拠します。
GPT-6.2 Astra API 機能一覧
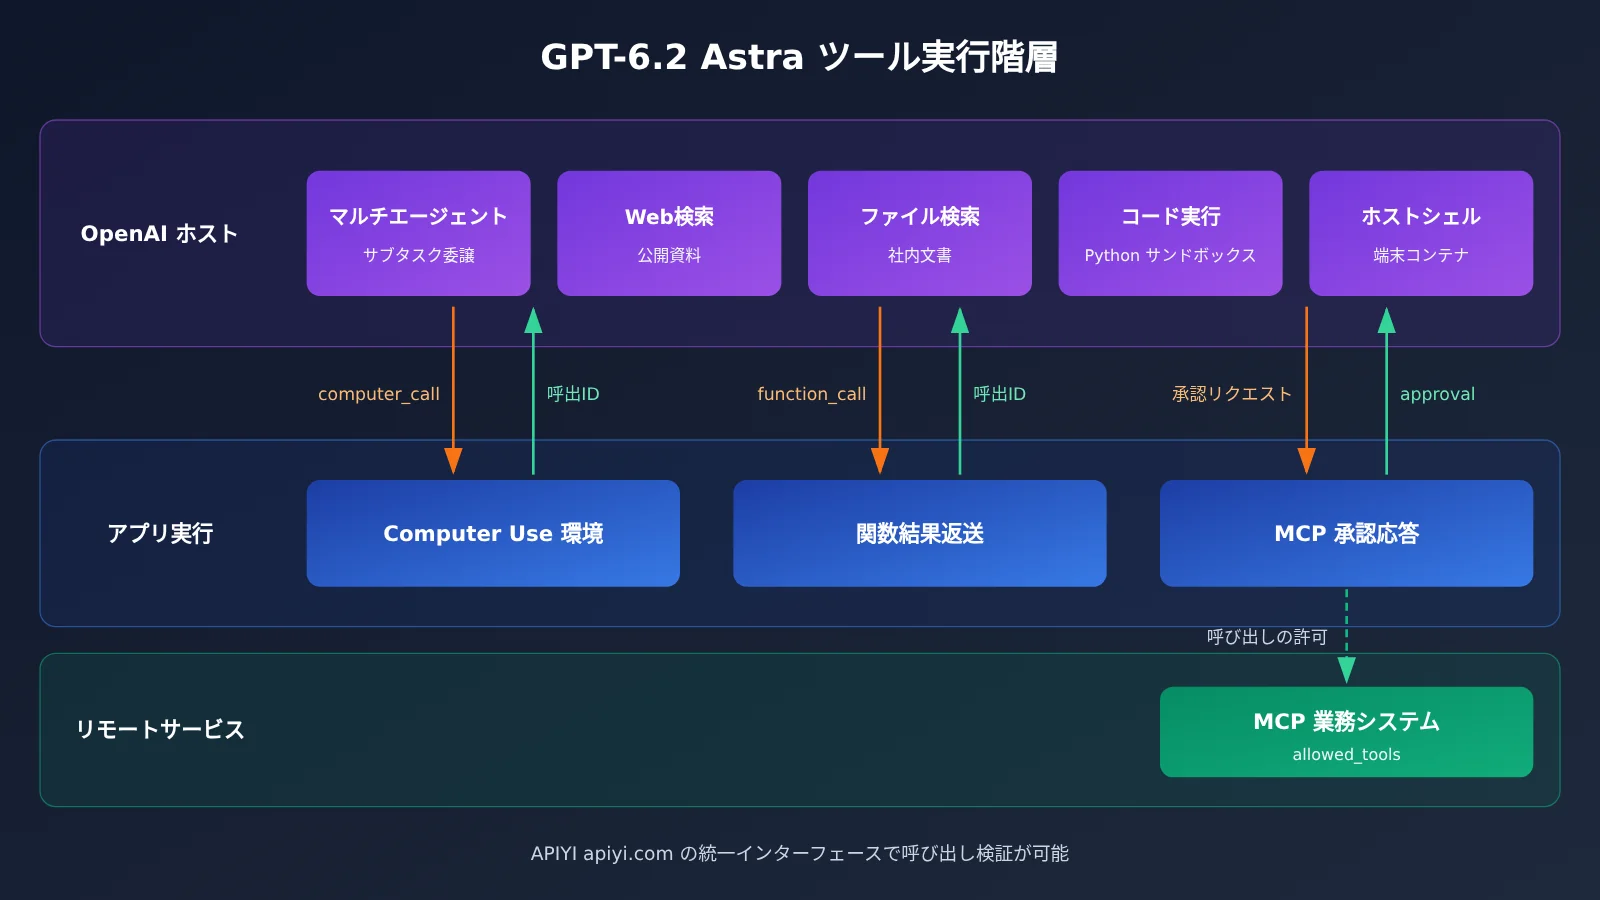
モデルカードでは、Web Search、File Search、Code Interpreter、Hosted Shell、Computer Use、MCP が Astra の Responses API でサポートされるツールとして、Structured Outputs が出力機能として、Multi-agent が Responses の beta 機能としてそれぞれ記載されています。開発者はリクエスト内で利用可能なツールを宣言し、モデルはタスクに応じて呼び出しを開始するかどうかを判断します。レスポンスにはツールリクエスト、承認リクエスト、実行結果、最終テキストなどが含まれうるため、クライアントがどの出力項目を処理するかは、各ツールの実行主体によって決まります。
| 機能 | 実行主体 | 前提 / 設定 | 適した操作 |
|---|---|---|---|
| Multi-agent | Responses のホスト型委任 | beta を明示的に有効化 | 独立したサブタスクを並列処理して集約 |
| Computer Use | アプリが提供するブラウザまたはデスクトップ | アプリ側で環境とログイン状態を管理 | インタラクションが必要な画面の表示や操作 |
| MCP | OpenAI が設定済みのリモートサービスを呼び出す | サービスアドレス、認証、allowed_tools | 業務システムへの照会や書き込み要求 |
| Web Search | OpenAI がホスト | ツールを宣言するだけでよい | 公開され変化の速い情報を調査 |
| File Search | OpenAI がホスト | 事前にアップロードしてベクターストアにインデックス化 | セマンティック検索とキーワードで社内文書を検索 |
| Code Interpreter | OpenAI が管理する Python コンテナ | ファイルの入力と取得を管理 | 照合、統計、グラフ生成 |
| Hosted Shell | OpenAI が管理するターミナルコンテナ | container_auto で設定可能 | 多段階のコマンドラインと複数ファイルの処理 |
| Structured Outputs | レスポンス形式の制約 | text.format で JSON Schema を宣言 | 検証可能な業務データを出力 |
GPT-6.2 Astra Multi-agent の有効化方法と共有範囲
Multi-agent を有効にするには、Responses リクエストで multi_agent.enabled を設定します。生の HTTP または WebSocket を使う場合は、リクエストヘッダー OpenAI-Beta: responses_multi_agent=v1 も付与します。SDK を使う場合は、対応する beta インターフェースを呼び出します。ルートエージェントはサブエージェントを作成し、それらと通信し、完了を待ち、最終的な集約を担当します。
各サブエージェントは独自のコンテキストを持ちますが、そのリクエストのモデルと利用可能なツールを共有します。max_concurrent_subagents のデフォルト値は 3 で、エージェントツリー全体で同時にアクティブなサブエージェントのターン数を制限します。委譲アクション multi_agent_call は API がホストします。サブエージェントが開発者定義のカスタム関数を呼び出した場合、アプリケーションは対応する呼び出し ID に従って実行結果を返す必要があります。公式ドキュメントではまた、並列処理は相互に独立した調査タスクに適しているものの、その分トークン使用量が増える可能性があると注意を促しています。前の結果に依存するステップや共有書き込みでは、実行順序を自分で調整する必要があります。
GPT-6.2 Astra Computer Use と MCP の実行境界
Computer Use の実行環境はアプリケーションが提供します。ネイティブの computer ツールを使用する場合、モデルは computer_call を発行し、あなたの実行環境がその中のクリックや入力などのアクションを実行します。その後、新しいスクリーンショットを computer_call_output と対応する call_id を通じてモデルに返します。これをタスク終了まで繰り返します。公式ガイドには別の接続方法も示されています。モデルにスクリプトを生成させ、アプリケーションが隔離環境で実行する方法です。いずれの方式でも、環境そのもの、ログイン状態、アクセス可能なページ、および重要な書き込み前の確認は、アプリケーションの責任です。
リモート MCP の実行方式は異なります。API は指定されたサービスアドレスに接続し、サーバーが公開するツールをインポートし、承認された呼び出しを実行します。リモート認証はサービスの要件に従って設定します。allowed_tools でインポートするツールを制限できます。デフォルトでは、コネクタやリモートサービスにデータを送信する前に承認を求めます。アプリケーションは mcp_approval_request 内のツール名とパラメータを読み取り、都度 mcp_approval_response を返します。
GPT-6.2 Astra の検索・計算・構造化出力のルール
Web Search は公開インターネットを対象としており、アプリケーションは url_citation を使って結論と出典を関連付けられます。File Search は指定されたベクターストア内でアップロード済みのファイルを検索し、アーカイブ済みの社内資料に適しています。Code Interpreter は Python サンドボックスを提供し、ファイルを生成できます。Hosted Shell では container_auto を使ってクラウドターミナルを構成できます。Shell ガイドでは、アプリケーションがランタイムを自前でホストする方法も紹介されています。2つの計算環境にあるファイルは、利用時に能動的に管理し、取得する必要があります。
Structured Outputs は text.format で JSON Schema を宣言し、完了済みで拒否されていない応答を制約します。公式ドキュメントでは、受信側が引き続き拒否、未完了、API エラー、およびスキーマでは表現できない業務ルールを処理する必要があると明記されています。
GPT-6.2 Astra の分析と判断:1回の購買検証で全機能をつなぐ
以下のフローは設計例であり、参考資料に示された機能の組み合わせから推論したもので、公式の事例ではありません。リクエストごとに実際の状況に応じてツールを設定する必要があり、最終的にどの組み合わせを有効にできるかは、アカウント、ツール設定、実行環境によって決まります。
GPT-6.2 Astra マルチエージェント:並列化が適するのはどんなときか
タスクの目標は、ある契約書の条項、調達システムの注文記録、サプライヤー公式サイトの公開情報の三者が一致しているかを、すべて読み取り専用で確認することです。この3つの照会には依存関係がなく、ちょうどデフォルトの並列数3に対応します。契約グループは File Search で条項を検索し、調達グループは読み取り専用の MCP 経由で注文を照会し、Webグループは Web Search で公開情報を調べます。ルートエージェントは3グループすべての報告を待ってから統合します。
並列実行できるかどうかは、次の基準で判断できます。サブタスクの入力に、別のサブタスクの出力が必要かどうかです。たとえば「まず注文番号を取得し、その注文番号で請求書を照会する」場合は順次実行が必須で、無理に並列へ分割するとサブエージェントがそれぞれ推測してしまい、結果の照合がより難しくなります。また、委譲処理は API 側でホストされますが、サブエージェントがあなたの定義した関数を呼び出した場合、関数の結果は呼び出しIDに基づいてアプリケーションから返す必要があります。この工程を漏らすと、エージェントツリー全体が待機状態のまま止まってしまいます。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

# サンプルコード:パラメータ構造は OpenAI の最新ガイドに従ってください
resp = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "medium"},  # none に設定すると拒否されます
    input="只读核验:合同 C-102 条款、订单 PO-881 记录、供应商官网公示信息是否一致",
    tools=[
        {"type": "file_search", "vector_store_ids": ["vs_contracts"]},
        {"type": "web_search"},
        {
            "type": "mcp",
            "server_label": "procurement",
            "server_url": "https://mcp.example.com/procurement",
            "allowed_tools": ["get_purchase_order"],  # 読み取り専用ツールを1つだけ公開
            "require_approval": "always",
        },
    ],
    extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
    extra_body={"multi_agent": {"enabled": True, "max_concurrent_subagents": 3}},
)
💡 選択のヒント:並列委譲はトークン消費を増やします。まず小規模なサンプルで1回の検証に必要な実際の使用量を測り、そのうえで並列数を決めることをおすすめします。APIYI apiyi.com の従量課金で呼び出せば、異なる並列設定間のコストをすばやく比較できます。
GPT-6.2 Astra Computer Use と MCP の役割分担の判断
例えば、サプライヤーの公式サイトで資格の有効期限が「資格証明書」のポップアップを開いたときにだけ表示され、Web Search ではこのフィールドを取得できない場合、Computer Use が必要になります。流れは3ステップです。アプリが隔離されたブラウザでページを開いてスクリーンショットを撮る。モデルがクリック座標や操作指示を返す。アプリが実行した後、新しいスクリーンショットを call_id とともにモデルに返す。ログイン状態とアクセス可能範囲はアプリ側が掌握しているため、読み取り専用タスクでは環境レベルでフォーム送信を禁止するのが望ましく、プロンプトによる制約だけに頼るべきではありません。
一方、注文照会は MCP を経由します。ツール検出の段階では、allowed_tools を通じて get_purchase_order という読み取り専用ツールだけをインポートします。認証には最小権限の読み取り専用クレデンシャルを使用します。呼び出しのたびに、アプリは mcp_approval_request 内のパラメータを読み取り、注文番号が今回の検証範囲内にあることを確認してから、承認を返します。2つの経路の責任は次のように分担できます。画面上で何が起きたかはアプリが担い、リモートシステムが何を返したかはサービス提供側が担い、モデルは要求を出すことだけを担います。
| 観点 | Computer Use | リモート MCP |
|---|---|---|
| 実行環境 | アプリが提供するブラウザ / デスクトップ | 設定したリモートサービス |
| 連携識別子 | computer_call と call_id | mcp_approval_request / response |
| 権限制御のポイント | 環境の隔離、ログイン状態、ページホワイトリスト | サービス認証、allowed_tools、呼び出しごとの承認 |
| 適したフィールド | 操作を伴って初めて表示される公開情報 | 業務システム内の構造化レコード |
| 主なリスク | 誤クリック、ページ改訂 | 権限を越えた呼び出し、パラメータの逸脱 |
GPT-6.2 Astra:資料収集から実用的な出力まで
検索ツールはドキュメントの所在に応じて使い分けます。公開されていて頻繁に更新される情報には Web Search を使い、url_citation を保持します。アーカイブ済みの契約書には File Search を使います。計算環境はタスクの形態で選びます。金額の突合や集計といった作業なら、Code Interpreter の Python サンドボックスで十分です。複数ファイルの一括解凍・変換や、コマンドラインツールを連携させる処理が必要な場合に、Hosted Shell を検討します。ファイルを取り戻すステップも、フローの中に忘れずに組み込んでおきましょう。
ルートエージェントのマージが完了したら、アプリ側が発行する後続の Responses リクエストで構造化結果を個別に生成することをおすすめします。検索と混ぜて同じリクエストにまとめないようにしましょう。こうすると schema がよりシンプルになり、失敗時のリトライも容易になります。
承認応答の返送と構造化出力のサンプルコードを見る
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

ALLOWED_PO = {"PO-881"}

def handle_approvals(resp):
    """MCP呼び出しを1件ずつ承認する:今回の検証範囲内の注文番号だけを許可する"""
    replies = []
    for item in resp.output:
        if item.type == "mcp_approval_request":
            ok = item.name == "get_purchase_order" and \
                 item.arguments and any(po in item.arguments for po in ALLOWED_PO)
            replies.append({
                "type": "mcp_approval_response",
                "approval_request_id": item.id,
                "approve": bool(ok),
            })
    return replies

schema = {
    "type": "object",
    "properties": {
        "records": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "record_id": {"type": "string"},
                    "evidence": {"type": "array", "items": {"type": "string"}},
                    "status": {"type": "string",
                               "enum": ["match", "mismatch", "needs_review"]},
                },
                "required": ["record_id", "evidence", "status"],
                "additionalProperties": False,
            },
        }
    },
    "required": ["records"],
    "additionalProperties": False,
}

def to_structured(prev_id):
    final = client.responses.create(
        model="gpt-6.2-astra",
        previous_response_id=prev_id,
        input="把核验结论整理为结构化记录,evidence 只写可追溯来源",
        text={"format": {"type": "json_schema", "name": "procurement_check",
                         "schema": schema, "strict": True}},
    )
    if final.status != "completed":
        raise RuntimeError(f"未完成:{final.status}")  # 拒否・未完了は個別に処理する必要がある
    return final.output_text
フォーマット上の制約はあくまで第一の防御線であり、フィールドの論理はプログラムと人の手でチェックする必要があります。以下は出力サンプルと、各フィールドの検証責任です。
| フィールド | サンプル値 | フォーマットでの保証 | 引き続き確認が必要な内容 | 担当 |
|---|---|---|---|---|
| record_id | PO-881 | schema で文字列に制約 | 購買システムに実際に存在するか | プログラムによる再照会 |
| evidence | 契約第5.2条;公式サイトの資格ページ | 必ず配列であること | ソースを開けるか、引用が対応しているか | プログラム+抜き取り検査 |
| status | mismatch | 列挙値のみ | 判定が業務上の基準に合致するか | 人手によるレビュー |
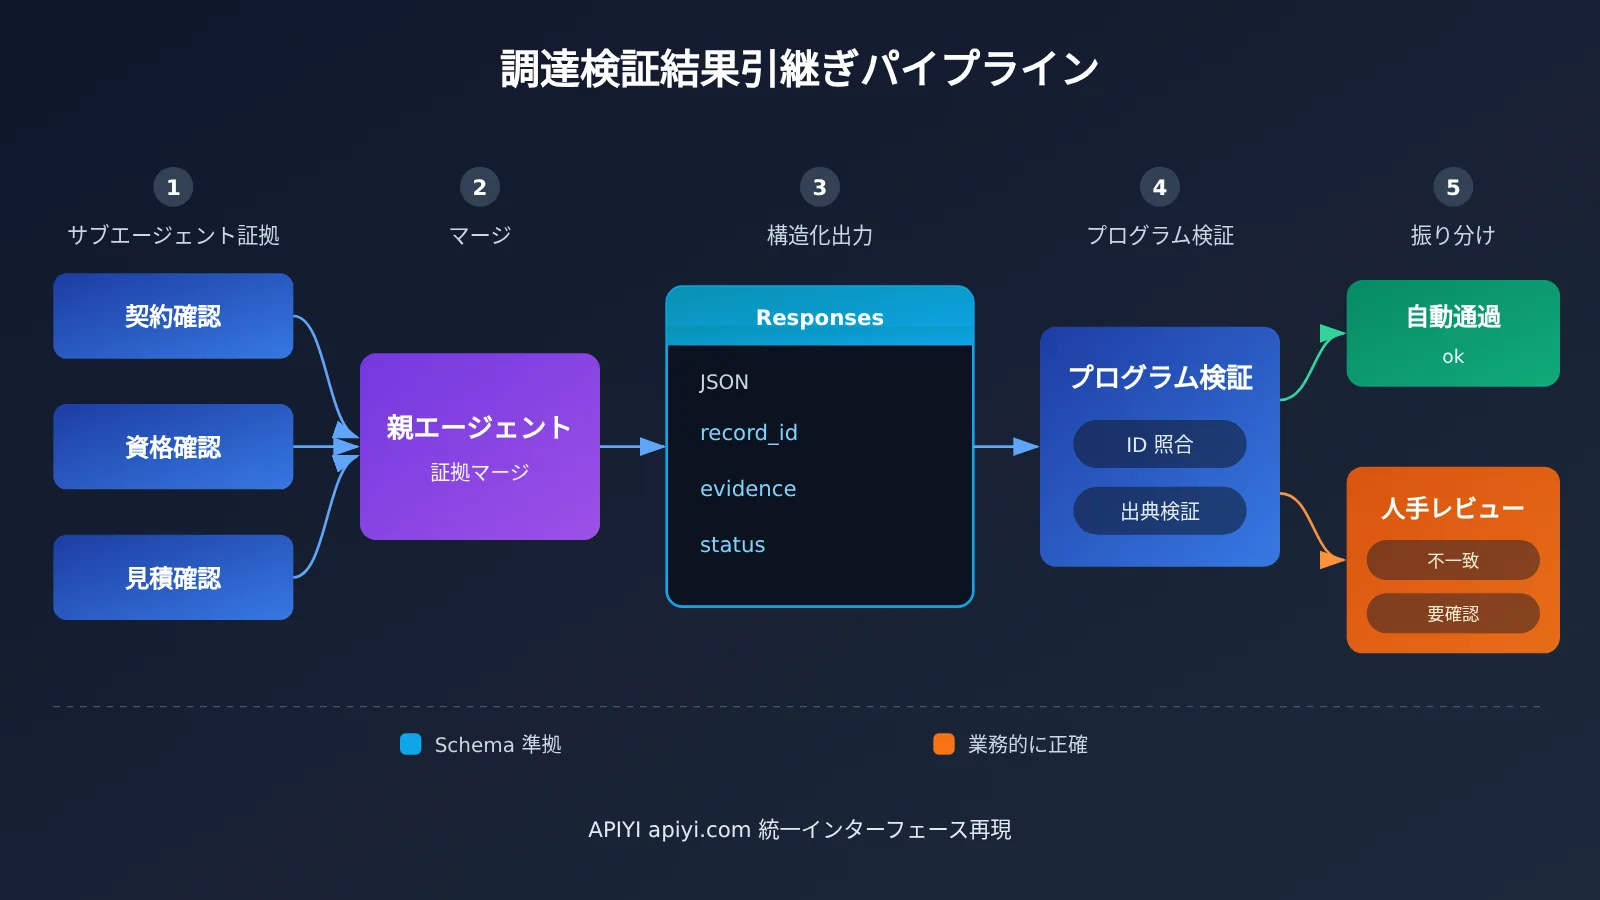
🎯 技術的な提案:「schema に適合しているか」と「業務的に正しいか」を2つの独立した検証ステップに分けることをおすすめします。
statusがmismatchまたはneeds_reviewのレコードは、すべて人手レビューのキューに入れます。公開前に APIYI apiyi.com 上で過去の購買発注書を使ってフロー全体をリプレイし、誤判定率を集計したうえで、どのステータスを自動で通過させてよいかを決めるとよいでしょう。
GPT-6.2 Astra 導入順序の判断
以上の事実に基づくと、私たちが導き出した導入順序は次のとおりです。まず Structured Outputs と File Search を通し、次に読み取り専用の MCP を接続し、最後に Multi-agent と Computer Use を導入する。最初の2つは OpenAI がホストしているため、エラーが発生する確率が最も低くなります。MCP の承認応答は、個別にテストが必要なステートマシンです。Multi-agent は現在も beta であり、Computer Use の安定性は自前で構築する環境の品質に左右されます。この2つは、メインのフローが安定してから重ねて導入するのが適しています。
この判断が成立する前提は、beta インターフェースに近い将来破壊的な変更がなく、あなたのアカウントでも該当するツールを有効化できることです。どちらについても、OpenAI の API 更新ログを継続的に確認する必要があります。また、「読み取り専用」はあくまでサンプルにおける設計上の制約です。ビジネスで書き込みが必要になった時点で、承認ポリシー、書き込み順序、ロールバックの計画をすべて再設計しなければならず、本記事の設定をそのまま流用することはできません。
💰 コスト最適化:長い契約書を繰り返し検索する場合、キャッシュにヒットした入力の単価は通常の入力よりはるかに低くなります。固定のシステム指示とスキーマをリクエストの前部に配置すると、キャッシュヒット率の向上に役立ちます。中小規模のチームも、APIYI(apiyi.com)を通じて従量課金で呼び出し、検証の規模を段階的に広げることができます。
ツールのリストはどんどん長くなっていますが、エージェントが実際に本番投入できるかどうかを決めるのは、やはりあのいくつかの素朴な境界線です。誰が実行するのか、誰が承認するのか、誰がレビューするのか。陸游が『冬夜読書、子聿に示す』に記したように:
紙の上で得た知識は結局のところ浅い。このことを深く知るには、自ら実践するしかない。
作者:APIYI 技術チーム
技術交流:GPT-6.2 Astra の導入に関する実践資料は、APIYI(apiyi.com)のサイトトップページからお問い合わせいただければ、より多く入手できます。