Anthropicは2026年11月9日、Claude Fable 5.2の公開にあたり、社内実験の内容を明らかにしました。Fable 5.2は空のフォルダからスタートし、1,000を超えるサブAgentを連携させて8日間連続で作業し、ノートパソコンで起動できるOSのプロトタイプを完成させました。
この記事のポイント:Claude Fable 5.2のマルチAgentワークフローで費用がどのように発生するのか、誤解しやすい課金ルールは何か、モデル選びや呼び出しの管理で総コストをどう抑えられるのかを解説します。
Claude Fable 5.2のOS実験:1,000 Agentの請求額が不明な理由
まずは、公式に公開されている主な情報を確認しましょう。この実験が示しているのは、モデルのコーディング能力だけではありません。大規模なソフトウェア開発を進め、多数のサブAgentを連携させ、長期にわたって作業を継続しながら、コードの検証を繰り返す能力です。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026年11月9日 |
| 公開元 | Anthropic |
| 実験の開始条件 | 空のフォルダから出発し、OSのプロトタイプを設計・実装 |
| Agentの規模 | 1,000を超えるサブAgent |
| 実行期間 | 8日間連続で、昼夜を問わずコードの作成、テスト、レビュー、修正を実施 |
| 最終成果 | 実際のノートパソコンで起動できるOSのプロトタイプ。カーネル、ディスク・キーボード・ネットワーク用ドライバー、ファイル保存機能、ウィンドウシステム、ログイン画面、インストーラー、Claudeの組み込み機能を備える |
| 未公開情報 | 総Token消費量、実験の総コスト、Agentの役割分担、通信プロトコル、コード量など |
ここで注意したいのは、公式が「動作するOSのプロトタイプ」と説明しているからといって、成熟した商用OSになったわけではないという点です。また、Anthropicはこの実験の実際の請求額を公開していません。そのため、「このOSの開発にいくらかかったのか」という数字は、いずれも推測にすぎません。
Agentチームでは、API呼び出しが何層にも重なる
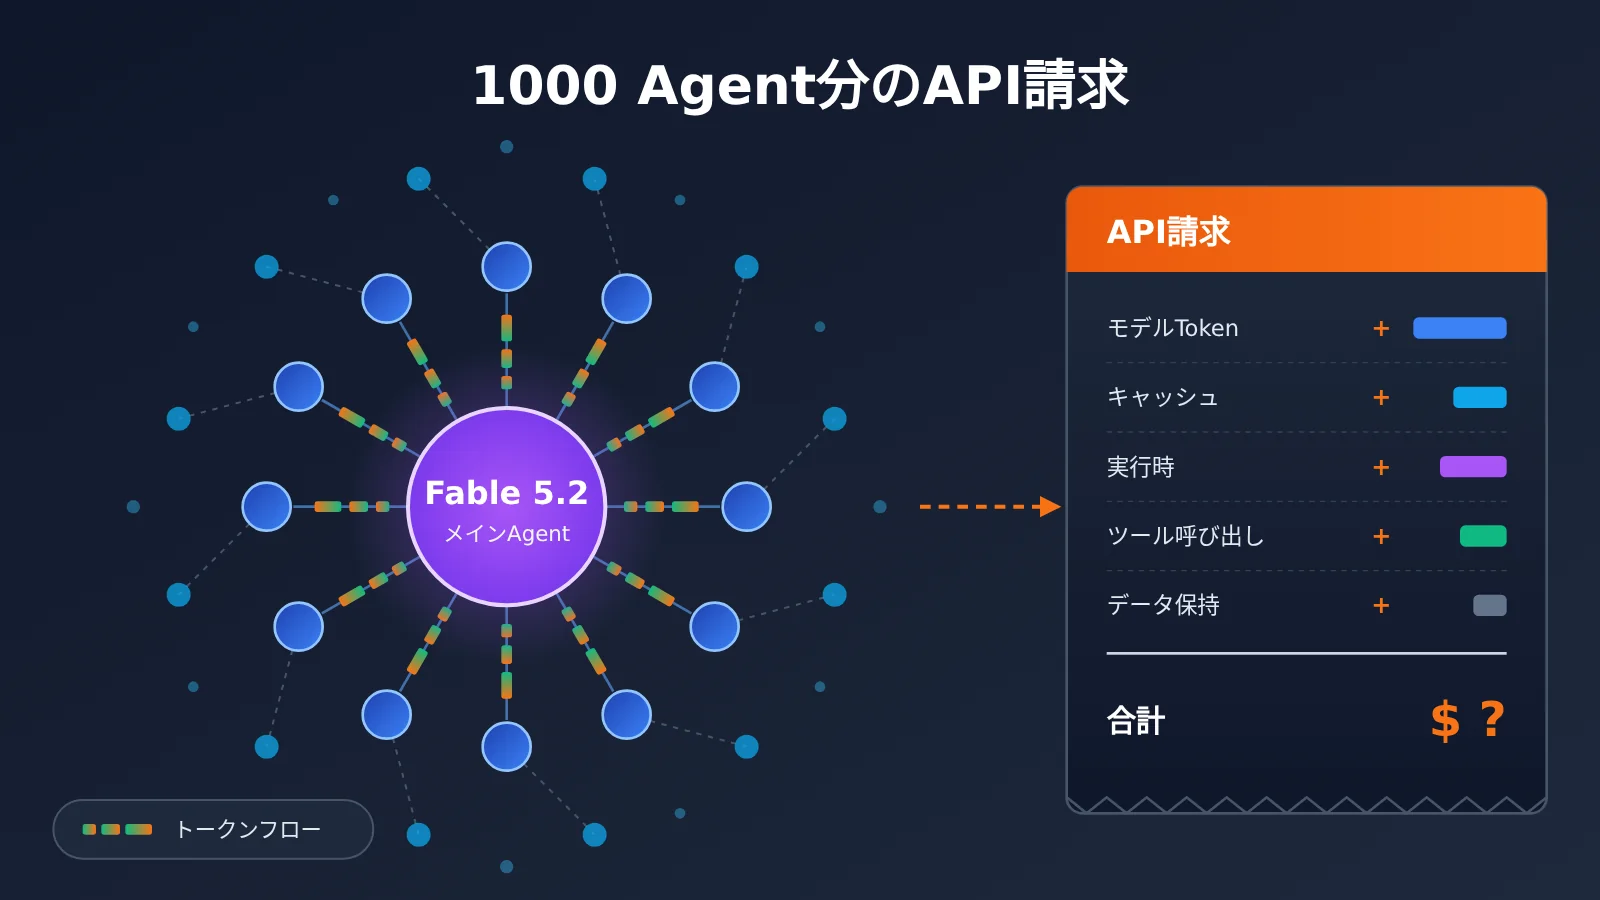
実際の請求額がわからなくても、構造を見ればマルチAgentのコストが膨らむ要因を理解できます。メインAgentは目標を理解し、タスクを分割してサブAgentに割り当てます。その後、結果を集めて要約し、検証します。一方、各サブAgentはプロジェクトの背景やツールの説明、関連するコードを読み込み、それぞれ推論して結果を出力します。
つまり、「タスクを完了する」という一連の処理の裏では、計画、実行、結果の返却、検証、失敗後の再試行といった複数層のモデル呼び出しが積み重なります。Agentの数が増え、実行期間が数日に及ぶと、Token費用、並列呼び出し、長時間の実行が、いずれも請求額を左右する要素になります。
Claude Fable 5.2 APIの料金:マルチエージェントのコストを考える出発点
マルチエージェントのコストを考えるなら、まずは単価を確認しましょう。以下はすべてAnthropicが公開している価格で、単位は米ドル/100万トークン(MTok)です。
| モデル | 入力価格 | 出力価格 | 用途 |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | 複雑で自由度が高く、長時間にわたるタスク |
| Claude Opus 5.5 | $4 | $20 | 大半のプログラミングや知的作業で、公式が推奨する出発点 |
| Claude Sonnet 5.5 | $2 | $10 | 中程度の難易度のサブタスク、資料の処理 |
| Claude Haiku 5.5 | $0.10 | $0.50 | シンプルで頻度の高いサブタスク(入力が100Kトークン以下の場合) |
Haiku 5.5は入力が100Kトークンを超えると、入力が$0.50/MTok、出力が$2.50/MTokになります。Fable 5.1の価格は以前、入力が$10、出力が$50でした。そのため、Fable 5.2では標準のトークン単価が20%下がっています。
💡 選び方のヒント:モデルは、能力が同等でそのまま置き換えられるわけではありません。どれを選ぶかは、タスクの難易度と求める品質によって異なります。APIYI(apiyi.com)では、同じOpenAI互換インターフェースを使って複数のClaudeモデルの出力とトークン使用量を比較し、サブタスクごとのモデルの使い分けを決められます(利用可能なモデルは、プラットフォームのモデル一覧をご確認ください)。
Claude Fable 5.2の仕様とFast Mode
Fable 5.2のAPI Model IDはclaude-fable-5-2です。コンテキストウィンドウは1Mトークン、最大出力は128Kトークンで、知識のカットオフは2026年6月です。Adaptive Thinkingは常時有効で、EffortのデフォルトはHighです。Low、Medium、High、Xhigh、Maxから選択できます。Effortは回答のスタイルを調整するパラメーターではなく、思考の深さ、実行時間、トークン消費量に直接影響します。
| 料金項目 | 価格(米ドル/MTok) | 説明 |
|---|---|---|
| 通常の入力/出力 | $8 / $40 | 標準モード |
| Fast Modeの入力/出力 | $16 / $80 | 価格は2倍。出力速度は通常モードの最大2.5倍 |
| Batch APIの入力/出力 | $4 / $20 | 非同期のバッチリクエストは50%割引。Fast Modeとの併用不可 |
| 5分間のキャッシュ書き込み | $10 | 後で再利用する入力プレフィックスを保存 |
| 1時間のキャッシュ書き込み | $16 | より長い有効期間 |
| キャッシュ読み取り | $0.20 | 通常の入力価格のわずか2.5% |
この表からわかる重要な点は、最も高性能なモデルに、すべてのサブタスクを任せる必要はないということです。書式の整理や簡単な分類といった作業にFable 5.2を使うと、単価はSonnet 5.5の4倍、Haiku 5.5の80倍になります。それに見合うだけの推論能力を活用できる場面は、ほとんどありません。
マルチエージェントのコストはどう積み上がるのか:Claude Fable 5.2のワークフローを解説
マルチエージェントシステムでは、メインエージェントが計画と取りまとめを担い、サブエージェントが具体的な作業を実行します。作業が「分担」されているように見えますが、トークンがなくなるわけではありません。むしろ、いくつかの段階で消費量が増えていきます。
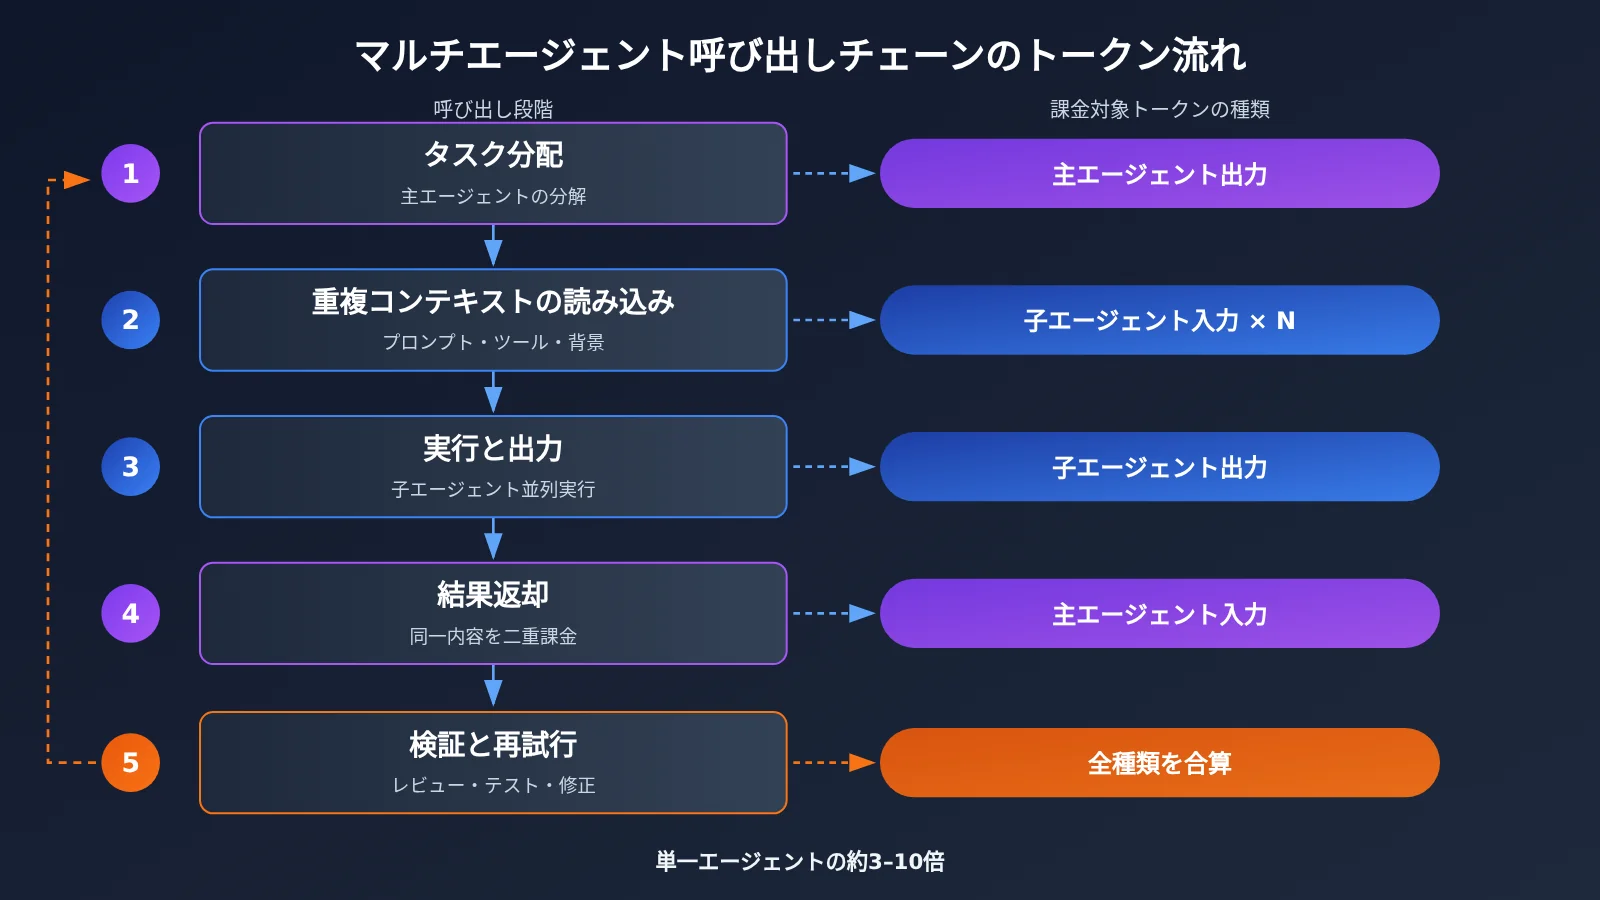
- タスクの割り当て:メインエージェントが生成するタスクの説明は出力トークンとなり、メインエージェントのモデル料金に基づいて課金されます。
- コンテキストの重複:各サブエージェントはシステムプロンプト、ツールの説明、プロジェクトの背景情報を毎回読み込む必要があるため、同じ内容に複数回課金されます。
- 結果の返送:サブエージェントの出力はメインエージェントの入力となり、同じ内容に2回課金されることになります。
- 複数回の検証:レビューやテストで問題が見つかり、修正を指示するたびに、新たな呼び出しが発生します。
- 失敗時の再試行:呼び出しが失敗したり、結果が基準を満たさなかったりすると、再実行され、トークン消費がそのまま上乗せされます。
Anthropicの2026年版マルチエージェントエンジニアリングガイドによると、同じタスクを実行した場合、マルチエージェントシステムのトークン消費量は、一般にシングルエージェントの3〜10倍になります。これは同じタスクでの典型的な比較範囲であり、固定倍率ではありません。あくまで例として、シングルエージェントのタスクにかかるトークン料金が1.60ドルだとします。同じモデル、同じ入力と出力の比率であれば、3倍の使用量で4.80ドル、10倍で16ドルになります。
このことから、並列実行しても総コストが下がるとは限らないとわかります。並列化によって短縮できるのは経過時間です。各エージェントのトークン消費量が減るわけではなく、調整のためのコストも追加で発生します。管理すべきなのはエージェントの数そのものではなく、各エージェントの実際のトークン使用量です。
Claude Fable 5.2のマルチエージェント仮定計算:ワークフローの費用はいくら?
ここでは、仮定上のワークフローを構成します。1つのFable 5.2メインAgentが計画と取りまとめを担当し、10個のSonnet 5.5サブAgentが独立した資料処理タスクを担当します。すべてのToken使用量は仮定値であり、Anthropicの運用システム実験における実際の請求額でも、同等品質のタスクを使ったモデル比較テストでもありません。
メインAgent(Fable 5.2):入力100,000 Token、出力10,000 Tokenと仮定します。
- 入力:100,000 × $8 / 1,000,000 = $0.80
- 出力:10,000 × $40 / 1,000,000 = $0.40
- 小計:$1.20
サブAgent 10個(Sonnet 5.5):各Agentの入力を100,000 Token、出力を20,000 Tokenと仮定します。合計は入力1,000,000 Token、出力200,000 Tokenです。
- 入力:1,000,000 × $2 / 1,000,000 = $2.00
- 出力:200,000 × $10 / 1,000,000 = $2.00
- 小計:$4.00
| 内訳 | 入力費用 | 出力費用 | 合計 |
|---|---|---|---|
| Fable 5.2メインAgent | $0.80 | $0.40 | $1.20 |
| Sonnet 5.5サブAgent 10個 | $2.00 | $2.00 | $4.00 |
| Token費用の合計 | $2.80 | $2.40 | $5.20 |
| Session Runtime(Session 1つがちょうど8時間runningすると仮定) | — | — | $0.64 |
| 計算例の合計(ツール費用を除く) | — | — | $5.84 |
Managed AgentsのSession Runtimeの課金方法
Claude Managed Agentsを利用すると、請求額にSession Runtimeの費用が加わります。料金はSession 1時間あたり$0.08です。課金対象となるのはSessionがrunning状態の時間だけで、idle状態、ユーザーの確認待ち、終了済みのSessionは課金されません。サブAgentのTokenには、それぞれのモデルの料金が別途適用されます。
上表の$0.64は、「Session 1つがちょうど8時間稼働する」という仮定に基づく金額です。8 × $0.08 = $0.64。RuntimeはAgentの数に各Agentの時間料金を掛けて計算するのではなく、Sessionの稼働時間に基づいて課金されます。システム内の複数のSessionで稼働時間が発生した場合は、各Sessionの実際のrunning時間を個別に計算して合算してください。$0.64をマルチエージェントシステムの運用費用として固定的に扱うことはできません。
キャッシュ、Batch、ツール呼び出しによる総コストの変化
ほかにもいくつかの課金要素があり、同じワークフローでも実際の請求額は$5.84から変わる可能性があります。
- Prompt Caching:サブAgent間で共有されるSystem Promptやプロジェクトの背景情報がキャッシュにヒットすれば、読み込み料金は$0.20/MTokです。ただし、初回の書き込みは通常の入力より高額なため、ヒット回数が少ないと、かえって割高になることがあります。
- Batch API:非同期の一括リクエストでは、Token料金が半額になる場合があります。一方、Managed Agentsは状態を保持する対話型Sessionなので、Messages APIのBatch割引は適用できません。50%の割引をSession料金に適用することもできません。
- ツール呼び出し:Managed AgentsのWeb Searchは1,000回あたり$10です。検索を多用するAgentでは、別途費用を計算する必要があります。
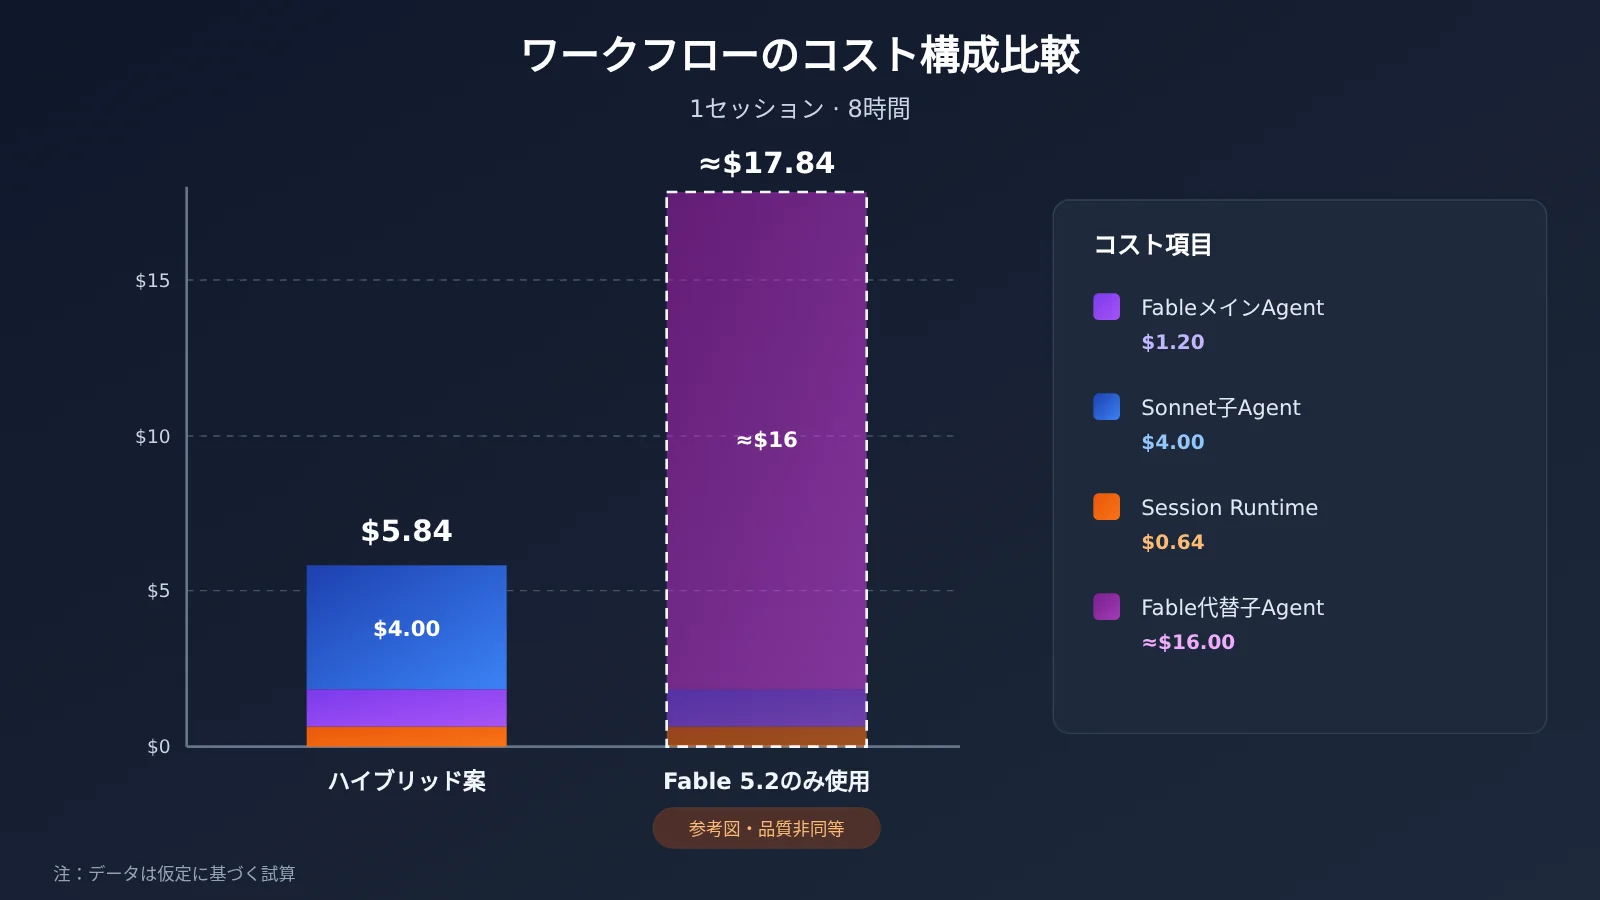
📊 図の説明:上図は公開価格に基づく仮定計算です。ご自身のワークフローを見積もるには、まずAPIYI apiyi.comを通じて少数の実リクエストを実行し、レスポンスのusageフィールドから実際のToken数を確認して、料金表に当てはめてください。
Claude Fable 5.2のマルチエージェントシステムでコストを抑える方法
次のシンプルな例では、レスポンスからusageを取得し、料金表に基づいて1回の呼び出しにかかる費用を見積もります。モデル名は、プラットフォームで実際に利用できるモデルIDに置き換えてください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

resp = client.chat.completions.create(
    model="claude-sonnet-model-id",  # プラットフォームのモデル一覧にある実際のIDに置き換えてください
    messages=[{"role": "user", "content": "总结这段需求文档的要点"}]
)
u = resp.usage
cost = u.prompt_tokens * 2 / 1e6 + u.completion_tokens * 10 / 1e6  # Sonnet 5.5の公表価格
print(resp.choices[0].message.content, f"估算费用: ${cost:.4f}")
完全な実装コードを見る:モデルを使い分けて予算を累計する
import openai

# 単位:米ドル / 100万トークン。Anthropicが公開している料金に基づく
PRICES = {
    "planner": {"model": "claude-fable-model-id", "in": 8, "out": 40},
    "worker":  {"model": "claude-sonnet-model-id", "in": 2, "out": 10},
    "simple":  {"model": "claude-haiku-model-id", "in": 0.10, "out": 0.50},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

class BudgetTracker:
    def __init__(self, limit_usd: float):
        self.limit = limit_usd
        self.spent = 0.0

    def add(self, tier: str, usage) -> float:
        p = PRICES[tier]
        cost = usage.prompt_tokens * p["in"] / 1e6 + usage.completion_tokens * p["out"] / 1e6
        self.spent += cost
        if self.spent > self.limit:
            raise RuntimeError(f"预算超限:已花费 ${self.spent:.2f}")
        return cost

def run(tier: str, prompt: str, tracker: BudgetTracker) -> str:
    resp = client.chat.completions.create(
        model=PRICES[tier]["model"],
        messages=[{"role": "user", "content": prompt}],
    )
    cost = tracker.add(tier, resp.usage)
    print(f"[{tier}] 本次 ${cost:.4f},累计 ${tracker.spent:.4f}")
    return resp.choices[0].message.content

tracker = BudgetTracker(limit_usd=10.0)
plan = run("planner", "把资料整理任务拆成 3 个独立子任务,每行一个", tracker)
results = [run("worker", f"执行子任务:{t}", tracker) for t in plan.splitlines() if t.strip()]
summary = run("planner", "汇总以下结果:\n" + "\n".join(results), tracker)
print(summary)
🚀 まず試すなら:APIYI(apiyi.com)で新規ユーザー向けの無料テストクレジットを受け取り、上の予算追跡スクリプトで「計画—実行—要約」という最小構成を動かしてみるのがおすすめです。実際のトークン使用量を把握してから、エージェントの規模を拡大しましょう。
上記の課金ルールを踏まえると、コストを抑える方法は次の5つにまとめられます。
| 方法 | 実施内容 | 適用上の注意 |
|---|---|---|
| 難易度に応じてモデルを選ぶ | 計画や複雑な推論にはFable 5.2またはOpus 5.5を使う | 公式は、ほとんどのタスクでOpus 5.5から始めることを推奨 |
| 簡単なサブタスクは低価格モデルに切り替える | 分類、フォーマット調整、抽出にはSonnet 5.5またはHaiku 5.5を使う | 低価格モデルの品質が要件を満たすか、事前に検証が必要 |
| Prompt Cachingを有効にする | 共通のSystem Prompt、ツールの説明、長文ドキュメントをキャッシュする | 削減効果は、キャッシュのヒット回数やコンテキストの一貫性によって変わる |
| Fast Modeは必要なときだけ有効にする | 遅延が問題になる対話型リクエストに限定して使う | 料金が2倍になるため、オフライン処理には不向き |
| 予算と使用状況を監視する | モデル、エージェント、タスクごとに使用量を集計し、上限を設定する | 導入が早いほど、想定外の消費に気づきやすい |
Batch APIは、非同期処理が許容される大規模な文書分類、オフラインでのコンテンツ生成、リアルタイム性を求めないデータ分析などに適しています。一方で、長時間稼働するすべてのAgent Sessionに適しているわけではありません。
Claude Fable 5.2のマルチエージェント時代におけるAPIゲートウェイの役割
Vercelは2026年11月9日、Claude Fable 5.2がAI Gatewayに対応したと発表しました。モデルIDは anthropic/claude-fable-5.2 です。マルチモデルゲートウェイの実例として注目できます。AI SDK、OpenAI Chat Completions、OpenAI Responses、Anthropic Messagesなどのインターフェースに対応しており、開発者は統一されたエントリーポイントからモデルを呼び出せます。
ルーティング層では、同じモデルでもAnthropic、AWS Bedrock、Google Vertex AIなどのプロバイダーから選択でき、価格、最初のトークンが返るまでの遅延、スループット速度などを基準に優先順位を設定できます。Vercelが示すフォールバックの例では、まずFable 5.2を呼び出し、安全性分類器によって拒否された場合は、Opus 5.5、Sonnet 5.5の順に切り替えます。さらに、使用量レポート、コスト集計、APIキーの予算設定、リトライ、フェイルオーバーなどの機能も提供しています。
単純なチャットよりも、マルチエージェントシステムでこうした基盤が必要とされるのはなぜでしょうか。チャットなら一度失敗してもユーザーが再送信できます。しかし、数日間にわたって動き続けるAgentワークフローでは、1回の呼び出し失敗がタスク全体を止めてしまう可能性があります。再試行を重ねれば、トークン消費も増えていきます。モデル選択、呼び出し管理、障害時の切り替え、コスト集計は、マルチエージェントの場面では「あれば便利」な機能から必須の機能へと変わります。
🎯 技術的なアドバイス:中国国内の開発者にとって、APIYI(apiyi.com)は、同様の考え方に基づくマルチモデル接続レイヤーを提供しています。1つのAPIキーでOpenAI、Claude、Geminiなどの主要モデルを利用でき、OpenAI互換インターフェースによって、各プロバイダー間のインターフェースの違いを抑えられます。また、従量課金制のため、Agentやタスクごとにコストを分けて計算しやすくなっています。
Claude Fable 5.2のデータ保持:企業のマルチエージェントアプリにおけるコンプライアンス上の課題
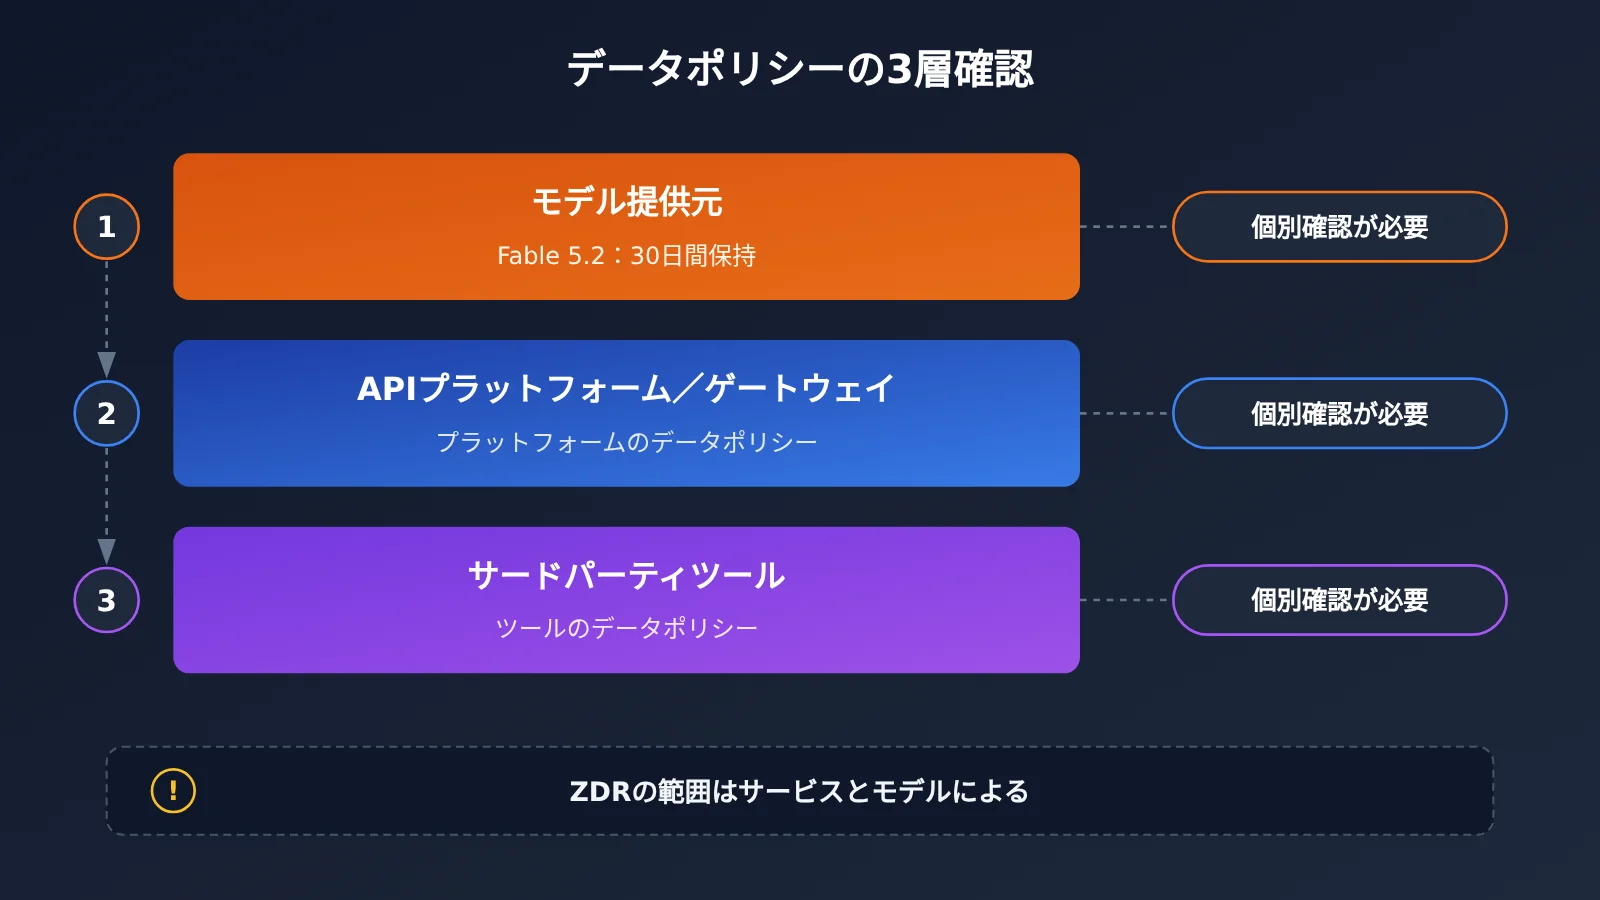
コストだけでなく、企業の開発者はデータコンプライアンスにも注意する必要があります。Anthropicの公式データ保持ドキュメントによると、Fable 5.2は30日間のデータ保持が必要なCovered Modelに該当し、デフォルトでゼロデータ保持(ZDR)に対応しているわけではありません。
具体的なルールは次のとおりです。デフォルトでは、Anthropicから明示的な許可を得ない限り、組織はZDRの適用下でこのモデルを呼び出せません。プロンプトとモデルの出力は、適用されるポリシーに従って30日間保持されます。保持されたデータが、明示的な許可なくモデルのトレーニングに使われることはありません。条件を満たすZDR組織は、特定のWorkspaceで30日間のデータ保持を有効にすることで、このモデルを利用できます。Vercelの導入告知でも、この要件について明確に注意喚起されています。
混同しやすい点として、モデル提供元のデータポリシーと、サードパーティのAPIゲートウェイのデータポリシーは別物です。APIプラットフォーム自体がZDR機能を提供していても、接続先のすべてのモデルがZDRに対応しているとは限りません。機密性の高い業務データを扱う企業は、モデル提供元、APIプラットフォーム、サードパーティツールそれぞれのデータ処理ポリシーを確認しましょう。モデルの単価だけを比較するのでは不十分です。
よくある質問(FAQ)
Q1:Claude Fable 5.2 の1,000 Agentオペレーティングシステム実験には、いくらかかりましたか?
Anthropicは公開していません。実験全体のトークン消費量、計算コスト、総費用は公式に明らかにされておらず、インターネット上にある具体的な数字も公式情報ではありません。
Q2:マルチAgentは、シングルAgentより必ず3〜10倍高くなりますか?
必ずしもそうではありません。これは、同じタスクにおける典型的な比較範囲としてAnthropicが示したもので、固定の倍率ではありません。実際の倍率は、コンテキストの重複度、タスクの引き継ぎ回数、モデルの選択、キャッシュのヒット状況によって変わります。
Q3:Session RuntimeはAgentごとに課金されますか?
いいえ。Managed Agentsは、各Sessionがrunning状態にある時間に応じて課金されます。料金は1 Sessionあたり1時間$0.08で、idle状態、確認待ち、終了後の時間は課金対象外です。複数のSessionを利用する場合は、それぞれの実際の稼働時間に基づいて計算し、合算します。
Q4:Batch APIの50%割引はManaged Agentsにも適用されますか?
適用されません。Batchの割引は、Messages APIの非同期バッチリクエストが対象です。Managed Agentsは状態を保持するインタラクティブなSessionのため、割引は適用されません。また、Fast ModeとBatch APIを同時に使用することもできません。
Q5:複数モデルで役割分担した場合の実コストを、手早くテストするにはどうすればよいですか?
次の3つの手順がおすすめです。
1. APIYI(apiyi.com)に登録し、APIキーと無料テスト枠を取得します
2. この記事のコードで`base_url`を`https://api.apiyi.com/v1`に設定し、プラットフォームで利用可能なモデルIDに置き換えます
3. 予算追跡スクリプトで小規模なタスクを実行し、各階層のモデルにおける実際のトークン分布を記録します
Q6:Claude Fable 5.2を利用する際、どのような制限に注意すべきですか?
まず、料金が高く、出力は$40/MTokのため、すべてのサブタスクを担わせるのには向いていません。次に、Fast Modeでは料金が2倍になります。さらに、データ保持期間として30日が求められ、デフォルトではZDRの条件下で呼び出すことはできません。機密データを扱う前に、必ずコンプライアンス要件を確認してください。
Claude Fable 5.2 マルチAgentのコスト:重要ポイント
- 請求額は非公開:1000 Agentのオペレーティングシステム実験にかかった実際の費用は、Anthropicから公表されていません
- 単価は20%値下げ:Fable 5.2の標準料金は、入力が100万Tokenあたり$8、出力が100万Tokenあたり$40です
- コストは膨らみやすい:同じタスクでも、マルチAgentのToken消費量は一般にシングルAgentの3〜10倍です
- RuntimeはSession単位で課金:Session 1時間あたり$0.08で、Agentの数ではなく実行時間のみが課金対象です
- 割引には適用範囲がある:Batchの50%割引はManaged Agentsには適用されません。キャッシュによる節約効果は、ヒット率によって変わります
- コンプライアンスにも注意:Fable 5.2では30日間のデータ保持が必要で、ZDRの利用には追加の承認が必要です
- まず測定してから拡大:APIYI(apiyi.com)の統一インターフェースを活用し、複数モデルにタスクを分担させた場合の実際のToken使用量を検証できます
まとめ
Claude Fable 5.2の1000 Agent実験をきっかけに、開発者のコストに対する視点は、「1回の呼び出しにいくらかかるか」から「ワークフロー全体でいくらかかるか」へと移りつつあります。押さえておきたいポイントは次のとおりです。
- コストは複数の要素が積み重なって発生する:メインAgent、サブAgent、コンテキストの重複、検証、再試行、Session Runtime、ツール呼び出しなどが、合計請求額を構成します。
- モデルの役割分担がコストを大きく左右する:最も高性能なモデルは計画や重要な推論に限定し、実行系のサブタスクはより低価格なモデルに任せましょう。
- 課金ルールを正しく理解する:RuntimeはSessionの実行時間に応じて課金され、BatchはManaged Agentsには適用されません。また、キャッシュの費用対効果を得るには、十分な回数のヒットが必要です。
- コンプライアンスも価格と同じくらい重要:30日間のデータ保持やZDRの制限は、モデル選定の段階から考慮しましょう。
マルチAgentアプリケーションが複雑になるほど、安定したモデル接続、明確な使用量の把握、信頼性の高い障害切り替えが重要になります。APIYI(apiyi.com)の統一インターフェースを利用して複数モデルの分担方法をすばやく検証し、実際のToken使用量に基づいて予算を立ててから、Agentの規模を段階的に拡大することをおすすめします。
📚 参考資料
- Anthropicの発表:Claude Fable 5.2 and Mythos 5.2
- リンク:
anthropic.com/claude-fable-and-mythos-5-2 -
説明:1,000体のAgentを使ったオペレーティングシステム実験に関する公式発表
-
Claude Platformのモデル仕様と料金:Fable 5.2 Overview
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview -
説明:料金、コンテキストウィンドウ、Effortなどの仕様
-
Claude Managed Agentsの料金:Session Runtimeの課金ルール
- リンク:
platform.claude.com/docs/en/about-claude/pricing -
説明:Runtime、Web Search、およびAPIの全料金
-
Prompt Cachingのドキュメント:キャッシュの書き込みと読み込みについて
- リンク:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
説明:自動キャッシュと明示的なキャッシュブレークポイント
-
APIのデータ保持ポリシー:Covered ModelとZDR
- リンク:
platform.claude.com/docs/en/manage-claude/api-and-data-retention -
説明:データを30日間保持する要件の公式根拠
-
Vercel AI Gatewayの接続発表:Fable 5.2の提供開始について
- リンク:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway - 説明:複数プロバイダーへのルーティング、Fallback、コスト管理の事例
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI公式サイトのトップページからお気軽にお問い合わせください。接続に関する詳しい資料は、ドキュメントセンター(docs.apiyi.com)をご覧ください。