著者注:DeepSeek が Super-agent の研究プロトタイプをオープンソース公開しました。Claude Code や Codex との本当の違いはどこにあるのでしょうか?この記事では、モデル・プログラミングツール・スケジューリングシステムという3層の能力を6つの観点から整理し、働き方に合ったツールの選び方を紹介します。
2026年10月31日、DeepSeek Harness チームは技術記事「Super-agent の設計探究:より自律的な Agent システムに向けて」を公開し、公式 GitHub で関連プロトタイプ dsh-superagent-prototype を MIT ライセンスのもとでオープンソース公開しました。常駐する Router と独立した Worker による2層のスケジューリングアーキテクチャはたちまち話題となり、Bloomberg やサウスチャイナ・モーニング・ポストなどのメディアは、Claude Code や Codex との競争という文脈で報じました。
この記事は、単に「どれがどれに取って代わるか」を論じるものではありません。リポジトリ自体に研究プロトタイプと明記されており、Claude Code と Codex も、すでに単一セッションだけのツールではなくなっています。DeepSeek Super-agent を Claude Code や Codex と比較する際に本当に問うべきなのは、その違いが基盤モデルによるものなのか、それとも Agent のスケジューリングシステムによるものなのか、という点です。
この記事でわかること:3つのツールがそれぞれどの層に位置するのか、DeepSeek の設計上の重点が実際に何を意味するのかを理解し、自分の働き方に合ったツールの組み合わせを選べるようになります。
DeepSeek Super-agentの主要情報
まず、事実関係を整理しておきましょう。DeepSeek Super-agentは新しい基盤モデルではなく、大規模言語モデルを中心に構築されたAgentシステムのアーキテクチャです。現在公開されているのは研究用プロトタイプであり、正式な商用製品ではありません。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026年10月31日(技術記事とリポジトリを同日公開) |
| 公開元 | DeepSeek Harnessチーム |
| プロジェクト名 | deepseek-ai/dsh-superagent-prototype。主にTypeScriptを使用 |
| オープンソースライセンス | MIT。無料でダウンロード・改変でき、ライセンス上の義務を満たせば商用プロジェクトでも利用可能 |
| プロジェクトの状態 | 研究用プロトタイプ。正式な製品のリリース日や専用のサブスクリプション料金は未発表 |
| 実行に必要な環境 | DeepSeek Harness環境と、設定済みのモデルプロバイダー |
| 現在の対象範囲 | 単一のGitHubリポジトリを監視し、オプションで飛書と連携。IssueからPRまで作業を進める |
11月2日時点で、プロジェクトページには約8,900のStarと898のForkが表示されており、この数字は今も変動しています。Star数が示すのはあくまで注目度であり、実際のインストール数やコーディングの成功率を示すものではありません。
DeepSeek Super-agentは何を解決しようとしているのか
DeepSeekチームの着眼点は興味深いものです。モデルが単一のタスクをこなす能力を高めるにつれ、効率を制限する要因がモデルの能力から人間の注意力へと移りつつあります。チームは自らの経験に基づき、一人が効果的に管理できる稼働中のAgentセッションは通常3〜5件程度だと考えています。その理由として、コンテキストの分散、頻繁なウィンドウの切り替え、タスク終了後に人が次の指示を出す必要があること、ツール呼び出しによるセッションの停止、端末のスリープによるタスクの中断などを挙げています。
この3〜5セッションという数字はDeepSeekチームの経験に基づく見解であり、業界全体の統計ではありません。ただし、Super-agentの研究の方向性は明確に示しています。目指しているのはモデルをさらに賢くすることではなく、セッションのスケジューリング、イベント処理、コンテキスト管理を「人」から「システム」へ移すことです。そのために公式が掲げているのが、Continuous(連続性)、Productive(高い生産性)、Proactive(能動性)、Persistent(永続性)という4つの特徴です。これらは設計目標であり、プロトタイプですべて実現済みという意味ではありません。
DeepSeek Super-agent と Claude Code、Codex の比較:まず3つのレイヤーを整理
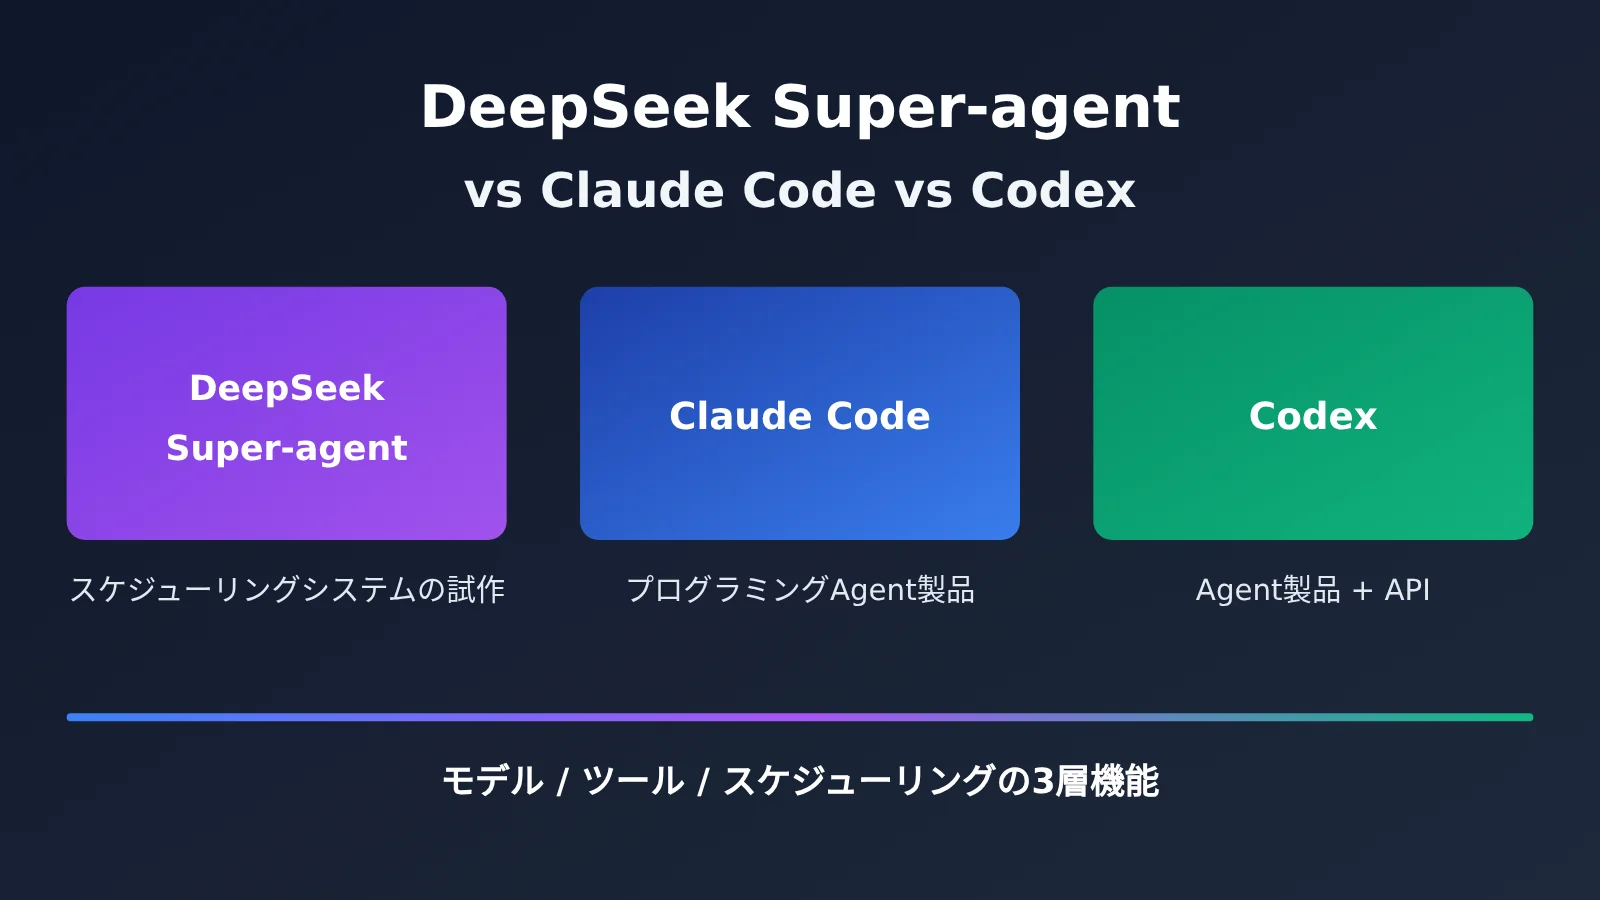
「どれが強いか」を考える前に、3つは完全に同じ製品レイヤーにあるわけではない、という点を押さえておきましょう。Claude Code と Codex は、プログラミング作業向けのエージェント製品およびツールエコシステムです。一方、Super-agent はエージェントの外側に、常時オンラインでイベント駆動型の、複数タスクを調整する仕組みを構築することに重点を置いています。実際の推論やツールの実行は、基盤となるモデルと DeepSeek Harness に依存します。
そのため、比較は3つのレイヤーに分ける必要があります。モデルの能力は個々の推論やコード生成の品質を左右し、プログラミングツールの能力はファイルの読み書き、テストの実行、PRの作成ができるかを左右します。そして、スケジューリングシステムの能力は、複数のタスクをどのように受け付け、振り分け、追跡し、成果物を届けるかを左右します。この3つを混同して比較すると、誤解を招く結論に至りかねません。
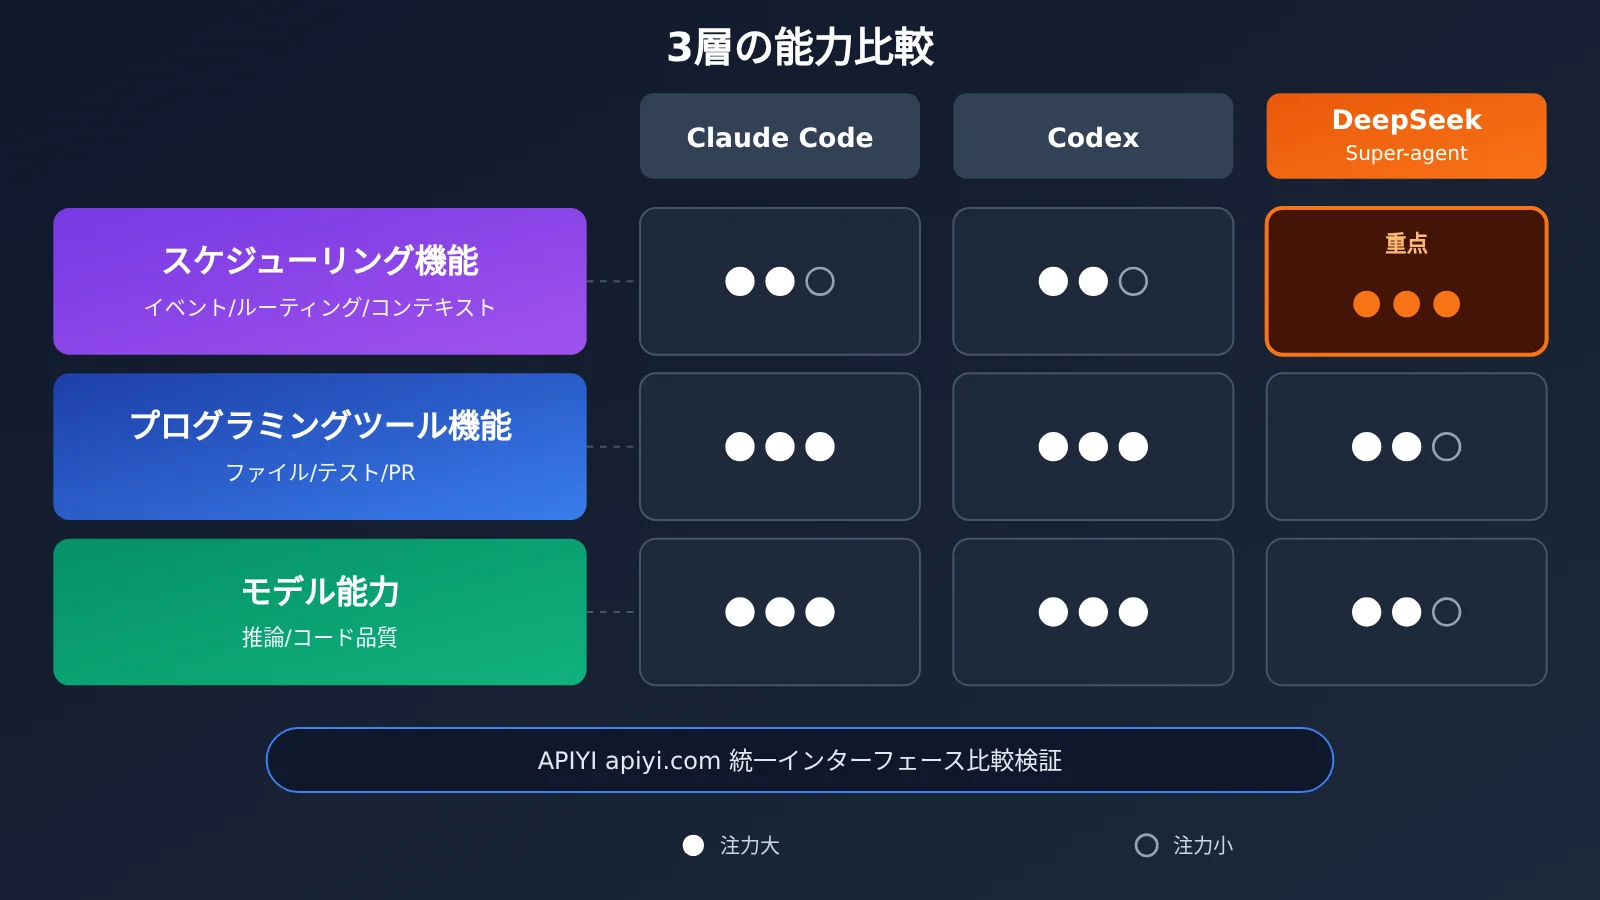
以下では、現在公開されている能力や仕組みを6つの観点から比較します。この表が比較しているのは「仕組み」であり、同一条件下での性能ランキングではない点に注意してください。
| 比較項目 | DeepSeek Super-agent プロトタイプ | Claude Code エコシステム | Codex / OpenAI エコシステム |
|---|---|---|---|
| 単一タスクのプログラミング | Harness と選択したモデルに依存し、Worker が実行 | 成熟したプログラミングエージェント。CLI、デスクトップ、クラウドに対応 | 成熟したプログラミングエージェント。ローカルとクラウドに対応 |
| マルチエージェント連携 | Router + Worker の2層構成 | Subagents、実験的な Agent Teams | 並列セッション、Worktrees。Multi-agent は API の機能 |
| イベントによるトリガー | GitHub、オプションで飛書 | GitHub Actions、Channels(研究プレビュー) | 対応アプリのイベント自動化、GitHub Actions ワークフロー |
| バックグラウンドでの継続実行 | Worker セッション。デバイスをまたいだ継続実行は引き続き設計を検討中 | バックグラウンドエージェント、クラウドの定期実行タスク | クラウドタスク、バックグラウンドの定期実行タスク |
| コンテキスト管理 | 常駐する Router が全体のコンテキストを維持し、Worker は分離 | サブエージェントごとに独立したコンテキスト、チームで共有するタスクリスト | クラウドタスクごとにワークスペースを分離し、メインエージェントが取りまとめ |
| 導入コスト | 自己ホスト。Node.js、tmux、専用の GitHub アカウントなどが必要 | 正式製品で、導入のハードルは低い | 正式製品で、導入のハードルは低い |
各項目が意味することはそれぞれ異なります。「単一タスクのプログラミング」は日々のコーディング体験を左右します。「イベントによるトリガー」と「バックグラウンドでの継続実行」は、目を離している間もエージェントに作業を任せられるかに関わります。「コンテキスト管理」はタスクが増えたときに情報が互いに混ざらないかを左右し、「導入コスト」はチームが最初に時間を投資するかどうかに直結します。
Claude Code のマルチエージェント機能も決して弱くない
Anthropic の公式ドキュメントによると、Claude Code の Subagents はそれぞれ独立したコンテキストウィンドウを持ち、専用のシステム指示、利用できるツールの制限、異なるモデルの指定が可能です。調査や一部の実装タスクをバックグラウンドで並列に進めることもできます。実験的機能の Agent Teams はさらに一歩進んだ仕組みです。1つの Lead と複数の Teammate がそれぞれ独立した Claude Code セッションとして動作し、タスクリストを共有するほか、Teammate 同士で直接メッセージをやり取りできます。この機能はデフォルトでは無効で、調整の手間やトークン消費が増えることも公式に注意喚起されています。
イベントへの対応や継続的な実行についても、claude-code-action は Issue や PR コメント内の @claude に反応し、適切に設定すれば Issue をもとに PR を作成できます。Channels はリサーチプレビューとして提供されており、MCP を通じてチャットメッセージ、Webhook、CI の結果を実行中のセッションに届けます。ただし、セッションを実行したままにしておく必要があります。このほか、セッション内の /loop、デスクトップ版のスケジュールタスク、クラウドのスケジュールタスクもあります。一部のタスクは、ローカルマシンを閉じた後もクラウドで実行を続けられます。つまり、「Claude Code は受け身で入力を待つことしかできない」というのは、もはや古いイメージです。
Codex のマルチタスク機能:製品と API は分けて考える
Codex は Git Worktree を使い、同じプロジェクトに複数の独立した作業ディレクトリを作成できます。これにより、異なるセッションが別々のブランチを並行して変更できます。Codex Cloud は隔離されたワークスペースでコードの分析、変更の実装、テストの実行を行い、ローカルマシンを閉じた後もクラウド上でタスクを継続できます。ChatGPT/Codex のエコシステムでは、バックグラウンドのスケジュールタスクに加え、対象ユーザー向けに GitHub などのアプリイベントをトリガーとする実行や PR アクティビティのフィルタリングにも対応しています。
ここで混同しやすい点があります。OpenAI Agents API と Responses API が提供するマルチエージェント機能(メインエージェントによるサブエージェントへのタスク委任や、サブエージェントの独立したコンテキスト)は API の機能であり、Codex のすべての製品インターフェースに標準で備わっている機能と同一視することはできません。同様に、OpenAI Cookbook で紹介されている「CI の失敗後に GitHub Actions から Codex CLI を呼び出して修正 PR を作成する」という方法は、ワークフローの構築例であり、Codex CLI に標準搭載された機能ではありません。
DeepSeek Super-agent の Router + Worker によるタスク振り分け
DeepSeek プロトタイプの基本フローは、Source → Trigger → Eval → Ticket → Assignment → Executor → Result と表せます。GitHub や飛書から届いたイベントは、まず決定的なルールによる権限フィルタリングを通過し、続いてモデルがタスクを作成する必要があるかを判断します。受け付けられたタスクは独立した Ticket となり、それぞれ専用の作業ディレクトリを持つ Worker に割り当てられます。結果は、たとえば GitHub PR として、元のチャネルに返されます。
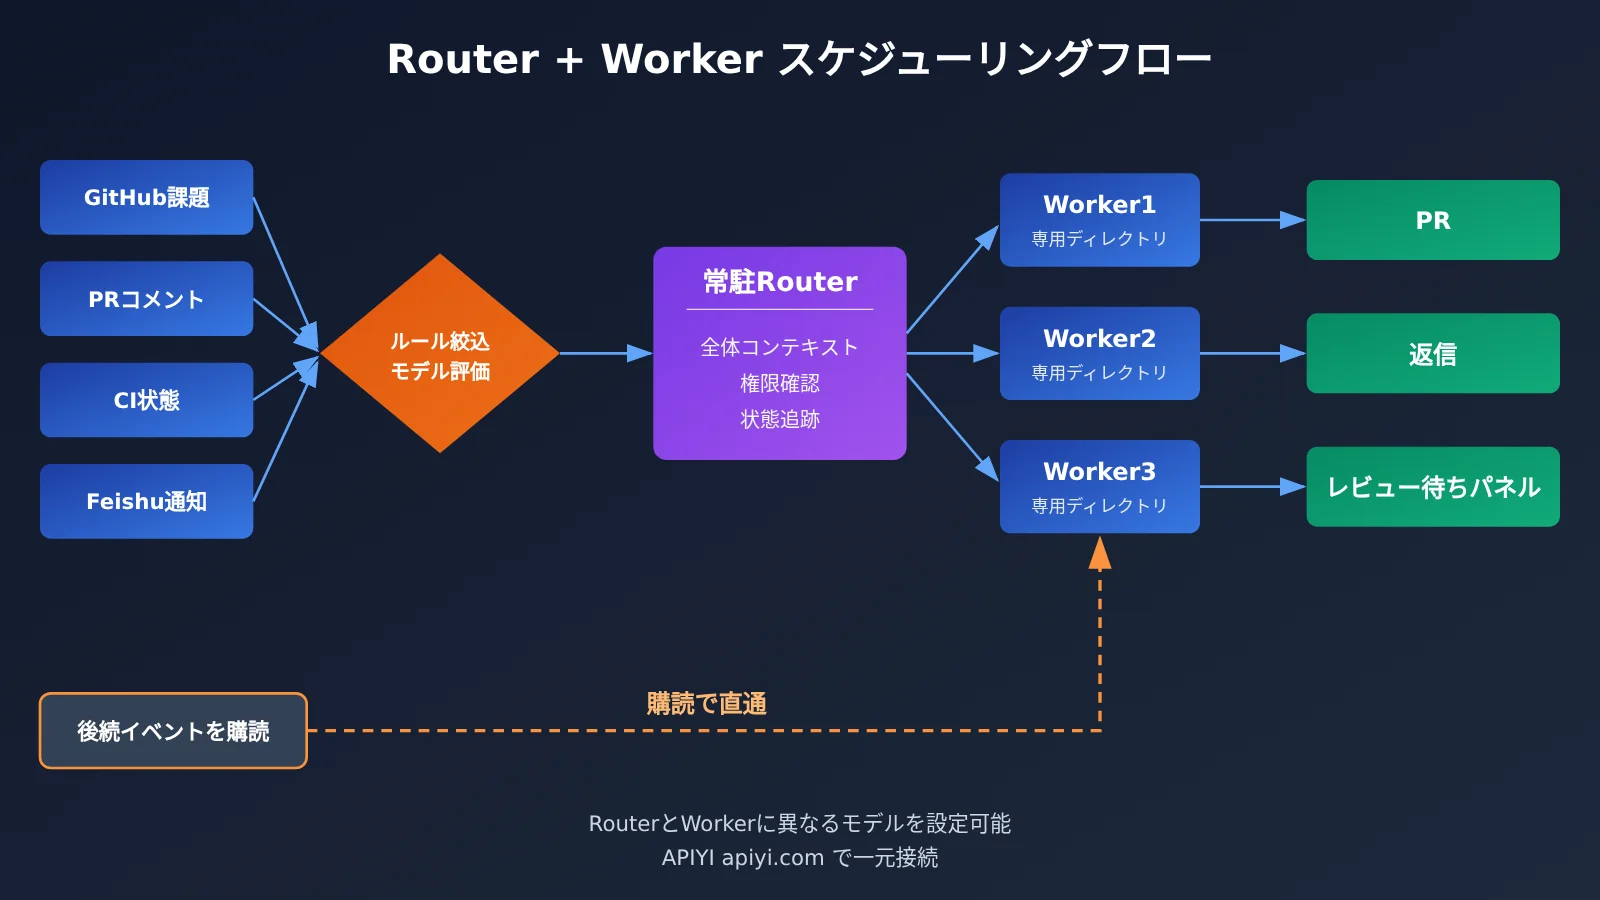
Router は長期間稼働するメインセッションで、メッセージの受信、グローバルコンテキストの維持、タスク作成の判断、権限チェック、タスクの割り当てと追跡を担い、原則として複雑なコーディングは行いません。公式では、この役割分担により、場合によっては Router に比較的軽量なモデルを採用し、タスク振り分けのコストを抑えられるとしています。一方、Worker は明確な作業指示を受け取り、分離されたディレクトリでコードの作成、テストの実行、後続のフィードバックへの対応を行い、結果を提出します。
本当の違い:DeepSeek Super-agent のスケジューリングシステムが重視すること
Claude Code と Codex にも、すでにマルチエージェント、バックグラウンド実行、イベント処理の機能があります。では、DeepSeek はどこで差別化しているのでしょうか。答えは機能の「有無」ではなく、「誰がタスクを管理するか」と、その管理範囲にあります。
一般的なメインエージェントによるサブタスクの割り当てや、Agent Team の Team Lead は、単一の複雑なタスクの計画、調整、結果の統合に深く関わります。一方、DeepSeek の Router が重視するのは、タスクをまたぐ高レベルの調整です。常駐する Router が比較的独立した複数の作業を同時に管理するため、ユーザーは論理上の一つの Super-agent を窓口として、GitHub や飛書などの業務チャネルで直接やり取りできます。Worker のセッションを一つひとつ自分で管理する必要はありません。
DeepSeek の公式資料も、Agent Team のメインエージェントを全体的なやり取りと割り当てだけに専念させ、自らは実行しないように設定すれば、同様の二層アーキテクチャを構築できると率直に認めています。つまり、Router + Worker は他では実現できない独自の機能ではありません。本当の違いは、常駐監視、タスク間のルーティング、作業コンテキストの統一をどこまでシステム化しているかにあります。具体的には、次の3点です。
- 常駐 Router:タスクごとに立ち上がる一時的な調整役ではなく、長期間オンラインのメインセッションとして存在します。全体のコンテキストをタスク間で引き継げます。
- イベント購読の直接配信:特定の Thread を購読している Worker は、後続のイベント(同じ PR への新しいコメントなど)を直接受信できます。これにより、Router による繰り返しの割り当てを減らせます。
- 慎重な自律性:タスクは Explicit(明示的な依頼)と Inferred(推論された候補)に分けられます。推論された作業はデフォルトで
observeモードとなり、記録のみで実行はされません。PR の自動マージもデフォルトではオフです。
DeepSeek Super-agent の公式実験データをどう読むか
DeepSeek は、合成データを使ったスケジューリング実験を行いました。各回のメッセージは約300件で、そのうち約20件が作業依頼、残りは雑談、追加フィードバック、キャンセル、CI メッセージです。プログラミング作業は、実行に時間のかかるシミュレーションツールで代替し、各方式を5回ずつ実行しています。
| 方式 | P50 完了時間 | P95 完了時間 | 1回あたりのキャッシュ読み取り Token |
|---|---|---|---|
| Super-agent | 12.4 分 | 15.7 分 | 約2320万 |
| Super-agent、購読の直接配信を除去 | 12.6 分 | 15.5 分 | 約3180万 |
| 単一 Session + Subagent、中立的なプロンプト | 20.4 分 | 29.5 分 | 約610万 |
| 単一 Session + Subagent、委譲を優先 | 13.8 分 | 29.0 分 | 約1080万 |
このデータから読み取れる重要な点は二つあります。一つ目は、委譲を優先した単一セッション方式と比べると、Super-agent の P50 の優位性は小さいものの、P95 の長い待ち時間は明らかに短いことです。二層アーキテクチャの主なメリットは、「タスクが増えても遅延を引きずりにくい」点にあると考えられます。二つ目は、購読の直接配信を除去しても完了時間はほぼ変わらない一方、キャッシュ読み取りは約2320万から約3180万に増えたことです。直接配信の主な役割は、高速化ではなく、Router による処理の重複を減らすことだと分かります。
ただし、実験の範囲は明確にしておく必要があります。これはスケジューリングの実験であり、コード生成の品質テストではありません。対照群も、特定のプロンプトを使った単一 Session + Subagent であって、Claude Code や Codex の製品全体を同じ条件で実測したものではありません。したがって、実際のプログラミング効率が39%または47%向上すると証明するものではなく、ましてや三者の速度ランキングを作る根拠にはなりません。公式の別の Router バッチ処理テストでは、イベントが毎分約40件の場合、平均バッチサイズは2.8に増え、意思決定1件あたりの推論時間は1.6秒に下がりました。これも、あくまでそのテスト負荷における実用性を示すものです。
DeepSeek Super-agent のコストとセキュリティ上の注意点
高速化の代償は、Token 消費量の増加です。合成テストでは、Super-agent のキャッシュ読み取り量は、中立的な単一セッション方式の約 3.8 倍でした。ただし、総費用が 3.8 倍になるわけではありません。最終的な費用は、モデルの料金、キャッシュヒット率、入出力 Token 量、Router と Worker がそれぞれ使用するモデルによって変わります。実際の工数チケット 1 件あたりの平均費用も、公式にはまだ公表されていません。
参考として、2026 年 11 月 2 日時点の DeepSeek 公式 API の料金を以下に示します(米ドル/100 万 Token)。これはモデルの利用料金であり、Super-agent の料金プランではありません。
| モデルと時間帯 | 入力キャッシュ未ヒット | 入力キャッシュヒット | 出力 |
|---|---|---|---|
| DeepSeek V4.1 Flash オフピーク | $0.15 | $0.003 | $0.60 |
| DeepSeek V4.1 Flash ピーク | $0.30 | $0.006 | $1.20 |
| DeepSeek V4 Pro オフピーク | $0.66 | $0.022 | $1.98 |
| DeepSeek V4 Pro ピーク | $1.32 | $0.044 | $3.96 |
また、Search と Fetch はそれぞれ、成功したリクエスト 1,000 回あたり $0.75 です。2026 年 11 月 1 日の北京時間 00:00 から課金が始まり、実際に呼び出した場合にのみ費用が発生します。デプロイする側は、サーバーリソース、継続運用、人的メンテナンスのコストも考慮する必要があります。Claude Code と Codex には、サブスクリプション、API、クラウド実行などの異なるプランがあり、現時点では 3 者を共通の「条件を満たす PR 1 件あたりのコスト」で比較することはできません。
💰 コスト管理のヒント:マルチエージェント構成の費用を左右するのは、「どの役割にどのモデルを使うか」です。Router に軽量モデル、Worker に高性能モデルを使う組み合わせを自分で試したい場合は、APIYI apiyi.com を通じて、1 つの APIキーで複数の主要モデルにアクセスできます。従量課金のため、さまざまな組み合わせの Token 消費を同じ請求書で確認しやすくなります。
セキュリティ面も見逃せません。公式デプロイドキュメントによると、Router と Worker の専用プリセットは danger-full-access モードで動作し、デフォルトでは操作者のシステムユーザー権限で実行されます。そのため、ホームディレクトリ内のファイルを読み取ったり、ローカルプログラムを実行したり、ローカルの認証情報にアクセスしたりする可能性があります。公式は、専用のシステムユーザーと GitHub ボットアカウントの使用を推奨しています。外部のコメントやメッセージを監視する場合は、プロンプトインジェクションのリスクもあります。コミュニティでは、コミット 6337fc8 を対象とした第三者監査レポートも公開され、管理インターフェースの検証などに関する潜在的な問題が指摘されています。ただし、攻撃の全過程は独立して再現されていないため、実際に発生した事件ではなく「潜在的なリスク」として捉えるべきです。
DeepSeek Super-agent の影響分析
開発者への影響
- 評価の観点を広げる必要がある:ツールを選ぶ際は、基盤モデルのスコアだけでなく、イベント連携、タスクの分離、バックグラウンド実行、人的レビューの仕組みがチームのワークフローに合っているかも確認する必要があります。
- プロトタイプは使えるが、手放しでは使えない:コミュニティユーザーの xxxxkkkqq は、プライベートリポジトリで Issue を PR まで進めることに成功した一方、通知を受信できない、デプロイのチェックは正常なのにメッセージが届かない、システム言語が中国語のためテストのアサーションが失敗する、といった問題にも遭遇しました。別のユーザーは WSL2 上で、Node.js 24 のプロセス認識と GitHub コメントの受信漏れに関する2つの不具合を1時間以内に発見しています。
- 追加開発の参考として価値が高い:TypeScript、GitHub 連携、モデル API を保守できるチームにとっては、Router、イベント、チケット、Worker、権限ルールを網羅したリファレンス実装になります。
業界への影響
- 競争の焦点が広がる:AI コーディングの競争は、もはやモデル同士の比較だけではありません。Agent Harness、ワークフロー設計、開発者体験も同じくらい重要な要素になりつつあります。
- 「自律的に動く Agent」の運用が規範化へ:DeepSeek は「自律的な作業」を権限ポリシー、observe モード、人による検収と結び付けることで、「Agent がチームの注意を無駄に奪わないか」という現実的な懸念に応えています。
こうした機能を踏まえると、作業スタイルに応じて次のように選択できます。
| 作業スタイル | おすすめの組み合わせ | 理由 |
|---|---|---|
| 日常的な単一タスクのコーディング | Claude Code または Codex | 正式な製品で導入しやすく、スケジューリングシステムのデプロイも不要 |
| 複数の独立したタスクの並行処理 | Claude Code Agent Teams / バックグラウンド Agent、Codex Worktrees / クラウドタスク | 並行処理と分離の仕組みがすでに成熟している |
| 継続的なイベント監視と統一ルーティングの研究 | DeepSeek Super-agent のプロトタイプ | 常駐 Router とイベント購読の設計を最も直接的に確認できる |
| Agent オーケストレーションシステムの自社構築 | オープンソースのプロトタイプ + 複数のモデル API | スケジューリングロジックやモデルの役割分担をカスタマイズできる |
| 機密性の高い本番リポジトリ | 現時点では研究用プロトタイプの直接利用は非推奨 | 高い権限での実行やセキュリティの問題がまだ解決されていない |
🎯 選び方のヒント:ツールの組み合わせは排他的ではありません。多くのチームでは、日常のコーディングを Claude Code や Codex に任せ、イベント処理やルーティングを自社構築のスケジューリング層で担うこともできます。自社構築の際は、まず APIYI(apiyi.com)で無料のテスト枠を取得し、異なるモデルを Router や Worker として使った場合の効果を比較できます。
API で DeepSeek Super-agent の Router の考え方を再現する
スケジューリングシステムを理解するには、最小限のバージョンを実際に作ってみるのが一番です。以下の例では、OpenAI 互換インターフェースを使い、「軽量モデルによるルーティング判断」を実装します。あくまで考え方を示すものであり、DeepSeek のプロトタイプの実際のコードではありません。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

event = "PR #42 评论:CI 在 test_auth.py 失败,请帮忙看看"
resp = client.chat.completions.create(
    model="ROUTER_MODEL",  # コンソールで利用可能な軽量モデル名に置き換える
    messages=[{"role": "user", "content": f"判断该事件是否需要建任务,只回答 YES/NO:{event}"}]
)
print(resp.choices[0].message.content)
Router + Worker の完全なサンプルコードを見る
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 1つのキーで複数のモデルにアクセス
)

ROUTER_MODEL = "ROUTER_MODEL"   # 軽量モデル:ルーティング判断を担当
WORKER_MODEL = "WORKER_MODEL"   # 高性能モデル:具体的なタスクを担当
AUTHORIZED_USERS = {"alice", "bob"}  # 決定論的ルール:許可リスト

@dataclass
class Ticket:
    thread_id: str
    task: str
    history: list = field(default_factory=list)

tickets: dict[str, Ticket] = {}

def router_eval(event: dict) -> bool:
    """先规则过滤,再由模型判断是否建任务"""
    if event["user"] not in AUTHORIZED_USERS:
        return False  # 未認可:監視のみで実行しない
    resp = client.chat.completions.create(
        model=ROUTER_MODEL,
        messages=[
            {"role": "system", "content": "你是任务路由器,只回答 YES 或 NO。"},
            {"role": "user", "content": f"该消息是否是需要执行的工作请求?\n{event['text']}"}
        ],
        max_tokens=5
    )
    return "YES" in resp.choices[0].message.content.upper()

def worker_run(ticket: Ticket, text: str) -> str:
    """Worker 使用独立上下文处理任务"""
    ticket.history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model=WORKER_MODEL,
        messages=[{"role": "system", "content": "你是代码修复助手,给出修复思路。"}] + ticket.history
    )
    answer = resp.choices[0].message.content
    ticket.history.append({"role": "assistant", "content": answer})
    return answer

def handle(event: dict) -> str:
    tid = event["thread_id"]
    # 購読による直接転送:Ticket が存在する後続イベントは対応する Worker に直接渡す
    if tid in tickets:
        return worker_run(tickets[tid], event["text"])
    if router_eval(event):
        tickets[tid] = Ticket(thread_id=tid, task=event["text"])
        return worker_run(tickets[tid], event["text"])
    return "已记录,未建任务"

print(handle({"thread_id": "pr-42", "user": "alice", "text": "CI 在 test_auth.py 失败"}))
print(handle({"thread_id": "pr-42", "user": "alice", "text": "补充:只在 Python 3.12 下失败"}))
この例では、決定論的ルールをモデルによる判断より先に適用すること、Router と Worker で異なるモデルを使うこと、同じ Thread の後続イベントを既存の Worker のコンテキストに直接渡すことの3点を示しています。実際のシステムには、作業ディレクトリの分離、権限のサンドボックス化、状態の永続化、人的レビューも必要です。これらはプロトタイプでも引き続き改善が進められている部分です。
🚀 すぐに試してみる:上記のコードは APIキーとモデル名を置き換えるだけで実行できます。現在利用可能なモデルの一覧は、APIYI apiyi.com のコンソールで確認できます。新規ユーザー向けの無料テスト枠もあるため、まずは低コストでスケジューリングの考え方を検証し、その後に追加開発に取り組むかどうかを判断できます。
よくある質問 FAQ
Q1:DeepSeek Super-agent は新しいモデルですか?
いいえ。Super-agent は、モデルとは別の Agent システムアーキテクチャです。オープンソースとして公開されているのは、DeepSeek Harness をベースにした研究用プロトタイプです。特定の DeepSeek モデルを使う必要はなく、Router と Worker のそれぞれに、設定でモデルプロバイダーとモデルを指定できます。
Q2:DeepSeek Super-agent は Claude Code や Codex に取って代わりますか?
現時点では、そう言える根拠はありません。3つは役割が異なります。Claude Code と Codex は成熟したコーディング Agent 製品であるのに対し、Super-agent は外側からの継続的なタスク管理に重点を置いています。11月2日時点では、同じ条件で行われた大規模なコーディング性能の公開比較もなく、公式の合成実験を3者の性能比較として扱うことはできません。
Q3:Claude Code と Codex でもイベントをきっかけにした処理やバックグラウンドタスクを実行できますか?
はい、できます。Claude Code には GitHub Actions、リサーチプレビュー版の Channels、バックグラウンド Agent、クラウドでの定期タスクがあります。Codex のエコシステムには、クラウドタスク、Worktrees、バックグラウンドの定期タスク、対応アプリのイベント自動化があります。違いは、機能の有無ではなく、利用する入口や利用資格、実装の仕組みにあります。
Q4:DeepSeek Super-agent のプロトタイプは無料ですか?
コードは MIT ライセンスで無料公開されていますが、モデル呼び出しには引き続きトークン単位の料金がかかるほか、サーバー、保守、人による確認のコストも発生します。オープンソースだからといって、各タスクの総コストが必ず低くなるわけではありません。複数モデルの API 費用を一元管理したい場合は、APIYI apiyi.com を通じて従量課金で呼び出し、使用量をまとめて確認できます。
Q5:Router + Worker による複数モデルの役割分担を低コストで試すには?
この記事のサンプルコードを参考に、`base_url` を `https://api.apiyi.com/v1` に設定し、軽量モデルにルーティングを、高性能なモデルに実行を担当させる方法があります。APIYI apiyi.com に登録すると無料のテスト枠を利用でき、1つの APIキーで OpenAI、Claude、Gemini などの主要モデルを切り替えて比較できます。
Q6:DeepSeek Super-agent のプロトタイプには、どのような既知の制限がありますか?
現在、監視できるのは単一の github.com リポジトリのみで、GitHub Enterprise Server には対応していません。デプロイには Node.js 22.19+ または 24+、tmux、GitHub CLI 2.48+、専用のボットアカウントが必要です。Worker はデフォルトで高い権限を持って動作するため、プロンプトインジェクションや認証情報に関するリスクがあります。また、コミュニティからは通知の欠落や Node.js 24 との互換性などの問題も報告されているため、機密情報を扱う本番リポジトリに直接使うことはおすすめしません。
DeepSeek Super-agentとClaude Code、Codexの比較:重要ポイント
- レイヤーが異なる:Super-agentはタスクを振り分けるスケジューリングシステムのプロトタイプで、Claude CodeとCodexはプログラミングAgent製品です。
- マルチAgentは独自の機能ではない:Claude CodeとCodexにも、サブAgent、並列セッション、バックグラウンド処理、イベントに関する機能があります。
- 本当の違いはシステム化にある:常駐するRouter、タスク間のルーティング、サブスクリプションの直接利用、コンテキストの統合が設計の重点です。
- 実験データには限界がある:合成タスクによるスケジューリング実験は、その処理性能を示すものであり、コードの品質や3者の順位を示すものではありません。
- 速度と引き換えにTokenを消費する:キャッシュ読み取り量は単一セッション方式の約3.8倍で、費用はモデルの組み合わせに応じて計算する必要があります。
- セキュリティは最初から考慮する:高権限での実行や外部入力を通じたインジェクションのリスクに備え、専用アカウントと人間による成果物の確認が必要です。
- 実際に試すのが確実:APIYI apiyi.comなら、1つのキーで複数モデルを使ったRouterとWorkerの役割分担を試せます。
まとめ
DeepSeek Super-agentとClaude Code、Codexの比較から得られる主な結論は次のとおりです。
- まずレイヤーが違う:モデルの能力、プログラミングツールの能力、スケジューリングシステムの能力は別のものです。混同して比較しても意味がありません。
- DeepSeekの価値はスケジューリング設計にある:常駐監視、タスク間のルーティング、コンテキストの統合をシステム化し、権限設定とobserveモードによって自律的な動作を制御しています。
- 成熟度には実際に差がある:プロトタイプにはIssueからPRまで対応した実例がありますが、インストール、信頼性、セキュリティはまだ改善が必要です。日常的なコーディングには、引き続きClaude CodeとCodexが堅実な選択肢です。
AIプログラミングの競争は、「どのモデルが強いか」から、Agent Harness、ワークフロー、開発者体験を含めた総合的な競争へと広がっています。多くのチームにとっては、成熟した製品で日常のコーディングに対応しながら、自前のスケジューリング層を小規模に試すのが現実的な道でしょう。
APIYI apiyi.comを通じて複数の主要モデルにまとめてアクセスし、RouterとWorkerのそれぞれの役割で、モデルごとの性能と費用を素早く検証することをおすすめします。
📚 参考資料
- DeepSeek Super-agent 公式プロトタイプリポジトリ:プロジェクトの状況、ソースコード、適用範囲
- リンク:
github.com/deepseek-ai/dsh-superagent-prototype -
説明:README、デプロイドキュメント、認可の仕組み、設計思想に関するドキュメントを掲載
-
DeepSeek API 公式料金表:モデルの料金と Search/Fetch の費用
- リンク:
api-docs.deepseek.com/quick_start/pricing -
説明:Router/Worker のモデルコストを算出する際の根拠
-
Claude Code Subagents と Agent Teams のドキュメント:マルチエージェント機能の説明
- リンク:
code.claude.com/docs/en/sub-agents、code.claude.com/docs/en/agent-teams -
説明:サブエージェントの独立したコンテキストとチームの協調動作の仕組みを解説
-
Claude Code Channels と定期タスクのドキュメント:イベントのプッシュ通知と継続的な実行
- リンク:
code.claude.com/docs/en/channels、code.claude.com/docs/en/scheduled-tasks -
説明:リサーチプレビュー機能の利用条件と制限を解説
-
Codex Cloud と Worktrees のドキュメント:クラウド上のタスクと並列ワークスペース
- リンク:
help.openai.com/en/articles/20001545-using-codex-cloud、learn.chatgpt.com/docs/environments/git-worktrees -
説明:Codex の各製品機能を区別するための公式資料
-
OpenAI Agents API マルチエージェントガイド:API レベルでのマルチエージェントオーケストレーション
- リンク:
developers.openai.com/api/docs/guides/agents-api/multi-agent -
説明:Codex の製品機能とは区別して参照
-
DeepSeek Harness コミュニティでの実践テストに関する議論:Issue から PR までの一連の流れをまとめたレポート
- リンク:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - 説明:プロトタイプの実際の動作状況やよくある問題を紹介
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI 公式サイトのトップページからお気軽にご連絡ください。複数モデルの接続やエージェントオーケストレーションに関する資料は、docs.apiyi.com のドキュメントセンターでもご覧いただけます。