著者注:DeepSeek のスーパーエージェント設計を出発点に、マルチエージェントシステムにおける router と worker のモデル割り当てを解説し、キャッシュ読み取り Token がアーキテクチャのコストにどう影響するかを説明します。
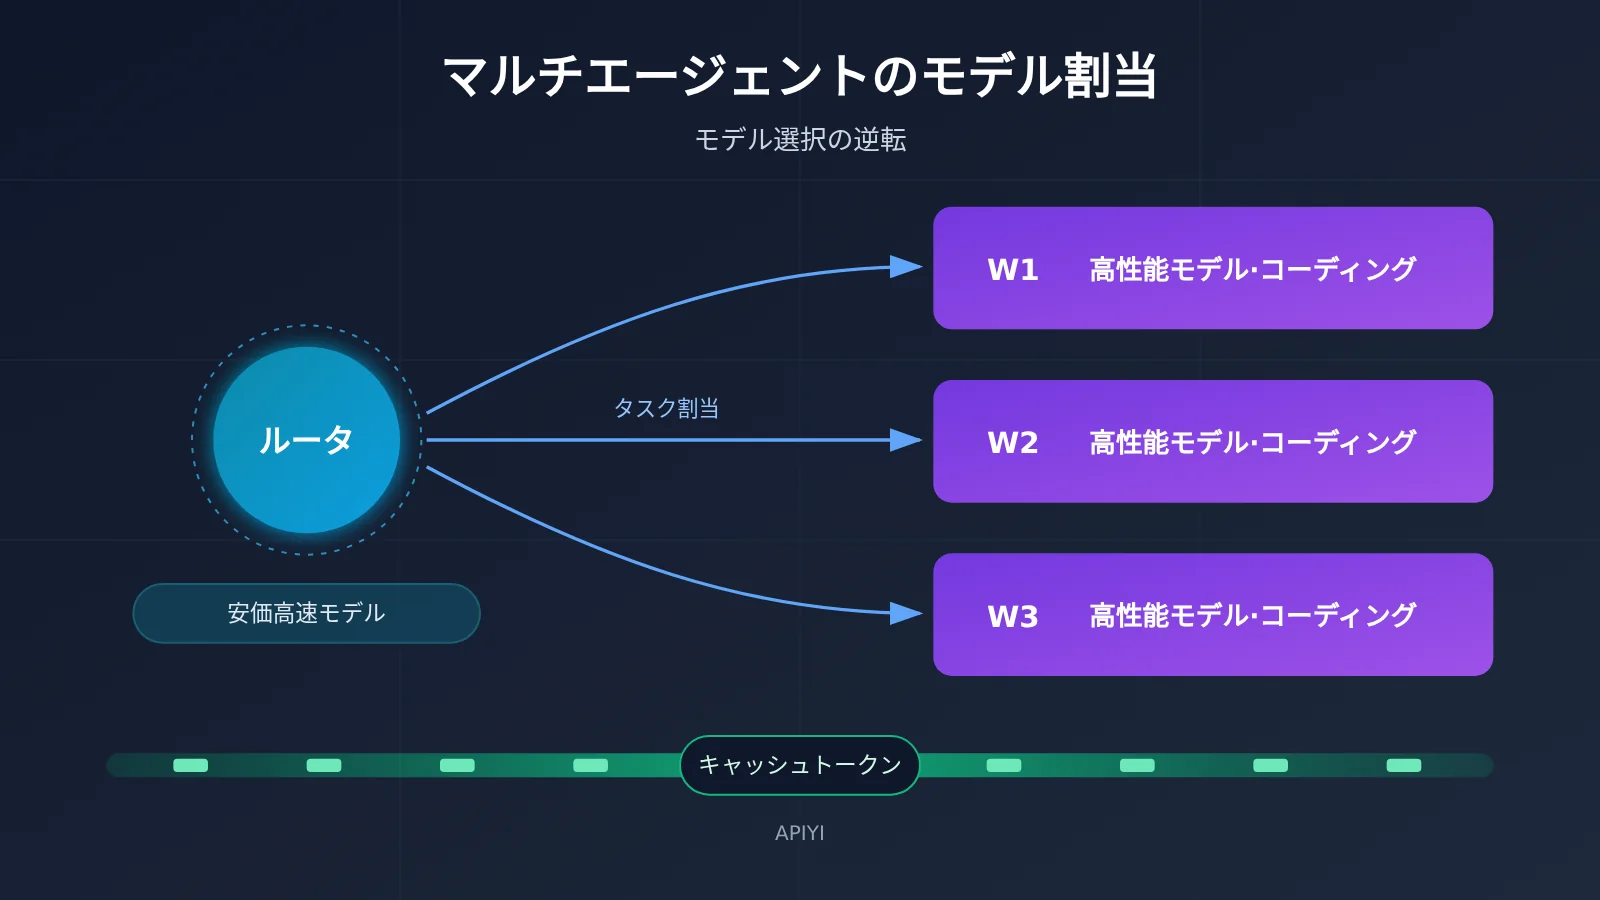
マルチエージェント型のコーディングシステムを構築するとき、多くの人は「総指揮役」に最も強力なモデルを割り当て、その下で働く実行役には安価なモデルを使います。DeepSeek Harness チームが 2026 年 11 月に公開したスーパーエージェントの設計は、その逆の考え方を示しました。router には安価なモデル、worker には強力なモデルを使うというものです。対話とタスクの割り振りを担う router には軽量モデルを、実際にコードを書く worker には最も強力なモデルを使います。
この記事はニュースを紹介するだけのものではありません。このアーキテクチャを、実際のモデル選定に使える判断基準に落とし込みます。router と worker にそれぞれ必要な能力、キャッシュ読み取り Token の見積もり方、低価格モデルを選ぶべきタイミングを解説します。記事中で引用するテストデータについては、DeepSeek 自身も「参考程度」の結果と位置づけています。その限界も明確にお伝えします。
この記事で得られること:自分のマルチエージェントシステムに向けて、役割ごとにモデルを割り当てるプランを作り、キャッシュ読み取り量からそのコストの規模を概算できるようになります。
マルチエージェントのモデル割り当て:要点
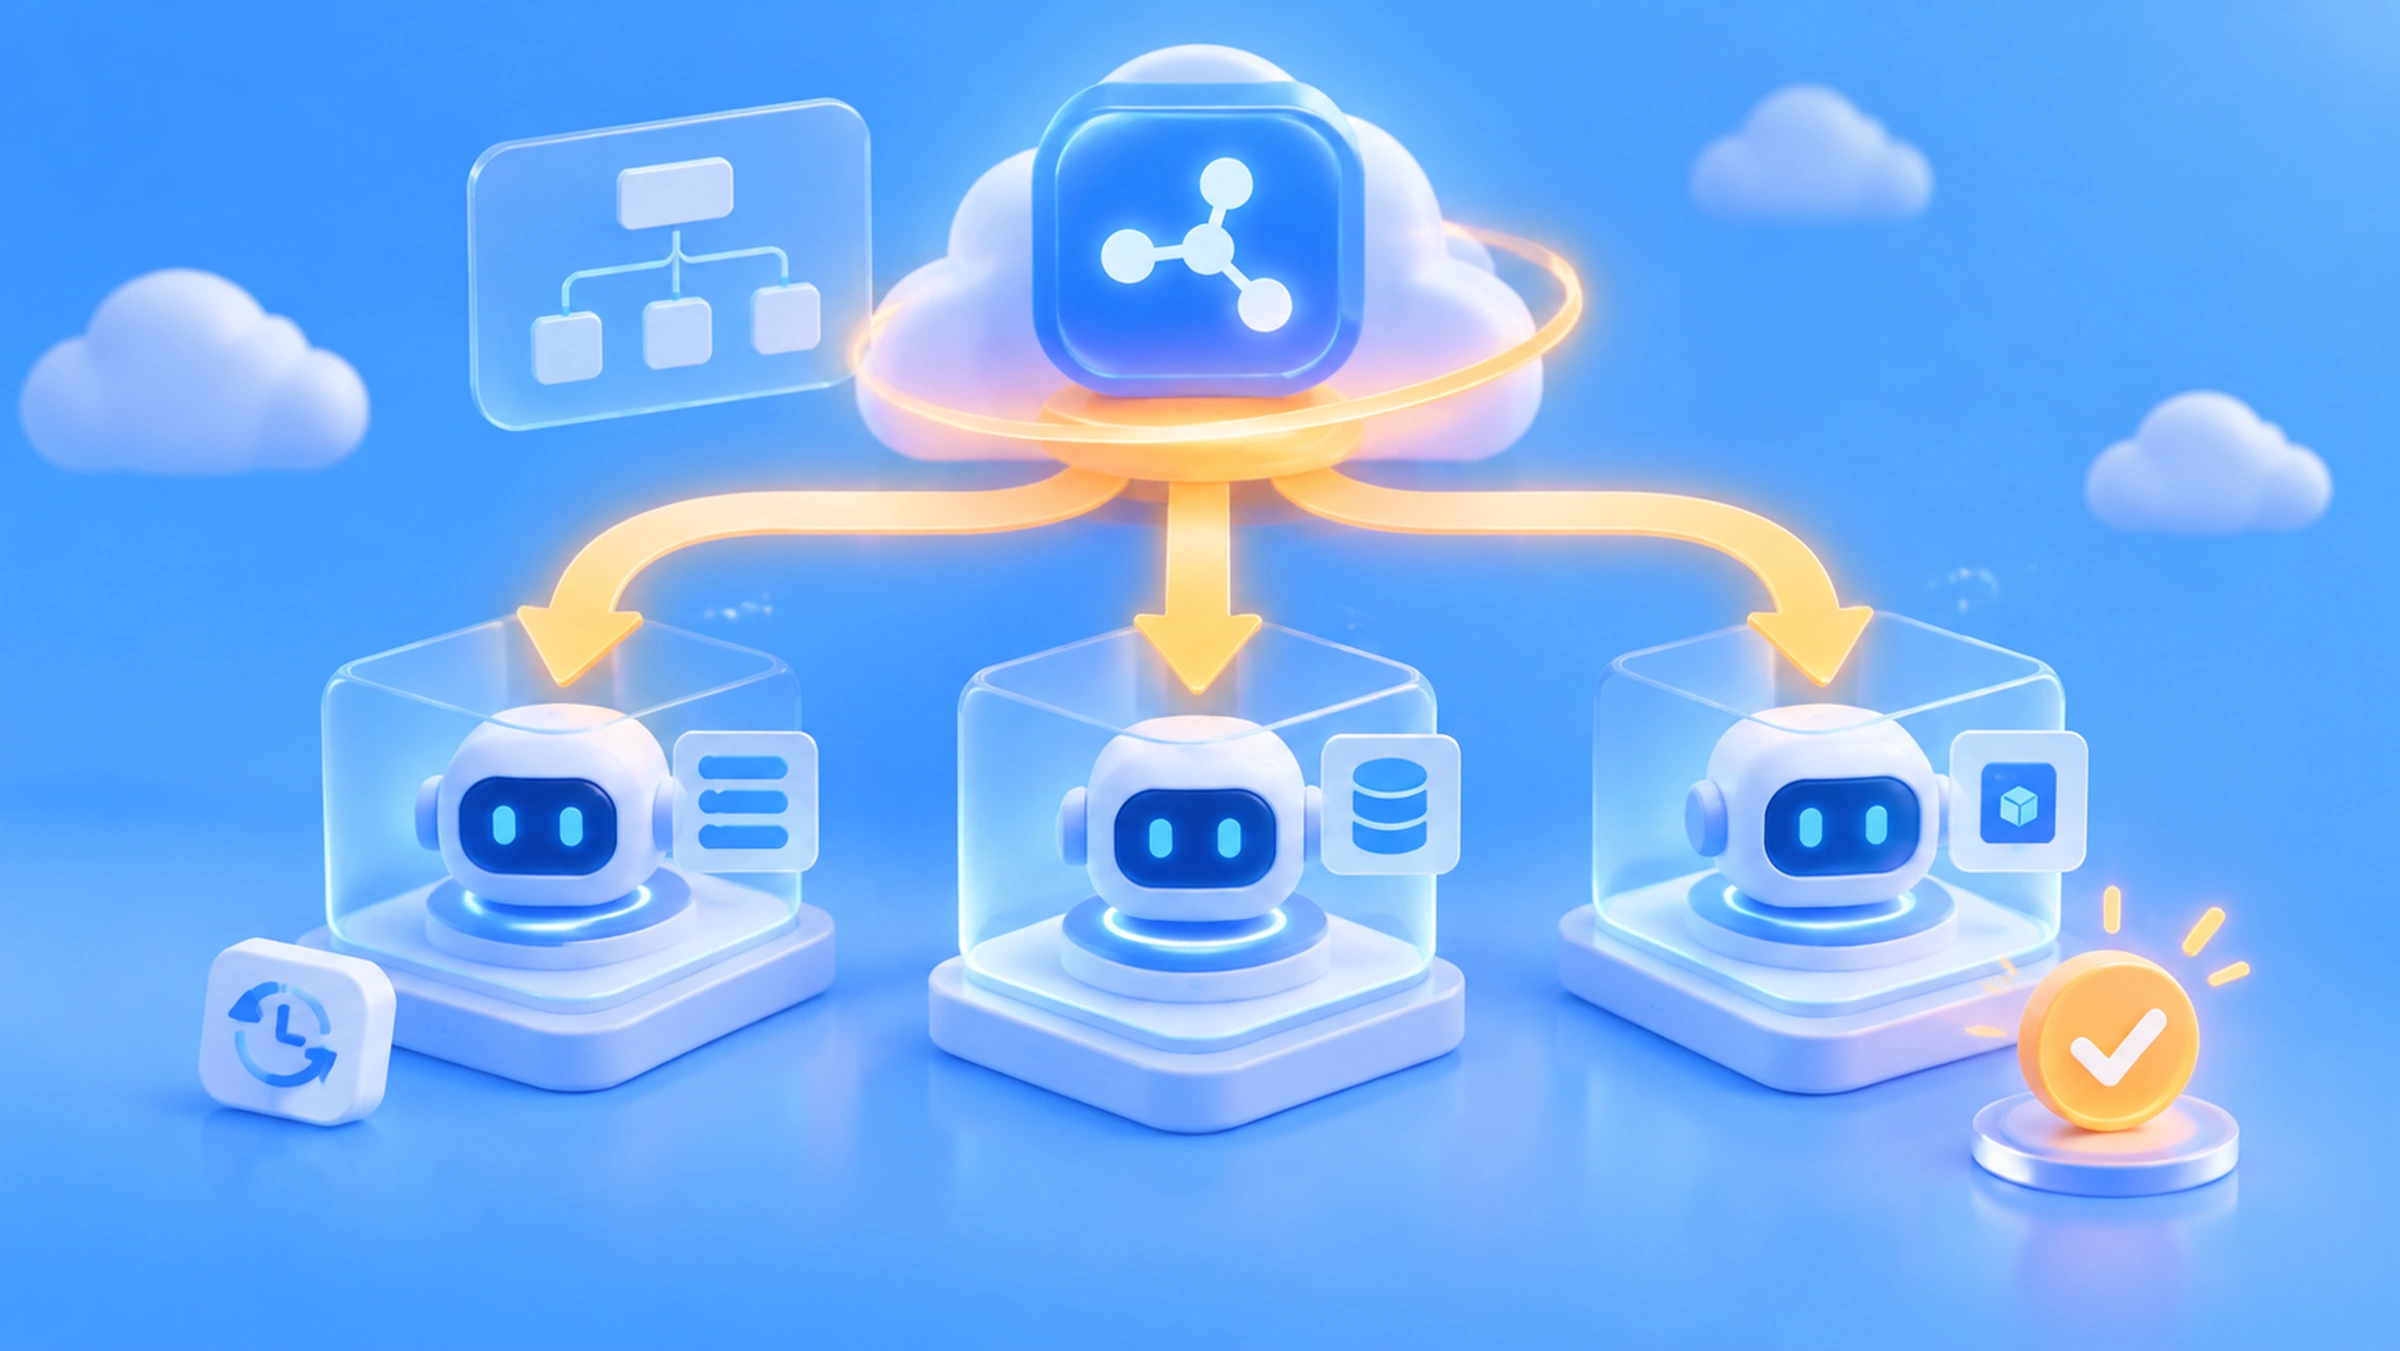
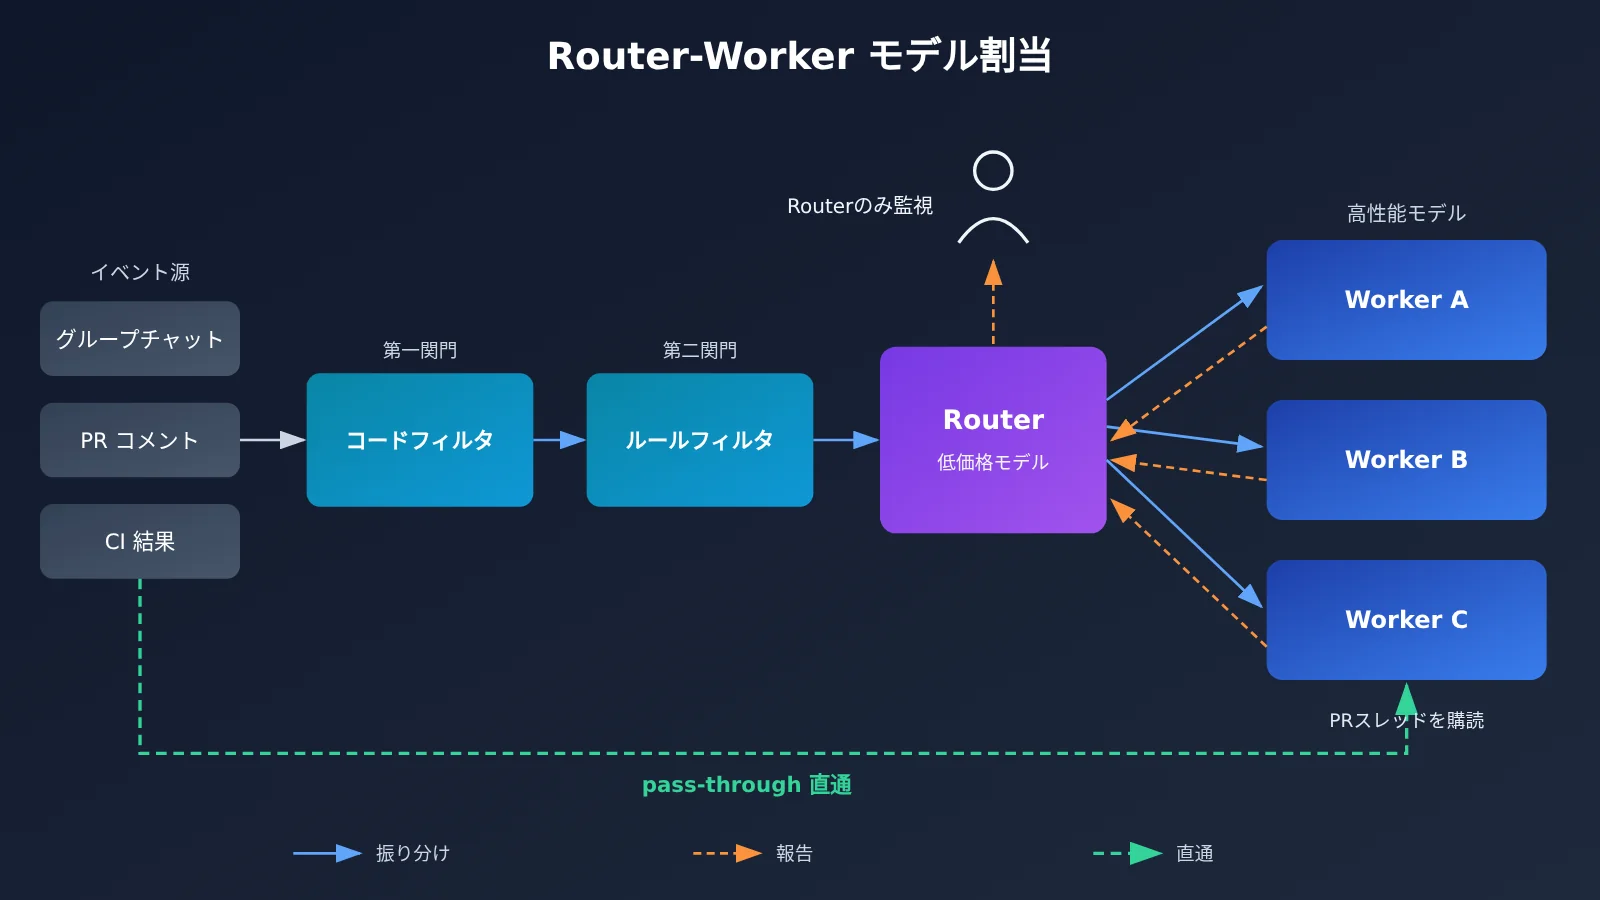
DeepSeek の設計は2層に分かれています。router は長期間維持されるセッションで、人とのやり取り、タスクの割り当て、タスク間の関係の追跡を担当します。worker は毎回1つのタスクだけを受け取り、独立したクリーンなコンテキストで作業します。人とは直接やり取りせず、状態を router に報告するだけです。この役割分担を踏まえると、モデル割り当ての基本方針は次のようになります。
| 役割 | 主な責務 | コードを書くか | 推奨モデルのクラス | 選定理由 |
|---|---|---|---|---|
| router | 対話、タスクの割り当て、タスク間の関係の追跡 | いいえ。シェル権限も不要 | 軽量、低価格、高速 | 作業は単純だが呼び出し頻度が高いため、レイテンシと単価が重要 |
| worker | 単一のタスクを受け取り、コーディングを完了する | はい | 現在利用可能な最強のコーディングモデル | コードの品質が成果物を直接左右する |
| トリガーフィルタリング層 | グループチャットや CI 通知のノイズを除外する | いいえ | 第1段階は通常のコード、第2段階は小規模モデル | ほとんどのイベントはモデルに渡す必要がない |
なぜマルチエージェントのモデル割り当てを「逆転」させるのか
DeepSeek は、AI 支援コーディングのボトルネックが、すでにモデルの能力から人間の注意力へと移ったと考えています。通常、1人が同時に追跡できるアクティブなエージェントセッションは3〜5個です。それ以上になると、どれが承認待ちなのか、どれが行き詰まっているのか、どの2つが同じ PR をひそかに変更しているのか、把握しきれなくなります。そのため、router の価値は「賢さ」ではなく、「安定して作業を割り振り、記録すること」にあります。タスクを分解せず、割り当てと追跡だけを担当する点が、よくある「メインエージェントがタスクをステップに分解する」パターンとは異なります。
router には深い推論もコーディングも必要ないため、最も高価なモデルをここに使うのは無駄です。実際にコードを生み出すのは worker であり、コードの品質が成果物の成否を左右します。高性能モデルのための予算は、こちらに使うべきです。これが「モデル選択の逆転」です。ユーザーに近い役割ほど軽量に、コードに近い役割ほど高性能にします。
router と worker にそれぞれ必要な能力
役割ごとの責務を能力項目に分解すると、具体的なモデル選定につなげられます。以下のリストは、候補モデルの評価にそのまま使えます。
| 能力項目 | router に求められる要件 | worker に求められる要件 | 選定のポイント |
|---|---|---|---|
| 指示への追従と分類 | 高い水準で、タスクの担当先を安定して判断できること | 中程度 | router は分派の正確さを優先して測定する |
| 長いコンテキストの処理と情報の遡及 | 中程度。ID や要約を頼りに段階的に詳細を展開する | 高い水準。大量のコードを読む必要がある | worker はコンテキストウィンドウとコード検索能力を確認する |
| コード生成の品質 | 不要 | 最優先 | worker の予算は惜しまない |
| 応答レイテンシ | 最優先。頻繁に判断を行う | 中程度。個々のタスクには多少時間がかかってもよい | router には Flash 系の高速モデルを選ぶ |
| 単価への敏感さ | 非常に高い。キャッシュの読み取り量が膨大 | 中程度 | router の単価は総コストに影響する |
| ツール呼び出し | 少ない。shell 権限を与えなくてもよい | 多い。実行とテストが必要 | 権限の境界で各役割を制約する |
router には、見落とされがちな要件がもう一つあります。構造上、「自分で作業できない」ことです。DeepSeek が router にあえて shell 権限を与えていないのは、router が直接作業する可能性をなくすためです。そのため、router のモデル選定では「何でもできる」ことを求める必要はありません。むしろ、「作業の分派しかできない」ことを受け入れるのがポイントです。
マルチエージェントのモデル割り当てにおけるキャッシュ読み取り Token のコスト
router を安価に抑えるだけでは十分ではありません。このアーキテクチャでコストの大半を占めるのは、キャッシュ読み取り Token です。router は長時間続くセッションであり、キャッシュ内のコンテキストを繰り返し読み込みます。さらに、複数の worker が並行して動作し、それぞれ大量のコンテキストを読み込みます。DeepSeek のテストデータは、この問題をわかりやすく示しています。
| テスト指標 | 数値 | 説明 |
|---|---|---|
| 1 ラウンドあたりのメッセージ数 | 約 300 件 | うち約 20 件が実際の作業リクエスト |
| スーパーエージェントの平均完了時間 | 12.4 分 | 遅いケースでは 15.7 分 |
| 単一セッションのベースラインにおける遅いケースの所要時間 | 29.5 分 | 比較対象 |
| router の意思決定負荷 | 毎分約 1 回から約 40 回に増加 | 1 回の意思決定にかかる時間は 6.4 秒から 1.6 秒に短縮 |
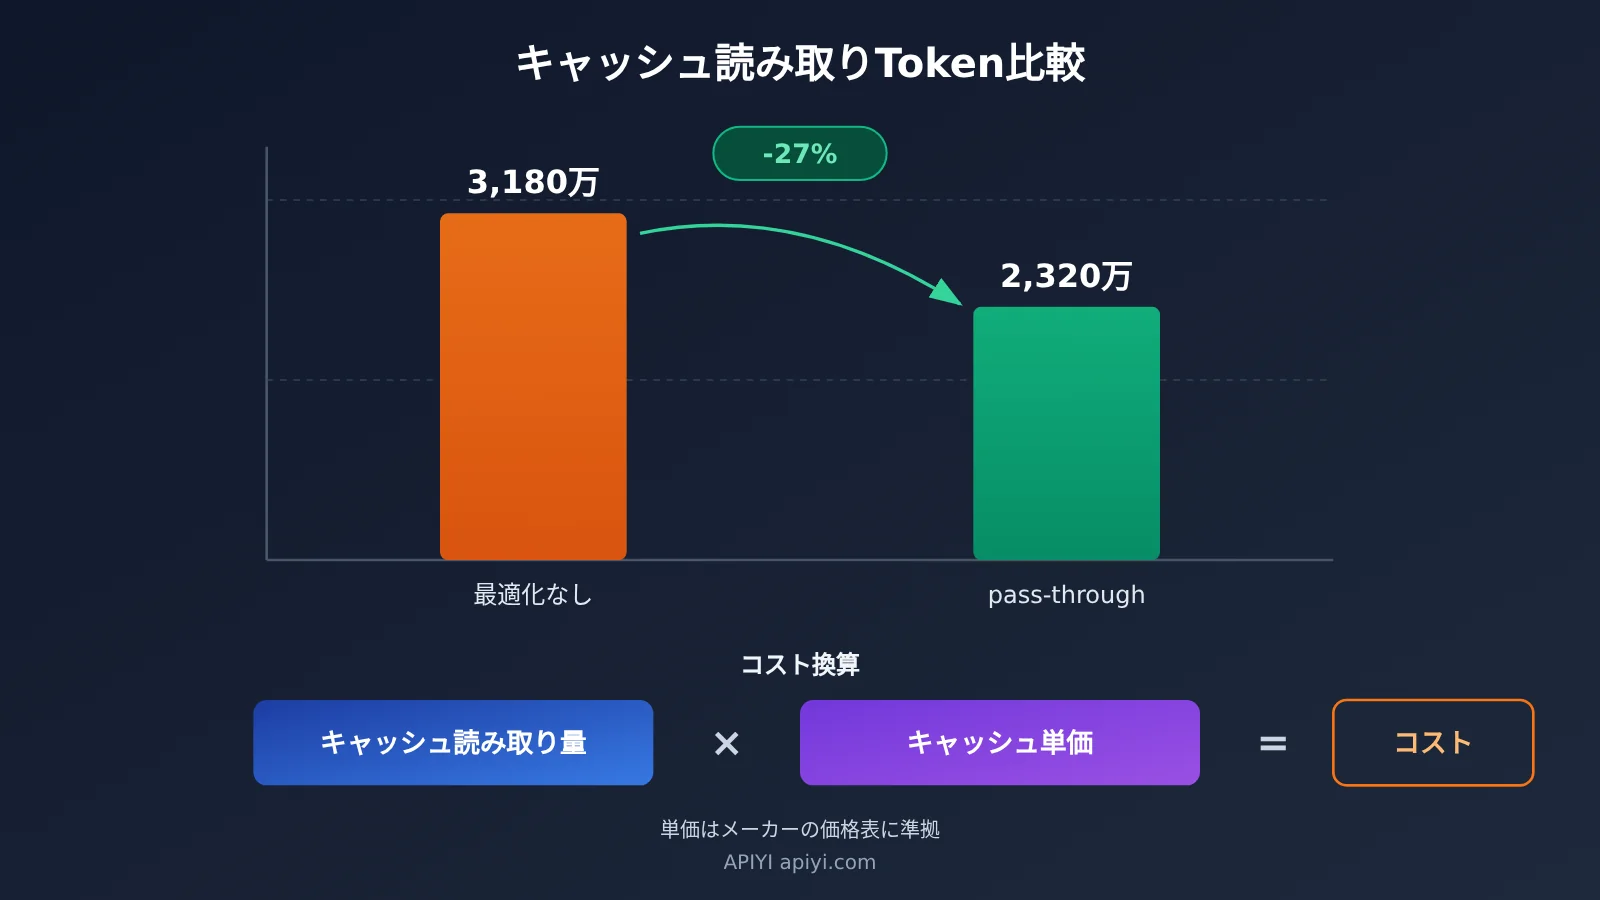
| キャッシュ読み取り Token | 2,320 万 | pass-through 最適化を有効化 |
| 最適化なしのキャッシュ読み取り | 3,180 万 | worker がスレッドを直接購読しない場合 |
| キャッシュコスト | 約 7 ドル | DeepSeek 自社の閑散時間帯における Flash クラスの料金に基づく |
キャッシュ読み取り量からマルチエージェントのモデル割り当てコストを見積もる方法
1 回の実行コストは、次の 3 つに分けて見積もることができます。キャッシュ読み取り Token にキャッシュ読み取り単価を掛けた額、キャッシュにヒットしなかった入力 Token に入力単価を掛けた額、出力 Token に出力単価を掛けた額です。router-worker アーキテクチャでは、最初の項目が圧倒的に大きくなることが多いため、モデル選定時はキャッシュ読み取り単価を特に重視しましょう。
報告された数値から逆算すると、約 7 ドルは 2,320 万キャッシュ読み取り Token に相当するため、100 万 Token あたり約 0.3 ドルの水準になります。これは報告値から逆算した概算であり、公式料金ではありません。実際の価格は、モデル提供元の最新の料金表を確認してください。この水準を目安に候補モデルのキャッシュ読み取り単価を当てはめれば、同じ作業量を高価格のモデルで処理した場合、コストが何倍になるかをすばやく把握できます。
pass-through 最適化自体も注目に値します。worker がスレッドを購読すると、新しいイベントが router を経由せずに worker に直接届きます。これにより、キャッシュ読み取り量は 3,180 万から 2,320 万に減少し、約 27% 削減されました。つまり、アーキテクチャの最適化も、安価なモデルへの切り替えと同様に、請求額を直接抑えられます。
元データについて注意したい 3 つの限界
- コーディング工程はシミュレーションです:テストでは「コードを書く」作業を、時間を消費するだけのツールで代用しています。測定対象はスケジューリングの挙動であり、コードの品質ではありません。そのため、このテストから worker にどのモデルを使うのが最適かを証明することはできません。
- データはあくまで参考値です:DeepSeek は、これらの数値は目安(indicative)であり、厳密なベンチマークではないと明言しています。
- Sonnet クラスとの価格比較に矛盾があります:報道の要約では Sonnet クラスで約 4.64 ドルと見積もられている一方、本文では同じ使用量でも高価格帯では「明らかに高くなる」と述べられており、両者は矛盾しています。DeepSeek の原文を確認するまでは、この具体的な価格比較を引用することはおすすめしません。
マルチエージェントのモデル割り当て:クイックスタート
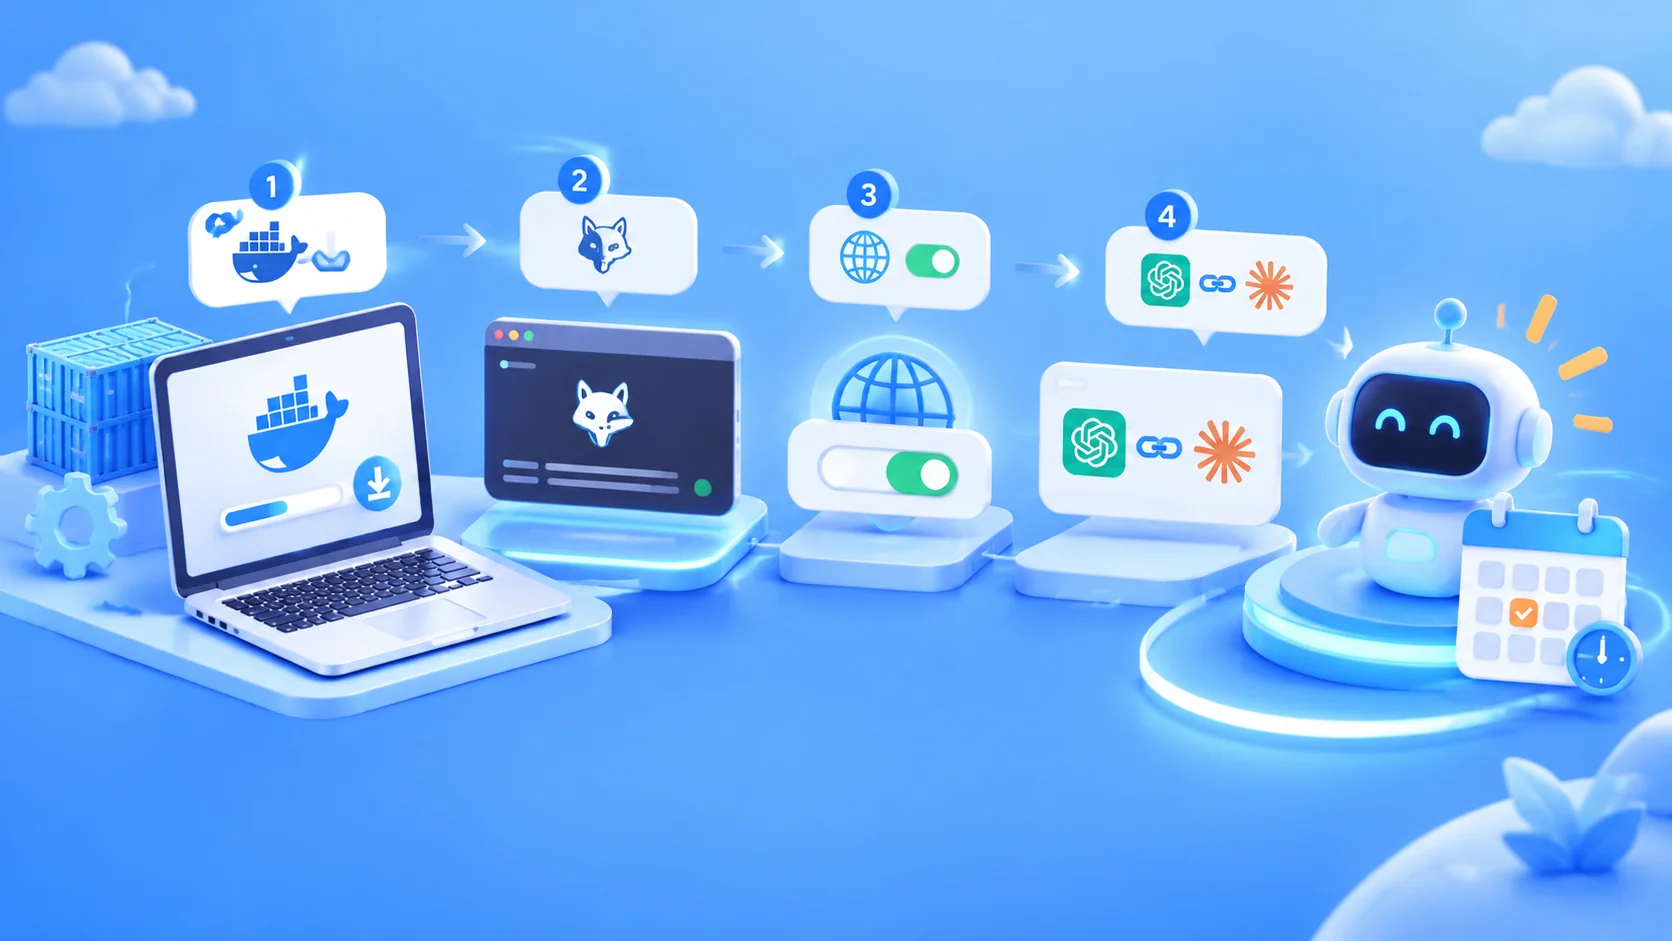
ここまでの考え方を自分のシステムに取り入れるには、以下の手順で進めます。コードは示さず、すべての設定項目をインラインで説明するので、お使いのフレームワークと照らし合わせてみてください。
- まず役割を分け、それからモデルを選ぶ:システム内でモデルを呼び出す役割をすべて洗い出し、少なくとも router、worker、トリガーのフィルタリングの3種類に分けます。それぞれについて、コードを書くか、ツールが必要かを明確にします。
- モデル名を設定項目にする:
router_model、worker_model、filter_modelのように、役割ごとにパラメータを設定します。モデル名を業務コードに直接書き込むのは避けましょう。 - 構成によって委任を徹底する:router から shell などの実行ツールを取り除きます。DeepSeek の実験では、単一セッションのエージェントに中立的なプロンプトを与えた場合、5回の実行ですべて委任が行われず、最も遅いケースでは完了まで約30分かかりました。プロンプトで明示的に委任を求めた場合でも、5回中1回はタスクが小さすぎると判断して自分で処理しました。
- フィルタリングを先に行う:トリガーとなるイベントは、まず通常のコードでイベントの発生元や許可リストに基づいてノイズを除外します。残ったイベントだけをモデルに渡し、チームのルールに従って判断させます。
- キャッシュの読み取り量を記録する:実行ごとに、キャッシュ読み取り、キャッシュされていない入力、出力の3種類のトークン数を記録し、前述の計算式で1回あたりのコストを算出します。
- モデルを変えて比較する:タスクセットは変えずに
router_modelだけを変更し、振り分けの正確さ、レイテンシ、コストの変化を確認してから、下位モデルに切り替えるか判断します。
手順2と手順6では、接続方法が実験の効率に直接影響します。router と worker が異なるベンダーのモデルを使う場合、それぞれのキーや SDK の設定を個別に管理していると、切り替えのたびに多くの箇所を変更しなければなりません。APIYI apiyi.com のような統一インターフェースのプラットフォームを利用すれば、同じ APIキーと OpenAI 互換のリクエスト形式を使い、model パラメータを変更するだけで、router と worker に異なるベンダーのモデルを割り当てられます。これにより、比較実験の負担を大幅に減らせます。
🚀 クイックスタートのヒント:プロトタイプを検証する際は、まず APIYI apiyi.com で同じキーを使って router と worker のモデルパラメータをそれぞれ設定し、同じタスク群を実行してトークン使用量を記録するのがおすすめです。利用可能なモデル(DeepSeek の Flash クラスのモデルなど)については、プラットフォームの最新のモデル一覧をご確認ください。
マルチエージェントの役割に低価格モデルを割り当てるべき場面
低価格モデルがあらゆる場面に適しているわけではありません。以下の表を参考に、各役割に割り当てるモデルのグレードを下げるべきか判断してみましょう。
| 場面の特徴 | 推奨 | 理由 | 接続方法 |
|---|---|---|---|
| 役割が振り分け、進捗追跡、キャッシュされたコンテキストの確認に限られる | 低価格で高速なモデルを選ぶ | タスクが単純で、単価とレイテンシーが使い勝手を左右する | APIYI apiyi.com または提供元の公式 API |
| コードの生成と修正を担当する | 高性能モデルを選ぶ | コードの品質が成果物を左右する | APIYI apiyi.com または提供元の公式 API |
| キャッシュ読み取り量が数千万単位に達し、毎日繰り返し実行する | キャッシュ読み取り単価の引き下げを優先する | キャッシュコストは実行回数に比例して増える | 提供元の料金表に基づいて計算する |
| たまに実行する軽量な単発タスク | 従量課金で十分 | 使用量が少なく、アーキテクチャを複雑にするコストに見合わない | 任意の従量課金チャネル |
| 高頻度でトークンを大量に消費する自動化タスク | 月額プランや高上限プランを検討する | 実行ごとの限界費用が請求額に直接反映されなくなる | 具体的な契約条件による |
最後の行の参考例として、同時期の報道では、Claude Code Pass は月額 9.99 ドルで、Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash などのオープンモデルに対して約 2~5 倍のレート制限を提供し、5 時間・週・月の 3 段階の使用量上限が設けられています。同じ報道では、ルーティングの判断やキャッシュされたコンテキストの確認だけを行う工程では、高速で安価なモデルはコスト面だけでなく、技術的にも適しているとされています。ただし、この種のプランでは利用できるモデルがプラン内のものに限られます。worker がプラン外のモデルに依存する場合は、別の接続チャネルが必要です。
マルチエージェントにおけるモデル割り当てのリスクと限界
モデルの割り当てが解決するのはコストと役割分担の問題であり、アーキテクチャ自体に残る課題は解決しません。DeepSeek は、未解決の問題を2つ挙げています。1つ目は長期記憶です。システムを数か月運用した後、コンテキストウィンドウを圧迫せずに関連する履歴を保持するのは、依然として困難です。2つ目はプロンプトインジェクションです。外部イベント(グループチャットや PR のコメント)を読み取るエージェントは、いずれも操られる可能性があります。router と worker は共有のクラウド上のループを通じてつながっているため、侵害されたイベントソースから、システムがアクセスするすべてのマシンに指示が広がる可能性が理論上あります。
これはモデルの割り当てにも直接影響します。router に安価なモデルを使うからといって、防御を緩めてよいわけではありません。外部イベントに最初に触れるのが、まさに router だからです。DeepSeek の社内環境では、自律的なアクションをすぐに実行するのではなく、まず「本来ならこう実行する」という内容をログに記録するモードで動かしました。例えば「ひそかに再現して修正する」方針では、バグが報告されるとエージェントがバックグラウンドで再現を試みます。再現を確認して修正できた場合にのみ、会話が進む中で PR を提出し、再現できなければ何も発信しません。新しいシステムを導入する際は、まずログを観察し、その後少しずつ権限を与えるほうが堅実です。
また、プロトタイプコードの DSH Super Agent は、GitHub 上で正式な製品ではなく研究用コードであると明記されています。設計の考え方を参考にするのは問題ありませんが、そのまま本番環境にデプロイすることはおすすめしません。
よくある質問 FAQ
Q1: マルチエージェントシステムにおける「モデル選択の逆転」とは何ですか?
router に軽量で安価なモデルを使い、worker に最も高性能なモデルを使うことです。router は対話、タスクの割り当て、進捗管理だけを担当し、コードは書きません。実際のコーディングは worker が担当するため、高性能モデルの予算は「総指揮役」ではなく worker にかけるべき、という考え方です。
Q2: router-worker アーキテクチャと「メインエージェントがタスクを分解する」方式の違いは何ですか?
メインエージェント方式では、メインエージェントがタスクをステップに分解するため、高い推論能力が求められます。DeepSeek の router は分解を一切行わず、タスクの割り当てと進捗管理だけを行うため、より軽量なモデルを使えます。その代わり、worker はタスク全体を独力で完了できなければなりません。
Q3: この設計はいつ公開されましたか?DSH Super Agent はそのまま使えますか?
関連する報道は 2026 年 11 月 3 日に公開されました。DSH Super Agent は設計に関する記事とともに GitHub で公開された研究用プロトタイプです。公式にはサポート対象の製品ではないと明記されており、アーキテクチャを理解するためのものです。
Q4: プロンプトだけで単一のエージェントに委譲を覚えさせることはできますか?
DeepSeek のテストでは、信頼性に欠けることが示されました。中立的なプロンプトでは 5 回の実行すべてで委譲が行われず、委譲を強調したプロンプトでも 1 回は委譲されませんでした。確実に委譲させるには、プロンプトを長くするのではなく、セッションを分離したり実行ツールを取り除いたりするなど、構造的に隔離する必要があります。
Q5: 同じシステム内で、router と worker に異なるベンダーのモデルを手軽に設定するにはどうすればよいですか?
ポイントは、モデル名を役割ごとの設定項目にし、接続方法を統一することです。
1. APIYI apiyi.com に登録し、APIキーを取得する
2. システム設定で router と worker の `model` パラメータをそれぞれ設定する
3. リクエスト形式は変えず、モデル名だけを切り替えて比較実験を行う
これにより、ベンダーごとに個別の SDK 設定を管理する必要がなくなります。利用可能なモデルは、プラットフォームの最新リストを確認してください。
Q6: 原文のコストデータをそのまま予算策定に使えますか?
そのまま使うことはおすすめしません。コーディング工程はシミュレーションであり、データはあくまで参考値です。また、Sonnet クラスとの価格比較の記述にも前後で食い違いがあります。自分のタスクセットでキャッシュ読み取り量を実測し、現在の単価を掛ける方法がより適切です。APIYI apiyi.com でタスクを変えずにモデルを切り替えてそれぞれ実行すれば、自分の用途に合ったデータを得られます。
Q7: このアーキテクチャにはどのような既知の制限がありますか?
主に 3 つあります。長時間の稼働による記憶の劣化、外部イベントの読み取りに伴うプロンプトインジェクションのリスク、そしてキャッシュ読み取りのトークン量が非常に多く、高価なモデルを使うとコストが大きく膨らむことです。また、router に具体的にどのモデルを使った場合の効果データも現在は不足しており、自分でテストする必要があります。
マルチエージェントのモデル割り当て:重要ポイント Key Takeaways
- モデル選択を逆転:router には軽量で安価なモデルを、worker にはコードを書くための高性能モデルを使います。
- ボトルネックは注意力:人が同時に目を配れるのは通常 3〜5 セッション。router がコミュニケーションを集約します。
- 委任は構造で徹底:router から実行ツールを取り除くほうが、プロンプトの変更よりもはるかに確実です。
- コストの大部分はキャッシュ:あるテストではキャッシュ読み取りが 2,320 万トークンに達しており、単価が特に重要です。
- アーキテクチャの改善でも節約:pass-through による直接転送で、キャッシュ読み取りが約 27% 減少しました。
- データの引用は慎重に:コーディングはシミュレーションであり、結果はあくまで参考値です。価格比較も確認が必要です。
- 統一インターフェースで実験:APIYI apiyi.com なら、
modelパラメータを変えるだけで異なる割り当て方案を比較できます。
まとめ
router に安価なモデルを、worker に高性能モデルを使う、このマルチエージェントのモデル割り当てにおける重要ポイントは次のとおりです。
- 役割に応じて使い分ける:コードを書かず、割り振りと進捗管理だけを担当する役割には安価で高速なモデルを、コーディング担当には高性能モデルを使います。
- キャッシュを基にコストを計算する:キャッシュ読み取りトークンは、この種のアーキテクチャにおける主なコストです。モデルを選ぶ際は、まずキャッシュ読み取りの単価を比較しましょう。
- 実測に基づいて決める:原文のデータは方向性をつかむための参考にとどめ、最終的には自分のタスクセットでコストと効果を測定する必要があります。
まずは小さなタスクセットで router-worker のプロトタイプを構築し、モデル名を役割ごとに設定できるパラメータにするのがおすすめです。そのうえで、router のモデルを段階的に入れ替え、割り振りの正確さとコストの変化を確認しましょう。APIYI apiyi.com を通じて 1 つのキーで複数社のモデルに接続し、この比較を行えば、自分のデータに基づいてモデルを選べます。
📚 参考資料
- DeepSeek’s Super Agent Harness: Fixing the Attention Bottleneck in AI Coding:DeepSeek Super Agent の設計を解説
- リンク:
mindstudio.ai/blog/deepseek-super-agent-harness-design -
内容: router-worker アーキテクチャ、委任実験、キャッシュされたトークンのデータ、未解決の課題を紹介
-
Claude Code Pass Pricing: What’s in the $9.99/Month Plan:月額制の高利用枠プランを解説
- リンク:
mindstudio.ai/blog/claude-code-pass-pricing - 内容: マルチエージェントや大量のトークンを消費するワークフローにおける、従量課金と月額制プランの選択を考察
著者: APIYI 技術チーム
技術に関するお問い合わせ: マルチエージェントにおけるモデルの割り当てについては、APIYI apiyi.com のホームページからお気軽にお問い合わせください。接続方法の詳細は、ドキュメントセンター docs.apiyi.com をご覧ください。