Nota do autor: Os mesmos modelos chineses de código aberto aparecem em ordens opostas no ranking de gastos da Menlo Ventures e no ranking de solicitações do OpenRouter. Neste artigo, explicamos como cada ranking é calculado e apresentamos um método de seleção em 5 etapas que você pode colocar em prática.
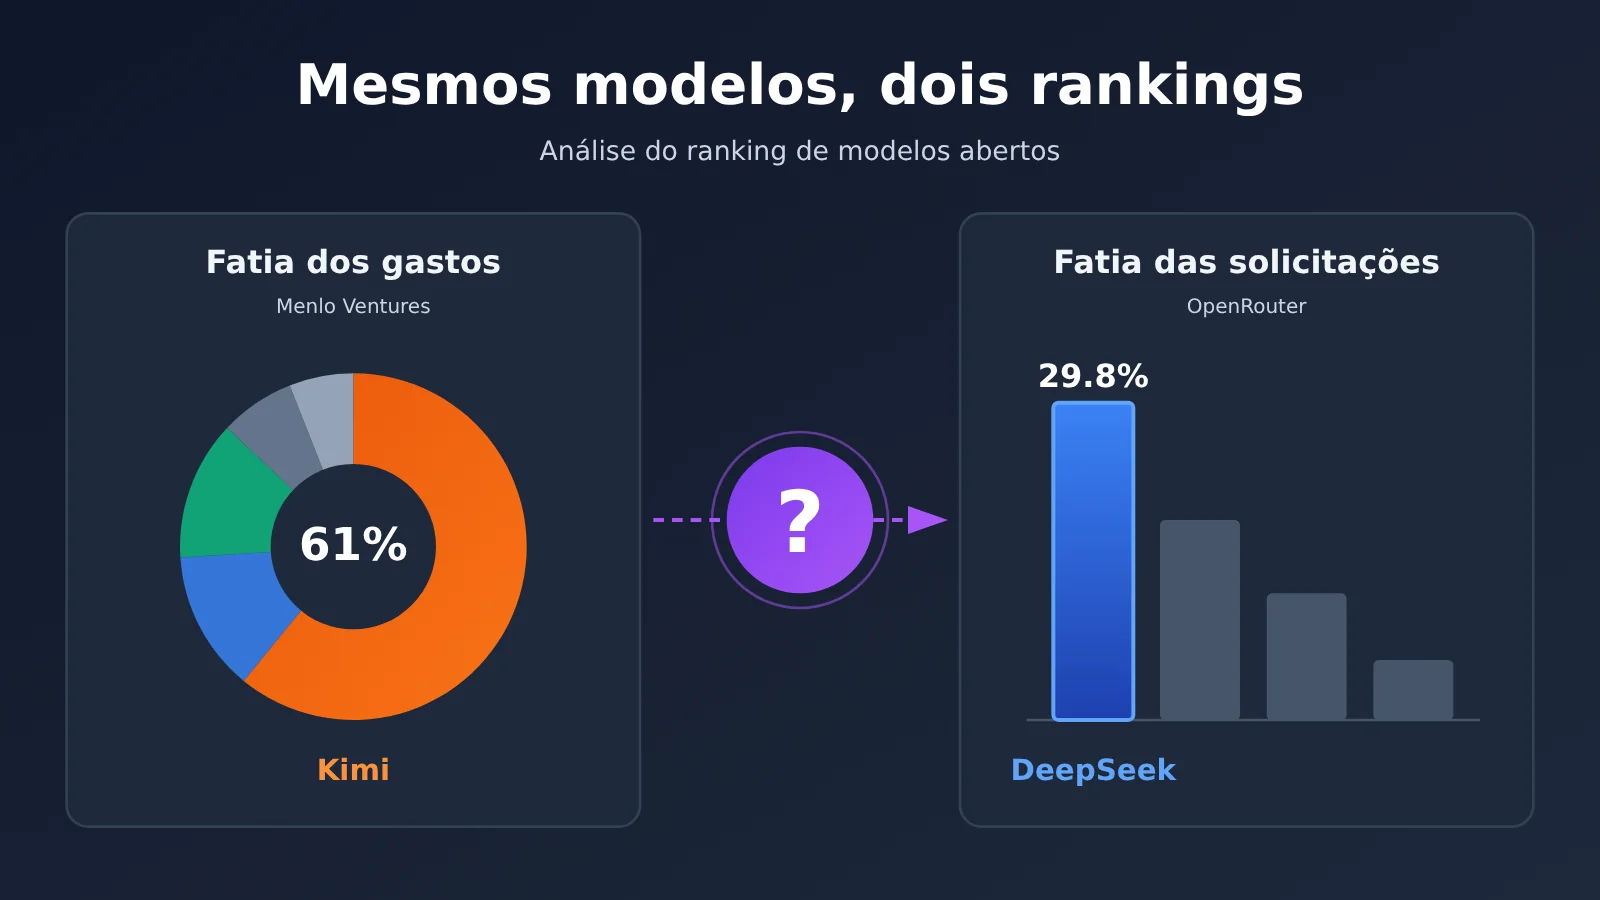
No início de novembro, foram divulgados dois conjuntos de dados. Segundo o relatório da Menlo Ventures, a Kimi ficou com 61% dos gastos das empresas americanas em modelos de código aberto. Já o ranking semanal do OpenRouter mostrou que a DeepSeek respondeu por 29,8% das solicitações de texto da plataforma. Os líderes são diferentes e a ordem das posições é quase inversa. A primeira reação de muitos responsáveis técnicos é: em qual dos dois rankings devemos confiar?
A resposta é que os rankings não se contradizem: eles medem coisas diferentes. O ranking de gastos mostra “para quem as empresas pagaram”, enquanto o de solicitações mostra “quais modelos os desenvolvedores invocaram em uma determinada plataforma”. Na hora de escolher, não dá para simplesmente copiar um dos rankings: é preciso considerar seus próprios tipos de tarefa e critérios de custo. Os rankings ajudam a reduzir a lista de candidatos, mas não escolhem por você.
Este não é apenas mais um resumo de rankings. Vamos explicar a amostra, o período e os limites de aplicação de cada um, mostrar como a queda no preço unitário e o aumento do uso afetam a estrutura de custos e, por fim, apresentar uma lista de 5 etapas para escolher um modelo.
Ranking de modelos abertos: por que Kimi e DeepSeek lideram listas diferentes
O principal: a Menlo Ventures mede os gastos das empresas, enquanto a OpenRouter mede as requisições na plataforma. As amostras, os períodos e os objetos medidos são diferentes.
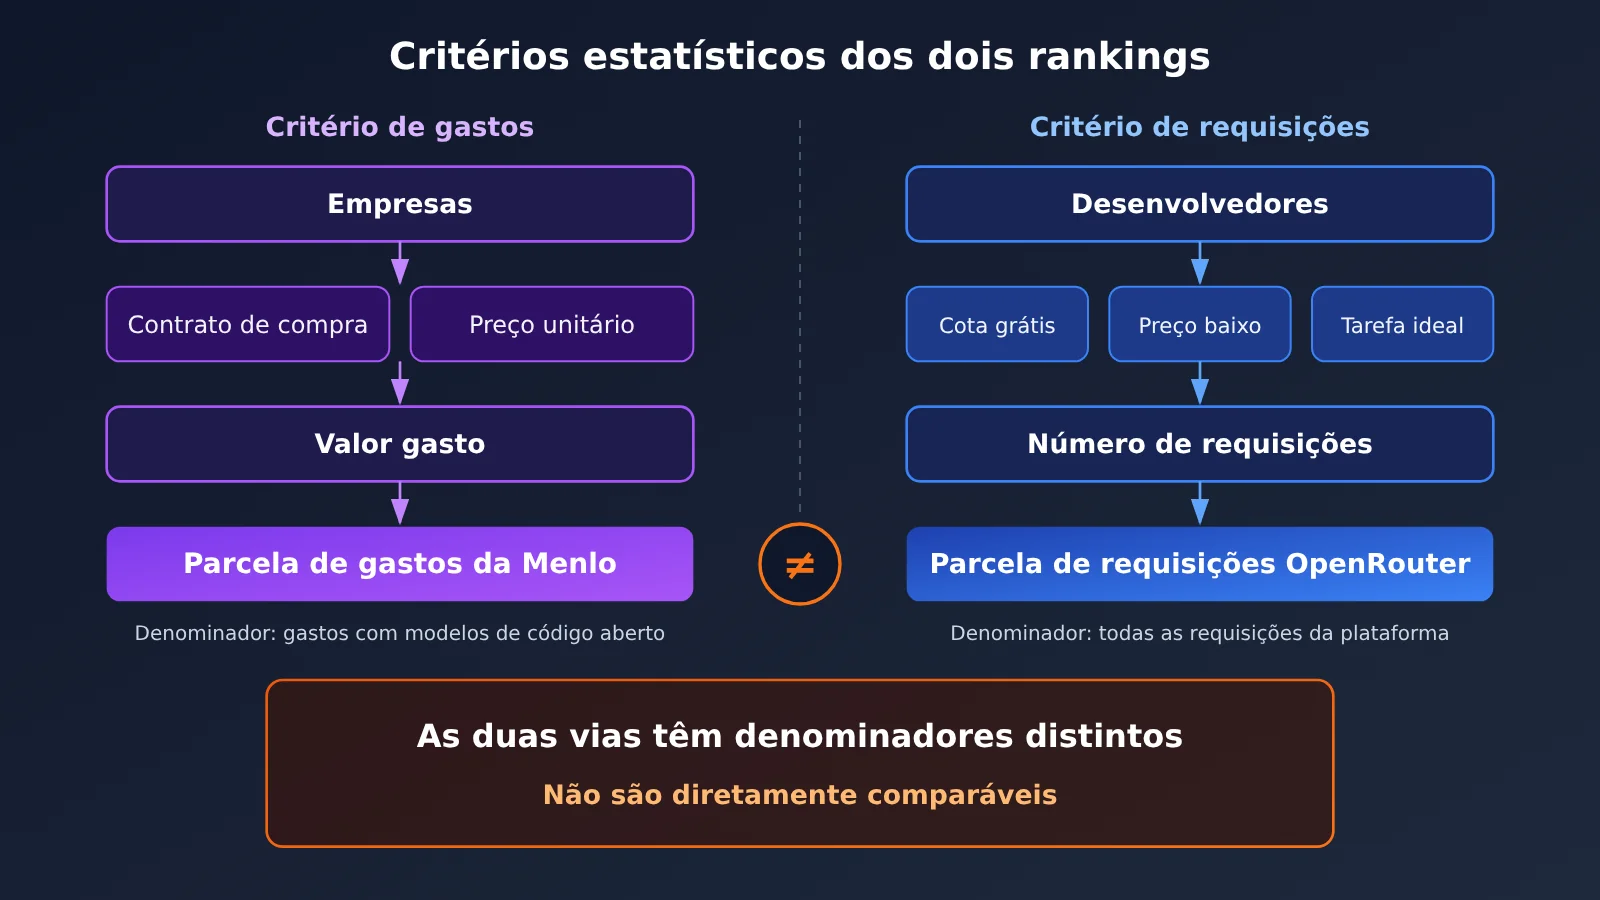
Os dois conjuntos de dados costumam aparecer lado a lado, mas seus “denominadores” são completamente diferentes. Os dados da Menlo Ventures vêm de uma pesquisa com responsáveis por decisões sobre IA em empresas americanas: são estimativas, não valores auditados. Já os dados da OpenRouter vêm das requisições feitas em sua própria plataforma. Eles refletem apenas o comportamento desses usuários, não o mercado inteiro.
| Ranking | O que mede | Amostra/período | Principais posições | O que ajuda a avaliar |
|---|---|---|---|---|
| Relatório da Menlo Ventures sobre o estado da IA empresarial em 2026 | Participação nos gastos com modelos abertos em empresas americanas | Cerca de 400 responsáveis por decisões sobre IA em empresas americanas; pesquisa realizada de 8 a 26 de setembro de 2026 e publicada em 3 de novembro | Kimi 61%, DeepSeek 15%, GLM 11%, Meta Llama 7%, Qwen 3% | Preferências de compra das empresas, destino dos orçamentos e quais modelos entraram em contratos formais |
| Ranking semanal da OpenRouter | Participação nas requisições de texto na plataforma | Plataforma OpenRouter, de 26 de outubro a 1º de novembro | DeepSeek 29,8%, OpenAI 18,8%, Z.ai 11,9%, Qwen 5,6% (sexto lugar) | Atividade dos desenvolvedores, invocações sensíveis a preço e popularidade na comunidade |
A tabela mostra que os rankings nem sequer têm os mesmos “participantes”. A Menlo contabiliza apenas modelos abertos, enquanto a OpenRouter também inclui fornecedores de modelos fechados, como OpenAI e Google. Comparar diretamente os dois percentuais mistura métricas diferentes.
Como ler o ranking de gastos da Menlo Ventures: Kimi fica com 61% dos gastos com modelos abertos
Direto ao ponto: os dados da Menlo Ventures mostram que modelos abertos chineses já entraram no orçamento das empresas americanas, mas são estimativas de uma pesquisa, não um ranking de capacidade.
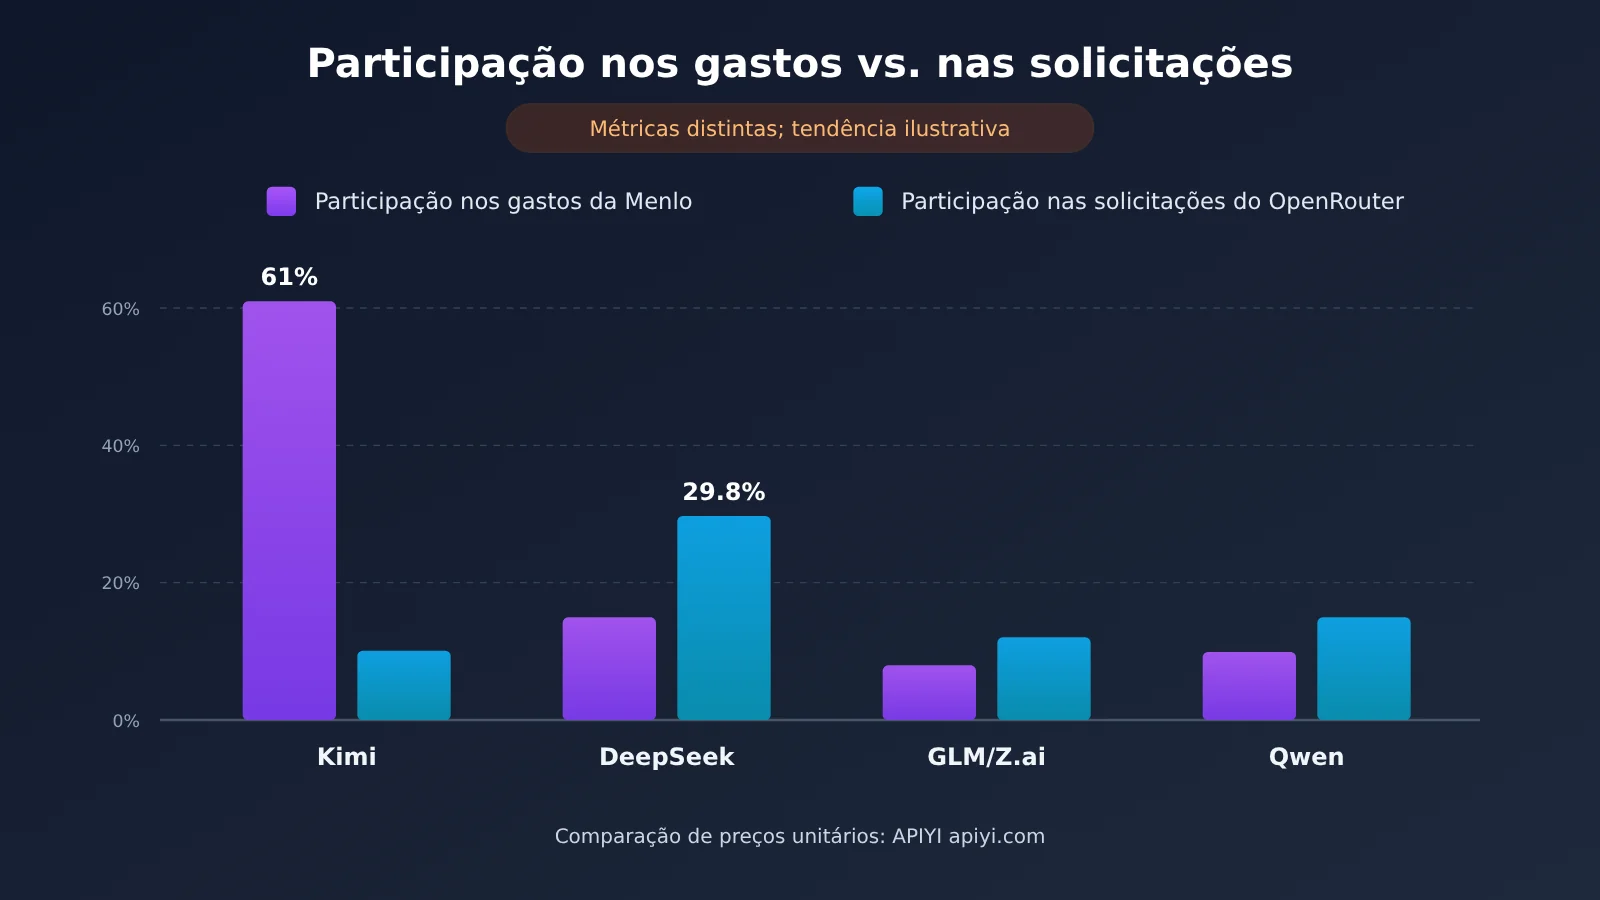
O número que mais chamou atenção no relatório é que modelos chineses representam 89% dos gastos das empresas americanas com modelos abertos. Só o Kimi fica com 61%, seguido por DeepSeek, com 15%, GLM, com 11%, e Qwen, com 3%. Entre os modelos não chineses, o Meta Llama tem 7%.
| Modelo | Participação nos gastos de empresas americanas com modelos abertos | Como interpretar |
|---|---|---|
| Kimi | 61% | Maior participação, possivelmente relacionada aos canais de compra das empresas e ao preço unitário |
| DeepSeek | 15% | Segundo em gastos, mas mais ativo em número de chamadas |
| GLM | 11% | Presença estável no orçamento das empresas |
| Meta Llama | 7% | Maior participação entre os modelos abertos não chineses |
| Qwen | 3% | Participação menor nos gastos, mas com certa presença em número de chamadas |
Os números ficam mais claros quando vistos no contexto geral. O relatório estima que os gastos globais anualizados das empresas com implantação de IA chegam a cerca de US$ 176,8 bilhões, um crescimento de mais de 100 vezes em três anos. Os laboratórios de ponta respondem por 69% dos gastos com implantação, enquanto os modelos abertos representam apenas 4% dos gastos totais com modelos. Portanto, “Kimi fica com 61%” significa 61% dessa pequena fatia de modelos abertos, não 61% de todo o mercado empresarial de IA.
Além disso, os dados do questionário dependem das estimativas dos participantes sobre o orçamento de suas próprias empresas, e a amostra de quase 400 participantes cobre apenas empresas americanas. A leitura mais razoável é que os dados indicam uma tendência nas compras das empresas; os percentuais específicos são estimativas da pesquisa e ainda precisam ser validados por mais dados.
Como ler o ranking de requisições do OpenRouter: DeepSeek fica com 29,8%
A conclusão primeiro: o ranking semanal do OpenRouter mostra a popularidade das chamadas entre os desenvolvedores da plataforma. Ele ajuda a identificar tendências, mas não representa a participação no mercado inteiro.
Na semana de 26 de outubro a 1º de novembro, a DeepSeek ficou em primeiro lugar, com 29,8% das requisições de texto, alta de 7% em relação à semana anterior. A OpenAI veio em segundo, com 18,8%; a participação do Google caiu de 14,4%; a Z.ai ficou em quarto, com 11,9%; e a Qwen, em sexto, com 5,6%.
| Posição | Fornecedor | Participação nas requisições | Variação |
|---|---|---|---|
| 1º | DeepSeek | 29,8% | +7% em relação à semana anterior |
| 2º | OpenAI | 18,8% | — |
| Em queda | Abaixo de 14,4% | Participação em baixa | |
| 4º | Z.ai | 11,9% | — |
| 6º | Qwen | 5,6% | — |
Há outras duas tendências que merecem atenção. O volume de tokens processados por modelos chineses já supera o dos modelos americanos há 27 semanas consecutivas. Além disso, quatro dos cinco modelos individuais com maior volume semanal de chamadas são chineses. No mesmo período, a DeepSeek atualizou seu modelo para DeepSeek V4.1-Flash-1017, sem alterar a forma de chamada pela API nem os preços. Para os desenvolvedores que já usam a integração, isso reduz bastante o custo de migração.
Também vale ficar de olho na estabilidade. Em 3 de novembro, a interface web e a API da DeepSeek tiveram uma interrupção parcial de cerca de uma hora. Um alto volume de chamadas não significa disponibilidade permanente — e é por isso que, mais adiante, vamos falar sobre manter um modelo de reserva. Após o lançamento da nova versão, consulte a lista de modelos no console da APIYI apiyi.com para verificar o ID do modelo e os valores cobrados.
Por que os rankings de gastos e de solicitações de modelos de código aberto estão invertidos
Em resumo: a diferença entre os rankings se deve principalmente a cinco fatores: preço unitário, forma de contratação, franquia gratuita, adequação às tarefas e critérios de cada plataforma. Isso não significa que algum dos rankings esteja “errado”.
A participação nos gastos equivale, aproximadamente, ao “volume de chamadas × preço unitário”, com a influência adicional de contratos e formas de contratação. Já a participação nas solicitações conta apenas o número de chamadas, sem considerar o custo de cada uma. Se um modelo tem preço unitário mais alto e as empresas estão dispostas a firmar contratos para usá-lo, ele tende a ficar mais bem posicionado no ranking de gastos. Se tem preço baixo e é muito usado por desenvolvedores, tende a aparecer no topo do ranking de solicitações.
| Fator | Efeito na participação nos gastos | Efeito na participação nas solicitações |
|---|---|---|
| Preço unitário | Com preço mais alto, o mesmo volume de uso custa mais, ampliando a participação nos gastos | Preços baixos atraem mais testes e aumentam o número de solicitações |
| Contratação empresarial | Contratos, implantação privada e acordos de serviço entram nos gastos | O acesso não passa necessariamente pelo OpenRouter e, nesse caso, não aparece na plataforma |
| Franquia gratuita | Chamadas gratuitas não geram gastos | Chamadas gratuitas entram na contagem de solicitações |
| Adequação às tarefas | Documentos longos, Agents e outras tarefas com alto consumo de tokens elevam os gastos | Conversas curtas e pequenas tarefas em lote aumentam o número de solicitações |
| Critérios da plataforma | Abrange apenas as empresas americanas entrevistadas | Abrange apenas os usuários do OpenRouter |
Seguindo essa lógica, o Kimi pode ter vantagem nos canais de contratação empresarial e no preço unitário, o que explicaria sua alta participação nos gastos. Já o DeepSeek tem preço unitário mais baixo e uma comunidade de desenvolvedores ativa, o que explicaria seu alto volume de solicitações. Essa é uma hipótese razoável com base nos critérios de cada levantamento: os dois relatórios não apresentam uma análise detalhada de cada fator.
Há ainda um detalhe frequentemente ignorado: versões diferentes de um mesmo modelo, canais de acesso distintos e taxas de acerto no cache também podem causar diferenças entre gastos e chamadas. Se uma equipe usa bastante o cache, as solicitações continuam sendo contabilizadas, mas o gasto real pode ser bem menor.
Preço e uso de modelos de código aberto: o que significa uma queda de cerca de 70% no preço e um aumento de 22,5 vezes no uso
A conclusão é simples: preço unitário menor não significa custo total menor. Comparar o custo para concluir uma tarefa é mais confiável do que comparar o preço por milhão de tokens.
O relatório da Menlo traz alguns números importantes: o preço médio caiu de US$ 0,45 por milhão de tokens para US$ 0,13 por milhão de tokens, uma redução de cerca de 70%. No mesmo período, o uso aumentou 22,5 vezes. Fazendo uma conta aproximada com esses números, o gasto total, em vez de cair, subiu para cerca de 6,5 vezes o valor original. Esse cálculo é apenas uma ilustração baseada nas médias do relatório; a situação real varia de equipe para equipe.
O caso dos modelos de código aberto é ainda mais revelador. Eles respondem por 19% do uso de tokens nas empresas, mas representam apenas 4% dos gastos com modelos. Em outras palavras, muitos tokens são processados por modelos de código aberto mais baratos, mas a maior parte do dinheiro ainda vai para modelos avançados de código fechado.
Para desenvolvedores, a queda no preço unitário incentiva mais invocações, especialmente em tarefas com agentes e processamento em lote. O custo real também depende de alguns fatores:
- Acertos de cache: a possibilidade de reutilizar no cache comandos de sistema e contextos longos determina diretamente o preço efetivo.
- Tamanho do contexto: em tarefas com documentos longos, a quantidade de tokens de entrada costuma ser muito maior que a de saída.
- Número de tentativas: saídas inconsistentes ou erros de formatação podem exigir novas tentativas e multiplicar o custo.
- Rodadas de chamadas de ferramentas: uma tarefa com agente pode envolver mais de dez rodadas de interação. O preço unitário é baixo, mas o número de rodadas é alto.
Ao comparar preços, vale primeiro consultar os preços de tabela e as regras de cobrança dos modelos candidatos no console da APIYI apiyi.com. Confira como são cobrados os tokens de entrada, de saída e de cache. Depois, teste um pequeno lote de amostras com suas próprias tarefas e calcule quanto custou concluir cada uma. Esse valor é uma referência mais útil do que o preço unitário de tabela.
Como escolher um modelo de código aberto: use rankings para filtrar e tarefas para decidir
Em resumo: rankings ajudam a montar uma lista de candidatos, mas a decisão final depende da adequação à tarefa, do custo, da estabilidade e de testes com uma pequena amostra.
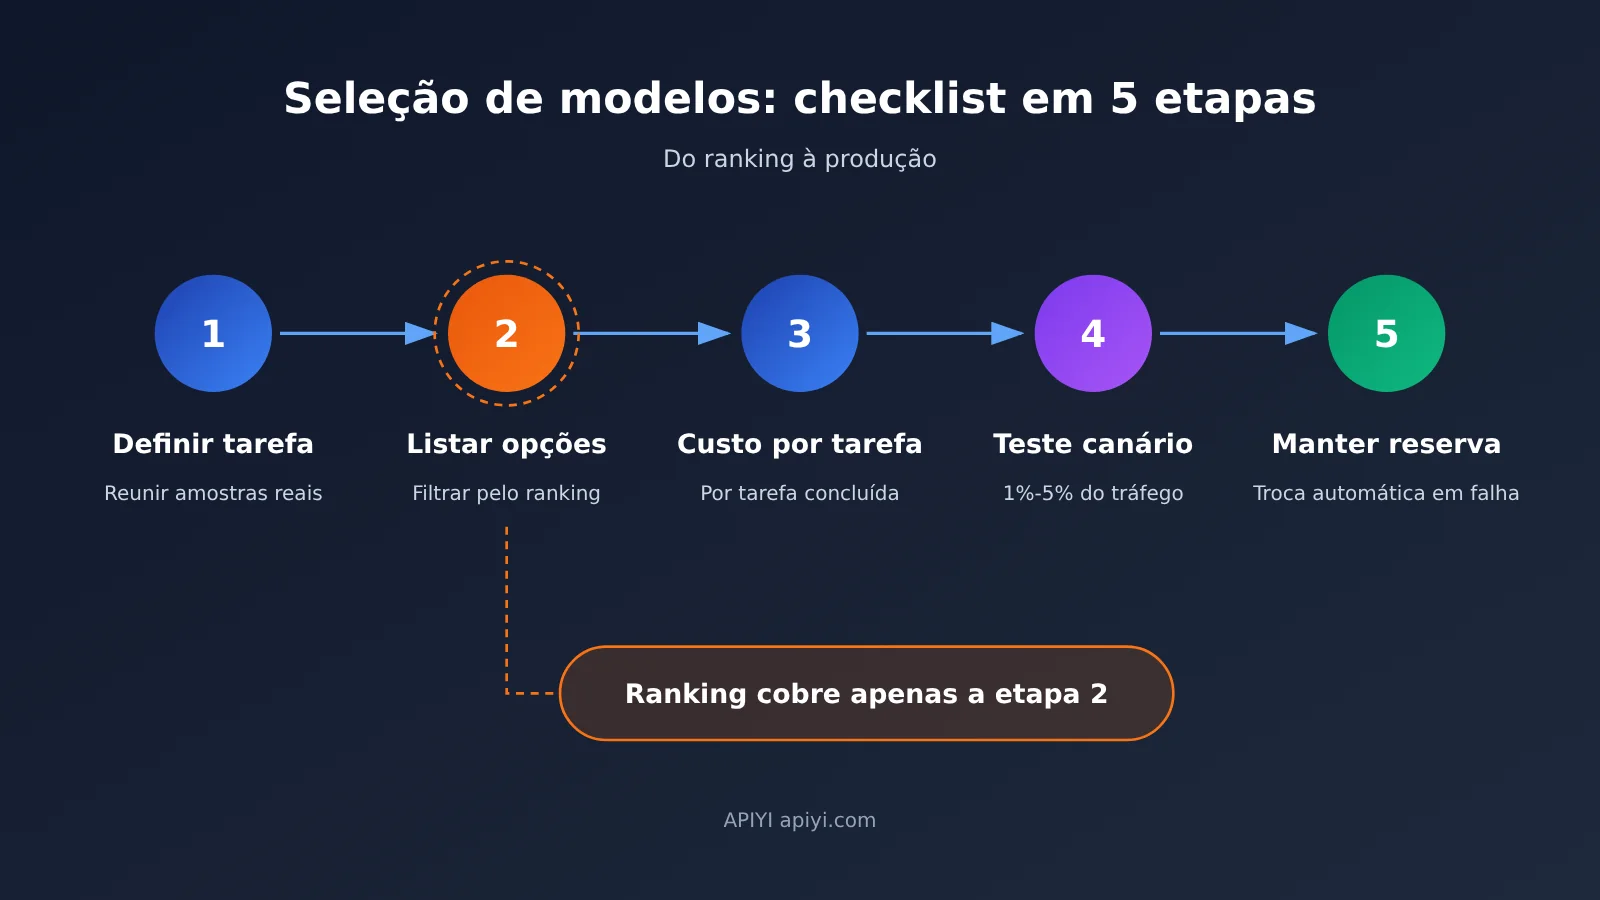
A escolha pode seguir esta ordem: tarefa → custo → estabilidade → validação → alternativa de reserva. A tabela abaixo mostra as perguntas e os métodos de avaliação para cada dimensão.
| Dimensão | O que perguntar | Como verificar | Impacto no custo |
|---|---|---|---|
| Adequação à tarefa | O foco é programação, documentos longos, tarefas multimodais ou chamadas de ferramentas por agentes? | Prepare de 30 a 100 amostras de tarefas reais e avalie as respostas manualmente | Baixa adequação aumenta as tentativas e as correções manuais |
| Preço e cache | Quanto custam os tokens de entrada, saída e os atendidos pelo cache? | Consulte a lista de modelos e as informações de cobrança no console; calcule a taxa de acerto do cache | Define o preço real por milhão de tokens |
| Contexto | Qual é o tamanho máximo da entrada? O desempenho cai em entradas muito longas? | Use os documentos reais mais longos para testar truncamento e recuperação de informações | Contextos longos aumentam diretamente o consumo de tokens de entrada |
| Limites de requisições | Os limites de concorrência e de requisições por minuto são suficientes? | Faça testes de carga com base no tráfego de pico | Ao atingir o limite, é preciso enfileirar requisições ou trocar de modelo, aumentando a latência |
| Disponibilidade regional | O acesso é estável na região de implantação? | Faça chamadas reais a partir da região de produção | Se não estiver disponível, será preciso encontrar outro canal |
| Estabilidade | Houve interrupções recentes? Quanto tempo leva para recuperar o serviço? | Consulte o histórico de incidentes e acompanhe os registros de taxa de erro | Interrupções geram custos com novas tentativas e perdas para o negócio |
Comparar vários modelos costuma ser a etapa mais demorada. Se for preciso criar uma conta e integrar um SDK separadamente para cada candidato, só a integração pode levar vários dias. Com a APIYI apiyi.com, uma única chave API permite chamar modelos de vários provedores, como OpenAI, Claude, Gemini, DeepSeek e Kimi. A interface é compatível com o formato da OpenAI: basta definir base_url como https://api.apiyi.com/v1 e alterar o parâmetro model na requisição para trocar de modelo. Assim, você consegue testar rapidamente o mesmo conjunto de amostras e comparar os resultados.
Para avaliar a estabilidade, não basta olhar os comunicados dos provedores. A interrupção da DeepSeek em 3 de novembro lembra que qualquer modelo pode ficar temporariamente indisponível. No console da APIYI apiyi.com, é possível consultar o uso e os registros de chamadas por modelo, incluindo taxa de erro, latência e consumo de tokens. Isso ajuda a acompanhar o desempenho real dos candidatos durante a implantação canário. A plataforma usa implantação em múltiplos nós e roteamento inteligente, além de oferecer fallback automático. A aplicação também pode configurar um modelo de reserva e acioná-lo se o principal falhar, reduzindo o impacto de uma falha em um único ponto.
Para a implantação canário, comece com 1% a 5% do tráfego real e acompanhe por alguns dias a taxa de erro, a latência e o custo por tarefa. Se os dados estiverem estáveis, aumente o tráfego gradualmente. Não faça a troca completa de uma vez apenas com base no ranking.
Perguntas frequentes sobre rankings de modelos de código aberto
Em resumo: as cinco perguntas abaixo abordam os equívocos mais comuns na leitura de rankings de modelos de código aberto.
Q1: A participação de 61% do Kimi nos gastos significa que o modelo é melhor?
Não. A participação nos gastos mostra para onde o dinheiro foi, e é influenciada pelo preço unitário, pelos contratos de compra das empresas e pelos canais utilizados. Ela não tem relação direta com a capacidade do modelo. Além disso, os dados da Menlo são estimativas de pesquisa que abrangem apenas os gastos de empresas americanas com modelos de código aberto. “Primeiro em gastos” não significa “primeiro em capacidade”: avalie o desempenho usando suas próprias tarefas.
Q2: O ranking de requisições do OpenRouter representa as compras das empresas?
Não. O OpenRouter contabiliza a participação nas requisições feitas em sua própria plataforma, usada principalmente por desenvolvedores e equipes pequenas e médias. Contratos diretos de empresas, implantações privadas e outros canais ficam fora dessa contagem. O ranking serve para acompanhar a popularidade entre desenvolvedores e as tendências de uso sensíveis a preço, mas não para tirar conclusões sobre como as empresas distribuem seus orçamentos.
Q3: Um modelo com preço unitário menor sempre terá custo total menor?
Não necessariamente. Se um modelo mais barato exigir mais tentativas, comandos mais longos ou mais rodadas de chamadas de ferramentas, o consumo total de tokens pode acabar sendo maior. Uma boa prática é calcular o custo para “concluir uma tarefa”: no console da APIYI apiyi.com, consulte o uso de tokens e os registros de custos de cada chamada e compare o gasto total de diferentes modelos para concluir o mesmo conjunto de tarefas.
Q4: Modelos de código aberto podem substituir completamente os de código fechado?
Depende da tarefa. Segundo os dados da Menlo, modelos de código aberto responderam por 19% dos tokens usados pelas empresas, mas por apenas 4% dos gastos. Isso indica que muitas equipes usam modelos abertos para tarefas rotineiras e em grande volume, enquanto deixam as tarefas complexas para modelos de ponta fechados. Uma abordagem mais segura é combinar os dois: pela APIYI apiyi.com, use a mesma chave para acessar modelos abertos e fechados e direcione as tarefas conforme a dificuldade.
Q5: Com que frequência vale a pena consultar rankings de modelos de código aberto?
Você pode conferir os rankings semanais uma vez por mês, olhando para as tendências em vez de se prender às oscilações de uma única semana. Quando saírem relatórios anuais ou trimestrais, leia-os com atenção e verifique se houve mudanças nos critérios e na amostra. O que realmente influencia suas decisões é o acompanhamento contínuo dos indicadores do seu negócio, como taxa de erro, custo por tarefa e feedback dos usuários. Vale revisá-los toda semana.
Rankings de modelos open source: checklist de seleção em 5 passos
Em resumo: os dois rankings medem coisas diferentes. Para interpretá-los, primeiro entenda o que cada um mede, depois examine a amostra e, por fim, valide os resultados nas suas próprias tarefas.
Principais pontos:
- Gasto ≠ chamadas: a Menlo mede os gastos das empresas; o OpenRouter mede as requisições na plataforma. Como as bases são diferentes, não dá para compará-las diretamente.
- Pesquisa ≠ auditoria: os dados da Menlo são estimativas de uma pesquisa com quase 400 tomadores de decisão de empresas americanas. Já o OpenRouter representa apenas sua própria plataforma.
- Preço menor ≠ economia: o preço unitário caiu cerca de 70%, mas o uso cresceu 22,5 vezes e o gasto total aumentou. Por isso, calcule o custo por tarefa.
- Popular ≠ estável: até o modelo com mais chamadas pode sofrer interrupções. Prepare uma alternativa com antecedência.
- Rankings ajudam a reduzir a lista de candidatos, mas não substituem o processo de seleção.
Use este checklist na próxima seleção de modelo:
- Defina a tarefa: descreva os principais tipos de tarefa (programação, documentos longos, multimodal, Agent) e reúna de 30 a 100 exemplos reais e critérios de avaliação.
- Liste os candidatos: escolha de 2 a 3 modelos de cada ranking, de gastos e de requisições, e acrescente 1 modelo de código fechado como referência. Limite a lista final a 3-5 candidatos.
- Calcule o custo por tarefa: execute todos os candidatos com o mesmo conjunto de exemplos. Registre o uso de tokens, os acertos de cache e o número de tentativas, e calcule o custo por tarefa e a pontuação de qualidade.
- Faça um teste canário: direcione primeiro 1%-5% do tráfego real ao modelo escolhido. Observe a taxa de erros, a latência e o custo por alguns dias e aumente o tráfego depois que ele atingir os critérios.
- Mantenha uma alternativa: configure pelo menos um modelo alternativo de outro fornecedor, defina regras de troca e teste o procedimento regularmente.
Para realizar as etapas 3 a 5 em uma única plataforma, você pode usar uma única chave na APIYI apiyi.com para acessar os modelos candidatos, comparar preços, uso e logs no console e configurar a troca para um modelo alternativo com o recurso de fallback automático da plataforma. Novos usuários recebem créditos gratuitos para testes, úteis para começar com uma amostra pequena.
Fontes dos dados
- Relatório de 2026 da Menlo Ventures sobre o estado da IA nas empresas: publicado em 3 de novembro de 2026
- Link:
menlovc.com -
Descrição: gastos empresariais com IA, participação dos modelos open source nesses gastos e variação dos preços de tokens; dados estimados a partir de pesquisa
-
Ranking de modelos do OpenRouter: ranking semanal de 26 de outubro a 1º de novembro de 2026
- Link:
openrouter.ai/rankings - Descrição: participação nas requisições de texto e tendências de uso de tokens; representa apenas a própria plataforma
Autor: Equipe técnica da APIYI
Contato técnico: se tiver dúvidas sobre preços, limites de requisições ou troca de modelos, entre em contato pela página inicial da APIYI em apiyi.com. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com