著者注: 今回は請求書(コスト)に関する疑問にお答えします。ここ数ヶ月でモデルの定価は急速に値下がりしたものの、コーディングAgentの利用コストは依然として高いままです。本稿の価格は2026年10月26日時点で確認できる各社公式価格表、およびAPIYIのモデル価格ページをもとに照合しています。なお「96%」という数値はサードパーティ著者による独自の試算であり、本稿での実測値ではありません。
2026年6月26日から2026年9月29日までの約4ヶ月間、OpenAIとAnthropicは競うように価格改定を繰り返しました。Max Woolf氏は2026年10月25日、このタイムラインを自身のサイト(minimaxir.com/2026/10/cheap-llms)にまとめ、タイトルでは「最大80%の値下げ」と掲げています。同記事によると、コーディングAgentでは総トークン費用の96%〜99%をキャッシュ読み取り(Cache Read)が占めています。これはターンごとにこれまでの会話履歴をキャッシュから再度読み込むためで、推論プロバイダーによって異なるものの、キャッシュヒット率は約90%〜100%に達します。なお、元の記事には検証可能なリクエストログが添付されていません。本稿ではこの数値をあくまでサードパーティの試算として扱い、読者自身の実際の利用量にそのまま当てはめることは避けています。
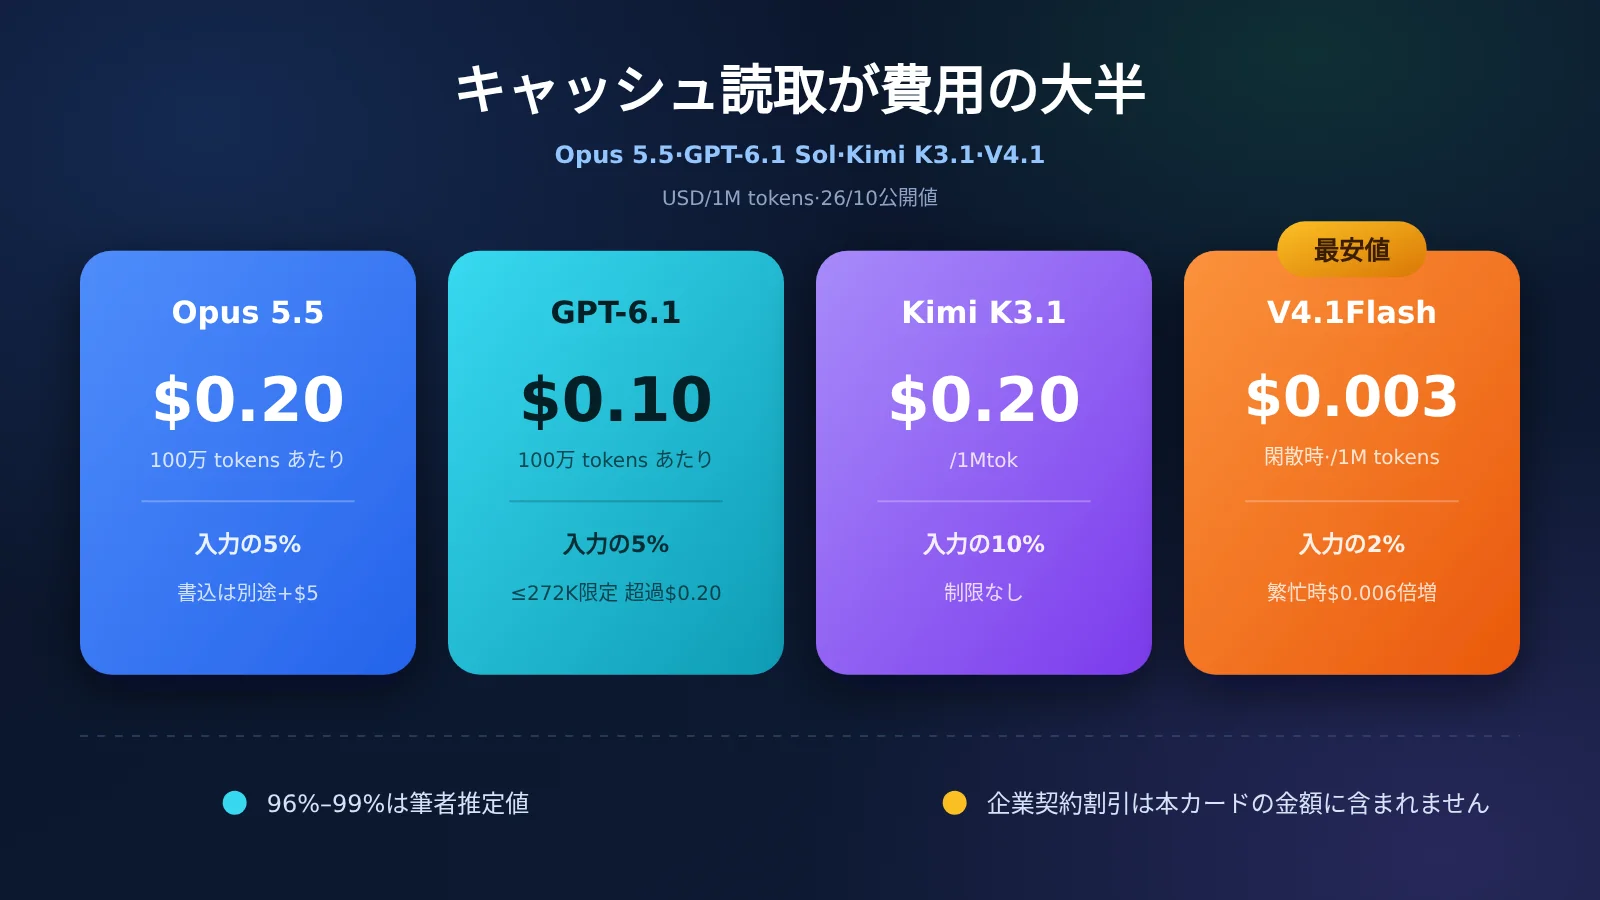
同時期において、現在も公式価格表と照合できるキャッシュ読み取り料金は以下のとおりです。
- Claude Opus 5.5:$0.20
- GPT-6.1 Sol(入力272K以下):$0.10
- Kimi K3.1 Pro:$0.20
- DeepSeek V4.1 Flash:オフピーク $0.003、ピーク $0.006
※単位はいずれも米ドル / 100万トークン($/1M tokens)です。
これは「一長一短で妥協する」ための比較表ではありません。 プレフィックスが固定されており、入力が通常272Kを下回るコーディングループであれば、クローズドソース3社の中ではまずGPT-6.1 Solのキャッシュ読み取りに注目すべきです。さらに一桁抑えたい場合は、DeepSeekのオフピーク時のキャッシュ読み取りを検討しましょう。Opus 5.5とKimiのキャッシュ読み取り価格は同等ですが、キャッシュミス時の入力料金、出力料金、および書き込みプレミアムに違いがあります。
本稿のポイント: 読み終えることで、単純な入力価格ではなく「キャッシュヒット率」を基準にモデルを選べるようになり、メディアで報じられる大企業向け割引がなぜ小規模チームの請求額と一致しないのかが理解できるようになります。
💡 選択のアドバイス: 4社のモデルはすべて、APIYI(apiyi.com)にて共通のAPIキーでモデル名を切り替えてテスト運用できます。新規アカウントには無料テスト枠も用意されています。まずはプレフィックスを固定し、利用状況内のキャッシュ読み取り量を確認したうえで判断しましょう。一度きりの短い対話だけで結論を出さないことが大切です。
4大モデルのキャッシュ読み取り料金、どこに差があるのか?
まずはキャッシュ読み取り料金と、それがキャッシュ未命中(ミス)時の入力料金に占める割合を見ていきましょう。この割合によって、長い会話においてキャッシュ読み取りがどれほど「お得」になるかが決まります。Opus 5.5 と GPT-6.1 Sol の短コンテキストではどちらも入力料金の5%、Kimi K3.1 Pro は10%、DeepSeek V4.1 Flash はわずか2%となっています。絶対的な価格差はこの比率以上に大きく、オフピーク時の Flash($0.003)は、Sol の短コンテキスト($0.10)の33分の1、$0.20 のモデルと比べると実に67分の1という驚きの安さです。
| モデル | キャッシュ読み取り | 未命中入力比 | キャッシュ未命中入力 | 出力 |
|---|---|---|---|---|
| Claude Opus 5.5 | $0.20 | 5% | $4 | $20 |
| GPT-6.1 Sol(入力 ≤272K) | $0.10 | 5% | $2 | $10 |
| GPT-6.1 Sol(入力 >272K) | $0.20 | 5% | $4 | $15 |
| Kimi K3.1 Pro | $0.20 | 10% | $2 | $10 |
| DeepSeek V4.1 Flash(オフピーク) | $0.003 | 2% | $0.15 | $0.60 |
| DeepSeek V4.1 Flash(ピーク時) | $0.006 | 2% | $0.30 | $1.20 |
単位はすべて100万トークンあたりの米ドル(USD / M tokens)です。Batch、Fast、リージョン追加料金などは含まない標準レートを記載しています。Opus 5.5 は Anthropic の価格表に基づいており、キャッシュヒット時は入力料金の0.05倍(5%)で計算されます。GPT-6.1 Sol は OpenAI の標準価格で、短コンテキストとは入力が272Kトークン以下の場合を指します。これを超えるとキャッシュ読み取り・入力・出力のすべてが上位ティアへと切り替わります(ただし出力は$20ではなく$15です)。Kimi は Moonshot の公開情報に基づいており、コンテキスト長による価格ティアの変動はありません。DeepSeek は公式価格ページのもので、モデル名は deepseek-flash、バージョンは DeepSeek-V4.1-Flash-1017 です。ピーク時は月曜〜金曜の UTC 01:00–04:00 および 06:00–10:00(中国の法定節假日を除く。北京時間 09:00–12:00 / 14:00–18:00、日本時間 10:00–13:00 / 15:00–19:00)となります。この2つの時間帯の合間にある 12:00–14:00(北京時間)はオフピーク扱いです。また、週末と中国の祝日は終日オフピーク料金が適用されます。
APIYI のモデル価格一覧(docs.apiyi.com/models )における2026年10月25日時点のカタログでは、claude-opus-5-5 が $4 / $20 / $0.20、gpt-6.1-sol が $2 / $10 / $0.10(272,000トークン超過後は入力が $4 になると記載あり)、kimi-k3.1-pro が $2 / $10 / $0.20 となっています。DeepSeek は2行に分かれており、deepseek-v4.1-flash および deepseek-flash は公式のピーク時と同じ $0.30 / $1.20 / $0.006、deepseek-v4-1-flash-260910 は公式のオフピーク時と同じ $0.15 / $0.60 / $0.003 です。公式ではリクエスト到達時間に応じて自動で切り替わりますが、APIYI のカタログではこの2つの価格帯を別々のモデル行として提供しています。モデル呼び出しを行う際は、事前にコンソールに表示されているモデル名をご確認ください。
ただし、キャッシュ読み取りは請求額の半分に過ぎません。プレフィックスが期限切れになった際、再び追加コストを支払う必要があるかどうかは「書き込み料金」によって決まります。なお、下表における「短期」「長期」の保持時間は分単位で単純比較できない点にご注意ください。OpenAI の短期枠はすでに30分となっていますが、Anthropic と Kimi の短期枠は5分間です。
| モデル | 短期書き込み | 長期書き込み | プレフィックスのキャッシュ化方法 |
|---|---|---|---|
| Opus 5.5 | 5分、$5(入力の1.25倍) | 1時間、$8(入力の2倍) | リクエストに cache_control を含める |
| GPT-6.1 Sol(≤272K) | 30分、$2.50(入力の1.25倍) | 12時間、$5(入力の2.5倍) | 料金表に書き込み価格が個別に記載;プレフィックスの固定が必須 |
| Kimi K3.1 Pro | 5分、$2(入力価格と同額) | 1時間、$4(2倍換算で推計) | デフォルトで自動適用(5分);より長い間隔が必要な場合は1時間を指定 |
| V4.1 Flash | 個別の書き込み料金なし | なし | 初回はキャッシュミス扱い、以降はキャッシュ読み取り価格 |
Kimi公式サイトのトップページに記載されているキャッシュ書き込み料金は$2で、これはデフォルトの5分枠に該当します。1時間枠の$4は、APIYIのKimiドキュメントにある設定価格に基づいています(同ページには、このキャッシュ枠設定が今回のテストにおける決済検証をまだ完了していない旨が明記されています)。前世代のKimi K3の公式説明では、1時間枠の書き込みは5分枠の2倍とされており、K3.1 Proでも同様の倍率を適用すると$4となります。コンソールの表示と異なる場合は、コンソールの記載を優先してください。高速版である kimi-k3.1-pro-highspeed は入力と出力が2倍になりますが、キャッシュ読み取りは$0.20のままです。プレフィックスのヒット率が高い場合、両者の価格差は大幅に縮まります。
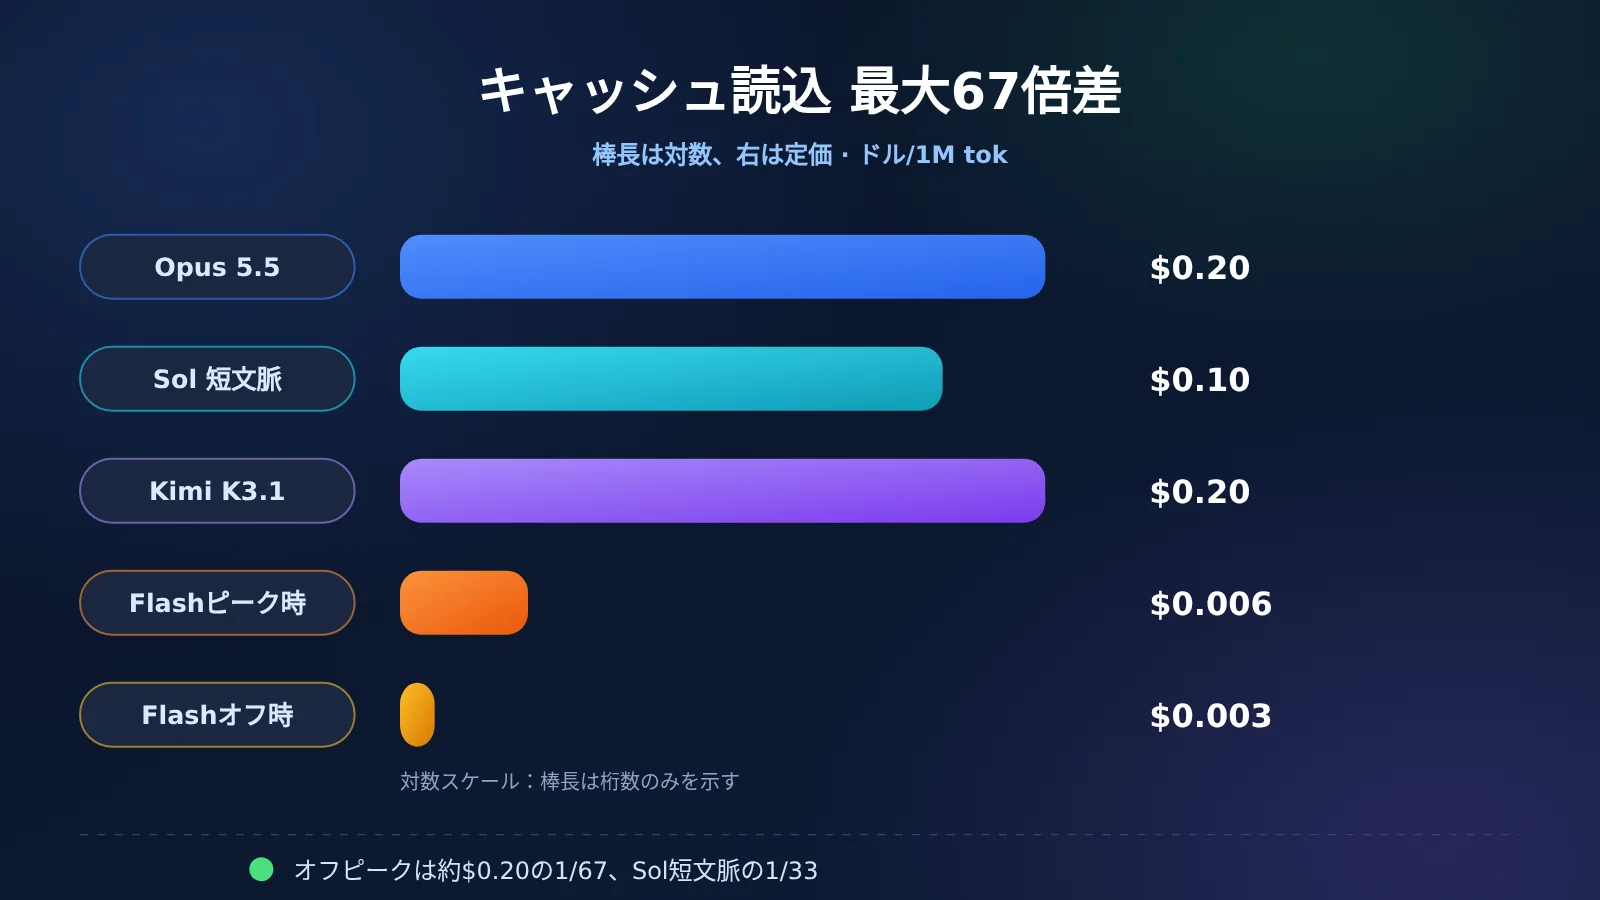
グラフのバーの長さは、あくまで桁数(オーダー)を視覚的に把握するためのものです。実際の請求金額は、元の単価にトークン数を掛けて計算されます。同一のAPIキーでモデルを切り替えた際は、本グラフで金額を概算するのではなく、APIYIコンソールの「キャッシュ読み取り」列の記載を必ずご確認ください。
コード生成Agentの請求でキャッシュ読み取りを別枠にするべき理由
Agentは毎ターン、システムプロンプト、ツール定義、そしてこれまでの会話履歴をすべて再送信します。プレフィックス(接頭辞)が変わっていない部分は、キャッシュ読み取り(Cache Read)として安価に課金される可能性があります。一方で、プレフィックスが変化した位置以降はキャッシュ未ヒット(Miss)として扱われ、プロバイダーによってはさらに書き込み料金(Cache Write)が発生します。そのため、入力トークンの単価が20%下がったからといって、コード生成タスク全体のコストが20%下がるわけではありません。キャッシュ読み取りがトークン消費の大半を占めているなら、注目すべきはまさに「キャッシュ読み取り」の項目なのです。
Max Woolf氏の「96%〜99%」という記述は、「総トークン消費量(expenditure)」を指しています。英語の「expenditure」は金額ともトークン消費量とも解釈できますが、原文では分母が明確に示されていませんでした。一方、別のサードパーティ測定ではその基準が明確に定義されています。WorkloadBenchが2026年10月16日に更新したデータによると、長時間のコーディングタスクにおいて、プロンプトトークンの89%〜96%がキャッシュからの読み取りでした。GPT-6.1 SolとClaude Opus 5.5の中央値はいずれも95%で、範囲はそれぞれ91%〜98%、94%〜99%となっています(出典:workloadbench.brenhq.com/cache)。これはあくまで「プロンプトトークン」に対する比率であり、分母に出力トークンは含まれておらず、ましてやドル換算の金額比率でもありません。この2つのデータを安易に混同して「請求額の96%」と解釈してはいけません。
金額ベースの比率は通常、これよりもずっと低くなります。出力トークンの単価がキャッシュ読み取りの数十倍から数百倍にも達するためです。ここではコスト構造を把握するために、明確な前提条件を置いた試算モデルを見てみましょう(筆者の実データや実測ログではなく、構造比較のためのシミュレーションです)。40ターンを想定し、毎ターンのキャッシュ読み取りが120,000トークン、新規の未ヒット分が1,500トークン、出力が800トークン、そしてセッション開始時に初回書き込みとして40,000トークンが発生するとします(この40,000トークンは毎ターンの未ヒット分には重複計上しません。DeepSeekのように書き込み料金がない場合は未ヒットとして扱います)。毎ターンの入力は約12万トークンとなり、Solの短コンテキスト枠に収まります。
トークン合計は4,932,000トークン、そのうちキャッシュ読み取りが4,800,000トークンで、全体の約97%を占めます。これは、「プレフィックスが長く、ターン数が多く、1ターンあたりの出力が短い」という条件下であれば、トークン数が前述の範囲に収まることを示しています。
| モデル | キャッシュ読み取り | 未ヒット(Miss) | 出力 | 書き込みまたは初回未ヒット | 合計 | キャッシュ読み取りの金額比率 |
|---|---|---|---|---|---|---|
| Opus 5.5(5分書き込み) | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | 約47% |
| GPT-6.1 Sol(≤272K、30分書き込み) | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | 約47% |
| Kimi K3.1 Pro(5分書き込み) | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | 約65% |
| V4.1 Flash(オフピーク) | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | 約30% |
| V4.1 Flash(ピーク時) | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | 約30% |
OpusとSolの短コンテキストにおける4項目の単価はちょうど2倍の関係にあるため、構成比は同じになり、合計金額はちょうど半分になります。Kimiのキャッシュ読み取り単価は通常入力の5%ではなく10%に設定されているため、同じトークン構造でもキャッシュ読み取りの金額比率は約65%に達し、合計$1.48と両者の中間に位置します。Flashのオフピーク時の合計は約$0.049で、ピーク時にはその倍になります。キャッシュ読み取り単価が未ヒット時のわずか2%であるため、この試算では金額の最大シェアが出力(約4割)に戻り、キャッシュ読み取りは約3割にとどまります。それでもフラグシップ級の3モデルにおいては、キャッシュ読み取りが試算表の中で最大の支出項目であることに変わりはありません。Flashの強みは請求書全体の桁数を劇的に下げる点にあり、「96%がキャッシュ読み取り」という金額構造そのものを再現しているわけではないのです。
プレフィックスがターンごとに変わってしまうようでは、先ほどの比較表は役に立ちません。タイムスタンプや、ランダムな順序で並んだツールリスト、システムプロンプトの途中に差し込まれたユーザー名などは、どれもキャッシュヒットを台無しにしてしまいます。そうなった場合に比較すべきなのは、キャッシュミス時の価格と書き込み価格です。Opusの5分間書き込みは通常入力の1.25倍、Solの30分間書き込みも1.25倍で、12時間書き込みは2.5倍になります。一方、Kimiの5分間書き込みは通常入力と同額で、短期枠の割増はありません。DeepSeekは初回がそのままキャッシュミス時の価格となります。
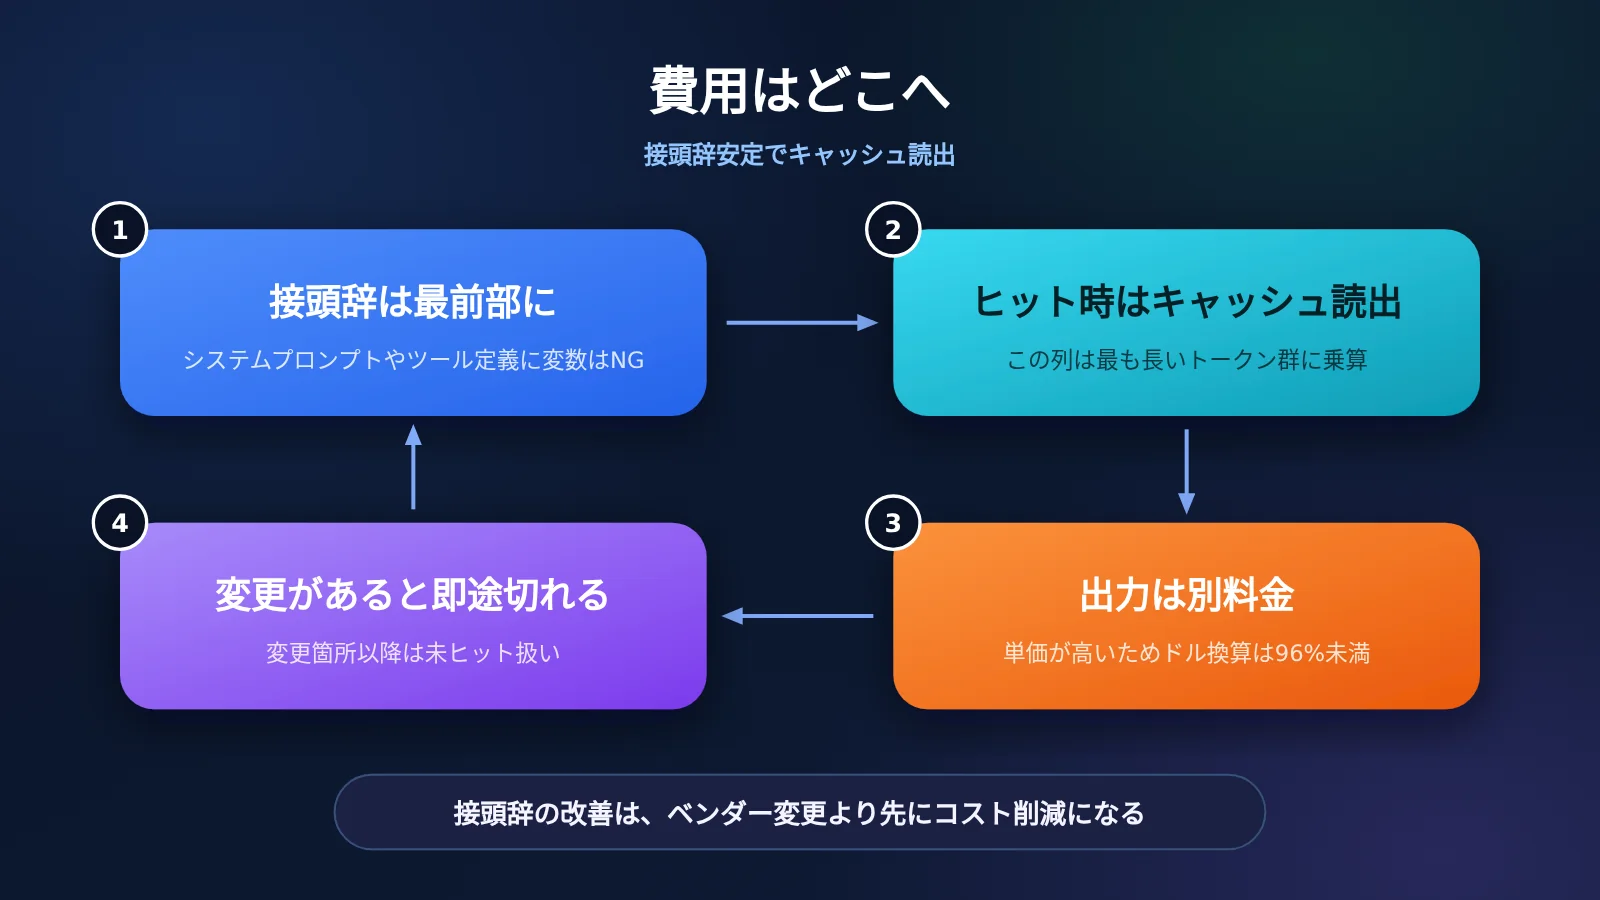
プロバイダーを乗り換えるよりも、まずはプレフィックスを見直すほうが手っ取り早くコストを抑えられます。ツールリストの並び順を固定する、動的なコンテンツはメッセージの末尾に配置する、同一セッションの間隔が短期枠のTTLを超えないようにする——これらを徹底したうえで、キャッシュ読み取りの単価をもとにモデルを選択するのがベストです。
この4ヶ月の値下げタイムラインは何を物語っているのか?
「最大80%値下げ」という点には合致する箇所が2つありますが、どちらもすべてのモデルが一律8割引き(20%の価格)になったと解釈すべきではありません。1点目はMax Woolf氏の記録にある通り、2026年7月30日にOpenAIがGPT-5.6 Lunaの価格を$1 / $6 / $0.10から$0.20 / $1.20 / $0.02へと引き下げたケースで、入力とキャッシュ読み取りがともにおよそ80%値下げされています。2点目はSolシリーズのキャッシュ読み取りで、2026年6月26日のGPT-5.6 Solにおける$0.50から、2026年9月29日のGPT-6.1 Solにおける$0.10への値下げであり、こちらも80%の引き下げです。ただし、モデル自体が5.6から6.1へと世代交代しており、同一SKUに単に値引きシールが貼られたわけではありません。
| 日付 | 記録された変更内容 | 入力 / 出力 / キャッシュ読み取り |
|---|---|---|
| 2026-06-26 | OpenAIがGPT-5.6 SolとLunaをリリース | Sol $5 / $30 / $0.50 |
| 2026-06-30 | AnthropicがSonnet 5をリリース(当時の発売価格は暫定と説明) | $2 / $10 / $0.20 |
| 2026-07-24 | AnthropicがOpus 5をリリース | $5 / $25 / $0.50 |
| 2026-07-30 | GPT-5.6 Lunaが値下げ | $0.20 / $1.20 / $0.02 |
| 2026-08-21 | GPT-5.6 Solが3ヶ月間の期間限定で約20%値下げ | $4 / $20 / $0.40 |
| 2026-09-01 | Fable 5.1、キャッシュ読み取りが6月のFable 5より低価格に | $10 / $50 / $0.25 |
| 2026-09-22 | 同日にGPT-6 SolとOpus 5.5をリリース | Sol $2 / $10 / $0.20;Opus 5.5 $4 / $20 / $0.20 |
| 2026-09-29 | GPT-6.1 Sol、キャッシュ読み取りがさらに半額に | $2 / $10 / $0.10 |
上記の表はMax Woolf氏による整理データで、価格の並び順はいずれも「入力 / 出力 / キャッシュ読み取り」となっています。本記事で改めて確認したのは末尾2行の現行価格です。Opus 5.5の「$4 / $20 / $0.20」はAnthropicの公式料金表と一致しており、GPT-6.1 Solの「$2 / $10 / $0.10」はOpenAIの標準枠・短コンテキストの価格と一致しています。それ以前の行については公式アナウンスを1件ずつ遡って確認したわけではないため、引用する際は同氏の原文をご参照ください。
また、同氏はOpus 5.5について「総コストが40%〜60%削減された」とも述べています。公式の料金表から確認できるのは3項目の単価です。Opus 5と比較すると、入力と出力はそれぞれ20%値下げされ($5から$4、$25から$20)、キャッシュ読み取りは$0.50から$0.20へと60%値下げされています。「40%〜60%」というのは、同氏が利用パターンに基づいて試算したレンジであり、公式の一律割引ではありません。Anthropic側のコメントとしては、「Opus 5.5はOpus 5よりも推論計算量が少なく、価格設定にはそれが反映されている」と説明されています。これはベンダー側の発表によるものです。
さらに同氏は、DeepSeek V4.1 FlashがDeepSeek自社のAPIエンドポイントにおいて、およそ$0.15 / $0.60 / $0.003であるとも記しています。この数値は公式のオフピーク(閑散時)価格と一致しており、ピーク時には倍になります。Kimi K3.1 Proについては「$2 / $10 / $0.20」と記載されており、公式サイトのカード表記と一致しています。なお、文中にあるArtificial Analysisのスコア(Kimi:55、Opus 5.5:58、Flash:45)はサードパーティによる指標であり、本記事独自のコーディング評価ではありません。モデル選定の際には、このわずか3点ほどのスコア差だけで判断しないように注意してください。
エンタープライズ割引が使えない小規模チームはモデルをどう選ぶべきか?
公開されている定価の裏には、大口顧客だけが享受できる特別な割引が存在します。AI Weekly(2026年10月24日付)がThe Informationの報道として伝えたところによると、OpenAIは30%以上の割引を提示し、年間1億ドルを超える大型契約を獲得しました。これにより、ReplitはAI関連支出の大半をAnthropicからOpenAIへと切り替えたとされています。報道によれば、AnthropicはこれまでReplitに提供していた割引の継続を見送ったとのことです(ただし、当事者3社による公式発表はありません)。ReplitのCEOであるAmjad Masad氏はTechCrunch Disruptにて、今回の決定はコスト、パートナーシップ、そして性能を総合的に考慮した結果だと述べています。同報道では、Claudeモデルも引き続き選択肢として残るものの、エージェントのデフォルトはOpenAIになると伝えられています。また同記事では、Ripplingもコーディング用途の利用をAnthropicからOpenAIへ移行したとされ、その理由としてコストを挙げています。これらはあくまで報道ベースの話であり、3社が公式に公表した価格表ではありません。
小規模なチームでは、このような大型契約を結ぶことは不可能です。年間1億ドルのコミットメントがなければ、報道にあるような30%もの割引は引き出せません。仮に30%オフをOpusのキャッシュ読み取り単価に機械的に適用したとしても、$0.20が$0.14になるだけで、GPT-6.1 Solの短コンテキスト時の公開価格($0.10)より依然として割高です。報道ではこの割引がキャッシュ読み取り、キャッシュミス(通常入力)、あるいは総額のどこに適用されたのかまでは明記されていませんが、この比較は桁感(スケール)を把握するだけでも十分意味があります。小規模チームの第1次選定としては、公開されているキャッシュ読み取り価格をベースに検討すれば十分なのです。
| セッションの特徴 | まず検討すべきモデル | 理由 |
|---|---|---|
| プレフィックスが固定、入力が通常272K未満、商用クローズドのコーディングモデルが必要 | GPT-6.1 Sol | キャッシュ読み取りが$0.10で、3社の中で最安 |
| 1回の入力が272Kを超える場合 | $0.10の前提は見直しが必要 | Solのキャッシュ読み取りは$0.20に、出力は$15に跳ね上がる |
| キャッシュ読み取り予算はOpusと同等で、キャッシュミス時の入力や出力を安く抑えたい | Kimi K3.1 Pro | キャッシュ読み取りは同じ$0.20だが、入力/出力が$2 / $10と安価で、トークン長による価格変動がない |
| キャッシュヒット率が高く、タスクの実行をピーク時間外に回せる | DeepSeek V4.1 Flash(オフピーク時) | キャッシュ読み取りが$0.003と、桁違いにコストを削減可能 |
| 平日の北京時間9:00〜12:00、14:00〜18:00に実行が集中する場合 | ピーク時料金でFlashを再計算 | キャッシュ読み取りが$0.006となり、その他の単価も2倍になる |
| 毎回のターンでプレフィックスが変わる | まずプレフィックス設計を見直す | キャッシュ読み取りの恩恵をまったく受けられない |
この表ではモデルの「性能」順には並べていません。Max Woolf氏は、より高価なFable 5.1よりもOpus 5.5のほうが優れていると評価していますが、これはあくまで同氏の使用環境に基づく判断です。またDeepSeek公式は、deepseek-flashが現在DeepSeek-V4.1-Flash-1017によって提供されており、従来のdeepseek-v4-flashという名称も引き続きFlash料金で利用可能であること、そしてdeepseek-v4-proは別枠で提供されていることを明記しています。ただし、公式からFlashとProの明確な性能序列は示されていません。失敗したときのやり直しコストがトークン単価の差額を上回る場合は上位モデルを使い、失敗コストが差額より低ければFlashを使って試行回数を回す、というのが賢い使い分けです。
💰 コスト最適化のヒント: カタログ価格はあくまで標準価格です。APIYI(apiyi.com)の管理コンソールでは、所属グループに応じた割引後の価格が表示されます。チャージキャンペーンなどは別途適用され、ルールは価格ページに公開されています。これらは営業と交渉して勝ち取る年間フレームワーク契約ではなく、誰でも利用できる公開ルールです。実際の請求額は管理コンソールの表示をご確認ください。
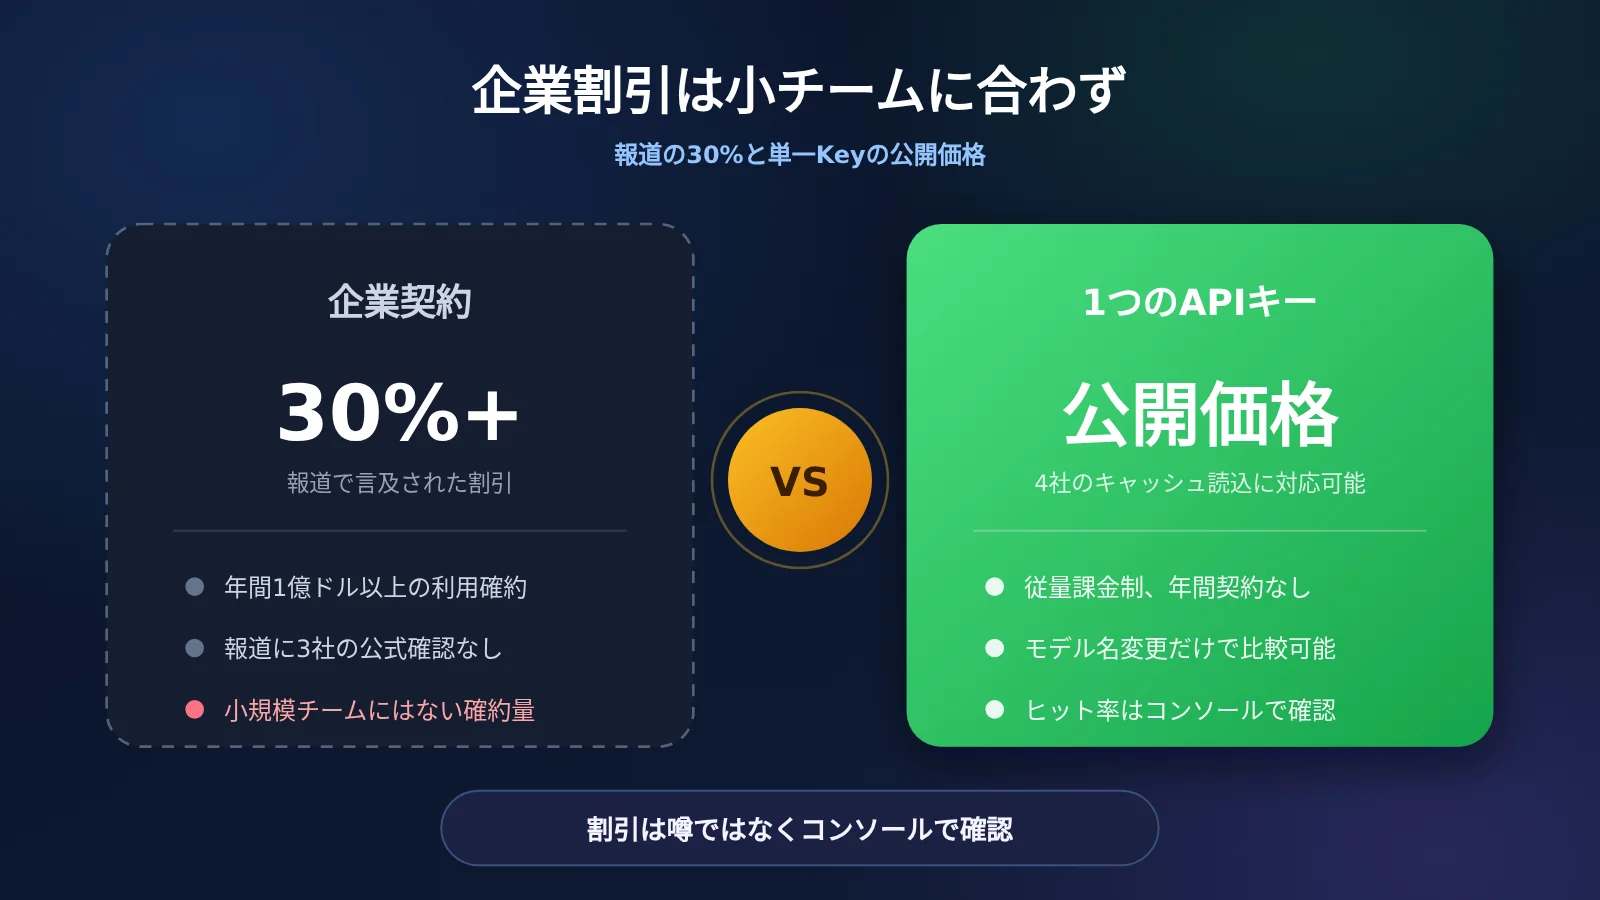
図の左側にある「30%割引」や「年間1億ドル」は報道上の数字であり、小規模チームがそのまま適用できる価格ではありません。現実的に小規模チームが実行できる選択肢は、図の右側に示されたアプローチです。
1つのキーで4社のキャッシュ読み取りを検証する方法
料金ページでは、GPT-5以降のモデルは /v1/responses を優先して利用することが推奨されており、マルチターンのキャッシュヒット率が高くなります。Chat Completions も引き続き利用可能です。以下の手順で Chat Completions を使用しているのは、gpt-6.1-sol、kimi-k3.1-pro、deepseek-flash でモデル名だけを切り替えてテストできるようにするためです。Opus 5.5 のキャッシュはこのパスのデフォルトの挙動ではありません。現在の Anthropic の有効化方法は、リクエストのトップレベルに cache_control を配置するか、コンテンツブロックにブレークポイントを設定することです。APIYI は claude-opus-5-5 に対して chat と messages の両方を提供しています。キャッシュ料金を適用させるには、messages を利用し、cache_control を付与してください。Chat Completions のみを使用する場合、カタログに記載されている $0.20 がすでに適用されていると思い込まないよう注意してください。
- 基本ツールのセットアップ: SDKをまだインストールしていない場合は、まず
pip install openaiを実行します。ファイルの先頭にimport osとfrom openai import OpenAIを記述してください。キーは環境変数APIYI_API_KEYに設定し、リポジトリにコミットしないようにしましょう。 - クライアントの作成:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")と1行記述するだけで準備完了です。ベースURLの変更はこの1箇所のみです。 - プレフィックスの固定:
STABLE_PREFIXにシステムプロンプトやツール定義を格納し、一言一句変更しないようにします。user_turnにはそのターンで新しく追加された動的コンテンツを格納し、常に最後のメッセージとして配置します。 - リクエストの送信:
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}])と呼び出します。modelをkimi-k3.1-proやdeepseek-flashに置き換えるだけで、他の2社もテストできます。 - 使用量の確認: まず
details = resp.usage.prompt_tokens_detailsを取得し、次にcached = getattr(details, "cached_tokens", 0) or 0でキャッシュトークン数を取得します。最後にprint(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens)と出力すれば、3つの数値がそれぞれプロンプトトークン数、キャッシュヒットしたトークン数、出力トークン数となります。
複数ターンを連続して実行し、キャッシュヒットしたトークン数をプロンプトトークン数で割ることで、実際のヒット率が算出できます。さらに各社のキャッシュ読み取り単価にヒット量を掛けることで、正確な費用(USD)が把握できます。なお、Kimiのドキュメントにはキャッシュ料金設定が構成価格であり、実際の請求はコンソール側の表示が基準となる旨が明記されています。DeepSeekでオフピーク割引を適用したい場合は、カタログにある deepseek-v4-1-flash-260910 などのモデル名を確認して指定してください。deepseek-flash が時間帯に応じて自動的に価格変更されると思い込まないよう注意が必要です。
APIキーは環境変数 APIYI_API_KEY に設定し、リポジトリにコミットしないようにしてください。無料テストクレジットは、同一のプレフィックスを使って4つのモデル名それぞれで数ターン実行し、トークン消費構造を比較するのに最適です。まずは使用感を確認し、必要に応じてターン数を増やしていくのがおすすめです。最初から4社すべてで大規模なリポジトリ全体を処理させないようにしましょう。
キャッシュ読み取り比較に関するよくある質問(FAQ)
Q1:96%というのは、キャッシュ読み取りが請求金額の96%を占めているという意味ですか?
本記事の結論としては、そうではありません。Max Woolf氏が言及しているのは「キャッシュ読み取りが総トークン消費量の96%〜99%を占める」という点であり、分母となる詳細データは非公開のため、サードパーティによる推計値にとどまります。WorkloadBenchの測定結果ではプロンプトトークンの89%〜96%とされており、出力トークンは含まれていません。本記事の試算モデルに基づくと、トークン数ベースでは約97%を占めますが、金額(米ドル)ベースではOpusとSolで約47%、Kimiで約65%、Flashで約30%となります。
Q2:Solのキャッシュ読み取りが$0.10の時と$0.20の時があるのはなぜですか?
1回のリクエストにおける入力トークン長によって異なります。272Kトークン以下の通常コンテキストの場合、OpenAI標準ティアのキャッシュ読み取りは$0.10です。これを超えると$0.20となり、同時にキャッシュミス時の入力は$4、出力は$15に上がります。APIYIのモデル一覧には、短コンテキスト向けの「$2 / $10 / $0.10」が記載されており、272,000トークンを超えると入力が$4になる旨が注記されています。長コンテキストの出力とキャッシュ読み取りはOpenAIの標準レートに準拠し、コンソールで階層表示されている場合はコンソールの表示が優先されます。
Q3:DeepSeekに2種類のキャッシュ読み取り価格があるのはなぜですか?
公式によりピーク時間帯(オフピーク/ピーク)で料金が異なり、オフピーク時はピーク時の半額に設定されているためです。オフピークのキャッシュ読み取りは$0.003、ピーク時は$0.006です。ピーク時間帯は平日(中国の法定祝日を除く)の北京時間 09:00〜12:00 および 14:00〜18:00(公式のUTC指定から換算)です。週末と祝日は終日オフピーク扱いとなります。APIYIのディレクトリでは、この2つの料金体系が別々のモデル行として記載されています。
Q4:エンタープライズ向けの30%割引は、小規模チームでも適用できますか?
報道にある割引は年間1億ドル以上の大型契約が前提となっており、各社からの公式な確認も出ていません。小規模チームにはそのような利用コミットメントを満たすのは難しいため、まずは公開されているキャッシュ読み取り料金を比較するだけでも十分な選定基準になります。グループごとの割引価格やチャージキャンペーンについてはAPIYIコンソールで確認してください。これらは大企業向けの特別割引とは別のものです。
Q5:1つのAPIキーで4社すべてに接続するにはどうすればよいですか?
APIYI(apiyi.com)でAPIキーを1つ発行し、ベースURLを `https://api.apiyi.com/v1` に設定します。`gpt-6.1-sol`、`kimi-k3.1-pro`、`deepseek-flash` はChat Completionsエンドポイントを利用でき、モデル名を切り替えるだけで呼び出せます。`claude-opus-5-5` でキャッシュ料金を適用したい場合は `messages` エンドポイントを使い、`cache_control` を付与してください。なお、GPT-5以降でマルチターンのキャッシュヒット率をさらに高めたい場合は、料金ページで推奨されている通り `/v1/responses` への切り替えを検討してください。
Q6:キャッシュ読み取りが安いなら、デフォルトのモデルをFlashに変更すべきでしょうか?
失敗によるコストが価格差を下回る場合に限られます。オフピーク時の試算では、Solの約20分の1($0.0486 対 $1.02)、ピーク時でも約10分の1のコストで済みます。しかし、Flashで同じタスクを達成するために余計なターン数(やり取り)がかかる場合、その往復コストで価格差が相殺されてしまいます。まずは無料クレジットを使って同一プレフィックスで完了までにかかるターン数を比較し、その上でデフォルトモデルを決定するのがおすすめです。
Q7:キャッシュ書き込み料金は、キャッシュ読み取りよりも高くなりますか?
プレフィックスの有効期限が頻繁に切れ、キャッシュヒット回数が極端に少ない場合は高くなります。OpusとSolの短期間ティアでの書き込みは、通常入力料金の1.25倍、Solの12時間ティアでは2.5倍になります。Kimiの5分間書き込みは通常の入力料金と同額です。2〜3ターン以上キャッシュにヒットして初めて、キャッシュ読み取りが費用の主因(大幅な節約要素)になります。呼び出し間隔が不安定なタスクでは、まず適切なTTLを選択した上で、キャッシュ読み取り料金を比較するようにしましょう。
キャッシュ読み込み比較の重要ポイント
- 96%は第三者による推定: Max Woolf氏はログを公開していません。実際の金額ベース(ドル換算)の割合は、各単価を掛けて自身で算出する必要があります。
- まずキャッシュ読み込み、次にティアの切り替わりを確認: Solは272Kトークンを超えると、キャッシュ読み込みが$0.10から$0.20へ跳ね上がります。
- OpusとKimiのキャッシュ読み込みは同額の$0.20: ただしKimiはキャッシュミス時と出力の単価がより安く、短コンテキスト時の書き込みにプレミアム(割増料金)がありません。
- Flashの強みは圧倒的な価格帯(桁違いの安さ): オフピーク時は$0.003、ピーク時でも$0.006であり、コスト構造がキャッシュ読み込みだけに左右されることはなくなります。
- 報道にある「企業向け30%引き」は小規模チームには無関係: それらは年間契約を前提とした特別枠の話です。一次選定を行うには公開価格の比較で十分です。
- 1つのAPIキーで4社すべてに接続: APIYI(apiyi.com)ならモデル名を切り替えるだけで検証可能。実際のキャッシュヒット率は管理画面の利用実績を基準に判断しましょう。
まとめ
ここ4か月で、最大80%もの公式値下げが実施されました。その中心はLunaの標準価格改定と、Sol製品群におけるキャッシュ読み込み単価の引き下げ($0.50から$0.10へ)です。コーディング支援エージェントを運用する場合、依然としてキャッシュ読み込みコストを分けて計算する必要があります。
2026年10月26日時点の公式価格に基づくと、短いコンテキストにおいてGPT-6.1 Solのキャッシュ読み込みは$0.10、Opus 5.5とKimi K3.1 Proは$0.20、DeepSeek V4.1 Flashはオフピーク時$0.003・ピーク時$0.006です。なお「96%〜99%」という数値は、あくまでMax Woolf氏による推計値の引用です。試算シート上ではトークン数の削減率がこの数値に近づくとしても、実際の支払額(ドル換算)の削減幅は単価差によってもう少し控えめになります。
報道されているような大企業向けの割引は年間契約のコミットメントが必要となるため、小規模なチームでは適用が困難です。それよりも、4社のモデルを1つのAPIキーに集約し、自社の実際のヒット率に公開されているキャッシュ読み込み単価を掛け合わせて試算するほうがはるかに現実的です。まずはAPIYI(apiyi.com)を使って同一の固定プロンプト(プレフィックス)でテストを実行し、常用するデフォルトモデルを決定することをおすすめします。
著者: APIYI 技術チーム
技術的なお問い合わせ: APIYI公式サイトのトップページよりお気軽にお問い合わせください。各モデルの最新単価は docs.apiyi.com ドキュメントセンターの料金ページをご確認ください。
参考資料
- Max Woolf氏による値下げのタイムラインと96%〜99%の試算
- リンク:
minimaxir.com/2026/10/cheap-llms -
説明: 2026-10-25。96%〜99%という数値は著者独自の見解であり、本記事の実測値ではありません。
-
Anthropic モデルの料金
- リンク:
platform.claude.com/docs/en/about-claude/pricing -
説明: Opus 5.5 の入力、出力、キャッシュ読み取り、および2段階の書き込み料金。
-
OpenAI モデルの料金
- リンク:
developers.openai.com/api/docs/pricing -
説明: GPT-6.1 Sol のショートコンテキスト、ロングコンテキスト、キャッシュ読み取りおよび書き込み料金。272Kが公式による短文・長文の境界値です。
-
DeepSeek モデルの料金
- リンク:
api-docs.deepseek.com/quick_start/pricing -
説明:
deepseek-flashのピーク時・オフピーク時のキャッシュヒット料金、ミス料金、および出力料金。 -
Kimi API
- リンク:
platform.kimi.ai -
説明: Kimi K3.1 Pro の入力、出力、キャッシュヒット、およびデフォルトの書き込み料金。
-
AI Weekly による Replit 契約の報道
- リンク:
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
説明: 30%以上の割引や年間1億ドルを超える規模についての記述は、The Informationの報道を引用したものであり、当事者3社によって公式に確認されたものではありません。
-
WorkloadBench におけるキャッシュトークンの割合
- リンク:
workloadbench.brenhq.com/cache - 説明: 2026-10-16。プロンプトトークン全体に占めるキャッシュ由来の割合であり、金額ベースの割合ではありません。