著者注:カスタマーサポートの品質チェックリクエストを例に、GPT-6.2 Sol の Responses API における出力検収、会話状態の保持、バックグラウンドでの結果回収を分解します。
結論から先に:GPT-6.2 Sol を本番システムに接続するには、同じ業務タスクを4つの振る舞いに分解し、それぞれに検収基準を定義する必要があります。4つの振る舞いとは、UIでの即時フィードバック、機械がDBに格納できる結果、ターンをまたぐコンテキスト、最終状態です。ストリーミングイベントは表示のみを担当し、DBに格納する前に完全なレスポンスを取得して、スキーマと業務バリデーションを通過させる必要があります。ターンをまたぐ情報は、まず誰が状態を保持するかを決めます。バックグラウンドタスクはレスポンスIDと終端状態だけを扱い、通知は重複する可能性があるため、書き込みは冪等でなければなりません。
この4点を実現する前提は2つあります。第一に、組み込みまたはカスタムツールが必要な場合は、GPT-6.2 の移行ガイドに従って Responses API を使用します。本記事でも Responses の実行挙動だけを扱います。第二に、アグリゲーションプラットフォーム経由で呼び出す場合、バックグラウンドモードや Webhook などの機能が公開されているかどうかは、プラットフォームの現在の設定に依存します。APIYI apiyi.com では、gpt-6.2-sol が responses と chat の2つのエントリを公開しています。
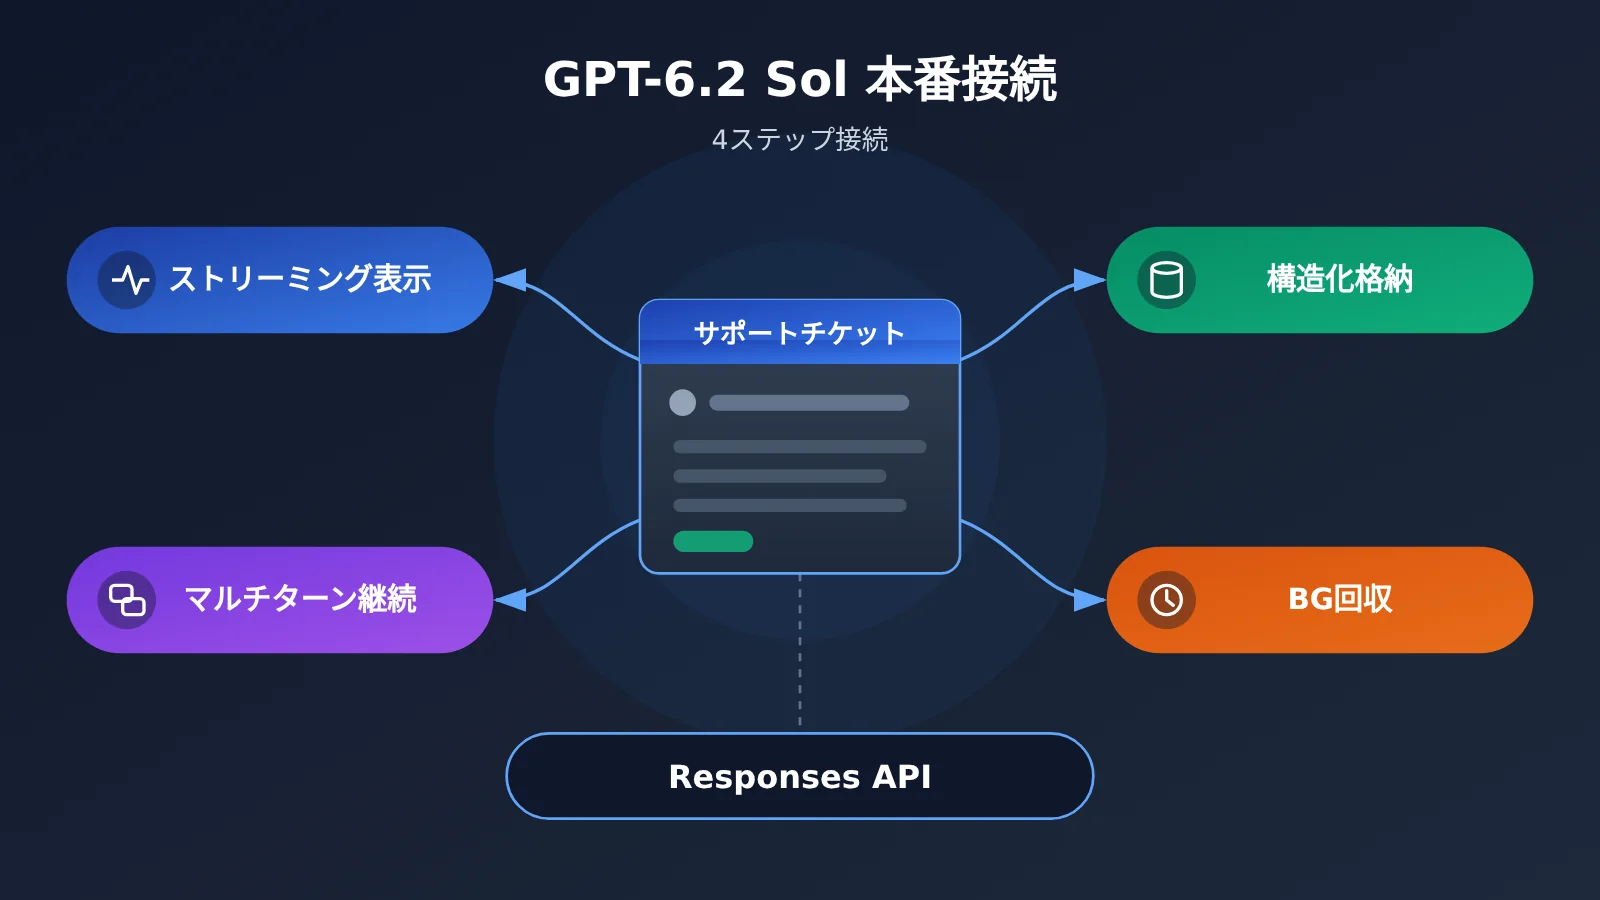
GPT-6.2 Sol 本番接続ナレッジマップ
この記事全体は、ひとつのフローを中心に展開します。すなわち「リクエスト発行 → 表示 → 継続 → 読み戻し → 受け入れ確認」です。以下のフロー図には、各ステップの成果物と対応する本文の節番号を示しています。
リクエスト発行(model=gpt-6.2-sol,Responses API)
  │
  ├─▶ 表示【第1節】
  │     増分イベント → ページに品質チェック所見をリアルタイム表示
  │     終了イベント → 読み込み終了;完全なレスポンス → Schema + 業務検証 → DB登録 / 人手による再確認
  │
  ├─▶ 継続【第2節】
  │     自前管理の履歴 / previous_response_id / Conversation
  │     常駐ルール(developer) と 当ラウンドの指示(instructions) の分離
  │
  ├─▶ 読み戻し【第3節】
  │     background 送信 → レスポンス ID を保存 → Webhook の署名検証と重複排除 → ID で読み戻し → 終態を保存
  │
  └─▶ 受け入れ確認【第4節】
        成功 / 不完全 / 通知の重複 / クライアント切断 / Schema 変更
GPT-6.2 Sol 接続インデックス
| セクション | 答える問い | 後続に提供するもの | 読了後にできること |
|---|---|---|---|
| 1. ストリーミングと構造化 | ページ側でストリームをどう見るか、マシン側で結果をどう受け取るか | 「完了」と「登録可能」の判定を定義する | 表示パスとDB登録パスを区別する |
| 2. マルチターン状態 | 次のリクエストを前のターンにどうつなげるか | 状態の保持者と保存条件を確定する | 当ラウンドの焦点だけを変え、プレフィックスを壊さない |
| 3. バックグラウンドタスク | ユーザーがページを離れた後、結果をどうDBに落とすか | レスポンス ID、タスク ID と終態の対応関係 | 署名検証・重複排除・冪等書き込みを実装する |
| 4. リリース受け入れ | どの動作を事前に検証すべきか | 前三節の判定条件をまとめる | 追跡可能なリグレッション記録を作る |
第1節から第3節は、それぞれひとつの実行パスに対応します。1つだけ実装する場合は、必要に応じて該当箇所を参照してください。第4節は前三節で定義した状態に依存するため、最後に読むのが適しています。
GPT-6.2 Sol 関連用語 To Know
| 用語 | 説明 |
|---|---|
| SSE | サーバーが1本の HTTP 接続を通じて、クライアントへ順番にイベントをプッシュするプロトコル。 |
| Structured Outputs | 成功時に返される構造化コンテンツが、サポート対象の JSON Schema に準拠することを求める API 機能。 |
| 拒否レスポンス | モデルがタスク完了を明確に拒否したときに返されるコンテンツ項目で、個別のフローが必要になる。 |
| 会話状態 | 後続のリクエストのために保持される、メッセージやツール結果などのコンテキスト。 |
| 暗号化推論項目 | 推論状態を継続するために使われる暗号化されたレスポンス項目で、コンテキストと一緒に送り返すことができる。 |
| プレフィックス | 現在のリクエストの先頭部分のうち、前のターンと完全に同一のコンテキスト系列。 |
| 完了ウィンドウ | サービスがバックグラウンドリクエストを受け付けた後、このレスポンスに対して設定する目標完了時間の範囲。 |
| Webhook | サーバーがアプリケーション指定の URL へ主体的に送信する、署名付きの通知。 |
| 終態 | タスクが完了・失敗・不完全・キャンセルされた後の最終状態。 |
| 冪等 | 同じコールバックやタスクが重複して処理されても、業務上の効果を一度だけ生じさせること。 |
1. GPT-6.2 Sol のストリーミング出力と構造化検証
1.1 GPT-6.2 Sol の2つの出力経路
まずはカスタマーサポートの品質チェックというシナリオを見てみましょう。当番のオペレーターがチケットを1件開くと、ページにはモデルが返した監査意見をすぐに表示する必要があります。同じ分析結果は、日締め集計のために品質チェック用データベースにも書き込まれます。この2つの要件では「完了」の定義が異なるため、処理を2つの経路に分ける必要があります。
| 経路 | 利用者 | 依存するシグナル | 「完了」と判定する条件 | 失敗時の扱い |
|---|---|---|---|---|
| 表示経路 | オペレーターのページ | response.output_text.delta インクリメンタルイベント |
response.completed または失敗系の終端イベントを受信 |
ページに通知し、表示済みの内容を保持 |
| 登録経路 | 品質チェックDB | 完全なレスポンスオブジェクト | Schema検証と業務検証の両方を通過 | 拒否・不完全・形式エラーはそれぞれ手動レビューへ |
ストリーミングリクエストで stream=true を設定すると、サーバーは HTTP SSE を通じてイベントを順次プッシュします。ページ側は response.output_text.delta に含まれるテキストを追記して表示するだけで十分です。ローディング状態は終端イベントを待ってから終了させる必要があります。テキストの出力が止まったからといって、タスクが完了したわけではありません。
1.2 GPT-6.2 Sol のストリーミング表示例
次の例は表示のみを担当します。増分テキストをフロントエンドに渡し、終端状態で待機を終了します。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 互換エンドポイント
)

stream = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "你是客服质检督查员,只依据工单原文给出意见。"},
        {"role": "user", "content": "工单 #A1024:客户三次催单未获回复……"},
    ],
    stream=True,
)

for event in stream:
    if event.type == "response.output_text.delta":
        push_to_page(event.delta)          # ページにリアルタイムで追記
    elif event.type == "response.completed":
        finish_loading(event.response.id)  # 終端状態でローディングを終了
    elif event.type in ("response.failed", "response.incomplete"):
        show_error(event.type)             # 失敗と不完全を別々に通知
push_to_page や finish_loading などは業務側の関数です。終端イベントの完全なリストは、公式のストリーミングレスポンスのドキュメントを参照してください。
1.3 GPT-6.2 Sol 構造化出力の検収順序
Responses API では、構造化出力は text.format で宣言し、メッセージには含めません。登録処理の経路では、完全なレスポンスを受け取った後、次の順序で判定します。
- レスポンスのステータスを確認します。不完全なレスポンス(
statusが incomplete)はそのまま人手による再確認に回し、途中までの JSON を解析しようとしません。 - コンテンツ項目を確認します。拒否タイプのコンテンツ項目が現れた場合は拒否フローへ進み、フォーマットエラーとして扱いません。
- JSON を解析し、スキーマ検証を行います。
- 業務チェックを行います。元のチケットが存在すること、欠落項目が明確に可視化されていること、暗黙的に補完されていないことを確認します。
GPT-6.2 Sol の構造化データ登録の完全なコードを表示
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

QA_SCHEMA = {
    "type": "object",
    "properties": {
        "ticket_id": {"type": "string"},
        "verdict": {"type": "string", "enum": ["合格", "需整改", "信息不足"]},
        "issues": {"type": "array", "items": {"type": "string"}},
        "missing_fields": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["ticket_id", "verdict", "issues", "missing_fields"],
    "additionalProperties": False,
}

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[{"role": "user", "content": "请质检工单 #A1024:……"}],
    text={"format": {"type": "json_schema", "name": "qa_result",
                     "schema": QA_SCHEMA, "strict": True}},
)

def route(resp):
    if resp.status == "incomplete":
        return ("manual_review", "incomplete", resp.incomplete_details)
    for item in resp.output:
        for part in getattr(item, "content", []) or []:
            if part.type == "refusal":
                return ("manual_review", "refusal", part.refusal)
    try:
        data = json.loads(resp.output_text)
    except json.JSONDecodeError:
        return ("manual_review", "bad_json", None)
    if not ticket_exists(data["ticket_id"]):
        return ("manual_review", "unknown_ticket", data)
    return ("save", "ok", data)

print(route(resp), resp.id)
スキーマ検証が通ることは、構造が正しいことを示すだけで、内容が正しいことを示すものではありません。チケット番号が存在するかどうか、欠落項目が事実どおりに示されているかどうか、といったチェックは業務層で行う必要があります。
🎯 技術的な推奨:テスト環境では、APIYI apiyi.com を通じてストリーミングと非ストリーミングの両方のリクエストを同時に発行し、同じチケットが両方の経路でどのような終端状態と登録結果になるかを比較できます。これにより、フロントエンドのローディング処理と登録分岐が互いに干渉しないことを事前に確認できます。
2. GPT-6.2 Sol のマルチターン会話における状態の継続
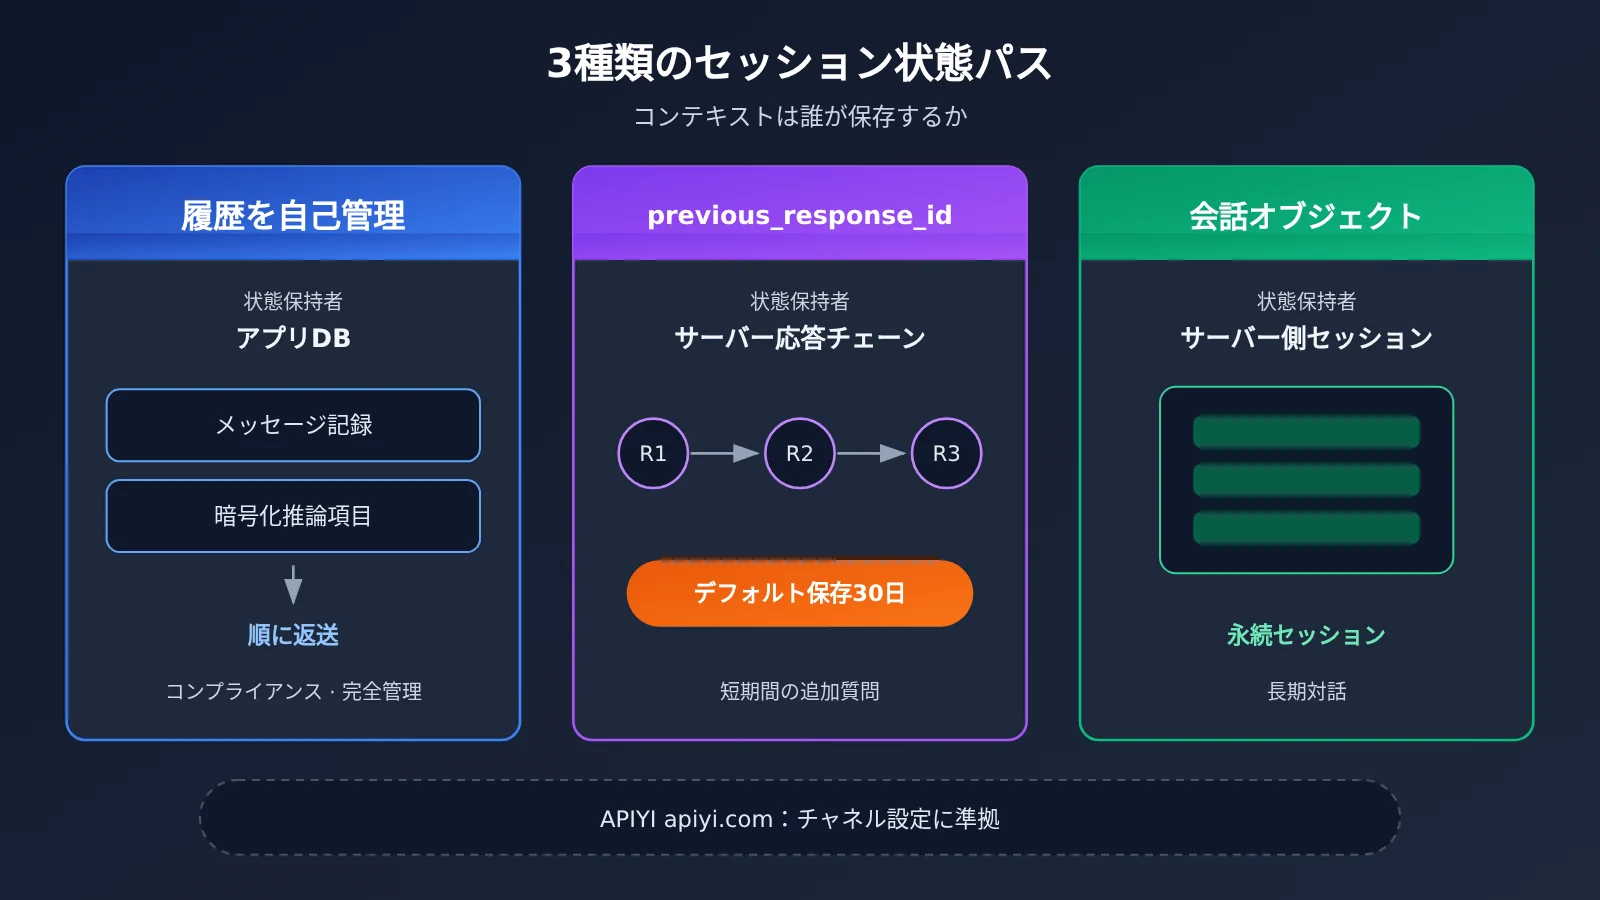
2.1 GPT-6.2 Sol の3つの状態パスの比較
オペレーターが同じチケットに新しい事実を補足し、モデルに前のターンから分析を続けさせたいとします。このとき最初に答えるべき問いは、「コンテキストを誰が保存するのか」です。
| パス | 状態の保持者 | 保持条件 | 適した場面 | 利用可能なプラットフォーム |
|---|---|---|---|---|
| 自前管理履歴 | アプリケーション自身 | アプリ側が決める。メッセージと必要なレスポンス項目を元の順序で返送する必要がある | コンプライアンス要件がある場合、またはコンテキストを完全に掌握したい場合 | 公式 API、APIYI apiyi.com |
previous_response_id |
サーバー側のレスポンスチェーン | レスポンスがまだ利用可能な場合のみ継続できる。レスポンスオブジェクトはデフォルトで30日間保存される | 短いサイクルでの連続的な追加質問 | 現在のチャネル設定に準じる |
| Conversation オブジェクト | サーバー側の会話オブジェクト | Conversation に付加された項目は、そのオブジェクトの保持ルールに従って処理される | より永続的に会話を保存したい場合 | 現在のチャネル設定に準じる |
自前管理履歴を選びつつ、推論も連続させたいのであれば、テキストだけを返送するわけにはいきません。必要なレスポンス項目はすべて保持し、順序どおりに再生する必要があります。これには暗号化された推論項目も含まれます。
2.2 GPT-6.2 Sol でレビュー観点だけを変える書き方
2回目のラウンドで、レビュー観点を「応答時間」から「応対スクリプトのコンプライアンス」に変えたいだけだとします。正しい方法は、汎用の品質チェックルールをチェーンの先頭となる developer メッセージに置き、今回のラウンド専用の観点をトップレベルの instructions に書くことです。instructions は、それを指定したリクエストにのみ作用し、後続のラウンドを汚染しません。
first = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "通用质检规则:依据工单原文;缺项必须列出……"},
        {"role": "user", "content": "质检工单 #A1024,关注响应时效。"},
    ],
)

second = client.responses.create(
    model="gpt-6.2-sol",
    previous_response_id=first.id,
    instructions="本轮只审查话术合规,不重复时效结论。",  # 今回のリクエストにのみ作用する
    input=[{"role": "user", "content": "补充:坐席第二次回复使用了模板话术。"}],
)
この書き方にはもう一つ利点があります。先頭のルールは変わらず、プレフィックスも安定したままになることです。
2.3 GPT-6.2 Sol のプレフィックス変更リスク
GPT-6.2 はいくつかの状況で、関連する推論項目をクリアする可能性があります。古い履歴を書き換えた場合、部分的なモデル切り替え(たとえばダウングレード)を行った場合、そしてユーザーや組織を切り替えた場合です。継続が必要な Standard シングルエージェントセッションで、推論レベルや出力 Schema を調整したい場合は、古い設定を後から書き換えるのではなく、該当する configuration_update 項目を1条追加してください。この項目の具体的なフィールドは、GPT-6.2 移行ガイドに従います。
長期的なルールを更新する必要があるときは、コンテキストの末尾に新しい developer メッセージを追加し、古いルールは編集せず、以前のツールや Schema の設定も変更しません。プレフィックスが安定していても、キャッシュがヒットするかどうかは個々のリクエストと処理条件に左右されます。必ずヒットすると見なすことはできません。
3. GPT-6.2 Sol バックグラウンドタスクのDB保存
3.1 GPT-6.2 Sol のバックグラウンド送信と完了ウィンドウ
日次終了時に承認待ちのチケット概要を作成する処理は時間がかかることがあり、オペレーターも常に画面を見ているわけではありません。こうしたタスクは background: true を指定して送信します。送信後すぐに返されたレスポンスIDを永続保存し、業務タスクIDと1対1で対応付けます。
完了ウィンドウは許容できる待ち時間に応じて選択します。デフォルト値は soonest です。2h と 8h は Standard の割引ウィンドウで、現在はパブリックベータ機能であり、送信時にストリーミングを有効にできません。完了ウィンドウのパラメーター名と保存要件は、バックグラウンドモードのドキュメントに従ってください。
| 完了ウィンドウ | 位置づけ | ストリーミング | 適した品質チェックタスク |
|---|---|---|---|
soonest(デフォルト) |
できるだけ早く完了 | バックグラウンドモードのドキュメントに従う | 当番中に確認が必要なレビュー |
2h |
Standard の割引ウィンドウ、パブリックベータ | 無効 | シフト終了後の集計 |
8h |
Standard の割引ウィンドウ、パブリックベータ | 無効 | 日次終了時の一括要約 |
3.2 GPT-6.2 Sol Webhook の署名検証、重複排除、再取得
タスクがキュー待ちまたは実行中の間は、同じIDを継続的に問い合わせるだけで済みます。完了イベントを受信した場合は、次の順序で処理します。
- 署名を検証します。検証に失敗した場合はそのまま破棄します。
webhook-idを使って重複を排除します。同じ通知が再送される可能性があります。event.data.idに従って完全なレスポンスを再取得します。通知自体は結果として使用しません。- タスクIDをキーに、最終状態と結果を冪等に書き込みます。
GPT-6.2 Sol のバックグラウンドタスク回収コードを見る
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 送信
job = client.responses.create(
    model="gpt-6.2-sol",
    background=True,
    input=[{"role": "user", "content": "汇总今日待审工单摘要:……"}],
)
db.save_task(task_id="QA-20261120-01", response_id=job.id, status=job.status)

# Webhook 処理
def on_webhook(headers, raw_body):
    event = verify_and_parse(headers, raw_body)        # 署名検証、失敗時は例外を送出
    if db.seen_webhook(headers["webhook-id"]):         # 重複排除
        return 200
    db.mark_webhook(headers["webhook-id"])
    resp = client.responses.retrieve(event.data.id)    # 完全なレスポンスを再取得
    task_id = db.task_by_response(resp.id)
    db.upsert_result(task_id, status=resp.status,      # タスクIDごとに冪等に書き込み
                     body=resp.output_text if resp.status == "completed" else None)
    return 200
ユーザーがページを閉じてから戻ってきたとき、フロントエンドは業務タスクIDを使ってローカルDBを検索するだけで済みます。ステータスがまだ最終状態に達していない場合は、サーバー側が保存済みのレスポンスIDを使って問い合わせを続けます。
データ保持には特に注意が必要です。バックグラウンドモードでは再取得を可能にするため、レスポンスデータが一時保存されます。store: false を設定した場合や、組織で ZDR を有効にした場合でもこの点は変わりません。そのため、データ管理ドキュメントと照らし合わせて許容できるか確認してください。
💡 導入のヒント:Webhook コールバックURLとバックグラウンドモードにはチャネル側のサポートが必要です。APIYI apiyi.com 経由で接続する前に、現在のアカウントグループでバックグラウンドモードとコールバック機能が利用可能か確認することをおすすめします。まだ利用できない場合は、まずレスポンスIDのポーリング方式でステートマシンを一通り動作させてください。
4. GPT-6.2 Sol リリース受け入れチェックリスト
4.1 GPT-6.2 Sol 統合受け入れ表
以下の受け入れ表では、カスタマーサポート品質検査という複合ケースを引き続き使い、前の3節の判定条件を1つずつ実行可能なテストケースに落とし込みます。
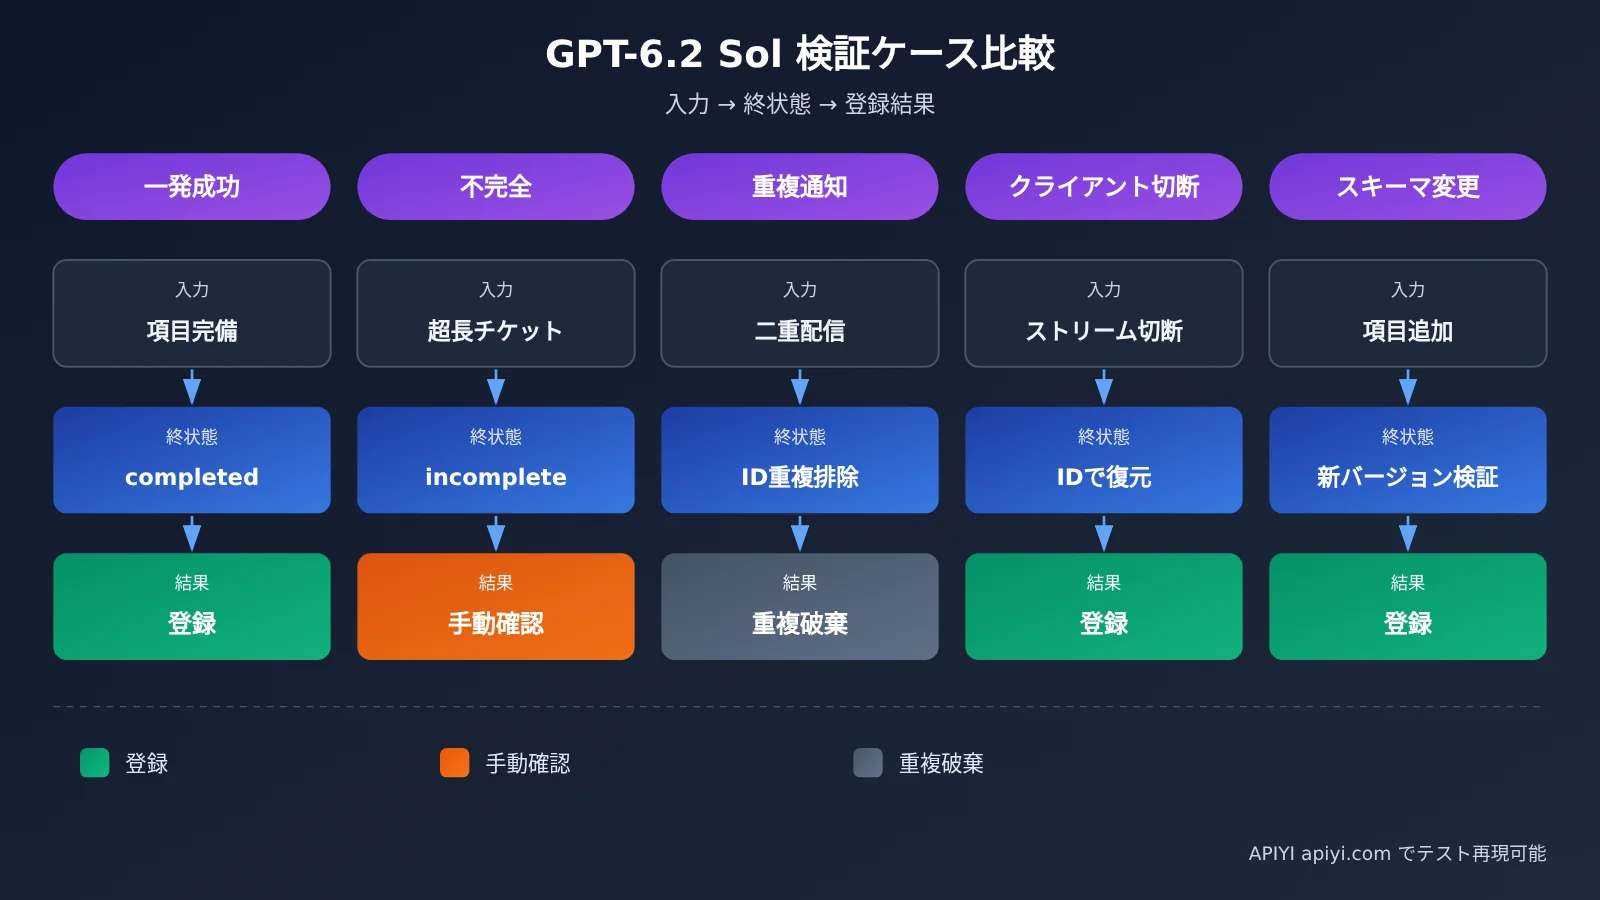
| テストケース | 入力条件 | 期待される状態または結果 |
|---|---|---|
| 1回で成功 | 実在するチケットで、フィールドがすべて揃っている | 最終状態 completed;スキーマと業務検証に合格;タスク ID ごとに結果を1件書き込む |
| 不完全なレスポンス(1回) | 出力上限を意図的に低くする、または非常に長いチケットを使用する | 状態 incomplete;JSON を解析しない;人手によるレビューに回し、理由を記録する |
| 重複通知(1回) | 同じ webhook-id を2回配信する |
2回目は重複排除される;結果テーブルには1件だけ記録が残る |
| クライアント切断(1回) | ストリーミング中にブラウザ接続を切断する | 保存済みのレスポンス ID を使って状態を復元する;保存結果はページの影響を受けない |
| スキーマ変更(1回) | セッションの途中で必須フィールドを1つ追加する | 設定の追記更新によって調整を完了し、古い設定は書き換えない;新しい結果は新しいスキーマで検証する |
各テストケースでは、次の4項目を保存します。呼び出したモデル ID(gpt-6.2-sol)、実行パラメータ、レスポンス ID、アプリ側の設定バージョンです。問題が発生したときは、この4項目から具体的にどのリクエストだったかを特定できます。
4.2 GPT-6.2 Sol 回帰時の基準
| 項目 | 記録内容 | 説明 |
|---|---|---|
| モデル | gpt-6.2-sol |
モデルカードの公開 ID を参照 |
| エンドポイント | Responses | 関数呼び出しと組み込みツールはこの経路を使用 |
| 推論ティア | 実際に使用したティア | Responses と Chat Completions のどちらも none を受け付けない |
| 使用量 | usage.output_tokens とその中の推論 token サブ項目 |
出力課金には推論 token がすでに含まれている |
| 課金ティアの切り替え | 単一リクエストの入力が 272K を超えるかどうか | APIYI の公開価格 API では 272,000 入力 token でティアを切り替え、実際の請求額は請求書に準拠する |
旧システムを移行するときは、エンドポイント、リクエストパラメータ、マルチターン入力、推論コンテキスト、キャッシュの各項目を個別に確認します。確認が完了したら、同じテストケース群でサンプルリクエストと本番リクエストを同時に回帰します。
🚀 受け入れの推奨事項:5種類のテストケースは CI に組み込んで、スキーマ変更やチャネル切り替えのたびに自動で実行できます。APIYI apiyi.com の共通 Key を使えば、同じテストケース群で異なるグループの動作差異を比較できます。
受け入れ表の5つのテストケースがすべて合格し、それぞれをレスポンス ID で追跡できれば、この品質検査パイプラインはリリース条件を満たしていると判断できます。
参考資料
- GPT-6.2 Sol モデルカード:モデルID、コンテキスト、課金ルール
- リンク:
developers.openai.com/api/docs/models/gpt-6.2-sol
- リンク:
- GPT-6.2 移行ガイド:エンドポイント選択、プレフィックス変更、設定更新
- リンク:
developers.openai.com/api/docs/guides/latest-model
- リンク:
- ストリーミング応答と構造化出力:SSEイベントと
text.format- リンク:
developers.openai.com/api/docs/guides/streaming-responses
- リンク:
- 会話状態:
previous_response_idと Conversations- リンク:
developers.openai.com/api/docs/guides/conversation-state
- リンク:
- バックグラウンドモードとWebhook:完了ウィンドウ、署名検証、重複排除
- リンク:
developers.openai.com/api/docs/guides/background
- リンク:
著者:APIYI 技術チーム
技術交流:APIYIのウェブサイトのトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com のドキュメントセンターをご覧ください。