著者注:この記事では、Flint-interactive が「セマンティックイベント+更新操作」によって、エージェントによるインタラクティブなグラフの生成コストとエラー率をどう抑えているかを解説し、3つの導入方法を整理します。
データ分析やレポート作成を行う AI エージェントを開発していると、こんな場面に遭遇したことがあるかもしれません。エージェントは静的なグラフならすぐに描けるのに、「クリックしてフィルタリング」や「範囲選択による連動」を加えようとすると、何度も修正が必要になる。レイアウトがずれたり、ハイライトが効かなくなったり、一箇所を直すと別の箇所が壊れたりと、デバッグにトークンと時間を費やしてしまいます。
Microsoft Research は 2026 年 10 月 22 日、Flint を基盤とするインタラクティブなデータ可視化言語 Flint-interactive を発表しました。この記事は新しいグラフライブラリをおすすめするものではありません。Flint-interactive を事例として、エージェントが低レベルの描画コードを書く量を減らすために、高レベルの出力仕様をどう設計するかを考えます。
この記事のポイント:エージェントによるインタラクティブなグラフ生成におけるコストと信頼性のボトルネックを理解し、「視覚的なロジックはコンパイラに任せ、インタラクションのロジックはセマンティックイベントで記述する」という設計思想を学べます。また、会話内、アプリ内、カスタムインタラクションという3つの導入方法が、それぞれどのような場面に適しているかも紹介します。
Flint-interactive を使わずにエージェントがインタラクションコードを直接書くと、なぜコストが高いのか
エージェントにインタラクティブなチャートのコードを直接書かせる方法は、最も柔軟に見えます。しかし、研究ブログによると、能力の高い最先端モデルを使っても、実際に実装する際には依然として2つの大きなボトルネックがあります。
1つ目は生成コストの高さです。エージェントが1回で満足のいくインタラクティブなチャートを完成させることはまれで、通常は推論、コーディング、デバッグを何度も繰り返します。そのたびにトークンと時間を消費します。2つ目は信頼性の低さです。インタラクティブな可視化はそれ自体が複雑で、表現力の高いチャートほどレイアウトの崩れや操作の不具合が起きやすく、修正時に新たな問題が発生することもあります。
では、チャートライブラリに備わったインタラクション機能をそのまま使う方法はどうでしょうか。ブログでは、一部の可視化ライブラリに組み込まれた機能は表現力が十分でなく、カスタマイズされたインタラクティブなチャートを作るのが難しいとしています。結局のところ、必要なのは「表現力があり、かつ十分に高水準な」インタラクション記述言語です。
| 方法 | エージェントが出力する内容 | 主な問題 | 適性 |
|---|---|---|---|
| 低レベルのレンダリングコードを直接書く | イベントリスナー、ヒット検出、再描画ロジック | デバッグを繰り返す必要があり、トークン消費が多く、新たなバグを生みやすい | 表現力は最も高いが、安定性が低い |
| チャートライブラリの組み込み機能だけを使う | いくつかの設定項目の切り替え | インタラクションの種類が限られ、カスタマイズが難しい | 安定しているが、表現力が不足 |
| Flint-interactive の仕様 | 意味に基づくイベントから更新操作へのマッピング | 新しい仕様体系を学ぶ必要がある | 表現力と信頼性を両立 |
このような複数回にわたる生成タスクで、エージェントが利用するモデルを頻繁に切り替える必要があるなら、APIYI apiyi.com の統一インターフェースから複数の主要モデルにアクセスできます。同じ呼び出しコードでモデルごとのやり取りの回数や消費量を比較し、まずは「低レベルのコードを直接書く」方法が自分の用途でどれほどコストがかかるのかを把握できます。
Flint-interactive の重要ポイント
| ポイント | 説明 | 開発者にとっての価値 |
|---|---|---|
| セマンティックイベント | コンパイラがクリック、ドラッグ、キー操作などの生のトリガーを「どのグラフ要素とデータが選択されたか」に変換 | agent がピクセル座標やヒットテストを処理する必要がない |
| 更新操作 | set-style、set-annotation、set-viewport などの高水準な操作で画面の変化を記述 | レンダラー固有のグラフィック要素を操作する必要がない |
| Flint Canvas の状態機械 | キャンバス上のユーザー操作を追跡し、レンダリング状態を管理 | フレームワークがランタイムを管理するため、状態の不整合を減らせる |
| 組み合わせ可能 | イベントの生成と視覚的な更新を組み合わせ、表やテキスト、コンポーネントと連携できる | データストーリーや連動するダッシュボードを構築できる |
セマンティックイベント:Flint-interactive が注目するのは「ユーザーがどのデータを選択したか」
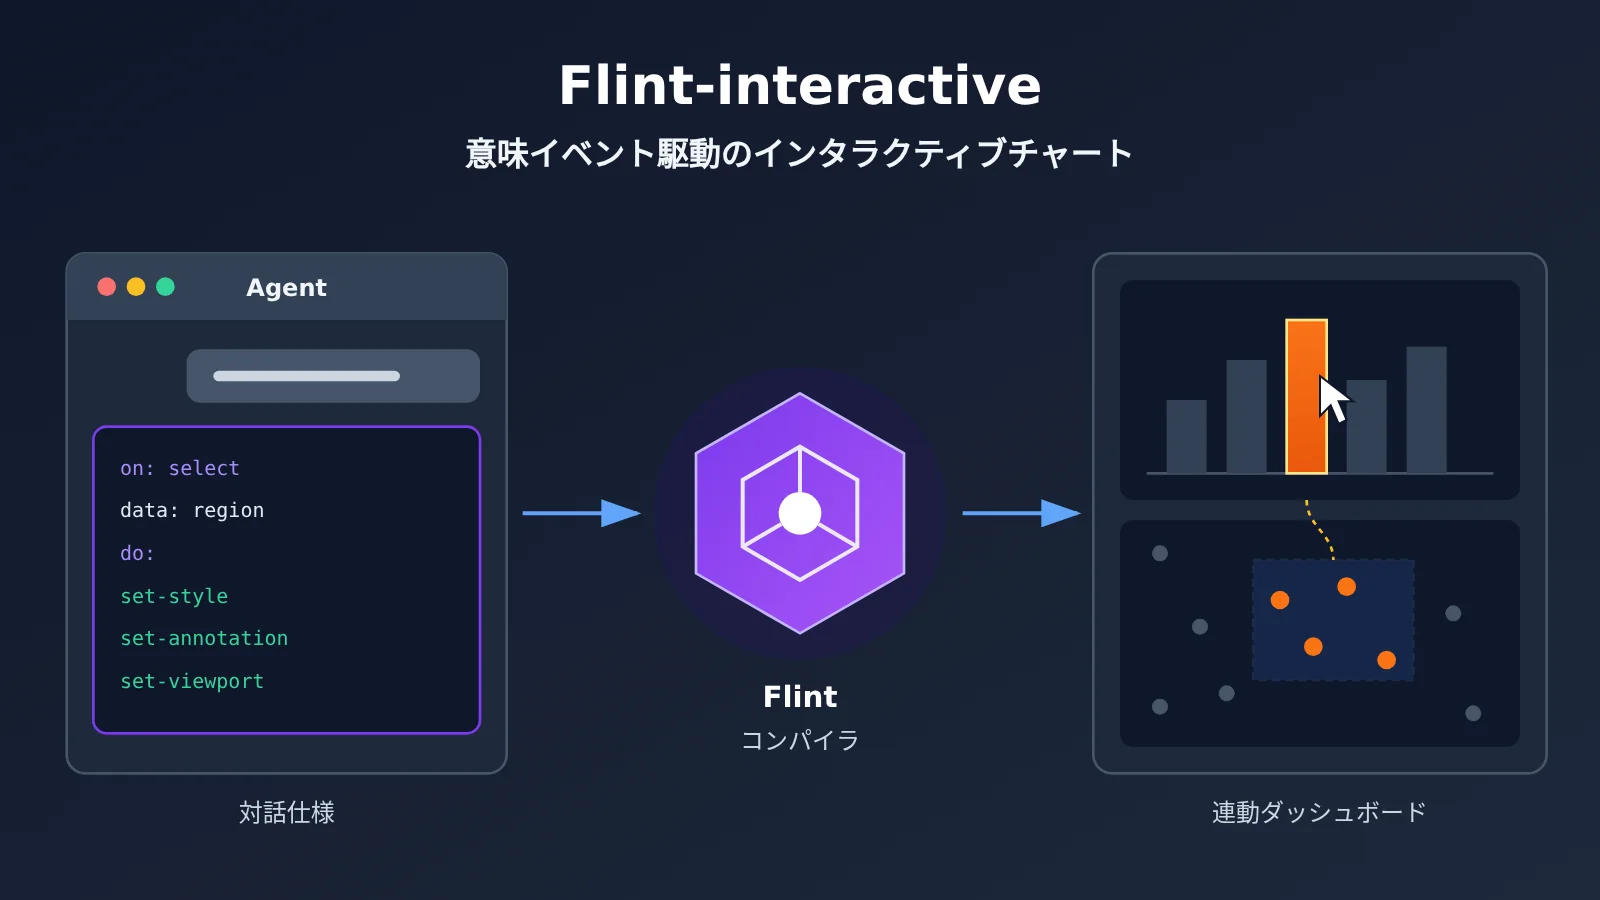
セマンティックイベントは、Flint-interactive の最も重要な概念です。従来の方法では、agent が「マウスが座標(x、y)で押され、どこまでドラッグされたか」を処理し、その領域に含まれるデータポイントを自分で計算する必要がありました。Flint では、この処理をコンパイラが担い、「ユーザーがこれらの国のグループを範囲選択した」というように、意味を持つイベントを直接生成します。
フロントエンド開発における「ネイティブ DOM イベント」と「業務イベント」の違いに例えられます。業務ロジックを書くとき、mousedown の座標ではなく、「ユーザーが注文 A を選択した」という事実に注目します。セマンティックイベントは、可視化の領域で同じような抽象化を実現するもので、その抽象化の正しさをコンパイラが保証します。
更新操作:Flint-interactive は命令的な再描画を宣言的な結果の記述に置き換える
セマンティックイベントを受け取った後、インタラクションロジックが答えるべき問いは「画面をどのような状態にするか」だけです。ブログで紹介されている更新操作には、set style でデータをハイライトする、set annotation で特定の点にラベルを付ける、set viewport でビューを平行移動・ズームする、といったものがあります。
これは SQL と手書きのループの関係に少し似ています。SQL では「どんな結果が欲しいか」を記述し、データベースが実行方法を決めます。Flint のインタラクションでは「どのデータをハイライトするか」を記述すると、コンパイラがヒットテストや低レベルの視覚的な更新を含む、具体的なキャンバスの変化に変換します。
状態機械:Flint Canvas がインタラクションのランタイムを管理
Flint Canvas は本質的には状態機械であり、キャンバス上のユーザー操作を継続的に追跡し、レンダリング状態を管理します。agent は「現在何が選択されているか」「前回のハイライトは解除されたか」といった、間違いが起きやすい中間状態を自分で管理する必要がありません。
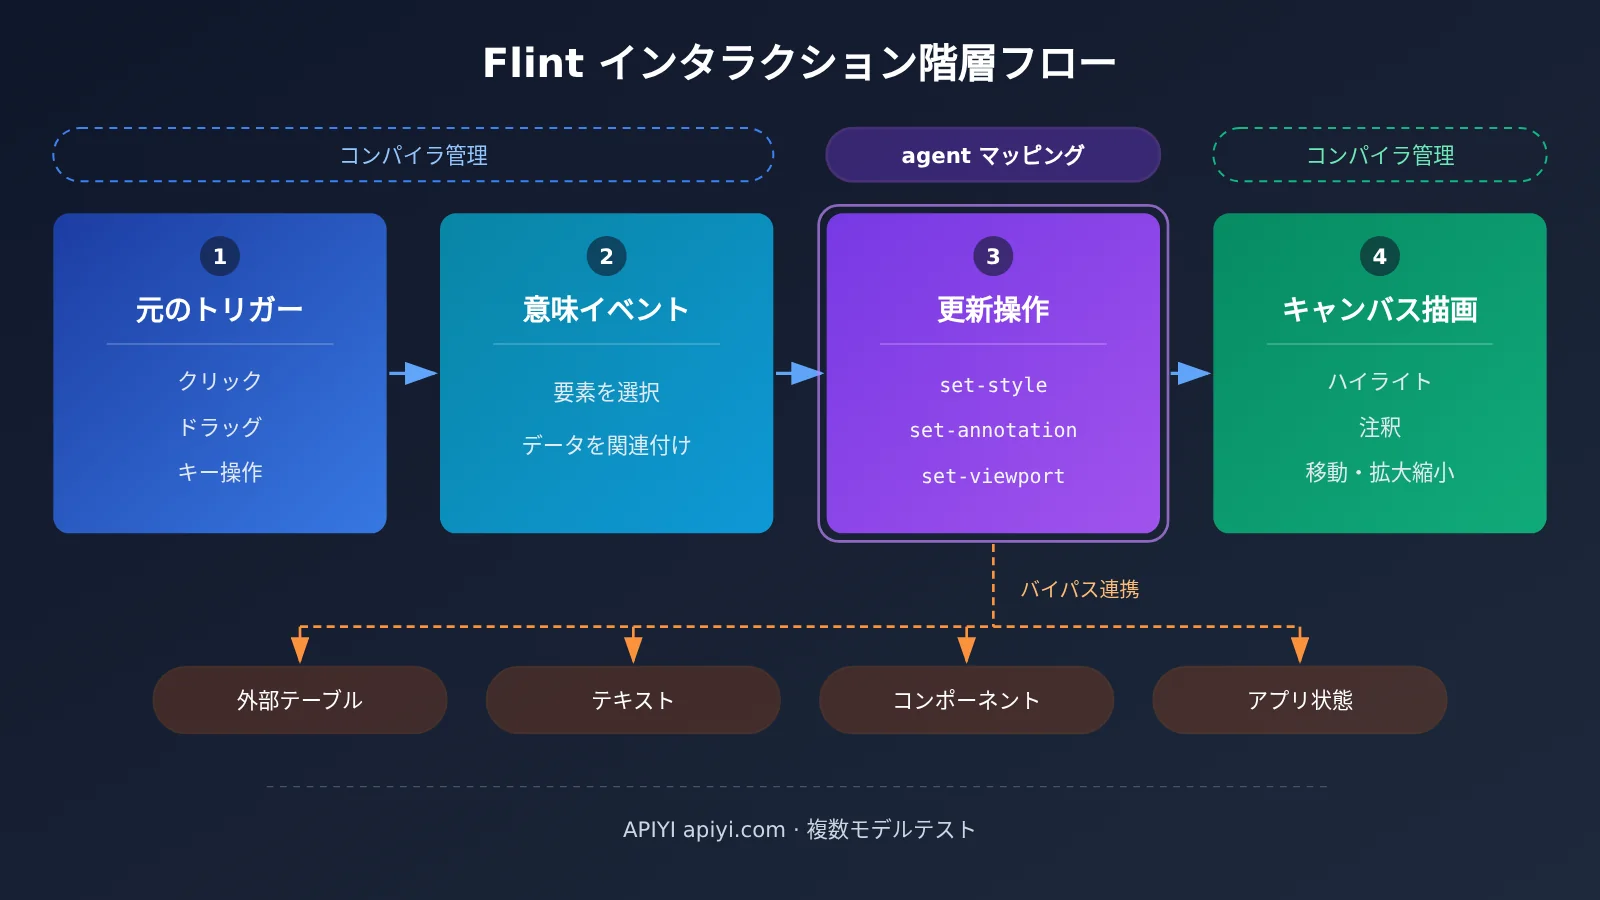
上図は、ブログで示された中心的な役割分担を表しています。視覚的なロジックはコンパイラが管理し、インタラクションロジックはユーザーが意味のあるレベルで記述します。agent が担当するのは、中央の「どのイベントにどの更新を対応させるか」というマッピングだけです。特に間違いが起きやすい両端の処理は、フレームワークに任せられます。
Flint-interactive の背後にある汎用的な原則:agent 向けに高水準の出力仕様を設計する
Flint-interactive の事例で広く参考にしたいのは、その技術的な判断です。agent に、最も間違えやすい層を出力させないという考え方です。低水準のレンダリングコードは依存関係が複雑で、結果がフィードバックされるまでの過程も長いため、agent がこの層で試行錯誤を繰り返すと、コストが高くなります。
別の見方をすると、Flint は自由度の高いプログラミングの問題を、「限られた語彙の中で対応関係を定める」問題に絞り込んでいます。agent の出力範囲が狭まり、構造も整うことで、検証しやすくなります。この考え方は、ワークフローのオーケストレーション、フォーム生成、レポートのレイアウトなどにも応用できます。
| 判断基準 | agent に出力させるのに適しているもの | コンパイラやランタイムに任せるのに適しているもの |
|---|---|---|
| ビジネス上の意図を表現するか | はい。例:「国を選択したら同じグループを強調表示する」 | いいえ。例:ピクセル座標の変換 |
| 多くの暗黙的な状態に依存するか | 依存が少なく、一度の対応付けで記述できる | 依存が多く、継続的な追跡が必要 |
| エラーの原因を特定しやすいか | 仕様の構造が明確で、検証しやすい | レンダリングの詳細が分散しており、調査しにくい |
| 再利用できるか | linked-brush などのプリセットとして蓄積できる | 汎用的な基盤として一度実装する |
自社の agent の出力形式を設計する際は、この表を使って項目ごとに確認してみてください。ある層が「意図を表現する」「状態への依存が少ない」「検証しやすい」をすべて満たすなら、agent に任せるのに適しています。そうでなければ、決定論的なコードやコンパイラに処理を移すべきです。
なお、研究ブログでは、トークン消費量の削減や成功率の向上に関する定量的なデータは示されていません。この設計原則のメリットについては、結論をそのまま当てはめるのではなく、自分たちのタスクで実測して検証することをおすすめします。
Flint-interactive クイックスタート:3 つの導入方法
ブログでは、グラフの利用者、アプリ開発者、インタラクションの設計者に向けた 3 つの利用方法が紹介されています。ここでは、手軽な方法から順に見ていきましょう。
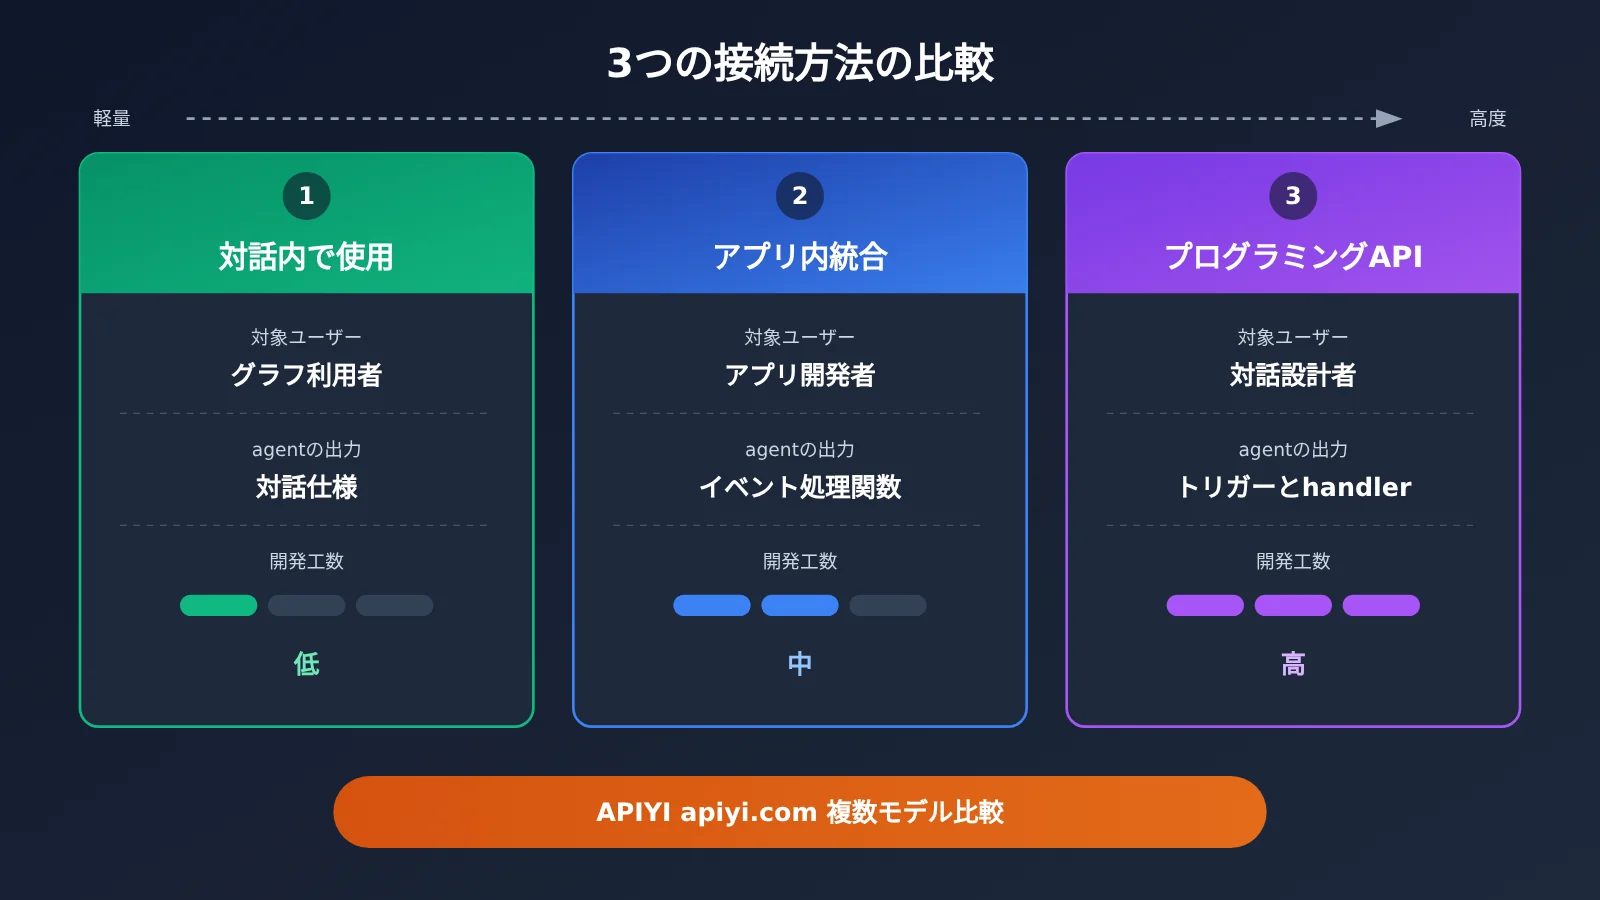
| 導入方法 | 対象ユーザー | エージェントまたはアプリの出力 | 典型的な利用シーン |
|---|---|---|---|
| 会話内で使用(Flint-MCP + MCP Apps) | グラフの利用者 | Flint グラフ仕様 + interaction_spec |
チャットでデータを探索し、選択した内容を追加の質問に引き継ぐ |
| アプリ内に統合(Flint Interactive Canvas) | アプリ開発者 | セマンティックイベントのハンドラー + Canvas に送信する更新操作 | ダッシュボード、データストーリー、グラフと表の連携 |
| インタラクションのカスタマイズ(プログラミング API) | インタラクションの設計者 | トリガー trigger + カスタム handle 関数 | DimpVis のような、プリセットを超えた独自のインタラクション |
方法 1:会話内で Flint-interactive を使う(MCP)
最も手軽な方法です。Flint-MCP と MCP Apps を使うと、チャットやキャンバス環境で Flint Interactive を直接利用できます。具体的な設定は、公式の MCP セットアップガイドに従って行います。導入後の流れは、おおむね次のとおりです。
- 公式の MCP セットアップガイドに従い、Flint-MCP を MCP Apps 対応のチャットまたはキャンバス環境に接続します。
- 描きたいグラフと必要なインタラクションをエージェントに伝えます。例えば「範囲選択に対応し、同じグループの国を連動してハイライトする」といった具合です。
- エージェントが Flint グラフ仕様に加えて
interaction_specを生成し、会話内にインタラクティブなグラフを表示します。 - グラフ上で項目を選択すると、その内容をコンテキストとして後続の会話に渡せます。
特に便利なのが 4 のステップです。ユーザーが異常なデータの一部を範囲選択して「この数点はなぜ高めなの?」とそのまま質問すると、エージェントは曖昧な文章ではなく、構造化された選択結果を受け取れます。
方法2:アプリに Flint-interactive Canvas を組み込む
自分のダッシュボードやデータストーリーで使いたい場合は、Flint Interactive Canvas を選べます。データは双方向に流れ、それぞれ次のように整理できます。
- グラフ → アプリ:Flint Canvas がセマンティックイベントを発行し、アプリがイベントハンドラーで受け取ります。テーブルの絞り込み、別のグラフの更新、アプリの状態変更などに利用できます。
- アプリ → グラフ:アプリのコンポーネントからグラフを制御したいときは、Flint Canvas に更新操作を送信します。
ブログの例では、グラフとテーブルが双方向に連動しています。テーブルの行をクリックするとグラフ内の点がハイライトされ、グラフの点をクリックするとテーブルにも反映されます。レポート系の製品にとって、これは「グラフとデータが連動する」体験の基本です。また、interaction-author スキルをコーディングエージェントに共有すれば、アプリへのインタラクションプリセットの追加を手伝ってもらえると紹介されています。
方法3:プログラミング API で Flint-interactive のカスタムインタラクションを作成する
プリセットのインタラクション(linked-brush による連動範囲選択など)では足りない場合は、プログラミング API でトリガーとカスタムの handle 関数を定義し、セマンティックイベントを一連のカスタムグラフ更新に対応付けられます。
ブログで紹介されている例では、国をクリックするとその国がハイライトされ、国名のラベルが付きます。この handler は set-style と set-annotation の2つの操作を組み合わせており、レンダラー固有のグラフィックマークを操作する必要はありません。より複雑な DimpVis の例では、ユーザーが時系列の軌跡に沿って点をドラッグし、すべての都市の気温と降水量がどのように変化するかを確認できます。
🚀 使い始めるときのヒント:まずは方法1で、手元のデータがインタラクティブな可視化に適しているかを会話の中で確かめてから、方法2や方法3に取り組むかどうかを決めましょう。エージェントを動かすモデルには APIYI apiyi.com を通じてまとめてアクセスできます。同じコード内で複数の主要モデルを切り替え、どのモデルが有効な
interaction_specをより安定して生成できるか試してみましょう。
エージェントが生成する Flint-interactive 仕様の信頼性を評価する
ブログでは、どのモデルやエージェントが Flint 仕様の生成に適しているかは説明されていません。そのため、本番導入前にシンプルな評価プロセスを整えておくとよいでしょう。以下の指標に注目することをおすすめします。
| 評価指標 | 確認方法 | 説明 |
|---|---|---|
| 初回生成の実用率 | 1回目の生成で正しくレンダリングされ、操作できる割合を集計 | 生成コストを直接反映 |
| 平均修正回数 | 初回生成から実用可能になるまでに必要な対話の回数を記録 | トークンと時間の消費に対応 |
| インタラクション意図の一致度 | 操作時の挙動が要件に合っているかを人手で確認 | 仕様が有効でも、意図どおりとは限らない |
| 回帰時の安定性 | あるインタラクションを変更した後も、ほかの操作が正常に動作するかを確認 | ブログで言及された信頼性の問題に対応 |
固定のインタラクション要件をいくつかテストセットとして用意し、同じプロンプトを使って「レンダリングコードを直接書く」方法と「Flint 仕様を出力する」方法をそれぞれ試してみましょう。APIYI のような複数モデルをまとめて利用できるインターフェースを使えば、1つのスクリプトで複数のモデルを横断的に比較でき、各社の SDK に個別に対応する手間を省けます。
よくある質問 FAQ
Q1: Flint-interactive とは何ですか?
Flint-interactive は、Microsoft Research が Flint をベースに開発した、インタラクティブなデータ可視化言語です。コンパイラがユーザーの操作を意味を持つイベントに変換し、高水準の更新操作でグラフを変更します。これにより、ユーザーやエージェントは、クリック、フィルタリング、ズーム、ハイライト、グラフ間の連動などの操作を簡潔な仕様で記述できます。
Q2: エージェントがグラフのインタラクションコードを直接書く場合と、Flint-interactive では何が違いますか?
コードを直接書く場合、エージェントはイベント、ヒットテスト、再描画を同時に処理する必要があります。表現の自由度は高いものの、複数回にわたるデバッグのコストが高く、エラーも起きやすくなります。Flint-interactive では視覚的な処理をコンパイラに任せ、エージェントは「どの意味イベントにどの更新を対応させるか」だけを記述します。そのため、出力が短くなり、構造も検証しやすくなります。
Q3: Flint-interactive はいつ発表されましたか?
Microsoft Research のブログでは、この研究が 2026 年 10 月 22 日に発表されました。オープンソースライセンス、成熟度、本番環境での利用可否については、参考資料に明確な記載がありません。正式なプロジェクトで使う前に、公式リポジトリの最新情報を確認することをおすすめします。
Q4: Flint-interactive はどのような用途に適していますか?
– **対話型データ分析**:チャット中にデータ点を範囲選択し、その結果を使って追加の質問をする;
– **レポートとダッシュボード**:複数のグラフを連動させ、グラフをクリックして詳細テーブルを絞り込む;
– **データストーリー**:グラフと本文の段落を双方向にハイライトし、データジャーナリズムのようなインタラクティブなストーリーを作る。
Q5: Flint-interactive を使うエージェントを構築する際、モデル呼び出しはどう準備すればよいですか?
Flint が解決するのは「何を出力するか」という問題であり、モデル自体は別途接続する必要があります。手軽な方法の一つは、APIYI apiyi.com を通じて複数の主要モデルに接続し、統一インターフェースで同じインタラクション要件を試すことです。各モデルが生成した仕様の初回利用可能率や修正に要した回数を比較したうえで、本番環境で使うモデルを決められます。
Q6: プロダクト責任者は、チームに Flint-interactive を導入すべきかどう判断すればよいですか?
まず、ユーザーがグラフ上でデータを探索する必要が本当にあるか、そして現在エージェントが生成するインタラクティブなグラフの手戻り率が高いか、という二つの質問に答えてみましょう。どちらも当てはまるなら、方法1で小規模な検証を行う価値があります。テスト段階では APIYI プラットフォームを活用してモデルを素早く切り替え、検証コストを低く抑えられます。
Q7: Flint-interactive には、どのような既知の制限や未確認事項がありますか?
– **定量データの不足**:ブログでは、トークンの節約量や成功率の向上に関する具体的な数値が公表されていません;
– **モデルとの適合性が不明**:どのモデルが Flint の仕様を最もうまく生成できるかは示されていません;
– **インタラクションの種類が限定的**:プリセットにないインタラクションは、プログラミング API を使って自分で実装する必要があります。公式は、種類を増やすために GitHub で新しいプリセットを提出することを推奨しています。
Flint-interactive の重要ポイント Key Takeaways
- コストの根本原因:agent がインタラクションのコードを直接書くと、何度もデバッグが必要になり、トークン消費が増えます。修正の過程で新たなバグが生まれることもあります。
- セマンティックイベント:コンパイラがクリックやドラッグなどの操作を「どのデータが選択されたか」という意味に変換します。
- 更新操作:set-style、set-annotation、set-viewport を使って画面の変化を宣言し、低レベルのレンダリングには手を触れません。
- 責務の分離:視覚的な処理はコンパイラに任せ、インタラクションのロジックは意味レベルで記述し、Canvas の状態マシンが実行時の処理を管理します。
- 3つの利用方法:会話内では MCP、アプリ内では Canvas、カスタムインタラクションにはプログラミング API を使います。
- 応用できる設計原則:agent 向けに高レベルの出力仕様を設け、間違いが起きやすい処理を決定論的なシステムに任せます。
- 実際の検証:APIYI の統一インターフェースを使って複数のモデルを比較し、仕様生成の安定性を実測します。
まとめ
Flint-interactive のセマンティックイベントの考え方は、次の3点にまとめられます。
- 問題を的確に特定:インタラクティブなグラフの生成が難しいのは、モデルの能力不足ではなく、表現力があり、かつ十分に高レベルなインタラクション言語がないためです。
- 責務を明確に分離:コンパイラがイベントの解析と画面の更新を担当し、agent は「イベント → 更新」の対応関係だけを記述します。
- 段階的な導入方法:会話内での試用からアプリへの統合、カスタムインタラクションまで、ニーズに応じて段階的に取り組めます。
レポート作成やデータ分析の agent を開発しているチームは、すぐに Flint を使わない場合でも、その設計原則を参考にして、自社の agent の出力形式を見直せます。
実際に検証する際は、APIYI(apiyi.com)を通じて複数の主要モデルに統一的にアクセスし、同じインタラクション要件で生成結果を比較するのがおすすめです。自社の用途に合ったモデルと仕様の組み合わせを、効率よく見つけられます。
📚 参考資料
- Microsoft Research Blog – Flint-interactive: Flint-interactive の公式研究ブログ
- リンク:
microsoft.com/en-us/research/blog/flint-interactive-a-language-for-creating-interactive-data-visualizations - 概要:セマンティックイベント、更新操作、Canvas の状態機械、MCP・Canvas・プログラミング API の3つの利用方法を紹介しています。ブログには MCP の設定ガイド、インタラクティブなサンプル集、プログラミング API へのリンクも掲載されています。
著者: APIYI 技術チーム
技術交流:APIYI apiyi.com では、エージェントや複数モデルの接続に関する実践経験について、皆さまとの情報交換をお待ちしています。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。