Note de l’auteur : DeepSeek vient d’ouvrir ses API Search & Fetch, et APIYI a déjà intégré en simultané deepseek-search et deepseek-fetch. Dans cet article, nous passons en revue les informations clés du guide officiel, analysons leur impact pour les développeurs de solutions RAG, d’agents et de questions-réponses connectées au web, et détaillons la tarification ainsi que les modalités d’accès sur APIYI.
La documentation officielle de DeepSeek a récemment inauguré un guide dédié à la recherche et publié une annonce dans sa rubrique actualités : les API Search & Fetch sont officiellement ouvertes aux développeurs. Concrètement, lors de l’invocation du modèle DeepSeek, vous pouvez désormais vous appuyer sur ces fonctionnalités natives pour « chercher sur le web + extraire le contenu des pages », sans avoir à bricoler vous-même une intégration avec des moteurs de recherche tiers.
Il ne s’agit pas d’une simple rumeur. Le guide Search dans la documentation officielle et le communiqué sont bel et bien en ligne. Des fils de discussion dédiés sont également apparus sur Hacker News, preuve que la communauté internationale des développeurs suit le sujet de très près. Notre analyse des fonctionnalités officielles repose exclusivement sur les informations publiques disponibles (référez-vous à la documentation officielle pour le détail des paramètres de requête). Pour ce qui est de la disponibilité et des tarifs sur la plateforme APIYI, rendez-vous dans la section dédiée un peu plus bas.
L’essentiel en bref : comprenez en 3 minutes les points clés des API DeepSeek Search & Fetch, la répartition des rôles entre les deux outils, et leur impact concret sur vos projets de RAG, d’agents autonomes et de recherche web en temps réel.
Déjà disponible sur APIYI : APIYI a ajouté deepseek-search et deepseek-fetch, facturés au nombre d’appels réussis sans consommer de tokens. Le tarif standard sur la plateforme est de 0,0009 $ par requête, et descend à 0,75 $ pour 1 000 requêtes grâce au bonus de 20 % accordé aux recharges grands comptes, s’alignant ainsi sur le tarif officiel.
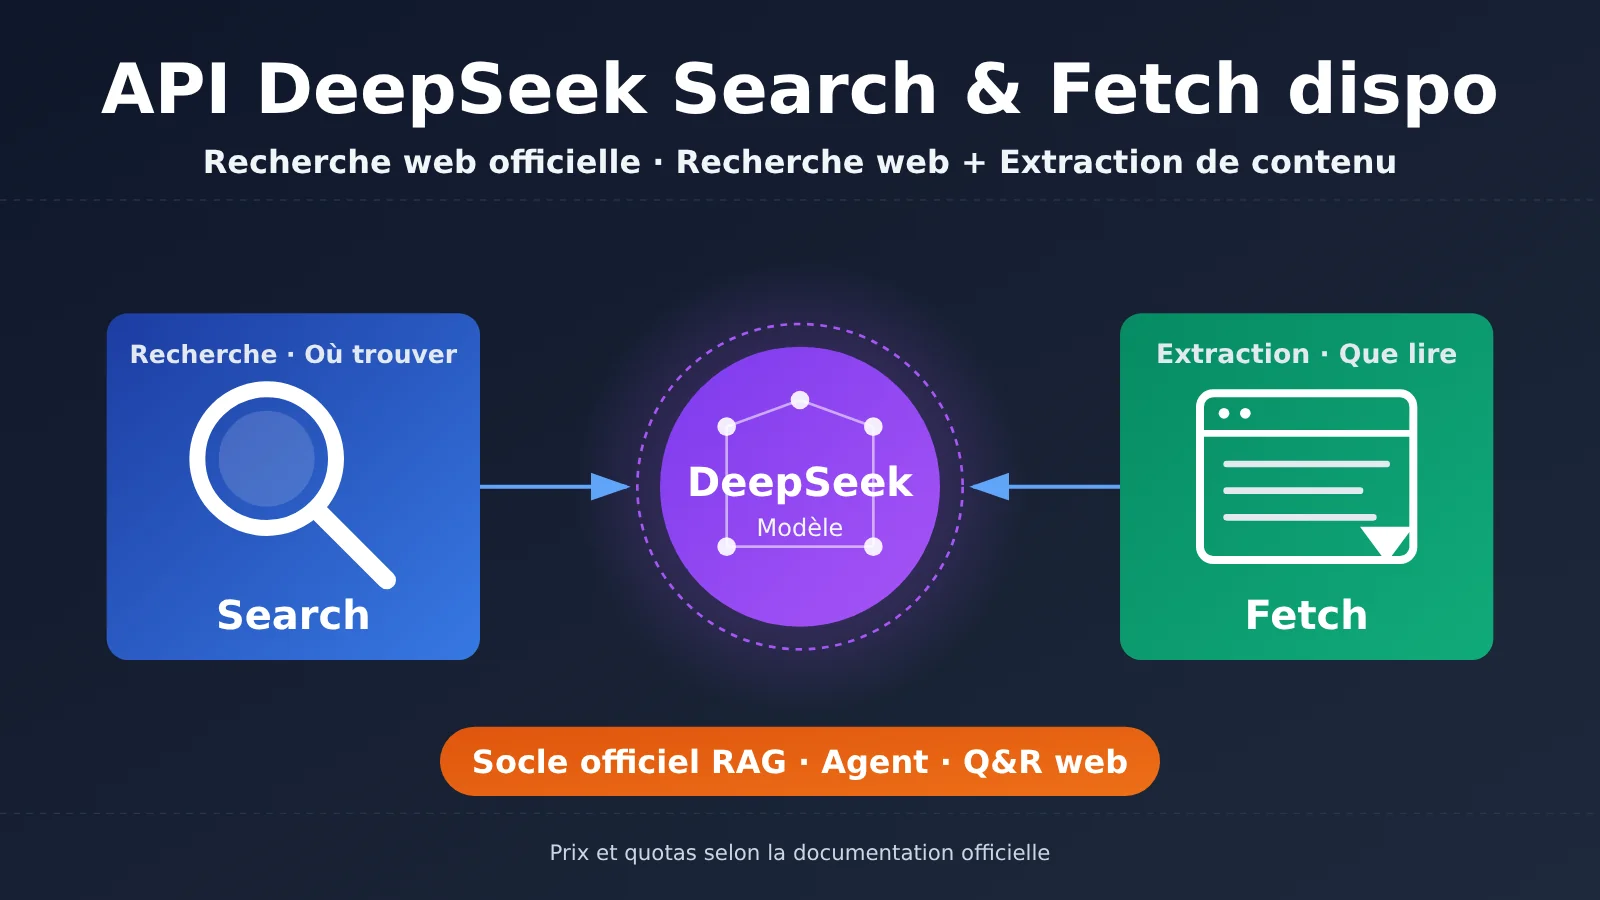
Vue d’ensemble des API DeepSeek Search & Fetch
Commençons par récapituler les faits confirmés dans un tableau clair. Nous nous limitons ici strictement aux informations vérifiables issues des canaux officiels, sans spéculations tarifaires ni benchmarks non publiés.
| Élément | Détails |
|---|---|
| Émetteur | DeepSeek (officiel) |
| Sources | Documentation officielle de l’API (guide Search), annonces officielles |
| Fonctionnalités clés | Ouverture de Search (recherche web) et Fetch (extraction de contenu de pages) |
| Public cible | Développeurs concevant des systèmes de questions-réponses connectés, du RAG ou des agents avec l’API DeepSeek |
| Retours communautaires | Fils de discussion actifs sur Hacker News, fort engouement |
| Tarifs et quotas | Tarifs et quotas officiels selon la documentation et la console officielles ; tarification APIYI détaillée ci-dessous |
Répartition des rôles : Search vs Fetch
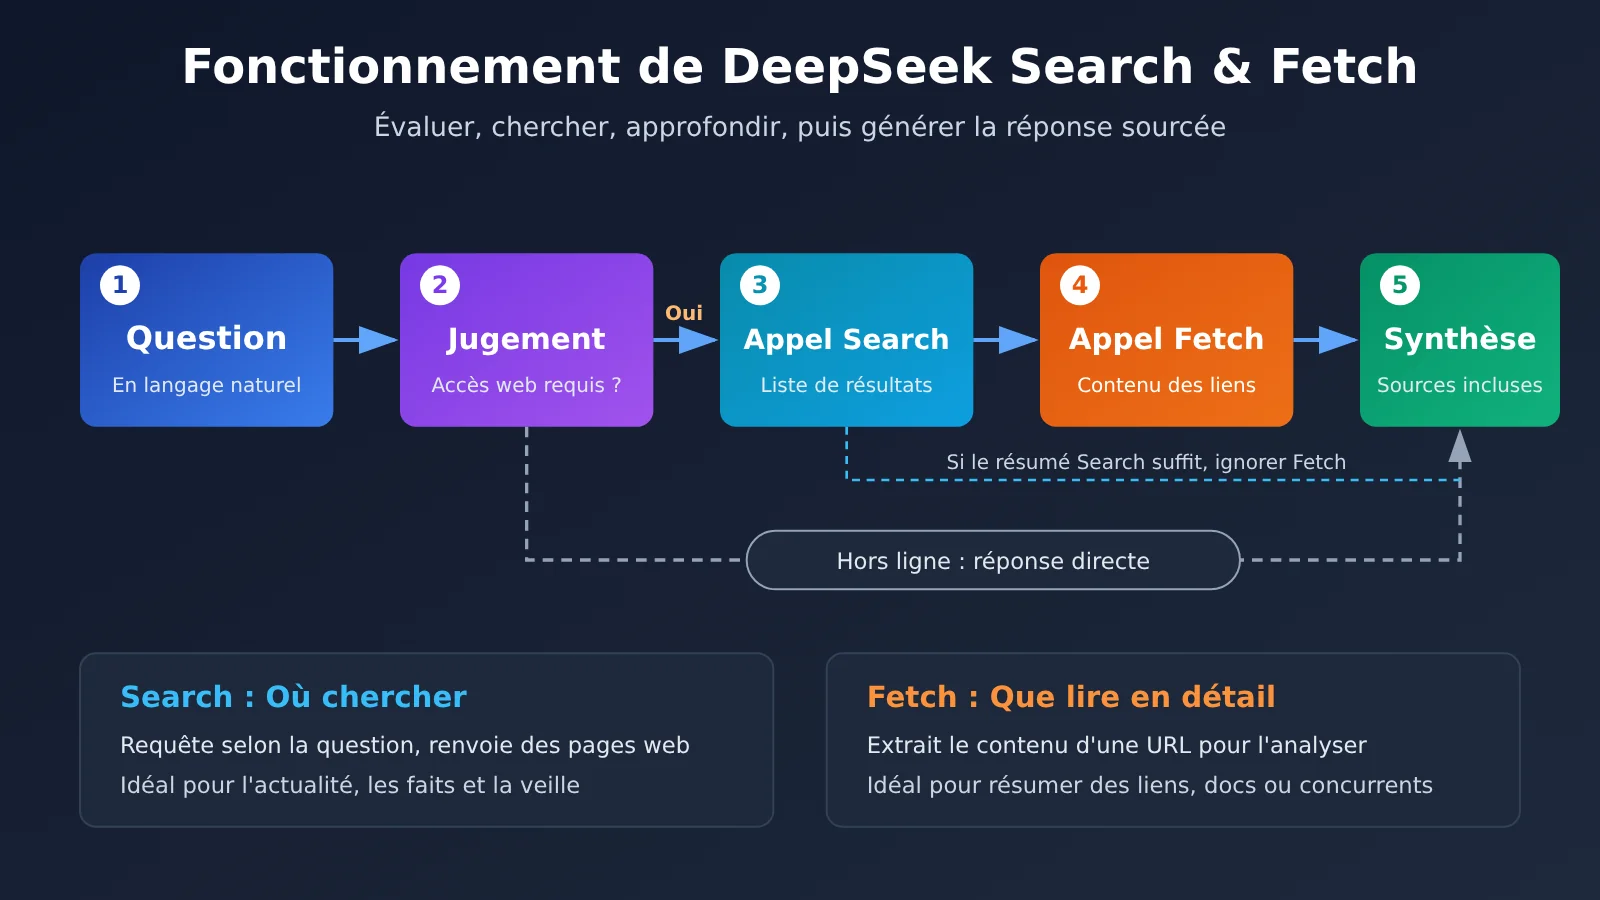
Leurs noms parlent d’eux-mêmes : il s’agit d’un véritable travail d’équipe. Search répond à la question « où chercher ? » : le modèle génère une requête de recherche à partir de la question de l’utilisateur et récupère une liste de résultats candidats. Fetch, quant à lui, répond à la question « quoi lire ? » : il cible une URL précise pour en extraire le corps du texte, permettant ainsi au modèle de l’analyser et de le citer.
L’intérêt de découpler ces deux briques réside dans le contrôle et la flexibilité. Dans bien des cas, les extraits fournis par la recherche suffisent amplement pour répondre, sans qu’il soit nécessaire d’extraire chaque page en détail. Dans d’autres situations, l’utilisateur fournit directement un lien : seul Fetch est alors utile, rendant Search superflu. En séparant ces deux fonctions, les développeurs peuvent composer leur pipeline sur mesure et trouver le juste équilibre entre pertinence et coûts.
| Capacité | Problème résolu | Entrée type | Sortie type | Cas d’usage idéal |
|---|---|---|---|---|
| Search | Où trouver l’information | Question en langage naturel ou mots-clés | Liste de pages web candidates | Veille d’actualité, vérification de faits, étude de marché |
| Fetch | Quel contenu lire en détail | URL précise | Contenu textuel de la page | Résumé d’articles, analyse de documentation, étude concurrentielle |
| Search + Fetch | Chercher puis approfondir | Requête de recherche complexe | Synthèse multi-sources | Recherche approfondie (Deep Research), veille automatisée par agents |
Pourquoi l’API Search & Fetch de DeepSeek mérite votre attention
La solution officielle au problème de date limite des connaissances des grands modèles de langage
Chaque Grand modèle de langage possède une date limite d’entraînement pour ses données (knowledge cutoff) : le modèle ne sait tout simplement pas ce qui s’est passé aujourd’hui. Jusqu’ici, pour que DeepSeek réponde à des questions d’actualité, les développeurs devaient intégrer eux-mêmes l’API d’un moteur de recherche, coder un scraper pour extraire le texte des pages, puis injecter le tout dans la fenêtre de contexte. Une chaîne longue, fragile et coûteuse à maintenir.
Avec l’arrivée officielle de Search & Fetch, ce pipeline peut être considérablement raccourci. Le créateur du modèle est le mieux placé pour comprendre comment son IA utilise les outils : les capacités de recherche intégrées nativement sont généralement bien mieux adaptées au format de requête et à l’organisation des résultats du modèle, ce qui évite ce problème classique où l’information est trouvée mais mal exploitée.
Passer d’un « modèle de questions-réponses » à une véritable infrastructure d’agents
Autre signal particulièrement intéressant : la direction stratégique prise par l’équipe. La recherche sur le web et l’extraction de contenu sont les deux briques fondamentales de n’importe quel agent IA. Qu’il s’agisse de recherche automatisée, d’agents de navigation ou d’outils type « Deep Research », impossible de s’en passer. En proposant ces deux fonctionnalités sous forme d’API officielles, DeepSeek fait évoluer son modèle : ce n’est plus une simple interface de chat, mais une véritable infrastructure prête à propulser des workflows d’agents.
Pour les développeurs, le gain pratique est immédiat. De nombreuses équipes utilisent déjà DeepSeek comme modèle principal : pouvoir gérer l’accès au web au sein du même écosystème simplifie énormément la stack technique et élimine une dépendance tierce lors du débogage.
Guide d’intégration des API Search & Fetch de DeepSeek
Exemple minimaliste : valider l’invocation du modèle DeepSeek de base
Avant d’ajouter les capacités web, mieux vaut vérifier que vos appels de base fonctionnent correctement. Le code ci-dessous utilise l’interface compatible OpenAI pour appeler le modèle DeepSeek, en à peine dix lignes de code :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Utilisation de l'interface unifiée APIYI
)

response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": "Explique en trois phrases l'intérêt de la recherche web pour un Grand modèle de langage"}]
)
print(response.choices[0].message.content)
Petite précision : pour les champs de requête exacts, les paramètres d’activation et la structure de réponse de l’API officielle Search & Fetch, référez-vous toujours à la documentation officielle de DeepSeek. L’exemple complet ci-dessous s’appuie sur le pattern standard de Function Calling pour illustrer le flux où le modèle décide lui-même quand chercher et quand extraire une page. Cela vous permettra de bien assimiler le fonctionnement global, tout en gardant la flexibilité de basculer vers les appels natifs dès que les paramètres officiels seront arrêtés.
Voir le code complet : simulation du flux Search + Fetch via Function Calling
import json
import openai
import requests

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI fournie par APIYI
)

# Définition de deux outils : recherche et extraction (pour la démo, à remplacer par les capacités natives officielles)
tools = [
    {
        "type": "function",
        "function": {
            "name": "web_search",
            "description": "Effectue une recherche web à partir de mots-clés et renvoie une liste de pages candidates",
            "parameters": {
                "type": "object",
                "properties": {"query": {"type": "string"}},
                "required": ["query"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "fetch_page",
            "description": "Extrait le contenu textuel d'une URL spécifiée",
            "parameters": {
                "type": "object",
                "properties": {"url": {"type": "string"}},
                "required": ["url"]
            }
        }
    }
]

def web_search(query: str) -> str:
    # Branchez ici votre moteur de recherche ou remplacez par la capacité Search officielle
    return json.dumps([{"title": "Exemple de résultat", "url": "https://example.com"}])

def fetch_page(url: str) -> str:
    # Implémentation simplifiée : en production, gérez l'encodage, l'extraction de texte et les timeouts
    try:
        resp = requests.get(url, timeout=10)
        return resp.text[:4000]
    except Exception as e:
        return f"Échec de l'extraction : {e}"

TOOL_MAP = {"web_search": web_search, "fetch_page": fetch_page}

def ask(question: str, max_rounds: int = 4) -> str:
    messages = [
        {"role": "system", "content": "Si vous avez besoin d'informations récentes, commencez par chercher, puis extrayez les pages clés. Citez vos sources dans la réponse finale."},
        {"role": "user", "content": question}
    ]
    for _ in range(max_rounds):
        resp = client.chat.completions.create(
            model="deepseek-chat",
            messages=messages,
            tools=tools
        )
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return msg.content
        messages.append(msg)
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = TOOL_MAP[call.function.name](**args)
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result
            })
    return "Nombre maximal d'itérations atteint sans obtenir de réponse"

print(ask("Résume les points clés des récentes discussions autour de l'API DeepSeek Search"))
🚀 Démarrage rapide : Nous vous recommandons de récupérer des crédits de test sur APIYI apiyi.com pour valider l’invocation du modèle DeepSeek de base et tester le flux de Function Calling. APIYI prend déjà en charge deepseek-search et deepseek-fetch : une fois le flux validé, vous pourrez remplacer directement les outils simulés de cet exemple par ces deux interfaces natives. Les détails d’intégration sont présentés dans la section suivante.
DeepSeek Search et Fetch sont disponibles sur APIYI : tarification et intégration
APIYI (apiyi.com) vient de déployer ces deux fonctionnalités, associées à deux nouveaux noms de modèles : deepseek-search et deepseek-fetch. Il ne s’agit pas de modèles conversationnels, mais d’interfaces d’outils (tools) conçues sur mesure pour permettre aux agents autonomes et aux architectures RAG de récupérer des données sur le Web. Les requêtes ne consomment aucun token et sont facturées uniquement au nombre d’appels réussis.
| Élément | deepseek-search | deepseek-fetch |
|---|---|---|
| Point de terminaison | /v1/tools/search |
/v1/tools/fetch |
| Rôle | Recherche en ligne, renvoie des pages candidates | Récupère le contenu d’une URL spécifique |
| Mode de facturation | Facturation par requête réussie, sans consommation de tokens | Facturation par requête réussie, sans consommation de tokens |
| Tarif plateforme | 0,0009 $ / appel | 0,0009 $ / appel |
| Requêtes échouées | Non facturées | Non facturées |
| Groupes disponibles | default, svip | default, svip |
Côté tarif, un petit calcul s’impose. Le prix affiché sur la plateforme est de 0,0009 $ par appel. Pour les recharges professionnelles plus importantes, avec le bonus de 20 % appliqué, cela revient à environ 0,75 $ pour 1 000 requêtes, ce qui s’aligne directement sur le tarif officiel de DeepSeek, taxes comprises. En clair, passer par APIYI ne vous coûte pas plus cher, tout en vous permettant de centraliser la recherche, le scraping et vos modèles conversationnels sur un seul compte et une seule facture.
L’utilisation reste identique à celle de l’API officielle : il suffit de remplacer le domaine racine par celui d’APIYI. Les champs de requête et la structure des réponses restent conformes à la documentation officielle. Vous trouverez le guide complet sur la documentation d’APIYI : docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview.
Deux petits points d’attention avant de vous lancer. Premièrement, même si les endpoints de recherche et d’extraction ne consomment pas de tokens en soi, réinjecter le texte extrait dans un modèle conversationnel consomme bien des tokens de contexte (et entraîne donc les coûts associés au modèle). Le conseil habituel consistant à « limiter les tours de conversation et tronquer les textes » reste donc tout à fait d’actualité. Deuxièmement, la gratuité des requêtes échouées vous évite de payer pour des timeouts réseau ou des pages inaccessibles, mais il est toujours indispensable de prévoir une limite de tentatives (retries) et une stratégie de repli côté applicatif.
🔗 Accès au service : Vérifiez dans la console APIYI que votre compte est configuré sur le groupe default ou svip pour utiliser deepseek-search et deepseek-fetch. Les dernières mises à jour et guides pratiques sont disponibles dans le centre de documentation.
Comparatif : API DeepSeek Search & Fetch vs autres solutions de recherche web
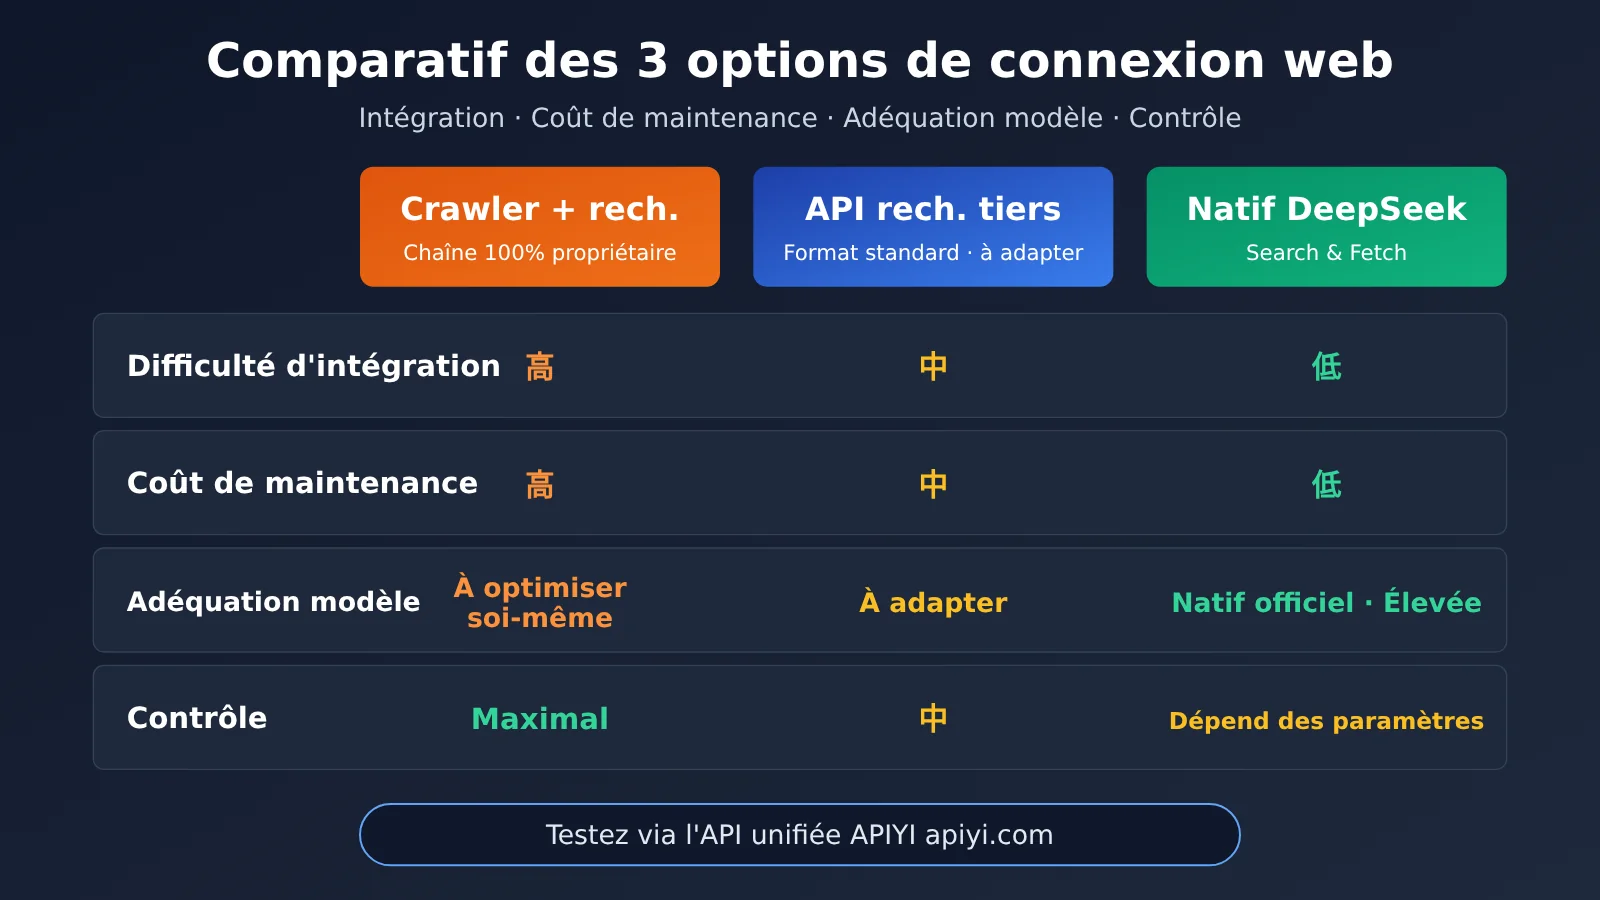
Avant l’arrivée de cette solution native, les développeurs avaient généralement deux options : monter leur propre infrastructure de recherche et de scraping, ou intégrer une API de recherche tierce. Voici une comparaison qualitative d’un point de vue ingénierie, sans entrer dans le détail des prix (pour lesquels nous vous invitons à consulter les documentations respectives).
| Solution | Difficulté d’intégration | Coût de maintenance | Adéquation avec le modèle | Niveau de contrôle | Plateformes disponibles |
|---|---|---|---|---|---|
| Crawler maison + moteur de recherche | Élevée | Élevé | Nécessite un ajustement manuel | Maximal | Serveurs dédiés / propres |
| API de recherche tierce | Moyenne | Moyen | Format générique, adaptation requise | Moyen | Différents fournisseurs de recherche |
| DeepSeek Search & Fetch natif | Faible | Faible | Intégration officielle, excellente synergie | Dépend des paramètres exposés | API officielle DeepSeek, disponible sur APIYI (apiyi.com via deepseek-search / deepseek-fetch) |
Analyse comparative
Analyse de la solution maison : Développer son propre robot d’indexation et son moteur de recherche offre un contrôle inégalé. Vous maîtrisez le choix des sources, les règles de nettoyage et le reclassement des résultats. En revanche, les coûts de développement et d’infrastructure sont considérables : gestion des protections anti-bot, encodage et extraction du contenu textuel demandent un effort continu. La solution native de DeepSeek s’avère bien plus pertinente pour les équipes souhaitant déployer vite sans gérer la corvée du scraping.
Analyse des API de recherche tierces : Les services de recherche tiers bénéficient d’une excellente couverture et d’une grande maturité, avec un écosystème bien rodé. Toutefois, ils renvoient des formats génériques qui nécessitent une couche d’adaptation avant d’être injectés dans le modèle. Ajouter un fournisseur supplémentaire implique aussi une facture de plus et un point de défaillance additionnel dans la chaîne. Pour les projets qui reposent principalement sur DeepSeek, l’approche native offre une simplicité de mise en œuvre imbattable.
💡 Notre recommandation : Il n’existe pas de solution universelle. Pour des contraintes strictes de conformité ou un besoin absolu de cibler des sources précises, l’approche maison reste pertinente. En revanche, pour maximiser la rapidité de mise en production, l’API native est idéale. Le plus simple reste de tester et comparer directement les résultats via l’interface unifiée d’APIYI (apiyi.com) avant de trancher.
Analyse de l’impact des API DeepSeek Search & Fetch pour les développeurs
Impact direct sur 4 profils de développeurs
Selon la nature de vos projets, l’ouverture de ces API n’aura pas le même impact. Voici un récapitulatif pour quatre cas d’usage courants :
| Profil de développeur | Impact principal | Actions recommandées |
|---|---|---|
| Produits de recherche / Q&R connectés au Web | Peut remplacer une chaîne de recherche maison et simplifier l’architecture | Mettre en place un déploiement progressif (canary) sur un faible volume pour comparer la qualité et la latence |
| Applications RAG (bases de connaissances) | Permet d’enrichir les données privées avec des informations publiques en temps réel | Bien séparer les connaissances internes des sources publiques pour éviter toute confusion |
| Développeurs d’agents IA | Fournit des outils de base officiels, réduisant le coût de développement d’outils sur mesure | Définir un plafond strict sur le nombre d’itérations de recherche et de scraping |
| Outils de veille et de recherche | Fluidifie la synthèse de liens et l’analyse concurrentielle | Faire attention à la citation des sources et au respect du droit d’auteur |
Impact sur le paysage de l’écosystème
- L’accès au Web devient un standard pour les API de modèles : les principaux fournisseurs de modèles intègrent peu à peu la recherche et la lecture de pages web au niveau natif. Le modèle tout-en-un « modèle + outils » s’impose rapidement, rendant les simples interfaces de discussion textuelle nettement moins compétitives.
- Les services de recherche tiers face à une segmentation : les API de recherche généralistes conservent leur pertinence, mais elles devront s’orienter vers des sources spécialisées, des secteurs verticaux pointus et des exigences de contrôle d’entreprise, en complémentarité avec les capacités natives des modèles.
- Une barrière à l’entrée encore plus basse pour les agents IA : dès lors que les outils fondamentaux sont fournis par le concepteur du grand modèle de langage, les équipes produit peuvent se concentrer sur la conception des flux de travail et l’optimisation des cas d’usage, plutôt que de réinventer la roue technique.
Points de vigilance lors de l’intégration de DeepSeek Search & Fetch
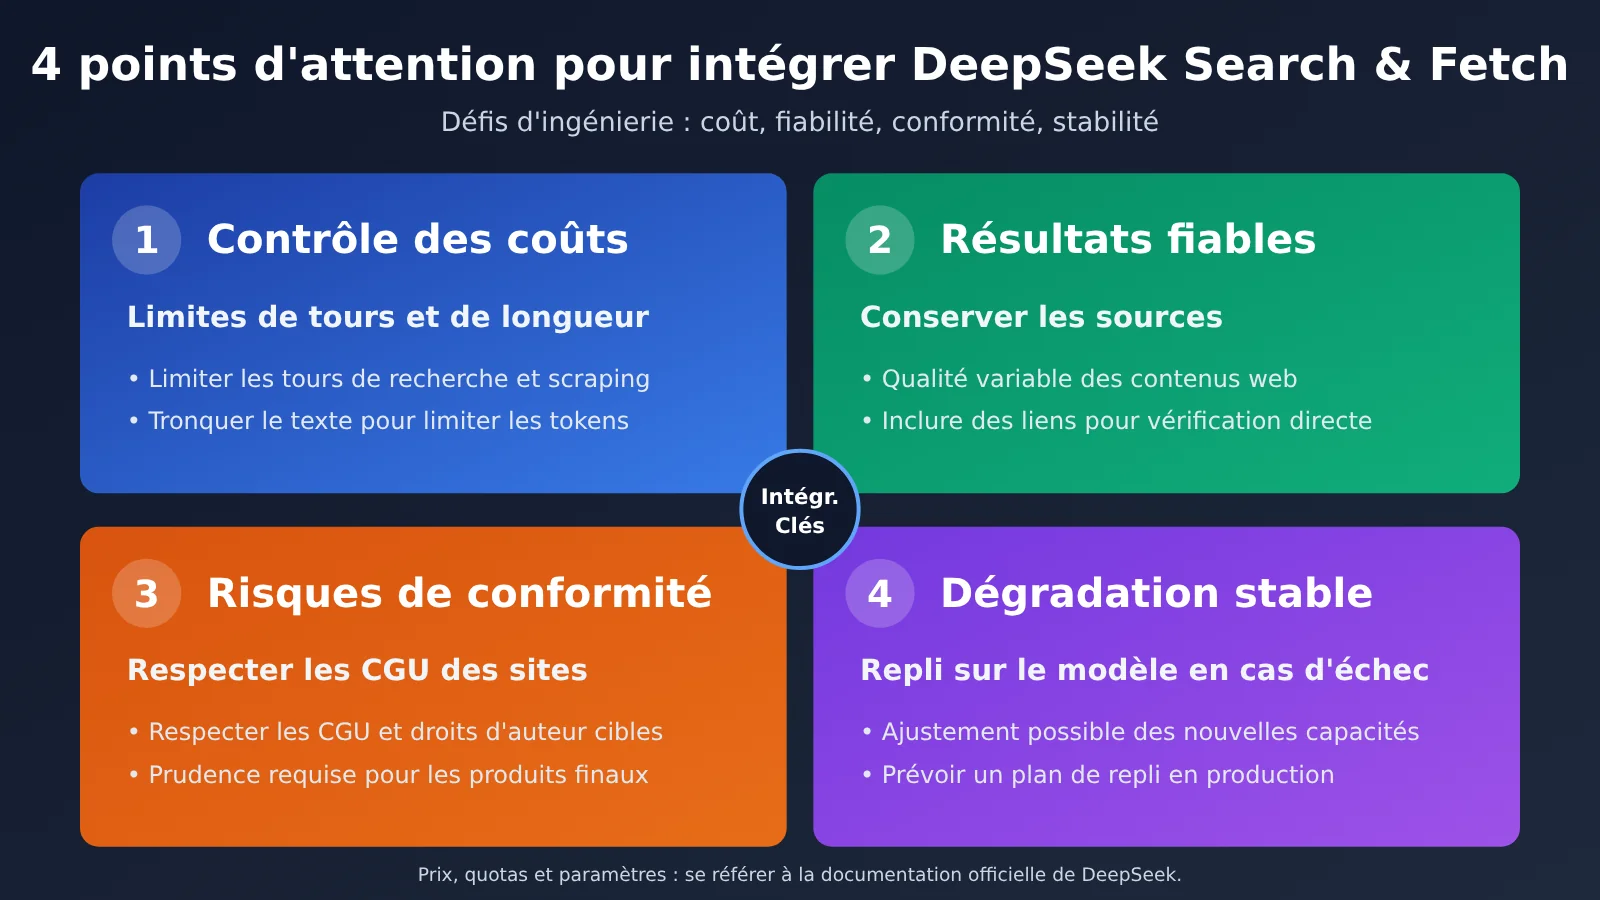
Si l’accès au Web apporte un réel confort, il amène aussi de nouveaux défis d’ingénierie.
Le premier concerne la maîtrise des coûts : la recherche et le scraping augmentent souvent de manière significative la taille de la fenêtre de contexte, ce qui fait grimper la consommation de tokens du modèle de dialogue (même si les appels aux API Search et Fetch sont facturés à la requête et ne consomment pas de tokens en soi). Il est donc vivement conseillé de fixer des limites strictes sur le nombre de tours de boucle et sur la longueur maximale des pages récupérées.
Le deuxième point touche à la fiabilité des résultats : la qualité des données sur le Web public étant très variable, il est essentiel de conserver et d’afficher les sources dans la réponse afin que l’utilisateur puisse vérifier l’information.
Le troisième aspect est la conformité. Récupérer le contenu d’une page web implique de respecter les conditions d’utilisation et les droits d’auteur du site source — une précaution incontournable si votre produit s’adresse à des utilisateurs finaux.
Enfin, veillez à la stabilité. Toute nouvelle fonctionnalité traverse généralement une période d’ajustement de ses paramètres. En production, prévoyez toujours un mécanisme de repli (fallback), comme le retour automatique à une réponse sans navigation web en cas d’échec de la requête réseau.
Foire aux questions (FAQ)
Q1 : Qu’est-ce que l’API DeepSeek Search & Fetch ?
Il s’agit d’un ensemble de fonctionnalités d’accès au Web proposé officiellement par DeepSeek. Search se charge d’effectuer des recherches en ligne pour trouver des résultats pertinents selon votre question, tandis que Fetch extrait le contenu textuel des pages web ciblées. Ensemble, ils permettent aux modèles DeepSeek de répondre à des questions d’actualité et de fournir des réponses sourcées en s’appuyant sur des données réelles du Web.
Q2 : Quelle est la différence entre DeepSeek Search & Fetch et l’intégration d’une API de recherche tierce ?
Intégrer soi-même une API de recherche offre davantage de contrôle, mais vous devez gérer le formatage des résultats, l’extraction du contenu et la maintenance de plusieurs fournisseurs. Les fonctionnalités natives de DeepSeek sont directement intégrées par l’équipe officielle : la synergie avec le modèle est plus étroite et le flux de traitement plus court. En contrepartie, le niveau de personnalisation dépend des paramètres exposés par DeepSeek.
Q3 : Quand l’API DeepSeek Search & Fetch sera-t-elle disponible ?
Le guide Search et les annonces officielles sont déjà en ligne dans la documentation, ce qui signifie que la fonctionnalité est d’ores et déjà accessible. APIYI a également déployé deepseek-search et deepseek-fetch, accessibles via les groupes default et svip, au tarif de 0,0009 $ par requête (aucun débit en cas d’échec). Pour les tarifs et quotas des canaux officiels, veuillez vous référer directement à la documentation et à la console officielles.
Q4 : Comment tester rapidement les capacités Web de DeepSeek via l’API ?
Voici les étapes recommandées pour vous lancer :
1. Rendez-vous sur APIYI (apiyi.com) pour créer un compte et récupérer votre clé API
2. Utilisez l’exemple minimaliste de cet article (en définissant `base_url` sur `https://api.apiyi.com/v1`) pour valider une première invocation du modèle DeepSeek standard
3. Consultez la documentation d’APIYI pour appeler `/v1/tools/search` et `/v1/tools/fetch` (noms de modèles : deepseek-search et deepseek-fetch)
4. Dans le flux de Function Calling de l’exemple complet, remplacez les outils simulés par ces deux interfaces natives
Q5 : Quelles sont les limites connues de DeepSeek Search & Fetch ?
Les informations publiques restent encore limitées, mais plusieurs points méritent une attention particulière : le coût des appels augmente avec le volume de recherches et d’extractions ; la qualité des résultats web varie, d’où l’importance de conserver les sources pour vérification ; l’extraction de pages implique de respecter les conditions d’utilisation des sites et les droits d’auteur ; enfin, les paramètres pouvant évoluer au lancement d’une nouvelle fonctionnalité, prévoyez toujours une solution de repli (fallback) en production.
Points clés à retenir : API DeepSeek Search & Fetch
- Information clé : DeepSeek ouvre officiellement ses deux capacités d’accès au Web, Search et Fetch. La documentation et les annonces officielles sont déjà en ligne.
- Répartition des rôles : Search trouve l’information, Fetch lit le contenu de la page web. Vous pouvez les utiliser séparément ou combinés selon vos besoins.
- Valeur ajoutée majeure : Réduction de la complexité de la chaîne de recherche en ligne, limitant le besoin de développer ses propres scrapers ou d’intégrer des couches tierces.
- Principaux bénéficiaires : Les développeurs de systèmes de questions-réponses connectés, d’architectures RAG, d’agents IA et d’outils d’analyse de contenu.
- Disponible sur APIYI : deepseek-search et deepseek-fetch sont facturés au nombre de requêtes réussies (sans consommation de tokens), à 0,0009 $ par appel sur la plateforme, sans débit en cas d’échec.
- Comparatif tarifaire : Avec le bonus de recharge grand compte de 20 %, le coût revient à 0,75 $ pour 1 000 requêtes, soit un tarif équivalent au site officiel, toutes taxes comprises.
- Conseil d’intégration : Fiez-vous à la documentation officielle pour les paramètres de requête, et gardez un œil sur les coûts, la conformité légale et les scénarios de repli.
- Prise en main : Accessible directement via les groupes default / svip ; il vous suffit de remplacer le domaine racine des exemples officiels par celui d’APIYI.
En résumé
Voici les points clés à retenir sur l’API Search & Fetch de DeepSeek :
- L’accès au Web désormais comblé nativement : Grâce aux fonctionnalités Search et Fetch, les modèles DeepSeek peuvent enfin explorer et extraire directement des informations Web en temps réel.
- Une infrastructure essentielle pour les Agents : La recherche et la lecture de pages Web constituent les outils fondamentaux de tout agent IA. Leur prise en charge officielle abaisse considérablement la complexité de développement.
- Évaluer méthodiquement avant le déploiement : Préparez des scénarios solides sur les plans du coût, de la fiabilité, de la conformité et de la stabilité avant de basculer définitivement vos flux de production actuels.
APIYI propose d’ores et déjà deepseek-search et deepseek-fetch, avec une facturation basée uniquement sur les requêtes réussies (aucun coût en cas d’échec). Pour les équipes qui utilisent déjà DeepSeek, c’est le moment idéal pour tester ces fonctionnalités : commencez par router une petite fraction de votre trafic afin de comparer la qualité des réponses et les coûts, avant d’envisager une migration globale. Nous vous recommandons de passer par APIYI apiyi.com pour valider rapidement les résultats : la plateforme met à disposition une interface unifiée compatible OpenAI, facilitant grandement les comparaisons et les bascules entre DeepSeek et d’autres grands modèles du marché.
📚 Ressources et références
- Documentation officielle de DeepSeek – Guide Search : Présentation officielle des capacités Search & Fetch
- Lien :
api-docs.deepseek.com/guides/search/ -
Remarque : Document de référence pour les méthodes de requête, les paramètres et les structures de réponse.
-
Annonce officielle de DeepSeek : Page de lancement de ces nouvelles capacités
- Lien :
api-docs.deepseek.com/news/news261017/ -
Remarque : Utile pour comprendre le contexte du déploiement et la vision officielle.
-
Discussion sur la communauté Hacker News : Fil de discussion des développeurs internationaux autour de cette sortie
- Lien :
news.ycombinator.com/item?id=50138531 - Remarque : Idéal pour consulter les retours d’utilisation et les points d’attention de la communauté.
Auteur : Équipe technique APIYI
Échanges techniques : N’hésitez pas à partager vos retours d’expérience sur l’intégration des fonctionnalités de navigation Web de DeepSeek dans les commentaires. Pour plus de guides d’intégration, rendez-vous sur le centre de documentation APIYI : docs.apiyi.com