Hinweis des Autors: DeepSeek hat die Search & Fetch API freigegeben, und APIYI hat deepseek-search sowie deepseek-fetch zeitgleich integriert. Dieser Artikel fasst die Kerninformationen des offiziellen Leitfadens zusammen, analysiert die Auswirkungen auf Entwickler von RAG, Agents und webbasierten Frage-Antwort-Systemen und erläutert die Abrechnung sowie den Zugriff über APIYI.
Die offizielle DeepSeek-Dokumentation wurde kürzlich um einen Search-Leitfaden erweitert, und im News-Bereich wurde eine Ankündigung veröffentlicht: Die Search & Fetch API ist ab sofort offiziell für Entwickler verfügbar. Das bedeutet, dass Sie bei einem Modellaufruf von DeepSeek über offizielle Schnittstellen Webseiten durchsuchen und Seiteninhalte abrufen können – ohne dafür mühsam Suchdienste von Drittanbietern anbinden zu müssen.
Das ist kein Gerücht. Der offizielle Search-Leitfaden und die Ankündigung sind online, und auch auf Hacker News gibt es bereits rege Diskussionen – die internationale Entwickler-Community verfolgt das Thema also mit großem Interesse. Die Beschreibung der offiziellen Funktionen basiert ausschließlich auf öffentlich zugänglichen Informationen; für genaue Anfrageparameter gilt die offizielle Dokumentation. Details zum Start auf APIYI und zu den Abrechnungsmodalitäten finden Sie im entsprechenden Abschnitt weiter unten.
Kernwert: Erfahren Sie in 3 Minuten alles Wesentliche über die DeepSeek Search & Fetch API, die Aufgabenteilung der beiden Endpunkte und die praktischen Auswirkungen auf RAG, Agents sowie webbasierte Frage-Antwort-Systeme.
Bereits auf APIYI verfügbar: APIYI unterstützt ab sofort deepseek-search und deepseek-fetch. Die Abrechnung erfolgt pro erfolgreichem Aufruf ohne Token-Verbrauch: regulär 0,0009 $ pro Aufruf auf der Plattform, für Großkunden mit 20 % Aufladebonus effektiv 0,75 $ / 1.000 Aufrufe – exakt auf dem Niveau der offiziellen Preise.
DeepSeek Search & Fetch API: Wichtigste Fakten im Überblick
Verschaffen wir uns zuerst mit einer Übersichtstabelle Klarheit über den aktuellen Stand. Hier listen wir ausschließlich Fakten auf, die über offizielle DeepSeek-Kanäle verifiziert werden können – ohne spekulative Preise oder unbestätigte Benchmark-Daten.
| Merkmal | Details |
|---|---|
| Herausgeber | DeepSeek offiziell |
| Quellen | Offizielle API-Dokumentation (Search Guide), offizielle Ankündigungen |
| Kernfeatures | Freigabe zweier Funktionen: Search (Websuche) und Fetch (Webseiten-Crawling / Scraping) |
| Zielgruppe | Entwickler, die mit der DeepSeek API webbasierte Frage-Antwort-Systeme, RAG oder KI-Agenten aufbauen |
| Community-Feedback | Bereits rege Diskussionen u. a. auf Hacker News mit hoher Aufmerksamkeit |
| Preise & Quoten | Offizielle Preise und Limits richten sich nach der DeepSeek-Dokumentation und -Konsole; Abrechnungsdetails für APIYI folgen im entsprechenden Abschnitt unten |
Aufgabenverteilung: Search vs. Fetch
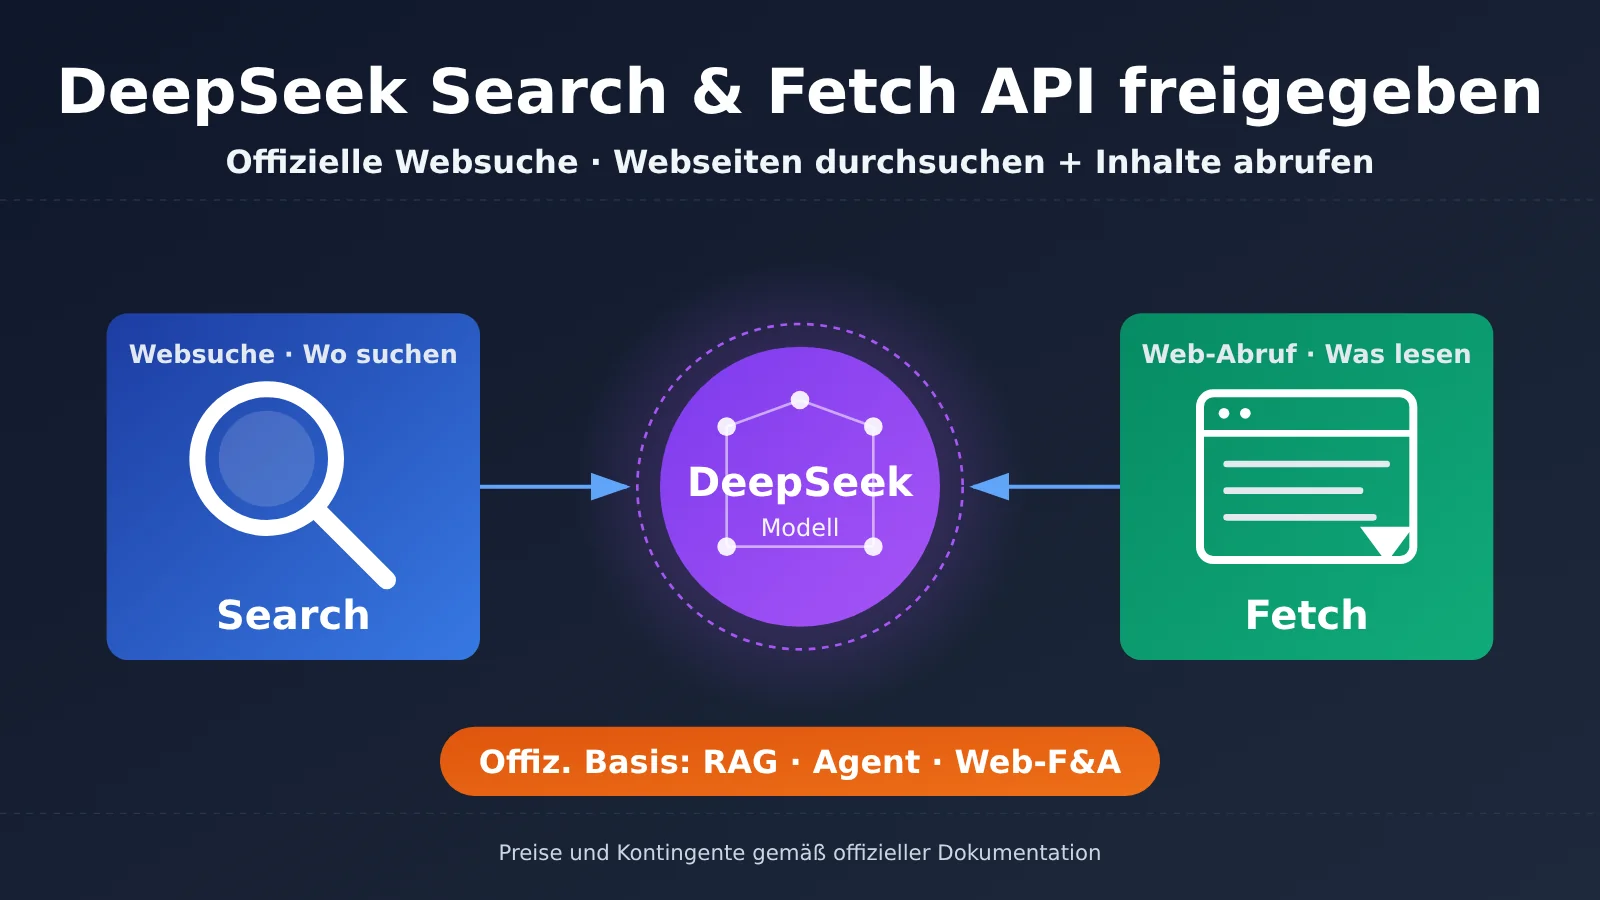
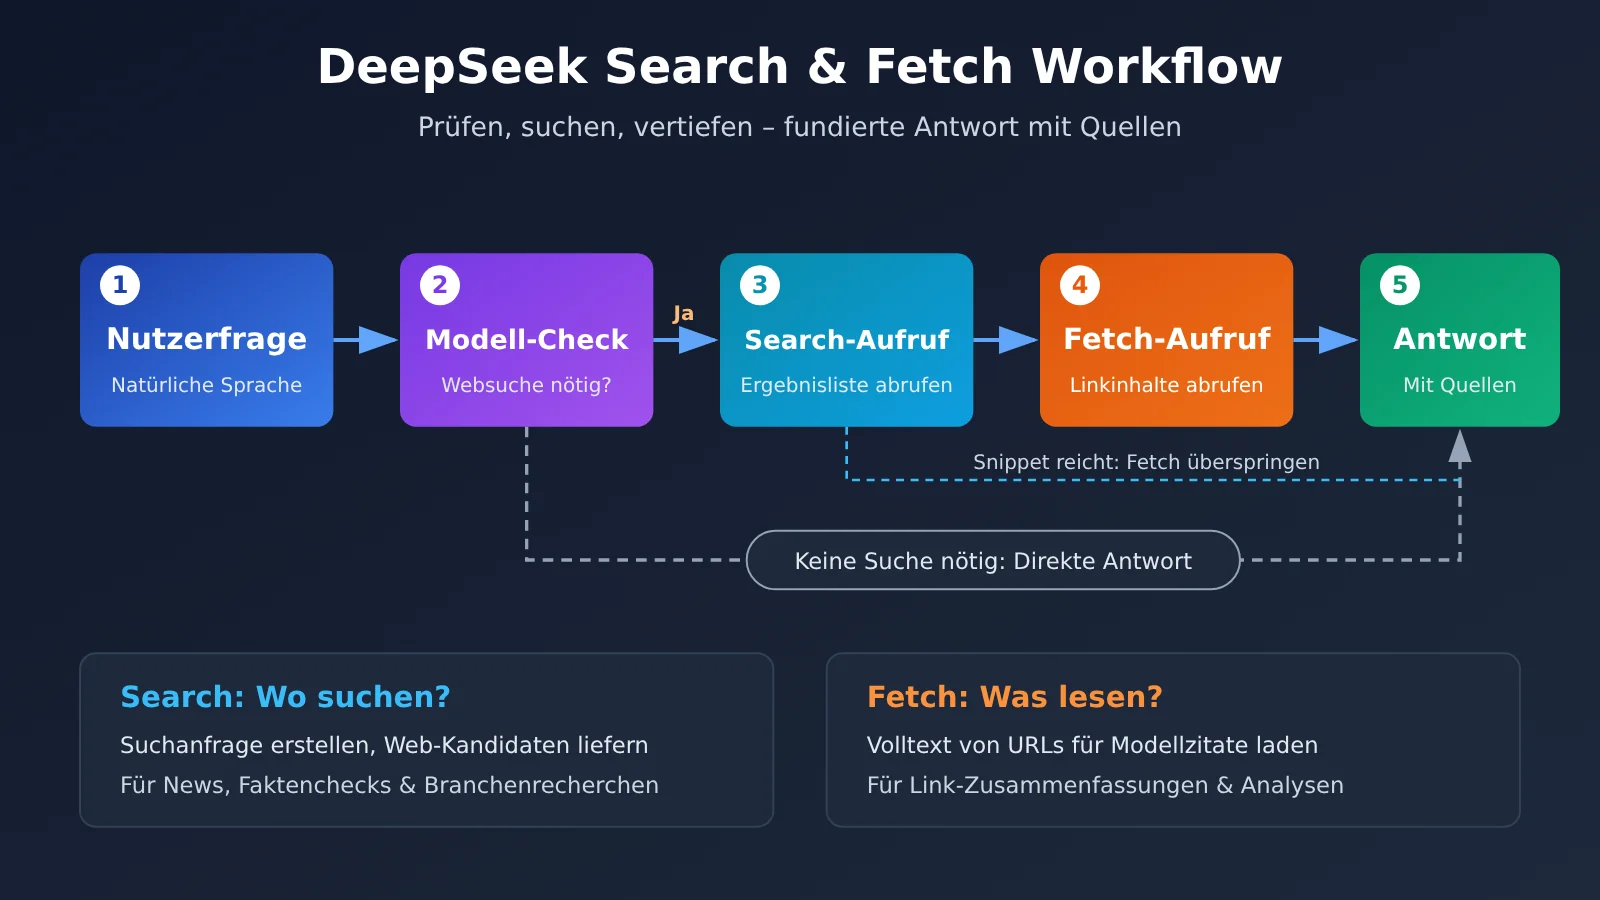
Schon am Namen erkennt man, dass es sich um ein perfekt aufeinander abgestimmtes Doppelpaket handelt. Search löst die Frage: „Wo finde ich was?“ – das Modell generiert basierend auf der Nutzerfrage eine Suchanfrage und liefert relevante Treffer zurück. Fetch beantwortet wiederum: „Was genau lese ich?“ – hier wird der eigentliche Volltext einer konkreten URL abgerufen, damit das Modell den Inhalt analysieren und zitieren kann.
Der große Vorteil dieser Trennung liegt in der präzisen Kontrolle. In vielen Szenarien reicht bereits das Such-Snippet (die Zusammenfassung) völlig aus, um eine Frage zu beantworten – ein Abruf der kompletten Webseite wäre unnötig teuer und rechenintensiv. In anderen Fällen liefert der Nutzer direkt einen Link mit; hier wird ausschließlich Fetch benötigt. Durch die Entkopplung beider Funktionen können Entwickler sie flexibel kombinieren und die optimale Balance zwischen Ausgabequalität, Latenz und Kosten finden.
| Funktion | Gelöstes Problem | Typischer Input | Typischer Output | Ideale Anwendungsfälle |
|---|---|---|---|---|
| Search | Wo man Informationen findet | Natürliche Sprache oder Keywords | Liste relevanter Web-Suchergebnisse | News-Q&A, Fact-Checking, Marktrecherchen |
| Fetch | Welche Inhalte konkret gelesen werden | Spezifische Web-URL | Bereinigter Volltext der Webseite | Link-Zusammenfassungen, Dokumentenanalyse, Mitbewerber-Checks |
| Search + Fetch | Erst suchen, dann vertiefen | Komplexe Recherchefragen | Synthese aus mehreren Quellen | Deep Research, autonome Recherche-Agenten |
Warum die DeepSeek Search & Fetch API einen genaueren Blick wert ist
Die offizielle Lösung für das Wissensstopp-Problem bei Großen Sprachmodellen
Jedes Große Sprachmodell hat ein Trainingsdaten-Stichtagsdatum (Knowledge Cutoff) – das Modell selbst weiß schlichtweg nicht, was „heute passiert ist“. Wollten Entwickler DeepSeek bisher Fragen mit aktuellem Zeitbezug beantworten lassen, mussten sie meist selbst eine Suchmaschinen-API anbinden, einen Web-Scraper für den Volltext schreiben und die Inhalte mühsam in das Kontextfenster packen. Eine lange Kette mit hohem Wartungsaufwand.
Mit den offiziellen Search- & Fetch-Funktionen lässt sich dieser Ablauf nun drastisch verkürzen. Die Modellanbieter kennen das Tool-Calling-Verhalten ihrer eigenen Modelle am besten: Eine offiziell integrierte Suchfunktion ist beim Aufrufformat und bei der Ergebnisaufbereitung meist viel genauer auf das Modell abgestimmt. Das hilft enorm dabei, das Problem „Ergebnisse zwar gefunden, aber nicht sinnvoll verwertet“ zu minimieren.
Vom reinen „Q&A-Modell“ zur echten „Agent-Infrastruktur“
Ein weiteres wichtiges Signal liegt in der strategischen Ausrichtung: Websuche und das Auslesen von Webseiten sind die beiden elementarsten Werkzeuge für KI-Agenten. Nahezu alle automatisierten Recherche-Tools, Browser-Agenten oder Deep-Research-Produkte bauen darauf auf. Dass DeepSeek diese beiden Funktionen als offizielle APIs bereitstellt, zeigt deutlich: Das Modell entwickelt sich von einer simplen Chat-Schnittstelle hin zu einer vollwertigen Infrastruktur für agentenbasierte Workflows.
Für Entwickler ist das ein enormer praktischer Vorteil. Viele Teams nutzen DeepSeek ohnehin schon als primäres Modell. Wenn nun auch der Webzugriff innerhalb desselben Ökosystems gelöst wird, bleibt der Tech-Stack schlank – und bei der Fehlersuche entfällt eine zusätzliche externe Abhängigkeit.
Integrationsmöglichkeiten der DeepSeek Search & Fetch API
Minimalbeispiel: Den Basis-Modellaufruf von DeepSeek testen
Bevor Sie Web-Funktionen anbinden, sollten Sie sicherstellen, dass der grundlegende Modellaufruf reibungslos funktioniert. Der folgende Code nutzt die OpenAI-kompatible Schnittstelle, um DeepSeek mit rund zehn Zeilen Python anzusprechen:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle verwenden
)

response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": "Erkläre in drei Sätzen, warum die Websuche für Große Sprachmodelle so wichtig ist."}]
)
print(response.choices[0].message.content)
Wichtiger Hinweis: Die genauen Anfragefelder, Parameter und Antwortstrukturen von Search & Fetch entnehmen Sie bitte der offiziellen DeepSeek-Search-Dokumentation. Das folgende vollständige Beispiel verwendet ein standardmäßiges Function-Calling-Muster. Es demonstriert den Ablauf, bei dem das Modell eigenständig entscheidet, wann gesucht und wann eine Seite abgerufen werden soll – so verstehen Sie das Prinzip und können die Platzhalter später problemlos durch native Aufrufe ersetzen.
Vollständigen Code anzeigen: Search- und Fetch-Ablauf via Function Calling simulieren
import json
import openai
import requests

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

# Zwei Tools definieren: Suchen und Abrufen (zur Demonstration, durch offizielle Schnittstellen ersetzbar)
tools = [
    {
        "type": "function",
        "function": {
            "name": "web_search",
            "description": "Führt eine Websuche anhand von Suchbegriffen durch und gibt eine Liste relevanter Seiten zurück",
            "parameters": {
                "type": "object",
                "properties": {"query": {"type": "string"}},
                "required": ["query"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "fetch_page",
            "description": "Liest den Haupttext einer bestimmten Webseiten-URL aus",
            "parameters": {
                "type": "object",
                "properties": {"url": {"type": "string"}},
                "required": ["url"]
            }
        }
    }
]

def web_search(query: str) -> str:
    # Hier eigene Suchlogik einbinden oder durch offizielle Search-API ersetzen
    return json.dumps([{"title": "Beispiel-Ergebnis", "url": "https://example.com"}])

def fetch_page(url: str) -> str:
    # Vereinfachte Fetch-Logik; in der Praxis sollten Encoding, Textextraktion und Timeouts abgefangen werden
    try:
        resp = requests.get(url, timeout=10)
        return resp.text[:4000]
    except Exception as e:
        return f"Abruf fehlgeschlagen: {e}"

TOOL_MAP = {"web_search": web_search, "fetch_page": fetch_page}

def ask(question: str, max_rounds: int = 4) -> str:
    messages = [
        {"role": "system", "content": "Suche bei Bedarf nach aktuellen Infos, rufe wichtige Seiten ab und gib in der Antwort Quellen an."},
        {"role": "user", "content": question}
    ]
    for _ in range(max_rounds):
        resp = client.chat.completions.create(
            model="deepseek-chat",
            messages=messages,
            tools=tools
        )
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return msg.content
        messages.append(msg)
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = TOOL_MAP[call.function.name](**args)
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result
            })
    return "Maximale Rundenzahl erreicht, Antwort konnte nicht fertiggestellt werden."

print(ask("Fasse die wichtigsten Diskussionspunkte rund um die DeepSeek Search API zusammen."))
🚀 Schnellstart: Am besten holen Sie sich über APIYI (apiyi.com) Testguthaben, um den Basis-Modellaufruf und den Function-Calling-Workflow von DeepSeek einmal durchzuspielen. APIYI unterstützt
deepseek-searchunddeepseek-fetchbereits direkt. Sobald die Tests stehen, können Sie die simulierten Tools im Code einfach durch diese beiden nativen Endpunkte austauschen – Details dazu folgen im nächsten Abschnitt.
APIYI unterstützt jetzt DeepSeek Search & Fetch: Abrechnung und Integration
APIYI (apiyi.com) hat diese beiden Funktionen bereits bereitgestellt – abrufbar über zwei neue Modellbezeichnungen: deepseek-search und deepseek-fetch. Dabei handelt es sich nicht um Chat-Modelle, sondern um Tool-Schnittstellen (Tool APIs), die speziell dafür entwickelt wurden, AI-Agents und RAG-Pipelines mit Live-Daten aus dem Web zu versorgen. Abfragen verbrauchen keine Tokens, sondern werden rein nach der Anzahl der erfolgreichen Aufrufe abgerechnet.
| Parameter | deepseek-search | deepseek-fetch |
|---|---|---|
| Endpunkt | /v1/tools/search |
/v1/tools/fetch |
| Funktion | Websuche, liefert relevante Webseiten | Scraping und Extrahieren von Inhalten einer Ziel-URL |
| Abrechnung | Pro erfolgreichem Aufruf, verbraucht keine Tokens | Pro erfolgreichem Aufruf, verbraucht keine Tokens |
| Preis auf der Plattform | 0,0009 $ / Aufruf | 0,0009 $ / Aufruf |
| Fehlgeschlagene Anfragen | Keine Berechnung | Keine Berechnung |
| Verfügbare Gruppen | default, svip | default, svip |
Beim Preis lohnt sich ein genauerer Blick auf die Zahlen: Der reguläre Plattformpreis liegt bei 0,0009 $ pro Anfrage. Für Großkunden, die von Guthaben-Boni von bis zu 20 % profitieren, entspricht das effektiv 0,75 $ pro 1.000 Aufrufe. Das entspricht exakt den offiziellen Preisen von DeepSeek – inklusive Steuern. Sie zahlen bei APIYI also keinen Aufpreis, können Websuche, Scraping und Chat-Modelle aber zentral über ein einziges Konto und eine gemeinsame Abrechnung verwalten.
Die Nutzung ist identisch mit der offiziellen API: Tauschen Sie einfach die Basis-URL gegen die APIYI-Domain aus. Request-Parameter und Response-Payloads entsprechen exakt der offiziellen Dokumentation. Eine ausführliche Anleitung finden Sie in der APIYI-Dokumentation: docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview.
Zwei praktische Tipps für die Implementierung:
1. Kontextfenster beachten: Die Search- und Fetch-Endpunkte selbst verbrauchen zwar keine Tokens. Sobald Sie die abgerufenen Textinhalte jedoch an ein Chat-Modell weiterleiten, belegen sie dort Kontext und erzeugen die üblichen Token-Kosten. Begrenzen Sie die Chat-Runden und schneiden Sie überflüssige Webseitentexte vorab ab.
2. Fehlerbehandlung: Wenn Anfragen fehlschlagen (z. B. bei Timeouts oder unerreichbaren Zielseiten), entstehen Ihnen keine Kosten. Dennoch sollte Ihre Anwendungslogik Obergrenzen für Retries und Fallback-Strategien definieren.
🔗 Schnellstart: Stellen Sie im Dashboard von APIYI sicher, dass Ihr Konto der Gruppe default oder svip zugeordnet ist, um
deepseek-searchunddeepseek-fetchdirekt zu nutzen. Aktuelle Hinweise finden Sie wie gewohnt in den Release-Notes und im Dokumentationszentrum.
DeepSeek Search & Fetch API im Vergleich zu anderen Web-Lösungen
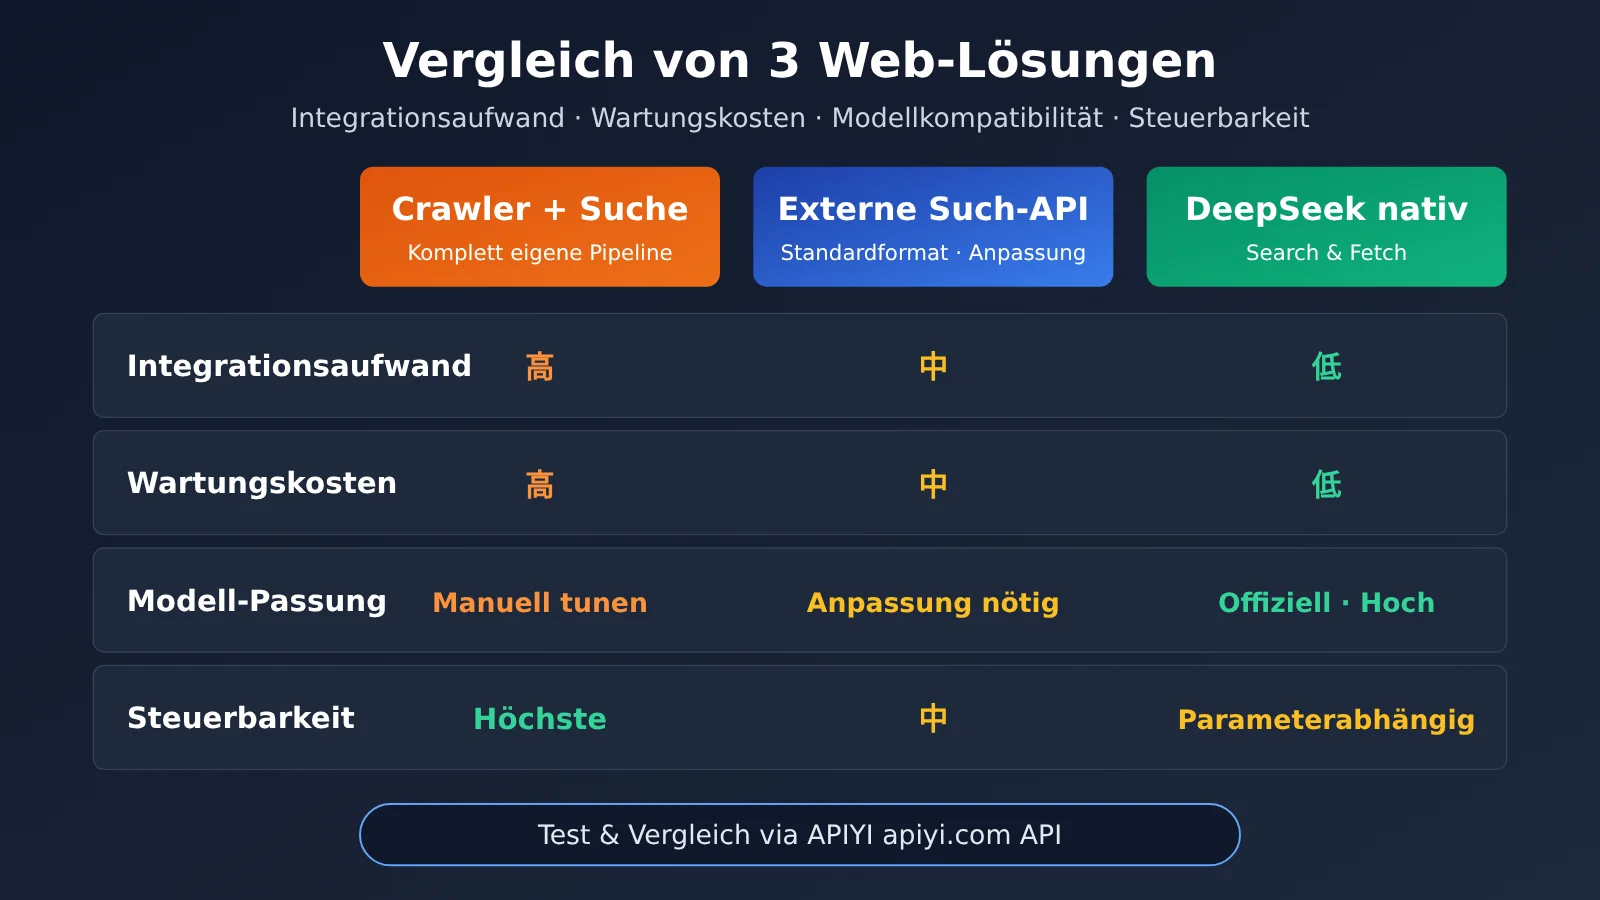
Vor der Veröffentlichung dieser nativen Funktionen standen Entwickler meist vor zwei Optionen: Entweder eine eigene Scraping- und Retrieval-Pipeline aufbauen oder auf Drittanbieter-Such-APIs zurückgreifen. Die folgende Tabelle vergleicht diese Ansätze aus technischer Sicht (ohne konkrete Preisangaben – diese entnehmen Sie bitte den jeweiligen Preislisten):
| Lösung | Integrationsaufwand | Wartungsaufwand | Modell-Passgenauigkeit | Steuerbarkeit / Kontrolle | Verfügbarkeit |
|---|---|---|---|---|---|
| Eigener Crawler + Suchmaschine | Hoch | Hoch | Erfordert manuelles Tuning | Am höchsten | Eigene Serverinfrastruktur |
| Drittanbieter-Such-API | Mittel | Mittel | Generisches Format, erfordert Parsing | Mittel | Diverse Suchmaschinen-Provider |
| DeepSeek Native Search & Fetch | Gering | Gering | Nativ integriert, optimal abgestimmt | Abhängig von API-Parametern | Offizielle DeepSeek-API, APIYI (apiyi.com) verfügbar (deepseek-search / deepseek-fetch) |
Einordnung der Ansätze
Eigene Crawler-Infrastruktur: Bei maximaler Kontrolle bleibt ein selbst gebauter Crawler unschlagbar. Sie bestimmen exakt, welche Domains gecrawlt werden, wie Texte bereinigt werden und nach welchen Kriterien gerankt wird. Dem gegenüber steht allerdings der erhebliche Entwicklungs- und Wartungsaufwand: Anti-Scraping-Mechanismen, Proxy-Management und HTML-Parsing erfordern dauerhafte Betreuung. Für Teams, die ohne Wartungslast schnell live gehen wollen, ist die native Lösung deutlich attraktiver.
Such-APIs von Drittanbietern: Etablierte Suchdienstleister überzeugen mit breiter Webabdeckung und ausgereiften Ökosystemen. Allerdings liefern sie Antworten in Standardformaten zurück, die vor der Übergabe an das Sprachmodell aufbereitet werden müssen. Zudem bedeutet ein weiterer Anbieter auch einen weiteren Vertrag, getrennte Rechnungen und eine zusätzliche Fehlerquelle im System. Wer ohnehin primär auf DeepSeek setzt, profitiert bei den nativen Tools von einer schlankeren Architektur.
💡 Empfehlung: Es gibt keine Universallösung. Für strikte Compliance-Vorgaben oder fest vorgegebene Quellen bleibt ein eigenes Scraping-Setup oft die beste Wahl. Geht es dagegen um schnelle Marktreife und geringe Komplexität, punkten die nativen APIs. Über APIYI (apiyi.com) können Sie die verschiedenen Ansätze und Modelle über eine einheitliche Schnittstelle direkt im Praxisbetrieb vergleichen.
DeepSeek Search & Fetch API: Auswirkungen auf Entwickler im Überblick
Direkte Auswirkungen auf 4 Entwicklertypen
Je nach Art des Projekts fallen die Auswirkungen dieser Neuerung unterschiedlich aus. Im Folgenden fassen wir die Folgen für vier typische Entwicklergruppen zusammen:
| Entwicklertyp | Wesentliche Auswirkungen | Empfohlene Maßnahmen |
|---|---|---|
| Webbasierte Q&A- / Suchprodukte | Kann eigene Retrieval-Pipelines ersetzen und Architekturen vereinfachen | A/B-Tests mit geringem Traffic zur Bewertung von Antwortqualität und Latenz durchführen |
| RAG-Wissensdatenbank-Anwendungen | Ergänzung privater Wissensbestände um Echtzeitdaten aus dem Web | Interne Daten klar von öffentlichen Webquellen trennen, um Verwechslungen zu vermeiden |
| KI-Agent-Entwickler | Erhalt nativer Basistools, was den Aufwand für die Tool-Entwicklung senkt | Klare Obergrenzen für die Anzahl der Such- und Fetch-Runden definieren |
| Content- & Recherche-Tools | Reibungslosere Abläufe bei Link-Zusammenfassungen und Konkurrenzanalysen | Auf Quellennennung und Einhaltung von Urheberrechtsvorgaben achten |
Auswirkungen auf die Branchenlandschaft
- Web-Zugriff wird zum Standard für Modell-APIs: Führende Modellanbieter integrieren Such- und Web-Scraping-Funktionen zunehmend direkt in ihre Plattformen. Das Paket aus „Modell + Tools“ entwickelt sich zum Standard – isolierte Chat-Schnittstellen verlieren dadurch an Wettbewerbsfähigkeit.
- Differenzierung bei Drittanbieter-Suchdiensten: Zwar bleibt ein Markt für allgemeine Such-APIs bestehen, diese dürften sich jedoch stärker auf spezialisierte Datenquellen, vertikale Branchen und kontrollierbare Enterprise-Recherchen konzentrieren, um native Modellfunktionen sinnvoll zu ergänzen.
- Hürden für KI-Agent-Produkte sinken weiter: Da die grundlegenden Werkzeuge direkt vom Modellanbieter bereitgestellt werden, können sich Start-ups und Entwicklerteams voll auf das Workflow-Design und spezifische Anwendungsfälle konzentrieren, statt das Rad neu zu erfinden.
Worauf bei der Integration von DeepSeek Search & Fetch zu achten ist
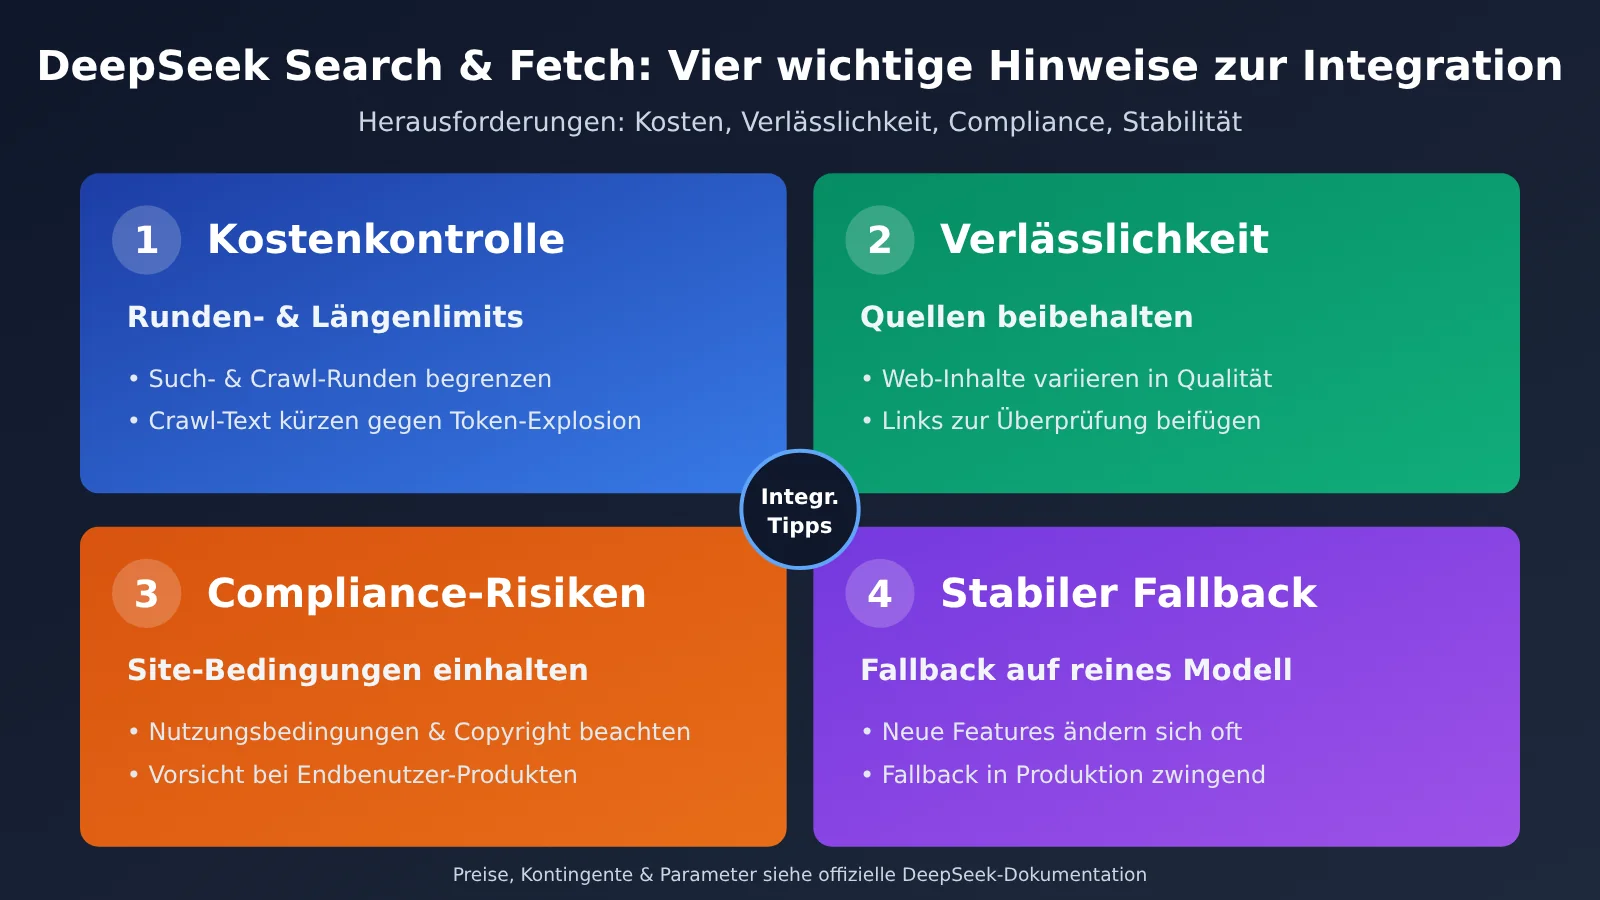
Die Anbindung an das Web bringt viele Vorteile mit sich, stellt Entwickler aber auch vor neue technische Herausforderungen. Der erste Punkt ist die Kostenkontrolle: Suchabfragen und Scraping vergrößern den Kontext oft erheblich, was den Token-Verbrauch des nachgelagerten Modells in die Höhe treibt (die Search- und Fetch-Endpunkte selbst werden pro Aufruf abgerechnet und verbrauchen keine Tokens). Hier empfiehlt es sich, strikte Obergrenzen für die Aufrufanzahl pro Sitzung sowie für die Textlänge der gecrawlten Inhalte festzulegen. Der zweite Punkt ist die Zuverlässigkeit der Ergebnisse: Die Qualität von Webinhalten variiert stark. In den Antworten sollten daher stets Quellenangaben erhalten bleiben, damit Nutzer die Angaben selbst überprüfen können.
Drittens müssen Compliance und rechtliche Vorgaben beachtet werden. Beim Abrufen von Webinhalten sind die Nutzungsbedingungen und das Urheberrecht der Zielseiten relevant – dies gilt insbesondere für Produkte, die sich an Endnutzer richten. Viertens spielt die Stabilität eine Rolle: Bei neu eingeführten Funktionen kann es noch zu Anpassungen an Parametern oder Leistungsschwankungen kommen. Für Produktionsumgebungen ist daher eine Fallback-Strategie ratsam, beispielsweise der automatische Rückfall auf eine reine Modellantwort ohne Websuche, falls der Webabruf fehlschlägt.
Häufig gestellte Fragen (FAQ)
F1: Was ist die DeepSeek Search & Fetch API?
Hierbei handelt es sich um eine offizielle Web-Recherche-Kombination von DeepSeek. Search übernimmt die Websuche nach passenden Ergebnissen basierend auf der gestellten Frage, während Fetch den eigentlichen Textinhalt bestimmter Webseiten extrahiert. Zusammengenommen ermöglichen beide Werkzeuge es dem DeepSeek-Modell, zeitkritische Fragen präzise zu beantworten und quellenbasierte Antworten auf Grundlage echter Webseiteninhalte zu liefern.
F2: Was unterscheidet DeepSeek Search & Fetch von der manuellen Integration einer Such-API?
Eine selbst angebundene Such-API bietet mehr Flexibilität und Kontrolle, erfordert jedoch das eigene Parsing der Ergebnisse, Web-Scraping für Textinhalte und die Wartung mehrerer Drittanbieter. Die nativen Funktionen von DeepSeek sind direkt vom Anbieter integriert, arbeiten nahtloser mit dem Modell zusammen und verkürzen die Verarbeitungskette erheblich. Der Nachteil: Der Anpassungsspielraum ist auf die offiziell bereitgestellten Parameter beschränkt.
F3: Ab wann ist die DeepSeek Search & Fetch API verfügbar?
Die offiziellen Leitfäden und Ankündigungen in der Dokumentation sind bereits online, die Funktion ist also freigeschaltet. Auch APIYI hat `deepseek-search` und `deepseek-fetch` bereits integriert; sie stehen in den Gruppen „default“ und „svip“ zur Verfügung. Auf der Plattform kostet der Aufruf 0,0009 $ pro erfolgreicher Anfrage (Fehlschläge werden nicht berechnet). Die offiziellen Preise und Kontingente entnehmen Sie bitte der DeepSeek-Dokumentation und Konsole.
F4: Wie lassen sich die Web-Funktionen von DeepSeek schnell per API testen?
Folgender Ablauf empfiehlt sich für den Einstieg:
1. Besuchen Sie APIYI auf apiyi.com, erstellen Sie ein Konto und generieren Sie einen API-Schlüssel.
2. Nutzen Sie das minimalistische Beispiel aus diesem Artikel (mit `base_url` auf `https://api.apiyi.com/v1`), um einen ersten Basis-Modellaufruf mit DeepSeek durchzuführen.
3. Rufen Sie gemäß der APIYI-Dokumentation die Endpunkte `/v1/tools/search` und `/v1/tools/fetch` auf (Modellnamen: `deepseek-search`, `deepseek-fetch`).
4. Übernehmen Sie den vollständigen Function-Calling-Workflow aus dem Beispiel und ersetzen Sie die Mock-Tools durch diese beiden nativen Schnittstellen.
F5: Welche bekannten Einschränkungen gibt es bei DeepSeek Search & Fetch?
Aktuell sind die öffentlichen Informationen noch überschaubar, daher sollten einige Punkte realistisch bedacht werden: Die Aufrufkosten steigen mit dem Such- und Scraping-Umfang; Webinhalte variieren in ihrer Qualität, weshalb Quellenangaben zur Überprüfung erhalten bleiben sollten; das Crawlen von Websites unterliegt Nutzungsbedingungen und Urheberrechtsvorgaben; und kurz nach dem Start neuer Funktionen können sich Parameter noch ändern – für Produktionsumgebungen empfiehlt sich daher stets eine Fallback-Strategie.
DeepSeek Search & Fetch API: Wichtigste Erkenntnisse (Key Takeaways)
- Kerninfo: DeepSeek hat die beiden Web-Funktionen Search und Fetch offiziell freigegeben; Dokumentation und Ankündigungen sind bereits live.
- Aufgabenteilung: Search sucht nach relevanten Treffern, Fetch liest und verarbeitet den Webseiteninhalt. Beide Tools können einzeln oder kombiniert genutzt werden.
- Größter Mehrwert: Verkürzt die Retrieval-Pipeline deutlich und spart den Entwicklungsaufwand für eigene Crawler und Drittanbieter-Schnittstellen.
- Hauptzielgruppe: Entwickler von Web-basierten Q&A-Systemen, RAG-Pipelines, AI-Agenten und Recherche-Tools.
- Auf APIYI verfügbar:
deepseek-searchunddeepseek-fetchrechnen nach erfolgreichen Anfragen ab (kein Token-Verbrauch), zum Preis von 0,0009 $ pro Aufruf – fehlgeschlagene Aufrufe kosten nichts. - Preisvergleich: Mit einem Aufladebonus von 20 % für Großkunden sinkt der Preis auf 0,75 $ pro 1.000 Anfragen – inklusive Steuern auf Augenhöhe mit den offiziellen Tarifen.
- Integrationshinweis: Halten Sie sich bei Parametern an die offizielle Dokumentation und behalten Sie Kosten, rechtliche Aspekte sowie Fallback-Optionen im Blick.
- Schnellstart: In den Gruppen „default“ und „svip“ sofort einsatzbereit; ersetzen Sie in den offiziellen Beispielen einfach die Basis-URL durch die APIYI-Domain.
Fazit
Die wichtigsten Kernpunkte der DeepSeek Search & Fetch API im Überblick:
- Offizielle Schließung der Websuche-Lücke: Dank der beiden Funktionen Search und Fetch kann das DeepSeek-Modell nun direkt auf Echtzeit-Webinformationen zugreifen.
- Infrastruktur für KI-Agenten: Websuche und das Abrufen von Webseiteninhalten gehören zum Basis-Werkzeugkasten moderner Agenten. Dass dies nun nativ bereitgestellt wird, senkt die Hürde für Entwickler noch weiter.
- Erst fundiert evaluieren, dann ausrollen: Erstellen Sie zunächst einen klaren Plan bezüglich Kosten, Zuverlässigkeit, Compliance und Stabilität, bevor Sie bestehende Pipelines schrittweise umstellen.
APIYI hat deepseek-search und deepseek-fetch bereits integriert – die Abrechnung erfolgt rein erfolgsbasiert, fehlgeschlagene Aufrufe werden nicht berechnet. Für Teams, die DeepSeek bereits einsetzen, ist jetzt der ideale Zeitpunkt, dieses Feature zu evaluieren: Testen Sie Antwortqualität und Kosten zunächst mit geringem Traffic, bevor Sie über eine vollständige Migration entscheiden. Für eine schnelle Validierung empfiehlt sich APIYI über apiyi.com. Die Plattform stellt eine einheitliche, OpenAI-kompatible Schnittstelle bereit, mit der Sie DeepSeek bequem mit anderen führenden Modellen vergleichen und nahtlos zwischen ihnen wechseln können.
📚 Referenzen
- Offizielle DeepSeek-Dokumentation – Search Guide: Offizielle Beschreibung der Search- und Fetch-Funktionen
- Link:
api-docs.deepseek.com/guides/search/ -
Hinweis: Maßgeblich für Request-Methoden, Parameter und Response-Strukturen
-
Offizielle DeepSeek-Ankündigung: Die offizielle Release-Seite für dieses Update
- Link:
api-docs.deepseek.com/news/news261017/ -
Hinweis: Hintergrundinformationen zur Veröffentlichung und zur offiziellen Produktstrategie
-
Hacker News Community-Diskussion: Diskussions-Thread internationaler Entwickler zu diesem Release
- Link:
news.ycombinator.com/item?id=50138531 - Hinweis: Hilfreiche Praxiserfahrungen und Feedback aus der Entwickler-Community
Autor: APIYI-Entwicklerteam
Technischer Austausch: Teilen Sie Ihre Erfahrungen bei der Integration der DeepSeek-Websuche gerne in den Kommentaren. Weitere Integrationsanleitungen finden Sie im Dokumentationszentrum von APIYI unter docs.apiyi.com.