著者注:Google Antigravity Orchestrator の計画と実行の役割分担の仕組み、Google 公式テストにおけるクォータ24%削減・速度19%向上というデータの意味、そして単体モデルや並列エージェントとの選び方の違いを解説します。
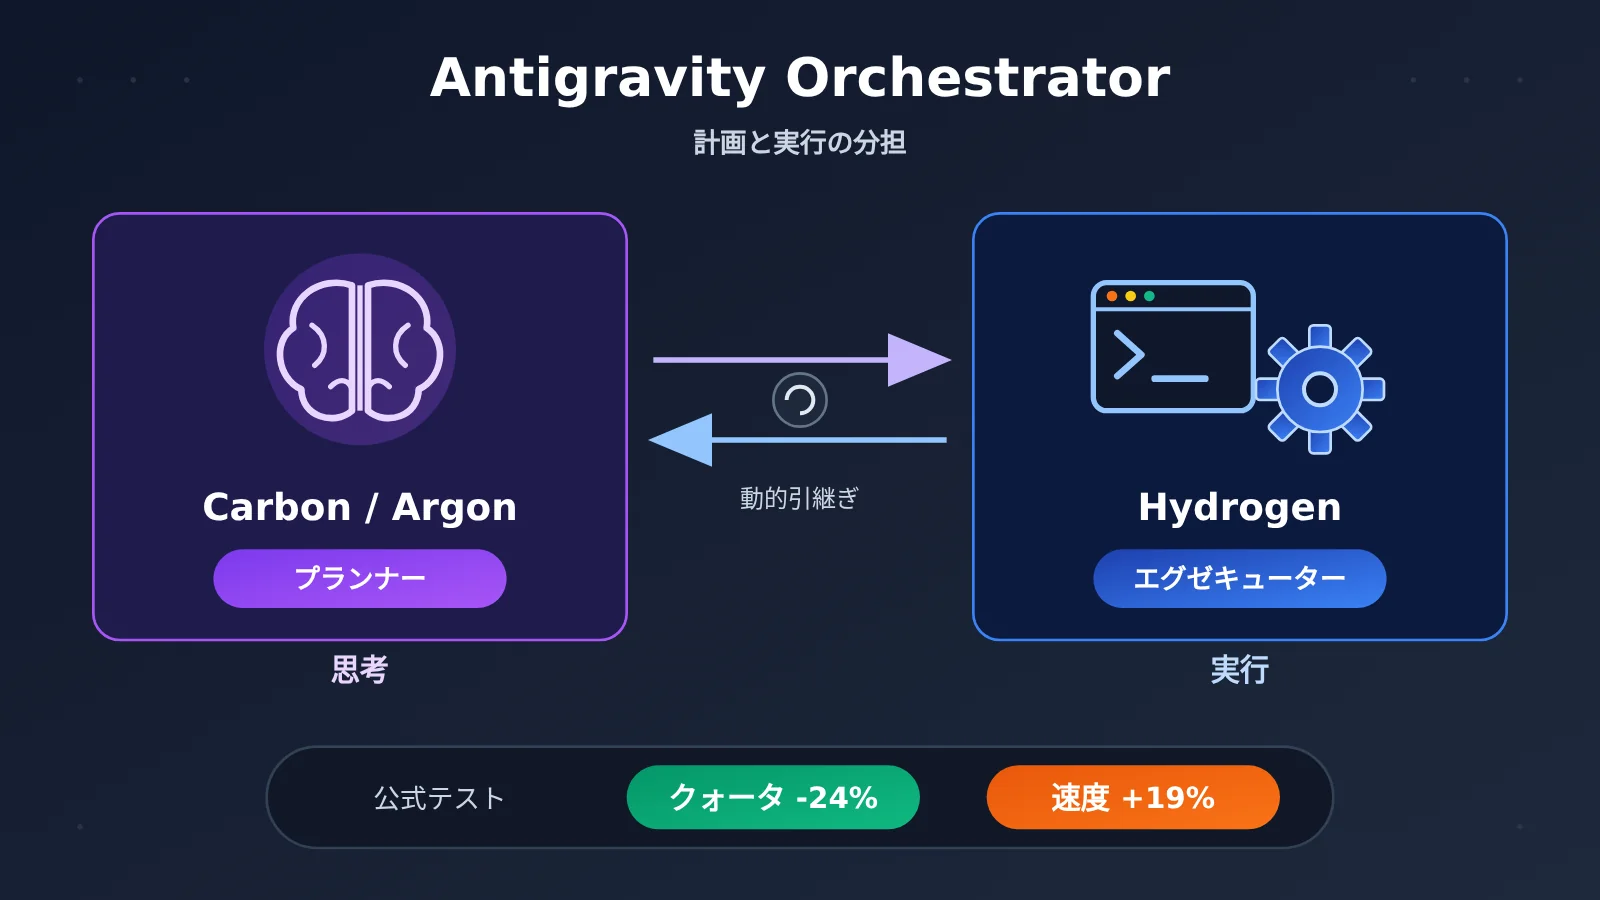
2026年11月12日、Google は Gemini 4 Hydrogen を発表し、同時に Antigravity で Orchestrator マルチモデル・オーケストレーションを導入しました。その仕組みは、同じ開発タスクの中で Carbon または Argon に計画を担当させ、Hydrogen に実行を担当させるというものです。Google 公式の比較テストでは、Orchestrator は Carbon 単体使用と比べて、クォータ消費量を平均24%削減し、完了速度を19%向上させています。
これは噂ではありません。Google Antigravity の公式ブログ、モデル選択ドキュメント、Google のリリース概要のいずれもがこの機能を確認しています。本記事では、Google Antigravity Orchestrator について現在公開されている情報をまとめます。具体的には、仕組み、テストデータの正しい読み方、プランと利用入口、そしてどのようなタスクに適しているかを扱います。
この記事の価値:読了後、自分のエンジニアリングタスクで Orchestrator、Hydrogen 単体モード、Carbon / Argon 単体モードのどれを選ぶべきか判断できるようになります。
一言まとめ:Antigravity Orchestrator は、単一のエージェントセッション内で Carbon または Argon に計画を、Hydrogen に実行を担当させます。Google 公式は、クォータと速度の両面で得られるメリットを報告しています。
to know:読む前に押さえたい5つの用語
- Planner(プランナー):タスクを分析し、方針を立て、必要に応じて再計画するモデルの役割。Orchestrator では Carbon または Argon が担当します。
- Executor(実行者):計画に沿ってコードを変更し、ツールを実行し、結果を検証する役割。Orchestrator では Hydrogen が担当します。
- エージェント:モデルとツール実行環境が協力して多段階タスクを完了するシステム。単一モデルとは異なります。
- クォータ:プラットフォームが利用可能なサービス量を制限するために用いる割り当て。クォータの削減は、実際の請求額の削減と直接同じではありません。
- Harness:モデルへの入力、ツール実行、タスクの採点を構成するテストフレームワーク。同じモデルでも、異なる Harness に入れるとスコアが変わる可能性があります。
Google Antigravity Orchestrator の主要情報早見表
| 情報項目 | 詳細 |
|---|---|
| 公開日 | 2026年11月12日、Gemini 4 Hydrogen と同時に発表 |
| 発表元 | Google(Antigravity チーム、Google DeepMind モデル) |
| 中核メカニズム | 単一のエージェントセッション内で、Planner と Executor が動的にハンドオフ |
| 選択可能なモード | Orchestrator(Carbon)、Orchestrator(Argon)。実行モデルはいずれも Hydrogen |
| 公式テスト結果 | Carbon 単体使用時と比較:クォータ消費量は平均 -24%、完了速度は +19%、タスク成功のパフォーマンスは Carbon とほぼ同等 |
| 提供範囲 | Google AI Ultra では2つのモードを利用可能。条件を満たす Google AI Pro では Argon モードを利用可能 |
| 思考設定 | 固定構成で、思考レベルを個別に調整することはできません |
Google が Antigravity Orchestrator を発表した理由
実際のソフトウェア開発タスクには、通常さまざまな作業が含まれます。まずコードベースと依存関係を理解し、次にどこをどう変更するかを決め、その後ファイルを一括編集してビルドとテストを実行し、最後に結果を確認します。これらのステップでは、要求される推論能力が大きく異なります。「どう変更するか」を決めるには深い判断力が必要で、「方針に沿って10個のファイルを変更し、テストを実行する」には速度、正確な編集、ツール呼び出しの安定性がより重要になります。
タスク全体を Carbon のような高性能推論モデルに任せると、実行フェーズの大量の反復作業も高性能モデルのペースとクォータで消費され、タスク時間とクォータ消費が増大します。軽量モデルだけを使うと、設計や難解なエラーで判断を誤り、手戻りが発生する可能性があります。
Hydrogen の位置づけは、まさにこの部分を埋めるものです。Google は Hydrogen を、高効率な日常プログラミングおよびエージェント実行モデルと定義し、正確な編集、多数のツール呼び出し、ツール失敗後に戦略を調整する能力を強調しています。また、マルチモデルシステムにおいて実行者または検証者として機能できると明言しています。Orchestrator は、この役割分担を製品化したものです。高コストなモデルは、判断が最も必要な工程にのみ使われます。
Antigravity Orchestrator の仕組み:Carbon が思考し、Hydrogen が実行する
Google Antigravity の公式ドキュメントによれば、Orchestrator はリクエストを受け取ったときに難易度を一度だけ判断して、1つのモデルに最後まで処理させる、ということはしません。同じタスクの中で、計画モデルと実行モデルを繰り返し切り替えます。
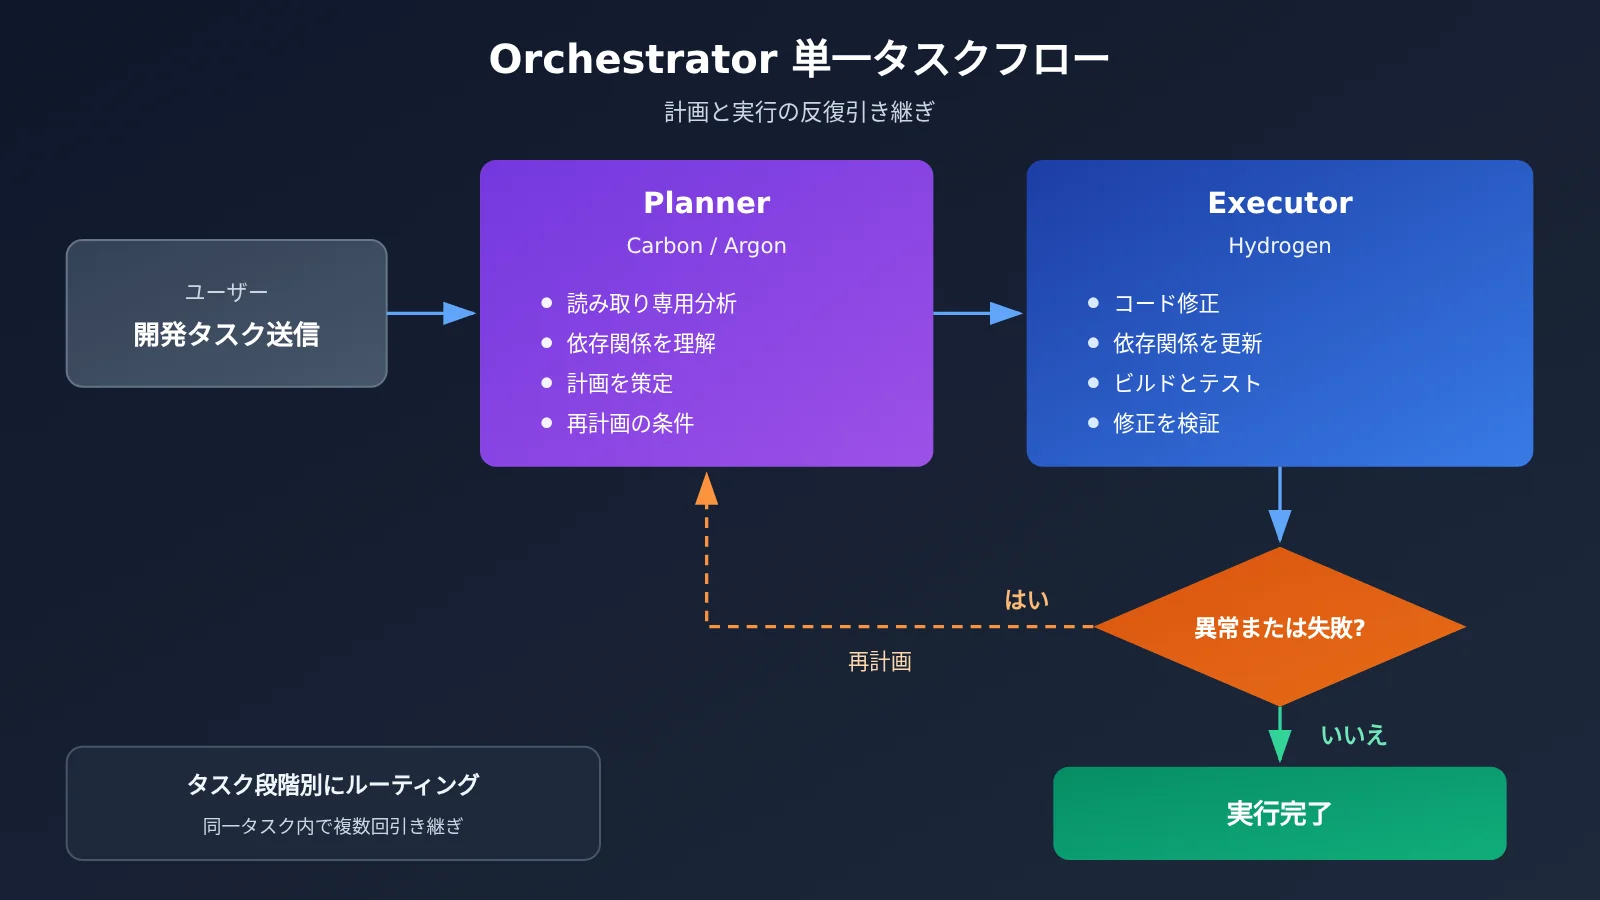
Orchestrator の5ステップのワークフロー
公式ドキュメントで挙げられている依存関係のアップグレードを例にすると、一連の流れはおおよそ次のようになります。
- コードベースを分析:Carbon(または Argon)が読み取り専用でコード構造と依存関係を洗い出します。
- 方針を策定:Planner が変更範囲と手順を決め、あわせてどのような条件で再計画が必要になるかを設定します。
- コードを変更:Hydrogen が実際の編集と依存関係のアップグレードを担当します。
- テストを実行:Hydrogen がビルドとテストを実行し、変更が有効かどうかを検証します。
- 結果を検証:合格すれば結果を確認してタスクを終了します。複雑なエラーに遭遇した場合は Planner に戻します。
Orchestrator が再計画を行うトリガー条件
公式ドキュメントには、制御を Planner に戻すケースがいくつか挙げられています。検証ステップが2回連続で失敗した場合、インターフェースの挙動が期待と一致しない場合、実装中に元の方針がカバーしていなかった設計上の選択が現れた場合です。Planner は再判断したうえで方針を調整し、再び Hydrogen に渡して以降の変更と検証を続行します。
この仕組みが肝心です。実行モデルはひたすら盲目的にリトライするのではなく、「元の計画の範囲を超えた」時点で速やかに意思決定権を上位に返し、高性能モデルは重要な節目にだけ介入します。
動的なハンドオフとワンショットのモデルルーティングの違い
よくある「モデルルーティング」は、リクエストの入口で一度だけ分類を行います。簡単なタスクは小型モデルに、複雑なタスクは大型モデルに割り当て、その後は変わりません。Orchestrator との違いは、1つのタスクの内部で何度もハンドオフが行われ、計画と実行を異なるモデルが担い、しかも実行の途中でいつでも計画段階に戻り得る点にあります。ルーティングするのはタスクの段階であり、リクエスト全体ではありません。
Orchestrator 公式テスト:24% のクォータと 19% の速度は何を意味するのか
以下のデータはすべて、Google 公式のターミナルタスク比較テストに基づくもので、「Orchestrator」と「Carbon 単体使用」を比較した結果です。
| 指標 | Carbon 単体と比較した Orchestrator | 正しい理解のしかた |
|---|---|---|
| タスク成功の実績 | Carbon 単体使用に近い | Carbon を超えたとは主張しておらず、「近い」とのみ述べている |
| クォータ消費 | 平均で 24% 削減 | Antigravity のクォータの変化であり、請求額が必ず 24% 減るわけではない |
| 完了速度 | 19% 向上 | 公式テストタスクの平均結果であり、すべてのタスクが 19% 速くなるわけではない |
なぜマルチモデルの分業でクォータを節約できるのか
その効果は主に実行フェーズから生まれます。コード編集、依存関係の更新、テストの繰り返し実行といったステップは呼び出し回数が多く、コンテキストも長くなるため、すべてを Carbon に任せるとハイエンドモデルが大量に繰り返し呼び出されてしまいます。Hydrogen に任せれば、Carbon は冒頭の計画と途中の再計画だけを担当するようになり、高度な推論の呼び出し量は自然と減少します。API の価格からも両者のコスト差が見えます。2026年11月13日時点で、Google AI Studio の公式標準価格では、Hydrogen の入力と出力はそれぞれ100万トークンあたり1.50ドルと7.50ドルです。Carbon は2026年11月30日までは100万トークンあたり2ドルと10ドルで、公式ページには12月1日から4ドルと20ドルに調整されると記載されています。
注意すべきなのは、上記が API 価格であるのに対し、Orchestrator は Antigravity のサブスクリプションクォータ体系の中で動作しており、両者の計量方法は異なるという点です。API 価格から Orchestrator の「実際のコスト」を推測することはできません。
この数字が開発チームにとって意味するもの
チームにとって、AI プログラミングツールの効率を評価する際には、単発の回答品質だけを見るのではなく、タスク成功率・クォータ消費・完了時間という3つの次元を同時に観察すべきです。Orchestrator の公式結果は、成功率がほぼ変わらない前提下で、後者2つが改善されたことを示しています。これはチームにとって参考になる考え方を提供します。すなわち、最強のモデルだけに注目するのではなく、「計画の品質」と「実行のスループット」を分けて評価するということです。
💡 データの注記:本節の効率に関する数値はすべて Google 公式の比較テストに帰属するもので、独立した第三者による再テストはまだ行われていません。自社の業務で「計画モデル+実行モデル」の分業効果を検証したい場合は、APIYI apiyi.com を通じて同じ Key で異なるグレードのモデルを呼び出し、独自の対照実験を設計してみてください。
Orchestrator と独立モデル/並列 Agent の比較
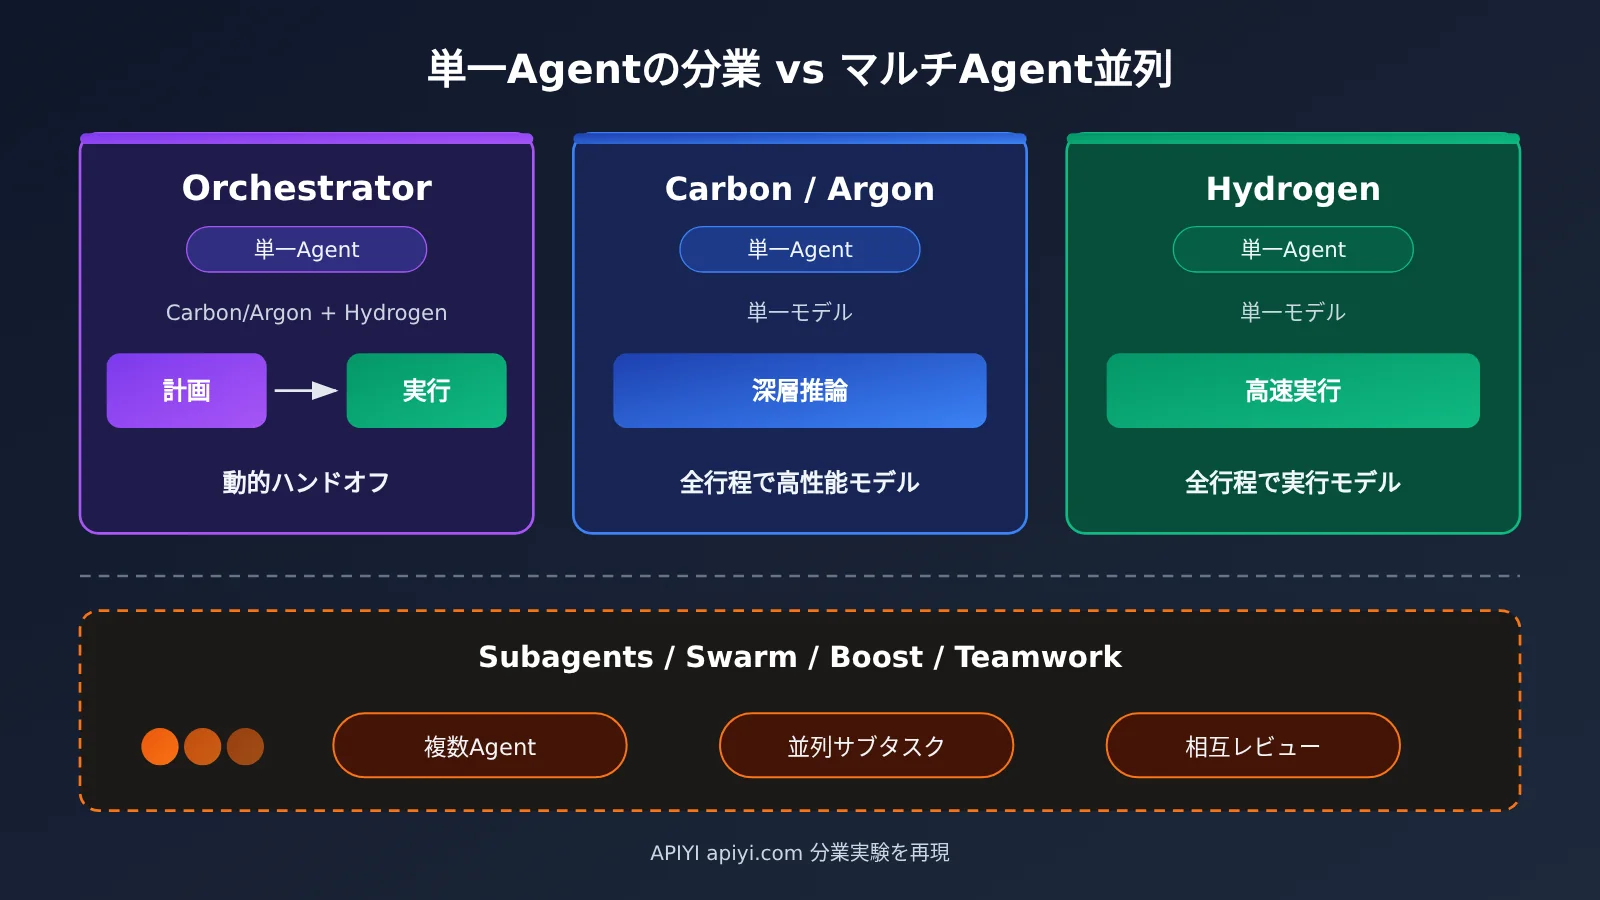
| 方式 | Agent 数 | モデルの使い方 | 思考レベル | 適した作業の複雑さ |
|---|---|---|---|---|
| Orchestrator | 1 | Carbon/Argon が計画し、Hydrogen が実行、自動で切り替え | 固定構成 | 中程度の複雑さ、多段階タスク |
| Carbon / Argon 単体 | 1 | 単一のハイエンドモデルで全工程を完了 | カスタマイズ可能 | 各ステップで深い推論が必要 |
| Hydrogen 単体 | 1 | 単一の実行モデルで全工程を完了 | カスタマイズ可能 | 要件が明確な定型タスク |
| Subagents / Swarm など | 複数 | 複数の Agent が並列処理または相互レビュー | 構成による | 分割可能な大規模並列作業 |
Carbon 単体の比較分析:Carbon は複雑な判断で優位性を保ちますが、実行フェーズの反復作業でも高性能モデルのクォータと時間を消費します。これに対し、Orchestrator は計画+実行という一般的なエンジニアリング作業の多くで、同等に近い成功率を維持しつつクォータ消費を抑えられます。
Hydrogen 単体の比較分析:Hydrogen は高速で編集も正確ですが、元の計画でカバーされていない設計上の選択に直面すると、より強力なモデルによるバックアップがありません。要件が明確で、何度も意思決定する必要がないタスクでは、依然として最も直接的な選択肢です。
並列マルチ Agent の比較分析:Google は、Orchestrator が1つのセッション内で1つの Agent だけを維持し、複数モデルの引き継ぎによって異なるフェーズを完了すると明確に説明しています。複数の Agent で同時にサブタスクを処理したり、相互レビューさせたりする必要がある場合は、Subagents、Swarm、Boost、Teamwork などの機能を選ぶべきです。両者は異なる問題を解決するものです。一方は「単一タスク内部でどう分担するか」、もう一方は「Agent の数を増やすかどうか」です。
Antigravity で Orchestrator を使う方法
Orchestrator モードとプランの対応関係
| モード | プランニングモデル | 実行モデル | 利用可能なプラン |
|---|---|---|---|
| Orchestrator(Carbon) | Gemini 4 Carbon | Gemini 4 Hydrogen | Google AI Ultra |
| Orchestrator(Argon) | Gemini 4 Argon | Gemini 4 Hydrogen | 対象となる Google AI Pro、Ultra |
| Hydrogen 独立モデル | — | Gemini 4 Hydrogen | Pro、Ultra ユーザーへ順次開放 |
Antigravity App では、対話入力欄の近くにあるモデル選択メニューを開き、Orchestrator(Carbon)または Orchestrator(Argon)を選択します。Antigravity CLI では、公式の例は次のとおりです(以下の構文は公式ドキュメントからの引用で、本記事ではローカルでの実測は行っていません):
# 現在のアカウントで利用可能なモデルを確認
agy models

# セッションに入った後、/model で Orchestrator を選択

# 起動時に直接指定することもできます
agy -p "Add input validation to the signup form and run the tests." --model "Orchestrator (Argon)"
Orchestrator は固定の思考設定を使用しており、Low、Medium、High、Extra などの段階を個別に設定できない点に注意してください。思考段階をカスタマイズしたい場合は、単体モデルに切り替えてください。また、公開当日には、モデルオプションは表示されるものの呼び出しに失敗する、アカウントによって開放時期が異なるといった報告がありました。こうした状況は段階的なリリースに関係している可能性が高いため、遭遇した場合はしばらくしてから再試行してください。
独自の Agent で「計画」と「実行」の分業を再現する
Orchestrator は Antigravity の製品機能ですが、「強力なモデルが計画を立て、高速なモデルが実行し、2回失敗したら計画に差し戻す」という考え方は、自分の Agent の中でも完全に実装できます。以下は OpenAI 互換インターフェースを使った最小限のサンプルです。モデル名は利用するプラットフォームのモデル一覧に従ってください:
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

PLANNER = "your-reasoning-model"   # 計画用モデル。プラットフォームのモデル一覧に従う
EXECUTOR = "your-fast-model"       # 実行用モデル。プラットフォームのモデル一覧に従う

def ask(model, system, user):
    r = client.chat.completions.create(model=model, messages=[
        {"role": "system", "content": system}, {"role": "user", "content": user}])
    return r.choices[0].message.content

plan = ask(PLANNER, "你是架构师,输出分步实施方案。", "为注册表单增加输入校验")
print(ask(EXECUTOR, "严格按方案执行,只输出代码改动。", plan))
「2回失敗したら再計画」を含む完全なサンプルを見る
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER = "your-reasoning-model"
EXECUTOR = "your-fast-model"
MAX_FAILS = 2  # Antigravity のドキュメントを参考:検証が2回連続で失敗したら計画に差し戻す

def ask(model: str, system: str, user: str) -> str:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    return r.choices[0].message.content

def run_tests(patch: str) -> tuple[bool, str]:
    """独自のビルド・テストロジックに置き換えてください。戻り値は (合格したか, ログ)"""
    raise NotImplementedError

def orchestrate(task: str, max_replans: int = 3) -> str:
    plan = ask(PLANNER, "你是规划者,输出分步方案及重新规划条件。", task)
    for _ in range(max_replans):
        fails, log = 0, ""
        while fails < MAX_FAILS:
            patch = ask(EXECUTOR, "你是执行者,严格按方案修改代码。",
                        f"方案:\n{plan}\n上次测试日志:\n{log}")
            ok, log = run_tests(patch)
            if ok:
                return patch
            fails += 1
        # 連続失敗のため、計画モデルに返して再判断させる
        plan = ask(PLANNER, "执行连续失败,请根据日志修订方案。",
                   f"原任务:{task}\n原方案:{plan}\n失败日志:{log}")
    raise RuntimeError("多次重新规划后仍未通过验证")
🚀 すぐに試すためのヒント:こうした「計画 + 実行」型のプロトタイプを組み立てるときは、APIYI apiyi.com で無料のテスト枠を取得するのがおすすめです。1つの APIキーで OpenAI、Claude、Gemini などの主要モデルを呼び出せ、PLANNER と EXECUTOR の切り替えは文字列を1つ変えるだけ。異なる組み合わせをすばやく比較できます。
Antigravity Orchestrator の影響分析:どの開発タスクに最適か
開発者への影響
- 通常の機能開発:計画・実装・テストという三段階の役割分担が明確で、Orchestrator の最も典型的なシナリオです。
- 複数ファイルのバグ修正:Planner が根本原因を特定し、Hydrogen が複数ファイルを修正してテストを実行・検証します。失敗した場合は判断を仰ぐために戻します。
- 中程度の複雑さのリファクタリング:方針は計画モデルが担い、具体的な大量の変更は実行モデルに任せることで、ハイエンドモデルが機械的な編集に没頭するのを避けられます。
- クォータ管理がより主体的に:サブスクリプションユーザーにとって、日常的なタスクを Orchestrator で処理すれば、より多くの枠を本当に深い推論が必要な作業に回せます。
業界への影響
- 「プランナー+エグゼキューター」が製品化モデルに:モデルベンダーは、ユーザー自身に編成を任せるだけでなく、マルチモデル連携を開発ツールに直接組み込むようになりました。
- 評価指標の多様化:成功率だけでなく、クォータ消費量や完了時間が、Agent ツールの比較により多く登場するようになります。
Orchestrator のシナリオ選定のヒント
| タスク種別 | 推奨モード | 理由(Google 公式の選定指針に基づく) |
|---|---|---|
| 計画・開発・テスト・手戻りという多段階の連携を伴う通常のエンジニアリング | Orchestrator | ハイエンドモデルは重要な節目でのみ介入 |
| 複雑な分散システムのアーキテクチャ、リポジトリをまたぐ移行 | Carbon または Argon の独立モード | 各重要ステップで深い推論が必要 |
| 依存関係のアップグレード、テスト作成、簡単なリファクタリング、スクリプトとドキュメント | Hydrogen の独立モード | 要件が明確で、実行効率を優先 |
| 分割して並列化できる大規模作業、相互レビューが必要な作業 | Subagents、Swarm など | 複数のモデルではなく複数の Agent が必要 |
よくある質問(FAQ)
Q1:Google Antigravity Orchestrator とは何ですか?
Antigravity のマルチモデル編成機能です。1つのエージェントセッションの中で、Carbon または Argon がプランナー(計画担当)を、Hydrogen がエグゼキューター(実行担当)を担い、実行状況に応じて動的に引き継ぎが行われます。
Q2:Orchestrator と Swarm、Subagents の違いは何ですか?
Orchestrator は常にエージェントが1つだけで、変わるのは各段階で使うモデルです。Swarm や Subagents などは複数のエージェントを有効にして、サブタスクの並列処理や相互レビューを行います。分割できる大規模な作業に向いています。
Q3:24% のクォータ節約は、請求額が 24% 減るのと同じですか?
同じではありません。24% は Google 公式の比較テストにおける Antigravity のクォータ消費量の平均変化で、比較対象は Carbon を単独で使用した場合です。実際の費用はサブスクリプションプラン、タスクの種類、リトライ回数などによって変わり、請求額に直接換算することはできません。
Q4:公式テストは Terminal-Bench 4.0 と 4.1 のどちらを使っていますか?
2つの公式発表で表記が一致していません。Google のリリース総覧と中国語の公式公告では 4.0、Antigravity の特集公告では 4.1 と記載されています。両者が示す改善数値は同じなので、本記事では統一して「公式ターミナルタスク比較テスト」と呼びます。
Q5:Antigravity のサブスクリプションがない場合、同様の「計画と実行の分離」を体験するには?
自分のエージェントに本記事のサンプルどおり実装すれば体験できます。APIYI apiyi.com で登録すると無料のテスト枠が付与され、OpenAI 互換インターフェースが利用できます。base_url を `https://api.apiyi.com/v1` に設定し、計画用モデルと実行用モデルをそれぞれ指定します。
Q6:Orchestrator にはどのような既知の制限がありますか?
1つ目は思考レベル(thinking レベル)が固定で、単独では調整できないこと。2つ目は Pro ユーザーは現状 Argon モードしか使えないこと。3つ目は効率のデータが公式テストに由来するもので、独立した再測定はまだ行われていないこと。4つ目は提供開始の初期に、一部のアカウントでモデルは表示されるものの呼び出しに失敗する事象が発生したことです。まず管理しやすい環境でモデルの組み合わせを比較したい場合は、APIYI apiyi.com の従量課金方式が小規模な試験に便利です。
Google Antigravity Orchestrator の要点(Key Takeaways)
- 核心的な定義:単一の Agent セッション内で、Carbon / Argon が計画を立て、Hydrogen が実行し、動的にハンドオフする。
- 重要な仕組み:検証が2回連続で失敗した場合などは、計画モデルに処理を戻して再判断させる。
- 公式データ:Carbon 単独の場合と比べて、クォータ -24%、速度 +19%、成功率はほぼ同等。
- 正しい解釈:クォータの消費は請求額とイコールではない。ベンチマークのバージョン表記が2つの告知で食い違っている。
- 利用条件:Ultra では2つのモードが使える。条件を満たす Pro は Argon モードを利用可能。
- 始め方:自前の Agent は APIYI apiyi.com の統一インターフェース経由で、役割分担の考え方を再現できる。
まとめ
Google Antigravity Orchestrator の要点は次のとおりです。
- 置き換えではなく役割分担:安価なモデルで高価なモデルを置き換えるのではなく、Carbon / Argon が判断を担い、Hydrogen が実行を担います。
- 動的ハンドオフ:実行中に異常が起きると計画フェーズに戻ります。これが、一度きりのモデルルーティングとの決定的な違いです。
- 公式のメリット:Carbon に近い成功率を前提に、公式テストではクォータが24%減り、速度が19%向上しました。
- 複雑さに応じた選択:通常の多段階エンジニアリングには Orchestrator、深いアーキテクチャには Carbon / Argon、明確な日常タスクには Hydrogen を使います。
ほとんどの日常的な開発タスクでは、Orchestrator は品質とクォータの両立を図る合理的なデフォルト選択肢です。同じ考え方を自分のプロダクトに応用したい場合は、APIYI apiyi.com を通じてさまざまなモデル構成の効果をすばやく検証することをおすすめします。同プラットフォームでは無料クォータとマルチモデル統一インターフェースを提供しています。
📚 参考資料
- Google Antigravity 公式ブログ:Gemini 4 Hydrogen と Orchestrator
- リンク:
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity -
説明: Orchestrator のリリース告知と、24% / 19% という公式テストデータ。ベンチマークは Terminal-Bench 4.1 としてマークされています
-
Google Antigravity ドキュメント:モデルの選択 / Orchestrator
- リンク:
antigravity.google/docs/models -
説明: Planner / Executor の仕組み、再計画が行われる条件、CLI の例とモデル選択の推奨事項
-
Google 公式ブログ:Introducing Gemini 4 Hydrogen
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen -
説明: Hydrogen のリリース概要。同じ比較結果が、ここでは Terminal-Bench 4.0 としてマークされています
-
Google 中国語公式発表:Gemini 4 Hydrogen
- リンク:
china.googleblog.com/2026/11/gemini-4-hydrogen.html -
説明: 中国語でのリリース情報。ベンチマークのバージョンも同様に 4.0 としてマークされています
-
Google AI Studio 価格ページ:Gemini シリーズの API 価格
- リンク:
aistudio.google.com/docs/pricing -
説明: Hydrogen、Carbon、Argon の標準 API 価格と、価格改定のタイミング
-
Antigravity のプランと共有クォータの説明
- リンク:
antigravity.google/blog/changes-to-antigravity-plans - 説明: サブスクリプションプランとクォータ体系
著者: APIYI 技術チーム
技術交流: APIYI ウェブサイトのトップページからお問い合わせください。その他の資料は docs.apiyi.com のドキュメントセンターでご覧いただけます