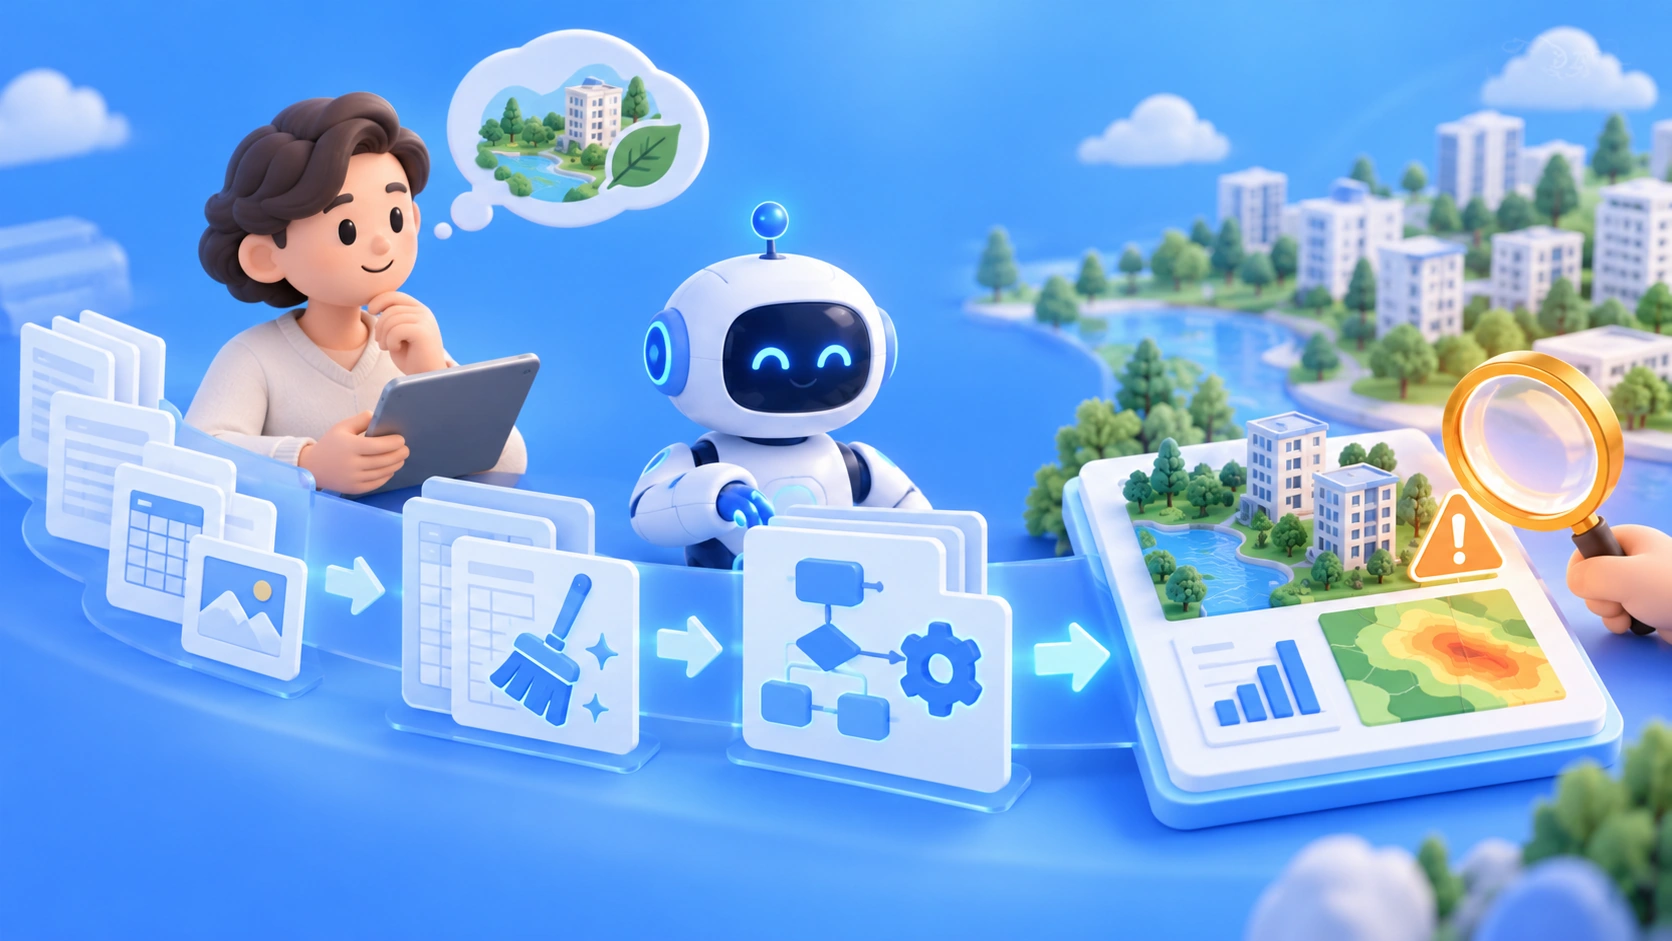
著者注:Heimstaden の環境リスク評価プロジェクトを例に、開発者ではない人が Codex を使ってデータの発見、クリーニング、処理フローの構築に取り組む際の人と AI の役割分担を解説します。また、なぜ方法論に関する判断と人間による検証を、領域の専門家が担い続ける必要があるのかを説明します。
業界に詳しくても、コードは書けないというビジネスアナリストは少なくありません。「データが数十の公開ソースに散在し、形式もばらばら」というプロジェクトに直面したとき、従来は技術チームの対応を待つか、外部コンサルタントに依頼するしかありませんでした。この記事では、公開されている実際の事例を手がかりに、開発者ではない人が Codex を使ってデータ処理フローを構築する際の、人と AI の役割分担を紹介します。特に、方法論の判断と人間による検証という、譲れない2つの原則に焦点を当てます。
これは「AI がすべてを代わりにやってくれる」という宣伝記事ではありません。 この事例には目を引く数字がある一方、公開されていない詳細も数多くあります。分かっている事実と推測を区別して説明します。
この記事で得られること:データプロジェクトのどの工程をプログラミングエージェントに任せるのが適しているか、また、どの責任を自分で担い続けるべきかが分かります。さらに、単発の分析を、チームが継続的に改善できる能力として蓄積する方法も学べます。
開発者ではない人が Codex でデータ処理フローを構築する際のポイント
2026 年 11 月 3 日、OpenAI は欧州の住宅不動産事業者 Heimstaden の顧客事例を公開しました。その中で紹介されている環境サステナビリティアナリストの Julia Erlandsen は、ソフトウェア開発の経験がないにもかかわらず、Codex を活用して資産ポートフォリオ全体の環境リスク評価を完了しました。以下の表に、この事例から特に参考になるポイントをまとめます。
| ポイント | 事例の内容 | 読者にとっての価値 |
|---|---|---|
| 課題の性質 | 情報は存在するものの、さまざまな公開情報源や形式、データセットに分散している | エージェントの導入に適した「データ分散型」のプロジェクトを見極められる |
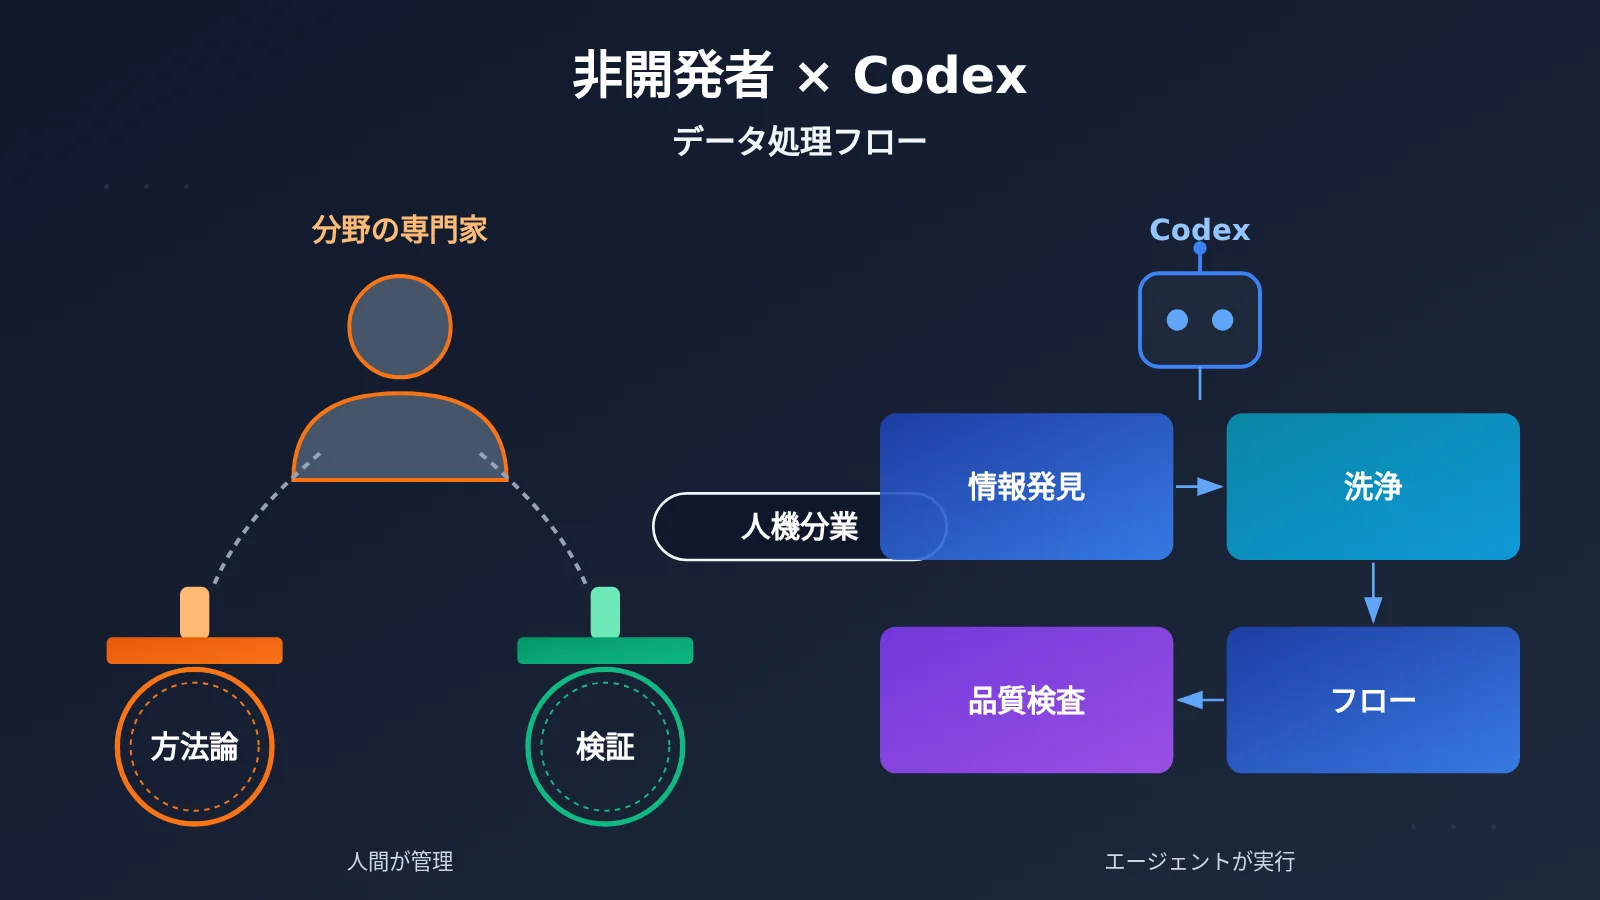
| エージェントの担当 | データの発見、クレンジングと標準化、品質チェック、再現可能な処理フローの開発 | 任せられる工程が明確になる |
| 専門家の担当 | 方法論と検証は一貫してアナリストが管理する | 結論の信頼性を確保できる |
| 処理規模 | 20,112 件の資産を評価し、600 万行以上の利用可能なデータを生成 | 開発者でなくても大規模なデータを扱えることがわかる |
| 長期的なメリット | 一度きりのプロジェクトが、外部コンサルタントに頼らず繰り返し実行できる能力に変わる | 方法論を自分たちで管理し、その後も改善を重ねられる |
Codex を使ったデータ処理フローにおける「役割分担」
この事例の最も重要なポイントは、短い一文に集約されています。Codex がデータの発見、クレンジング、標準化、品質チェック、再現可能な処理フローの開発を支援する一方、Julia は方法論と検証の管理を手放しませんでした。ここには明確な境界線があります。「データをどう整え、実行可能なフローにするか」はエージェントに任せられますが、「どの基準でリスクを判断し、結果が正しいか」は人間が判断する必要があります。
この境界が重要なのは、環境リスク評価が最終的に気候リスクの評価、報告に関する法令遵守、投資判断に役立てられるためです。方法論がエージェントのデフォルトの仮定に基づいていれば、アナリストは投資家や監査担当者に結論の根拠を説明できません。Julia 自身の言葉も、この点を裏付けています。「私たちは今、この方法論を自分たちのものとして持っており、今後も自分たちで発展させていけます」。ここでいう「自分たちのもの」とは、単に結果の表を手にしているだけでなく、評価のロジックを理解し、管理しているという意味です。
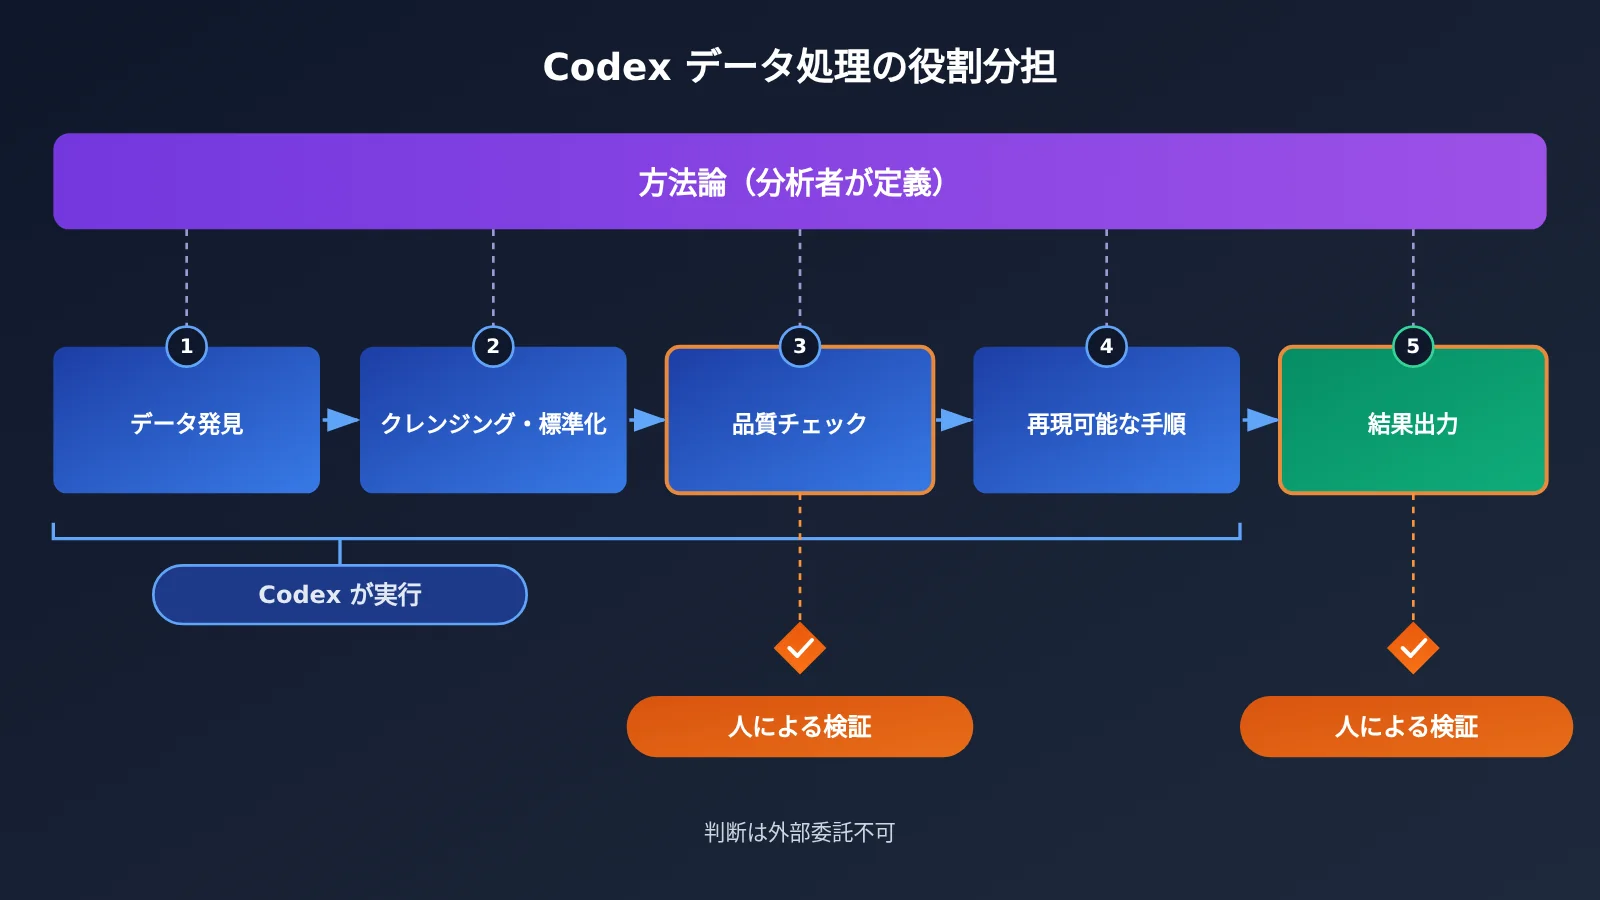
非開発者がCodexでデータ処理を行う際の役割分担の原則
事例における役割分担を整理すると、より汎用的な分担表が作れます。なお、「事例での詳細開示」欄は、原文に詳細が記載されているかどうかを示しています。表中の推奨事項は、一般的なデータプロジェクトの経験に基づいて整理したものであり、Heimstadenの実際の運用を示すものではありません。
| 工程 | コーディングエージェントが担当 | 専門家が担う | 事例での詳細開示 |
|---|---|---|---|
| データの探索 | 候補となるデータソースを検索・一覧化し、フィールドの意味を説明する | 情報源が信頼できるか、評価目的に適しているかを判断する | 具体的なデータソースは非開示 |
| クレンジングと標準化 | 形式、単位、エンコーディングを統一し、座標と住所を照合する | 欠損値や矛盾する値の扱いを決める | ルールは非開示 |
| 品質チェック | 自動チェックを作成し、異常の一覧を出力する | 「何を異常とするか」を定義し、サンプルを抽出して確認する | 方法とエラー率は非開示 |
| 処理フローの構築 | 各ステップを繰り返し実行できる処理フローにまとめる | フローのロジックが方法論と一致しているか確認する | 「再実行可能」とのみ説明 |
| 方法論と結論 | 指示に従って計算を実行する | 評価フレームワーク、重み、閾値を設定し、結果に責任を持つ | アナリストが担うと明記 |
この表から、役割分担に関する5つの原則が見えてきます。
- 実行は任せても、判断は任せきりにしない。 エージェントは、曖昧な「データを整理して」という依頼を具体的な操作に落とし込むのが得意です。しかし、「この閾値は妥当か」という問いに答えられるのは、業界を理解している人だけです。
- 方法論は先に文書化してから、エージェントに渡す。 評価フレームワークは、会話の中に散らばった断片的な指示ではなく、自分自身で明確に説明できる文書にしておきましょう。
- 検証には独立した視点を持つ。 フローを作成したエージェントに自分の成果物もチェックさせるだけでは、見つけられる問題は限られます。人によるサンプル確認や外部の基準との照合は省けません。
- フローは繰り返し実行できるようにする。 一度きりの手作業による結果は改善を重ねられません。再実行できるフローこそが資産になります。
- 結論の責任は常に人が持つ。 Heimstadenの全社的なAI戦略でも、従業員が意思決定の確認と承認を担い、AIが生成した内容は発信前に人がチェックすることを重視しています。
🎯 技術的なアドバイス:データ処理の中で、非構造化テキストの記述をリスクレベルに分類するなど、大規模言語モデルを呼び出す必要がある場合は、APIYI apiyi.com を通じて、同じインターフェースから複数の主要モデルを利用できます。複数のモデルで同じサンプルを照合すれば、特定のモデルに特有の系統的な偏りを発見しやすくなります。これ自体が、低コストで実施できる検証手段の一つです。
開発者以外のための Codex データ処理フロー入門
この事例では、Julia がどの形態の Codex を使ったのか、具体的にどうやり取りし、どのようなワークフローで進めたのかは明らかにされていません。そのため、以下の手順は事例を再現したものではなく、事例の役割分担を参考に、開発経験のないアナリスト向けにまとめた始め方です。ここではコードを使わず、各ステップでエージェントに何を渡し、自分で何を確認すべきかをチェックリストで説明します。
ステップ1:自然言語で評価方法の説明を書く
作業を始める前に、評価の考え方を文書にまとめましょう。ファイル名は、たとえば methodology.md とします。評価の目的、必要な指標、各指標の計算方法、リスクレベルを分類するしきい値、欠損データの処理方針を少なくとも盛り込みます。この文書は、評価方法を自分が決めたことを示す拠り所になります。今後エージェントにフローの変更を依頼する際も、毎回この文書を基準にしましょう。
ステップ2:データの調査はエージェントに任せ、最終判断は自分で行う
評価の目的をエージェントに伝え、考えられるデータソース、それぞれに含まれるフィールド、更新頻度、わかっている制約を列挙してもらいます。そのうえで、各ソースに信頼性があるか、対象範囲が自分の資産の分布に合っているかを一つずつ判断しましょう。ダウンロードした元データは専用の raw ディレクトリに保存し、決して変更せず、その後の処理はすべてコピーを使って行うようエージェントに指示することをおすすめします。
ステップ3:クレンジングと標準化では「すべての変更を記録する」
住所の統一形式、座標系、単位、日付形式など、標準化のルールをエージェントに伝え、処理フローを作成してもらいます。重要なのは、各変換ステップで変更記録を出力させることです。たとえば、削除した行数、統合したレコード数、マッチングできなかったレコードなどを記録します。こうすることで、コードを読み解かなくても、記録から処理が妥当かどうかを判断できます。
ステップ4:品質チェックを2段階で行う
第1段階はエージェントに任せます。重複値、欠損値、値の範囲外、資産の照合失敗などを自動でチェックする仕組みを作り、異常の一覧を出力してもらいます。第2段階はあなた自身が担当します。結果から一部の資産をランダムに抽出し、慣れた方法で手作業で照合してください。抽出率と許容基準はあらかじめ方法論ドキュメントに明記し、validation_log のような表にも別途記録しておきます。
ステップ5:繰り返し実行できるプロセスにする
結果が信頼できると確認できたら、一連の作業をワンクリックで再実行できるプロセスにまとめ、操作手順書を作るようエージェントに依頼します。手順書は、同じくコードがわからない同僚でも、そのとおりに実行できる内容にしましょう。ここまでできて初めて、プロジェクトは「一度きりの分析」から「再利用できる仕組み」になります。
| 段階 | エージェントへの入力 | 必ず確認する成果物 | よくあるリスク |
|---|---|---|---|
| 方法論 | 評価目標と業界知識 | 自分で書いた方法論ドキュメント | 指標の定義が曖昧で、後から何度も手戻りが発生する |
| データの発見 | 目標と対象範囲 | 情報源の一覧と限界に関する説明 | 信頼性の低いデータや古いデータを取り込む |
| クリーニングと標準化 | 標準化ルール | 各ステップの変更記録 | データが黙って削除され、結果がきれいに見えてしまう |
| 品質チェック | 異常の定義と抽出率 | 異常一覧と手作業での抽出チェック結果 | 自動チェックだけを信じ、系統的なエラーを見逃す |
| プロセスの定着 | 実行と更新の要件 | 再実行可能なプロセスと操作手順書 | 実行方法をエージェントしか「覚えていない」 |
🚀 クイックスタート:ステップ3や4で、各国の公開レポートに記載されたリスクの説明を解析するなど、大規模言語モデルを使ってテキストフィールドを理解する必要がある場合は、まず APIYI apiyi.com で少量のサンプルを使い、複数のモデルの出力を比較してみましょう。最も安定したモデルを選んでから本番のプロセスに組み込むことで、最初から全データを単一のモデルに委ねるリスクを避けられます。
Codexによるデータ処理フローと他の選択肢との比較
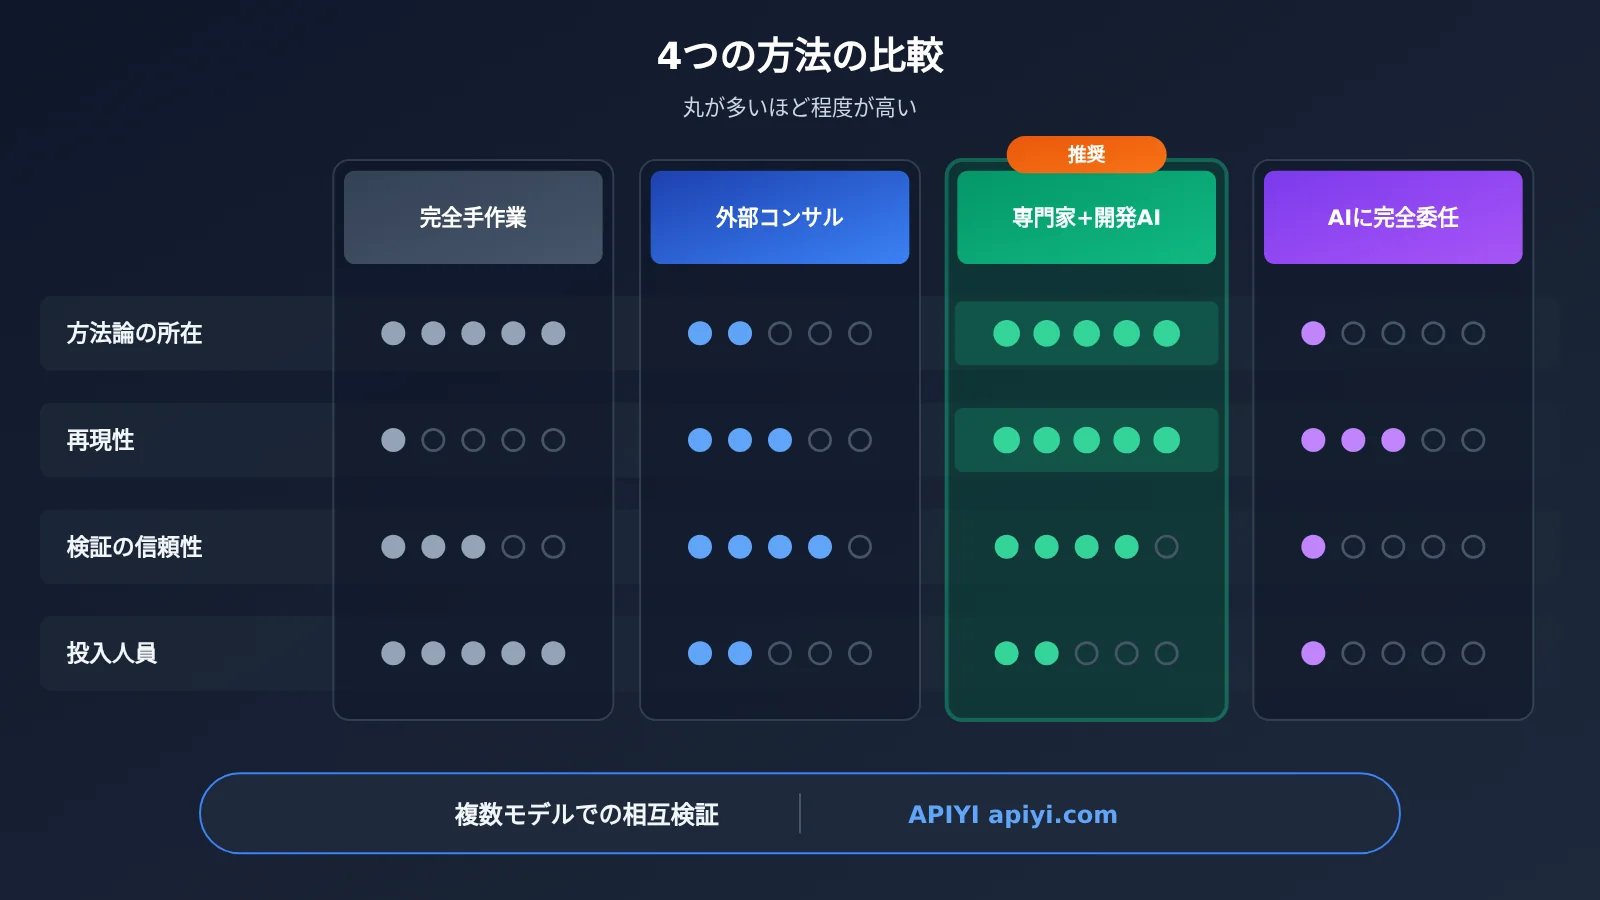
| 選択肢 | 方法論の所在 | 再現性 | 検証の信頼性 | 主な課題 |
|---|---|---|---|---|
| すべて手作業 | 専門家の手元 | 低い。再実行が難しいことが多い | 個人の注意深さに左右される | 人手の負担が大きく、事例では5人で1年かかると試算 |
| 外部コンサルタント | コンサルタントの手元に残ることが多い | 中程度。コンサルタントの成果物に依存 | 比較的高いが、透明性に欠ける | その後の更新にも繰り返しサービスを依頼する必要がある |
| 専門家+コーディングエージェント | 専門家の手元 | 高い。フローを再実行できる | 高い。ただし、人による検証が十分に行われることが前提 | 専門家には方法論を整理する高い能力が求められる |
| すべてエージェントに任せる | 曖昧。暗黙の前提に埋もれている | 中程度 | 低い。結論の根拠を説明しにくい | 結論について対外的な責任を持てない |
比較のポイント
外部コンサルタントとの比較:外部コンサルタントには、専門経験や成果物を納品するまでのスピードに一定の強みがあります。しかし、方法論はコンサルタントの手元に残ることが多く、翌年に評価を更新するには、再び相談して費用を支払わなければなりません。一方、「専門家+コーディングエージェント」の形なら、方法論を組織内に残せます。Heimstadenも、このプロジェクトによって、本来必要だった外部コンサルタントの雇用を避けられたと明言しています。
すべてエージェントに任せる場合との比較:プロジェクト全体をエージェントに任せれば、最も手間がかからず、成果も早く得られるように見えます。しかし、エージェントは欠損値をどう補完するか、外れ値をどう除外するかなど、多くの細部を自ら仮定します。こうした仮定が業界の慣行に合わない可能性もあります。報告書のコンプライアンスや投資判断の根拠となる評価では、このような結論は詳細を問われたときに十分に説明できないおそれがあります。
人手の削減に関する数字は、客観的に見る必要があります。原文では、「納品に必要と見積もられた工数」が5人で1年から2人で2か月に減ったとされています。人月に大まかに換算すると、約60人月から4人月への削減です。ただし、これは企業自身の試算であり、第三者による検証は行われていません。また、2人それぞれの役割分担も明らかにされていません。
💡 選び方のヒント:チームにすでに方法論があり、技術面での実行力が不足しているのであれば、「専門家+コーディングエージェント」が最も試す価値のある選択肢です。フロー内でモデル呼び出しが必要な部分では、APIYI apiyi.com の統一インターフェースを使って複数のモデルを切り替え、比較できます。後からモデルを変更する際も、フロー全体を書き直す必要はありません。
Codexを使ったデータ処理事例で分かっていること・分かっていないこと
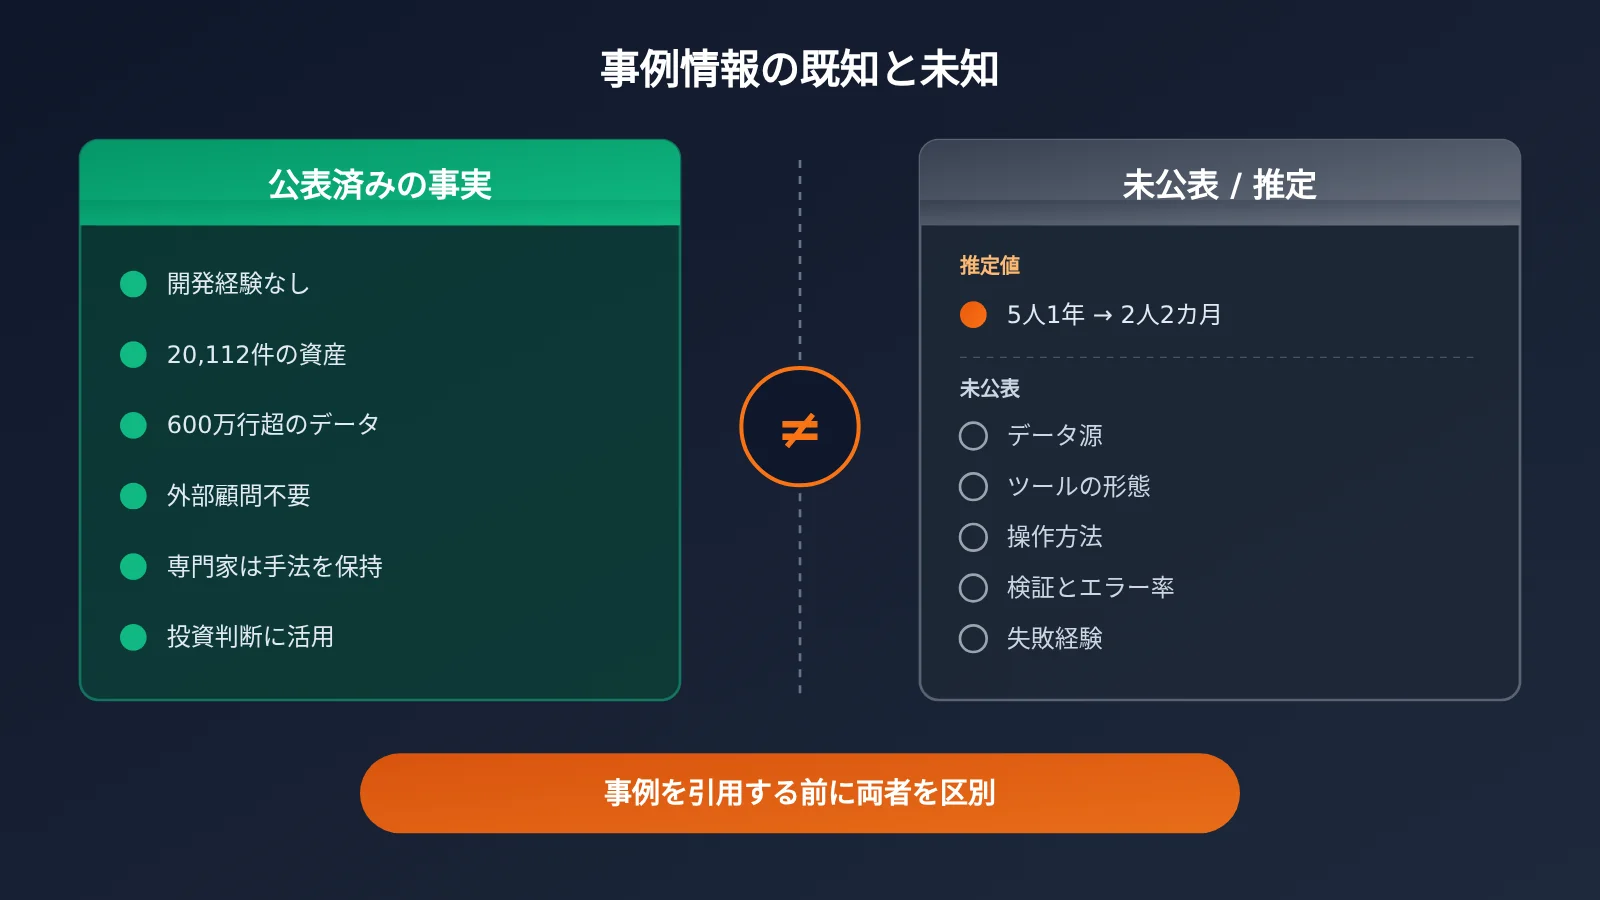
事例を「読み込みすぎる」ことを避けるため、原文で明示されている情報と、公開されていない情報を分けて整理します。
| カテゴリ | 内容 |
|---|---|
| 公開済み | アナリストにソフトウェア開発の経験はなかった;Codexがデータの探索、クレンジング・標準化、品質チェック、処理フローの開発を支援した;方法論の策定と検証はアナリストが担当した;20,112件の資産を評価し、600万行以上のデータを生成した;外部コンサルタントは不要だった;成果は気候リスク評価、報告、投資判断に活用された |
| 推定値 | 作業に必要な人員と期間が5人で1年から2人で2か月に減ったという数値は、企業による推定 |
| 非公開 | 具体的なデータソース;Codexの利用形態(デスクトップ、CLI、その他);やり取りの方法とワークフロー;具体的な検証方法とエラー率;利用中に直面した困難や失敗の経験 |
これらの不明点があっても、役割分担の考え方は参考になります。ただし、事例の効率化に関する数字をそのまま自分のプロジェクトに当てはめることはできません。実際のプロジェクトでは、「エージェントに処理フローを書かせる」ことよりも、方法論の整理や人による検証に多くの時間がかかる可能性があります。Heimstadenの経営陣がまとめた次の言葉は、覚えておく価値があります。AIは悪いプロセスを修正できませんが、良いプロセスの効果を大きく増幅できます。
よくある質問 FAQ
Q1:開発者ではない人が Codex でデータ処理フローを構築するとは、具体的にどういうことですか?
プログラミング経験のない分野の専門家が、コーディングエージェントに自然言語で要件を伝え、データの取得・クリーニング・チェックやフローの作成といった技術的な作業を任せることです。専門家は方法論の定義と結果の検証を担当します。Heimstaden の環境リスク評価プロジェクトは、その公開事例の一つです。
Q2:ChatGPT に直接データについて質問するのとは何が違いますか?
質疑応答形式での利用は、一度きりの問題を対象とすることが多く、結果の再現が難しい場合があります。コーディングエージェントの価値は、繰り返し実行できる処理フローを作れる点にあります。データが更新されたら再実行でき、方法論を見直したらフローも修正できます。事例でいう「複雑な分析プロジェクトから、繰り返し使える能力へ」という変化は、まさにこのことです。
Q3:この事例はいつ公開されましたか?
この事例は OpenAI が 2026 年 11 月 3 日に公開したもので、企業におけるコーディングエージェントの最近の活用例を示しています。具体的な数値やツールの形は時間とともに変わる可能性がありますが、「実行はエージェントに任せ、判断は専門家が担う」という役割分担の原則は、長期にわたって参考になるでしょう。
Q4:どのようなデータプロジェクトがこの役割分担に適していますか?
– **複数の公開データの統合**:環境、気候、人口など、さまざまな機関に分散しているデータセット
– **定期報告**:四半期ごとや毎年繰り返し作成するコンプライアンス報告書や情報開示資料
– **ポートフォリオ全体の一括評価**:数千から数万件のレコードを統一基準で採点する場面
Q5:フロー内で大規模言語モデルを呼び出す場合、手軽に始めるにはどうすればよいですか?
まず APIYI apiyi.com に登録し、同じインターフェースから複数の主要モデルを呼び出して、少数の代表的なサンプルで分類や抽出の結果を比較できます。安定性と判定基準の一貫性を確認してから、本番フローに組み込みましょう。複数モデルの比較は、人手による検証を補助する手段にもなります。
Q6:人手による検証は具体的にどの程度行うべきですか?
この事例では、検証方法やエラー率は公開されていません。一般的には、事前にサンプリング率と許容エラー基準を決め、自動チェックで検出された異常を一件ずつ再確認します。正常とされた結果もランダムに抽出して確認し、既知の外部基準とも照らし合わせます。検証記録はすべて保存し、後日の監査に備えましょう。
Q7:この方法にはどのような限界がありますか?
第一に、効率に関する数値は企業側の推定であり、第三者による検証がありません。第二に、開発者でない人にも方法論を明確に記述する能力が必要です。それができなければ、エージェントは混乱を増幅させるだけです。第三に、この事例では困難や失敗の経験に触れていません。実際の導入時には、フローでエラーが起きても内容を理解できない場合があり、必要に応じて技術担当者の調査支援が必要になります。
Q8:なぜ「方法論を自分たちで把握すること」がそれほど重要なのですか?
方法論を自分たちで把握していれば、次にデータが更新されたときや規制要件が変わったとき、投資家から詳しい説明を求められたときにも、チームが直接修正・説明できます。改めてコンサルタントを探す必要はありません。Julia の「私たちは今、この方法論を自分たちのものとして持ち、今後も自分たちで発展させていけます」という言葉が表しているのは、こうした長期的な自主性です。
開発者以外のための Codex データ処理ワークフロー:重要ポイント
- 役割分担を明確にする:データの発見、クリーニング、品質チェック、ワークフローの構築はエージェントに任せ、方法論の策定と検証は専門家が担う
- 方法論を先に定める:まず評価フレームワークを文書にまとめ、その文書に従ってエージェントを動かす
- 独立して検証する:自動チェック、手作業によるサンプリング、外部ベンチマークとの比較の3つを組み合わせる
- 再現性が重要:繰り返し実行できるワークフローこそが資産になる。一度きりの結果では改善を重ねられない
- 数字は慎重に扱う:5人で1年かかる作業が2人で2か月になったという数字は推定値であり、そのまま他のケースに当てはめるべきではない
- モデル比較を検証に役立てる:大規模言語モデルを呼び出す工程では、APIYI の統一インターフェースを使って複数モデルを相互に比較できる
まとめ
開発者以外の人が Codex を使ってデータ処理ワークフローを構築するうえで、最も参考になるのは効率を示す数字ではなく、明確な役割分担です。
- エージェントが実行を担当:データの発見、クリーニングと標準化、品質チェック、繰り返し実行できるワークフローの構築は任せられます
- 専門家が判断を担当:方法論の策定と結果の検証が、信頼でき、説明可能な結論の土台になります
- 能力を蓄積:方法論を自ら管理し、ワークフローを繰り返し実行できるようにすることで、単発のプロジェクトを組織が継続的に改善できる能力へと変えられます
「データが散在していて、技術リソースも確保できない」というプロジェクトを抱えているなら、まずは時間をかけて方法論を書き出し、小規模な試行から始めてみてください。ワークフロー内で大規模言語モデルを呼び出す工程では、APIYI(apiyi.com)の統一インターフェースを通じて複数モデルの結果を比較し、手作業による検証にもう一層の裏付けを加えられます。
📚 参考資料
- OpenAI お客様事例 – Heimstaden:Heimstaden が ChatGPT と Codex を活用して住宅不動産管理を変革
- リンク:
openai.com/index/heimstaden/ - 説明: 本記事の事例に関する唯一の情報源。環境リスク評価プロジェクトの役割分担と見積もりデータを掲載
著者: APIYI 技術チーム
技術に関するお問い合わせ: APIYI のトップページからお気軽にお問い合わせください。モデルの導入に関する詳しい資料は、docs.apiyi.com のドキュメントセンターをご覧ください。