作者注:DeepSeek 開放 Search & Fetch API,API易 已同步上線 deepseek-search 與 deepseek-fetch。本文梳理官方指南的核心信息,分析它對 RAG、Agent 與聯網問答開發者的影響,並給出 API易 上的計費與接入方式。
DeepSeek 官方文檔近期新增了 Search 指南,並在新聞欄目發佈了公告,Search & Fetch API 正式向開發者開放。這意味着調用 DeepSeek 模型時,可以通過官方能力完成“搜索網頁 + 抓取頁面內容”,不必再自己拼接第三方搜索服務。
這不是坊間傳言。官方文檔的 Search 指南頁面和新聞公告都已上線,Hacker News 上也出現了專門的討論帖,說明海外開發者社區同樣在關注。官方能力部分只基於公開信息解讀,具體請求參數以官方文檔爲準;API易 平臺側的上線信息與計費,見下文專門章節。
核心價值:3 分鐘瞭解 DeepSeek Search & Fetch API 的核心信息、能力分工,以及它對 RAG、Agent、聯網問答類產品的實際影響。
API易 已上線:API易 新增 deepseek-search 與 deepseek-fetch,按成功次數計費,不消耗 token;站內每次 $0.0009,充值大客戶疊加 20% 加贈後爲 $0.75 / 1000 次,與官網持平。
DeepSeek Search & Fetch API 核心信息速覽
先用一張表把目前能夠確認的信息說清楚。這裏我們只列出官方公開渠道可以覈實的內容,沒有寫入任何未公開的價格或跑分數據。
| 信息項 | 詳情 |
|---|---|
| 發佈方 | DeepSeek 官方 |
| 信息來源 | 官方 API 文檔 Search 指南頁面、官方新聞公告 |
| 核心內容 | 開放 Search(聯網搜索)與 Fetch(網頁內容抓取)兩類能力 |
| 面向人羣 | 使用 DeepSeek API 構建聯網問答、RAG、Agent 的開發者 |
| 社區反饋 | Hacker News 已有專門討論帖,關注度較高 |
| 價格與配額 | 官方價格與配額以官方文檔和控制檯爲準;API易 的計費見下文專門章節 |
DeepSeek Search & Fetch 兩類能力的分工
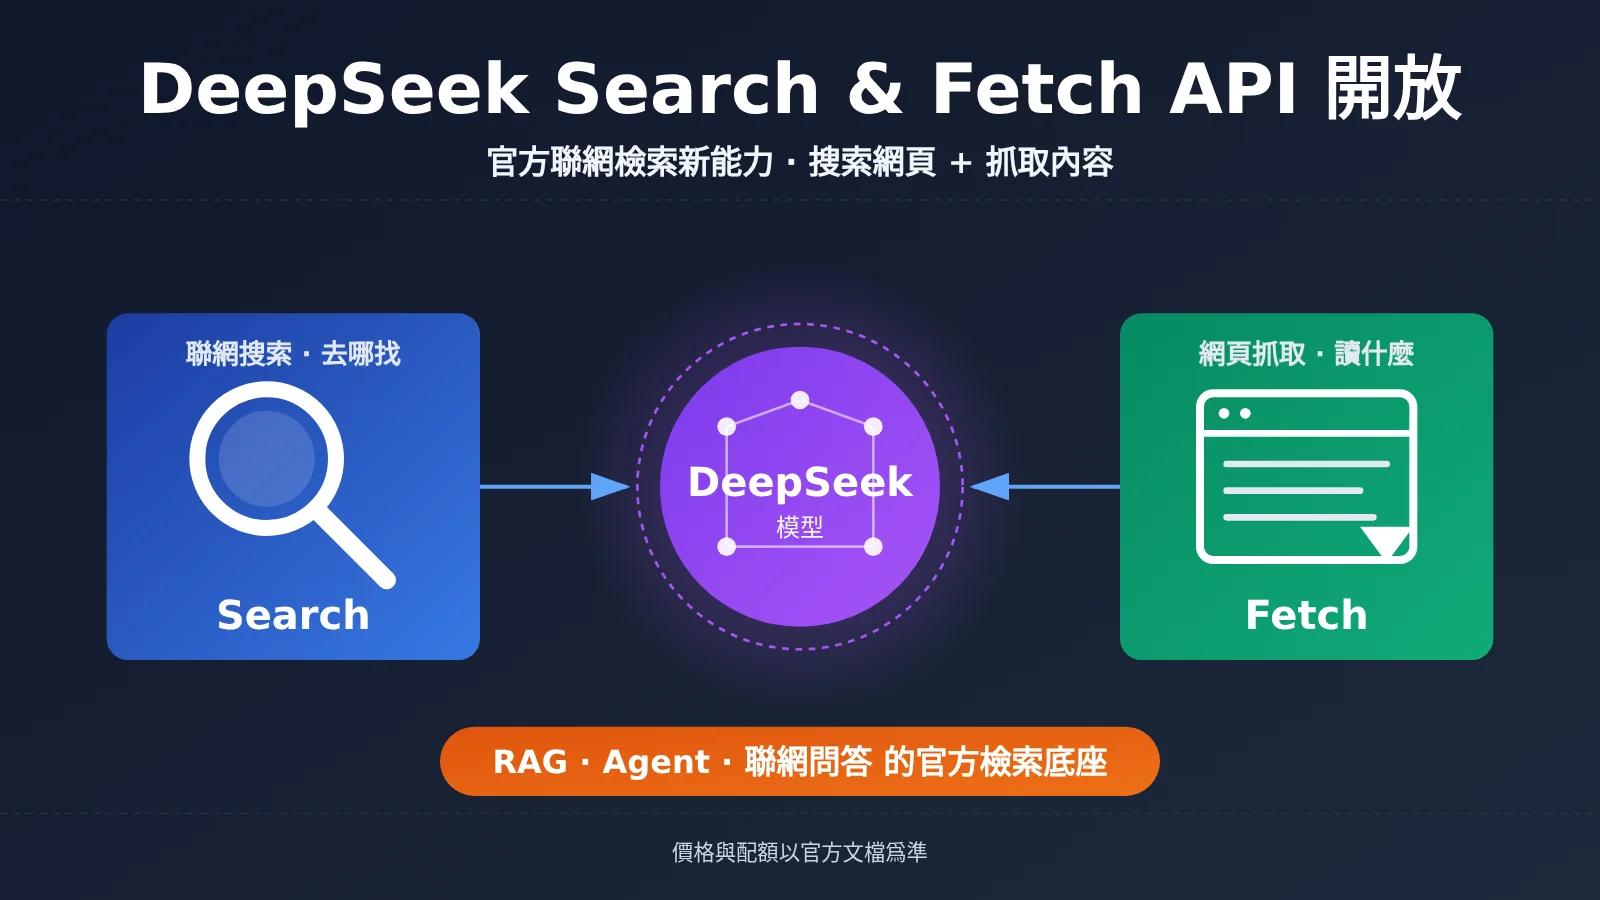
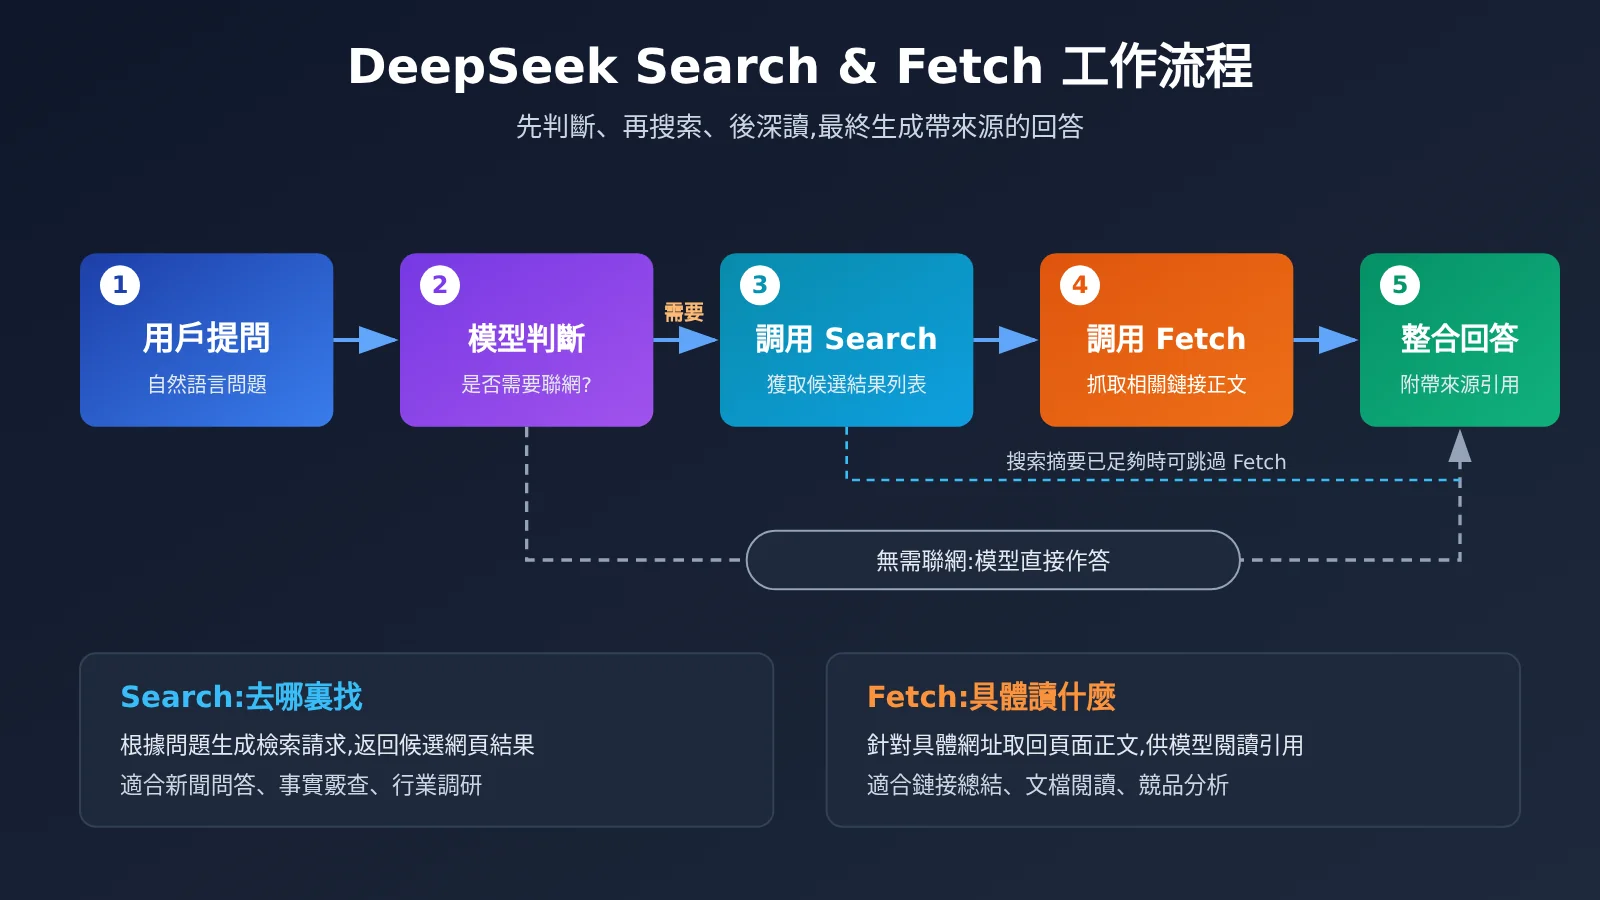
從命名就能看出,這次開放的是一組“組合拳”。Search 解決的是“去哪找”的問題,模型根據用戶問題生成檢索請求,拿回一批候選結果;Fetch 解決的是“讀什麼”的問題,針對某個具體網址把頁面正文取回來,供模型閱讀和引用。
兩者分開設計的好處在於可控。很多場景只需要搜索摘要就足夠回答,沒必要逐頁抓取;而另一些場景用戶直接甩來一個鏈接,此時只需要 Fetch 而不需要 Search。拆成兩個能力後,開發者可以按需組合,在效果和成本之間找到平衡點。
| 能力 | 解決的問題 | 典型輸入 | 典型輸出 | 適合場景 |
|---|---|---|---|---|
| Search | 去哪裏找信息 | 自然語言問題或關鍵詞 | 候選網頁結果列表 | 新聞問答、事實覈查、行業調研 |
| Fetch | 具體讀什麼內容 | 明確的網頁地址 | 頁面正文內容 | 鏈接總結、文檔閱讀、競品分析 |
| Search + Fetch | 先找再深讀 | 複雜研究型問題 | 多來源綜合結論 | Deep Research、Agent 自動調研 |
爲什麼 DeepSeek Search & Fetch API 值得關注
大模型知識截止問題的官方解法
任何大模型都有訓練數據截止時間,模型本身並不知道“今天發生了什麼”。過去開發者想讓 DeepSeek 回答時效性問題,通常要自己接入一個搜索引擎 API,再寫爬蟲抓正文,再把內容塞進上下文裏,鏈路長、維護成本高。
官方提供 Search & Fetch 之後,這條鏈路有機會被大幅縮短。模型廠商對自家模型的工具調用習慣最瞭解,官方集成的檢索能力在調用格式、結果組織上通常更貼合模型,這對減少“檢索到了卻用不好”的問題很有幫助。
從“問答模型”走向“Agent 基礎設施”
另一個值得注意的信號是方向性的。搜索和網頁讀取是 Agent 最基礎的兩個工具,幾乎所有自動化調研、瀏覽器 Agent、Deep Research 類產品都離不開它們。DeepSeek 把這兩項能力做成官方 API,說明它在把模型從單純的對話接口,推向可以直接承載 Agent 工作流的基礎設施。
對國內開發者來說,這一點尤其實際。很多團隊已經在用 DeepSeek 做主力模型,如果聯網能力也能在同一體系內解決,技術棧會更簡潔,排查問題時也少了一層第三方依賴。
DeepSeek Search & Fetch API 接入方式解讀
極簡示例:先跑通 DeepSeek 基礎調用
在接入聯網能力之前,建議先確認基礎調用是通的。下面的代碼使用 OpenAI 兼容接口調用 DeepSeek 模型,10 行左右即可運行:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 API易 統一接口
)

response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[{"role": "user", "content": "用三句話介紹聯網搜索對大模型的意義"}]
)
print(response.choices[0].message.content)
需要特別說明的是,官方 Search & Fetch 的具體請求字段、開關參數和返回結構,請以 DeepSeek 官方 Search 指南爲準。下面的完整示例採用通用的 Function Calling 模式,演示“模型決定何時搜索、何時抓取”的整體流程,便於你理解工作機制,也方便在官方參數確定後替換爲原生調用。
查看完整實現代碼:Function Calling 模擬 Search + Fetch 流程
import json
import openai
import requests

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

# 定義兩個工具:搜索與抓取(演示用,可替換爲官方原生能力)
tools = [
    {
        "type": "function",
        "function": {
            "name": "web_search",
            "description": "根據關鍵詞聯網搜索,返回候選網頁列表",
            "parameters": {
                "type": "object",
                "properties": {"query": {"type": "string"}},
                "required": ["query"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "fetch_page",
            "description": "抓取指定網址的頁面正文",
            "parameters": {
                "type": "object",
                "properties": {"url": {"type": "string"}},
                "required": ["url"]
            }
        }
    }
]

def web_search(query: str) -> str:
    # 這裏接入你的搜索實現,或替換爲官方 Search 能力
    return json.dumps([{"title": "示例結果", "url": "https://example.com"}])

def fetch_page(url: str) -> str:
    # 簡化的抓取實現,生產環境需處理編碼、正文提取與超時
    try:
        resp = requests.get(url, timeout=10)
        return resp.text[:4000]
    except Exception as e:
        return f"抓取失敗: {e}"

TOOL_MAP = {"web_search": web_search, "fetch_page": fetch_page}

def ask(question: str, max_rounds: int = 4) -> str:
    messages = [
        {"role": "system", "content": "需要最新信息時先搜索,再抓取關鍵頁面,回答時註明來源。"},
        {"role": "user", "content": question}
    ]
    for _ in range(max_rounds):
        resp = client.chat.completions.create(
            model="deepseek-chat",
            messages=messages,
            tools=tools
        )
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return msg.content
        messages.append(msg)
        for call in msg.tool_calls:
            args = json.loads(call.function.arguments)
            result = TOOL_MAP[call.function.name](**args)
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result
            })
    return "達到最大輪次,未能完成回答"

print(ask("總結一下最近關於 DeepSeek Search API 的討論要點"))
🚀 快速開始:建議先通過 API易 apiyi.com 獲取測試額度,把 DeepSeek 基礎調用和 Function Calling 流程跑通。API易 已上線 deepseek-search 與 deepseek-fetch,跑通後可直接把示例裏的模擬工具替換爲這兩個原生接口,接入方式見下一節。
API易 已上線 DeepSeek Search 與 Fetch:計費與接入
API易 apiyi.com 已經上線這兩項能力,對應兩個新的模型名:deepseek-search 與 deepseek-fetch。它們不是對話模型,而是工具類接口,專門給 Agent 與 RAG 聯網取數使用,請求不消耗 token,只按調用次數計費。
| 項目 | deepseek-search | deepseek-fetch |
|---|---|---|
| 接口路徑 | /v1/tools/search |
/v1/tools/fetch |
| 作用 | 聯網搜索,返回候選網頁 | 抓取指定網址的頁面內容 |
| 計費方式 | 按成功次數計費,不消耗 token | 按成功次數計費,不消耗 token |
| 站內價格 | $0.0009 / 次 | $0.0009 / 次 |
| 失敗請求 | 不扣費 | 不扣費 |
| 可用分組 | default、svip | default、svip |
價格方面有一個細節值得算一筆賬。站內標價是每次 $0.0009,對於充值大客戶,疊加 20% 加贈之後,摺合下來是 $0.75 / 1000 次,與 DeepSeek 官網的價格持平,並且含稅。也就是說,通過 API易 調用不用額外承擔溢價,還能把搜索、抓取和對話模型放在同一個賬號、同一份賬單裏管理。
用法和官網保持一致,只需要把請求地址裏的根域名換成 API易 的域名即可,請求字段和返回結構沿用官方文檔。完整說明可以查看 API易 文檔:docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview。
有兩點接入提醒。第一,搜索與抓取接口本身不消耗 token,但抓回來的正文餵給對話模型時,仍會佔用上下文併產生對話模型的 token 費用,所以前文提到的“限制輪次、截斷正文”依然有效。第二,失敗不扣費意味着網絡超時或目標頁面無法訪問時不會白花錢,但業務側仍應保留重試上限和降級邏輯。
🔗 接入入口:在 API易 控制檯確認賬號分組爲 default 或 svip,即可使用 deepseek-search 與 deepseek-fetch;更新公告與文檔中心會同步維護最新說明。
DeepSeek Search & Fetch API 與其他聯網方案對比
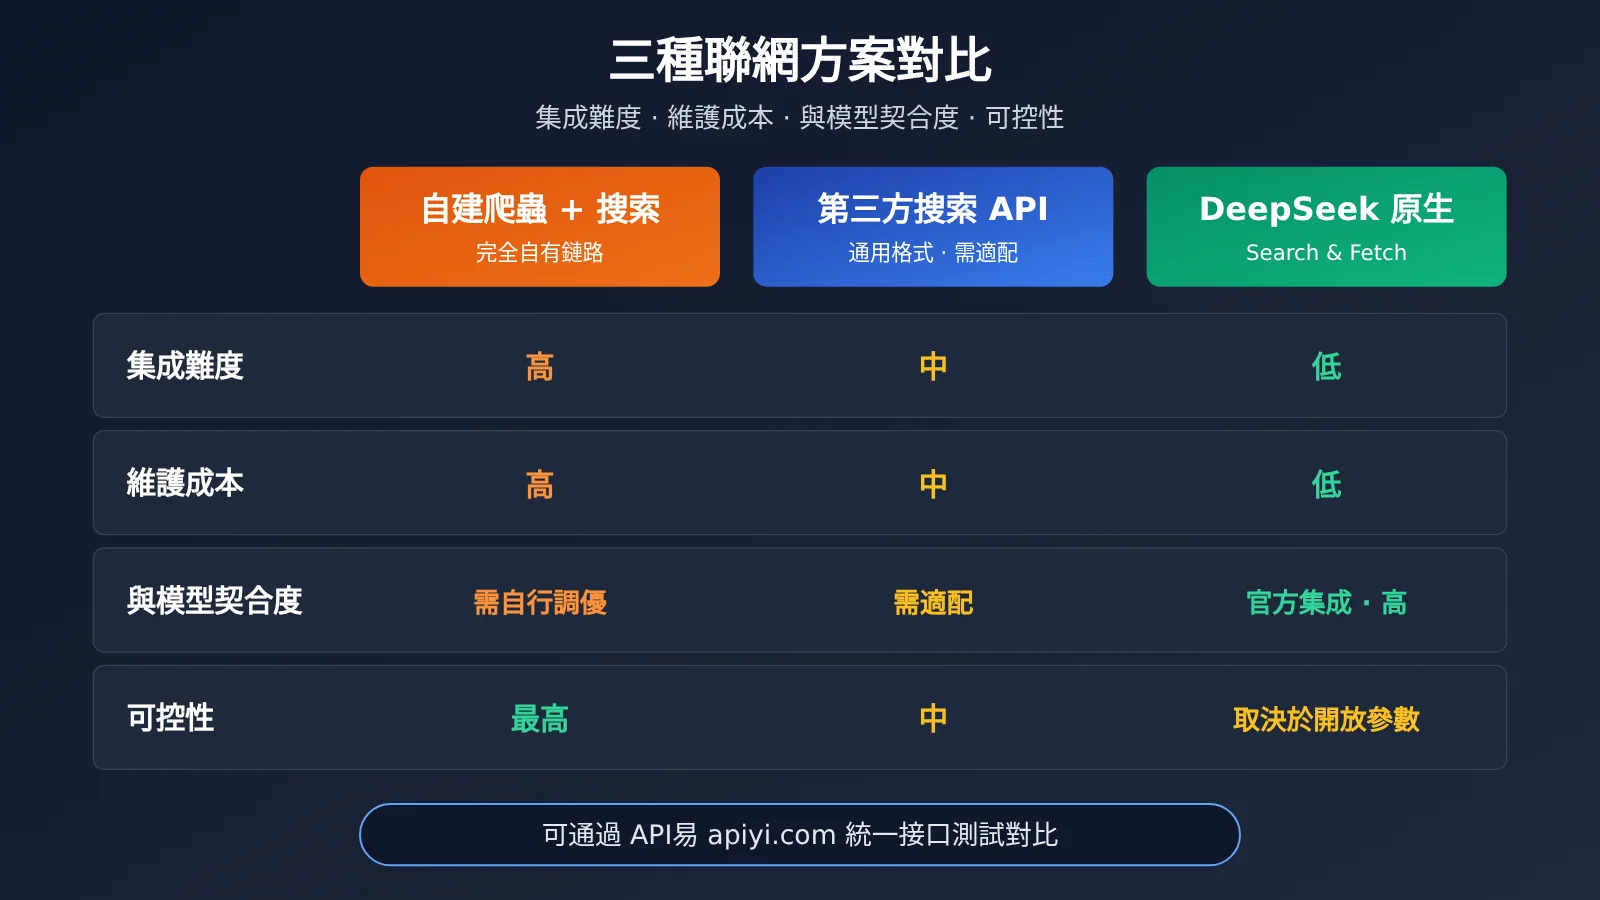
在官方能力出現之前,開發者主要有兩條路:自己搭檢索鏈路,或者接入第三方搜索 API。下表從工程角度做一個定性對比,不涉及具體價格,價格請分別查閱各方官方說明。
| 方案 | 集成難度 | 維護成本 | 與模型契合度 | 可控性 | 可用平臺 |
|---|---|---|---|---|---|
| 自建爬蟲 + 搜索 | 高 | 高 | 需要自行調優 | 最高 | 自有服務器 |
| 第三方搜索 API | 中 | 中 | 通用格式,需適配 | 中 | 各搜索服務商 |
| DeepSeek 原生 Search & Fetch | 低 | 低 | 官方集成,契合度高 | 取決於官方開放參數 | DeepSeek 官方 API,API易 apiyi.com 已上線(deepseek-search / deepseek-fetch) |
對比解讀
自建方案對標分析:自建爬蟲和檢索系統在可控性上保持領先,你可以決定抓哪些站點、怎麼清洗正文、怎麼排序。但它的開發與維護成本最高,反爬、編碼、正文提取都是長期工作。相比之下,DeepSeek 原生能力更適合希望快速上線、不想維護爬蟲的團隊。
第三方搜索 API 對標分析:第三方搜索服務在結果覆蓋面和成熟度上表現出色,生態也比較完善。但它返回的結構是通用格式,要餵給模型還需要一層適配,多一個供應商也意味着多一份賬單和故障點。對於主力模型就是 DeepSeek 的用戶,原生能力在鏈路簡潔性上更有優勢。
💡 選擇建議:沒有絕對最優的方案,強合規、需要指定信源的場景仍適合自建;追求上線速度的場景更適合原生能力。建議通過 API易 apiyi.com 用同一套接口快速對比不同模型和方案的實際效果,再做決定。
DeepSeek Search & Fetch API 對開發者的影響分析
對 4 類開發者的直接影響
不同類型的項目,受這次開放影響的程度並不一樣。下面按常見的四類開發者做個梳理:
| 開發者類型 | 主要影響 | 建議動作 |
|---|---|---|
| 聯網問答 / 搜索類產品 | 可替換自建檢索鏈路,簡化架構 | 小流量灰度對比回答質量與延遲 |
| RAG 知識庫應用 | 可在私有知識之外補充實時公網信息 | 區分內部知識與公網來源,避免混淆 |
| AI Agent 開發者 | 獲得官方級基礎工具,降低工具開發成本 | 設計好搜索與抓取的調用輪次上限 |
| 內容與研究工具 | 鏈接總結、競品調研流程更順暢 | 關注來源標註與版權合規要求 |
對行業格局的影響
- 聯網能力成爲模型 API 標配:主流模型廠商逐步把搜索、網頁讀取納入官方能力,“模型 + 工具”打包提供正在成爲趨勢,單純的對話接口競爭力會下降。
- 第三方搜索服務面臨分化:通用搜索 API 仍有市場,但會更多轉向專業信源、垂直領域和企業級可控檢索,與模型原生能力形成互補。
- Agent 產品門檻進一步降低:基礎工具由模型廠商提供後,創業團隊可以把精力放在工作流設計和場景打磨上,而不是重複造輪子。
DeepSeek Search & Fetch 接入時需要注意的問題
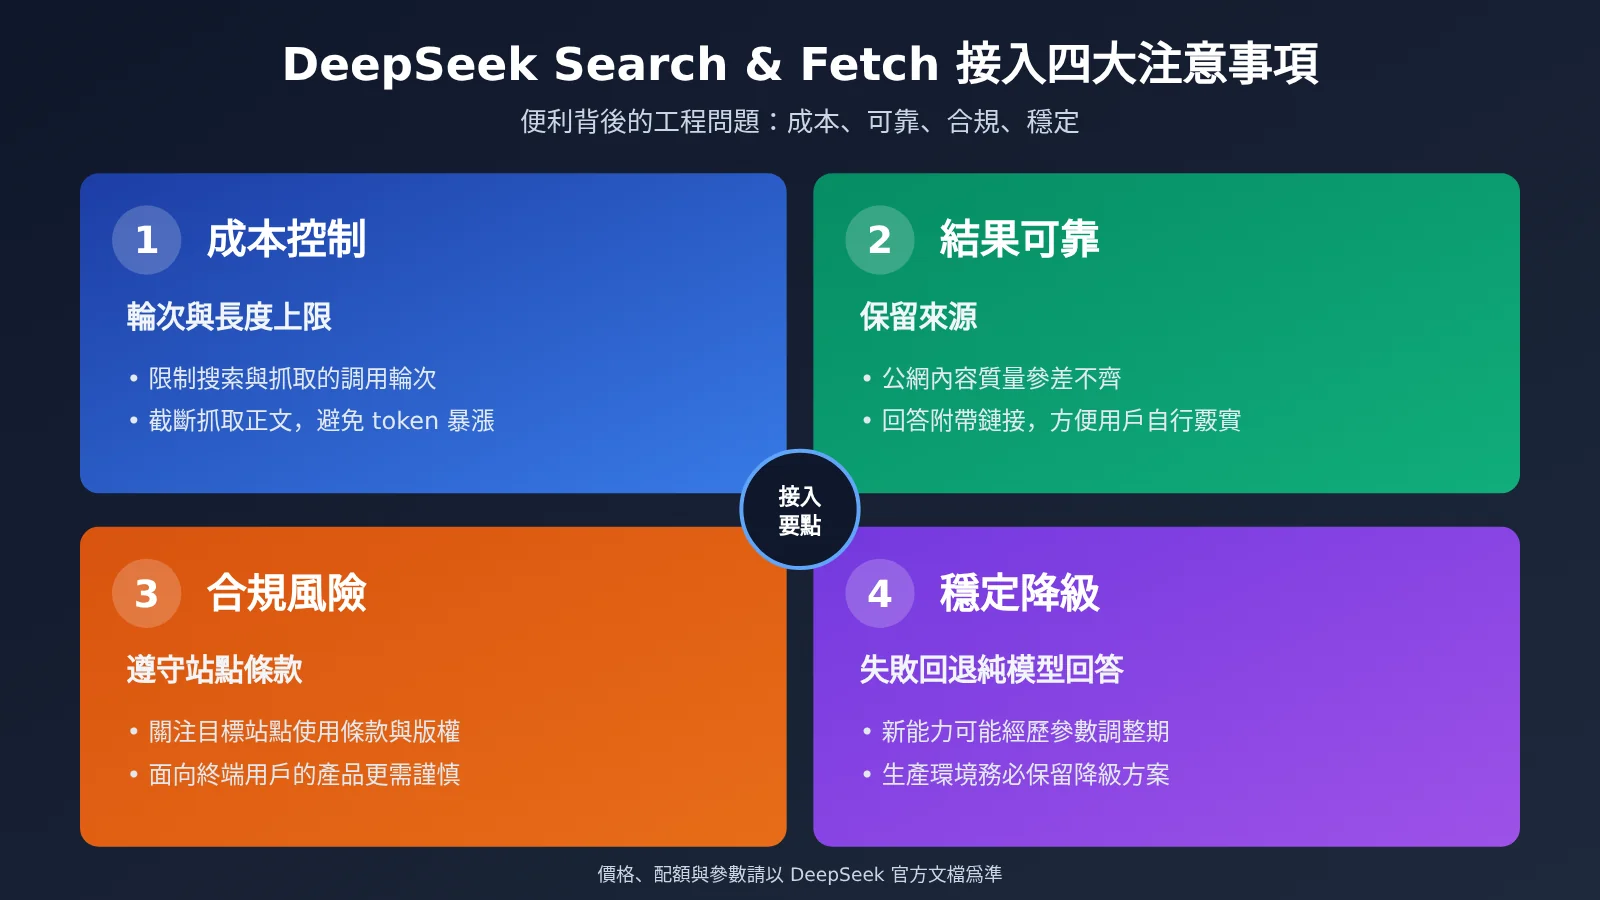
聯網能力帶來便利,也帶來新的工程問題。第一是成本控制,搜索和抓取往往會顯著增加上下文長度,進而推高對話模型的 token 消耗(搜索與抓取接口本身按次計費、不耗 token),建議設置調用輪次和抓取長度上限。第二是結果可靠性,公網內容質量參差不齊,回答中應該保留來源,讓用戶可以自行覈實。
第三是合規問題。抓取網頁內容需要關注目標站點的使用條款和版權要求,面向終端用戶的產品更要謹慎。第四是穩定性,任何新上線的能力都可能經歷參數調整期,生產環境最好保留降級方案,比如聯網失敗時退回純模型回答。
常見問題 FAQ
Q1:什麼是 DeepSeek Search & Fetch API?
它是 DeepSeek 官方開放的聯網能力組合。Search 負責根據問題聯網搜索候選結果,Fetch 負責抓取指定網頁的正文內容,二者配合可以讓 DeepSeek 模型回答時效性問題,並基於真實網頁內容給出帶來源的結論。
Q2:DeepSeek Search & Fetch 和自己接搜索 API 有什麼區別?
自接搜索 API 可控性更強,但要自己處理結果適配、正文抓取和多供應商維護。DeepSeek 原生能力由官方集成,與模型的配合更緊密,鏈路更短;代價是可定製範圍取決於官方開放的參數。
Q3:DeepSeek Search & Fetch API 什麼時候可以用?
官方文檔的 Search 指南和新聞公告都已上線,說明能力已經開放。API易 也已經上線 deepseek-search 與 deepseek-fetch,default 和 svip 分組可用,站內 $0.0009 / 次,失敗不扣費。官方渠道的價格與配額,請以官方文檔和控制檯爲準。
Q4:如何通過 API 快速體驗 DeepSeek 聯網相關能力?
推薦按以下步驟準備:
1. 訪問 API易 apiyi.com 註冊賬號並獲取 API Key
2. 用本文極簡示例(base_url 設爲 `https://api.apiyi.com/v1`)跑通 DeepSeek 基礎調用
3. 參考 API易 文檔,調用 `/v1/tools/search` 與 `/v1/tools/fetch`(模型名 deepseek-search、deepseek-fetch)
4. 用完整示例的 Function Calling 流程,把模擬工具替換爲這兩個原生接口
Q5:DeepSeek Search & Fetch 有哪些已知限制?
目前公開信息有限,需要客觀看待幾點:調用成本會隨搜索和抓取內容增加;公網結果質量不一,需要保留來源供覈實;網頁抓取涉及站點條款和版權合規;新能力上線初期參數可能調整,生產環境應保留降級方案。
DeepSeek Search & Fetch API 核心要點 Key Takeaways
- 核心信息:DeepSeek 官方開放 Search 與 Fetch 兩項聯網能力,文檔與公告均已上線
- 能力分工:Search 負責找信息,Fetch 負責讀網頁,可按需單獨或組合使用
- 最大價值:縮短聯網檢索鏈路,減少自建爬蟲和第三方適配的工作量
- 主要受益者:聯網問答、RAG、AI Agent 與內容研究類產品開發者
- API易 已上線:deepseek-search 與 deepseek-fetch 按成功次數計費,不消耗 token,站內 $0.0009 / 次,失敗不扣費
- 價格對比:充值大客戶疊加 20% 加贈後爲 $0.75 / 1000 次,與官網持平、含稅
- 接入提醒:請求參數以官方文檔爲準,注意成本、合規與降級
- 上手方式:default / svip 分組即可使用,只需把官方示例的根域名換成 API易 的域名
總結
DeepSeek Search & Fetch API 的核心要點:
- 官方補齊聯網短板:通過 Search 和 Fetch 兩項能力,讓 DeepSeek 模型可以直接獲取實時網頁信息。
- Agent 基礎設施化:搜索與網頁讀取是 Agent 的基礎工具,官方提供意味着開發門檻進一步降低。
- 理性評估再上線:在成本、可靠性、合規和穩定性四個方面做好預案,再逐步替換現有鏈路。
API易 已經上線 deepseek-search 與 deepseek-fetch,按成功次數計費、失敗不扣費。對已經在用 DeepSeek 的團隊來說,現在是評估這項能力的好時機:先用小流量對比回答質量和成本,再決定是否全面遷移。推薦通過 API易 apiyi.com 快速驗證效果,平臺提供統一的 OpenAI 兼容接口,方便在 DeepSeek 與其他主流模型之間對比和切換。
📚 參考資料
- DeepSeek 官方文檔 – Search 指南:Search & Fetch 能力的官方說明
- 鏈接:
api-docs.deepseek.com/guides/search/ -
說明:請求方式、參數與返回結構以此爲準
-
DeepSeek 官方新聞公告:本次能力開放的官方發佈頁面
- 鏈接:
api-docs.deepseek.com/news/news261017/ -
說明:瞭解發佈背景與官方定位
-
Hacker News 社區討論:海外開發者對本次發佈的討論帖
- 鏈接:
news.ycombinator.com/item?id=50138531 - 說明:可參考社區的使用反饋與關注點
作者:APIYI 技術團隊
技術交流:歡迎在評論區討論 DeepSeek 聯網能力的接入經驗,更多接入資料可訪問 API易 docs.apiyi.com 文檔中心