2026年11月9日、Anthropicは公式エンジニアリングブログで、マルチエージェント実験について発表しました。1000個のClaude Fable 5.2エージェントが協力し、28.7時間でフェルマーの最終定理を計算機で形式化し、最終的にLeanの公式カーネルによる検証に合格しました。2か月前に行われた最初の形式化実験では、数十個のエージェントが11日かけて完了しました。
これは「AIが30時間以内にフェルマーの最終定理を証明した」という話ではありません。 この定理は、20世紀の90年代にAndrew WilesとRichard Taylorによってすでに証明されています。今回の実験で行われたのは、既存の証明の道筋を、コンピューターが段階ごとに検証できる形式化された証明へと翻訳することです。そこで本記事では、1000個のAIエージェントがどのようにして30時間足らずで、これほど複雑な作業を協力して成し遂げたのかを解説します。
この記事のポイント:今回のフェルマーの最終定理の形式化実験に関する重要なデータ、1000個のエージェントの編成方法と検証の仕組み、そして企業向けエージェントシステムへの示唆とその限界が分かります。
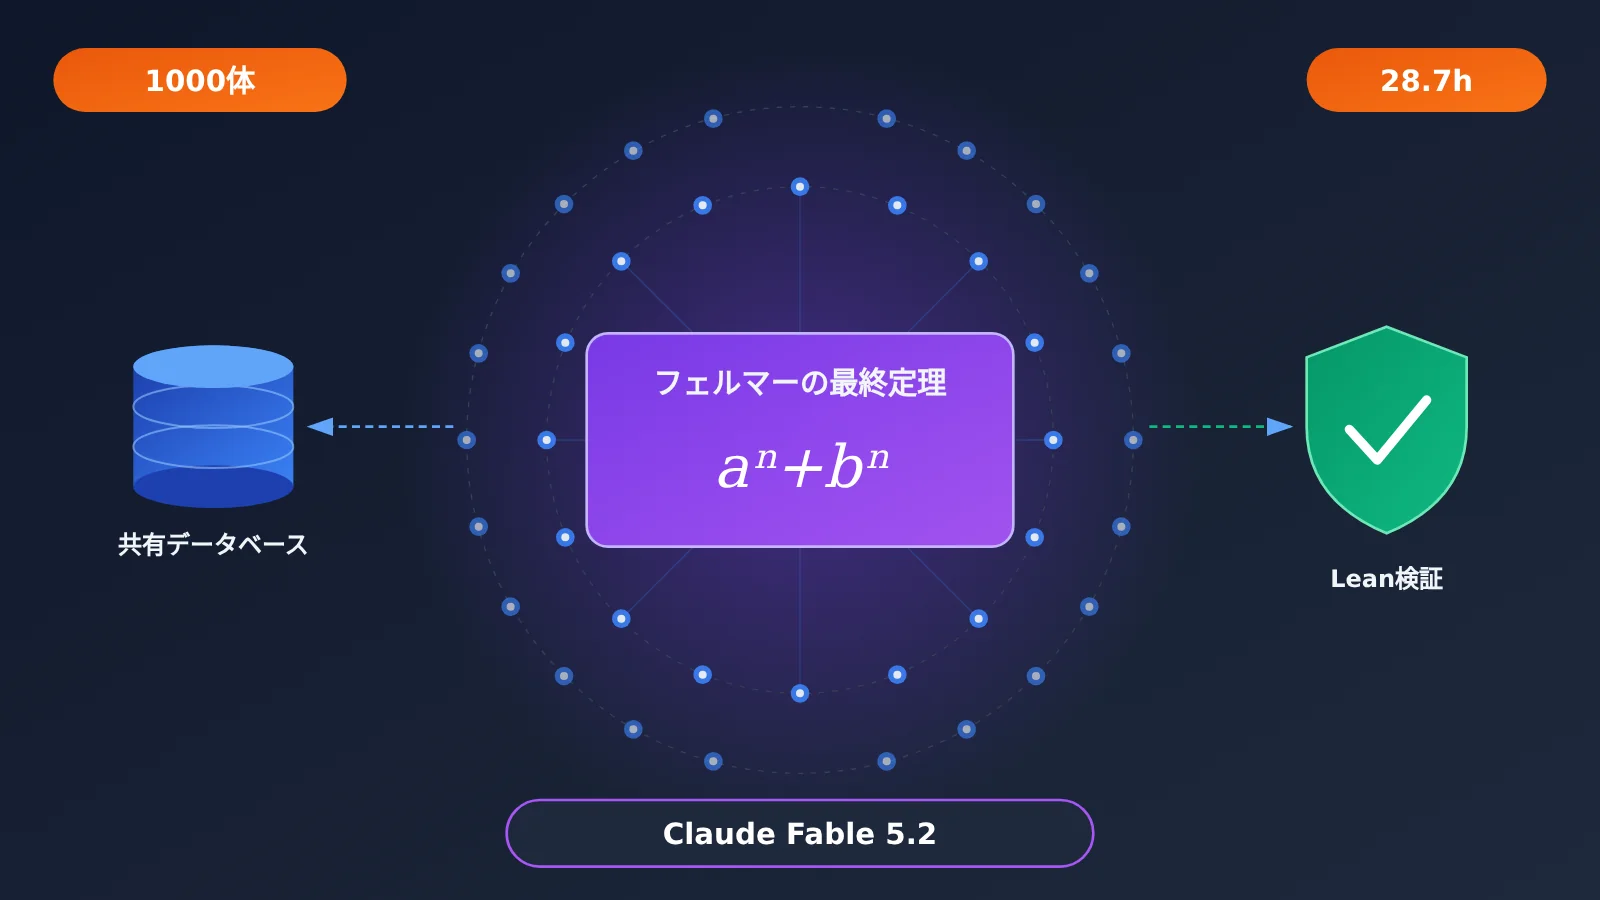
フェルマーの最終定理の形式化実験:概要
まず、Claude Fable 5.2を使った今回の実験について、基本情報を表にまとめます。混同しやすい点として、使用されたのは初期バージョンであり、実験には事前に与えられた入力がありました。また、公式も toy experiment(実験的なデモ)と位置づけています。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026年11月9日、Anthropic公式エンジニアリングブログ |
| 使用モデル | Claude Fable 5.2の初期バージョン(正式リリース前のアラインメント評価は未完了) |
| チーム規模 | Lead Agent 1体 + Helper Agent 999体 |
| 完了時間 | 28.7時間後。最終定理がLeanの公式カーネルによる検査に合格(公式発表では四捨五入して30時間) |
| 事前入力 | 60個の命題、古典的な証明ルートの概要を示す一文、関連する定義、前回の形式化で証明済みの47個の補題 |
| ツール環境 | Leanツールチェーン、Mathlib、Git、共有PostgreSQLデータベース、独立した仮想マシンサンドボックス |
| 公式の位置づけ | toy experimentであり、フェルマーの最終定理の初証明ではない |
フェルマーの最終定理の形式化:実験の前提を確認
研究者たちは、単に「フェルマーの最終定理を証明してください」と伝えて、あとは任せたわけではありません。Agentには、60個の命題(最終定理と59個の中間目標を含む)、証明ルートの概要、定義、そして前回の実験ですでに証明されていた47個の補題が与えられていました。LeadとHelperの役割も、研究者があらかじめ設定していました。
つまり、今回の実験で検証されたのは別の能力です。数学的な基礎とツールが与えられた状況で、大規模なAgentチームが自ら連携し、既知の証明ルートを機械検査可能な証明として完成させられるかどうかです。これは「AIに数学ができるか」という問いよりも、工学的な課題に近いものです。
フェルマーの最終定理の形式化がこれほど難しい理由
フェルマーの最終定理は、簡潔に表せます。整数 (n) が2より大きいとき、(a^n + b^n = c^n) を満たす正の整数 (a、b、c) は存在しません。17世紀にピエール・ド・フェルマーが提起してから、350年以上にわたって未解決のままでした。Wilesは1993年に証明を発表し、1994年にTaylorとともに重要な欠陥を修正したうえで、1995年に正式に論文を発表しました。原論文は約129ページに及び、現代数論や代数幾何学の多くの成果に依拠しています。
人間の数学者が証明を書くとき、「前述の結論から明らかに導かれる」と述べれば、読者は中間の手順を補って理解できます。コンピューターには、そうした暗黙の了解がありません。各ステップで、どの定義や定理、推論規則を使ったのかを明示する必要があります。ここに形式化の難しさがあります。人間にとって「明らか」なことでも、コードにすると数百行から数千行になる場合があります。
Lean、Mathlib、数学の形式化
今回の実験を理解するために、まず次の3つの概念を区別しておきましょう。
- Lean:対話型定理証明支援系です。証明が形式論理の規則に厳密に従っているかを検証します。
- Mathlib:Leanの数学ライブラリです。形式化済みの定義や定理が多数収録されており、そのまま参照できる「標準ライブラリ」に相当します。
- 数学の形式化:人間が読める数学の証明を、コンピューターが完全に検証できる論理構造に変換することです。
最も重要なのは、AIが証明を構築し、Leanのカーネルがその証明を検証するという点です。モデルが「証明できた」と言うことと、Leanが実際にその証明を受理することは、まったく別です。今回の実験が真剣に受け止められるのは、最終結果の妥当性をモデル自身の判断に委ねず、独立した機械検証を通しているからです。
1000体のAIエージェントはどう協力するのか:AIが運用するプロジェクト管理システム
Claude Fable 5.2の実験で、特に注目すべきなのがこの部分です。1000体のエージェントはそれぞれ独立して問題を解いていたのではなく、タスク管理、リソースの割り当て、状況に応じた調整の仕組みを備えた協調システムを構築していました。
Claude Fable 5.2チームの組織構造
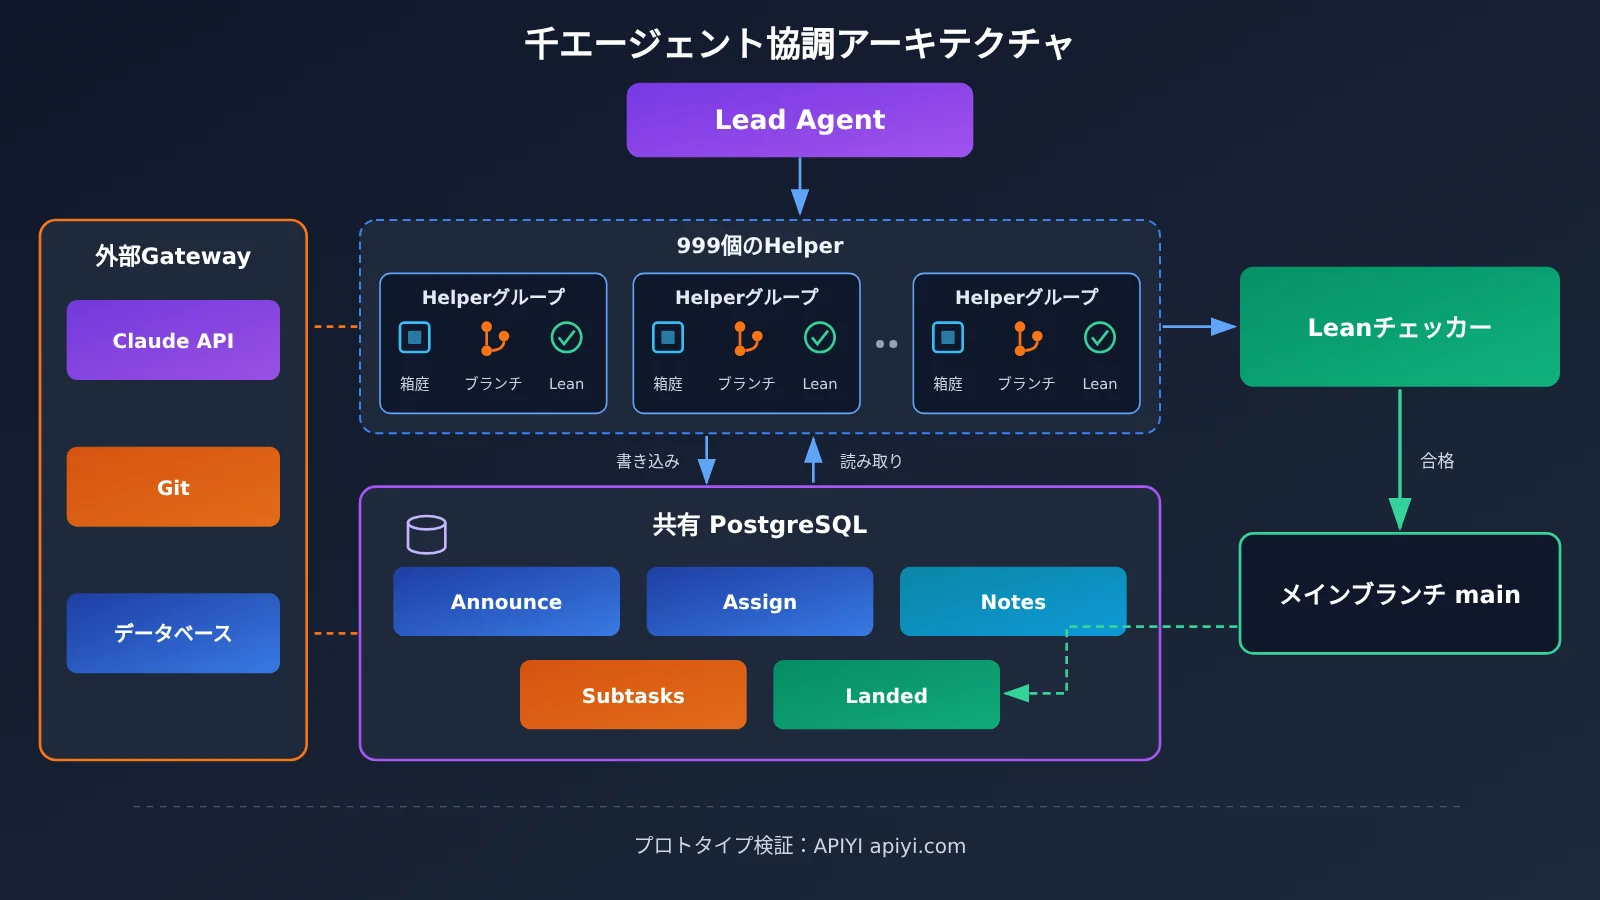
チームはシンプルな階層構造を採用しています。1体のLead Agentが全体計画、タスクの分割、進捗管理を担い、999体のHelper Agentが個別の証明を担当します。各エージェントには独立した軽量の仮想マシンサンドボックスが割り当てられ、Shell、ファイルエディター、Leanツールチェーン、Mathlibを利用できます。また、それぞれが独自のGitブランチを持ち、メインブランチにマージリクエストを送ることもできます。
すべてのエージェントはインターネットに直接アクセスできません。Claude API、Git、データベースとの通信は、すべて外部のGatewayを経由します。サンドボックスとブランチを分離することで、1000体のエージェントが同時にコードを変更しても、互いのファイルを上書きすることはありません。
共有 PostgreSQL:AI Agent の協業中枢
1000体の Agent が1対1のメッセージ交換で協力すると、通信量はすぐに制御不能になります。Lead Agent は、実験開始から10分以内に5つの共有データベーステーブルを作成し、やり取りを「同じ共有ボードへの読み書き」に置き換えました。
| テーブル名 | 役割 | 協業における機能 |
|---|---|---|
| Announce | チームへの指示を公開 | 全員への一斉通知。プロジェクトの掲示板に相当 |
| Assign | タスクと担当者を割り当て | 「誰が何をしているか」を明確にし、作業の重複を防ぐ |
| Notes | 進捗、問題、作業計画を記録 | コンテキストを共有し、情報の分断を減らす |
| Subtasks | 細分化したタスクを管理し、Agent が取得できるようにする | タスクプールとして、自主的なタスク取得を支える |
| Landed | 完了し、チェックに合格した作業を記録 | 検証済みの成果だけを登録する、信頼できる成果一覧 |
この仕組みの利点は、Agent がほかの999体に個別に連絡しなくても、データベースを確認するだけで、どんなタスクがあるか、どれが完了したか、どれに依存関係があるかを把握できることです。成果は Git でメインブランチにマージされます。公式発表によると、プロセス全体でデータベースへの書き込みは約36,612回、読み取りは約311,734回に上りました。このうち約20,600回の書き込みが Notes、約14,800回が Subtasks へのものでした(大半のスクリプト呼び出しは集計対象外)。読み取りが書き込みを大きく上回っていることからも、Agent の多くの時間が「全体の状況確認」に費やされていたことがわかります。
動的なタスク分配:固定の割り当てから自発的なタスク獲得へ
今回の実験では、タスクの割り振り方が終始同じだったわけではありません。次のタイムラインから、チームの運営方法がどのように変化したかが分かります。
| 時点 | 主な出来事 |
|---|---|
| 10分 | Lead が共有データベースのテーブルを5つ作成 |
| 約27分 | 3つの命題を証明 |
| その後 | Lead は、制限時間内の完了が難しいと判断した47の命題をいったん保留し、残りの10の命題に人員を集中 |
| 約70分 | 10の命題をすべて完了。Lead は Agent を再配置し、より難しい命題に取り組ませる |
| 約3時間 | Lead が、空いている Agent が割り当てを待たずに自分でタスクを引き受けることを許可 |
| 5.6時間 | 73の Helper が756件のタスクを作成 |
| 約18時間 | 前回保存した状態から実行を再開し、その後12時間にわたって続行 |
| 28.4時間 | ラングランズ–タネルに関連する命題が完了 |
| 28.7時間 | フェルマーの最終定理を完了し、公式カーネルのチェックに合格 |
注目したい点が2つあります。1つ目は、「Lead による割り当て」から「Agent による自発的なタスク獲得」への移行です。これは、チームの運用が集中管理からタスクプール方式に切り替わったことを意味し、Lead がボトルネックになるリスクを抑えています。2つ目は、実験が約18時間後に保存状態から再開されていることです。そのため、28.7時間という時間は、すべての Agent が最初から最後まで一度も中断せず稼働したことを意味するわけではありません。
また、いったん保留された47の命題は、入力としてあらかじめ与えられた47個の補題とは別のものです。公式資料を読む際は、混同しないようにしてください。
Langlands–Tunnell:750体のAgentがフェルマーの最終定理の形式化における最難関に挑む
ゴールが近づくなか、チームは最も難しい課題に直面しました。Wilesの証明戦略における重要な数学的結果、Langlands–Tunnell関連の命題です。この部分を初期に担当したAgentは、Leanのコードが70万〜100万行必要になる可能性があると見積もり、残り時間内に完了できる確率は1%未満だと考えていました。
その後、Leadは約750体のHelperをこの課題に集中させました。Agentたちは自ら、多層構造のタスクツリーを構築しました。
- 10の主要領域に分割
- 合計2,418個のサブタスクを作成
- タスクツリーは最大10階層
- 数百体のAgentが異なるサブタスクを同時に処理
その結果、Langlands–Tunnellは開始から28.4時間後に完成し、その0.3時間後にはフェルマーの最終定理も完成しました。この事例が示しているのは、大規模並列化の価値は単に「人数が多ければ計算が速い」ということではない、という点です。より重要なのは、すぐには取り組めないほど大きな問題を、独立して進められ、個別に検証でき、最後に統合できる小さなタスクへ分解することです。うまく分解できなければ、750体のAgentが互いに待ち合ったり、同じ作業を繰り返したりするだけになってしまいます。
フェルマーの最終定理の形式化はなぜ成功したのか:Leanによる検証と安全対策
エンジニアリングの信頼性という観点から見ると、今回の実験は3層の対策に支えられていました。
第1層は結果の検証です。 すべてのサブ命題は、主ブランチに提出する前にLeanのチェックを通過する必要がありました。Landed表には、チェックを通過した作業だけが記録されます。最終的な定理は公式カーネルチェッカーによって検証されました。Lead Agentが記録した言葉は、「Fermat’s Last Theorem is on main, kernel-checked by the official checker.」でした。
第2層は協業の分離です。 独立したサンドボックスとGitブランチを使うことで、Agent間のファイル競合や相互干渉を最小限に抑えました。
第3層は安全上の境界です。 実験では、正式リリース前のアラインメント評価が完了していない初期モデルを使用していたため、Anthropicは複数の制限を設けました。
- インターネットへのアクセスと、他のAgentのサンドボックスへの直接アクセスを禁止
- 非特権アカウントでコマンドを実行
- 外部Gatewayを通じて、API、Git、データベースとの通信を管理
- リアルタイム分類器がShellコマンドとファイル変更をチェックし、オフライン監視ツールが操作記録を再確認
実験では100万回を超えるツール呼び出しが行われましたが、遮断が必要なレベルに達したケースは一度もありませんでした。Anthropicによると、実験後には思考過程を並行して監視する仕組みも追加されています。ここから得られる教訓は、信頼できるAgentシステムかどうかは、モデルがタスクを完了できるかだけでは判断できないということです。独立した検証、権限の境界、そして追跡可能な実行環境も欠かせません。
11日から28.7時間へ:Claude Fable 5.2による2回の実験を比較
フェルマーの最終定理の形式化に関する2回の実験は、条件が異なるため、分けて見る必要があります。
| 指標 | 1回目(2026年9月に発表) | 2回目(2026年11月9日に発表) |
|---|---|---|
| モデル | 内部研究モデル(Fable 5.1とおおむね同等) | 初期版Fable 5.2 |
| Agent数 | 数十個 | 1000個 |
| 実行時間 | 11日 | 28.7時間 |
| 出力トークン数 | 約60億 | 公式発表では1回目の約3分の1まで減少 |
| 証明の長さ | 基準値(Leanコード約1300万行) | 1回目の約7分の1 |
| 協調プラットフォーム | Prove2Me + Claude CodeのマルチAgent Harness | 汎用ツール + PostgreSQL |
| 人間による指導 | 研究者のTianyi Pengが少量の高レベルな指導を提供 | 数学的な過程への継続的な指導なし |
60億トークン、1300万行のコード、約30,300個の定理という数字は、いずれも1回目の実験のものです。2回目の実験については、トークン数の絶対値、総費用、正確なコード行数は公式に発表されていません。
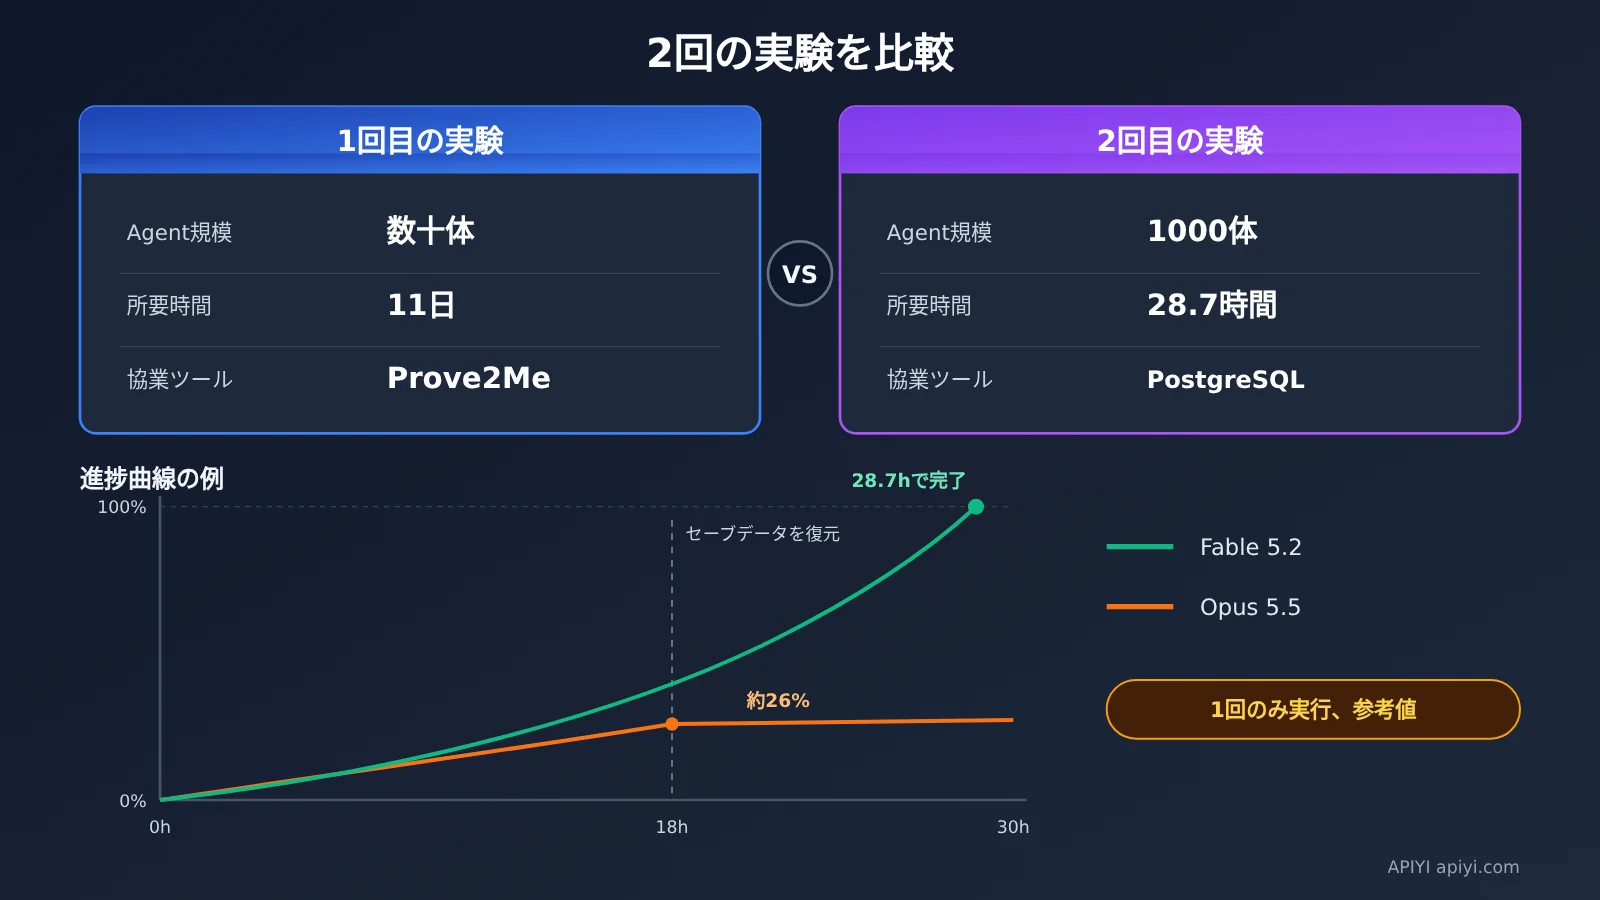
1回目の実験も、当初は試行錯誤がありました。Agentは全体の状況を把握するのが難しく、ほかのAgentが何を終えたのか分からず、作業の重複が発生していました。その後導入されたProve2Meプラットフォームは、DAGを使って定理の依存関係を管理し、タスクの状態確認、定理の検索、コンパイルの高速化を可能にしました。2回目では、こうした専用プラットフォームを使わず、汎用データベースとGitを使ってAgent自身が協調の仕組みを構築しました。5つのテーブルが、同様の役割を担っています。
Anthropicは、同じ1000 Agentの設定で比較実験も行いました。Opus 5.5は18時間で約26%を完了し、その後30時間までほとんど進展がありませんでした。一方、Fable 5.2は28.7時間で最終定理を完成させました。どちらの実験も、約18時間の時点で保存状態から再開しています。ただし、各モデルの実行は1回のみです。この結果から、あらゆる複雑なタスクで両者に普遍的な性能差があるとは結論づけられません。
1000個のAI Agent実験が企業に与える影響
開発者向け:マルチエージェントシステムに必要な4つの能力
数学的な背景を取り除いて考えると、今回の実験で明らかになった能力は、よくある企業の業務に当てはめられます。
| 能力 | 実験での具体例 | 企業での活用例 |
|---|---|---|
| 複雑なタスクの分解 | 2,418個のサブタスク、最深10階層のタスクツリー | 大規模なコードのリファクタリング、複雑な調査レポート |
| 動的なリソース配分 | 難題をいったん保留し、750個のHelperを集中投入 | 優先度に応じたAgentと計算リソースの再配分 |
| 共有状態の管理 | 5つのPostgreSQLテーブルとGitによるマージ | タスク管理ボードの一元化、重複作業の削減 |
| 結果の独立検証 | Leanカーネルによる各コミットのチェック | 単体テスト、データ検証、人によるレビュー |
開発者にとって最も参考になるのは、最初から複雑な専用プラットフォームを構築する必要はないという点です。適切に設計された共有データベースとバージョン管理があれば、かなり大規模な共同作業を支えられます。以下は、モデル呼び出しの最小限の例です。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIの統一インターフェース
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # モデル名はプラットフォームのモデル一覧に準拠
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
Lead / Helperのタスクプールを示すコードを見る
import sqlite3
import openai

# ローカルではSQLiteを使って実験のSubtasks / Landedテーブルを再現します(実験ではPostgreSQLを使用)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead:タスクを分解してタスクプールに登録します"""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """独立検証器:実際の用途ではテスト、検証スクリプト、またはLeanチェックに置き換えてください"""
    return len(result) > 0

def helper_claim(name: str):
    """Helper:タスクを自発的に引き受け、検証に合格した場合のみlandedに登録します"""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 手早く試すには:「Leadによる分解+Helperによる引き受け+独立検証」の小規模なプロトタイプを再現したい場合は、まずAPIYI(apiyi.com)で無料のテスト枠を利用できます。OpenAI互換のインターフェースを提供しており、1つのAPIキーでClaude、GPT、Geminiなどのモデルを切り替えられます。Lead役に使うモデルごとのタスク分解の質も、手軽に比較できます。
業界にとって、数字よりも重要なのは適用範囲
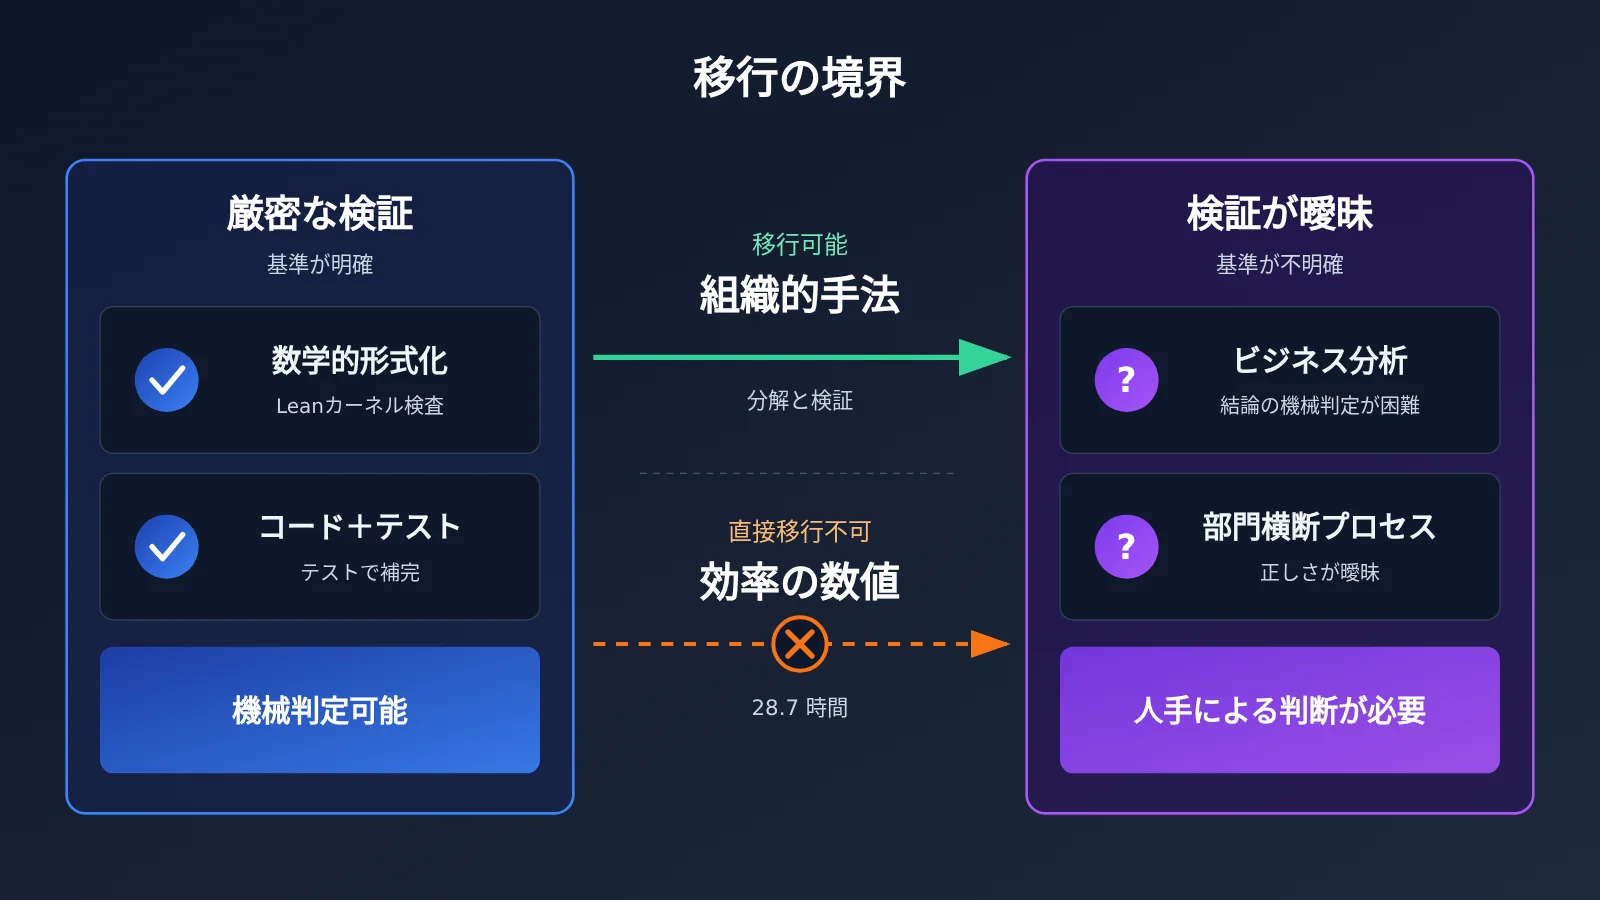
冷静に考えるべき点があります。数学の形式化にはLeanのような厳密で客観的な検証器がありますが、多くの企業業務には、同じように明確な正解の基準がありません。コードならテストで確認できますが、市場分析や部門横断の業務プロセスでは、「正しいかどうか」を機械で判定するのが難しい場合が少なくありません。そのため、28.7時間という数字や今回の成功率を、企業のAgentシステムにそのまま当てはめることはできません。
Anthropic自身も、いくつかの限界を挙げています。Agentはタスクを完了できないと早合点しやすく、初期段階で保留された47個の命題の大半は、後に証明されました。また、難しい局面では人間による進む方向の助言が依然として役立ちます。さらに、Prove2Meのような分野特化型ツールによって、コンパイル、検索、協業の効率が今後も向上する可能性があります。この実験が示しているのは、Agentの数は多いほどよいということでも、人間の専門家や専用Harnessがもう必要ないということでもありません。
💡 エンジニアリング上のアドバイス:企業でマルチAgent構成を試す際は、まずテスト駆動のコード改修など、明確な検証基準があるタスクを選び、段階的に適用範囲を広げるのがおすすめです。APIYI(apiyi.com)の従量課金を活用すれば、少数のAgentでタスク分解と検証の工程を評価してから、投資を拡大するかどうか判断できます。
よくある質問(FAQ)
Q1:今回の実験で、AIがフェルマーの最終定理を証明したのですか?
いいえ。フェルマーの最終定理は、1995年に Wiles が正式に証明を発表しました(重要な問題の修正には Taylor が協力しています)。今回の実験では、60個の命題、証明方針の概要、定義、すでに証明済みの47個の補題が与えられた状態で、既存の証明方針を Lean で検査できる形式的な証明に変換しました。
Q2:60個の命題のうち、証明済みとされたのが54個だけなのはなぜですか?
30時間時点の集計では、代替命題のうち5個は後に不要となり、別の1個は放棄されました。最終定理はすでに28.7時間時点で検証に通っており、当初挙げられた60個の命題をすべて完成させる必要はありませんでした。
Q3:Claude Fable 5.2 の API 料金はいくらですか?
公式価格は、入力が$8/百万Token、出力が$40/百万Tokenです。Fast Mode ではそれぞれ$16と$80、キャッシュ読み込みは$0.20/百万Tokenです。Batch API は50%割引で、コンテキストウィンドウは1M Token、最大出力は128K Tokenです。2回目の実験の総費用は公式には公表されていないため、1回目の60億 Tokenに単価を掛けて見積もることはできません。
Q4:APIで Claude Fable 5.2 を手軽に試すにはどうすればよいですか?
APIYI apiyi.com に登録して APIキーを取得し、base_url に `https://api.apiyi.com/v1` を設定すれば、この記事のサンプルコードをそのまま利用できます。新規ユーザーには無料のテスト枠があるため、まずは小規模なマルチAgentのプロトタイプを試すのに適しています。
Q5:マルチAgentシステムには、必ず PostgreSQL が必要ですか?
必ずしも必要ではありません。重要なのは、すべてのAgentが読み書きできる共有状態の保存先に加え、バージョン管理と独立した検証の仕組みを用意することです。小規模なプロトタイプなら、SQLite や Redis で十分です。APIYI apiyi.com 経由でモデルを呼び出す場合、状態の保存はご自身のシステムで管理するため、自由に組み合わせられます。
Q6:今回の実験には、どのような既知の限界がありますか?
公式は今回の取り組みを「toy experiment」と明確に位置づけています。Fable と Opus の比較実験はそれぞれ1回ずつしか実施されていません。また、使用されたのは初期モデルであり、多層的な安全対策が必要でした。Agentが誤ってタスクを早々に放棄したこともあり、人間による指導や分野に特化したツールにも依然として価値があります。
1000体のAIエージェントによるフェルマーの最終定理の形式化:押さえておきたいポイント
- 実験の本質:既存の証明をLeanで検証可能なコードに形式化したものであり、フェルマーの最終定理を初めて証明したわけではありません。
- 主な数字:初期版のFable 5.2を搭載した1000体のエージェントが、28.7時間で作業を完了し、Leanの公式カーネルによる検証にも合格しました。
- 組織の中核:1体のLeadと999体のHelperが、5つの共有データベーステーブルとGitを使って協調しました。
- 難所の攻略法:約750体のエージェントがLanglands–Tunnellを2,418個のサブタスクに分割し、最大10層の階層で処理しました。
- 信頼性の基盤:Leanによる独立検証とサンドボックスによる隔離により、100万回を超えるツール呼び出しを介入なしで実行しました。
- 適用範囲の限界:企業のタスクにはLeanのような検証器がない場合が多く、この効率を示す数値をそのまま当てはめることはできません。
- 始め方:APIYI(apiyi.com)の統一インターフェースを使えば、LeadとHelperが連携する小規模なプロトタイプを再現できます。
まとめ
Claude Fable 5.2を使った今回の千エージェント実験から、押さえておきたいポイントは次のとおりです。
- システム全体の力が重要:モデルの能力、タスク分解、共有状態、並列実行、機械による検証が組み合わさり、28.7時間での完了につながりました。
- 検証が信頼の土台:Leanカーネルによる検査によって、「モデルが完了したと主張すること」と「実際に完了していること」を厳密に区別できます。
- 適用範囲を明確にする:入力があらかじめ用意されていること、初期版のモデルが使われていること、比較実験が1回であること、そしてトイ実験として位置づけられていることから、結果を過大評価すべきではありません。
この実験は、今後のAIシステムの競争が、単一モデルの能力から、複雑なタスクを大勢のエージェントに実行させる組織力や調整力へと移っていくのか、という問いを業界に投げかけています。開発者なら、独立した検証機能を備えた小規模なマルチエージェントのプロトタイプから、今すぐ試してみることができます。APIYI(apiyi.com)なら、無料のテスト枠と複数モデルの統一インターフェースを利用して、手軽に効果を確かめられます。
📚 参考資料
- Anthropic エンジニアリングブログ:Safely scaling multi-agent teams with Claude Fable 5.2
- リンク:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
内容:2回目の実験における組織構成、データベース連携、安全対策、Opusとの比較
-
Anthropic 研究記事:Formalizing Fermat’s Last Theorem
- リンク:
anthropic.com/research/formalizing-fermats-last-theorem -
内容:1回目の形式化実験のデータと、Prove2Meとの連携方法
-
Anthropic公式 Lean 証明リポジトリ:第1版の形式化証明
- リンク:
github.com/anthropics/fermats-last-theorem -
内容:公開されている9月版の証明コード。READMEのデータは11月の実験統計とは異なります
-
Lean公式ユースケース:Formalizing Fermat’s Last Theorem
- リンク:
lean-lang.org/use-cases/flt -
内容:Leanと形式数学の背景を理解するための資料
-
Fable 5.2 モデルドキュメント:モデル仕様とAPI移行
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview - 内容:コンテキストウィンドウ、出力上限、料金に関する情報
著者:APIYI 技術チーム
技術交流:APIYIのトップページからお気軽にお問い合わせください。詳細はdocs.apiyi.comのドキュメントをご覧ください。