著者注:公式スコアと公式の制限に基づき、Claude Fable 5.2の強み、どこまで任せられるのか、そしてOpus 5.5から切り替えるべきでないケースを解説します。
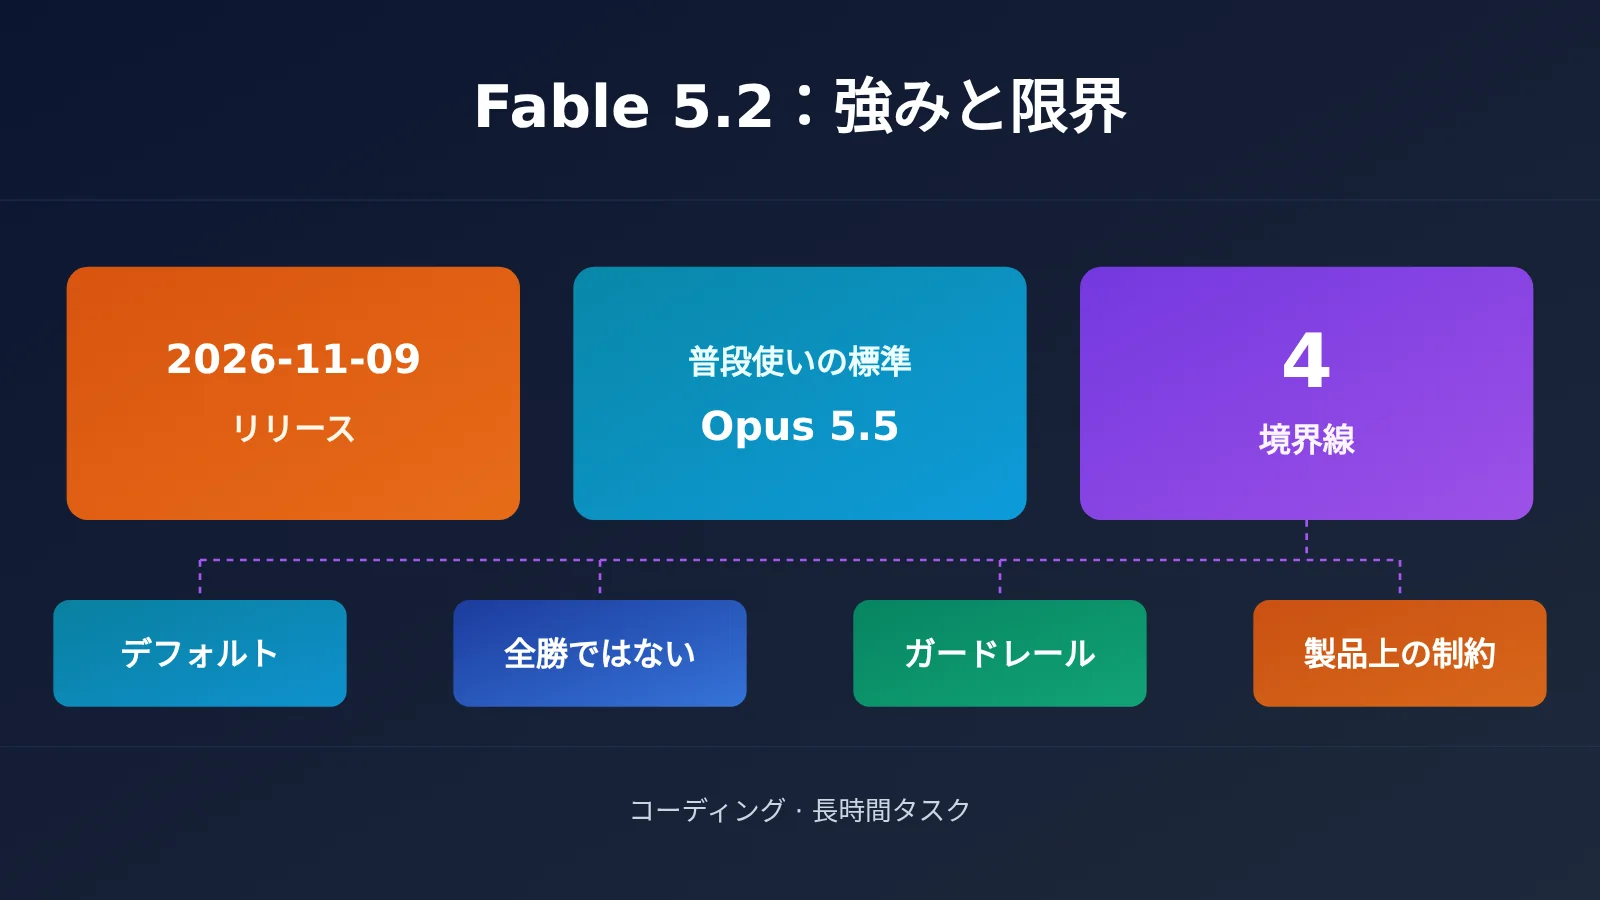
Claude Fable 5.2は、Anthropicが2026-11-09にリリースした技術分野向けのフラッグシップモデルです。Anthropicは、ほとんどのコーディングや知識労働では、引き続きOpus 5.5から始めることを推奨しています。Fable 5.2が適しているのは、規模が大きく、自由度が高く、長時間にわたる技術的な作業です。
この記事は、単なるランキングの紹介ではありません。 スコアはすべてAnthropicが2026-11-09のリリース記事で公開したもの、制限は公式のモデルページと更新情報に基づいています。読み終えると、4つの境界がわかります。明らかに優れている領域、必ずしも勝っているわけではない領域、安全策によって制限される領域、そして製品の仕組みによって制約される領域です。
この記事のポイント:すでにClaude APIを利用している方が、Opus 5.5からFable 5.2にアップグレードすべきか、また切り替え後に料金や呼び出しパラメーターをどう変更すべきかを判断するための情報をまとめています。
Claude Fable 5.2の要点
まず、よく聞かれるポイントを表にまとめます。数値はすべて公式のモデルページとリリース記事に基づいており、2026-11-10に確認しています。
| 要点 | 公式情報 | 何を意味するか |
|---|---|---|
| 位置づけ | 技術分野向けのフラッグシップ。規模が大きく、自由度の高い技術的な作業に適している | 日常的に使う標準モデルではありません。普段使いには引き続きOpus 5.5が適しています |
| Mythosとの関係 | 同じ基盤モデルですが、Fableはより強力な安全対策を備え、すべてのユーザーが利用できます | Mythosは、別のより強力なモデルというわけではありません |
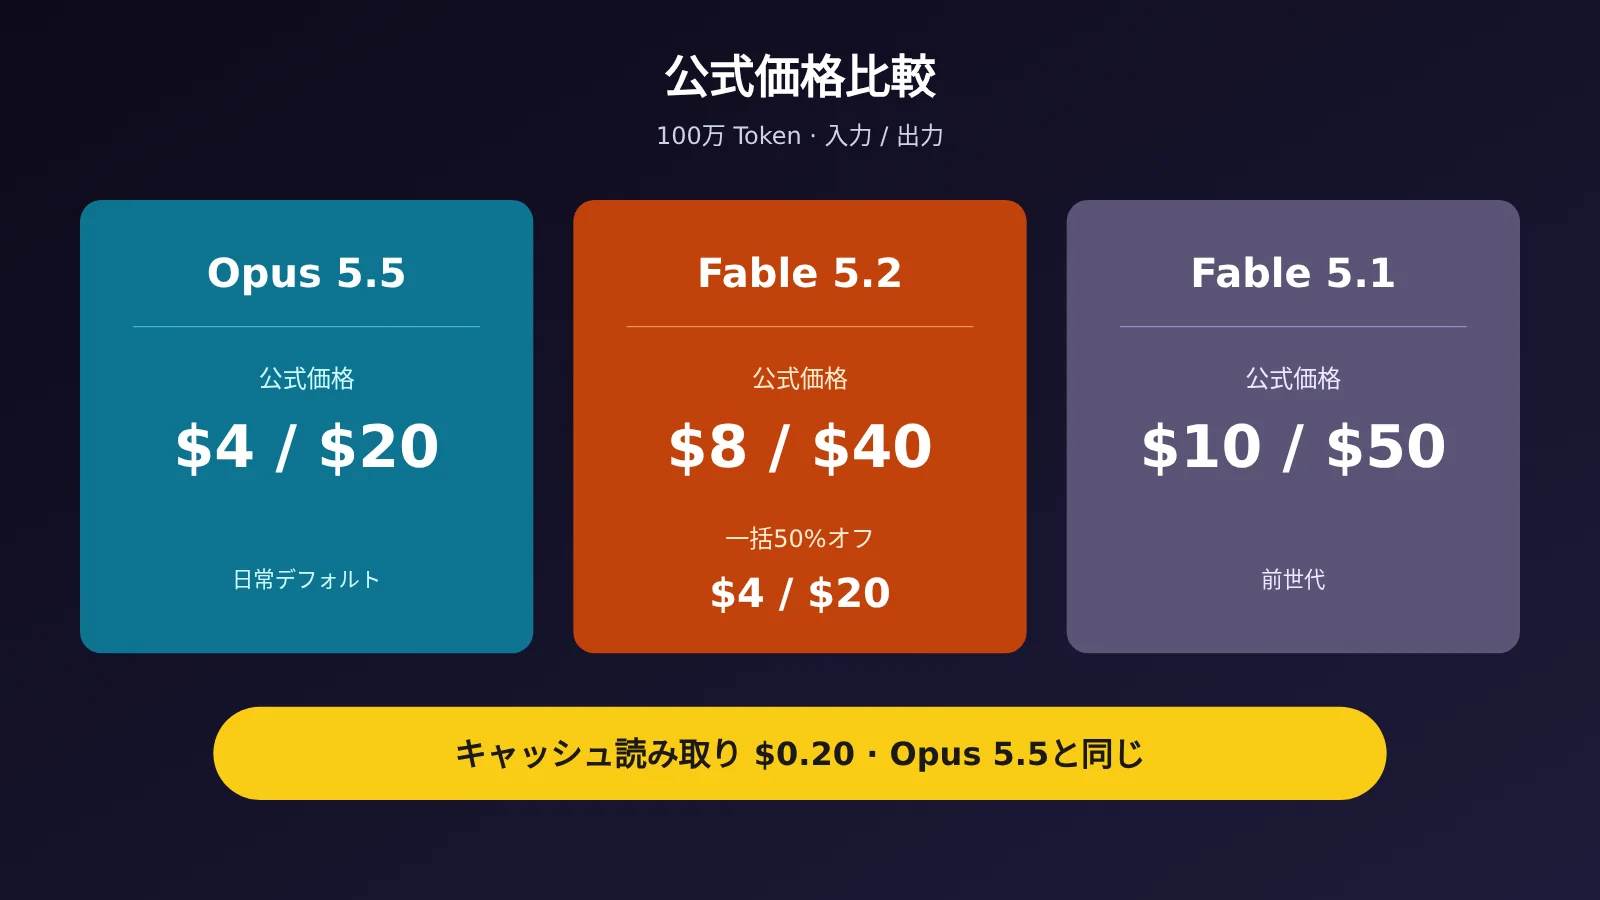
| 標準料金 | 入力は$8、出力は$40(100万トークンあたり) | Opus 5.5の2倍、Fable 5.1より20%安い料金です |
| 思考 | 適応型思考が常に有効で、無効にはできません | 思考を抑えたい場合は、effortを調整します |
| データ保持 | デフォルトで30日間の保持が求められます | データを一切保持しない必要がある場合は、事前に利用許可を確認してください |
Claude Fable 5.2とMythos 5.2の関係
リリース記事には、Claude FableとClaude Mythosは同じ基盤モデルだと明記されています。違いは、Fableのほうがネットワークセキュリティとバイオセキュリティの安全対策を強化している点です。そのため、すべてのユーザーが利用できます。一方、Mythosを利用できるのは、ライフサイエンスまたはネットワークセキュリティの審査プログラムを通過した組織に限られます。料金はどちらも同じです。
つまり、「Mythosのほうが強力」というのは誤解です。リリース記事にあるネットワークセキュリティやバイオセキュリティ関連の実績のうち、CyScenarioBenchの76.3%など、いくつかのスコアはClaude Mythos 5.2のものです。これらは同等の安全対策を備えていないMythosのスコアであり、Fableの実績として扱うことはできません。一般のAPIユーザーが利用できるのは、Claude Fable 5.2です。
Claude Fable 5.2の仕様と公式価格
以下の表では、公式モデルページに掲載されている3モデルを比較しています。Fable 5.1の完全な仕様は今回確認できなかったため、価格情報のみ後半に記載します。
| 仕様項目 | Claude Fable 5.2 | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| コンテキスト | 1M token | 1M token | 1M token |
| 最大出力(同期 Messages API) | 128K | 128K | 128K |
| 標準価格(入力 / 出力) | $8 / $40 | $4 / $20 | $2 / $10 |
| レイテンシの段階 | Moderate | Moderate | Fast |
| Claude APIのデフォルト effort | high | medium | high |
| 知識のカットオフ | 2026年6月 | 2026年6月 | 2026年6月 |
Fable 5.2はテキストと画像を入力として受け取り、テキストを出力します。モデルページでは、1M tokenは約55.5万語または250万Unicode文字に相当するとされています。これは現行のトークナイザーに基づく換算であり、中国語のテキストを必ずこれだけの量まで入力できることを意味するわけではありません。
注意点として、Message Batches APIでは、一部のモデルでベータ版ヘッダーを使うと出力上限を300Kまで引き上げられます。Opus 5.5は対象モデルに含まれていますが、このリストにFable 5.2の記載はありません。公式から追加情報が出るまでは、長い出力を計画する際は128Kを上限として見積もってください。
公式価格のその他の項目は、100万tokenあたり次のとおりです。
- キャッシュ:5分キャッシュへの書き込みは$10、1時間キャッシュへの書き込みは$16、キャッシュからの読み取りは$0.20です。キャッシュ読み取りの価格は、標準入力価格の0.025倍です。
- バッチ処理:入力・出力ともに50%割引です。Fable 5.2のバッチ価格は、入力が$4、出力が$20です。
- 高速モード:同じモデルを利用でき、知能はそのままに、出力速度が標準モードの最大2.5倍になります。価格は入力が$16、出力が$80です。Opus 5.5の高速モードは$8 / $40です。
- 高速モードのキャッシュ:ドキュメントには個別の価格表がなく、キャッシュの倍率は高速モードの価格に上乗せされるとだけ記載されています。倍率から計算すると、キャッシュ読み取りは約$0.40、5分キャッシュへの書き込みは約$20、1時間キャッシュへの書き込みは約$32です。
- 高速モードの指定方法:Claude APIでは
speedフィールドにfastを指定します。Microsoft Foundryでは、末尾に-fastが付いた別のモデルIDを使います。リクエストにspeedを指定する必要はありません。
もうひとつ注意したいのが、速度の異なるモード間でプロンプトキャッシュは共有されないことです。高速モードから標準モードに戻すと、キャッシュミスが発生します。リリース情報に記載された高速モードの提供先にAmazon Bedrockは含まれていませんが、標準モデルはBedrockで利用でき、IDはanthropic.claude-fable-5-2です。
Claude Fable 5.2の公式ベンチマーク結果
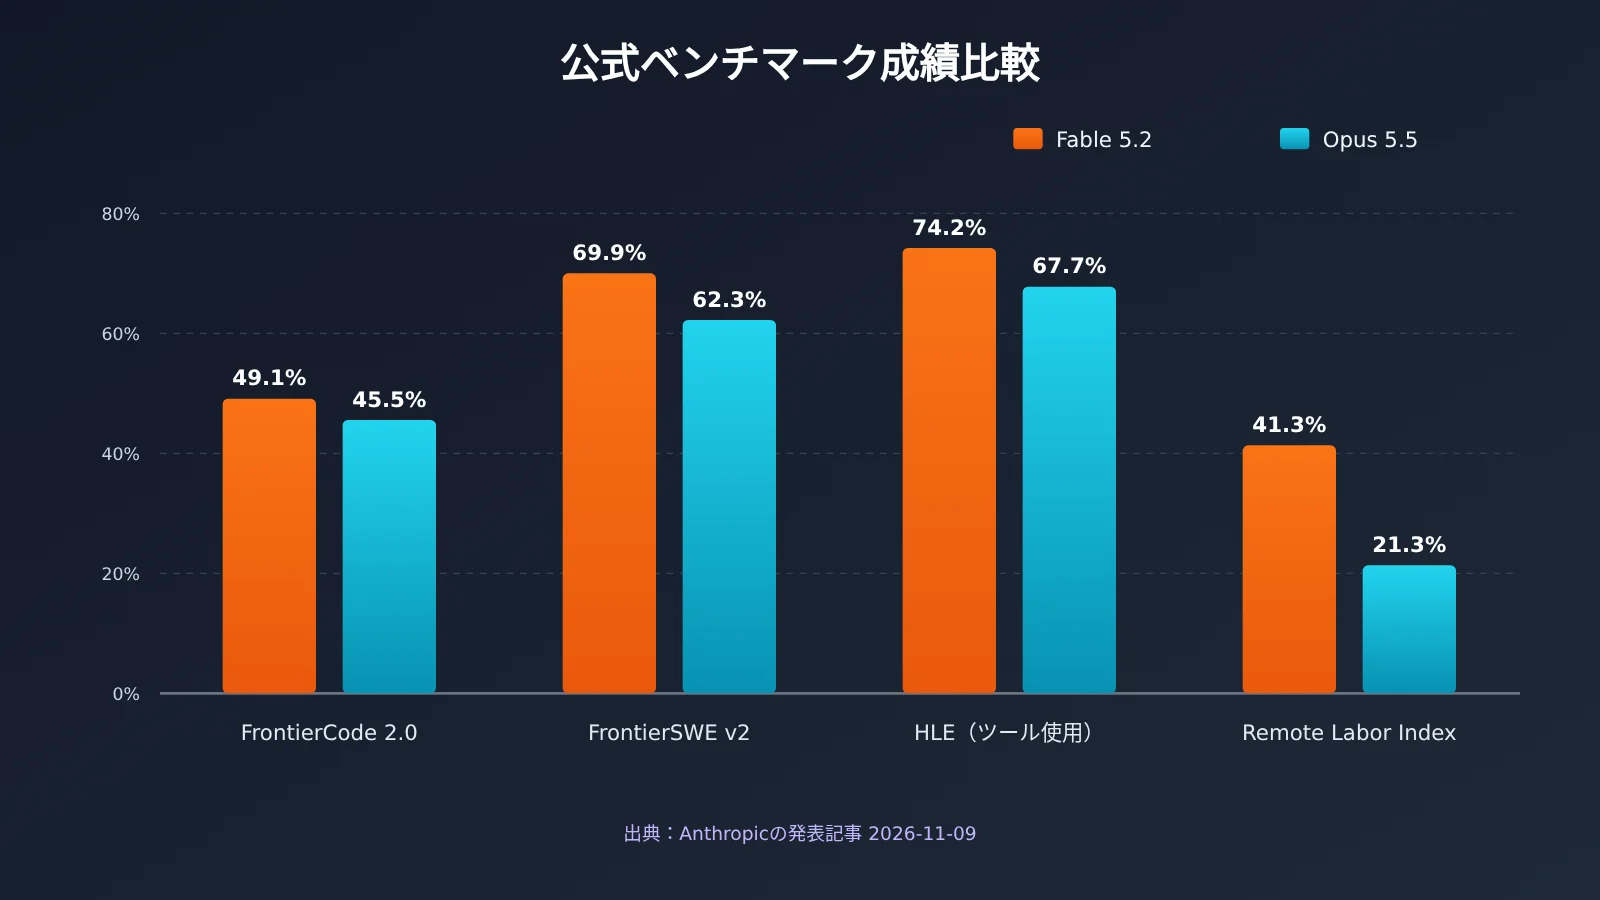
Fable 5.2の強みをよく表しているのが、次の4つの数値です。いずれもAnthropicが2026-11-09の発表で公開したもので、特に注記がない限り、Fable 5.2、Fable 5.1、Opus 5.5のスコアはガードレール有効時の結果です。スコアの算出条件として、注記のあるものを除き、各モデルで当時利用できた最高の推論努力レベルを使用しており、デフォルト設定ではありません。
| ベンチマーク | Fable 5.2 | 推論努力レベルの注記 | Opus 5.5との比較 |
|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 表ではXhighレベルと注記 | 45.5%(表の標準条件。最高の推論努力レベル) |
| FrontierSWE v2 | 69.9% | 注記なし。最高の推論努力レベル | 62.3%(最高の推論努力レベル) |
| Humanity’s Last Exam(ツール使用) | 74.2% | 注記なし。最高の推論努力レベル | 67.7%(最高の推論努力レベル) |
| Remote Labor Index | 41.3% | 表ではHighレベルと注記。最高レベルではない | 21.3%(最高の推論努力レベル) |
Claude Fable 5.2のコーディング成績をどう見るか
FrontierCodeは、変更がオープンソースリポジトリのメンテナーにマージされるかどうかを測るベンチマークです。テストに通るかどうかだけを見るより、実際の開発現場に近い指標といえます。Xhighでは49.1%を記録し、Anthropicがテストしたリリース済みモデルの中で最高の水準です。リリース記事では、さらに実用的な数字も示されています。HighのFable 5.2は約45.3%で、Opus 5.5の最高値である45.5%とほぼ同じながら、タスクあたりのコストはおよそ半分です。
この点は、コストを計算する人にとって重要です。Fable 5.2の価値は「最高設定でより高い成績を出す」ことだけではなく、Highでも、より少ないトークンで同じタスクをこなせる可能性があるということです。ただし、これはあくまで公式がこのベンチマークで示した結果です。自分のリポジトリで同じ成果が出るかどうかは、実際に検証する必要があります。
Remote Labor Indexでは、差が最も大きく、Fable 5.2は41.3%、Opus 5.5は21.3%でした。しかも、Fable 5.2の数値は最高設定ではなく、Highでの結果です。このベンチマークは、リモートで完結する一連の業務に重点を置いており、「自由度が高く、長時間かかる技術作業」という位置づけにも合っています。
Claude Fable 5.2の長時間タスク事例は、単発の実験として捉える
リリース記事には目を引く事例がいくつかあります。読むときは、誰が実行したのか、何回試したのかを区別しておきましょう。
- プロトタイプのOS:あるエンジニアがFable 5.2に空のフォルダーから作業を始めさせ、1000を超えるサブエージェントを連携させて約8日間連続で実行し、ノートPCで起動できるシステムを作りました。リリース記事には反復実験とは書かれていないため、単発の公式実験として見るべきです。
- フェルマーの最終定理の形式化:Fable 5.2のエージェント1000体を30時間稼働させ、人間の介入はごくわずかでした。同じ設定では、Opus 5.5は18時間で約26%を完了し、30時間後にはほとんど進展しなくなりました。図注によると、各モデルの実行は1回のみです。
- PythonからRustへの移行:重要な本番サービスをRustに移行し、起動を約26倍高速化したのは、リリース版の5.2ではなく、それ以前のバージョンのFable 5.2エージェント群です。
- 変更の90%超をマージ:リリース記事によると、ある中核コードベースでマージされた変更の90%超は、指導を受けながらClaudeが作成しました。ここでの主語はClaudeであり、Fable 5.2だけを指しているわけではありません。
これらの事例は、どこまでできるかを示していますが、安定した成績を保証するものではありません。業務で「数日間連続して稼働させる」ことを前提にするなら、自分で再現して確かめる必要のある仮説として扱いましょう。
Claude Fable 5.2の4つの境界
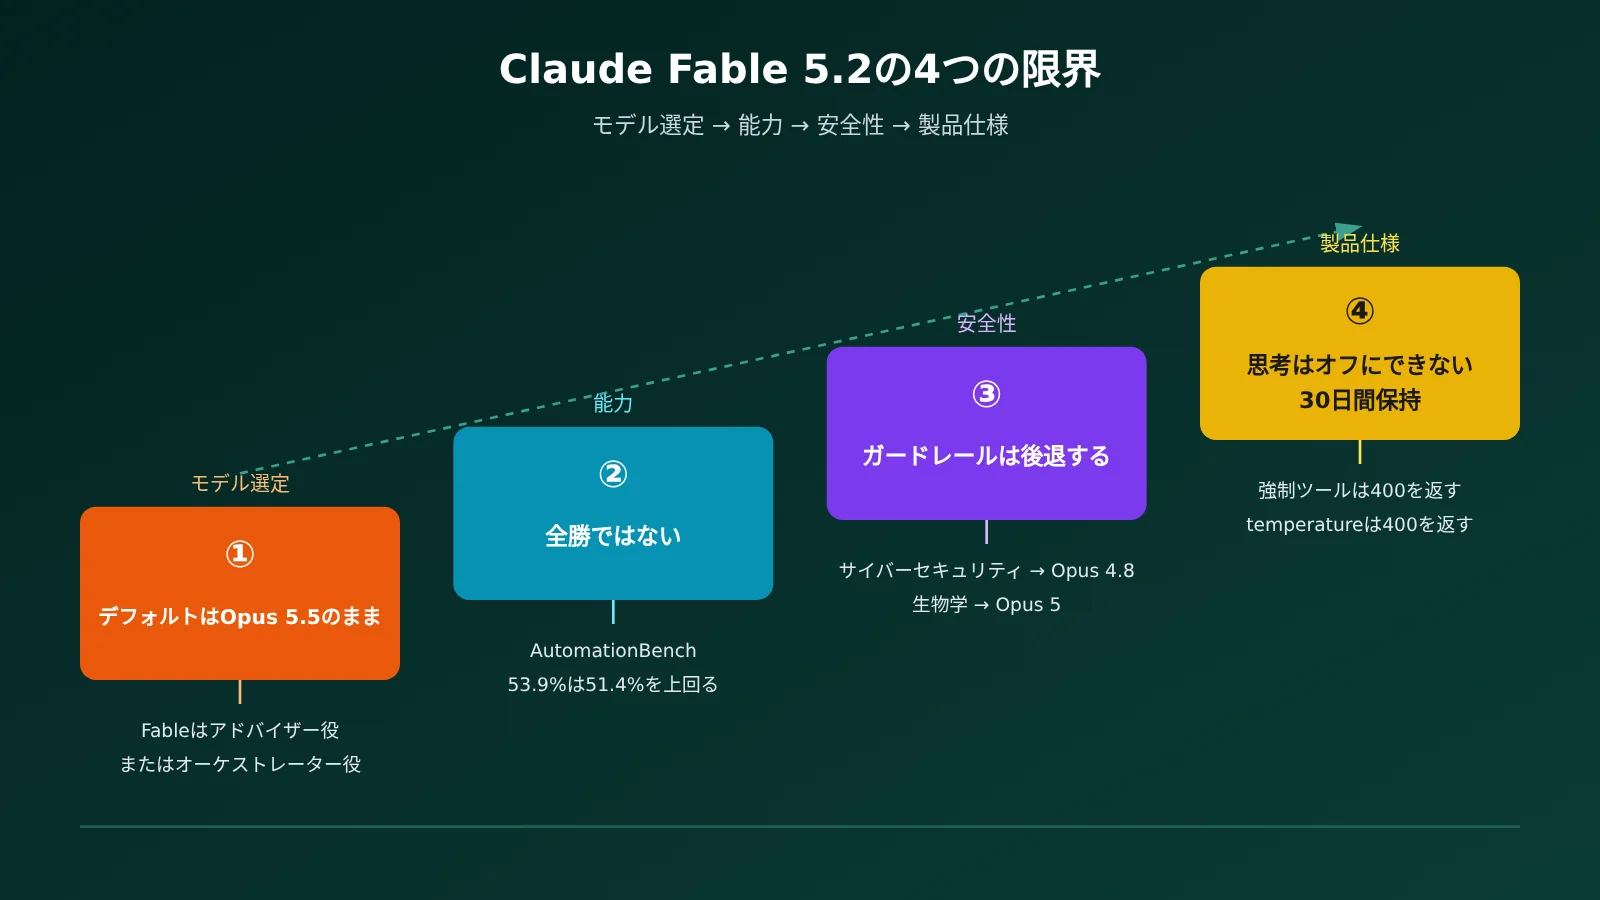
成績からは得意分野がわかります。ここでは、どこまでが得意で、どこから先は任せるべきでないのかを、次の4点に分けて見ていきます。「モデル選び → 能力 → 安全性 → 製品の仕組み」の順です。
境界1:Claude Fable 5.2は日常使いの既定モデルではない
リリース時の推奨は、ほとんどのコーディングや知識労働では、まずOpus 5.5を使い、難易度に応じてFableやMythosに切り替えるか、Sonnet 5.5やHaiku 5.5に切り替えるというものです。Fable 5.2が最も適しているのは、規模が大きく自由度の高い技術タスクです。
コストを抑える使い方も2つあります。1つ目はアドバイザーとして使う方法です。より小さなモデルが難しい問題に直面したとき、Fableに相談します。2つ目はオーケストレーターとして使う方法です。Fableにタスクを分解させ、簡単な部分をより小さなモデルに任せます。こうすれば、高価なトークンを最も難しい工程だけに使えます。
境界その2:Claude Fable 5.2の成績は全勝ではない
発表時に比較対象として挙げられているのはGPT-6 AstraとGemini 4 Carbonです。この表はAnthropicが実施したもので、OpenAIやGoogleが自社で公開したランキングではありません。しかも、この表の中でもFable 5.2が負けている項目があります。
| ベンチマーク | Fable 5.2 | 最高スコア | 説明 |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | この項目ではCarbonが上回る |
| AA-Briefcase v1.1 Elo | 1785 | Opus 5.5 1800 | EloではOpusが上回る |
| AA-Briefcase v1.1 ルールスコア | 66.1% | Fable 5.2 | Opus 5.5は61.2% |
| Chartography(ツールなし) | 73.4% | Fable 5.2 | Carbonは72.5%、Astraは71.0%。差はわずか |
AA-Briefcaseの結果は、少し掘り下げて見る価値があります。ルールスコアではFableが上回る一方、EloではOpusが上回っています。これは、主観的な好みに左右されやすい評価では、より高価なモデルが必ずしも好まれるとは限らないことを示しています。ブリーフィングの作成や文書を扱う知識労働が目的なら、Opus 5.5は単なる妥協案ではありません。
境界その3:Claude Fable 5.2の安全ガードレールは回答モデルを切り替える
安全分類器によってブロックされた場合、Fable 5.2は回答を返さずに終わるわけではありません。サイバーセキュリティ関連の質問にはOpus 4.8、生物関連の質問にはOpus 5が代わりに回答します。拒否されたリクエストでもHTTP 200が返り、stop_reasonはrefusalになります。コードではステータスコードだけでなく、このフィールドを見て判定する必要があります。出力前の拒否が課金対象になるかどうかは拒否のカテゴリによって異なりますが、いずれの場合もレート制限の枠は消費します。
もう一つ、見えにくい制限があります。AI研究開発に直結する能力は、意図的に制限されています。アクセラレーターカーネルの最適化と大規模言語モデルのアーキテクチャ改善という2種類のタスクでは、おおむねOpus 5.5と同程度の水準にとどまります。一部のテーマ(特定の非標準アクセラレーター向けカーネル開発など)では、推論時にOpus 5へ自動的に切り替わりますが、これは呼び出しの失敗ではありません。エージェントによるコーディング、ハードウェア開発、従来型の機械学習研究は、この制限の対象外です。
公式の初期テストによると、claude.ai、Claude Code、CoworkでのFable 5.2のブロック率は、Fable 5.1と比べて約55%低下しました。分野別では、サイバーセキュリティ関連で約60%、生物関連で約40%の低下です。ただし、これは公式の初期テストであり、独立した再検証ではありません。
境界その4:Claude Fable 5.2の製品仕様には厳しい制約がある
以下の項目は、現在の呼び出しコードに直接影響します。移行前に一つずつ確認してください。
- 思考をオフにできない:適応型思考は常に有効です。
medium以上では、プロンプトに「考えずに、すぐ答えて」と書いても思考を止められません。思考を減らしたい場合は、effortを下げてください。 - ツールの強制指定は400エラーになる:
tool_choiceにanyまたはtoolを指定すると、エラーが返されます。 - サンプリングパラメーターは400エラーになる:
temperature、top_p、top_kは指定しないでください。 - データは30日間保持される:Anthropicから明示的な許可を得ていない限り、ゼロデータ保持は利用できません。Enterprise Frontier Safeguardsの対象となる企業は、導入前であればゼロデータ保持を利用できます。それ以外の顧客のデータは、安全性の監視のため30日間保持されます。
- 長いタスクは途中で止まることがある:1回の応答で止まり、未完了のタスクリストを残したり、続きを実行できると自分から伝えたり、特に問題のない障害で止まったりすることがあります。こうした傾向は
low設定でより多く見られます。ツール呼び出しが長く続く場合、ユーザー向けの説明がほとんどないこともあります。 - 思考ブロックには互換性の制限がある:Fable 5.2の思考ブロックを読み取れるのは、Fable 5.2とMythos 5.2だけです。Fable 5.2を実行役にする場合、アドバイザーにもFable 5.2またはMythos 5.2を使う必要があります。
また、リリース告知では、プロンプトに「コードの所有者」を明記するかどうかで、既存の構造を変更するか、新たに作り直すかが変わると注意喚起されています。スタイルのルールには忠実に従いますが、文の長さを厳しく制限しすぎると、出力が細切れになることがあります。
Claude Fable 5.2で今使えるモデルと、まだ提供されていないモデル
2026-11-10時点で、APIYI apiyi.comのモデル一覧と公開価格インターフェースを確認しましたが、どちらにも claude-fable-5-2 はなく、Mythosモデルも掲載されていません。このモデルは準備が整い次第、提供を開始します。モデルと価格は、プラットフォームのモデル一覧をご確認ください。
提供開始までは、日常の作業にはすでに利用できるOpus 5.5を使い、最も難しい工程にはFable 5.2を待つ方法があります。今すぐFableクラスの性能が必要な場合は、一覧にあるFable 5.1を利用できます。ただし、5.2とは別のモデルであり、性能や挙動にも違いがあります。
| モデルID | APIYI apiyi.comでの状況 | 表示価格(入力 / 出力 / キャッシュ読み取り、100万トークンあたり) | エンドポイント |
|---|---|---|---|
claude-opus-5-5 |
提供中(-thinking版もあり) |
$4 / $20 / $0.2 | chat、messages |
claude-fable-5-1 |
提供中(-thinking版もあり) |
$10 / $50 / $0.25 | chat、messages |
claude-fable-5-2 |
未提供 | 価格未定。プラットフォームのモデル一覧をご確認ください | — |
claude-mythos-5-2 |
未提供 | 価格未定 | — |
表中の金額はドル建ての表示価格です。実際の請求額にはトークングループ倍率が適用されるため、請求明細をご確認ください。Fable 5.2は一覧に掲載されていないため、倍率を掛けて算出できる価格もありません。公式価格からAPIYIの請求額を独自に推算しないでください。APIYIはOpenAI互換インターフェースを提供しており、base_url は https://api.apiyi.com/v1 です。1つのAPIキーでOpus 5.5とFable 5.1を切り替えられます。新規ユーザーには無料のテスト枠があるので、まずはご自身のリポジトリで両モデルの違いを比較できます。
Claude Fable 5.2のメリット・デメリットまとめ
メリット
- オープンエンドの長時間タスクで大きく向上:Remote Labor IndexのHigh設定では、Opus 5.5のほぼ2倍のスコアです。
- High設定のコストパフォーマンスが高い:FrontierCodeではHigh設定で約45.3%を記録し、Opus 5.5の最高スコアに並びます。1タスクあたりのコストは約半分です(公式発表)。
- 5.1より安く、さらに高速:標準価格は20%安く、リリース記事によると、出力速度は5.1より最大30%速くなっています。
- キャッシュ読み込みの料金が手頃:$0.20で、Opus 5.5と同じ価格です。
デメリット
- 標準価格はOpus 5.5の2倍:日常的なタスクで乗り換えると、料金がそのまま倍になります。
- すべてのベンチマークで勝っているわけではない:AutomationBenchではGemini 4 Carbonに負け、AA-BriefcaseのEloスコアではOpus 5.5に及びません。
- 安全策と性能の上限に制約がある:サイバーセキュリティや生物学に関する質問には旧モデルが使われます。カーネル最適化やモデルアーキテクチャの改善も、Opus 5.5から大きくは進んでいません。
- 呼び出し時の制約が多い:思考を無効にできず、ツールの強制指定やサンプリングパラメーターを設定すると400エラーになる場合があります。デフォルトでは30日間データが保持され、長時間のタスクが途中で停止することもあります。
よくある質問(FAQ)
Q1:Claude Fable 5.2とFable 5.1の違いは何ですか?
価格面では、5.2の標準価格は入力が$8、出力が$40で、5.1の$10 / $50より20%安くなっています。キャッシュ読み込みの料金も$0.25から$0.20に下がりました。ベンチマークでは、FrontierSWE v2が56.3%から69.9%に、Remote Labor Indexが17.9%から41.3%に向上しています。挙動にも違いがあり、5.1は「考えないで」というプロンプトに従うことが多い一方、5.2はmedium以上の設定では従いません。現在、APIYI(apiyi.com)で利用できるのは`claude-fable-5-1`で、5.2はまだ提供されていません。
Q2:Claude Mythos 5.2は、より高性能なモデルですか?
いいえ。リリース記事では、FableとMythosは同じ基盤モデルだと明記されています。Mythosはサイバーセキュリティと生物学に関する安全策が少ないため、審査を通過したプロジェクトの組織にのみ提供されています。価格はFable 5.2と同じです。リリース記事に掲載されているサイバーセキュリティや生物学関連の一部のスコアはMythosのものなので、Fable 5.2の実績として引用することはできません。
Q3:Claude Fable 5.2の思考を無効にできますか?
できません。アダプティブ思考は常に有効で、プロンプトで停止することもできません。思考の量やコストを調整するには、effortを下げる必要があります。Claude APIではデフォルトがhigh、ClaudeアプリとClaude CodeではデフォルトがMediumです。low設定では、1回の応答だけで終了して未完了タスクの一覧を残すことが増える点にも注意してください。長時間のタスクでは、low設定はおすすめしません。
Claude Fable 5.2の主なポイント Key Takeaways
- 位置づけ:2026-11-09にリリースされた技術用途向けのフラッグシップモデルです。日常使いのデフォルトには、引き続きOpus 5.5が適しています。
- 強み:FrontierSWE v2で69.9%、Remote Labor IndexのHighカテゴリで41.3%を記録しました。
- すべてで勝るわけではない:AutomationBenchではCarbonに、AA-BriefcaseのEloではOpusに及びませんでした。
- ガードレール:サイバーセキュリティ分野ではOpus 4.8、生物分野ではOpus 5に回答が引き継がれます。
stop_reasonを確認してください。 - 製品上の制限:思考モードは常時有効です。ツールの強制指定やサンプリングパラメーターを指定すると400エラーになります。データはデフォルトで30日間保持されます。
- 長時間タスクの事例:OSの開発に8日、フェルマーの問題に30時間かかった事例は、いずれも単発の公式実験です。
- 提供状況:2026-11-10時点で、APIYIでは5.2をまだ利用できません。まずはOpus 5.5とFable 5.1をお試しください。
まとめ:Claude Fable 5.2に切り替えないほうがよいケース
Fable 5.2の実力は本物ですが、得意分野は、自由度が高く、長時間にわたる技術的な作業に集中しています。次の4つのケースでは、Opus 5.5を使い続けるか、Fableを相談役やオーケストレーターとして使うことをおすすめします。
- 予算を重視する場合:標準料金はOpus 5.5の2倍で、Fastモードではさらに2倍になります。
- データを一切保持させたくない場合:デフォルトでは30日間の保持が必要で、許可を得ない限りゼロ保持にはできません。
- ガードレールに阻まれるサイバーセキュリティや生物分野の作業を行う場合:制限にかかると、回答するモデルはOpus 4.8またはOpus 5に切り替わります。その場合、Fableの能力は利用できません。
- 日常的なコーディングが目的の場合:公式も、まずはOpus 5.5から始めることを推奨しています。
最大限の自由度を要するタスクに取り組む場合は、まずOpus 5.5でワークフローを確立し、最も難しい工程だけをFableに任せるとよいでしょう。5.2が提供開始された後は、プラットフォームのモデル一覧でモデル名と料金をご確認ください。
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYIのウェブサイトのトップページからお気軽にお問い合わせください。詳しい資料は、ドキュメントセンター(docs.apiyi.com)をご覧ください。