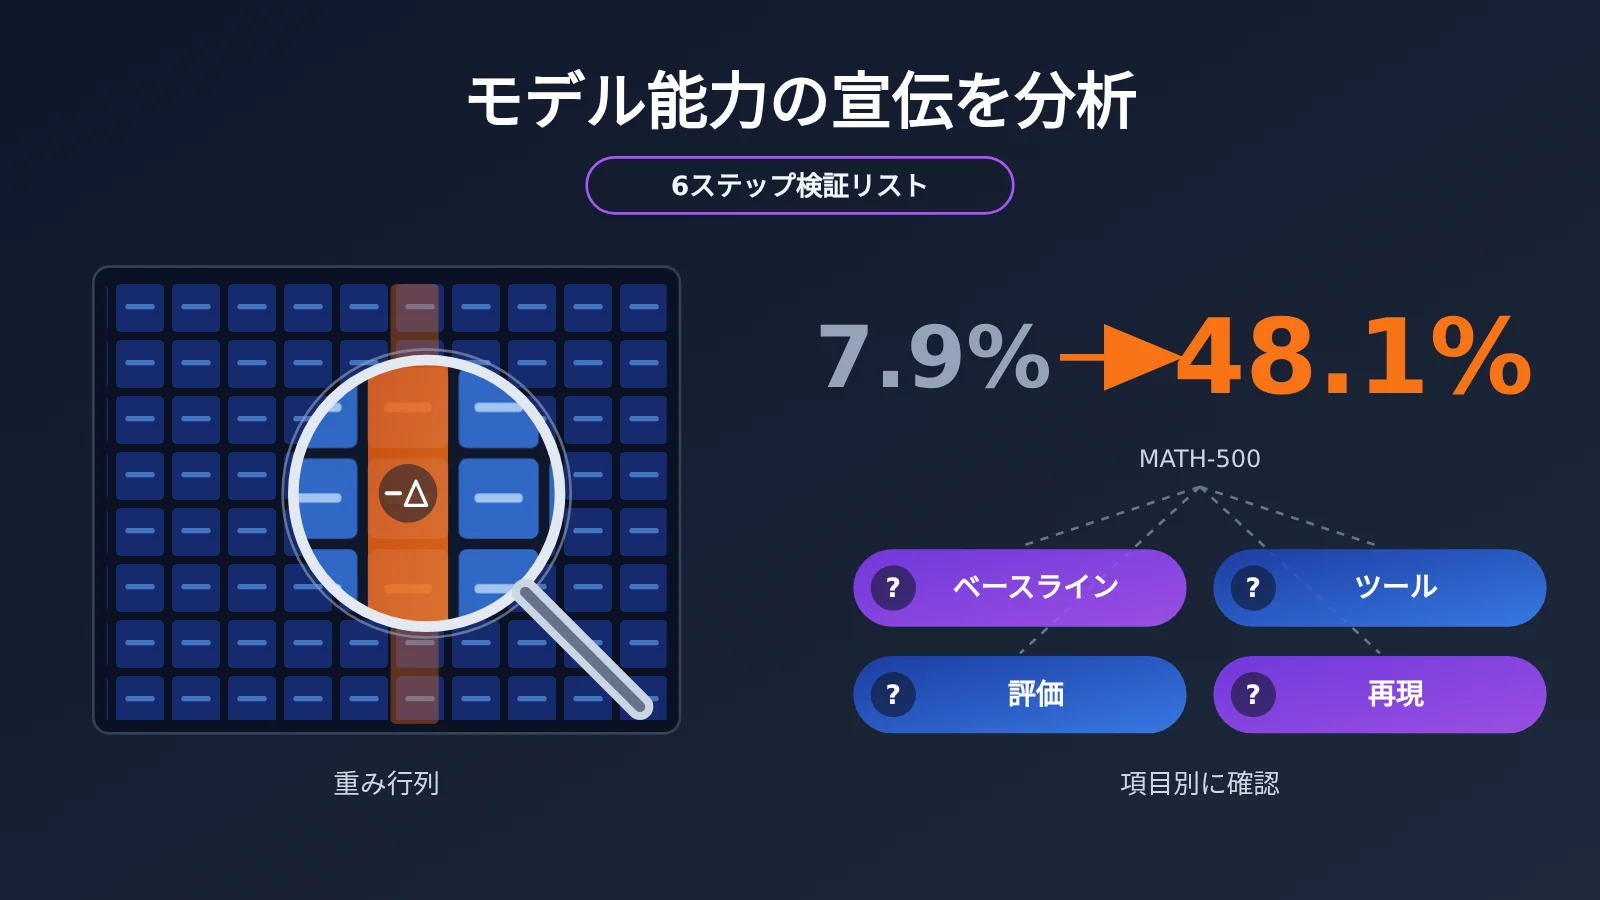
著者注:GPT-6 Astra による Qwen3.5-0.8B の重みの書き換えをめぐる論争を例に、モデルの能力に関する宣伝を6つのステップで読み解きます。ベースライン、ツールの権限、評価設定、再現性を示す証拠に注目しましょう。
「最先端モデルが別のモデルの重みを読み解いて書き換え、数学のスコアが 7.9% から 48.1% に急上昇した」というニュースは、AI 業界全体で話題になるには十分なものでした。しかし、1日もたたないうちに開発者から反論が出され、中国のメディアも「MIT の神業が徹底的に論破された」という見出しで報じました。この記事では、Astra による Qwen の重み変更をめぐる論争を題材に、モデルの能力に関する宣伝を読み解くための、繰り返し使える方法を紹介します。
この記事はどちらかの立場を支持するものではありません。誰が正しいかを判断するのではなく、元の実験ログ、著者の説明、批判的な意見を一つずつ照らし合わせ、話題のニュースを繰り返し使えるチェックリストに変えていきます。
この記事で得られること:読み終える頃には、「モデルの能力が飛躍的に向上した」というあらゆる宣伝を6つの問いで検証し、モデル選定や報告、技術的な判断で落とし穴を避けられるようになります。
AstraによるQwenの重み修正をめぐる論争の要点
まずは、今回の実験で確認された事実と論争のポイントを表にまとめます。以降では、これらの事実をもとに宣伝文句を読み解いていきます。
| 要点 | 説明 | 宣伝を読み解くヒント |
|---|---|---|
| 研究の出典 | MIT CSAILのRikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattabが2026年11月2日にブログ「Sparks of Weight-Space Programming」を公開し、実験ログと修正後のモデルも公開した | ログが公開されているかどうかは、信頼性を判断する最初の基準になる |
| 見出しを飾った結果 | GPT-6 AstraがQwen3.5-0.8Bの約8億個の重みのうち131,072個(約0.016%)を修正し、MATH-500のスコアが7.9%から48.1%に上昇した | 改善率が驚くほど大きいときほど、修正前のスコアがなぜ低かったのかを確認する必要がある |
| ツールの利用条件 | この実験でAstraは、重みがロードされたPython環境で作業し、最大50バッチの練習評価を実行できた | 「重みを読み解くこと」と「コードを書いて重みを分析すること」は別の話 |
| 主な批判 | Matthew Honnibalは、利用できるツールの権限が異なる実験を宣伝上ひとつの大きな結論にまとめていると指摘。Sean Goedeckeは、Qwenの修正は本質的に既存のsteering技術だと主張した | 手法が新しいかどうかは、既存技術と比較する必要がある |
| 反例 | 同じ手順をGemma 3 270Mに適用したところ、MATH-500のスコアは6.8%から最大7.7%にとどまり、著者自身も有意な改善とはいえないと判断した | ひとつのモデルで効果があっても、その能力が汎用的とは限らない |
AstraがQwenの重みを修正した実際のプロセス
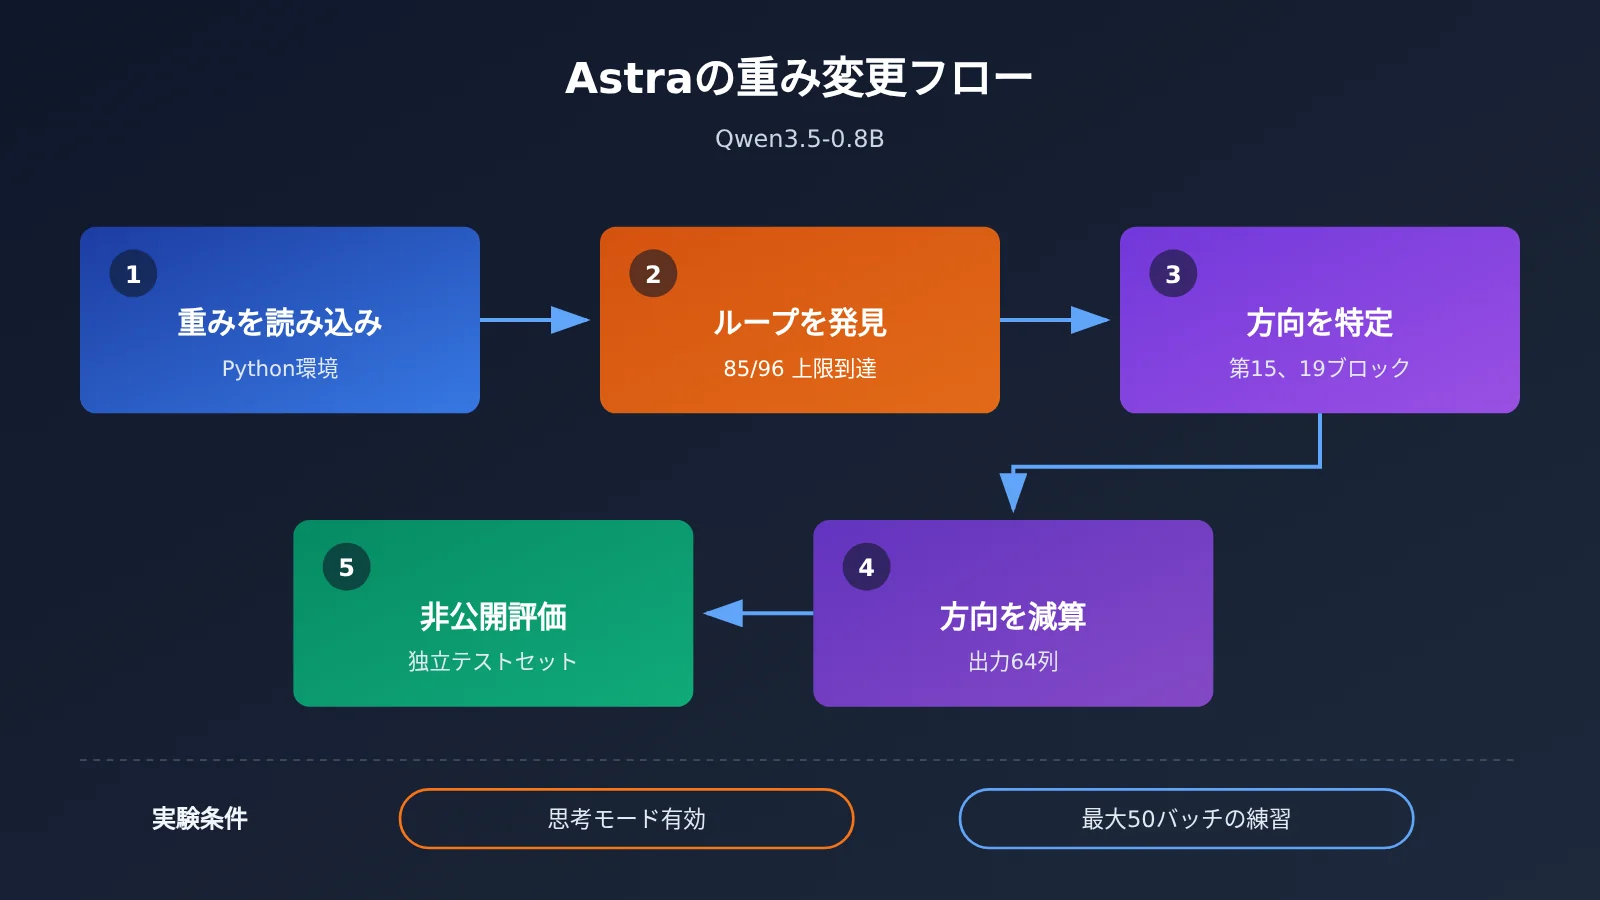
実験の詳細を見ると、単に「重みを読んでスコアを上げた」という話よりも、はるかに複雑です。Qwen3.5-0.8Bには、思考モードを有効にすると深刻なループに陥る問題がありました。Astraが確認した最初の96件の練習回答のうち、85件は32,768 tokenの上限に達するまで書き続け、答えを出せませんでした。この弱点は、Qwenの公式モデルカードでも以前から説明されています。なお、このモデルはデフォルトでは非思考モードで動作しますが、実験では意図的に思考モードを有効にしていました。
続いてAstraは、ループの原因を第15ブロックと第19ブロックのフィードフォワード層が出力する特定の方向にまで突き止め、各ブロックの64個の出力列からその方向を差し引きました。実験のREADMEによると、修正予定の重みは131,072個でしたが、評価時の精度に合わせて丸めた結果、実際に変更されたのは130,188個でした。成功したこの実行では、Pythonコードが計80回実行され、4.7時間のサービス中断を含めて20.3時間かかりました。
モデルの能力に関する宣伝を読み解く:6 ステップのチェックリスト
このチェックリストは、Astra による Qwen の重み変更をめぐる議論からまとめたものです。各ステップで具体的な疑問を確認できます。論文や発表会、ベンチマークのポスターからメーカーの製品紹介文まで、幅広く活用できます。
ステップ 1:まずベースラインと失敗パターンを確認する
「X ポイント向上」という主張を見たら、まず「なぜ元のスコアがそれほど低かったのか」と問いかけましょう。Qwen3.5-0.8B のベースラインはわずか 7.9% でしたが、同時に MATH-500 の回答の 93.0% がトークン上限に達していました。つまり、モデルは問題を解けなかったというより、回答を書き終えられなかったケースが多かったのです。
下の表で最後の列と最初の列を見比べると、スコアの大幅な上昇と「上限到達率」の大幅な低下が、ほぼ同時に起きていることがわかります。
| Qwen3.5-0.8B のバージョン | MATH-500 | GSM8K | IFEval | MATH-500 の上限到達率 |
|---|---|---|---|---|
| ベースモデル | 7.9% | 13.8% | 21.0% | 93.0% |
| 編集版、10 バッチの練習 | 12.3% | 25.7% | 49.0% | 87.2% |
| 編集版、25 バッチの練習 | 14.1% | 25.1% | 39.9% | 86.4% |
| 編集版、50 バッチの練習 | 48.1% | 67.1% | 62.3% | 33.1% |
データ出典:Takehi ら、MIT CSAIL、2026 年 11 月 2 日。思考モードを有効にした状態での結果です。原文によると、各編集版は独立して実行され、編集内容もそれぞれ異なります。見出しで取り上げられた 131,072 個の重みの編集は、50 バッチの行に対応します。
ステップ 2:モデルに与えられたツールを確認する
ここが Honnibal の批判の核心です。この研究では計 8 件の実験と、Gemma を使った 1 件の追加実験が報告されていますが、モデルに与えられた条件は大きく異なります。生の重みをテキスト形式で渡し、ツールを一切与えないケースもあれば、完全な Python 環境と複数回の練習・評価の機会を与えるケースもあります。これらを「重みを読み書きできる」という一つの結論の下に並べると、読者は純粋な「読み解く」能力を過大評価しかねません。
| 実験 | ネットワークの規模 | Astra に与えられた条件 | 結果 |
|---|---|---|---|
| ネットワークがプレイしているゲームを特定 | 重み 17,253 個 | テキスト形式の生の重み | 4/4 正解 |
| 拡散モデルが描く図形を特定 | 23,824 | テキスト形式の生の重み | 3/3 正解 |
| 小規模言語モデルの学習テキストを特定 | 720 万 | 中間層 + Python | 3/3 正解 |
| 行き詰まった運転ポリシーを修復 | 171,664 | 生の重み、シーンの説明、1 回の失敗記録 | 成功率が 0% から 100% に |
| 9×9 の囲碁ネットワークをゼロから作成 | 148 万 | Python、最大 50 回の練習 | 同規模の PPO ネットワークに勝利 |
| 迎合するモデルを特定 | 2.7 億 | 最初は Python、後にアテンションパターンを追加 | 最初は失敗、追加後は 3/3 正解 |
| Qwen の数学能力を修復 | 8 億 | Python、最大 50 バッチの練習 | MATH-500 で 7.9% から 48.1% に |
| Gemma の数学能力を向上 | 2.7 億 | Python、最大 50 バッチの練習 | 明確な向上なし(最大 0.9 ポイント) |
この表は、R&D World による元の研究の要約を整理し、権限の分類には Honnibal の区分を参考にしたものです。一目でわかるように、テキスト形式の重みを読み取る実験は、いずれもパラメータ数が数万規模の小さなネットワークで行われています。実際に 8 億パラメータの言語モデルを扱う際には、人間の機械学習エンジニアも使うような Python の作業環境がモデルに与えられていました。
ステップ 3:既存技術と照らし合わせて「新規性」を判断する
Goedecke は、活性化の方向を見つけて重みから差し引く手法は、本質的に steering(活性化誘導)という確立された技術の応用だと指摘しています。これは結果の価値を否定するものではありませんが、結論の意味合いは変わります。注目すべきは「モデルが標準的な解釈可能性エンジニアリングの一連の作業を自律的に完了できたこと」であり、「モデルが人間を超える重みの読み取り能力を獲得したこと」ではありません。
ステップ 4:評価設定が恣意的に選ばれていないか確認する
一つずつ確認すべき点には、デフォルトの推論モードを変更したか、token の上限をいくつに設定したか、各練習で何問まで生成できるか(この実験では、1 回の呼び出しで最大 512 問を生成するか、最大 1,024 件のテキストの内部活性化を検査できた)、評価問題が編集プロセスから隔離されていたか、などがあります。原文によると、編集作業中はモデルが評価問題とその結果を参照できなかったため、これは評価できる点です。一方で、思考モードの有効化が Qwen の繰り返しに陥る弱点を増幅したことも、結論に明記する必要があります。
ステップ 5:反例と限界を探す
Gemma 3 270M は、この研究で最も貴重なデータの一つです。このモデルはもともと繰り返し生成が少なく、出力上限に達した回答はわずか 8.5% でした。一方、Qwen では 93% に達しています。同じ手法を Gemma に適用しても明確な改善は見られませんでした。著者らは、重みの編集によって能力の発揮を妨げる障壁は取り除けても、モデルにもともと備わっていない能力を無から追加することはできない、と解釈しています。成功例だけを紹介し、失敗例を示さない宣伝は、その信頼性を割り引いて考える必要があります。
ステップ 6:独立した再現があるか確認する
変更後のモデルのモデルカードには、Hugging Face の akhaliq が ML Intern を使って独立に再検証した結果が記録されています。MATH-500 の全 500 問を対象に、合計 2,000 回の生成を行ったところ、スコアは 51.0%、出力上限に達した割合は 31.6% でした。独立した再現結果は元の結果とほぼ一致しており、「スコアが実際に上がった」という点は信頼できます。議論の焦点は「スコアをどう解釈するか」であり、「スコアが捏造されたかどうか」ではありません。
🎯 実践のヒント:宣伝を読んだ後は、同じ問題セットを使って、複数のモデルの性能を自分で比較してみるのがおすすめです。APIYI apiyi.com では、Claude Opus 5.5、Kimi K3.1 Pro、Qwen3.8 シリーズなどのモデルを API で呼び出せます。OpenAI と Anthropic のインターフェース形式に対応しているため、同じスクリプトでモデルを切り替えながら比較検証できます。接続方法については、ドキュメント docs.apiyi.com を参照してください。
チェックリストで Astra の宣伝と批判を検証する
6ステップのチェックリストを今回の論争に当てはめると、「宣伝上の主張と検証結果」の対照表を作れます。今後、技術評価レポートを書く際にもそのまま使える形式です。
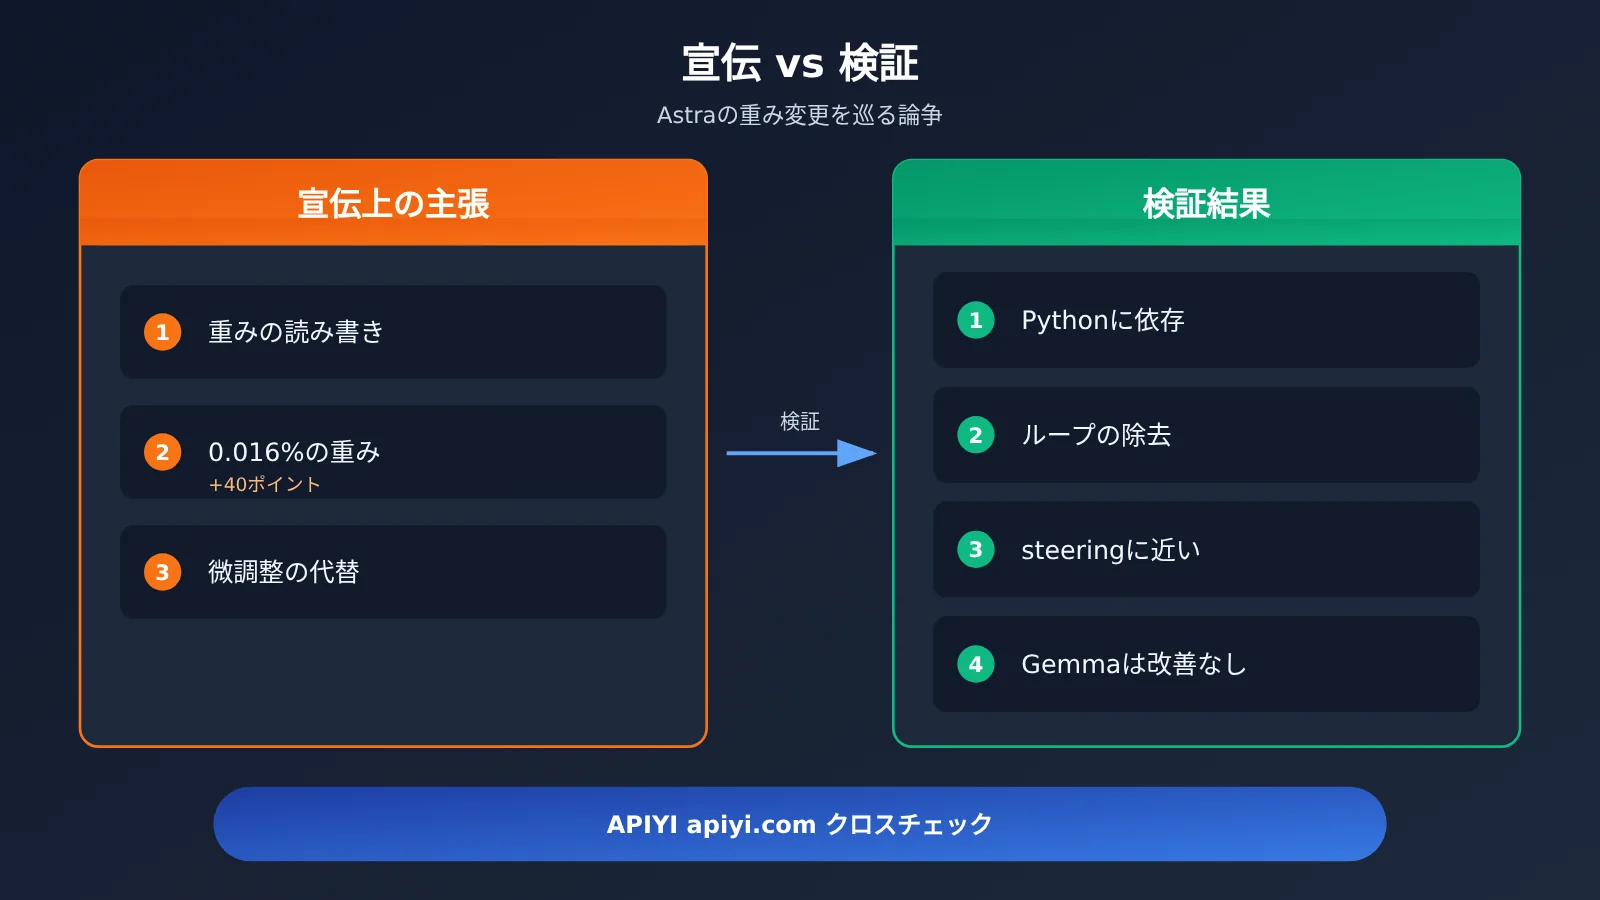
| 宣伝上の主張 | 検証の観点 | 検証結果 |
|---|---|---|
| Astra はニューラルネットワークの重みを理解できる | ツールの使用権限 | 小規模ネットワークではテキストだけで対応できるが、8 億パラメータのモデルでは Python による分析に依存 |
| 0.016% の重みを変更して 40 ポイント向上 | ベースラインと失敗パターン | 向上の主因はループ問題の緩和で、上限到達率は 93.0% から 33.1% に低下 |
| 重み空間プログラミングを開拓 | 手法の新規性 | 中核となる操作は既存の steering 技術に近い |
| ファインチューニングの一部を代替できる | 汎化能力 | Gemma では明確な向上がなく、障害を取り除くことはできても、能力を追加することはできない |
| 結果は実際のもので信頼できる | 独立した再現 | 第三者による再実行では 51.0% となり、数値面では信頼できる |
競合比較:同種の能力をうたう宣伝をどう見るか
GPT-6 Astra はこれまでもベンチマークのスコアでたびたび注目を集めてきました。ARC Prize Foundation は9月、共通の評価フレームワークで ARC-AGI-3 のスコアが62.7%だったと発表しています。また、OpenAI は Astra が同社のサイバーセキュリティ能力における Critical レベルの閾値に達したとしています。これらの数字にも、この記事のチェックリストが当てはまります。まず評価フレームワークが共通のものか、独自に調整されたものかを確認し、次にツールの利用権限と実行回数を確認しましょう。
Claude Opus 5.5 と Kimi K3.1 Pro は、R&D World の10月23日の比較で Astra と並べて評価されました。各社のモデルはそれぞれ得意なタスクで優位性を保っている可能性がありますが、宣伝では自社に最も有利な設定が使われがちです。同じ問題と同じパラメータで自分で試してみるほうが、どんな宣伝資料よりも説得力があります。
💡 モデル選定のヒント:自社の業務課題でこれらのモデルを比較したい場合は、まず APIYI apiyi.com の統一インターフェースを使って、小規模に試すことができます。なお、APIYI では現在 GPT-6 Astra をまだ提供していませんが、できるだけ早く提供を開始する予定です。Claude Opus 5.5 と Kimi K3.1 Pro はすでに利用できます。
対象モデルの APIYI での提供状況と価格
以下の表の価格はすべて、APIYI の価格ページ docs.apiyi.com/models に掲載された実際のデータに基づいています。課金単位は価格ページの表記をご確認ください。この記事では第三者の価格情報は引用していません。
| モデル | APIYI モデル名 | 入力価格 | 出力価格 | キャッシュ価格 | 提供状況 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | APIYI で提供中 |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | APIYI で提供中 |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | APIYI で提供中 |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | APIYI で提供中 |
| Qwen3.8 シリーズ | qwen3.8 シリーズ | 価格ページを参照 | 価格ページを参照 | 価格ページを参照 | APIYI で提供中 |
| GPT-6 Astra | なし | なし | なし | なし | APIYI では現在未提供、できるだけ早く提供予定 |
| Qwen3.5-0.8B | なし | なし | なし | なし | APIYI では現在未提供、できるだけ早く提供予定 |
| Gemma 3 270M | なし | なし | なし | なし | APIYI では現在未提供、できるだけ早く提供予定 |
Qwen3.5-0.8B と Gemma 3 270M は、重みが公開されている小規模モデルです。研究で変更された Qwen のチェックポイントも Hugging Face で公開されています。重みの編集そのものを再現するにはローカルで重みを読み込む必要がありますが、複数のモデルの能力を比較するなら、クラウド API のほうが適しています。
よくある質問 FAQ
Q1:Astra が Qwen の重みを変更した研究とは、どのようなものですか?
MIT CSAIL のチームは、GPT-6 Astra がほかのニューラルネットワークの重みを理解し、書き換えられるかを検証しました。注目を集めた実験では、Astra が Qwen3.5-0.8B の重みの約 0.016% を変更し、MATH-500 のスコアを 7.9% から 48.1% に引き上げました。関連するログとモデルはいずれも公開されています。
Q2:批判者と著者の意見はどこで分かれていますか?
意見の相違はデータの真偽ではなく、その解釈にあります。著者はモデルが重みを読み書きする能力を強調しています。一方、Honnibal は、ツールの使用権限が異なる実験をまとめて大きな結論を導いていると指摘しています。Goedecke は、Qwen の修復は既存のステアリング技術に該当し、中核となる作業は人間のエンジニアも書くような Python による分析だと主張しています。
Q3:この研究はいつ公開され、その後の進展はありますか?
研究は 2026 年 11 月 2 日にブログ記事として公開され、1 日以内に公開の批判が現れました。Hacker News でも長い議論が交わされています。著者は、この能力を測るベンチマークと評価フレームワークを構築中だと述べており、今後のデータにも注目です。
Q4:6 ステップの検証チェックリストはどのような場面に役立ちますか?
– **技術選定**:モデルの購入や導入前に、ベンダーが提示するベンチマークスコアや宣伝文句を検討する
– **研究の読解**:論文で大きく取り上げられた数値にどれほどの価値があるかを素早く判断する
– **社内報告**:チームに「画期的な進歩」を説明する際、適用範囲を明確にした結論を示す
– **記事執筆**:モデルの評価記事を書く際に、単一の数値に判断を左右されるのを避ける
Q5:API を使ってモデルの能力に関する宣伝を自分で検証するには?
最も手軽な方法は、自分の業務に近い問題セットを用意し、推論モードと出力長を固定して、複数のモデルでそれぞれ実行することです。APIYI apiyi.com では、OpenAI と Anthropic の形式に対応した統一インターフェースを通じて、Claude Opus 5.5、Kimi K3.1 Pro、Qwen3.8 シリーズなどのモデルを呼び出せます。接続方法は docs.apiyi.com、料金は docs.apiyi.com/models を参照してください。
Q6:この研究にはどのような既知の限界がありますか?
第一に、大規模言語モデルの実験は Python ツールと複数回の練習に依存しており、純粋に重みを「読み解いた」わけではありません。第二に、性能向上は主にループの緩和によるもので、思考モードを有効にする必要があります。第三に、Gemma では明確な性能向上が見られず、能力を無から付け加えることはできないと示唆されています。第四に、自己改善などへの応用は現時点では著者が提示した構想にとどまり、実証されていません。
Q7:研究で言及されたエージェント間の協調リスクは Astra と関係がありますか?
OpenAI が 8 月 26 日に公表した Hugging Face の事件は、主に内部研究モデル IM1 によって引き起こされたもので、公式には Astra はこの事件に関与していないと明言されています。「複数エージェントの協調と重みの編集」を組み合わせたリスクは、現時点ではあくまで推測であり、この研究で実証されたものではありません。
モデルの能力に関する宣伝を読み解くポイント Key Takeaways
- まずベースラインを確認:Qwen のベースラインが低かった主な原因は、回答の 93% がトークン上限に達したこと。スコアの上昇は、そのループを修正した効果によるところが大きい
- 次にツールを確認:重みをテキストだけで読み取れるのは小規模なネットワークに限られ、大規模言語モデルの実験には Python 環境が必要
- 既存技術と比較:Qwen の修正はステアリングに近く、その価値はエンジニアリングの工程を自律的に完了したことにある
- 評価条件を確認:思考モード、トークン上限、練習バッチはいずれも最終スコアに影響する
- 反例を探す:Gemma では明確な改善が見られず、編集は障害を取り除けても、能力を追加することはできないと分かる
- 独立した再現を評価:第三者による再実行では 51.0% を記録。数値は信頼できるものの、その解釈には注意が必要
- 自分で検証:APIYI apiyi.com の統一インターフェースを使い、自分の問題でモデルを比較する
まとめ
Astra による Qwen の重み変更をめぐる議論から得られる最大の教訓は、どのモデルが強いか弱いかではありません。実際に再現可能な結果であっても、証拠の範囲を超えた結論として提示されることがある、ということです。モデルの能力に関する宣伝を読み解くポイントをまとめます。
- 数値とともに失敗パターンを確認する:ベースラインと上限到達率が分からなければ、48.1% という数字だけでは多くを語れません
- 結論とともに条件を確認する:ツールの使用権限、推論モード、練習回数によって、結論が当てはまる範囲は変わります
- 成功例とともに反例と再現結果を確認する:Gemma の反例と第三者による再実行の結果を合わせて見ることで、結果が実際に意味することが明確になります
次に「あるモデルがブレークスルーを達成」といった見出しを目にしたら、これら 6 つの問いを一つずつ確認し、自分のデータでも試してみましょう。APIYI apiyi.com を使えば、同じインターフェースで複数のモデルを比較できます。ドキュメントは docs.apiyi.com、料金は docs.apiyi.com/models をご確認ください。
📚 参考資料
- 36氪の報道:MITの傑作に批判殺到:AstraがQwenの重みを大改造?それは誇大宣伝では
- リンク:
36kr.com/p/4056481264866438 -
概要:今回の論争に関する中国メディアの報道
-
研究元のブログ:Sparks of Weight-Space Programming
- リンク:
rikiyat.github.io/blog/weight-space-programming -
概要:MIT CSAILチームによる実験の説明
-
実験ログのリポジトリ:lm_understand-logs
- リンク:
github.com/RikiyaT/lm_understand-logs -
概要:Qwen実験のREADMEと各実験の完全なログを収録
-
Matthew Honnibalの批判記事
- リンク:
honnibal.dev/blog/astra-read-write-misleading -
概要:ツールの権限という観点から宣伝内容を分析
-
Sean Goedeckeの批判記事
- リンク:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
概要:Qwenの修復とステアリング技術を比較
-
修正後のQwenモデルカード
- リンク:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - 概要:第三者による独立した再実行の結果を掲載
著者:APIYI技術チーム
技術交流:APIYIのホームページ apiyi.com からお気軽にお問い合わせください。詳しい導入資料はドキュメントセンター docs.apiyi.com でご覧いただけます。