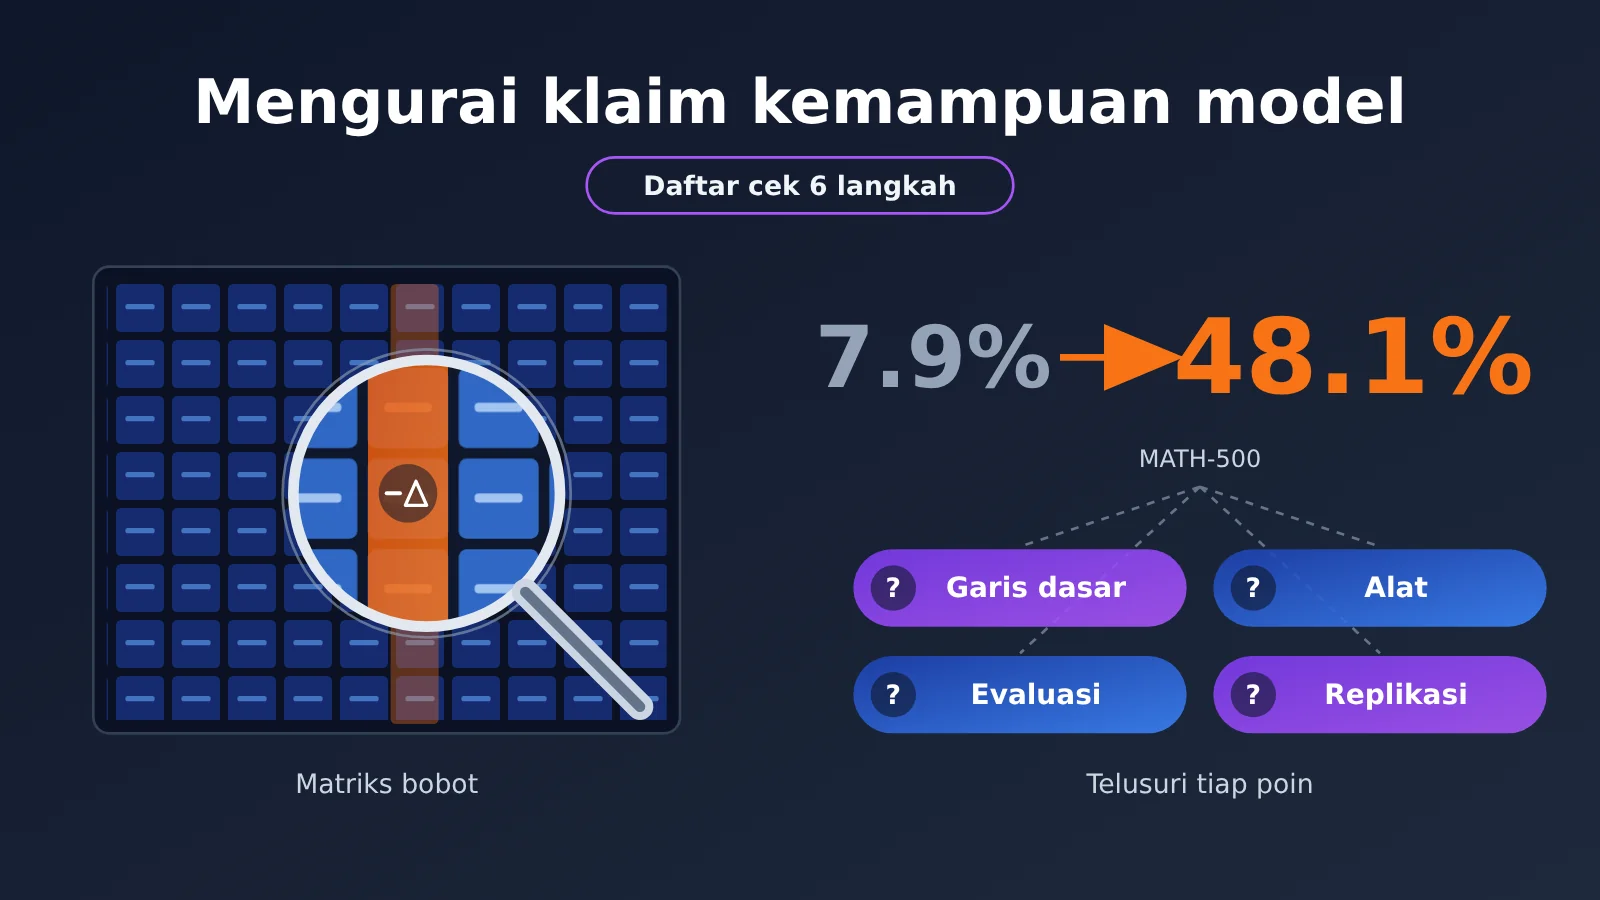
Catatan penulis: Dengan mengambil kasus kontroversi GPT-6 Astra yang mengubah bobot Qwen3.5-0.8B, artikel ini membahas 6 langkah untuk menelaah klaim kemampuan model, mulai dari baseline, akses alat, pengaturan evaluasi, hingga bukti reproduksi.
Kabar bahwa “model mutakhir membaca dan mengubah bobot model lain, lalu meningkatkan skor matematika dari 7.9% menjadi 48.1%” cukup untuk menghebohkan komunitas AI. Namun, dalam waktu kurang dari sehari, seorang developer menerbitkan sanggahan, dan media Tiongkok ikut memberitakannya dengan tajuk “Karya spektakuler MIT dibantah habis-habisan”. Melalui kontroversi Astra yang mengubah bobot Qwen ini, kita akan menyusun metode yang bisa digunakan kembali untuk menelaah klaim kemampuan model.
Artikel ini tidak berpihak. Kita tidak akan memutuskan siapa yang benar atau salah, melainkan membandingkan log eksperimen asli, pernyataan penulis, dan kritik secara bertahap. Dengan begitu, peristiwa yang ramai dibicarakan ini bisa menjadi daftar periksa yang dapat digunakan berulang kali.
Manfaat utama: Setelah membaca artikel ini, kamu akan bisa menggunakan 6 pertanyaan untuk menelaah klaim “terobosan kemampuan model” dan menghindari kesalahan saat memilih model, menyusun laporan, atau membuat penilaian teknis.
Poin-poin utama perdebatan modifikasi bobot Qwen oleh Astra
Tabel berikut merangkum fakta dan poin perdebatan utama. Pembahasan selanjutnya berangkat dari fakta-fakta ini.
| Poin | Penjelasan | Pelajaran untuk menelaah klaim promosi |
|---|---|---|
| Sumber penelitian | Rikiya Takehi, Jayden Teoh, Alex Zhang, dan Omar Khattab dari MIT CSAIL menerbitkan blog Sparks of Weight-Space Programming pada 2 November 2026, serta membuka log eksperimen dan model yang telah dimodifikasi | Ketersediaan log publik adalah pemeriksaan pertama untuk menilai kredibilitas |
| Hasil utama | GPT-6 Astra memodifikasi 131,072 dari sekitar 800 juta bobot Qwen3.5-0.8B (sekitar 0.016%), sehingga skor MATH-500 naik dari 7.9% menjadi 48.1% | Semakin mengesankan persentasenya, semakin penting untuk bertanya mengapa skor awalnya begitu rendah |
| Kondisi penggunaan alat | Dalam eksperimen ini, Astra bekerja di lingkungan Python yang sudah memuat bobot model dan dapat menjalankan hingga 50 batch evaluasi latihan | “Memahami bobot” dan “menulis kode untuk menganalisis bobot” adalah dua hal berbeda |
| Kritik utama | Matthew Honnibal menilai promosi tersebut menggabungkan eksperimen dengan hak akses alat yang berbeda menjadi satu kesimpulan besar; Sean Goedecke menilai perbaikan Qwen pada dasarnya menggunakan teknik steering yang sudah ada | Kebaruan metode perlu dibandingkan dengan teknik yang sudah ada |
| Contoh tandingan | Ketika proses yang sama diterapkan pada Gemma 3 270M, skor MATH-500 hanya naik dari 6.8% menjadi maksimal 7.7%, dan penulis sendiri menilai peningkatan itu tidak terbukti | Berhasil pada satu model tidak berarti kemampuan tersebut dapat digeneralisasi |
Proses sebenarnya Astra memodifikasi bobot Qwen
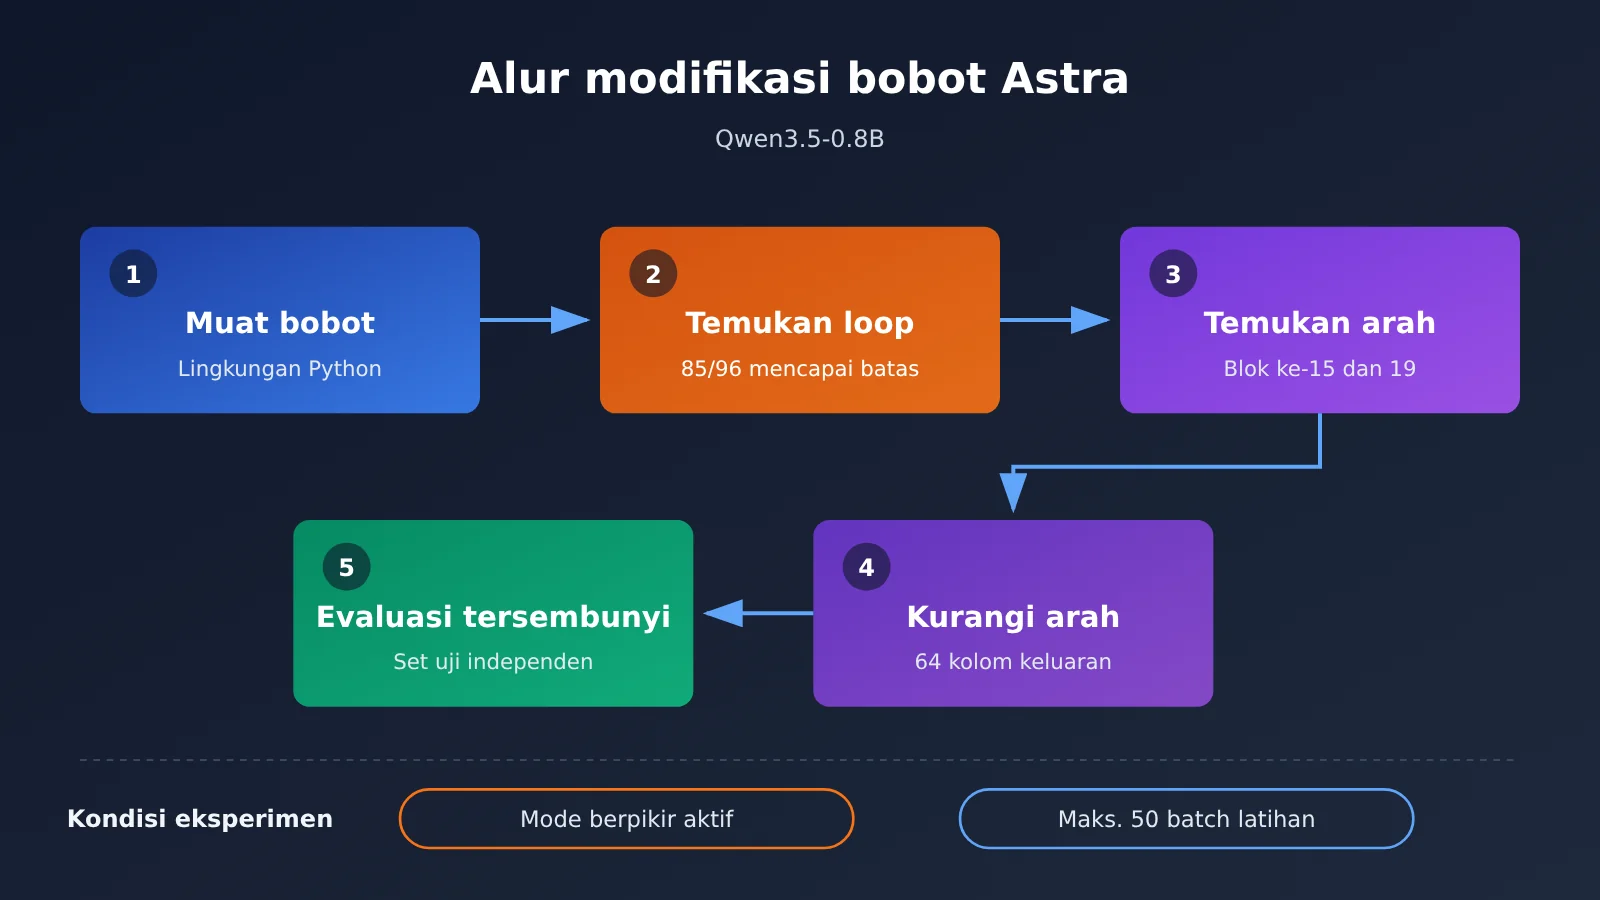
Detail eksperimennya menunjukkan bahwa proses ini jauh lebih rumit daripada sekadar “membaca bobot untuk meningkatkan skor”. Qwen3.5-0.8B mengalami masalah perulangan serius saat mode berpikir diaktifkan: dari 96 jawaban latihan pertama yang diperiksa Astra, 85 terus menghasilkan teks hingga mencapai batas 32,768 token tanpa memberikan jawaban. Kelemahan ini sudah dijelaskan dalam kartu model resmi Qwen. Perlu dicatat, model ini secara default menggunakan mode non-berpikir, tetapi eksperimen tersebut sengaja mengaktifkan mode berpikir.
Astra kemudian menelusuri perilaku perulangan itu ke suatu arah yang dihasilkan oleh lapisan feedforward pada blok ke-15 dan ke-19, lalu mengurangi arah tersebut dari masing-masing 64 kolom keluaran di setiap blok. Menurut README eksperimen, rencananya adalah memodifikasi 131,072 bobot, tetapi setelah pembulatan sesuai presisi evaluasi, jumlah yang benar-benar berubah adalah 130,188. Dalam percobaan yang berhasil ini, kode Python dieksekusi sebanyak 80 kali selama 20.3 jam, termasuk gangguan layanan selama 4.7 jam.
Panduan cepat membedah klaim kemampuan model: daftar periksa 6 langkah
Daftar periksa ini kami rangkum dari perdebatan soal modifikasi bobot Qwen oleh Astra. Setiap langkah menjawab pertanyaan tertentu dan bisa diterapkan pada makalah, acara peluncuran, poster hasil benchmark, hingga materi pemasaran produk.
Langkah 1: Periksa baseline dan pola kegagalan
Setiap kali ada klaim “naik X poin persentase”, tanyakan dulu: mengapa hasil awalnya begitu rendah? Baseline Qwen3.5-0.8B hanya 7.9%, sementara 93.0% jawaban MATH-500 mencapai batas token. Artinya, sering kali model bukan tidak bisa menjawab, melainkan belum sempat menyelesaikan jawabannya.
Bandingkan kolom terakhir dan kolom pertama pada tabel berikut. Terlihat jelas bahwa kenaikan skor yang besar terjadi hampir bersamaan dengan penurunan drastis proporsi jawaban yang mencapai batas token.
| Versi Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Proporsi jawaban MATH-500 yang mencapai batas token |
|---|---|---|---|---|
| Model dasar | 7.9% | 13.8% | 21.0% | 93.0% |
| Versi hasil edit, 10 batch latihan | 12.3% | 25.7% | 49.0% | 87.2% |
| Versi hasil edit, 25 batch latihan | 14.1% | 25.1% | 39.9% | 86.4% |
| Versi hasil edit, 50 batch latihan | 48.1% | 67.1% | 62.3% | 33.1% |
Sumber data: Takehi dkk., MIT CSAIL, 2 November 2026, dengan mode berpikir diaktifkan. Sumber asli menjelaskan bahwa setiap versi hasil edit dijalankan secara terpisah dengan perubahan yang berbeda-beda. Edit 131,072 bobot yang menjadi sorotan merujuk pada baris 50 batch.
Langkah 2: Lihat juga alat yang tersedia bagi model
Inilah inti kritik Honnibal. Penelitian tersebut melaporkan 8 eksperimen dan 1 eksperimen lanjutan pada Gemma, tetapi kondisi yang diberikan kepada model sangat berbeda. Ada eksperimen yang hanya menyediakan bobot mentah dalam bentuk teks tanpa alat apa pun; ada juga yang menyediakan lingkungan Python lengkap serta beberapa putaran latihan dan evaluasi. Jika semuanya disatukan di bawah kesimpulan bahwa model “bisa membaca dan menulis bobot”, pembaca bisa dengan mudah melebih-lebihkan kemampuan murninya untuk “memahami” bobot.
| Eksperimen | Ukuran jaringan | Kondisi yang diberikan kepada Astra | Hasil |
|---|---|---|---|
| Mengenali permainan yang dimainkan jaringan | 17.253 bobot | Bobot mentah dalam teks biasa | 4/4 benar |
| Mengenali bentuk yang digambar model difusi | 23.824 | Bobot mentah dalam teks biasa | 3/3 benar |
| Mengenali teks pelatihan model bahasa kecil | 7,2 juta | Lapisan perantara + Python | 3/3 benar |
| Memperbaiki strategi mengemudi yang macet | 171.664 | Bobot mentah, deskripsi skenario, 1 catatan kegagalan | Tingkat keberhasilan dari 0% menjadi 100% |
| Menulis jaringan Go 9×9 dari nol | 1,48 juta | Python, hingga 50 kali latihan | Mengalahkan jaringan PPO berukuran sama |
| Menemukan model yang suka menyanjung | 270 juta | Awalnya Python, lalu ditambah pola perhatian | Awalnya gagal, lalu 3/3 |
| Memperbaiki kemampuan matematika Qwen | 800 juta | Python, hingga 50 batch latihan | MATH-500 dari 7,9% menjadi 48,1% |
| Meningkatkan kemampuan matematika Gemma | 270 juta | Python, hingga 50 batch latihan | Tidak ada peningkatan yang pasti (maksimal 0,9 poin persentase) |
Tabel ini disusun dari rangkuman R&D World atas penelitian asli, dengan klasifikasi akses mengacu pada pembagian Honnibal. Terlihat jelas bahwa eksperimen membaca bobot dalam teks biasa semuanya dilakukan pada jaringan kecil dengan puluhan ribu parameter. Ketika menangani model bahasa dengan 800 juta parameter, model memiliki lingkungan kerja Python yang juga akan digunakan oleh seorang insinyur machine learning.
Langkah 3: Bandingkan dengan teknik yang sudah ada untuk menilai kebaruannya
Goedecke menunjukkan bahwa menemukan arah aktivasi lalu menguranginya dari bobot pada dasarnya merupakan penerapan steering (pengarahan aktivasi), teknik yang sudah mapan. Ini tidak mengurangi nilai hasilnya, tetapi mengubah makna kesimpulannya: yang patut diperhatikan adalah “model dapat secara mandiri menjalankan rangkaian proses rekayasa interpretabilitas standar”, bukan “model memiliki kemampuan membaca bobot yang melampaui manusia”.
Langkah 4: Periksa apakah pengaturan evaluasi dipilih secara khusus
Detail yang perlu diperiksa satu per satu meliputi: apakah mode penalaran default diubah, berapa batas token yang ditetapkan, berapa banyak soal yang boleh dibuat dalam setiap latihan (dalam eksperimen ini, setiap pemanggilan dapat menghasilkan maksimal 512 soal atau memeriksa aktivasi internal hingga 1.024 segmen teks), serta apakah soal evaluasi dipisahkan dari proses pengeditan. Teks asli menyebutkan bahwa soal dan hasil evaluasi tidak terlihat oleh model selama pengeditan; ini merupakan nilai tambah. Namun, mengaktifkan mode berpikir justru memperbesar kelemahan Qwen dalam pengulangan, dan hal ini juga harus dicantumkan dalam kesimpulan.
Langkah 5: Cari contoh tandingan dan batasannya
Gemma 3 270M adalah salah satu data paling berharga dalam penelitian ini. Model ini sendiri jarang mengalami pengulangan: hanya 8,5% jawabannya yang mencapai batas token, dibandingkan dengan 93% pada Qwen. Proses yang sama tidak menghasilkan peningkatan yang pasti pada Gemma. Menurut penulis, penyuntingan bobot dapat menghilangkan hambatan yang menutupi kemampuan model, tetapi tidak bisa menciptakan kemampuan yang memang tidak dimilikinya. Jika suatu klaim promosi hanya menyajikan kasus sukses tanpa menunjukkan kasus gagal, kredibilitasnya patut dipertanyakan.
Langkah 6: Pastikan apakah ada reproduksi independen
Kartu model hasil modifikasi mencatat pengujian ulang independen oleh akhaliq dari Hugging Face menggunakan ML Intern. Pengujian ini mencakup seluruh 500 soal MATH-500, dengan total 2.000 generasi, dan menghasilkan skor 51,0% serta proporsi respons yang mencapai batas token sebesar 31,6%. Hasil reproduksi independen tersebut pada dasarnya sejalan dengan hasil awal. Ini menunjukkan bahwa “skornya memang naik” dapat dipercaya; perdebatan berpusat pada “bagaimana menafsirkan skor tersebut”, bukan “apakah skornya dipalsukan”.
🎯 Saran praktis: Setelah membaca klaim promosi, sebaiknya bandingkan sendiri performa beberapa model menggunakan kumpulan soal yang sama. APIYI apiyi.com menyediakan pemanggilan API untuk model seperti Claude Opus 5.5, Kimi K3.1 Pro, dan seri Qwen3.8. Layanan ini kompatibel dengan format antarmuka OpenAI dan Anthropic, sehingga kamu bisa berganti model dalam skrip yang sama untuk melakukan validasi silang. Panduan integrasi tersedia di docs.apiyi.com.
Membandingkan klaim dan kritik Astra dengan daftar periksa
Dengan menerapkan daftar periksa 6 langkah pada kontroversi ini, kita bisa membuat tabel perbandingan “klaim vs hasil verifikasi”. Format ini juga bisa langsung kamu gunakan saat menulis laporan evaluasi teknis.
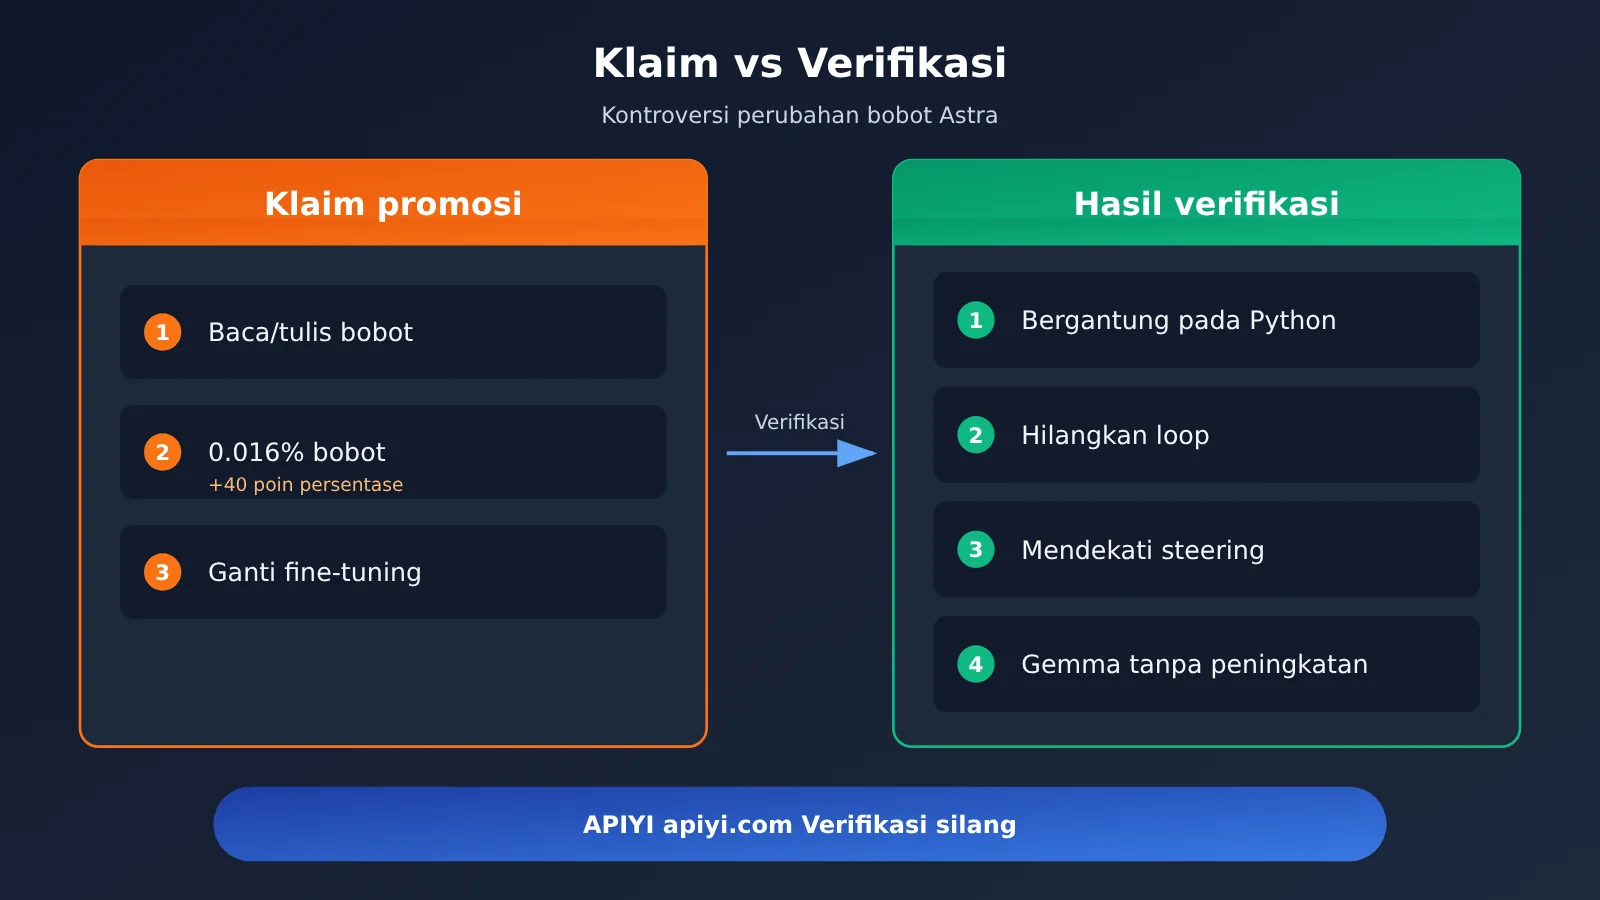
| Klaim promosi | Aspek verifikasi | Hasil verifikasi |
|---|---|---|
| Astra dapat memahami bobot jaringan saraf | Akses ke alat | Bisa dilakukan dengan teks saja pada jaringan kecil, tetapi analisis model 800 juta parameter bergantung pada Python |
| Mengubah 0.016% bobot menghasilkan peningkatan 40 poin persentase | Baseline dan pola kegagalan | Peningkatan terutama berasal dari berkurangnya masalah perulangan; tingkat pencapaian batas turun dari 93.0% menjadi 33.1% |
| Merintis pemrograman ruang bobot | Kebaruan metode | Operasi intinya mirip dengan teknik steering yang sudah ada |
| Dapat menggantikan sebagian fine-tuning | Kemampuan generalisasi | Tidak ada peningkatan yang pasti pada Gemma; hanya bisa menghilangkan hambatan, bukan menambahkan kemampuan |
| Hasilnya nyata dan dapat dipercaya | Reproduksi independen | Pengujian ulang oleh pihak ketiga menghasilkan 51.0%, sehingga angkanya dapat dipercaya |
Perbandingan kompetitor: menyikapi klaim kemampuan serupa
GPT-6 Astra sebelumnya sudah beberapa kali menarik perhatian berkat skor benchmark-nya. Pada September, ARC Prize Foundation melaporkan skor 62.7% di ARC-AGI-3 menggunakan kerangka evaluasi bersama. OpenAI juga menyatakan bahwa Astra telah mencapai ambang kemampuan keamanan siber tingkat Critical. Daftar periksa dalam artikel ini juga berlaku untuk angka-angka tersebut: pertama, tanyakan apakah kerangka evaluasinya digunakan bersama atau dibuat khusus, lalu periksa izin akses alat dan jumlah pengujiannya.
Claude Opus 5.5 dan Kimi K3.1 Pro juga disandingkan dengan Astra dalam perbandingan R&D World pada 23 Oktober. Model dari berbagai penyedia bisa saja unggul pada tugas yang berbeda-beda, tetapi materi promosi sering menggunakan pengaturan yang paling menguntungkan bagi masing-masing penyedia. Sebaliknya, menjalankan pengujian sendiri dengan soal dan parameter yang sama lebih meyakinkan daripada poster promosi mana pun.
💡 Saran memilih model: Jika ingin membandingkan model-model ini pada persoalan bisnis Anda sendiri, coba jalankan pengujian skala kecil melalui antarmuka terpadu di APIYI apiyi.com. Perlu diketahui, GPT-6 Astra saat ini belum tersedia di APIYI, tetapi kami akan menghadirkannya secepat mungkin; Claude Opus 5.5 dan Kimi K3.1 Pro sudah bisa langsung digunakan.
Ketersediaan dan harga model terkait di APIYI
Semua harga dalam tabel berikut mengacu pada data aktual di halaman harga APIYI, docs.apiyi.com/models. Untuk satuan penagihan, silakan merujuk pada keterangan di halaman tersebut; artikel ini tidak mengutip harga dari pihak ketiga.
| Model | Nama model di APIYI | Harga input | Harga output | Harga cache | Status ketersediaan |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | Tersedia di APIYI |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | Tersedia di APIYI |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | Tersedia di APIYI |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Tersedia di APIYI |
| Seri Qwen3.8 | Seri qwen3.8 | Lihat halaman harga | Lihat halaman harga | Lihat halaman harga | Tersedia di APIYI |
| GPT-6 Astra | Tidak ada | Tidak ada | Tidak ada | Tidak ada | Belum tersedia di APIYI, akan dihadirkan secepat mungkin |
| Qwen3.5-0.8B | Tidak ada | Tidak ada | Tidak ada | Tidak ada | Belum tersedia di APIYI, akan dihadirkan secepat mungkin |
| Gemma 3 270M | Tidak ada | Tidak ada | Tidak ada | Tidak ada | Belum tersedia di APIYI, akan dihadirkan secepat mungkin |
Qwen3.5-0.8B dan Gemma 3 270M adalah model kecil dengan bobot terbuka. Checkpoint Qwen yang telah dimodifikasi dalam penelitian ini juga tersedia di Hugging Face. Untuk mereplikasi proses penyuntingan bobotnya, Anda perlu memuat bobot tersebut secara lokal; sementara itu, API cloud lebih cocok untuk membandingkan kemampuan antar-model.
Pertanyaan Umum (FAQ)
Q1: Sebenarnya, penelitian tentang Astra yang memodifikasi bobot Qwen itu seperti apa?
Tim MIT CSAIL menguji apakah GPT-6 Astra mampu memahami dan mengubah bobot jaringan saraf lain. Dalam eksperimen utamanya, Astra mengubah sekitar 0,016% bobot Qwen3.5-0.8B dan meningkatkan skor MATH-500 dari 7,9% menjadi 48,1%. Log dan model terkait juga sudah dipublikasikan.
Q2: Di mana letak perbedaan pendapat antara pengkritik dan penulis?
Perbedaannya bukan soal kebenaran data, melainkan cara menafsirkannya. Penulis menekankan kemampuan model untuk membaca dan menulis bobot. Honnibal menilai eksperimen dengan hak akses alat yang berbeda digabungkan menjadi satu kesimpulan besar. Sementara itu, Goedecke menilai perbaikan Qwen termasuk teknik *steering* yang sudah ada, dan pekerjaan utamanya berupa analisis Python yang juga bisa ditulis oleh engineer manusia.
Q3: Kapan penelitian ini dipublikasikan, dan apakah ada perkembangan selanjutnya?
Penelitian ini diterbitkan dalam bentuk blog pada 2 November 2026. Dalam satu hari, kritik publik sudah bermunculan, disertai diskusi panjang di Hacker News. Penulis menyatakan sedang membangun benchmark dan kerangka evaluasi untuk mengukur kemampuan tersebut, sehingga data selanjutnya layak untuk diikuti.
Q4: Untuk situasi apa saja daftar periksa 6 langkah ini cocok digunakan?
– **Pemilihan teknologi**: Menelaah skor benchmark dan materi promosi vendor sebelum membeli atau mengintegrasikan model
– **Membaca penelitian**: Menilai dengan cepat seberapa bermakna angka utama dalam sebuah makalah
– **Laporan internal**: Menjelaskan suatu “terobosan” kepada tim dengan kesimpulan yang jelas batasannya
– **Penulisan konten**: Menghindari kesimpulan yang bias akibat terpaku pada satu angka saat menulis evaluasi model
Q5: Bagaimana cara menggunakan API untuk memverifikasi sendiri klaim kemampuan model?
Cara paling langsung adalah menyiapkan kumpulan soal yang mirip dengan kebutuhan bisnis Anda, menetapkan mode penalaran dan panjang output yang sama, lalu menjalankannya pada beberapa model. Melalui APIYI apiyi.com, Anda dapat memanggil model seperti Claude Opus 5.5, Kimi K3.1 Pro, dan seri Qwen3.8 lewat antarmuka terpadu yang kompatibel dengan format OpenAI dan Anthropic. Panduan integrasi tersedia di docs.apiyi.com, sedangkan biaya dapat dilihat di docs.apiyi.com/models.
Q6: Apa saja keterbatasan penelitian ini yang sudah diketahui?
Pertama, eksperimen Model Bahasa Besar bergantung pada alat Python dan latihan dalam beberapa putaran, bukan sekadar “memahami” bobot. Kedua, peningkatan terutama berasal dari pengurangan perilaku berulang dan bergantung pada mode berpikir yang diaktifkan. Ketiga, tidak ada peningkatan yang pasti pada Gemma, yang menunjukkan bahwa kemampuan tidak bisa ditambahkan begitu saja. Keempat, penerapan seperti peningkatan diri masih sebatas gagasan yang diajukan penulis dan belum terbukti.
Q7: Apakah risiko kolaborasi agen yang disebut dalam penelitian ini berkaitan dengan Astra?
Insiden Hugging Face yang diungkap OpenAI pada 26 Agustus terutama digerakkan oleh IM1, model penelitian internal. OpenAI secara resmi menyatakan bahwa Astra tidak terlibat dalam insiden tersebut. Kombinasi “kolaborasi multiagen + penyuntingan bobot” saat ini masih berupa spekulasi dan belum dibuktikan oleh penelitian ini.
Pokok Penting untuk Menelaah Klaim Kemampuan Model
- Tanyakan dulu baseline-nya: Baseline Qwen rendah terutama karena 93% jawabannya mencapai batas token; sebagian besar peningkatan skor berasal dari perbaikan masalah perulangan
- Tanyakan alat yang digunakan: Membaca bobot sebagai teks biasa hanya berlaku untuk jaringan kecil; eksperimen dengan Model Bahasa Besar bergantung pada lingkungan Python
- Bandingkan dengan teknik lama: Perbaikan Qwen mirip dengan steering; nilainya terletak pada kemampuan menyelesaikan alur kerja rekayasa secara mandiri
- Cermati pengaturan evaluasi: Mode berpikir, batas token, dan batch latihan semuanya memengaruhi skor akhir
- Cari contoh yang berlawanan: Gemma tidak menunjukkan peningkatan yang pasti, yang berarti pengeditan hanya dapat menghilangkan hambatan, bukan menambah kemampuan
- Hargai replikasi independen: Pengujian ulang oleh pihak ketiga menghasilkan 51.0%; angkanya dapat dipercaya, tetapi penafsirannya perlu hati-hati
- Uji sendiri: Gunakan antarmuka terpadu APIYI apiyi.com untuk membandingkan model pada soal Anda sendiri
Kesimpulan
Pelajaran terbesar dari perdebatan tentang modifikasi bobot Qwen oleh Astra bukanlah soal model mana yang kuat atau lemah. Hasil yang nyata dan dapat direplikasi pun bisa dikemas menjadi kesimpulan yang melampaui bukti. Berikut pokok-pokok penting untuk menelaah klaim kemampuan model:
- Angka harus disertai pola kegagalan: Tanpa baseline dan tingkat jawaban yang mencapai batas token, angka 48.1% saja tidak banyak menjelaskan
- Kesimpulan harus disertai kondisi: Izin penggunaan alat, mode penalaran, dan jumlah latihan menentukan batas keberlakuan kesimpulan
- Keberhasilan harus disertai contoh yang berlawanan dan replikasi: Contoh Gemma dan pengujian ulang oleh pihak ketiga bersama-sama membantu menjelaskan makna sebenarnya dari hasil tersebut
Lain kali Anda melihat judul seperti “suatu model mencapai terobosan”, coba telaah keenam pertanyaan ini satu per satu, lalu jalankan pengujian dengan data Anda sendiri. Anda bisa menggunakan APIYI apiyi.com untuk membandingkan beberapa model melalui antarmuka yang sama. Dokumentasi tersedia di docs.apiyi.com, dan harga dapat dilihat di docs.apiyi.com/models.
📚 Referensi
- Laporan 36氪: Karya MIT menuai kritik: Astra mengubah bobot Qwen? Jangan berlebihan
- Tautan:
36kr.com/p/4056481264866438 -
Keterangan: Laporan media Tiongkok tentang kontroversi ini
-
Blog penelitian asli: Sparks of Weight-Space Programming
- Tautan:
rikiyat.github.io/blog/weight-space-programming -
Keterangan: Penjelasan eksperimen asli dari tim MIT CSAIL
-
Repositori log eksperimen: lm_understand-logs
- Tautan:
github.com/RikiyaT/lm_understand-logs -
Keterangan: Berisi README eksperimen Qwen dan log lengkap setiap eksperimen
-
Artikel kritik oleh Matthew Honnibal
- Tautan:
honnibal.dev/blog/astra-read-write-misleading -
Keterangan: Analisis klaim promosi dari sudut pandang izin akses alat
-
Artikel kritik oleh Sean Goedecke
- Tautan:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
Keterangan: Membandingkan perbaikan Qwen dengan teknik steering
-
Kartu model Qwen yang telah dimodifikasi
- Tautan:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - Keterangan: Berisi hasil pengujian ulang independen oleh pihak ketiga
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama APIYI apiyi.com. Materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com