作者注:以 GPT-6 Astra 改寫 Qwen3.5-0.8B 權重引發的爭議爲案例,用 6 個步驟拆解模型能力宣傳,看懂基線、工具權限、評測設置與復現證據。
一條“前沿模型讀懂並改寫了另一個模型的權重,數學成績從 7.9% 飆到 48.1%”的消息,足以刷屏整個 AI 圈。但不到一天,就有開發者發文反駁,國內媒體也以“MIT 神作被錘爆”爲題跟進報道。本文借這場 Astra 修改 Qwen 權重之爭,帶你建立一套拆解模型能力宣傳的可複用方法。
這不是一篇站隊文章,我們不評判誰對誰錯,而是逐層對照原始實驗日誌、作者表述與批評意見,把一次熱點變成一份可以反覆使用的核查清單。
核心價值:讀完本文,你將學會用 6 個問題審視任何“模型能力突破”的宣傳,在選型、彙報和技術判斷時少踩坑。
Astra 修改 Qwen 權重之爭核心要點
先用一張表把事件的關鍵事實和爭議點講清楚,後面的方法論都圍繞這些事實展開。
| 要點 | 說明 | 對拆解宣傳的啓發 |
|---|---|---|
| 研究來源 | MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab 於 2026 年 11 月 2 日發佈博客 Sparks of Weight-Space Programming,並公開實驗日誌和修改後的模型 | 有沒有公開日誌,是判斷可信度的第一道門檻 |
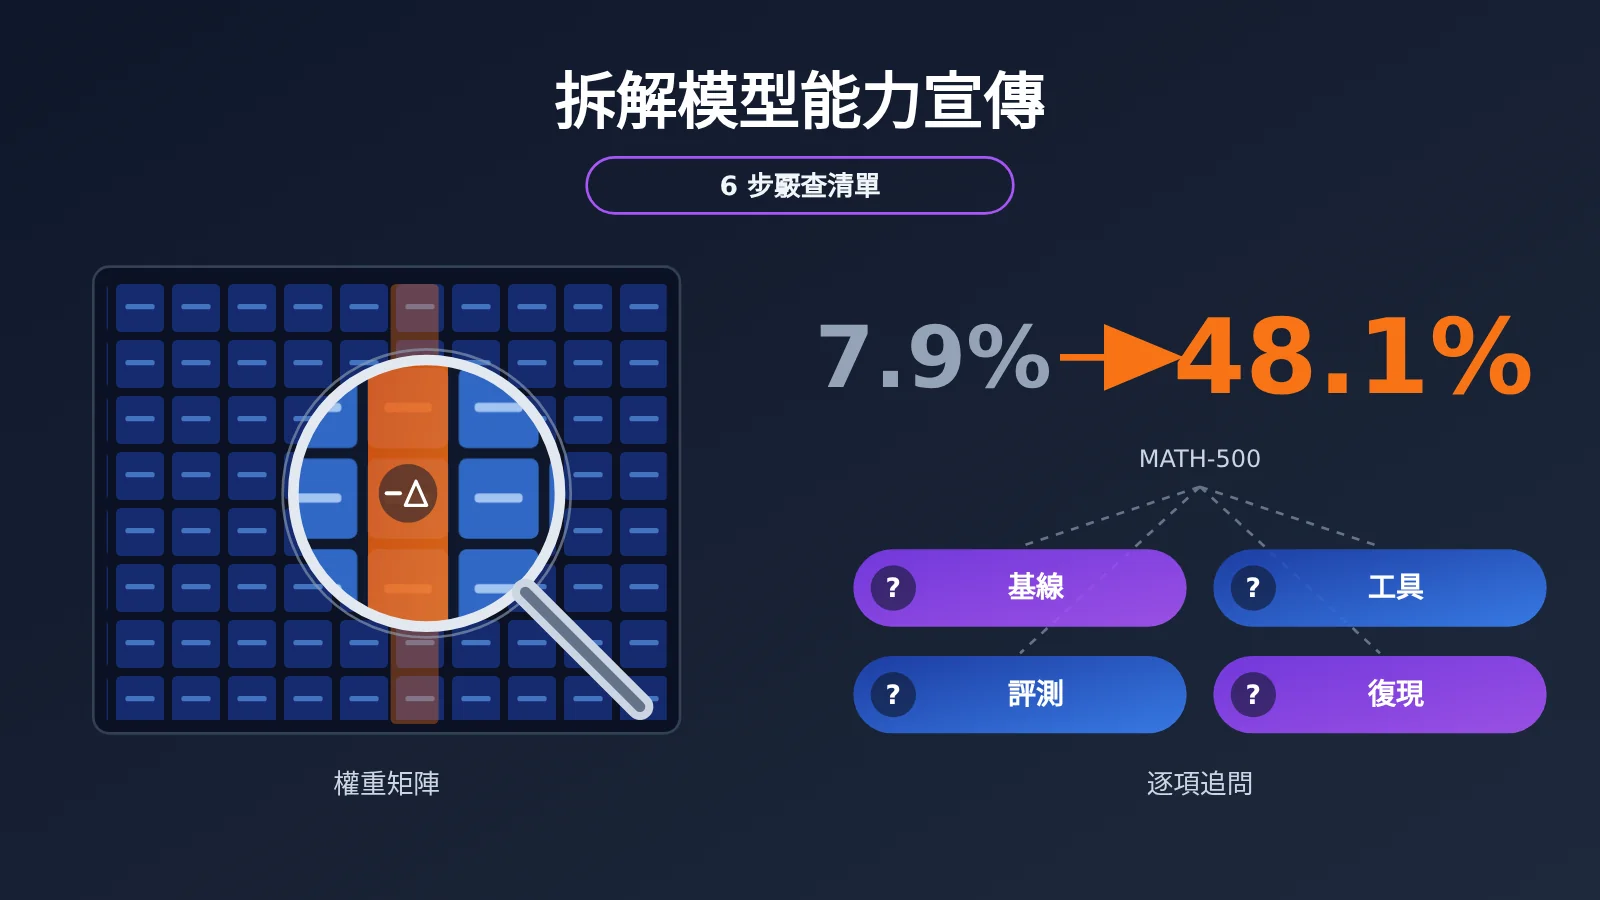
| 頭條結果 | GPT-6 Astra 修改了 Qwen3.5-0.8B 約 8 億權重中的 131,072 個(約 0.016%),MATH-500 從 7.9% 升至 48.1% | 百分比越驚人,越要追問基線爲什麼這麼低 |
| 工具條件 | 該實驗中 Astra 在加載了權重的 Python 環境裏工作,最多可跑 50 批練習評測 | “讀懂權重”和“寫代碼分析權重”是兩回事 |
| 主要批評 | Matthew Honnibal 認爲宣傳把不同工具權限的實驗合併成一個大結論;Sean Goedecke 認爲 Qwen 修復本質是已有的 steering 技術 | 方法新不新,要和現有技術對照 |
| 反例 | 同樣流程用在 Gemma 3 270M 上,MATH-500 從 6.8% 最多到 7.7%,作者自己也認爲提升不成立 | 一個模型上有效,不代表能力可以泛化 |
Astra 修改 Qwen 權重的真實過程詳解
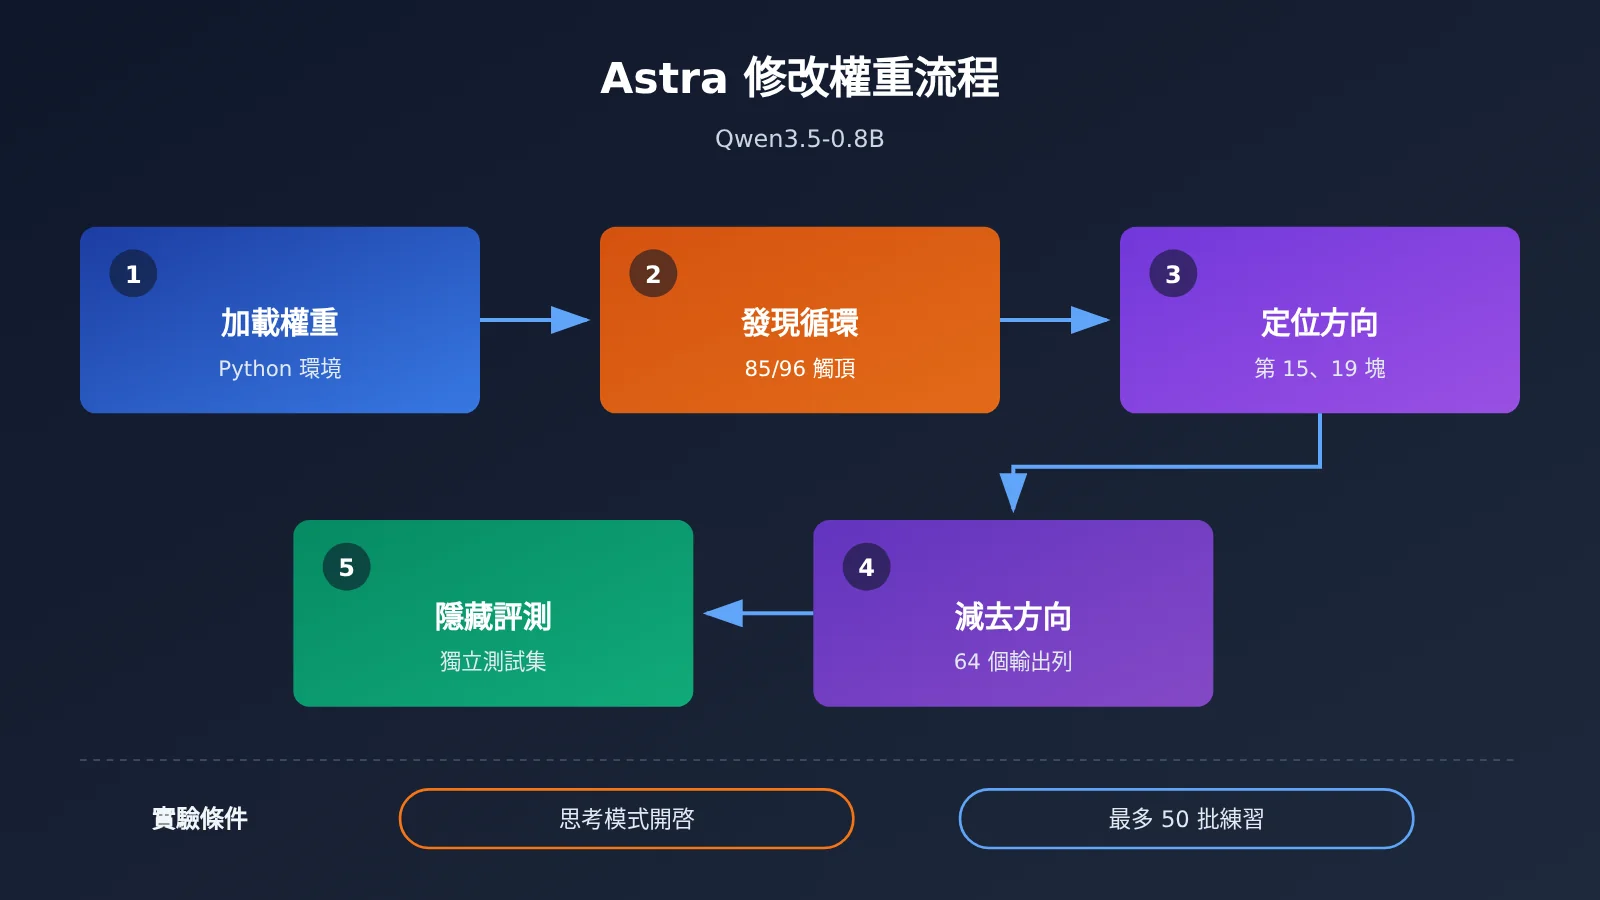
拆開實驗細節會發現,事情遠比“讀權重提分”複雜。Qwen3.5-0.8B 在開啓思考模式後存在嚴重的循環問題:Astra 檢查的前 96 個練習答案裏,有 85 個一直寫到 32,768 token 上限也沒給出答案,這一弱點在 Qwen 官方模型卡中早有說明。值得注意的是,該模型默認是非思考模式,實驗特意開啓了思考模式。
Astra 隨後把循環行爲追溯到第 15 和第 19 塊前饋層寫出的某個方向,並從每塊的 64 個輸出列中把這個方向減去。按實驗 README 的記錄,計劃修改 131,072 個權重,按評測精度取整後實際改變的是 130,188 個。成功的這次運行共執行了 80 次 Python 代碼,耗時 20.3 小時,其中包含 4.7 小時的服務中斷。
拆解模型能力宣傳快速上手:6 步覈查清單
下面這套清單,是我們從 Astra 修改 Qwen 權重之爭中提煉出來的。每一步都對應一個具體問題,適用於論文、發佈會、跑分海報乃至廠商的產品文案。
第 1 步:先看基線和失敗模式
任何“提升 X 個百分點”的說法,都要先問一句:原來爲什麼這麼差?Qwen3.5-0.8B 的基線只有 7.9%,而同期有 93.0% 的 MATH-500 答案撞上了 token 上限。也就是說,模型很多時候不是不會做,而是根本沒寫完。
把下面這張表的最後一列和第一列對照看,結論就很清楚了:分數的大幅上升與“觸頂率”的大幅下降幾乎同步發生。
| Qwen3.5-0.8B 版本 | MATH-500 | GSM8K | IFEval | MATH-500 觸頂比例 |
|---|---|---|---|---|
| 基礎模型 | 7.9% | 13.8% | 21.0% | 93.0% |
| 編輯版,10 批練習 | 12.3% | 25.7% | 49.0% | 87.2% |
| 編輯版,25 批練習 | 14.1% | 25.1% | 39.9% | 86.4% |
| 編輯版,50 批練習 | 48.1% | 67.1% | 62.3% | 33.1% |
數據來源:Takehi 等人,MIT CSAIL,2026 年 11 月 2 日,思考模式開啓。原文說明每個編輯版都是獨立運行、編輯內容各不相同,頭條的 131,072 權重編輯對應 50 批那一行。
第 2 步:再看模型手裏有什麼工具
這是 Honnibal 批評的核心。研究一共報告了 8 個實驗和 1 個 Gemma 後續實驗,但模型獲得的條件差別很大:有的只給純文本形式的原始權重、不給任何工具,有的給完整 Python 環境和多輪練習評測。把它們並列在“能讀寫權重”這一個結論下,讀者很容易高估純粹的“讀懂”能力。
| 實驗 | 網絡規模 | Astra 獲得的條件 | 結果 |
|---|---|---|---|
| 識別網絡在玩哪個遊戲 | 17,253 個權重 | 純文本原始權重 | 4/4 正確 |
| 識別擴散模型畫的形狀 | 23,824 | 純文本原始權重 | 3/3 正確 |
| 識別小語言模型的訓練文本 | 720 萬 | 中間層 + Python | 3/3 正確 |
| 修復卡住的駕駛策略 | 171,664 | 原始權重、場景描述、1 次失敗記錄 | 成功率 0% 到 100% |
| 從零編寫 9×9 圍棋網絡 | 148 萬 | Python,最多 50 次練習 | 勝過同規模 PPO 網絡 |
| 找出諂媚模型 | 2.7 億 | 先 Python,後加注意力模式 | 先失敗,後 3/3 |
| 修復 Qwen 數學 | 8 億 | Python,最多 50 批練習 | MATH-500 7.9% 到 48.1% |
| 提升 Gemma 數學 | 2.7 億 | Python,最多 50 批練習 | 無確定提升(最多 0.9 個百分點) |
表格整理自 R&D World 對原研究的彙總,權限分類參考 Honnibal 的劃分。一眼可見:純文本讀權重的實驗都發生在幾萬參數量級的小網絡上,真正動到 8 億參數語言模型時,模型手裏有的是一個人類機器學習工程師也會用的 Python 工作臺。
第 3 步:對照已有技術判斷“新不新”
Goedecke 指出,找到一個激活方向再從權重裏減掉,本質上就是 steering(激活引導)這一成熟技術的應用。這並不否定結果的價值,但會改變結論的含義:值得關注的是“模型能自主完成一套標準的可解釋性工程流程”,而不是“模型擁有了超人的讀權重能力”。
第 4 步:檢查評測設置是否被精心挑選
需要逐項確認的細節包括:是否改了默認推理模式、token 上限設多少、每次練習允許生成多少題(該實驗每次調用最多生成 512 題,或檢查最多 1,024 段文本的內部激活)、評測題是否與編輯過程隔離。原文提到評測題和結果在編輯期間對模型不可見,這是加分項;但開啓思考模式恰好放大了 Qwen 的循環弱點,這一點也必須寫進你的結論裏。
第 5 步:尋找反例與邊界
Gemma 3 270M 是這項研究裏最有價值的一組數據。它本身很少循環,只有 8.5% 的答案觸頂,而 Qwen 是 93%。同樣的流程在 Gemma 上沒有帶來確定提升,作者自己的解讀是:權重編輯可以清除遮蔽能力的障礙,卻無法憑空添加模型本不具備的能力。一項宣傳如果只給成功案例、不給失敗案例,可信度要打折扣。
第 6 步:確認是否有獨立復現
修改後模型的模型卡里,記錄了 Hugging Face 的 akhaliq 用 ML Intern 做的獨立復跑:覆蓋全部 500 道 MATH-500 題、共 2,000 次生成,得分 51.0%,觸頂比例 31.6%。獨立復現與原結果基本一致,說明“分數確實上去了”是可靠的;爭議集中在“如何解釋這個分數”,而不是“分數是否造假”。
🎯 實踐建議:讀完宣傳後,最好親自用同一組題目對比幾個模型的表現。API易 apiyi.com 提供 Claude Opus 5.5、Kimi K3.1 Pro、Qwen3.8 系列等模型的 API 調用,兼容 OpenAI 與 Anthropic 接口格式,方便你在同一套腳本里切換模型做交叉驗證。接入說明見文檔 docs.apiyi.com。
用覈查清單對照 Astra 宣傳與批評
把 6 步清單套回這場爭議,可以得到一張“宣傳說法 vs 覈查結論”的對照表,這也是你日後寫技術評估報告時可以直接沿用的格式。
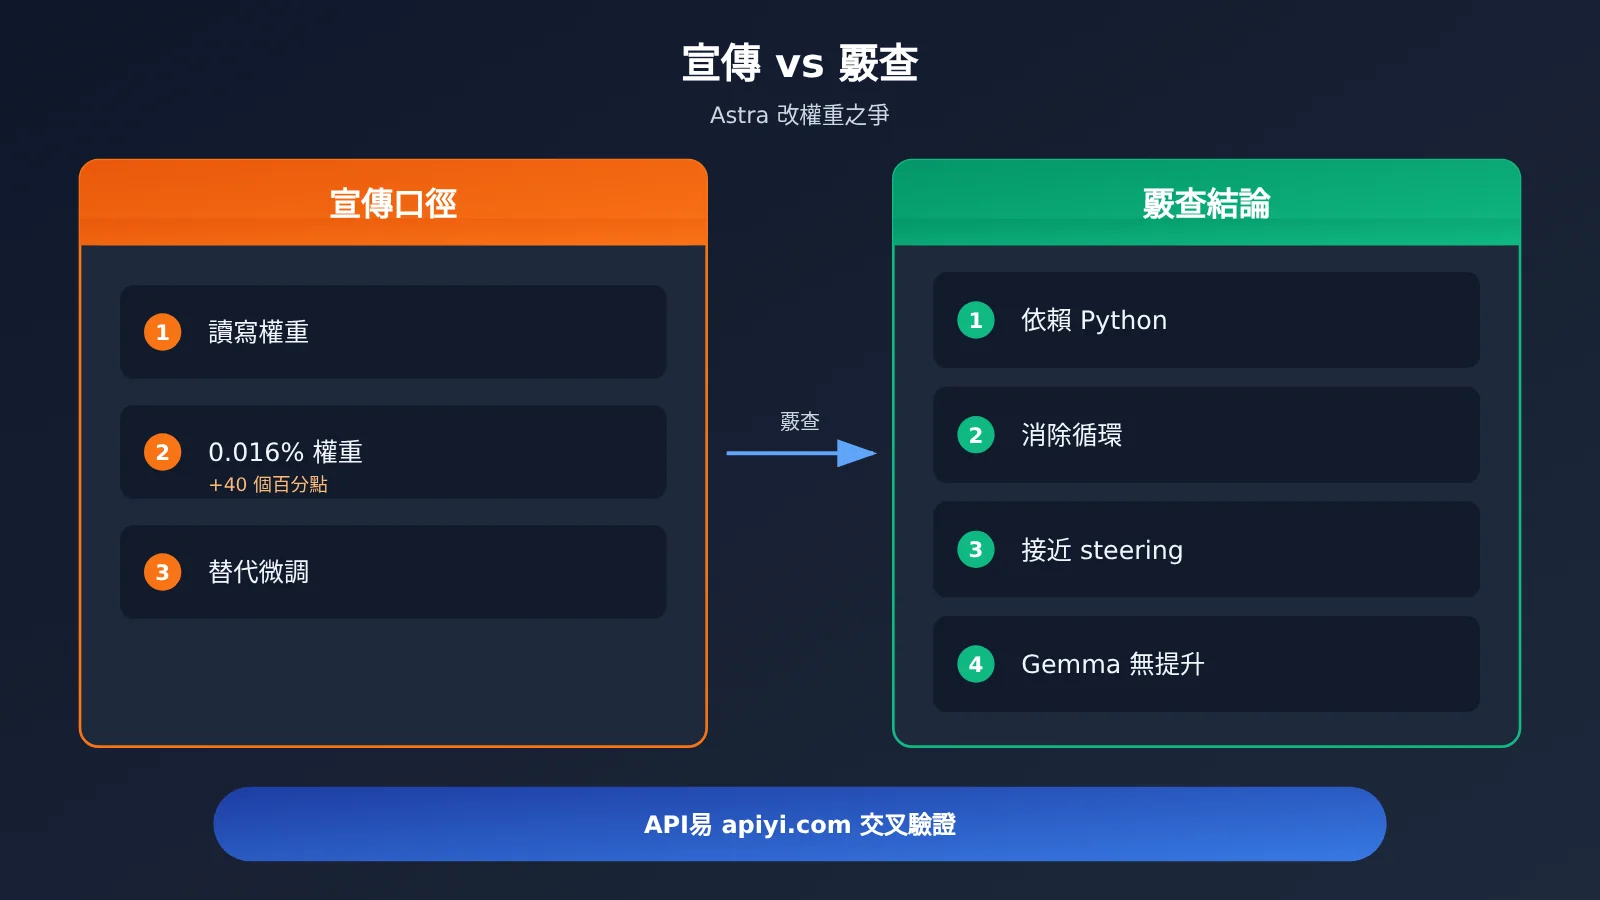
| 宣傳口徑 | 覈查維度 | 覈查結論 |
|---|---|---|
| Astra 能讀懂神經網絡權重 | 工具權限 | 小網絡上純文本可行,8 億參數模型依賴 Python 分析 |
| 改 0.016% 權重提升 40 個百分點 | 基線與失敗模式 | 提升主要來自循環問題緩解,觸頂率從 93.0% 降到 33.1% |
| 開創權重空間編程 | 方法新穎性 | 核心操作接近已有的 steering 技術 |
| 可替代部分微調 | 泛化能力 | Gemma 上無確定提升,只能清除障礙、不能添加能力 |
| 結果真實可靠 | 獨立復現 | 第三方復跑得到 51.0%,數值層面可信 |
競品對標:如何看待同類能力宣傳
GPT-6 Astra 此前已多次因跑分受到關注。ARC Prize 基金會 9 月在共享評測框架下給出了 ARC-AGI-3 上 62.7% 的成績,OpenAI 也表示 Astra 達到了其 Critical 級網絡安全能力閾值。這些數字同樣適用本文清單:先問評測框架是共享的還是定製的,再問工具權限與運行次數。
Claude Opus 5.5 與 Kimi K3.1 Pro 在 R&D World 10 月 23 日的對比中被拿來與 Astra 同臺比較。不同廠商的模型在各自擅長的任務上可能保持領先,但宣傳口徑往往採用對自己最有利的設置。相比之下,用同一份題目、同一套參數自己跑一遍,比任何海報都更有說服力。
💡 選型建議:如果你想在自己的業務題目上對比這些模型,可以先在 API易 apiyi.com 上用統一接口小規模試跑。需要說明的是,API易 目前暫未上線 GPT-6 Astra,我們會盡快上線;Claude Opus 5.5、Kimi K3.1 Pro 已可直接調用。
涉及模型的 API易 可用性與價格
下表價格全部以 API易 價格頁 docs.apiyi.com/models 的實際數據爲準,計費單位請以價格頁標註爲準;本文不引用任何第三方報價。
| 模型 | API易 模型名 | 輸入價格 | 輸出價格 | 緩存價格 | 可用狀態 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | API易 已上線 |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | API易 已上線 |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | API易 已上線 |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | API易 已上線 |
| Qwen3.8 系列 | qwen3.8 系列 | 見價格頁 | 見價格頁 | 見價格頁 | API易 已上線 |
| GPT-6 Astra | 無 | 無 | 無 | 無 | API易 目前暫未上線該模型,會盡快上線 |
| Qwen3.5-0.8B | 無 | 無 | 無 | 無 | API易 目前暫未上線該模型,會盡快上線 |
| Gemma 3 270M | 無 | 無 | 無 | 無 | API易 目前暫未上線該模型,會盡快上線 |
Qwen3.5-0.8B 與 Gemma 3 270M 是開放權重的小模型,研究中修改後的 Qwen 檢查點也公開在 Hugging Face 上,想復現權重編輯本身,需要在本地加載權重;而做跨模型的能力對比,則更適合用雲端 API。
常見問題 FAQ
Q1:Astra 修改 Qwen 權重到底是一項什麼研究?
MIT CSAIL 團隊測試 GPT-6 Astra 能否理解和改寫其他神經網絡的權重。頭條實驗中,Astra 改動 Qwen3.5-0.8B 約 0.016% 的權重,讓 MATH-500 從 7.9% 提升到 48.1%,相關日誌與模型均已公開。
Q2:批評者和作者的分歧到底在哪裏?
分歧不在數據真假,而在解釋。作者強調模型具備讀寫權重的能力;Honnibal 認爲不同工具權限的實驗被合併成一個大結論,Goedecke 認爲 Qwen 修復屬於已有的 steering 技術,核心工作是人類工程師也會寫的 Python 分析。
Q3:這項研究什麼時候發佈,後續還有進展嗎?
研究於 2026 年 11 月 2 日以博客形式發佈,一天內即出現公開批評,Hacker News 上也有長篇討論。作者表示正在構建衡量該能力的基準和評測框架,後續數據值得繼續關注。
Q4:6 步覈查清單適合哪些場景?
– **技術選型**:在採購或接入模型前,審視廠商跑分與宣傳文案
– **研究閱讀**:快速判斷一篇論文的頭條數字含金量
– **內部彙報**:向團隊解釋某項“突破”時,給出有邊界的結論
– **內容寫作**:撰寫模型評測時避免被單一數字帶偏
Q5:如何用 API 自己驗證模型能力宣傳?
最直接的辦法是準備一份與你業務相近的題目集,固定推理模式和輸出長度,在多個模型上各跑一遍。通過 API易 apiyi.com 可以用兼容 OpenAI 與 Anthropic 格式的統一接口調用 Claude Opus 5.5、Kimi K3.1 Pro、Qwen3.8 系列等模型,接入方式見 docs.apiyi.com,費用以 docs.apiyi.com/models 爲準。
Q6:這項研究有哪些已知侷限?
一是大模型實驗依賴 Python 工具和多輪練習,並非純粹“讀懂”權重;二是提升主要來自緩解循環,且依賴開啓思考模式;三是在 Gemma 上沒有確定提升,說明無法憑空添加能力;四是用於自我改進等應用目前仍是作者提出的設想,尚未被證實。
Q7:研究中提到的智能體協作風險和 Astra 有關嗎?
OpenAI 在 8 月 26 日披露的 Hugging Face 事件中,主要由內部研究模型 IM1 驅動,官方明確將 Astra 排除在該事件之外。“多智能體協作 + 權重編輯”的組合目前只是一種推測,並未被這項研究證明。
拆解模型能力宣傳核心要點 Key Takeaways
- 先問基線:Qwen 基線低主要因爲 93% 答案觸頂,提分大多來自修復循環
- 再問工具:純文本讀權重只在小網絡成立,大模型實驗依賴 Python 環境
- 對照舊技術:Qwen 修復接近 steering,價值在於自主完成工程流程
- 審視評測設置:思考模式、token 上限、練習批次都會影響最終分數
- 尋找反例:Gemma 無確定提升,說明編輯只能清障礙、不能加能力
- 認可獨立復現:第三方復跑 51.0%,數值可信但解讀需謹慎
- 親手驗證:用 API易 apiyi.com 統一接口在自己的題目上交叉對比模型
總結
Astra 修改 Qwen 權重之爭給我們的最大啓發,不是某個模型強或弱,而是一項真實可復現的結果,同樣可能被包裝成超出證據範圍的結論。拆解模型能力宣傳的核心要點:
- 數字要配上失敗模式:沒有基線和觸頂率,48.1% 本身說明不了太多
- 結論要配上條件:工具權限、推理模式、練習次數決定了結論的邊界
- 成功要配上反例和復現:Gemma 反例與第三方復跑,共同界定了結果的真實含義
下一次再看到“某模型實現突破”的標題,不妨把這 6 個問題逐一過一遍,再用自己的數據跑一次。推薦通過 API易 apiyi.com 在同一套接口下對比多個模型,文檔見 docs.apiyi.com,價格以 docs.apiyi.com/models 爲準。
📚 參考資料
- 36氪報道:MIT神作被錘爆:Astra爆改Qwen權重?就吹吧
- 鏈接:
36kr.com/p/4056481264866438 -
說明:國內媒體對本次爭議的中文報道
-
原始研究博客:Sparks of Weight-Space Programming
- 鏈接:
rikiyat.github.io/blog/weight-space-programming -
說明:MIT CSAIL 團隊的原始實驗描述
-
實驗日誌倉庫:lm_understand-logs
- 鏈接:
github.com/RikiyaT/lm_understand-logs -
說明:包含 Qwen 實驗 README 與各實驗完整日誌
-
Matthew Honnibal 的批評文章
- 鏈接:
honnibal.dev/blog/astra-read-write-misleading -
說明:從工具權限角度分析宣傳口徑
-
Sean Goedecke 的批評文章
- 鏈接:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
說明:將 Qwen 修復與 steering 技術進行對照
-
修改後的 Qwen 模型卡
- 鏈接:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - 說明:包含第三方獨立復跑結果
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心