Note de l’auteur : à partir de la controverse autour de la modification des poids de Qwen3.5-0.8B par GPT-6 Astra, cet article propose une méthode en 6 étapes pour examiner les annonces sur les capacités des modèles : points de référence, accès aux outils, paramètres d’évaluation et preuves de reproductibilité.
Une annonce selon laquelle « un modèle de pointe a compris et modifié les poids d’un autre modèle, faisant bondir son score en mathématiques de 7,9 % à 48,1 % » a de quoi enflammer toute la communauté de l’IA. Mais moins d’une journée plus tard, un développeur publiait une réfutation, tandis que des médias chinois reprenaient l’affaire sous le titre « Le chef-d’œuvre du MIT démoli ». À travers cette controverse sur la modification des poids de Qwen par Astra, nous allons construire une méthode réutilisable pour examiner les annonces sur les capacités des modèles.
Cet article ne prend pas parti : plutôt que de juger qui a raison ou tort, nous confrontons pas à pas les journaux d’expérience originaux, les déclarations de l’auteur et les critiques, pour transformer ce sujet d’actualité en une liste de vérification réutilisable.
Ce que vous allez en retirer : 6 questions pour examiner toute annonce de « percée » dans les capacités d’un modèle et éviter les pièges lors du choix d’un modèle, de la préparation d’un rapport ou d’une évaluation technique.
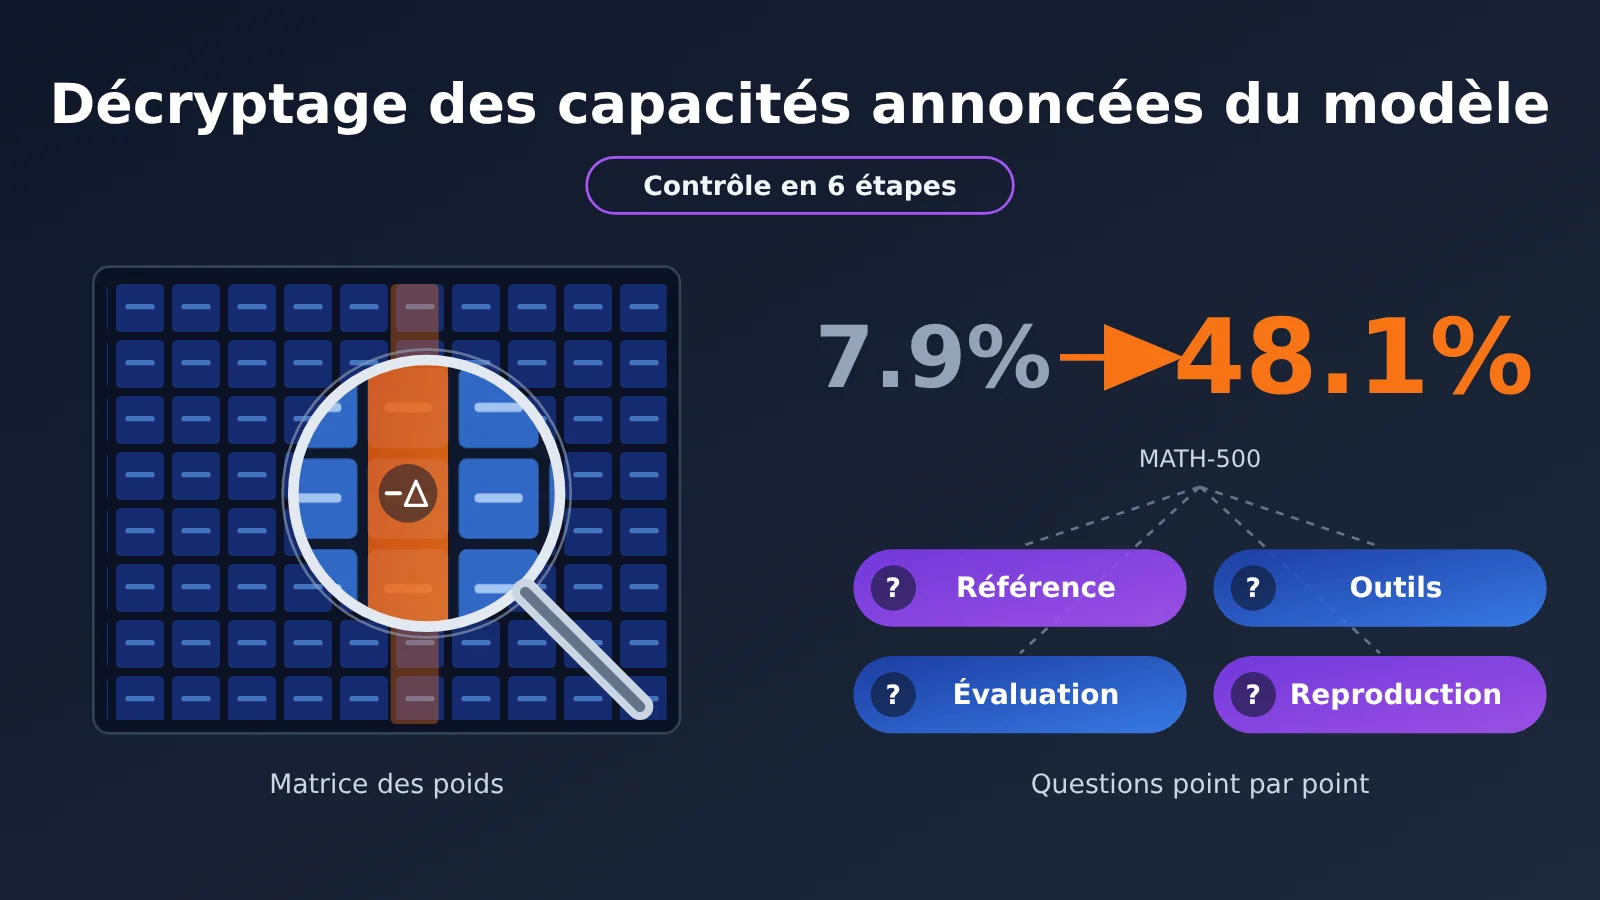
Les points clés du débat sur la modification des poids de Qwen par Astra
Commençons par un tableau des faits et des points de controverse. L’analyse qui suit s’appuie sur ces éléments.
| Point clé | Explication | Ce qu’il faut retenir pour décrypter les annonces |
|---|---|---|
| Origine de la recherche | Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, du MIT CSAIL, ont publié le 2 novembre 2026 le billet Sparks of Weight-Space Programming, ainsi que les journaux d’expérimentation et les modèles modifiés | La publication des journaux est un premier critère pour juger de la crédibilité |
| Résultat mis en avant | GPT-6 Astra a modifié 131,072 des quelque 800 millions de poids de Qwen3.5-0.8B (environ 0.016 %), faisant passer son score MATH-500 de 7.9 % à 48.1 % | Plus une progression paraît spectaculaire, plus il faut se demander pourquoi le score de départ est si bas |
| Outils disponibles | Dans cette expérience, Astra travaillait dans un environnement Python où les poids étaient chargés et pouvait exécuter jusqu’à 50 lots d’évaluation d’entraînement | « Comprendre les poids » et « écrire du code pour les analyser » sont deux choses différentes |
| Principales critiques | Matthew Honnibal estime que la communication regroupe sous une même conclusion des expériences donnant accès à différents outils ; Sean Goedecke considère que la correction de Qwen repose essentiellement sur une technique de steering déjà connue | Pour déterminer si une méthode est nouvelle, il faut la comparer aux techniques existantes |
| Contre-exemple | Appliqué à Gemma 3 270M, le même processus n’a fait passer le score MATH-500 que de 6.8 % à 7.7 % au maximum ; les auteurs eux-mêmes estiment que l’amélioration n’est pas concluante | Une méthode efficace sur un modèle ne se généralise pas forcément à d’autres |
Comment Astra a réellement modifié les poids de Qwen
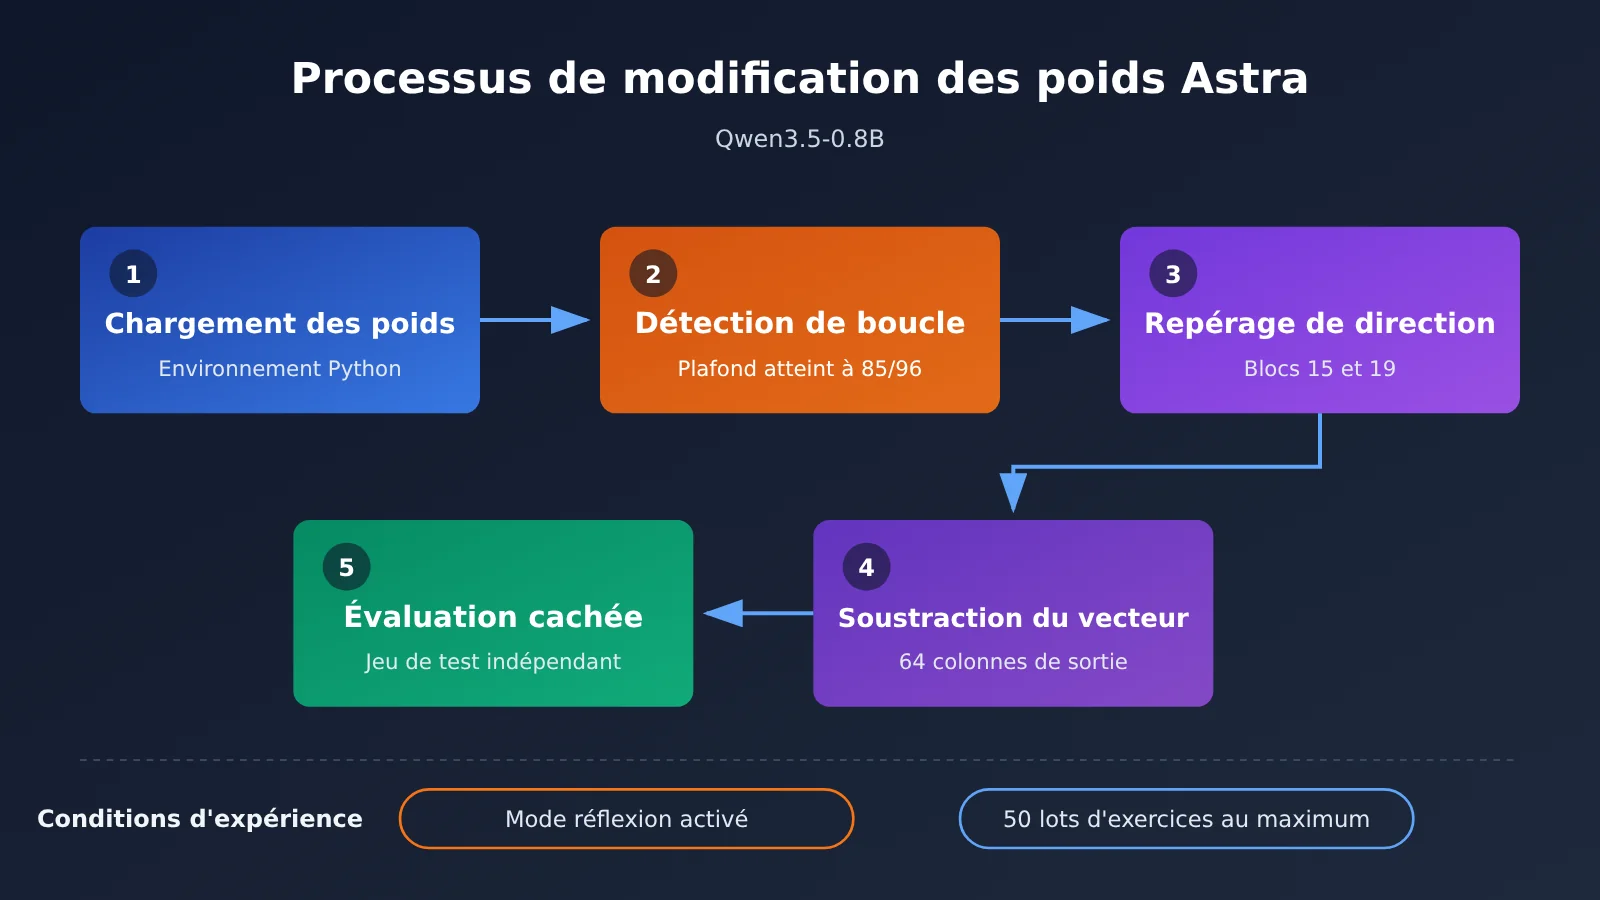
Les détails de l’expérience montrent que l’histoire est bien plus complexe que « lire les poids pour améliorer le score ». Lorsque le mode de réflexion est activé, Qwen3.5-0.8B présente un sérieux problème de boucles : parmi les 96 premières réponses d’entraînement examinées par Astra, 85 ont atteint la limite de 32,768 tokens sans donner de réponse. Cette faiblesse était déjà signalée dans la fiche officielle du modèle Qwen. À noter que ce modèle fonctionne par défaut sans mode de réflexion : celui-ci a été activé spécialement pour l’expérience.
Astra a ensuite identifié l’origine de ces boucles dans une certaine direction produite par les couches feed-forward des blocs 15 et 19, puis a soustrait cette direction de 64 colonnes de sortie de chaque bloc. Selon le README de l’expérience, 131,072 poids devaient être modifiés ; après arrondi à la précision utilisée pour l’évaluation, 130,188 l’ont effectivement été. L’exécution réussie a lancé du code Python 80 fois et duré 20.3 heures, dont 4.7 heures d’interruption du service.
Analyser les annonces sur les capacités d’un modèle : une liste de vérification en 6 étapes
Cette liste est tirée de la controverse autour de la modification des poids de Qwen par Astra. Chaque étape correspond à une question précise et s’applique aussi bien aux articles scientifiques qu’aux présentations de lancement, aux visuels de résultats de benchmarks ou aux textes marketing des fabricants.
Étape 1 : examiner les résultats de référence et les modes d’échec
Face à toute annonce d’une « amélioration de X points de pourcentage », posez-vous d’abord cette question : pourquoi le résultat initial était-il si mauvais ? Le score de référence de Qwen3.5-0.8B n’était que de 7.9%, tandis que 93.0% de ses réponses à MATH-500 atteignaient la limite de tokens. Autrement dit, le modèle ne manquait pas nécessairement de capacités : souvent, il ne terminait tout simplement pas sa réponse.
Comparez la dernière colonne du tableau ci-dessous à la première : la forte hausse des scores coïncide presque exactement avec la forte baisse du taux de réponses atteignant la limite.
| Version de Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Proportion de réponses MATH-500 atteignant la limite |
|---|---|---|---|---|
| Modèle de base | 7.9% | 13.8% | 21.0% | 93.0% |
| Version modifiée, 10 lots d’exercices | 12.3% | 25.7% | 49.0% | 87.2% |
| Version modifiée, 25 lots d’exercices | 14.1% | 25.1% | 39.9% | 86.4% |
| Version modifiée, 50 lots d’exercices | 48.1% | 67.1% | 62.3% | 33.1% |
Source des données : Takehi et al., MIT CSAIL, 2 novembre 2026, mode de réflexion activé. Le texte original précise que chaque version modifiée a été exécutée indépendamment et comporte des modifications différentes. Les 131,072 modifications de poids mises en avant correspondent à la ligne des 50 lots.
Étape 2 : examiner les outils à la disposition du modèle
C’est le cœur de la critique de Honnibal. L’étude rapporte au total 8 expériences et une expérience complémentaire sur Gemma, mais les conditions offertes au modèle varient considérablement : dans certains cas, il ne reçoit que les poids bruts sous forme de texte, sans aucun outil ; dans d’autres, il dispose d’un environnement Python complet et de plusieurs cycles d’entraînement et d’évaluation. Regrouper ces expériences sous la seule conclusion « capable de lire et de modifier les poids » risque d’amener le lecteur à surestimer sa capacité à les « comprendre » sans aide.
| Expérience | Taille du réseau | Conditions offertes à Astra | Résultat |
|---|---|---|---|
| Identifier le jeu auquel joue le réseau | 17 253 poids | Poids bruts en texte brut | 4/4 corrects |
| Identifier les formes dessinées par un modèle de diffusion | 23 824 | Poids bruts en texte brut | 3/3 corrects |
| Identifier le texte d’entraînement d’un petit modèle de langage | 7,2 millions | Couches intermédiaires + Python | 3/3 corrects |
| Corriger une stratégie de conduite bloquée | 171 664 | Poids bruts, description du scénario, 1 enregistrement d’échec | Taux de réussite de 0 % à 100 % |
| Écrire de zéro un réseau de go 9×9 | 1,48 million | Python, jusqu’à 50 essais | Bat un réseau PPO de même taille |
| Repérer le modèle qui flatte l’utilisateur | 270 millions | D’abord Python, puis ajout des motifs d’attention | Échec initial, puis 3/3 |
| Corriger Qwen en mathématiques | 800 millions | Python, jusqu’à 50 lots d’essais | MATH-500 de 7,9 % à 48,1 % |
| Améliorer Gemma en mathématiques | 270 millions | Python, jusqu’à 50 lots d’essais | Aucune amélioration certaine (au plus 0,9 point de pourcentage) |
Ce tableau s’appuie sur la synthèse de l’étude originale par R&D World ; la classification des accès reprend celle de Honnibal. On le voit d’un coup d’œil : les expériences de lecture des poids en texte brut portent toutes sur de petits réseaux de quelques dizaines de milliers de paramètres. Lorsqu’il s’agit de modifier un modèle de langage de 800 millions de paramètres, le modèle dispose d’un environnement de travail Python qu’utiliserait aussi un ingénieur humain en apprentissage automatique.
Étape 3 : comparer avec les techniques existantes pour juger de la nouveauté
Goedecke souligne que trouver une direction d’activation, puis la soustraire des poids, revient essentiellement à appliquer une technique éprouvée : le steering, ou guidage des activations. Cela n’enlève rien à la valeur du résultat, mais en change la portée : ce qui mérite l’attention, c’est que « le modèle peut mener de façon autonome un processus standard d’ingénierie de l’interprétabilité », et non qu’il « possède une capacité surhumaine à lire les poids ».
Étape 4 : vérifier si les conditions d’évaluation ont été choisies avec soin
Plusieurs détails doivent être vérifiés un par un : le mode de raisonnement par défaut a-t-il été modifié ? Quelle limite de tokens a été fixée ? Combien de questions le modèle peut-il générer à chaque exercice ? Dans cette expérience, chaque appel permettait de générer jusqu’à 512 questions ou d’examiner les activations internes de 1 024 extraits de texte au maximum. Les questions d’évaluation étaient-elles isolées du processus de modification ? L’article précise que les questions et les résultats d’évaluation étaient invisibles pour le modèle pendant la modification : c’est un point positif. Mais l’activation du mode de réflexion a justement amplifié la tendance de Qwen à tourner en boucle, et ce point doit aussi figurer dans votre conclusion.
Étape 5 : chercher les contre-exemples et les limites
Gemma 3 270M constitue l’un des ensembles de données les plus instructifs de cette étude. Ce modèle tourne rarement en boucle : seules 8,5 % de ses réponses atteignent la limite de génération, contre 93 % pour Qwen. La même procédure n’a pas produit d’amélioration nette sur Gemma. Selon les auteurs, la modification des poids peut lever les obstacles qui masquent certaines capacités, mais elle ne peut pas créer de toutes pièces des capacités que le modèle ne possède pas. Si une présentation promotionnelle ne montre que les réussites et passe sous silence les échecs, sa crédibilité s’en trouve réduite.
Étape 6 : vérifier l’existence d’une reproduction indépendante
La carte du modèle modifié mentionne une reproduction indépendante réalisée par akhaliq, de Hugging Face, avec ML Intern. Elle couvre les 500 questions de MATH-500, soit 2 000 générations au total, et obtient un score de 51,0 %, avec 31,6 % de réponses atteignant la limite de génération. Ces résultats concordent globalement avec ceux de l’étude initiale : la hausse du score semble donc fiable. Le débat porte sur la manière de l’interpréter, pas sur une éventuelle falsification.
🎯 Conseil pratique : après avoir lu une présentation promotionnelle, le mieux est de comparer vous-même les performances de plusieurs modèles sur la même série de questions. APIYI apiyi.com propose l’accès par API à des modèles comme Claude Opus 5.5, Kimi K3.1 Pro et la série Qwen3.8. Compatible avec les formats d’interface OpenAI et Anthropic, le service permet de changer facilement de modèle dans un même script pour effectuer des vérifications croisées. Consultez la documentation sur docs.apiyi.com pour les instructions d’intégration.
Confronter les arguments et les critiques sur Astra avec une checklist
En appliquant la checklist en 6 étapes à cette controverse, on obtient un tableau comparatif « affirmation vs conclusion de la vérification ». Vous pourrez reprendre ce format pour vos futurs rapports d’évaluation technique.
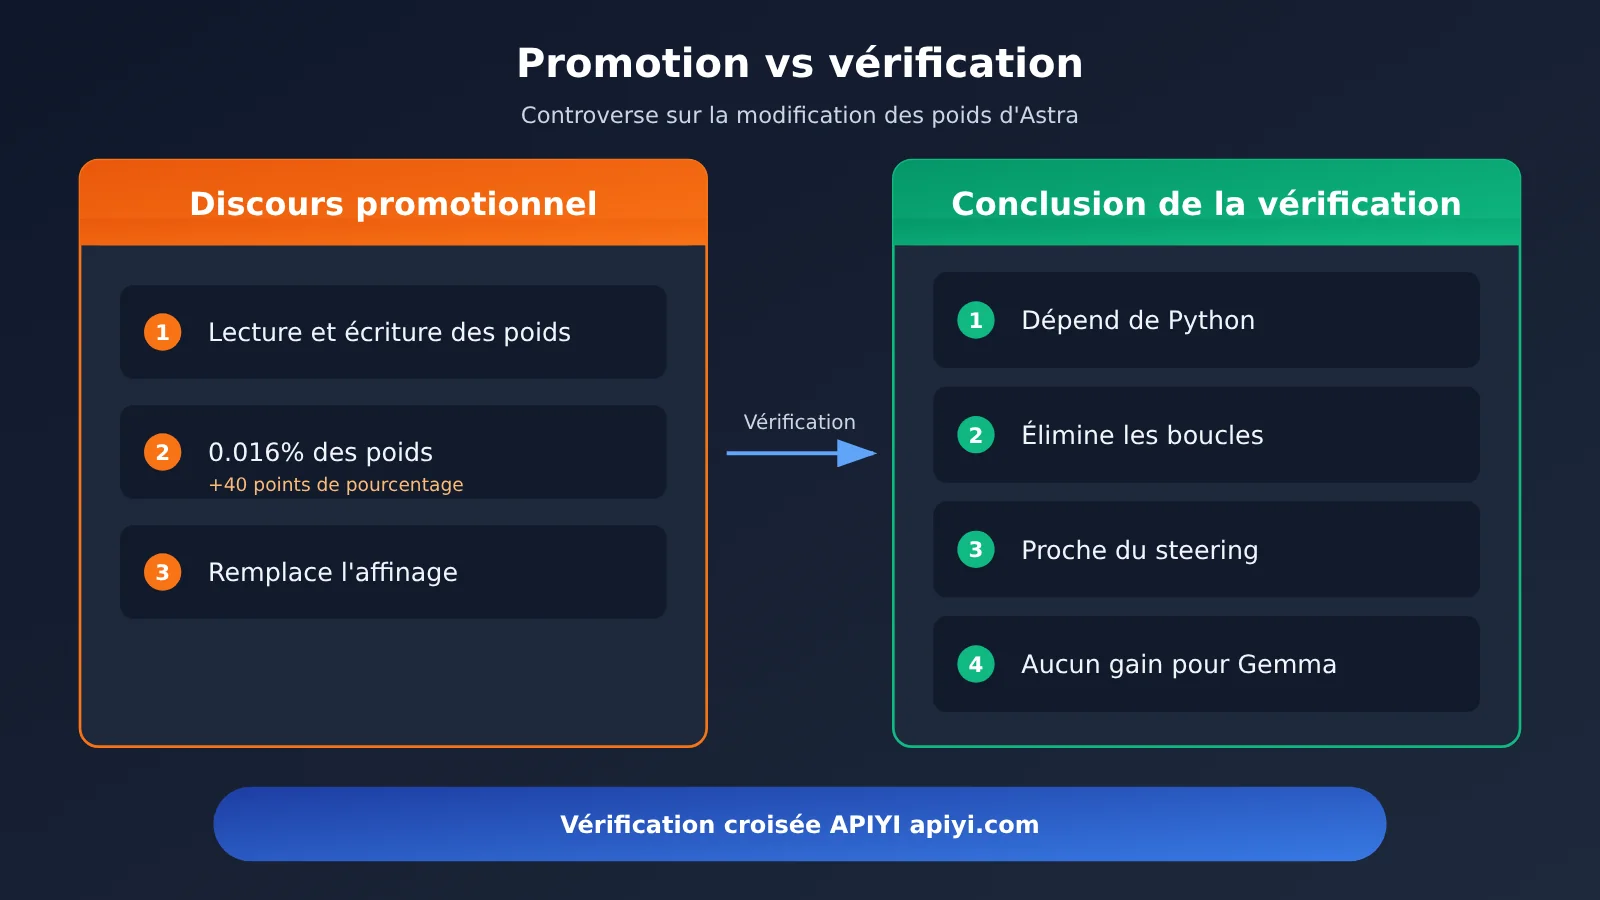
| Arguments promotionnels | Critère de vérification | Conclusion de la vérification |
|---|---|---|
| Astra comprend les poids des réseaux neuronaux | Accès aux outils | Possible en texte seul sur un petit réseau ; l’analyse du modèle de 800 millions de paramètres dépend de Python |
| Modifier 0,016 % des poids apporte un gain de 40 points de pourcentage | Référence et modes d’échec | Le gain provient surtout de l’atténuation des problèmes de boucles : le taux d’atteinte de la limite passe de 93,0 % à 33,1 % |
| Une approche pionnière de programmation dans l’espace des poids | Nouveauté de la méthode | L’opération centrale est proche des techniques de steering existantes |
| Peut remplacer une partie du fine-tuning | Capacité de généralisation | Aucune amélioration certaine sur Gemma : la méthode peut lever des obstacles, mais pas ajouter de nouvelles capacités |
| Les résultats sont fiables | Reproduction indépendante | Une reproduction par un tiers a obtenu 51,0 % : les chiffres sont crédibles |
Comparaison avec la concurrence : comment interpréter les annonces de capacités similaires
GPT-6 Astra a déjà attiré l’attention à plusieurs reprises grâce à ses résultats aux tests. En septembre, la fondation ARC Prize lui a attribué un score de 62,7 % sur ARC-AGI-3 dans un cadre d’évaluation partagé. OpenAI a également indiqué qu’Astra avait atteint son seuil de capacités de cybersécurité de niveau Critical. La grille de lecture de cet article s’applique aussi à ces chiffres : demandez-vous d’abord si le cadre d’évaluation est partagé ou personnalisé, puis vérifiez les autorisations d’accès aux outils et le nombre d’exécutions.
Claude Opus 5.5 et Kimi K3.1 Pro ont été comparés à Astra dans un article de R&D World publié le 23 octobre. Les modèles des différents fournisseurs peuvent rester en tête sur les tâches qu’ils maîtrisent le mieux, mais leurs annonces s’appuient souvent sur les configurations qui leur sont les plus favorables. À l’inverse, effectuer ses propres tests avec les mêmes questions et les mêmes paramètres est plus convaincant que n’importe quelle affiche promotionnelle.
💡 Conseil pour choisir : si vous souhaitez comparer ces modèles sur vos propres cas d’usage, vous pouvez commencer par un essai à petite échelle via l’interface unifiée d’APIYI sur apiyi.com. À noter : GPT-6 Astra n’est pas encore disponible sur APIYI ; nous le proposerons dès que possible. Claude Opus 5.5 et Kimi K3.1 Pro peuvent déjà être appelés directement.
Disponibilité et tarifs des modèles concernés sur APIYI
Tous les prix du tableau proviennent de la page tarifaire d’APIYI, docs.apiyi.com/models. Consultez cette page pour connaître les unités de facturation. Cet article ne cite aucun tarif tiers.
| Modèle | Nom du modèle sur APIYI | Prix en entrée | Prix en sortie | Prix du cache | Disponibilité |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | Disponible sur APIYI |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | Disponible sur APIYI |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | Disponible sur APIYI |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Disponible sur APIYI |
| Série Qwen3.8 | Série qwen3.8 | Voir la page tarifaire | Voir la page tarifaire | Voir la page tarifaire | Disponible sur APIYI |
| GPT-6 Astra | Aucun | Aucun | Aucun | Aucun | Pas encore disponible sur APIYI, mais sera ajouté dès que possible |
| Qwen3.5-0.8B | Aucun | Aucun | Aucun | Aucun | Pas encore disponible sur APIYI, mais sera ajouté dès que possible |
| Gemma 3 270M | Aucun | Aucun | Aucun | Aucun | Pas encore disponible sur APIYI, mais sera ajouté dès que possible |
Qwen3.5-0.8B et Gemma 3 270M sont de petits modèles à poids ouverts. Le point de contrôle Qwen modifié dans le cadre de l’étude est également disponible sur Hugging Face. Pour reproduire la modification des poids, il faut charger ceux-ci localement ; pour comparer les capacités de plusieurs modèles, une API cloud est plus adaptée.
Questions fréquentes (FAQ)
Q1 : En quoi consiste exactement la recherche sur la modification des poids de Qwen par Astra ?
L’équipe du MIT CSAIL a testé la capacité de GPT-6 Astra à comprendre et à modifier les poids d’autres réseaux de neurones. Dans l’expérience phare, Astra a modifié environ 0,016 % des poids de Qwen3.5-0.8B, faisant passer son score sur MATH-500 de 7,9 % à 48,1 %. Les journaux et les modèles associés ont été publiés.
Q2 : Sur quoi les critiques et les auteurs sont-ils en désaccord ?
Le désaccord ne porte pas sur l’authenticité des données, mais sur leur interprétation. Les auteurs soulignent la capacité du modèle à lire et à modifier des poids. Honnibal estime que des expériences donnant accès à des outils différents ont été regroupées pour aboutir à une conclusion générale. Goedecke considère quant à lui que la correction de Qwen relève de techniques de steering existantes et que l’essentiel du travail repose sur une analyse Python que des ingénieurs humains pourraient aussi écrire.
Q3 : Quand cette recherche a-t-elle été publiée et y a-t-il eu des développements depuis ?
La recherche a été publiée sous forme de billet de blogue le 2 novembre 2026. Des critiques publiques sont apparues dans la journée et une longue discussion a également eu lieu sur Hacker News. Les auteurs indiquent travailler à la création d’un benchmark et d’un cadre d’évaluation pour mesurer cette capacité. Les prochaines données seront donc à suivre.
Q4 : Dans quels cas utiliser la liste de vérification en 6 étapes ?
– **Choix technologique** : examiner les scores et les arguments marketing d’un fournisseur avant d’acheter ou d’intégrer un modèle
– **Lecture de recherches** : évaluer rapidement la portée du chiffre phare d’un article scientifique
– **Présentation interne** : expliquer une « percée » à son équipe en formulant des conclusions nuancées
– **Rédaction de contenu** : éviter de se laisser guider par un seul chiffre lors de l’évaluation d’un modèle
Q5 : Comment vérifier soi-même les affirmations sur les capacités d’un modèle avec une API ?
Le plus simple est de préparer un ensemble de questions proches de vos besoins métier, de fixer le mode de raisonnement et la longueur des réponses, puis de faire passer le même test à plusieurs modèles. APIYI apiyi.com permet d’appeler des modèles comme Claude Opus 5.5, Kimi K3.1 Pro et la série Qwen3.8 à travers une interface unifiée compatible avec les formats OpenAI et Anthropic. Les instructions d’intégration se trouvent sur docs.apiyi.com et les tarifs sur docs.apiyi.com/models.
Q6 : Quelles sont les limites connues de cette recherche ?
Premièrement, les expériences sur les grands modèles de langage reposent sur des outils Python et plusieurs séries d’exercices : il ne s’agit pas simplement de « comprendre » les poids. Deuxièmement, les gains viennent surtout de la réduction des boucles et dépendent de l’activation du mode de raisonnement. Troisièmement, aucune amélioration n’a été établie sur Gemma, ce qui indique qu’on ne peut pas créer des capacités à partir de rien. Enfin, les applications comme l’auto-amélioration restent à ce stade des hypothèses proposées par les auteurs et n’ont pas encore été démontrées.
Q7 : Les risques liés à la collaboration entre agents évoqués dans la recherche concernent-ils Astra ?
L’incident Hugging Face divulgué par OpenAI le 26 août impliquait principalement IM1, un modèle de recherche interne. OpenAI a explicitement exclu Astra de cet incident. La combinaison « collaboration multi-agents + modification des poids » reste pour le moment une hypothèse et n’a pas été démontrée par cette recherche.
Les points clés pour décortiquer les affirmations sur les capacités des modèles
- Commencez par le score de référence : celui de Qwen est faible surtout parce que 93 % des réponses atteignent la limite ; l’amélioration vient en grande partie de la correction de boucles
- Examinez les outils : lire les poids en texte brut ne fonctionne que pour les petits réseaux ; les expériences sur les grands modèles de langage nécessitent un environnement Python
- Comparez avec les techniques existantes : la correction de Qwen se rapproche du steering ; sa valeur tient à l’exécution autonome du processus d’ingénierie
- Examinez les conditions d’évaluation : le mode de raisonnement, la limite de tokens et les lots d’entraînement influencent le score final
- Cherchez les contre-exemples : Gemma ne montre aucune amélioration certaine, ce qui suggère que la modification peut lever des obstacles, mais pas ajouter des capacités
- Prenez en compte la reproduction indépendante : un tiers a obtenu 51,0 % en répétant l’expérience ; le chiffre est crédible, mais son interprétation demande de la prudence
- Vérifiez par vous-même : utilisez l’interface unifiée d’APIYI apiyi.com pour comparer les modèles sur vos propres questions
Conclusion
La controverse autour de la modification des poids de Qwen par Astra nous rappelle avant tout qu’un résultat réel et reproductible peut lui aussi être présenté à l’appui de conclusions qui dépassent les preuves disponibles. Pour décortiquer les affirmations sur les capacités des modèles, retenez trois principes :
- Associez les chiffres aux modes d’échec : sans score de référence ni taux de réponses atteignant la limite, les 48,1 % ne disent pas grand-chose à eux seuls
- Associez les conclusions à leurs conditions : les autorisations d’accès aux outils, le mode de raisonnement et le nombre d’essais d’entraînement définissent les limites des conclusions
- Confrontez les succès aux contre-exemples et aux reproductions : le contre-exemple de Gemma et la reproduction par un tiers délimitent ensemble la portée réelle du résultat
La prochaine fois que vous verrez un titre annonçant qu’un modèle a réalisé une « percée », passez en revue ces six questions, puis faites un essai avec vos propres données. Pour comparer plusieurs modèles avec une même interface, vous pouvez utiliser APIYI apiyi.com. La documentation se trouve sur docs.apiyi.com et les tarifs sont indiqués sur docs.apiyi.com/models.
📚 Références
- Article de 36氪 : La prouesse du MIT remise en question : Astra aurait-il vraiment modifié les poids de Qwen ?
- Lien :
36kr.com/p/4056481264866438 -
Présentation : couverture en chinois de cette controverse par un média chinois
-
Article de recherche original : Sparks of Weight-Space Programming
- Lien :
rikiyat.github.io/blog/weight-space-programming -
Présentation : description originale des expériences par l’équipe du MIT CSAIL
-
Dépôt des journaux d’expériences : lm_understand-logs
- Lien :
github.com/RikiyaT/lm_understand-logs -
Présentation : contient le README de l’expérience Qwen et les journaux complets de chaque expérience
-
Article critique de Matthew Honnibal
- Lien :
honnibal.dev/blog/astra-read-write-misleading -
Présentation : analyse des affirmations promotionnelles sous l’angle des autorisations accordées aux outils
-
Article critique de Sean Goedecke
- Lien :
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
Présentation : compare la correction de Qwen aux techniques de steering
-
Fiche du modèle Qwen modifié
- Lien :
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - Présentation : contient les résultats d’une reproduction indépendante par un tiers
Auteur : l’équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI, apiyi.com. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.