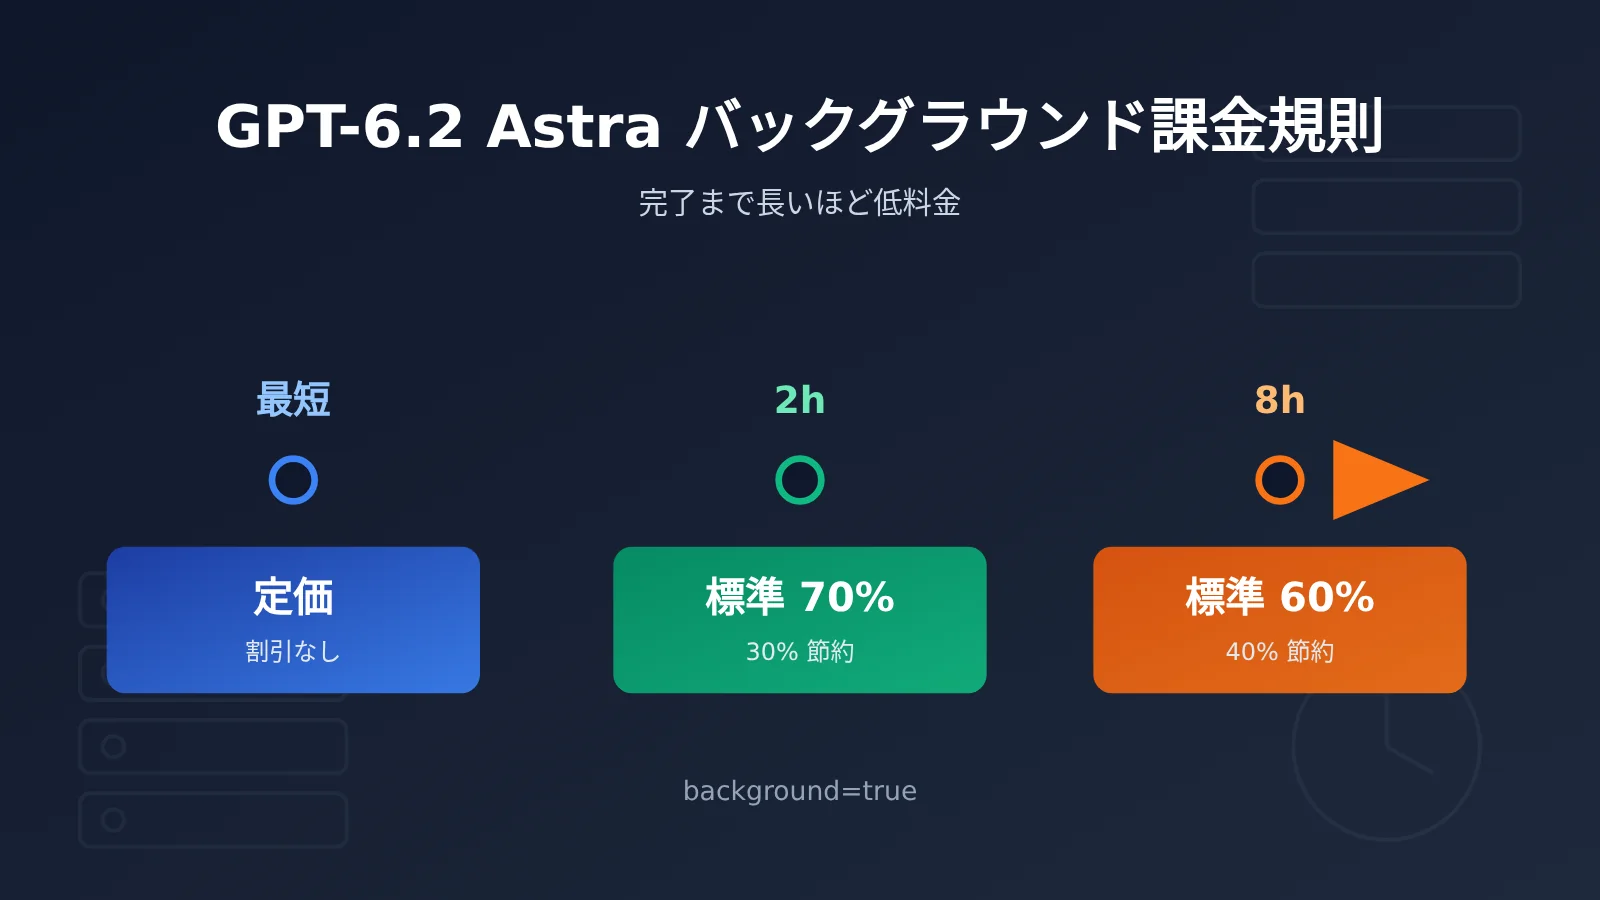
GPT-6.2 Astra のバックグラウンドタスクにおける課金ルールは、一言でまとめると「待てるなら安くなる」です。2026年11月17日から、Responses API のバックグラウンド完了ウィンドウがパブリックベータとして提供されます。デフォルトの soonest ウィンドウは、利用した処理ティアの通常料金で課金されます。2h ウィンドウを選んだ場合、対象となるリクエストは Standard モデルのトークン料金の70%で課金され、8h ウィンドウでは60%で課金されます。つまり、それぞれ30%と40%安くなります。
どのティアを選ぶかは、次の2つの問いで決まります。結果がいつまでに必要か、そしてリクエスト間で前のステップの中間結果への依存が必要かどうかです。まずこの2つの問いに答えてから使用量で費用を見積もるほうが、単価を直接比較するより確実です。
この記事を読むと分かること
- soonest、2h、8h の3つの完了ウィンドウの定義、計測開始点、料金計算の基準
- 同じ使用量(入力10万トークン+出力1万トークン)を7つのモードで使った場合の具体的なコスト
- リクエストが割引を受けるために満たす必要があるパラメータ条件、およびキュー枠とキャッシュ再利用の境界
- インタラクティブな質疑応答、チケット集約、夜間レビュー、独立した分類タスクにそれぞれどの送信方法が適しているか
目次:まず概念表と影響の早見表で用語を統一します。「客観的事実」パートでは、完了ウィンドウのルール、各ティアの料金、割引条件、マルチステップワークフローにおける後続ステップの処理を順に説明します。「分析と判断」パートでは、割引を重ねて適用できるか、マルチステップタスクの時間予算、キャッシュとキュー枠がもたらすトレードオフを議論し、ワークロードに応じたティア選択の提案も行います。
GPT-6.2 Astra バックグラウンドタスク課金の基礎知識:概念解説
| 概念 | 簡単な説明 |
|---|---|
| Standard | OpenAI APIの標準処理ティア。2h、8hのバックグラウンドウィンドウの割引は、このモデルtoken単価を基準に計算されます |
| Fast | Astraの現在の高速処理ティア。モデルtoken単価はStandardの2倍です |
| Ultrafast | さらに高速な処理ティア。プロモーション期間中はStandardの3倍、その後はリスト価格で6倍になります |
| バックグラウンドモード | リクエストはまずレスポンスIDを返し、アプリは後からステータスを照会して結果を取得します |
| 完了ウィンドウ | バックグラウンドレスポンスが受理された後のスケジューリングに用いる完了目標で、soonest、2h、8hがあります |
| soonest | バックグラウンドリクエストのデフォルトウィンドウ。できるだけ早く実行され、使用する処理ティアのモデルtoken単価が適用されます |
| Batch API | 互いに独立したリクエストをJSONLファイルにまとめ、1つのジョブとして非同期に実行します |
| continuation_id | アプリが同一のバックグラウンドワークフローに指定する識別子。対象となるフォローアップリクエストの関連付けに使用します |
| モデルtoken単価 | 通常入力、キャッシュヒット入力、出力などの計量項目ごとの単価 |
GPT-6.2 Astra バックグラウンドタスク課金の影響の概要
- API開発者:非同期タスクには、リアルタイム呼び出しとBatchの中間に位置する割引オプションが2つ増えます。ただし、バックグラウンドモードへの改修と、ポーリングまたはWebhookの処理が必要です。
- プロダクトマネージャー:要件の中で「結果が遅くともいつ利用可能になるか」を明確にする必要があります。2時間または8時間での提供を受け入れられる機能では、モデルtokenコストをそれぞれ30%または40%削減できます。
- コスト・運用責任者:2h、8h、Batchは同一のキュー枠を共有するため、大量のBatchジョブとバックグラウンド割引タスクは統合して計画する必要があり、容量を個別に算定することはできません。
客観的事実:GPT-6.2 Astra のバックグラウンドタスク課金ルール
GPT-6.2 Astra のバックグラウンドタスクには3つの完了ウィンドウがある
OpenAI は2026年11月17日に GPT-6.2 Astra と GPT-6.2 Sol を発表しました。Astra は複雑な推論、コーディング、専門業務向けのモデルで、APIモデルIDは gpt-6.2-astra です。同日の OpenAI API 更新ログには、Responses API のバックグラウンド完了ウィンドウがパブリックベータ版に入ったことが記録されています。
Astra の非同期リクエストでは background=true を設定する必要があり、ウィンドウは次の3種類に分かれます。
- soonest(デフォルト):できるだけ早く実行されます。モデルトークンは実際に使用された処理ティアで課金され、割引はありません。
- 2h:対象となるリクエストは、Standard モデルトークン料金の70%で課金されます。
- 8h:対象となるリクエストは、Standard モデルトークン料金の60%で課金されます。
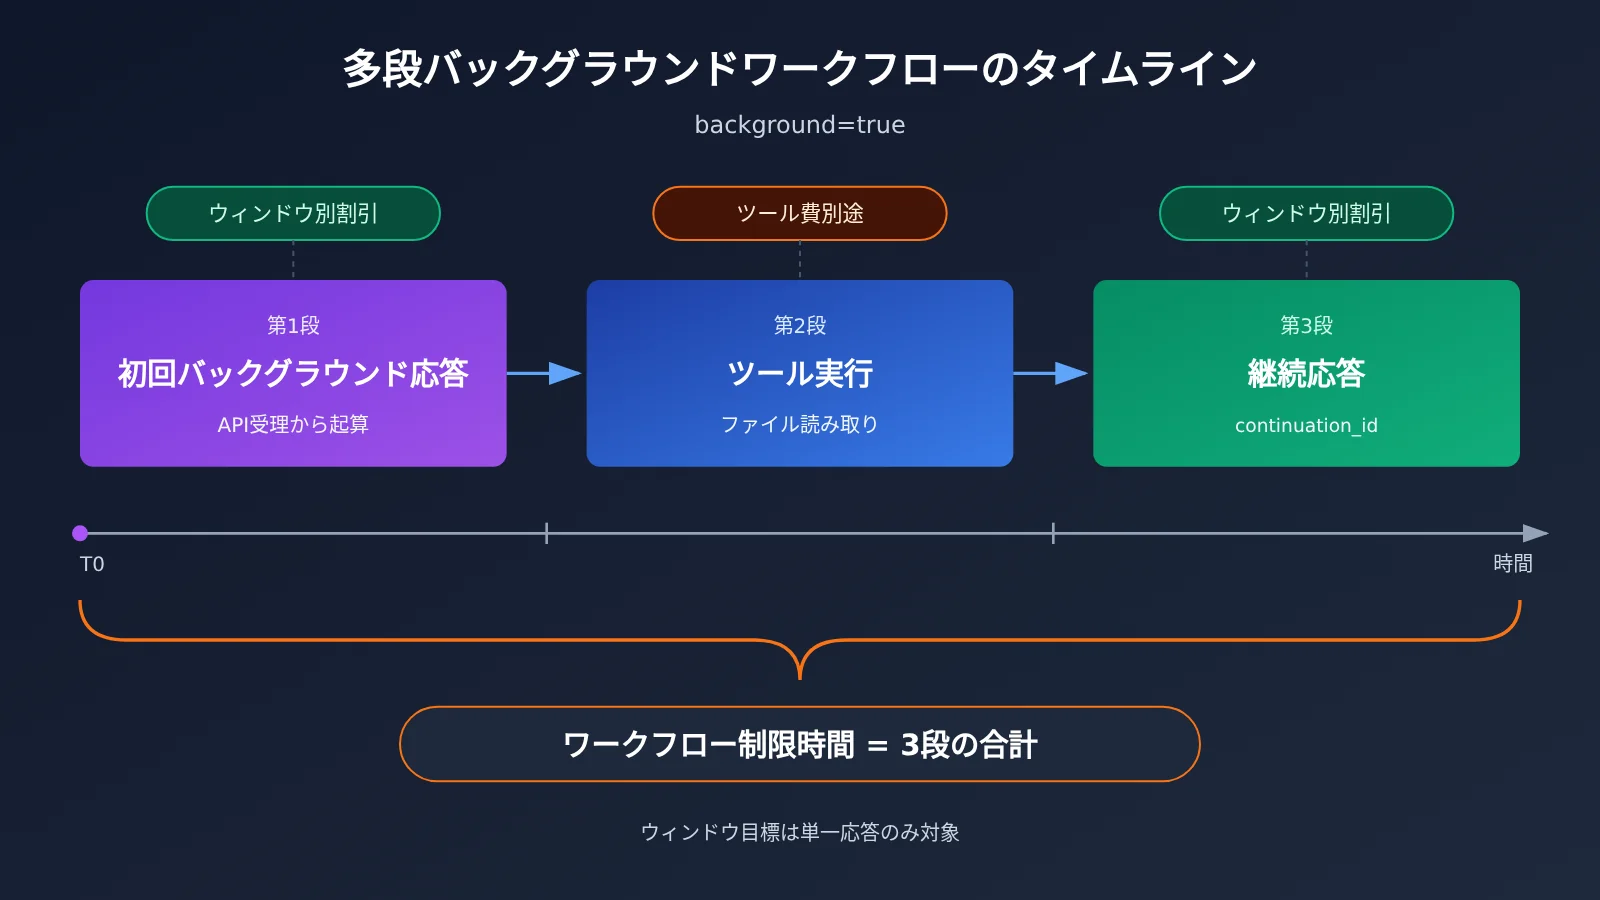
計測の起点は API が最初のリクエストを受け付けた時刻であり、ウィンドウの対象となるのはこの1件のレスポンスです。タスクの途中でアプリケーションがツールを実行し、その後さらに次のレスポンスを発行する必要がある場合、その実行時間と継続ステップの時間は、ワークフロー全体の制限時間に別途算入されます。
「まずファイルを確認し、その後レビューを続ける」を例に考えてみましょう。最初のレスポンスはウィンドウ内で完了し、アプリケーションが実行すべきツール呼び出しを返します。アプリケーションはファイルを読み取り、その結果をフォローアップリクエストとして送信すると、モデルがレビューを続けます。全体の所要時間は、最初のレスポンス、ツール実行、継続レスポンスという3段階の合計であり、1つのウィンドウだけではありません。
GPT-6.2 Astra の各ティアで同一リクエストにかかる費用
以下の表は GPT-6.2 Astra のショートコンテキスト料金(100万 token あたり、米ドル)です。2h と 8h の2行は公式の割引率から換算したもので、Ultrafast の価格適用日は米国太平洋時間で計算しています。
| モード | Standard 比 | 通常入力 | キャッシュヒット入力 | 出力 |
|---|---|---|---|---|
| Standard | 1倍 | $8.00 | $0.40 | $40.00 |
| Fast | 2倍 | $16.00 | $0.80 | $80.00 |
| Ultrafast(2027-02-28 まで) | 3倍 | $24.00 | $1.20 | $120.00 |
| Ultrafast(2027-03-01 以降) | 6倍 | $48.00 | $2.40 | $240.00 |
| バックグラウンド 2h | 0.70倍 | $5.60 | $0.28 | $28.00 |
| バックグラウンド 8h | 0.60倍 | $4.80 | $0.24 | $24.00 |
| Batch | 0.50倍 | $4.00 | $0.20 | $20.00 |
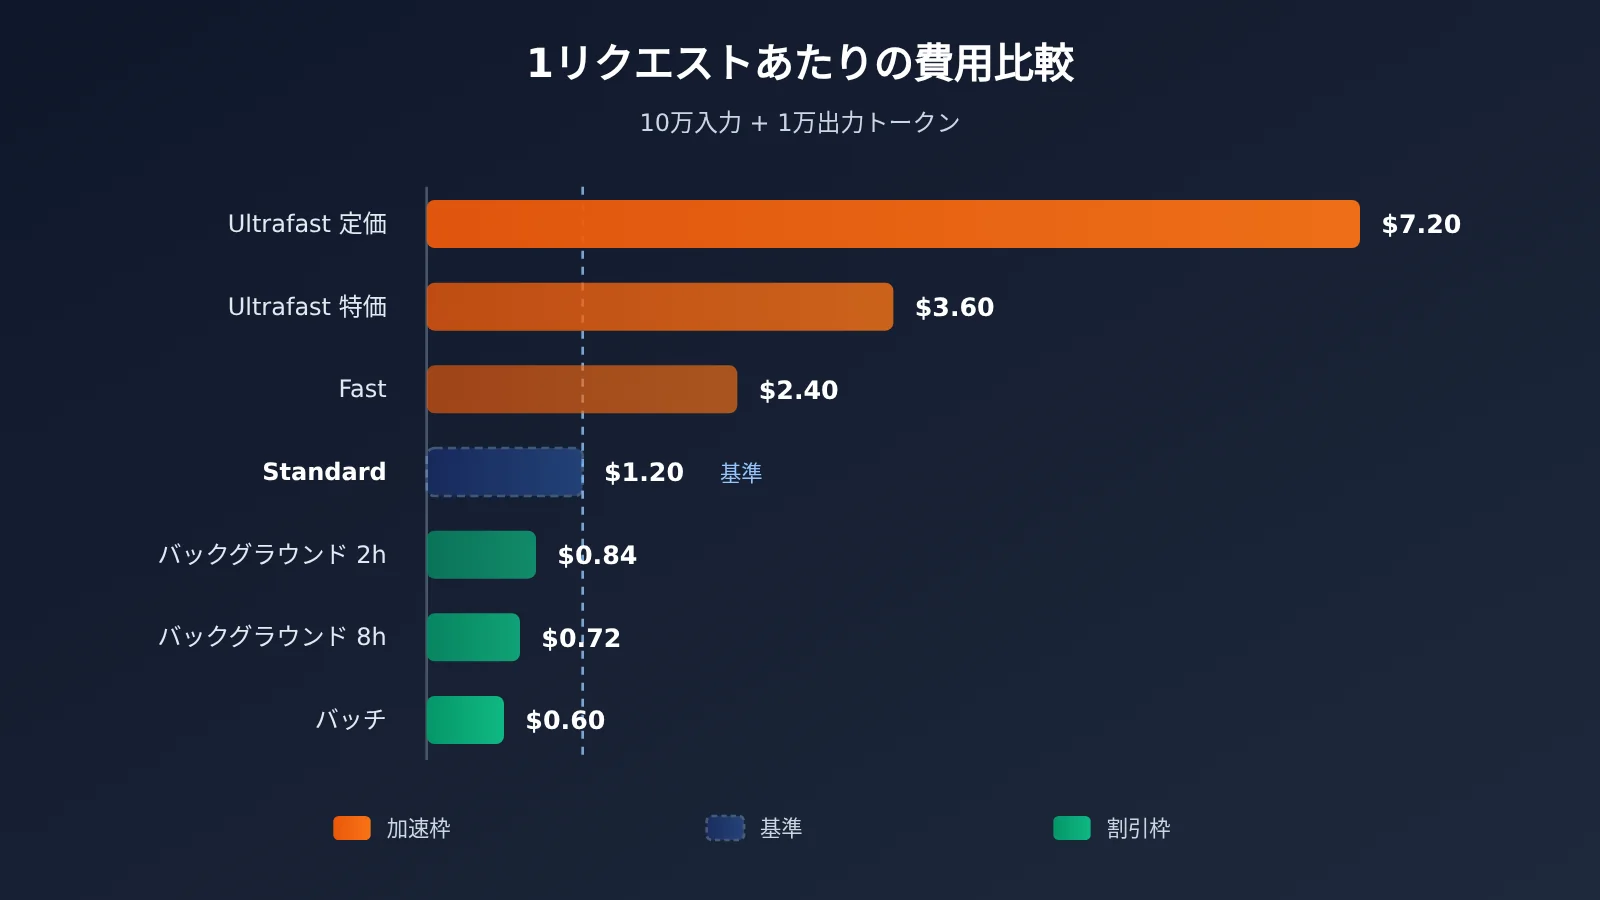
ここでは固定の使用量を基準に比較してみましょう。通常入力 100,000 token + 課金対象出力 10,000 token です。Standard は 0.1 × $8 + 0.01 × $40 = $1.20 となり、他のティアも同じ方法で換算します。
| モード | 1リクエストあたりのモデル token 費用 | Standard との差額 |
|---|---|---|
| Ultrafast 表示価格 | $7.20 | +$6.00 |
| Ultrafast プロモ価格 | $3.60 | +$2.40 |
| Fast | $2.40 | +$1.20 |
| Standard | $1.20 | 基準 |
| バックグラウンド 2h | $0.84 | −$0.36 |
| バックグラウンド 8h | $0.72 | −$0.48 |
| Batch | $0.60 | −$0.60 |
この例はモデル token のみを計算したものです。Web Search の呼び出し、Shell / Code Interpreter コンテナなどの費用は各項目ごとに別途計算され、キャッシュ書き込みも個別に課金されます。
さらにモデルカードには、入力が 272K token を超える場合、リクエスト全体にロングコンテキスト料金が適用され、入力とキャッシュの価格は2倍、出力価格は1.5倍になり、そのうえで選択したティアまたは適用可能な割引を掛けると記載されています。このルールに沿って試算すると、8h ウィンドウでのロングコンテキストリクエストは、通常入力が $16 × 0.6 = $9.6、出力が $60 × 0.6 = $36(100万 token あたり)となります。
上記の料金は OpenAI 公式の価格表と割引率をもとに換算したものです。APIYI apiyi.com 経由で呼び出す場合、実際の請求はプラットフォームの課金ページに準じます。まず少量のトラフィックで請求内容を確認してから、本番環境へ展開することをおすすめします。
GPT-6.2 Astra リクエストをバックエンドの課金割引に適合させる方法
割引は自動的に適用されるわけではなく、次の条件を同時に満たす必要があります。
| パラメータ / 条件 | 合格値 | 説明 |
|---|---|---|
| インターフェース | /v1/responses |
バックエンドの完了ウィンドウは Responses API を基準とする |
background |
true |
バックグラウンドモードに入り、まずレスポンス ID を返す |
background_options.completion_window |
2h または 8h |
デフォルトの soonest は割引なし |
service_tier |
default(Standard) |
auto は最終的に Standard になる場合のみ条件を満たす |
stream |
省略または false |
ストリーミング出力は割引条件に該当しない |
クォータについて、2h、8h、Batch は Batch/Background のキューイング枠を共有し、キューに入るときに入力トークンでカウントされます。soonest は通常のリクエスト数とトークン制限を使用します。キャッシュにはひとつ境界条件があります。Standard の通常リクエストでは、この 2 つの割引ウィンドウで作成されたプロンプトキャッシュを再利用できません。また、モデルカードの説明にあるとおり、reasoning.effort を none に設定したリクエストは拒否されますので注意してください。
以下にごく簡単な例を示します。background_options は SDK の型定義にまだ含まれていない可能性があるため、extra_body 経由で渡します。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

resp = client.responses.create(
    model="gpt-6.2-astra",
    input="请汇总以下 50 张支持工单的共性问题……",
    background=True,
    service_tier="default",          # Standardを使用、割引条件を満たす
    extra_body={"background_options": {"completion_window": "2h"}},
)
print(resp.id, resp.status)  # response IDを保存し、後で取得する
response ID を取得したら、webhook またはポーリングで状態を読み取れます。ステータスが queued または in_progress の場合は、同じ ID で引き続き照会してください。容量不足による合格範囲内のエラーは API が自動的に再試行するため、アプリ側で再送する必要はありません。
ポーリングとフォローアップリクエストの完全な例を見る
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI経由で統合アクセス
)

WINDOW = "8h"

def submit(input_items, previous_id=None):
    """バックグラウンド割引リクエストを 1 件送信する。continuation_id の具体的な渡し位置は OpenAI Background mode ガイドを参照してください。"""
    return client.responses.create(
        model="gpt-6.2-astra",
        input=input_items,
        background=True,
        service_tier="default",
        previous_response_id=previous_id,
        extra_body={
            "background_options": {"completion_window": WINDOW},
            # "continuation_id": "audit-2026-11-19-batch-01",  # 同じワークフローで一貫させる
        },
    )

def wait(response_id, interval=60):
    """終了までポーリングする。queued / in_progress の場合は同じ ID で継続して照会する。"""
    while True:
        r = client.responses.retrieve(response_id)
        if r.status not in ("queued", "in_progress"):
            return r
        time.sleep(interval)

first = wait(submit("审核合同,需要时调用 read_file 工具读取附件").id)

# アプリ側が担当するツール呼び出しが返された場合、アプリがツールを実行し、
# 同じプロジェクト、モデル、処理ティア、ウィンドウ、continuation_id で
# フォローアップリクエストを送信すると、続きのステップで優先キュー資格を取得できる
for item in first.output:
    if item.type == "function_call":
        tool_result = "……read_file 的实际返回内容……"
        follow = submit(
            [{"type": "function_call_output",
              "call_id": item.call_id,
              "output": tool_result}],
            previous_id=first.id,
        )
        print(wait(follow.id).output_text)
多段階のワークフローでは、続きのステップのリクエストに同じプロジェクト、モデル、処理ティア、ウィンドウ、continuation_id を使用することで、優先キュー資格を得られます。条件を満たすフォローアップリクエストは、それぞれ対応する割引に従って課金されます。
🚀 導入のヒント:バックグラウンド完了ウィンドウは、現在 OpenAI Responses API のパブリックベータ機能です。APIYI apiyi.com のようなアグリゲーションプラットフォーム経由で呼び出す場合は、まず無料テスト枠を使って
backgroundとcompletion_windowパラメータが完全に透過的に受け渡されるか、また課金が割引価格で決済されるかを確認したうえで、本番タスクを移行することをおすすめします。
分析判断:GPT-6.2 Astra のバックグラウンドタスク課金をうまく活用するには
GPT-6.2 Astra のバックグラウンド割引と高速化ティアは併用できません
割引の適用条件は、service_tier が default であるか、auto の最終的な適用先が Standard になることです。このことから、Fast と Ultrafast では 2h・8h の割引を同時に受けられないと判断できます。ここでのトレードオフは明快です。高速化ティアはより多くの費用と引き換えに遅延を短縮するもの、バックグラウンドウィンドウはより長い待ち時間と引き換えに低価格を得るものであり、両者の方向性は正反対です。
見落とされがちなポイントがもう 1 つあります。soonest もバックグラウンドモードではありますが、価格は処理ティアに従います。soonest と Fast を組み合わせても、支払うのは依然として Fast の価格で、インタラクションの方式が非同期になるだけです。soonest の役割は、UI が先にユーザーへ制御を返すことにあり、それ自体はコストを削減しません。
多段階タスクは「ワークフロー全体」で時間を見積もる
ウィンドウの目標は単一のレスポンスだけを制約し、ワークフロー全体をカバーするものではありません。3 回のツール呼び出しを必要とする審査タスクでは、理論上 3 回のウィンドウスケジューリングに加え、アプリケーション自身がツールを実行する時間も発生します。「朝 9 時までに結果を出す」と業務で約束している場合、8h ウィンドウで夜間の処理を行うときは、提出時刻に続きステップ用の余裕を確保する必要があり、8 時間ぎりぎりに提出してはいけません。
continuation_id の価値はここにあります。ウィンドウを延長したり統合したりはしませんが、続きステップに優先的なキューイング資格を与え、多段階フローの末尾の待ち時間を短縮できます。エンジニアリング面では、continuation_id と業務タスク ID を 1 対 1 で対応させることを推奨します。ログ調査とコスト集計も容易になります。
8h と Batch:料金差は10パーセントポイント、適用シーンが異なる
この例の使用量では、8h が $0.72、Batch が $0.60 で、両者の差はわずか $0.12 です。Batch のほうが安価ですが、リクエストを事前に JSONL へまとめられ、互いに独立しており、24時間の納品ウィンドウを受け入れられることが条件です。一方、8h ではツールの実行結果を踏まえてリクエストの推論を継続できます。
したがって、判断基準はどちらが安いかではなく、タスクの構造にあります。
- リクエスト間に依存関係がある(次のステップが前のステップの結果に依存する):8h または 2h を選択
- リクエスト同士が独立しており、一括で列挙できる:Batch を選択
Batch の 50% 割引とバックグラウンドウィンドウ割引は2つの独立した課金経路であり、重複して適用されることはありません。
キャッシュとキュー枠がもたらす隠れたコスト
割引ウィンドウで作成されたプロンプトキャッシュは、Standard の通常リクエストでは再利用できません。同じ長いシステムプロンプトをリアルタイムの質疑応答とバックグラウンドのバッチ処理の両方で使用する場合、双方がそれぞれキャッシュを構築するため、キャッシュ書き込みコストが二重に発生する可能性があります。また、キャッシュヒットした入力自体はすでに安価です。Standard は $0.40、8h は $0.24 です。キャッシュヒット率が高いワークロードでは、バックグラウンド割引による総請求額の削減率は、出力負荷の高いタスクよりも低くなります。
キュー枠の共有も事前に計画する必要があります。2h、8h、Batch は Batch/Background の枠を共有し、入力トークン数に応じてキューに登録されます。夜間に大量の Batch ジョブと 8h のレビューフローを同時に投入すると、両者が同じ枠を奪い合います。
💡 コストのヒント:ティアを決める前に、実際のプロンプトのトークン分布(通常入力、キャッシュヒット入力、出力の比率)を使って、各ティアの費用を個別に見積もることができます。APIYI apiyi.com の統合インターフェースを利用すれば、同じコードでパラメータを変更するだけで、リアルタイム経路と非同期経路の請求額の違いを比較できます。
GPT-6.2 Astra のサービスティアを実際のワークロードに当てはめる
以下はワークロードの例です。判断基準は順に、どれだけ待てるか、途中結果に依存するか、ツール費用が発生するかです。
| ワークロード | 推奨される送信方法 | 根拠 |
|---|---|---|
| 即時対話型のQ&A、誰かが待っている分析 | まずは Standard から。レイテンシとコストを検証してから Fast / Ultrafast を検討 | ユーザーが待っているため、割増料金で速度を上げるにはデータの裏付けが必要 |
| 非同期UIで、まず返却してから結果を表示したい | soonest | 制御を返し、料金は使用した処理ティアに準じる |
| 午後までに完了したいサポートチケットの集約 | バックグラウンド 2h | 数時間以内に納品、モデルの token コストが 30% 削減 |
| 一晩かけてよい、ツール呼び出しを伴う多段階レビュー | バックグラウンド 8h + continuation_id | 40% 削減、ツール実行と継続ステップ用の時間を確保 |
| 事前に組み立て可能な独立した分類タスク | Batch(JSONL) | 相互に独立し 24 時間のウィンドウを受け入れるなら、50% 削減 |
注意点として、タスクが Web Search や Code Interpreter コンテナを使うと、その部分の費用にはモデル token の割引が適用されません。ツール費用の比率が高いほど、バックグラウンドウィンドウの全体的な節約率は低くなります。
🎯 選定のヒント:まず APIYI apiyi.com で同一のサンプルバッチを使い、Standard、2h、8h をそれぞれ実行し、実際の完了時間と請求額を記録してから、タスク種別ごとのデフォルトティアを決めましょう。単価表だけを見るよりも、実コストに近い判断ができます。
引き続き注目すべき変化
バックグラウンド完了ウィンドウは現在もパブリックベータであり、パラメータ名、適用条件、割引率は正式リリース前に変更される可能性があります。提供開始前は OpenAI の公式ガイドを基準にしてください。もう2つのタイミングも押さえておきましょう。Ultrafast のプロモーション価格は 2027年2月28日(太平洋時間)まで有効で、3月1日から料率は3倍から6倍に上がります。Ultrafast に長期的に依存する製品は、事前に予算を評価する必要があります。GPT-6.2 Astra と Sol には現在 Flex ティアがありませんが、今後提供されれば、非同期タスクの選択肢が増えるでしょう。
Astra の非同期機能を計画しているチームは、まず APIYI apiyi.com でテスト用のクレジットを使ってバックグラウンドモードとポーリングロジックを通し、期限とタスクの依存関係を要件定義書に書き込んだうえで、ティアの話を進めるとよいでしょう。
『論語・子路』に「欲速則不達(速を欲すれば則ち達せず)」とあります。GPT-6.2 Astra の料金表では、この言葉がちょうど価格として表れています。数時間余分に待つことを選べば、モデル費用を3〜4割少なく支払えるのです。
📚 参考資料
-
OpenAI リリース告知:Introducing GPT-6.2 Astra and Sol(2026-11-17)
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol/ - 説明: モデルの位置づけと価格調整の説明
- リンク:
-
GPT-6.2 Astra モデルカード:仕様、短コンテキストと長コンテキストの料率
- リンク:
developers.openai.com/api/docs/models/gpt-6.2-astra - 説明: コンテキスト長、272K 長コンテキストの課金ルール
- リンク:
-
OpenAI API 更新ログ:2026-11-17 のモデルリリースとバックグラウンドウィーンドウの項目
- リンク:
developers.openai.com/api/docs/changelog - 説明: バックグラウンド完了ウィンドウのパブリックベータと割引率
- リンク:
-
OpenAI API 料金表:各処理ティアの単価
- リンク:
developers.openai.com/api/docs/pricing - 説明: Standard、Fast、Ultrafast、Batch の料率
- リンク:
-
Background mode ガイド:バックグラウンドモード、完了ウィンドウ、フォローアップリクエスト
- リンク:
developers.openai.com/api/docs/guides/background - 説明: 割引条件、continuation_id、キュー枠、キャッシュ境界
- リンク:
-
Batch API / Fast / Ultrafast ガイド
- リンク:
developers.openai.com/api/docs/guides/batch、developers.openai.com/api/docs/guides/fast-mode、developers.openai.com/api/docs/guides/ultrafast-mode - 説明: 各送信方法の適用条件
- リンク:
作者: APIYI 技術チーム
技術交流: APIYI apiyi.com のトップページからお問い合わせください。その他の接続資料は docs.apiyi.com のドキュメントセンターでご覧いただけます