概要:ゲーム開発向けモデルを選ぶときは、同じタスクでの成功率、実行時間、API費用、人手による修正コストを見るべきです。価格表や汎用コードベンチマークは、あくまで補助的な判断材料にすぎません。
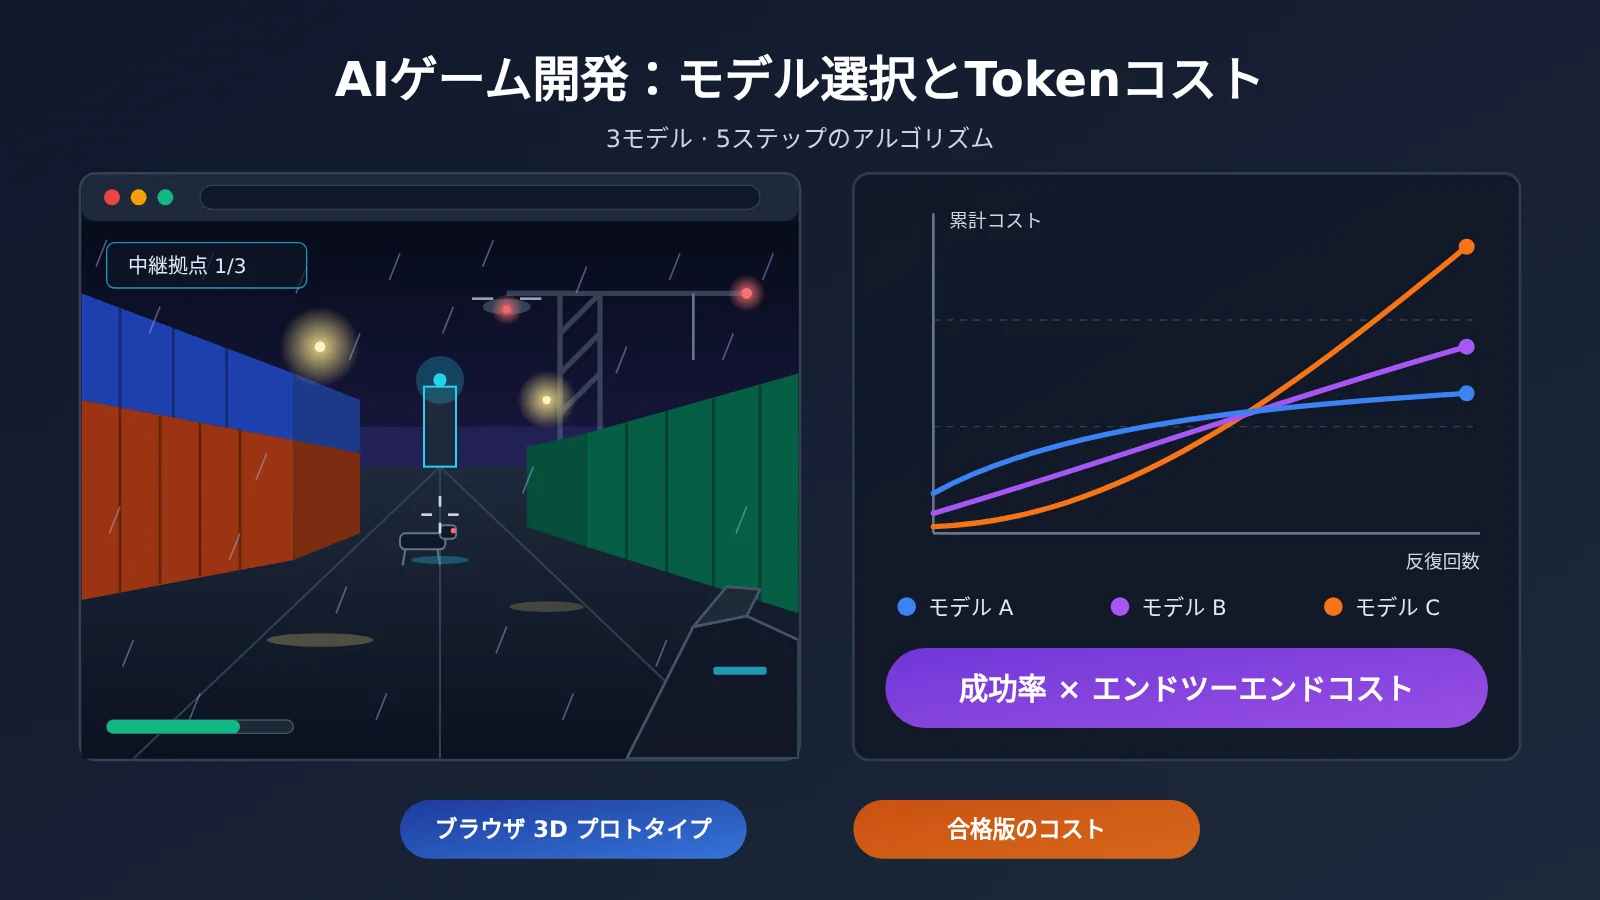
結論から先に:AIにゲームを任せて開発させる場合、最終的に比較すべきは成果物として納品できるバージョン1つを完成させるまでのエンドツーエンドコストであり、100万Tokenあたりの表示価格ではありません。Saltlineの事例では、Claude Fable 5.2が約8時間、約4億4500万入力Token、約270万出力Tokenを使って、ブラウザで動作する3Dシューティングのプロトタイプを生成しました。開発者がAPI価格を基に試算した費用は約550ドルで、しかも入力の大部分はキャッシュ経由でした。2026年11月16日時点では、3モデルの標準API単価は最大で約5倍の差がありますが、単価の低いモデルがより多くの試行回数を必要とするなら、総コストはかえって高くなる可能性があります。したがって信頼できる選定方法は、同じゲームタスクを候補モデルに与えて複数回実行し、成功率、Token、所要時間、人手による修正量を集計したうえで「合格バージョン1つあたりのコスト」を計算することです。
内容予告:第1節ではSaltlineを例に、AIゲーム開発実験のToken課金の内訳構造を分解します。第2節では3モデルの公式価格を比較し、キャッシュが総費用に与える影響を説明します。第3節ではSWE-bench Verified、Aider Polyglot、NISTの過去の評価がそれぞれ何を示せるのかを紹介します。第4節では、再現可能なゲーム開発向け専用評価の手法とコードを提示します。第5節では結果をモデル選択戦略に落とし込みます。
To Know:AIゲーム開発のモデル選定用語
| 用語 | 説明 |
|---|---|
| 入力 Token | モデルに処理させるために送信する内容の計量。プロンプト、コードファイル、ツールの返却結果などを含む |
| 出力 Token | モデルが生成した内容の計量。コード、説明テキスト、ツール呼び出しパラメータなど |
| キャッシュ読み取り | すでにキャッシュされたコンテキストを再利用すること。課金は通常の入力よりはるかに低い |
| キャッシュ書き込み | 初めてコンテキストをキャッシュに保存する費用。通常、普通の入力よりやや高い |
| SWE-bench Verified | 人手で検証済みの実オープンソースプロジェクトによるソフトウェアエンジニアリングタスク500件を含むベンチマーク |
| Aider Polyglot | 6種類のプログラミング言語、225問の練習問題をカバーするコード修正評価 |
| Harness | モデル、ツール、タスクループを編成する実行フレームワーク。たとえば Agent スキャフォールド |
| タスク成功率 | 事前に定義された受け入れ基準に従ってタスクを完了した割合 |
| エンドツーエンドコスト | タスク全体を完了するためのモデル呼び出し、ツール実行、人件費の合計 |
| 人手による修正 | 生成結果を受け入れ基準に達するよう人手で修正すること |
| プロシージャル生成 | コードと数学関数を使ってジオメトリ、テクスチャ、サウンドを生成する方式。素材ファイルをインポートしない |
| Shader | GPU上で動作するプログラム。色、照明、マテリアルなどの視覚効果を計算するために使う |
1 AIによるゲーム開発のコスト事例:Saltline はどれだけのトークンを消費したか
1.1 Saltline はどのくらいの規模のゲームか
2026年11月9日、AnthropicのエンジニアであるFelix Rieseberg氏が、Claude Fable 5.2を使ったコーディング実験を公開しました。モデルにはプロンプトを1つだけ与え、見た目ができるだけAAAゲームに近い小規模な一人称視点シューティングゲーム(FPS)を作るよう指示し、その間、人によるフィードバックは一切行いませんでした。その結果がSaltlineです。ブラウザ上で直接動作する3Dシューティングゲームで、舞台は雨の夜のコンテナ港。プレイヤーは3つの信号中継所を停止して脱出する必要があり、敵として空中パトロールドローンと地上の機械猟犬が登場します。
規模で見ると、Saltlineはシングルプレイ・1ステージのプレイアブルなプロトタイプです。ここでの「3A」は実験目標と視覚的な比喩であり、画面スタイルを表す言葉です。商業的な3A製品とは規模が大きく異なります。中国国内で広まった「几猫·国产3A大作」はSaltlineの中国語版または再パッケージ版であり、名称は流通過程に由来するもので、開発の帰属を示すものではありません。
1.2 開発者本人が語る時間・トークン・費用
以下のデータはすべて開発者本人がXで公開したもので、自己申告による推計であり、第三者による監査は受けていません。
- 開発時間:約8時間
- 入力トークン:約4億4,500万。うち大量のキャッシュを使用
- 出力トークン:約270万
- API価格に基づく推計費用:約550ドル
- 開発方法:1回のプロンプト、人によるフィードバックの反復なし
この金額は一度きりの生成コストです。ゲームファイルは生成後にプレイヤーのブラウザ上でローカルに実行され、プレイ時にClaude APIを呼び出すことはないため、550ドルを「プレイヤー1人あたりのAIコスト」に按分することはできません。
1.3 公式の単価でこの費用を分解する
Claude Fable 5.2の公式標準価格(出力 $40 / 100万トークン)では、270万出力トークンは約108ドルになります。残りの約440ドルは入力側に対応し、キャッシュ書き込み、キャッシュ読み取り、通常入力が含まれます。開発者は3者のそれぞれの数量を公開していないため、これ以上分解することはできません。
2つの境界値と比較すれば、キャッシュの効果がわかります。4億4,500万の入力がすべて通常入力価格の$8で課金された場合、約3,560ドルになります。すべてキャッシュ読み取り価格の$0.20で課金された場合、約89ドルです。実際の推計は両者の間にあり、しかも下限に明らかに近い値です。これは、長時間実行されるエージェント開発タスクでは、入力側のキャッシュヒット率が請求額の桁を決めることを示しており、出力単価の影響は相対的に小さいです。
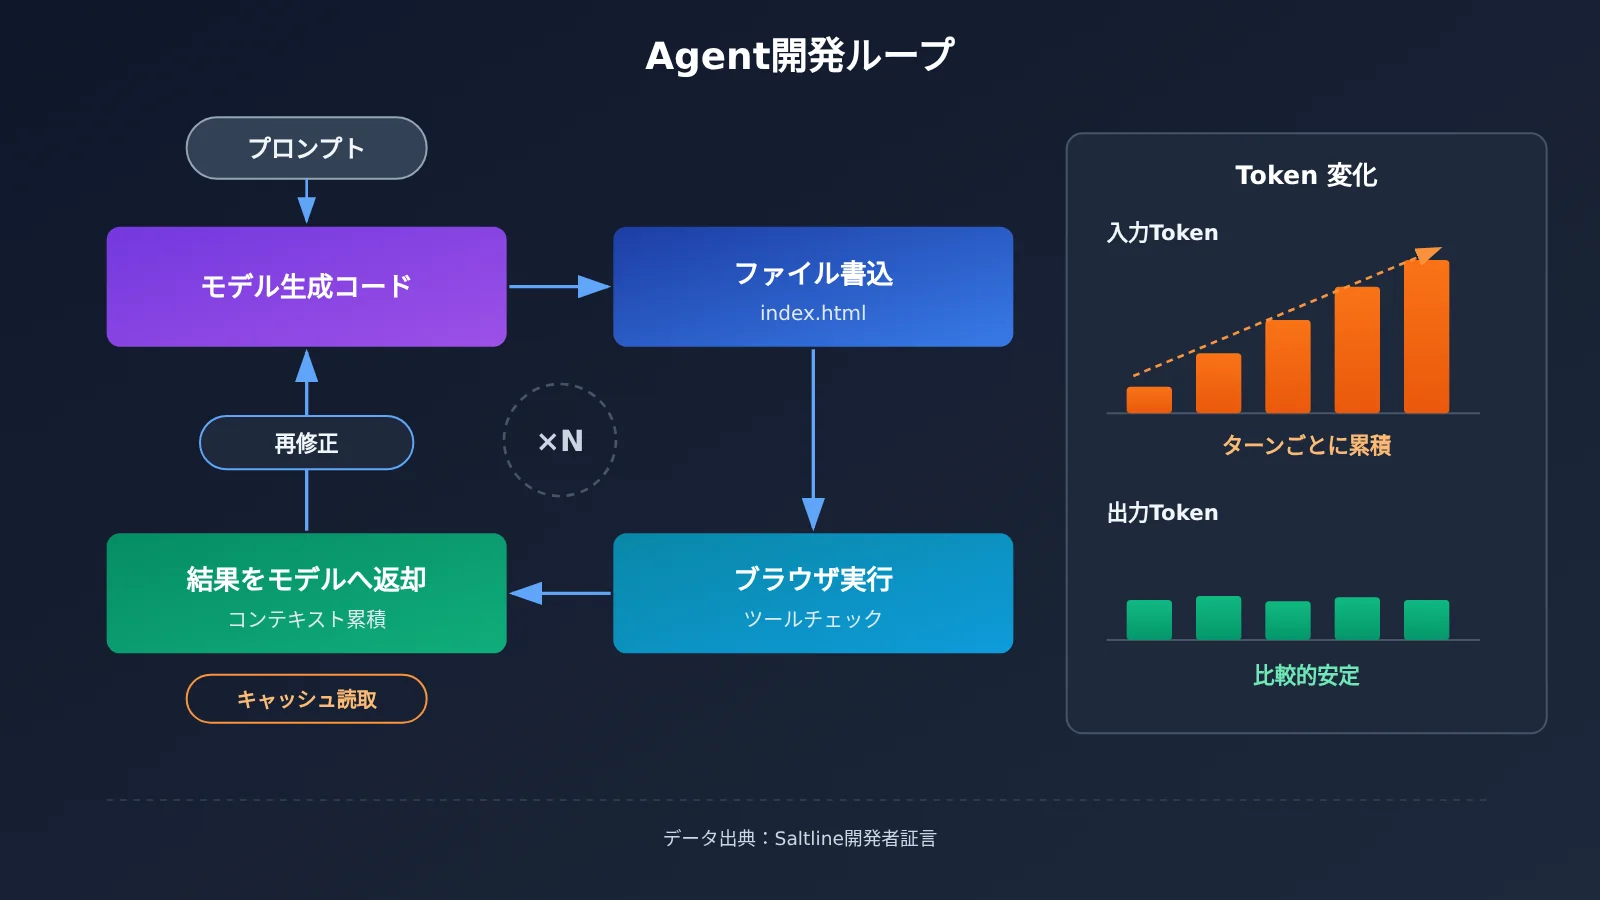
1.4 なぜ1.4MBのファイルが4億4,500万トークンを消費するのか
Saltlineの単体HTML版は約1.43MB(1,425,707バイト)です。開発者によると、ゲーム内のモデルやテクスチャはすべてコードで、ジオメトリはプログラムで構築され、表面の質感はシェーダーで計算され、音声もプログラムで生成されています。個別の画像や3Dモデルの素材はありません。
生成物は小さいのに、プロセスは長くなります。エージェントは8時間の間に、成長し続けるコードファイルを繰り返し読み込み、ツールを実行し、結果を確認して修正します。そのたびに大量のコンテキストをモデルに再入力します。最終的なトークン消費は主にこのループから生じるもので、最終ファイルの長さからではありません。これが、ゲーム開発モデルを評価する際に「プロセスコスト」を測定しなければならない理由です。
2 ゲーム開発モデルの価格比較:3社APIのトークン課金の違い
2.1 3モデルの公式標準価格
以下の表の価格はすべて各社の公式ページに基づくもので、2026年11月16日時点の価格です。単位はドル / 100万トークンで、標準APIの料金枠を指し、その他のチャネル割引や地域追加料金は含みません。
| モデル | 通常入力 | 出力 | キャッシュ読み込み | 備考 |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | 5分キャッシュ書き込み $10、1時間キャッシュ書き込み $16、コンテキスト 1M、最大出力 128K |
| GPT-6 Astra | $10 | $50 | $1 | 標準処理枠。その他の速度、バッチ処理、地域オプションでは価格が異なる場合があります |
| Gemini 4 Argon | $2 | $10 | $0.10 | この価格は2026年11月30日まで適用。12月1日から入力 $4、出力 $20 への調整を予定 |
Claude Fable 5.2にはFast Modeも用意されており、入力 $16、出力 $80 です。公式によると、出力速度は最大2.5倍まで向上します。決まった時間内に完了させる必要がある長いタスクでは、速度枠によって所要時間と費用の両方が変わるため、評価時には独立した構成として記録してください。
💡 比較のヒント:3モデルのインターフェースと課金フィールドはそれぞれ異なるため、自前で評価環境を構築する際は個別に接続する必要があります。APIYI apiyi.com はOpenAI互換の統合インターフェースを提供しており、1つのAPIキーでClaude、GPT、Geminiなどのモデルを呼び出せます。同じ評価スクリプト内でモデルを切り替えられるため便利です。利用可能なモデルと価格の詳細は、プラットフォームの一覧を参照してください。
2.2 同じトークン量での表示価格の差
単価の差を直感的に把握するため、Saltlineの出力量(270万トークン)を3社の価格に当てはめてみます。Claude Fable 5.2は約108ドル、GPT-6 Astraは約135ドル、Gemini 4 Argonは約27ドルです。4.45億の入力がすべてキャッシュ読み込みにヒットした場合、3社はそれぞれ約89ドル、445ドル、45ドルになります。
この数値は課金構造を示すだけであり、前提として3モデルがまったく同じトークンを消費する必要があります。しかし実際には、この前提はほとんど成立しません。モデルごとに、同じタスクを完了するのに必要なターン数、各ターンで読み込むコンテキスト、生成するコードの長さが異なり、失敗後の再実行は費用を倍々に膨らませます。
2.3 入力価格よりもキャッシュ価格に注目すべき
エージェント型の開発では、入力の大部分が重複したコンテキストです。GPT-6 Astraのキャッシュ読み込み価格は通常入力の1/10、Claude Fable 5.2は1/40、Gemini 4 Argonは1/20です。キャッシュ読み込み価格と通常入力価格の比率が低いほど、長いタスクの入力コストを抑えやすくなります。
キャッシュには書き込みコストと有効期限もあります。Claudeの5分キャッシュと1時間キャッシュでは書き込み価格が異なり、エージェントの2回の呼び出し間隔がキャッシュの有効期限を超えると、再書き込みが必要になります。長いタスクの費用を見積もる際は、キャッシュ書き込み回数、ヒット率、有効期限をまとめて計算に含める必要があります。
3 プログラミングベンチマークから何がわかるか:ゲーム開発モデルの能力を測る参考指標
3.1 SWE-bench Verified:実際のリポジトリを使ったソフトウェアエンジニアリングタスク
SWE-bench Verified には、実際のオープンソースプロジェクトから集めた500問が、人手による選別と検証を経て収録されています。モデルはリポジトリの文脈を理解したうえで、バグ修正、既存コードの変更、テスト失敗の解消、ファイルをまたぐ修正といった作業をこなす必要があり、単なるコード補完よりも実際の開発業務に近い内容です。
利用する際はハーネスの影響に注意してください。公式の説明によると、フルランキングには異なるエージェントシステムが混在しており、純粋にモデル同士を比較するなら統一された mini-SWE-agent 構成を使うべきとされています。エージェントの構成、ツール、プロンプト、バージョンの違いはスコアを変動させるため、構成が異なる成績は分けて見る必要があります。
3.2 Aider Polyglot:正解率とコストを同時に記録
Aider Polyglot は225問のプログラミング演習を収録し、C++、Go、Java、JavaScript、Python、Rust をカバーします。テストケースによって、モデルがコードを正しく修正できたかどうかを判定します。公開されている結果は正解率だけでなく、トークン消費量、実行コスト、エラー出力、フォーマットエラー、タスクごとの実行時間まで記録しています。
モデル選定においては、この「正解率+コスト」という記録の仕方が非常に有用で、本稿で後述する評価フレームワークの考え方とも一致します。ただし問題自体は独立した演習であり、規模も形態も本格的な3Dゲームプロジェクトとは大きく異なります。
3.3 NIST の過去評価:モデルバージョンと時期に注意
米国国立標準技術研究所(NIST)傘下の CAISI が2025年に公開したモデル評価レポートでは、複数モデルの SWE-bench Verified スコアを測定しています。以下のデータはいずれも同レポートの過去モデルと実験構成によるもので、2026年11月時点の最新モデルのランキングを示すものではありません。
| モデル(2025年レポートのテスト版) | SWE-bench Verified スコア |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
レポートでは標準誤差も示されており、同じベンチマークでもスコア自体に統計的なばらつきがあることを説明しています。数ポイント程度の差は、誤差の範囲内では実質的な優劣を意味しない場合があります。本稿で比較する Claude Fable 5.2、GPT-6 Astra、Gemini 4 Argon はいずれもこのレポートには登場しないため、選定にあたっては現行バージョン向けに構成を明記した最新の評価を探すか、自分で測定する必要があります。
3.4 汎用プログラミング能力とゲーム開発能力のギャップ
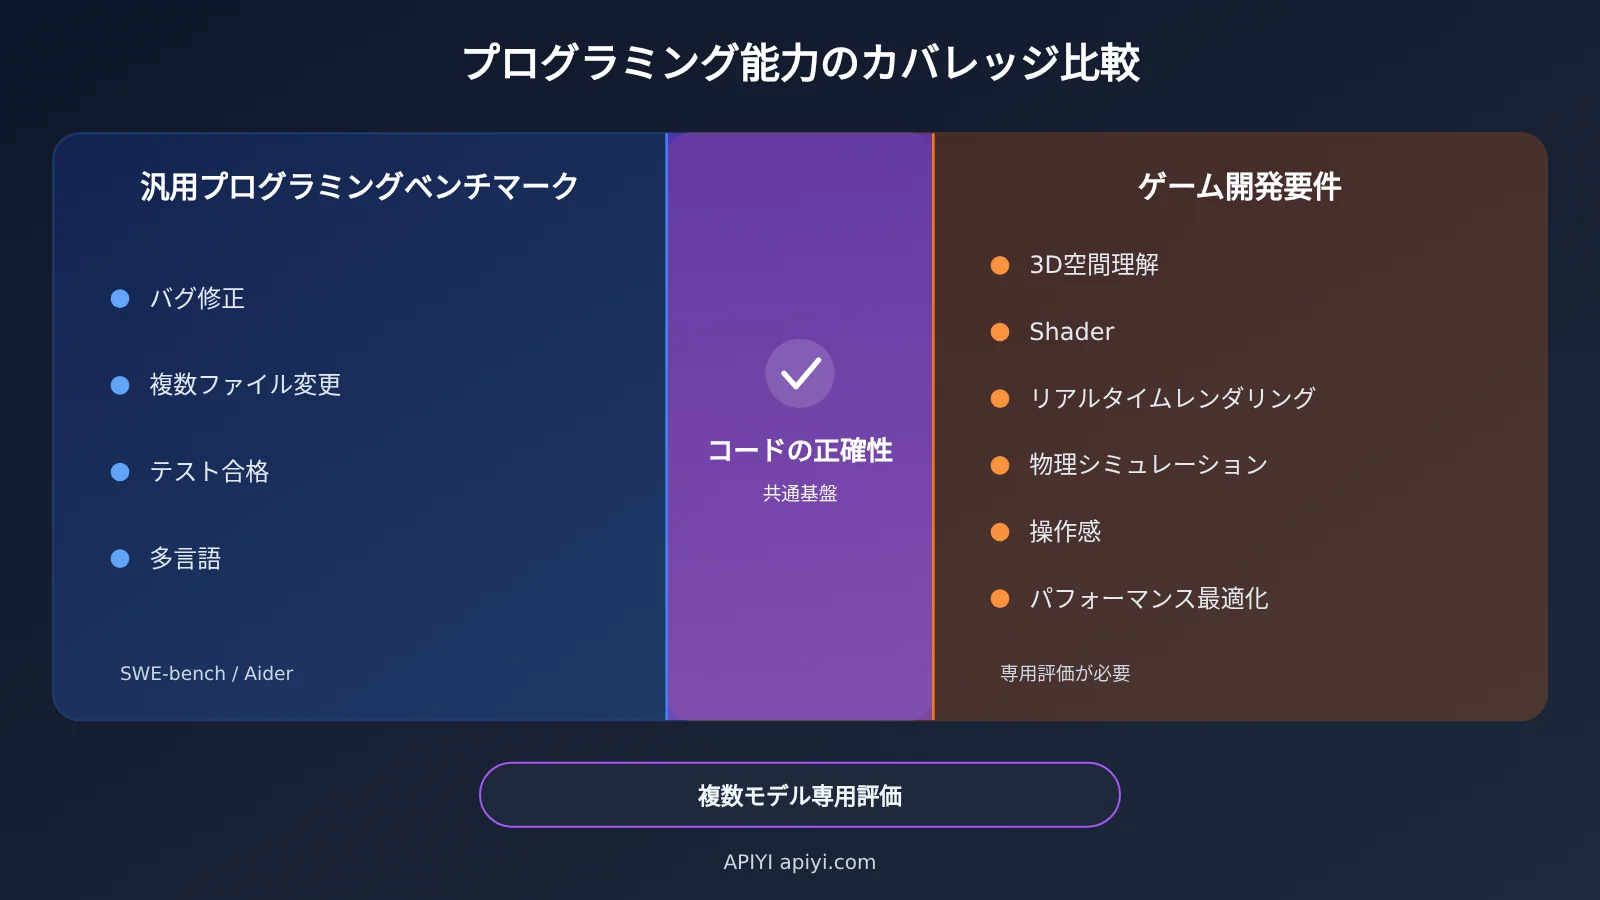
ゲーム開発には、汎用ソフトウェアエンジニアリングのベンチマークではカバーしきれない作業が数多く含まれます。3D空間の理解、シェーダの記述、リアルタイムレンダリング、アニメーションシステム、物理シミュレーション、操作感、実行パフォーマンスの最適化などです。Saltline のようなプロジェクトではさらに、コードによってビジュアルアセットを生成することが求められ、これはグラフィックスと視覚効果への理解に依存します。
あるモデルが Python リポジトリのバグ修正をとても得意でも、複雑な WebGL シーンでは平凡な結果しか出せないことがあります。SWE-bench や Aider は、コード能力が明らかに不足している候補をふるい落とす用途に向いており、最終的な順位付けにはゲーム開発に特化した評価が必要です。
4 AIゲーム開発モデルの比較方法:同一タスクによる専用評価スキーム
4.1 統一されたブラウザ3Dゲームタスクの設計
Saltlineの形態を参考に、タスクを「1つのプロンプトから、ブラウザ上で動作する3Dゲームのプロトタイプを生成する」と定義できます。すべての候補モデルには、まったく同じ要件を課します。
- 完全なプロジェクトを生成し、ブラウザで直接開いて実行できること
- 操作可能なキャラクターと3D環境を含むこと
- 衝突判定または基本的な物理演算を含むこと
- 明確なタスク目標と勝敗条件を含むこと
- 評価の過程で、コアコードの手動修正を認めないこと
タスクの難易度は、実際のニーズに近づける必要があります。カジュアルな小規模ゲームを作るチームがFPSプロトタイプでテストすると、必要なモデルグレードを過大評価してしまいます。逆に、複雑な3Dプロジェクトに取り組むチームがシンプルな2Dタスクでテストすると、過小評価につながります。
4.2 10項目の評価指標
| 次元 | 評価内容 | 推奨する記録方法 |
|---|---|---|
| 機能完全性 | 中核となるゲーム機能が実装されているか | 機能リストに従って項目ごとにチェック |
| 視覚品質 | シーン、マテリアル、ライティング、アニメーション | 複数人によるブラインド評価で採点 |
| 実行可能性 | 正常に起動できるか | はい / いいえ |
| インタラクション完全性 | 入力とフィードバックが正常か | 操作リストに従って項目ごとにテスト |
| 安定性 | 明らかなクラッシュが存在するか | 一定時間のプレイでクラッシュ回数を記録 |
| パフォーマンス | FPS、起動時間、メモリ | 固定デバイスで実測 |
| コード品質 | 可読性、モジュール性、エラーハンドリング | コードレビューで採点 |
| Token コスト | 入力、出力、キャッシュ | API usage フィールドから累計 |
| 総所要時間 | 開始から実行可能バージョンまで | 計測 |
| 手動修正 | 基準達成に必要な人的介入 | 人的工数を記録 |
このうち「実行可能性」「機能完全性」「インタラクション完全性」は必須の受け入れ条件として、1回の実行が成功したかどうかを判定するために使用します。視覚、パフォーマンス、コード品質は、成功した結果同士を順位付けするために使用します。
4.3 テスト環境の制御
評価結果を比較できるかどうかは、変数が制御されているかによって決まります。統一すべき条件には、同じブラウザ、同じデバイス、同じプロンプト、同じテストフロー、同じ時間予算、そしてネットワーク接続を許可するかどうかが含まれます。モデルが自らツールを呼び出したり、資料を検索したり、ファイルを作成したりできる場合、すべてのモデルのツール権限も一致している必要があります。
Harness も同様に固定する必要があります。同じモデルでも Agent フレームワークを変えると、成功率や Token 消費量が大きく変化する可能性があるため、評価レポートには使用したフレームワーク、バージョン、パラメータ(温度、最大出力長、速度設定など)を明記する必要があります。
4.4 各モデルを少なくとも複数回実行する
大規模言語モデルの生成にはランダム性があります。1回の成功は偶然かもしれませんし、1回の失敗も偶発的なものかもしれません。そのため各モデルは同一条件で複数回(たとえば5〜10回)実行し、成功率に加えて、成功サンプルの平均トークン数・所要時間・品質スコアを集計する必要があります。Saltline 自体も単発の実験にすぎず、「このことは実現できる」という証明にはなりますが、同種のタスクにおけるそのモデルの成功率を示すことはできません。
次のスクリプトは OpenAI 互換インターフェースでモデルを呼び出し、usage フィールドに基づいて第2節の価格から1回の呼び出しコストを計算します。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース。モデルを切り替えるときは model を変えるだけ
)

# 単位:ドル / 100万トークン、2026-11-16 時点の公式標準価格
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
モデル名は、実際に呼び出しているプラットフォームのモデル一覧に合わせてください。キャッシュ書き込みの費用や速度ティアの追加料金は、各社のルールに従って別途計算に加える必要があります。
多輪評価とコスト集計スクリプトを見る
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI経由で複数の候補モデルを呼び出す
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """簡略化したエージェントループ:生成 → 検査 → 結果の返送 → 修正"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # 自分で実装:ファイル書き込み、ヘッドレスブラウザの起動、機能チェックリストの実行
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 クイックスタート:この種の評価環境を構築するときは、まず小さなタスクでスクリプトを通しで動かしてみて、それから完全なゲームタスクに切り替えるのがおすすめです。APIYI apiyi.com は新規ユーザー向けに無料のテスト枠を用意しています。まずこれを使ってハーネスと課金集計ロジックを検証し、それから正式な評価予算を投入するとよいでしょう。
5 AI でゲームを開発する際のモデル選び:複雑なタスクの Token コストを制御する
5.1 成功率が総コストを決める
開発にかかる完全なコストは、次の3つの部分から構成されます。
タスク総コスト = モデル呼び出しコスト + ツール実行コスト + 人手による修正コスト
成功率を考慮に入れると、より実用的な比較指標は「合格バージョンあたりのコスト」になります。これは、すべての試行にかかった総費用を成功回数で割ったものです。モデル A が1回の試行で100ドル、成功率80%だと、合格バージョンあたり約125ドルになります。一方、モデル B は1回の試行で30ドル、成功率20%だと、合格バージョンあたり約150ドルになり、さらに失敗したバージョンの調査時間も加わります。単価の低いモデルが、この例ではかえって高くつくのです。
人手による修正は、たいてい最大の項目になります。エンジニアが数時間かけて生成結果を修正すると、人件費がAPI費用の全体を超えることもあります。そのため、評価の際には人手介入の時間を正確に記録し、チームの実際の人件費単価で総コストに換算する必要があります。
5.2 3つのモデル選択戦略
| 戦略 | 適用シーン | メリット | 注意すべきコスト |
|---|---|---|---|
| 高性能モデル | 複雑なアーキテクチャ、長いコンテキストでの開発、複数モジュールの連携、複雑なバグの特定 | 成功率が高く、再実行や手動修正を減らせる | 単価が高く、キャッシュに依存して入力コストを抑える必要がある |
| 低コストモデル | シンプルな機能、コードの説明、反復的な修正、テスト支援 | 単価が低く、高頻度の呼び出しに適している | 複雑なタスクでは複数回失敗し、総コストがかえって増える可能性がある |
| マルチモデル連携 | 1つのモデルがアーキテクチャを担当し、別のモデルが実装を担当、独立したモデルがコードレビューを行う | 各工程に能力と価格をマッチングできる | モデル間の引き継ぎでコンテキストを重複して送信するため、Token と調整コストが増える |
マルチモデル連携のコスト削減効果は、引き継ぎコストに左右されます。引き継ぎのたびにプロジェクトのコンテキストを別のモデルへ再送信する必要があり、異なるモデル間ではキャッシュを共有できません。低コストモデルが担う工程が十分に多く、引き継ぎ回数が十分に少ない場合にのみ、連携はコスト効率が良くなります。これも実際のテストで確認する必要があります。
💰 コストのアドバイス:マルチモデル連携では、1つのプロジェクト内で複数のモデルを同時に呼び出す必要があります。APIYI apiyi.com 経由で同じ Key と同一のコードセットで接続すれば、複数アカウントの管理やインターフェース適応の作業量を減らせます。アーキテクチャ、実装、レビューを異なるモデルに割り当てた後、費用を一元管理しやすくなります。
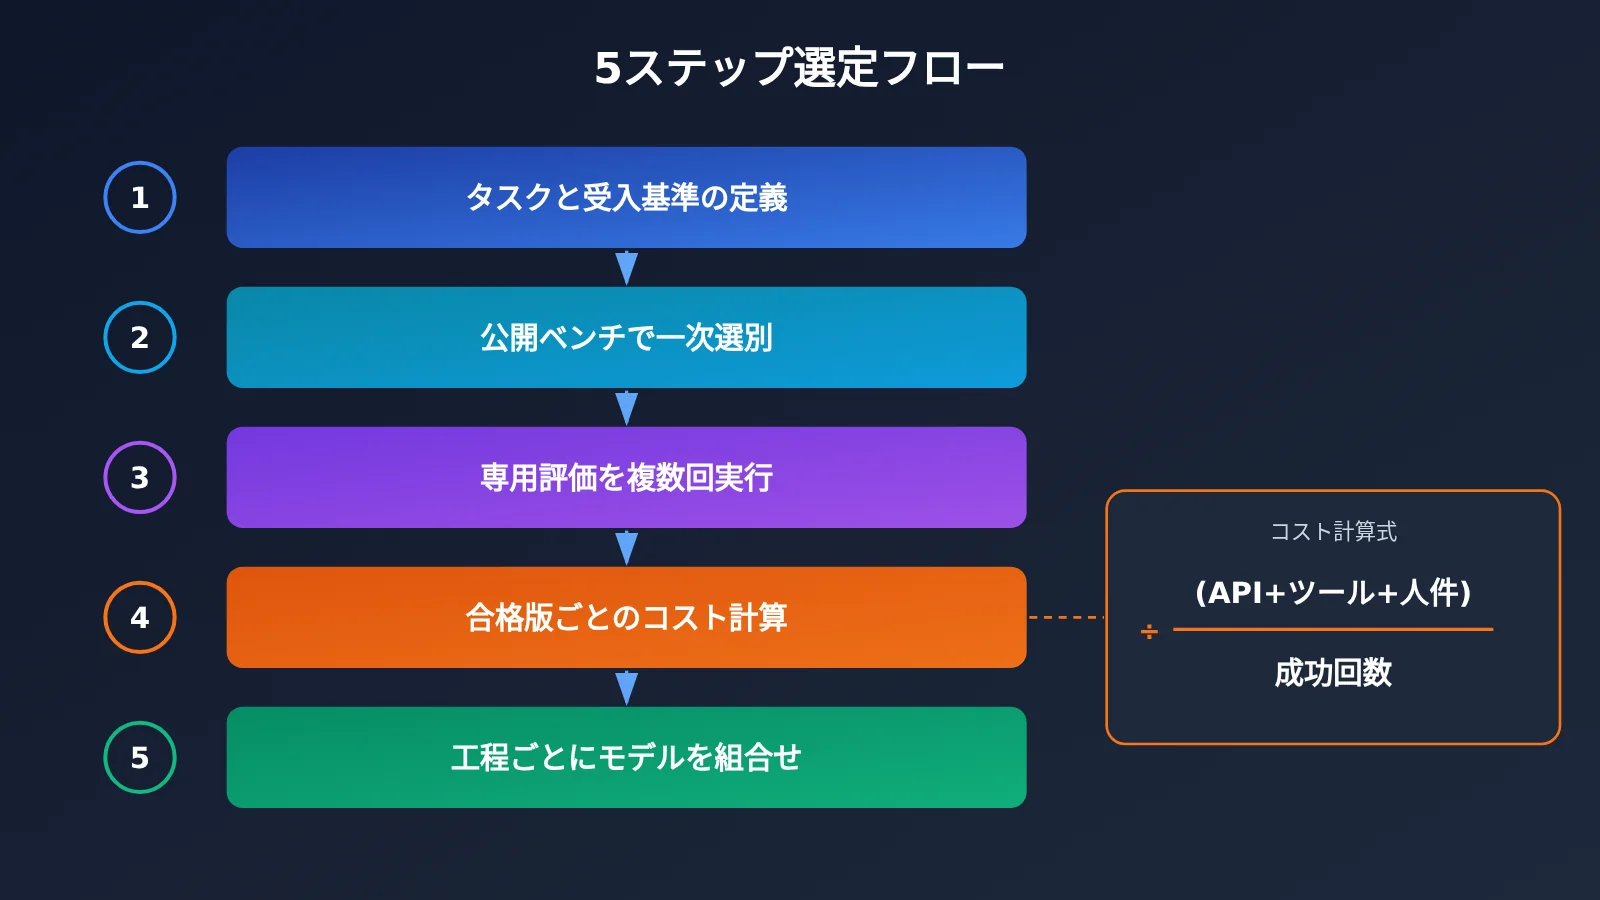
5.3 実行可能な5ステップ選定フロー
- タスクと合格基準を定義する:機能一覧、対象プラットフォーム、パフォーマンスの下限を明記し、成功を判定する根拠とします。
- 公開ベンチマークで一次スクリーニングする:現行バージョンで構成が明示された SWE-bench Verified と Aider Polyglot のスコアを参照し、コード能力が明らかに不足しているモデルを除外します。
- 専用評価を実行する:同一環境で、候補モデルごとに同じゲームタスクを5〜10回実行させ、4.2節の10項目の指標を記録します。
- 合格したバージョンごとにコストを算出する:API費用+ツール費用+人手による修正費用を、成功回数で割ります。
- 工程ごとにモデルを組み合わせる:複雑な工程は成功率の高いモデルに、反復的な工程は低コストのモデルに任せ、その組み合わせが本当にコスト削減につながるかを実測します。
価格は変動します。たとえば Gemini 4 Argon は12月1日からの価格改定を発表済みです。評価結果は元のトークンデータを保存しておき、価格が変わったら単価を差し替えるだけで結論を更新できます。
6 AIゲーム開発におけるモデル選択のよくある質問 FAQ
Q1:Saltlineの550ドルは実際の請求額ですか?
監査済みの請求書ではありません。550ドルは開発者Felix Rieseberg氏がAPI価格に基づいて算出した推定費用で、付随データ(約8時間、約4億4500万入力Token、約270万出力Token)も本人の自己申告によるものです。入力の多くにはキャッシュが使われており、キャッシュの書き込みと読み取りの具体的な比率は公開されていません。
Q2:単価が最も安いモデルが最もコストを抑えられるのでしょうか?
成功率次第です。単価はTokenあたりの価格を決めるだけであり、モデルがタスクを完了するのにどれだけTokenが必要か、何回やり直す必要があるか、どれだけ人手で修正が必要かはモデルの能力によって決まります。「総費用 ÷ 成功回数」で比較してこそ意味があります。
Q3:SWE-benchで1位のモデルはゲーム開発に最適ですか?
SWE-bench Verifiedが測定するのは実際のオープンソースリポジトリにおけるソフトウェアエンジニアリング能力であり、Shader、3D空間理解、リアルタイムレンダリング、インタラクションの操作感へのカバーは限定的です。初回スクリーニングには適していますが、ゲーム開発における最終的な順位付けには専用の評価が必要です。
Q4:NISTレポートのスコアは現在のモデルを代表していますか?
いいえ。NIST CAISIレポートは2025年に公開され、GPT-5、Opus 4、DeepSeek V3.1などの過去のモデルと特定の実験設定をテストしたものです。2026年11月の新しいモデルについては、そのバージョン向けの新しい評価を探す必要があります。
Q5:複数モデルの比較評価を素早く構築するには?
OpenAI互換インターフェースのアグリゲーションプラットフォームを使うのが最も手軽です。APIYI apiyi.com で登録してAPIキーを取得した後、本記事のスクリプトのbase_urlを `https://api.apiyi.com/v1` に設定し、modelパラメータを変更するだけで、同じスクリプト内で複数のモデルをテストできます。新規ユーザーはまず無料枠でスクリプトを検証できます。
Q6:評価時のTokenコストはどう統計するのが最も正確ですか?
APIレスポンスのusageフィールドを基準に、通常の入力、キャッシュ読み取り、出力Tokenを毎回累積し、呼び出し当日の公式価格と課金ティアに基づいて計算します。キャッシュ書き込みや速度ティアなどの追加料金は、各社のルールに従って個別に加算する必要があります。APIYI apiyi.com 経由で呼び出す場合は、プラットフォーム管理画面の利用記録と照合して統計結果を確認することもできます。
Q7:AIが生成したゲームプロトタイプはそのままリリースできますか?
Saltlineのようなプロトタイプは、モデルが人手のフィードバックなしにプレイ可能なバージョンを生成できることを証明していますが、商業リリースには複数ブラウザの互換性、モバイル対応、パフォーマンス最適化、長期的なメンテナンスが関わってきます。ブラウザゲームはローカルハードウェアとブラウザの制約を受け、Saltlineのページでも初期化が遅い、カクつく場合は低画質に切り替える必要があるなどの問題が提示されています。リリース前のテストと最適化のコストは、完全な開発コストに含めて計上すべきです。
7 AIゲーム開発におけるモデル選択の主なポイント
- 中心となる指標:100万トークンあたりの単価ではなく、合格した各バージョンのエンドツーエンドコストを比較します。
- Saltlineの請求額:約550ドルは開発者自身による推定値で、出力が約108ドル、残りは入力側です。
- キャッシュが桁を決める:長いタスクでは入力が大部分を占め、キャッシュ読み取り価格とヒット率が最も大きく影響します。
- 価格には有効期限がある:本文の価格は2026-11-16時点のもので、Gemini 4 Argonは12月1日から価格改定が予定されています。
- ベンチマークは一次スクリーニング用:SWE-benchやAiderは汎用的なプログラミング能力を測るもので、ゲーム開発能力には専用の評価が必要です。
- 複数回の実行:各モデルを同じ条件で5〜10回実行し、単一の結果ではなく成功率で判断します。
- 導入方法:APIYI apiyi.com の統一インターフェース経由でモデルを切り替え、同じスクリプトでコストを比較しやすくします。
8 まとめ:AIにゲームを自律開発させるためのモデル選択法
AIにゲームを1本自律的に開発させるうえで、モデル選択の要点は次の3つです。
- コストは全体で計算する:タスクの総コストにはモデル呼び出し、ツール実行、人手による修正が含まれ、API費用はそのうちの1項目にすぎません。
- 能力は実測する:公開ベンチマークは一次スクリーニングに使い、ゲーム開発における最終的な順位は、同一条件での複数回の専用評価から決まります。
- 工程ごとに組み合わせる:複雑な工程には成功率の高いモデル、繰り返しの工程には低コストのモデルを使い、組み合わせたプランも実際のテストで検証します。
Saltlineは参照可能な目安を示しています。1回のプロンプト、約8時間、推定費用約550ドルで、プレイ可能なブラウザ3Dプロトタイプを1つ生み出しました。あなたのプロジェクトで必要になる金額は、タスクの複雑さと選んだモデルの成功率によって変わります。最も信頼できる方法は、本記事のフレームワークを使って自分自身の評価を1ラウンド実行することです。
APIYI apiyi.com を通じて多モデル比較環境を素早く構築することをおすすめします。同プラットフォームはOpenAI互換インターフェースと新規ユーザー向けの無料枠を提供しており、同じスクリプト内で価格と成功率の実測を完了しやすくなります。
参考資料
- Saltline 独立体験ページ:ゲームの試遊とよくある質問の説明
- リンク:
saltline.games -
説明: 初期化、画質切り替え、操作方法などの体験情報を含みます
-
Saltline コードミラーと README:開発者データの帰属に関する説明
- リンク:
github.com/realcodebear/saltline-fable-5.2 -
説明: 生成時間、Token、推定コストの出所を記録しています
-
几猫 中国語版リポジトリ:Saltline 中国語パッケージ版のアーカイブ
- リンク:
github.com/Megasu/jimao-3a-game -
説明: index.html のファイルサイズなどのデータを提供しています
-
Claude Fable 5.2 モデルの仕様と価格:Anthropic 公式ドキュメント
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview -
説明: 入力、出力、キャッシュ、および Fast Mode の価格
-
GPT-6 Astra モデルドキュメント:OpenAI 公式価格
- リンク:
developers.openai.com/api/docs/models/gpt-6-astra -
説明: 標準処理ティアの価格はこちらを基準とします
-
SWE-bench Verified:ソフトウェアエンジニアリングベンチマーク公式ページ
- リンク:
swebench.com/verified.html -
説明: 500 件の人手検証済みタスクと mini-SWE-agent の統一設定に関する説明
-
Aider Leaderboards:Aider Polyglot の評価結果
- リンク:
aider.chat/docs/leaderboards -
説明: 正解率、Token 消費量、実行コストを同時に記録しています
-
NIST CAISI 評価レポート(2025年):過去モデルの独立評価
- リンク:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - 説明: SWE-bench Verified の過去のスコアと標準誤差を含みます
作者: APIYI 技術チーム
技術交流: APIYI apiyi.com サイトのトップページからお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご確認いただけます