著者注:星尘智能の来杰氏による「ネジを1本締めるたびにトークン料金を取らないでほしい」というたとえを出発点に、AIワークフローのどの工程を固定プログラムに任せ、どの工程に大規模言語モデルの判断が必要なのかを整理します。
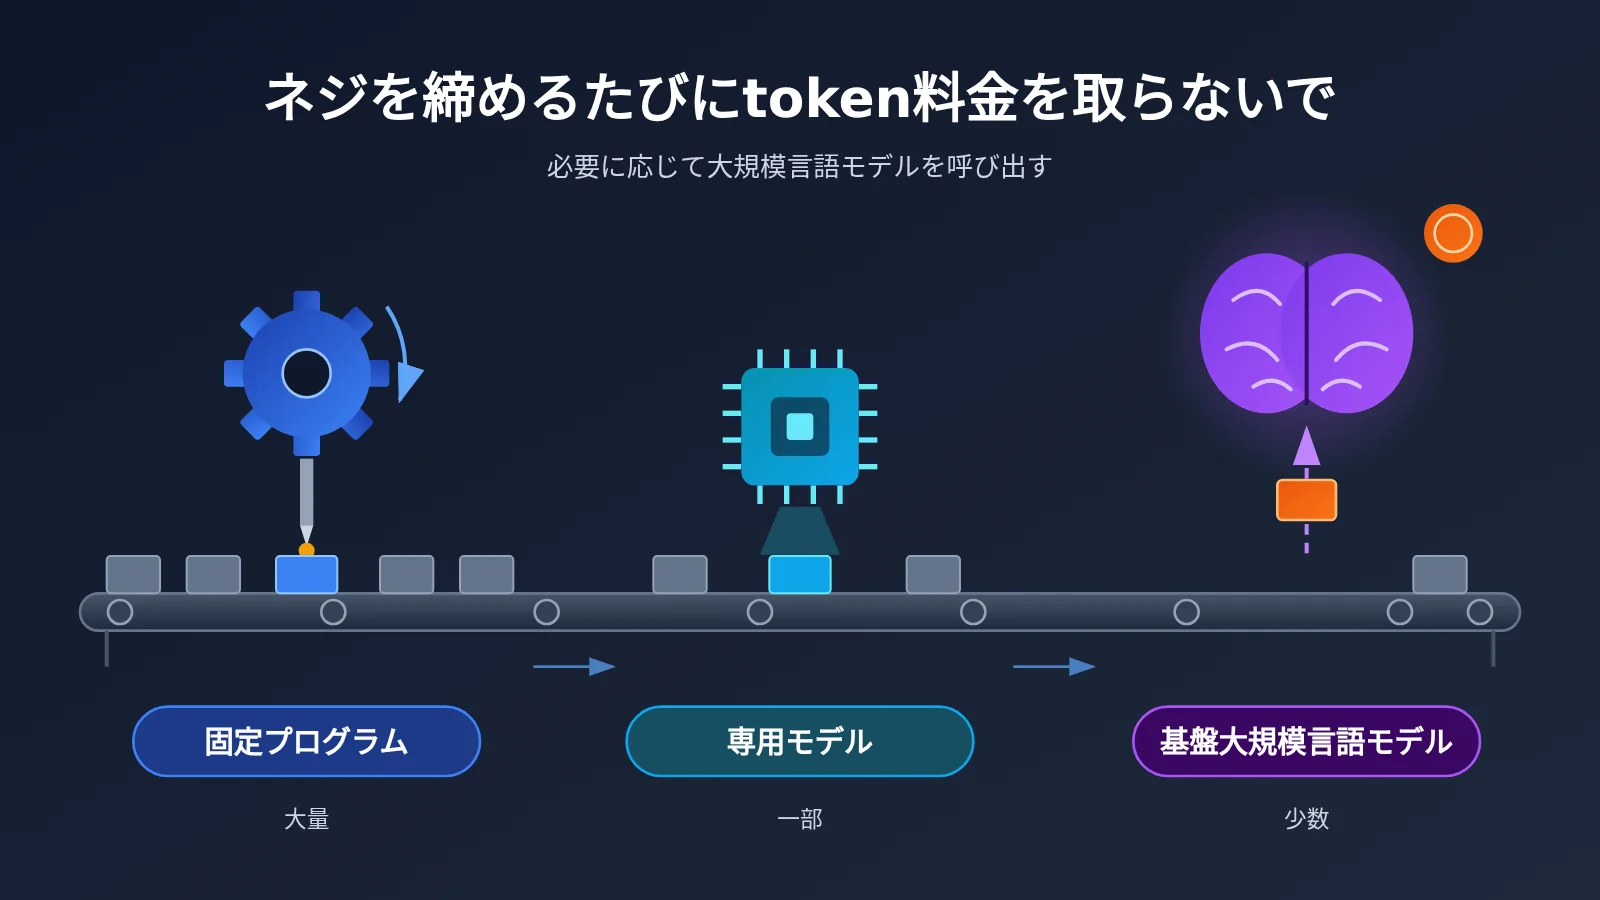
2026年11月5日、爱范儿の「多样性公司」コラムで、星尘智能の創業者兼CEO、来杰氏へのインタビューが公開されました。その中の一言は、AIアプリケーションの開発に携わる多くの人々の間で繰り返し引用されています。「ネジ締めは固定プログラムに任せて、24時間ずっと動かしてほしい。ネジを1本締めるたびにトークン料金を取らないでほしい」
これは単なるジョークではありません。来杰氏がインタビューで語っていたのは、ロボットの役割分担です。身体動作は具身モデルが担い、問題が起きたときに自然言語で基盤大規模言語モデルに尋ねる。この考え方をソフトウェアのワークフローに当てはめると、実に具体的な問いが見えてきます。AIアプリケーションの中で、大規模言語モデルを呼び出すべきでない工程はどこなのでしょうか?
この記事のポイント:インタビューで語られたロボットに関する考え方を、ソフトウェアのワークフローにおける呼び出しの境界設計に置き換え、大規模言語モデルを呼び出すべきでない5種類の工程、階層ごとの判断基準、すぐに改造して使えるルーティングコードの例を紹介します。あらかじめお伝えしておくと、ロボットとソフトウェアは別のシステムです。以下の議論は類推によるものであり、その効果は実際の使用量に基づいて検証する必要があります。
「ネジを1本締めるたびにトークン料金を取らないで」重要ポイント
この言葉は、インタビューの最後の質問から生まれました。ロボットに人間を何から解放してほしいかと聞かれた来傑氏は、ロボットに「工場でネジ締めをさせたいわけではない」と明言しています。ロボットの価値は幅広い能力にあるうえ、コストの面でも、反復作業の動作ごとにトークン料金を支払うのは見合わないという考えです。
| 項目 | 詳細 |
|---|---|
| 情報源 | 愛范児「多様性公司」シリーズ第15回インタビュー |
| 公開日 | 2026年11月5日 |
| インタビュー対象者 | 星塵智能の創業者兼CEO、来傑氏。元Tencent Robotics Xロボット研究所の1人目の社員 |
| 核心的な見解 | 反復動作は固定化されたプログラムに任せ、毎回トークン料金を支払うべきではない |
| 役割分担の考え方 | フィジカルAIモデルが物理的な動作を担当し、問題が生じたときに自然言語で基盤となる大規模言語モデルに問い合わせる |
| ソフトウェアへの示唆 | AIワークフローでは、固定プログラム、専用モデル、基盤となる大規模言語モデルの呼び出し範囲を分ける必要がある |
注意したいのは、インタビューの内容は創業者個人の見解であり、コストの実測値や第三者による検証データは示されていないことです。ここでは特定の結論ではなく、役割分担の考え方を参考にしています。
来杰の「母親にビデオ通話で聞く」たとえ:大規模言語モデルはコンテキストを補う
インタビューには、「ネジ締め」よりも役割分担をわかりやすく示すたとえが登場します。来杰は、料理ができない自分が料理をしたいときは母親にビデオ通話をかける、と話しています。母親は「まず熱した鍋に油を少し入れて」と教えてくれますが、どの瓶が油なのかまでは説明する必要がありません。疑問があれば、その都度聞き返します。重要なのは、母親はコンテキストとなる知識を補ってくれる一方、油を入れる動作は自分でできなければならないことです。電話の向こうにいる母親は、代わりに油を入れることはできません。
これをロボットに当てはめると、具身モデルは重さやつまむ力、しっかりつかめているかといった物理的な情報を自分で感知し、「うまくつかめず不安定なときにどうすればいいか」といった問題だけを基盤となる大規模言語モデルに尋ねます。来杰は、触覚情報も基盤モデルに学習させることについて、「できないわけではないが、コストに見合わず、通信帯域にも問題が生じる」と考えています。また、これは単純な階層化ではなく、アリの群れのようなエージェント化に近いとも補足しています。個々のエージェントの能力は必ずしも高くなくても、組み合わせると強力になるという考え方です。
| ロボットシステムでの役割 | インタビューでの担当 | ソフトウェアワークフローに置き換えた役割 |
|---|---|---|
| 固定プログラム | 24時間、繰り返しネジを締める | ルールエンジン、正規表現、スクリプト、データベースクエリ |
| 具身モデル | 物理的な動作、パラメータの感知、状態の自然言語への変換 | 分類、抽出、ベクトル検索などの専用小規模モデル |
| 基盤となる大規模言語モデル | コンテキストとなる知識の補足、難しい問題への解決策の提示 | 複雑な推論、自由度の高い生成、例外時の判断 |
| AOS オペレーティングシステム | 能力をスキルモジュールとしてまとめ、大規模言語モデルや Agent と連携させる | ワークフローオーケストレーション層、ツール呼び出し層、ルーター |
この対応表は本記事独自の考察であり、インタビューで直接語られたものではありません。ロボットには物理世界でのリアルタイム制御や通信帯域の制限が関わる一方、ソフトウェアワークフローは主にトークン課金、レイテンシ、安定性の制約を受けます。両者のボトルネックは完全に同じではありません。
AIアプリのどの処理で大規模言語モデルを呼び出すべきでないか:5つの判断基準
多くのチームは、Agentの最初のバージョンを作る際、あらゆる処理を大規模言語モデルに任せがちです。形式の検証も日付の変換も、さらには「フィールドが空かどうかの判定」までプロンプトで行います。プロトタイプの段階では手早く作れますが、リリース後は、リクエストのたびに決定的な処理にまでコストがかかり、不要なばらつきも生じます。
「ネジ締め」という考え方を借りて、各処理で大規模言語モデルを呼び出す価値があるかどうかを、次の5つの基準で判断できます。
| 判断基準 | 固定プログラム向き | 専用モデル向き | 基盤となる大規模言語モデル向き |
|---|---|---|---|
| 入力は構造化されているか | フィールドが固定され、形式が明確 | 半構造化テキスト | 自由な自然言語 |
| 出力は一意か | 正解が一つ | 限られたカテゴリ | 妥当な回答が複数ある |
| ルールを網羅できるか | if/elseで記述できる | ルールは多いがパターンは安定している | ルールを網羅できない |
| 間違えた場合の影響 | 誤りが許されない | 少数の誤りを許容でき、確認も可能 | 総合的な判断が必要 |
| 呼び出し頻度 | 非常に高く、毎回実行 | 高頻度 | 低頻度で、必要に応じて実行 |
固定プログラムに任せたい「ネジ締め型」の処理
次のような処理は一般に「ネジ締め」にあたります。決定的で繰り返しが多いため、大規模言語モデルを使うと、かえって安定性が下がります。
- 形式の検証とクリーニング:メールアドレス、電話番号、JSON構造、必須フィールドのチェックは、正規表現やSchema検証で対応できます。
- データの検索と計算:注文状況、在庫数、金額の集計は、データベースを直接検索するか、業務APIを呼び出しましょう。大規模言語モデルに「推測」させるべきではありません。
- 固定テンプレートでの出力:通知SMS、定型の受領通知、レポートのヘッダーは、テンプレートエンジンで変数を埋め込めば十分です。
- フロー制御とリトライ:分岐、タイムアウト時のリトライ、レート制限時のキュー処理は、オーケストレーション層のロジックであり、モデルは必要ありません。
- 高頻度のキャッシュ参照:同じ質問が繰り返される場合は、まずキャッシュやFAQを検索し、該当する回答があればそのまま返します。
大規模言語モデルによる判断が本当に必要な処理
一方、基盤となる大規模言語モデルを呼び出す価値があるのは、「電話の向こうにいるお母さんにしか答えられない問題」です。例えば、ユーザーの意図が曖昧で確認が必要な場合、複数の資料を総合して結論をまとめる場合、ルールでカバーされていない例外に遭遇した場合、創造的なコンテンツを生成する場合などです。これらに共通するのは、答えが一つではなく、ルールを網羅できず、発生頻度が比較的低いことです。
専用モデルは、その中間に位置します。意図の分類、エンティティ抽出、感情判定、テキストのベクトル化といったタスクは、比較的小さなモデルでも十分にこなせることが多いでしょう。これはソフトウェア版の「身体性を備えたモデル」と考えることもできます。自分でできることは済ませ、処理できないケースは明確な問題として整理し、上位の層に渡します。
AIワークフローの階層設計例:大規模言語モデルが不要な処理は先に振り分ける
ここでは、よくある「カスタマーサポートのチケット自動処理」を例に、モデルを呼び出す範囲を具体的なステップにどう落とし込むかを見ていきます。これは設計例であり、実際のプロジェクトで測定したデータではありません。
| ワークフローのステップ | 担当する層 | 処理方法 | トークンを消費するか |
|---|---|---|---|
| チケットの項目検証 | 固定プログラム | スキーマを検証し、必須項目がなければそのまま差し戻す | いいえ |
| 注文・配送状況の照会 | 固定プログラム | 業務データベースのAPIを呼び出す | いいえ |
| よくある質問との照合 | 固定プログラム / 専用モデル | キーワードルールを優先し、マッチしなければベクトル検索を使う | 少量 |
| 意図分類 | 専用モデル | 小規模モデルが限定されたカテゴリを出力する | 少量 |
| 複雑な苦情・例外への対応 | 基盤となる大規模言語モデル | 注文情報を踏まえて対応案を生成する | はい |
| 返信テンプレートへの入力 | 固定プログラム | テンプレートエンジンが最終的な文章を出力する | いいえ |
このように、6つのステップのうち、基盤となる大規模言語モデルの呼び出しが必要なのは1つだけです。実際にどれだけトークンを削減できるか、成功率が下がるか、レイテンシがどう変化するかは、トラフィックの構成やルールのカバー率によって異なります。実際のログを使って評価する必要があります。
最小限の例:ルールを優先し、モデルで補完する
以下のコードは、最小限の階層型ルーティングの考え方を示しています。まずルールで「ネジ型」のリクエストを処理し、次に小型モデルで分類します。大規模言語モデルを呼び出すのは、複雑なケースだけです。モデル名はあくまで例です。実際に利用できるモデルは、各プラットフォームのモデル一覧を確認してください。
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

def handle(query: str) -> str:
    # 第1層:固定プログラム。ルールで解決できる場合はモデルを呼び出さない
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # 第2層:小型モデルで意図を分類
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # 第3層:複雑な苦情の場合のみ基盤となる大規模言語モデルを呼び出す
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
使用量を記録する完全な実装コードを見る
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # 例:分類・抽出用の小型モデル
LARGE_MODEL = "claude-sonnet-4"   # 例:複雑な推論用の大規模言語モデル

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 まず試すなら:階層別ルーティングで信頼できる結論を得るには、同じインターフェースを使い、階層ごとにモデルを切り替えて消費量を記録することが重要です。APIYI apiyi.com なら、1つのAPIキーで小規模モデルと大規模言語モデルの両方を呼び出せます。プラットフォームの使用量統計を使って各階層のtoken消費量を比較しましょう。初めて利用する場合は、無料のテスト枠でプロトタイプを検証できます。
「ネジを1本締めるたびにtoken料金を取らないでほしい」の影響分析
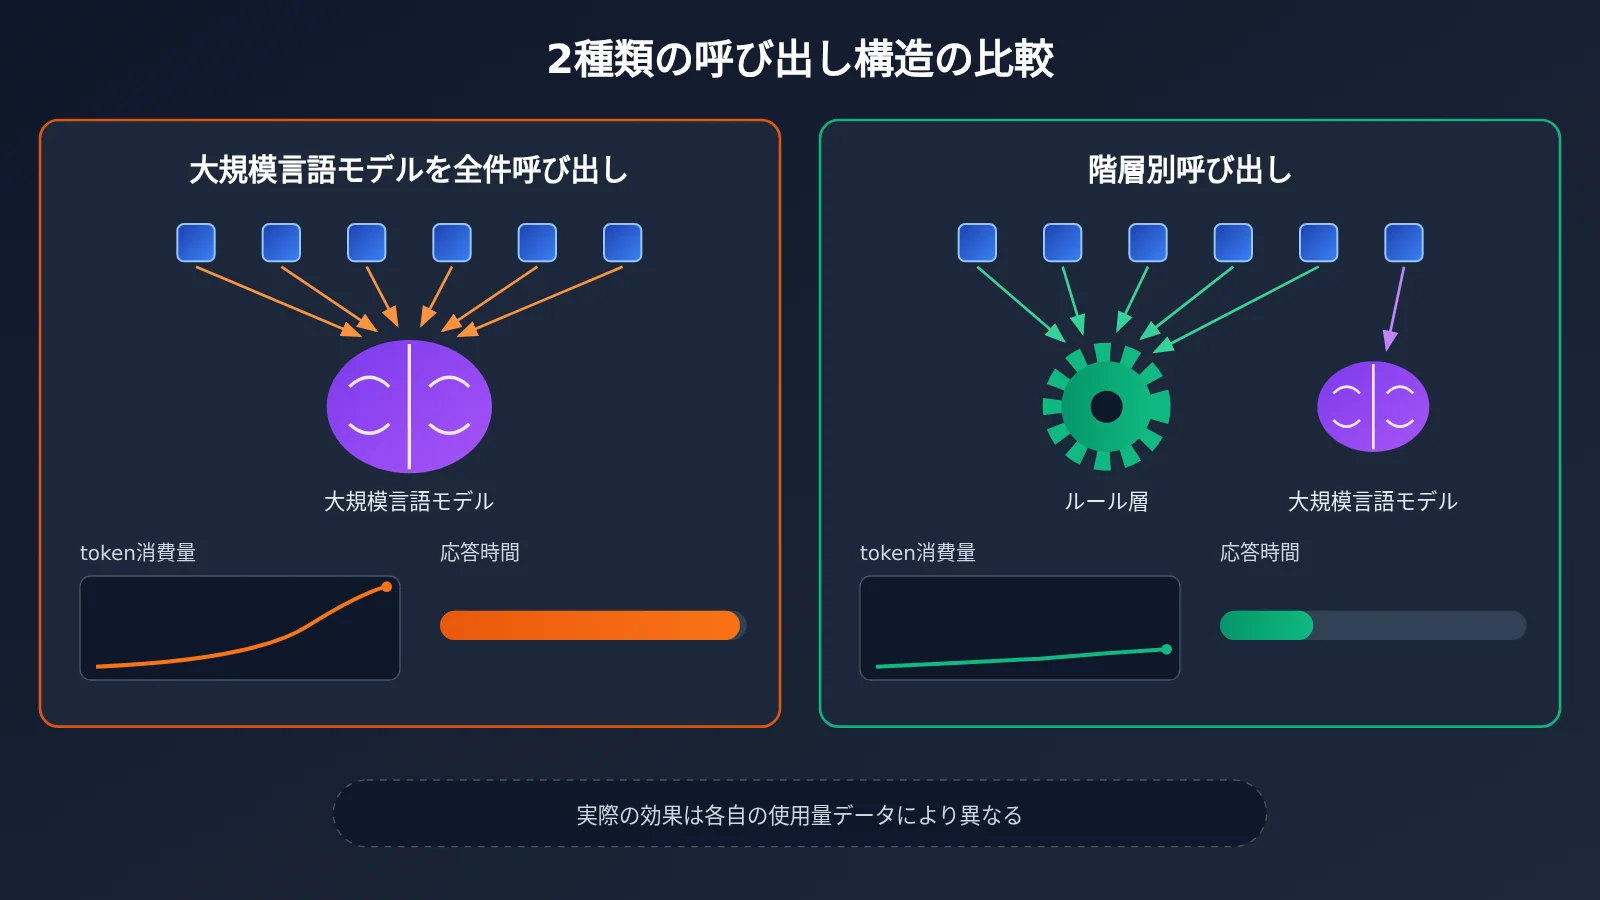
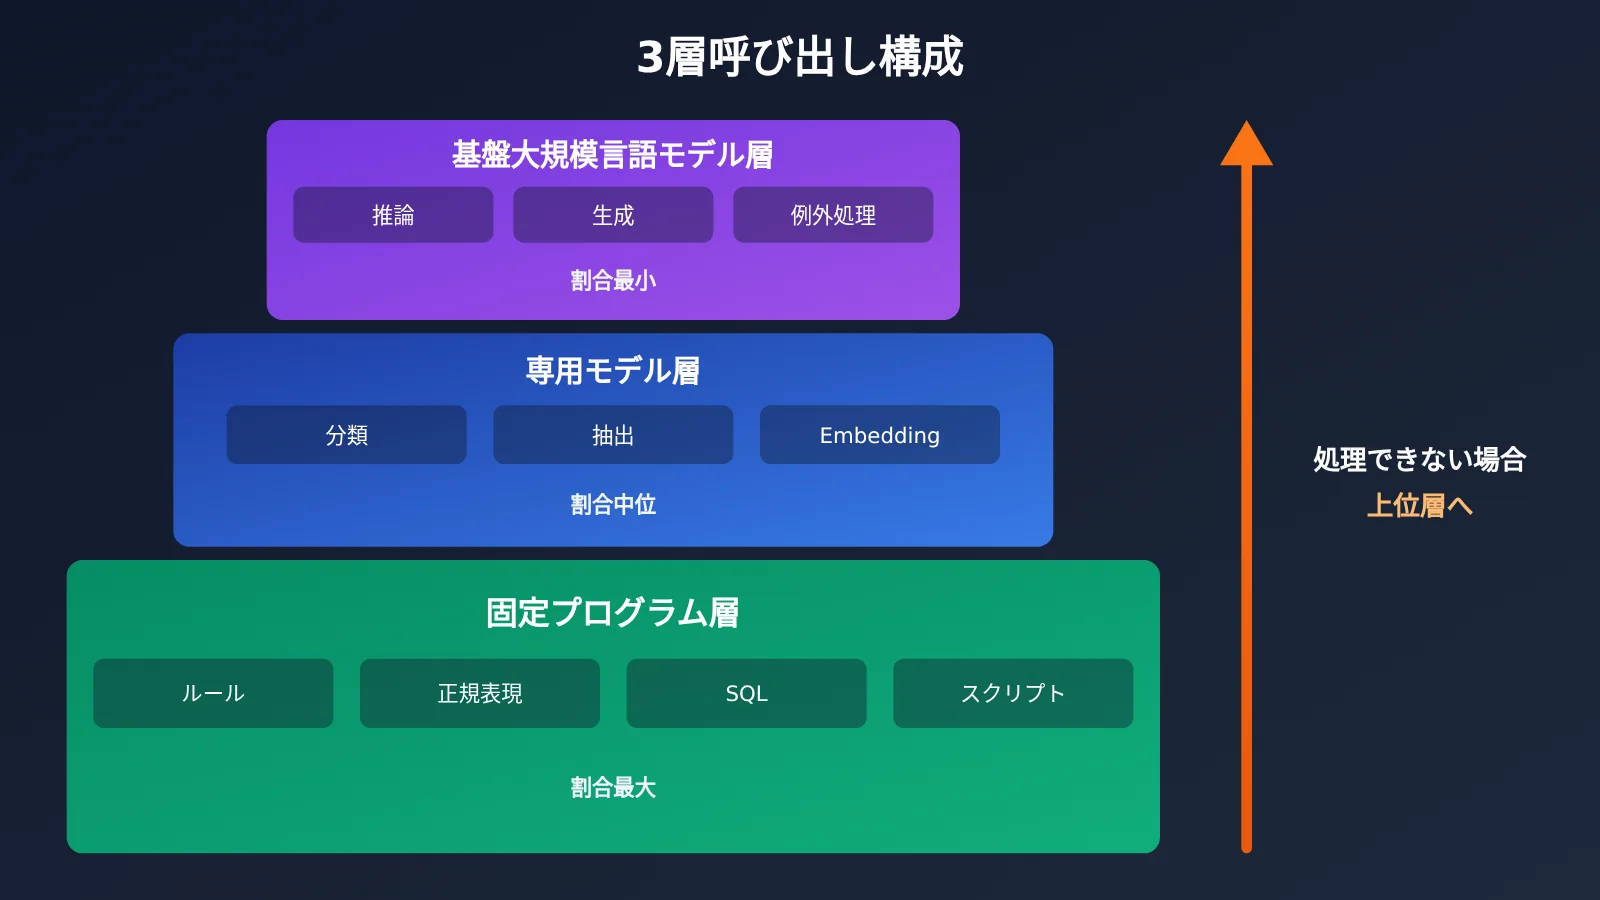
上の図は、2つの設計の構造的な違いを示したもので、実測値ではありません。具体的な比較には、APIYI apiyi.com で同じリクエストセットを使って両方の方式を実行し、使用量の記録と合わせて判断することをおすすめします。
| 比較項目 | すべて大規模言語モデルを呼び出す | 階層別に呼び出す | 利用できるプラットフォーム |
|---|---|---|---|
| 開発速度 | プロンプトを書くだけで済むため、プロトタイプを最も速く作れる | ルールとルーティングを別途整理する必要がある | APIYI apiyi.com、各社の公式API |
| token消費量 | すべての工程で課金される | 主に難しい工程だけで課金される | 同上 |
| 結果の確定性 | 確定的なタスクでもランダムなずれが生じることがある | ルール層の結果は予測できる | 同上 |
| 応答遅延 | 各ステップでモデルの生成を待つ必要がある | ルール層はほぼ即座に結果を返す | 同上 |
| 保守コスト | プロンプトを追加するほど長くなる | 業務の変化に合わせてルールを更新する必要がある | 同上 |
ワークフロー構築者と開発者への影響
- 設計の順序が逆になる:「まず大規模言語モデルを導入し、それからコスト削減を考える」のではなく、まずすべてのステップを洗い出し、どれが「ネジ締め」に当たるかを特定してから、モデルをどこに配置するか決めます。
- 専用モデルの配置がより重要になる:身体性を持つモデルが物理的な状態を自然言語に変換するように、中間層には曖昧な入力を構造化された問題に整理し、大規模言語モデルへの呼び出しをより的確にする価値があります。
- 可観測性が欠かせなくなる:階層化した後は、階層ごとの呼び出し回数、token消費量、遅延を記録する必要があります。そうしなければ、ある階層の処理を上位に引き上げるべきか、下位に移すべきかを判断できません。
プロダクト責任者への影響
- コストを予測しやすくなる:確定的な工程ではtokenが消費されず、費用は主に見積もり可能な難しいリクエストに集中します。
- 「賢ければ賢いほどよい」わけではないと受け入れる必要がある:注文の照会を大規模言語モデルに任せると、より賢く見えるかもしれません。しかし、ユーザーが本当に求めているのは正確さと速さです。
- 検証指標をあらかじめ定義する必要がある:階層化前後のtoken消費量、タスク成功率、エンドツーエンドの遅延を、リリース前の比較基準としましょう。
業界への影響
来杰の見解は、基盤となる大規模言語モデルがますます高性能になっても、すべての機能を1つのモデルに詰め込むのではなく、それぞれ異なる能力を持つ「エージェント」が役割を分担する、という考え方を示しています。ソフトウェアの分野では、これはツール呼び出しやAgentオーケストレーションの発展の方向性と一致しています。ただし、インタビューで議論されているのはロボットの利用シーンです。この考え方がソフトウェアのワークフローでどれほどの効果をもたらすかについては、公開された事例データがまだ不足しており、より多くのチームによる実践を通じた検証が必要です。
よくある質問 FAQ
Q1:「ネジを1本締めるたびにトークン料金を取らないでほしい」とはどういう意味ですか?
これは、星尘智能の創業者である来杰氏が、2026年11月の愛范児のインタビューで語った言葉です。工場でのネジ締めのような反復作業は、動作のたびにモデルを呼び出してトークン料金を支払うのではなく、固定プログラムに任せて24時間稼働させるべきだと考えています。AIアプリケーションに置き換えると、処理が決まっていて頻繁に実行される工程には、大規模言語モデルを呼び出すべきではないということです。
Q2:ロボットの階層化の考え方は、ソフトウェアのワークフローにもそのまま使えますか?
そのまま同じように扱うことはできません。ロボットにはリアルタイム制御、触覚センシング、通信帯域が関わる一方、ソフトウェアのワークフローは主にトークン課金、遅延、安定性の制約を受けます。参考にできるのは「実行層で自力で処理し、難しい問題だけ上位層に引き継ぐ」という役割分担の考え方です。具体的な効果は実例で検証する必要があります。
Q3:ある工程に小規模モデルと大規模モデルのどちらを使うべきか、どう判断しますか?
出力が限られているか、ルールが安定しているかを確認します。意図分類やフィールド抽出など、出力が限られた分類に収まり、パターンも安定しているタスクでは、まず小規模モデルを試します。総合的な推論、自由度の高い生成、例外処理が必要なタスクは、大規模モデルに任せます。APIYI apiyi.com で同じサンプルを使って複数のモデルをテストし、精度と消費量を比較してから決めることをおすすめします。
Q4:階層化すれば必ずコストを削減できますか?
必ずしもそうではありません。リクエストの大半が複雑な問題で、ルール層で処理できるものが少なければ、階層化の効果は限られます。また、ルールの適用範囲が広すぎると誤って処理してしまい、成功率が下がる可能性もあります。まず現状を記録し、階層化の前後でトークン消費量、成功率、遅延を比較することが大切です。
Q5:階層化されたモデル呼び出しのプロトタイプを手早く構築するには?
次の手順で進められます。
1. ワークフローの全工程を一覧にし、「ネジ締め型」の工程を特定してルールで実装する
2. APIYI apiyi.com にアクセスして登録し、APIキーを取得したうえで、OpenAI互換インターフェースから小規模モデルと大規模モデルの両方に接続する
3. 本記事のコードを参考にルーティングを実装し、層ごとにトークン消費量と遅延を記録する
統一されたインターフェースを使う利点は、`model` パラメータを変更するだけでモデルを切り替えられ、繰り返し比較しやすいことです。
Q6:階層設計でよくある落とし穴は何ですか?
– **ルールの肥大化**:ルールが増え続け、最終的にプロンプトよりも保守が難しくなります。定期的な整理が必要です。
– **層間での情報の欠落**:小規模モデルで分類した後、コンテキストを大規模モデルに渡さないと、大規模モデルが内容を再び理解し直す必要があります。
– **フォールバックの欠如**:ルールと小規模モデルのどちらでも判断できない場合に備え、大規模モデルや人間に引き継ぐ経路を用意しましょう。
「ネジを1本締めるたびにトークン料金を取らないで」要点 Key Takeaways
- 発言の出典:2026年11月の愛範児(爱范儿)による星尘智能の来杰氏へのインタビューで語られた、創業者の見解です。
- 役割分担の考え方:実行層が動作を自分で完結させ、難しい問題に限って基盤となる大規模言語モデルに追加のコンテキストを求めます。
- 5種類の「ネジ締め」作業:形式チェック、データ検索、テンプレート出力、フロー制御、キャッシュヒット時の処理には、大規模言語モデルを呼び出す必要はありません。
- 3層構造:固定プログラムを土台に、専用モデルを中間に置き、基盤となる大規模言語モデルは自由度の高い問題や例外だけを処理します。
- 類推には限界がある:ロボットに関する結論をそのままソフトウェアに当てはめることはできません。効果は自社のデータで検証する必要があります。
- 検証する3つの指標:階層化の前後で、トークン消費量、タスク成功率、エンドツーエンドのレイテンシを比較します。
- 始め方:APIYI apiyi.com の統一インターフェースを使えば、各層のモデルを切り替えながら使用量を確認できます。
まとめ
「ネジを1本締めるたびにトークン料金を取らないで」という言葉は、AIワークフローでどの処理にモデルを呼び出すべきか、その境界を見直そうという呼びかけです。
- まずはネジを見つける:結果が予測しやすく、頻度が高く、答えが一つに決まる処理は、固定プログラムに任せます。
- 次に専用モデルを配置する:分類先が限られ、パターンが安定しているタスクは、小規模モデルで処理し、問題を整理します。
- 大規模言語モデルは最後に使う:自由度の高い推論、例外時の判断、創造的な生成にこそ、トークン料金を払う価値があります。
この方法は特定のモデルやリリースに依存しないため、Agent設計のチェックリストとして長く活用できます。実際に導入する際は、コストが必ず下がると決めつけず、自社の業務ログを使って階層化前後の違いを検証してください。
階層型ワークフローを設計するなら、APIYI apiyi.com を通じて、1つのAPIキーでさまざまな規模のモデルにアクセスできます。各層で柔軟にモデルを切り替え、使用量の統計を比較しながら、一つひとつの「ネジ」を誰に締めてもらうべきか、データを基に判断できます。
📚 参考資料
- 爱范儿 – 星尘智能の来杰氏へのインタビュー:「多样性公司」連載の第15回インタビュー
- リンク:
ifanr.com/1687805 -
説明: 本記事の「ネジ締めとトークン料金」のたとえ、および身体性を持つモデルと基盤となる大規模言語モデルの役割分担についての考え方の出典
-
OpenAI Chat Completions APIドキュメント:OpenAI互換APIのパラメータ説明
- リンク:
platform.openai.com/docs/api-reference/chat - 説明:
model、max_tokens、usageなどのフィールドを理解し、層ごとの使用量記録を実装する際に役立ちます
著者: APIYI 技術チーム
技術交流: APIYI ウェブサイトのトップページからお気軽にお問い合わせください。モデル接続や使用量の集計について詳しくは、APIYI ドキュメントセンターをご覧ください。