著者注:推論サービスのコスト構造から出発して、Token サービスがなぜ赤字になりやすいのかを解説し、モデル API サービス提供者を評価するための実行可能なチェックリストを提示します。
Token はすでにライブコマースで販売されるようになりましたが、「硅基流动」のような推論サービス提供者の財務状況は依然として芳しくありません。別のニュースでは、ある企業が Claude は高すぎるとして GLM に切り替え、56 台の B200 で 2000 名のエンジニアを支え、AI コストを約 90% 削減したと報じられています。この 2 つを並べて見ると、Token サービスのコスト構造には独自の法則があることがわかります。本記事では 推論サービスのコスト構造 から出発して、Token サービスがなぜ赤字になるのかを説明し、さらに開発者が本当に気にする問題、つまりモデル API サービス提供者が信頼できるかどうかをどう評価するかに踏み込みます。
これはまたしても業界ゴシップの解説ではありません。本記事の分解はすべて技術的な変数を軸に展開します。GPU の減価償却、稼働率、Prefill と Decode のコスト差、KV Cache、キャッシュヒット率、補助金戦略などです。読み終えたら、そのまま選定評価に使えます。
コアバリュー:本記事を読めば、Token 価格の背後にあるコスト構成を理解でき、6 つの軸からなるサービス提供者評価の方法を身につけられます。さらに、実際の呼び出しデータを使って課金が透明かどうかを検証する方法もわかります。
トークンサービスはなぜ赤字になるのか:推論コスト構造の核心ポイント
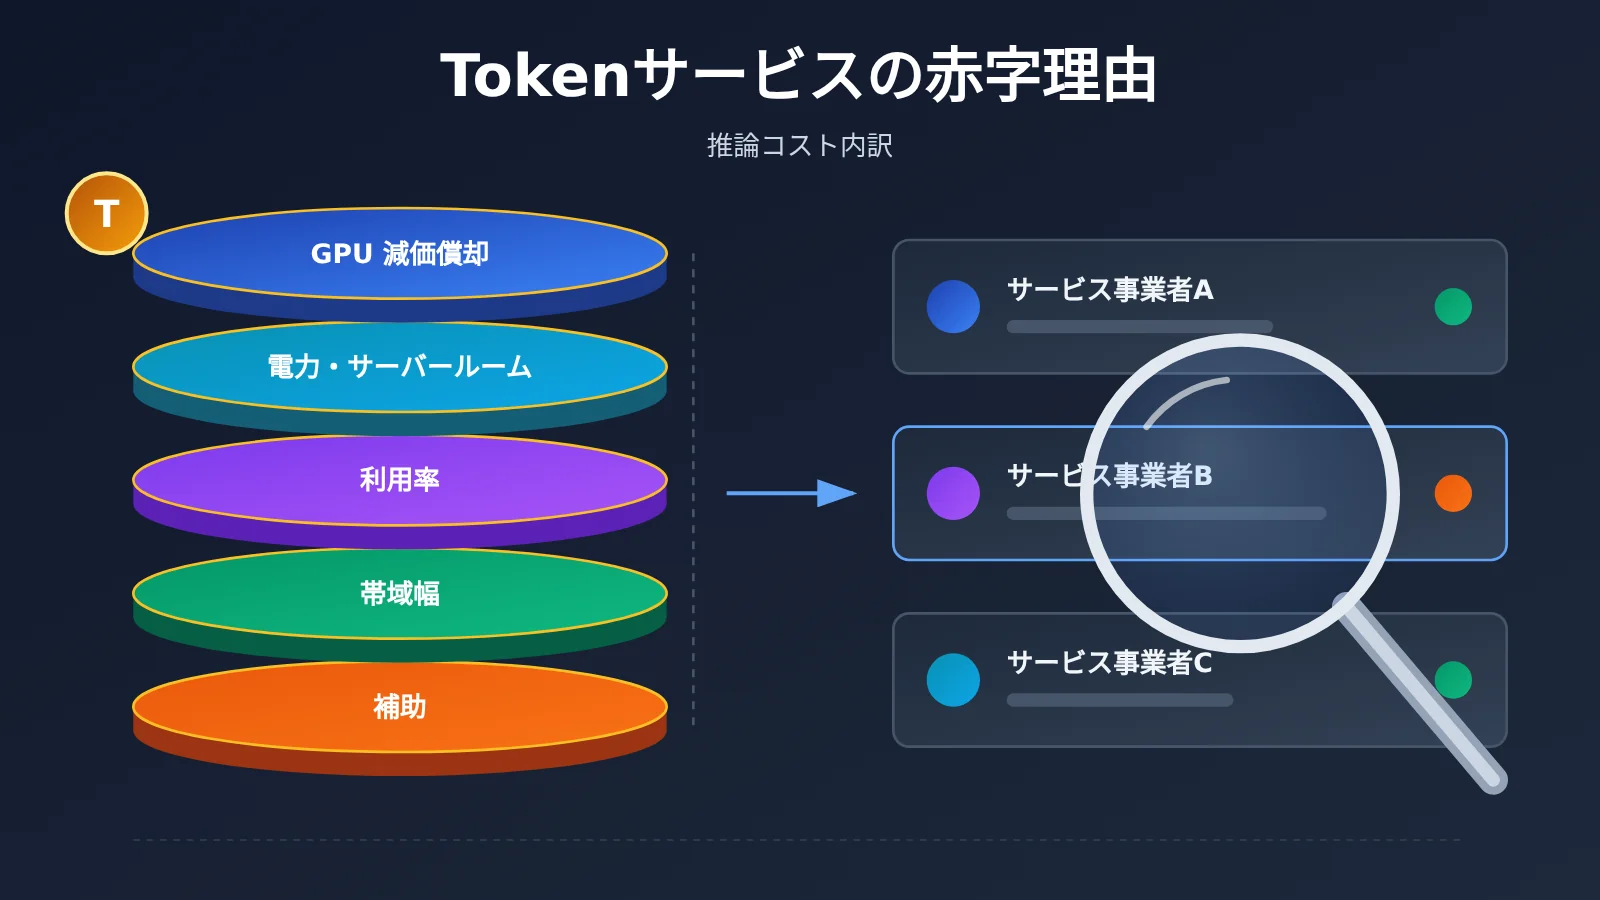
先に結論から述べます。推論サービスのコストは大部分が固定費である一方、収入はトークン量に応じた課金であり、両者は「稼働率」によって結びついています。稼働率が上がらない、あるいは価格が競争によって限界費用付近まで押し下げられると、帳簿上は赤字になります。
| コスト要素 | 説明 | トークン単価への影響 |
|---|---|---|
| GPU資本支出と減価償却 | 高性能GPUの購入または長期リース費用を年数で償却 | 固定費。稼働率が低いほど、トークンあたりの配賦額が高くなる |
| データセンター、電力、ネットワーク | コロケーション、冷却、帯域、リージョン間災害対策 | 準固定費。規模を拡大して初めて薄まる |
| GPU稼働率 | 実際に推論を実行している時間の割合とバッチ処理の飽和度 | 損益の核心的なレバー。ピークと谷の差が利益を直接食い潰す |
| Prefill / Decode 構造 | 入力は並列処理、出力はトークン単位で逐次生成 | 出力トークンのほうが高コスト。長い出力のシナリオでは負担が大きい |
| 長いコンテキストと KV Cache | VRAMがキャッシュに占有され、同時実行容量が低下 | 長いコンテキストのリクエストは、サービス提供できるユーザー数を圧迫する |
| 補助金と顧客獲得 | 無料枠、低価格での誘導、チャネル手数料 | 短期的には量を伸ばすが、長期的には粗利益を押し下げる |
トークンサービスのコスト構造の要点を詳しく解説
固定費と従量収入のミスマッチが第一の理由です。フル構成のGPUサーバーは、リクエストの有無にかかわらず、減価償却費、電気代、データセンター費用が発生し続けます。一方、ユーザーは実際に消費したトークン分だけを支払います。日中ピーク時にはレイテンシを保証するため十分な計算資源を確保する必要がありますが、夜間の閑散期にはその計算資源が遊んでしまいます。アイドル時間帯のコストは最終的に、ピーク時に販売するトークンへ配賦されることになります。価格設定が「フル稼働時の理論コスト」だけを基準にしていると、実際の運用ではほぼ確実に赤字になります。
価格競争が単価を限界費用へ押し下げることが第二の理由です。オープンソースモデルの重みは誰でも利用でき、複数の推論サービス事業者が同じモデルをデプロイしているため差別化の余地は小さく、価格が自然と主要な競争手段になります。トークンをライブコマースで販売するということは、この種の商品がすでに「標準化されたコモディティ」に近づいていることを示しています。このような状況では、サービス事業者はプレミアム価格で固定費をカバーするのは難しく、規模とスケジューリング効率で勝負するしかありません。
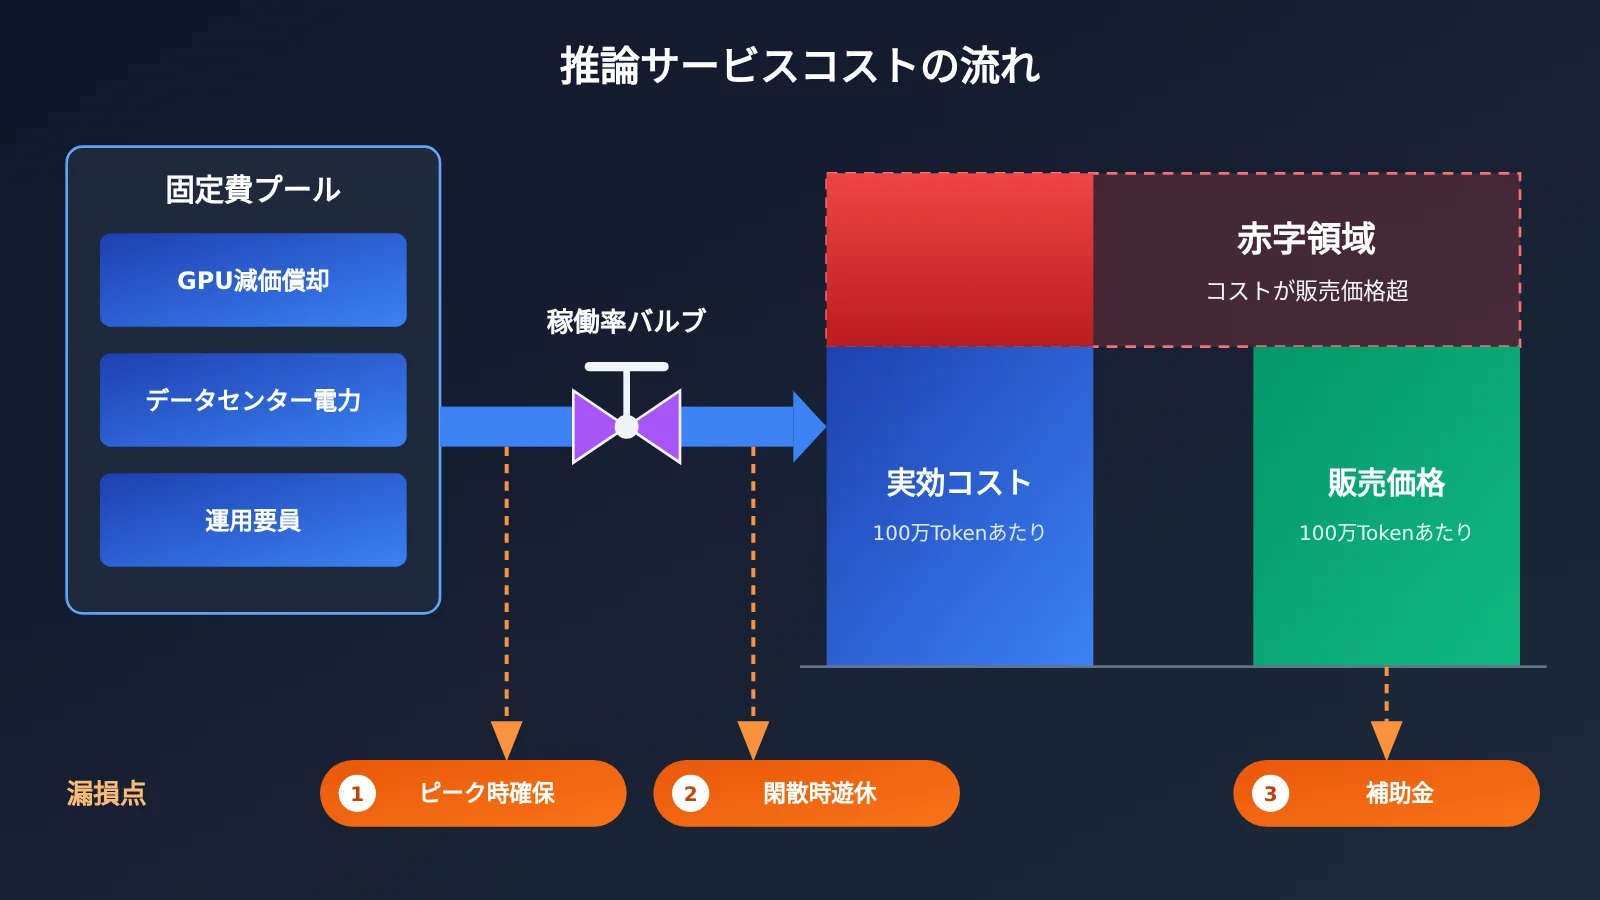
推論サービスのコスト内訳:トークン単価はどのように算出されるのか
トークンサービスの採算がなぜ悪化するのかを理解するには、1回の推論リクエストを2つのフェーズに分けて見る必要があります。フェーズごとに消費するリソースが異なるため、課金の基準も変わります。多くのプロバイダーが入力・出力・キャッシュを別々に価格設定しているのは、まさにこのためです。
Prefill と Decode:出力トークンが高くなる理由
1回のリクエストはまず Prefill フェーズに入ります。モデルはすべての入力トークンを並列処理するため、計算集約的ではありますが効率が高く、GPU の演算能力を十分に活用できます。続いて Decode フェーズに入ると、モデルは1回につき1トークンしか生成せず、さらに以前の KV Cache を繰り返し読み込みます。このフェーズはメモリ帯域の制約を受けやすく、GPU の演算能力をフルに使い切ることは難しくなります。
そのため、同じトークン数でも出力の単位コストは通常、入力よりも明らかに高くなります。主要プロバイダーの料金も、一般的に出力単価が入力単価より高く設定されています。長い出力が中心の業務、たとえばコード生成、長文執筆、Agent のマルチターン推論などでは、コストは出力側に集中します。プロバイダーを評価する際は、出力単価と出力スループットを優先的に確認しましょう。
KV Cache と長いコンテキスト:見えないVRAMコスト
長いコンテキストのリクエストでは、コストは「入力が多い」だけにとどまりません。KV Cache はコンテキスト長が増えるほど多くの VRAM を占有し、1枚の GPU で同時に処理できるリクエスト数はそれだけ減ります。つまり、非常に長いコンテキストを使う1人のユーザーが、一般ユーザー数人分の同時実行枠を圧迫する可能性があります。このコストは単価に完全には反映されないことが多く、プロバイダーは段階別の価格設定、レート制限、コンテキスト長の制限などでバランスを取るしかありません。
キャッシュヒット:コスト削減の手段であり、価格設定の落とし穴でもある
プロンプトキャッシュ(Prompt Caching)を使うと、繰り返し現れるプレフィックスを再計算せずに済み、ヒットした部分はより低いキャッシュ読み取り価格で課金されます。Agent や RAG のように、システムプロンプトが長く繰り返される業務では、キャッシュヒット率が最終的な請求額に大きく影響します。注意が必要なのは、キャッシュ書き込み、キャッシュ読み取り、キャッシュ有効期間の課金ルールがプロバイダーごとに異なることです。明示的に有効化が必要な場合もあります。評価時には、返される usage フィールドにキャッシュ関連のトークン統計が含まれているかを必ず確認してください。
| 課金の基準 | リソース消費の特徴 | 評価時に確認するポイント |
|---|---|---|
| 入力トークン | Prefill で並列計算するため効率が高い | コンテキスト長に応じた段階価格か |
| 出力トークン | Decode で1つずつ生成し、メモリ帯域の制約を受ける | 出力単価、出力スループット(トークン/s) |
| キャッシュ書き込み | 初回書き込みで、一部プラットフォームでは別途課金 | 書き込みに割増があるか、有効期間はどのくらいか |
| キャッシュ読み取り | プレフィックスにヒットし、重複計算をスキップ | ヒット部分の割引、usage が開示されるか |
| 推論思考トークン | 推論モデル内部の思考プロセス | 出力に計上されるか、予算を制限できるか |
💰 価格の基準について:上の表は課金の軸を示すもので、具体的な価格には触れていません。本文で扱うモデルの入力単価、出力単価、キャッシュ読み書き価格は、APIYI の料金ページ
https://docs.apiyi.com/modelsの実際のデータを基準にしてください。モデルやグループによって課金基準が異なる場合があります。申し込み前に項目ごとに確認してください。
自社推論 vs API呼び出し:Tokenコストの計算方法
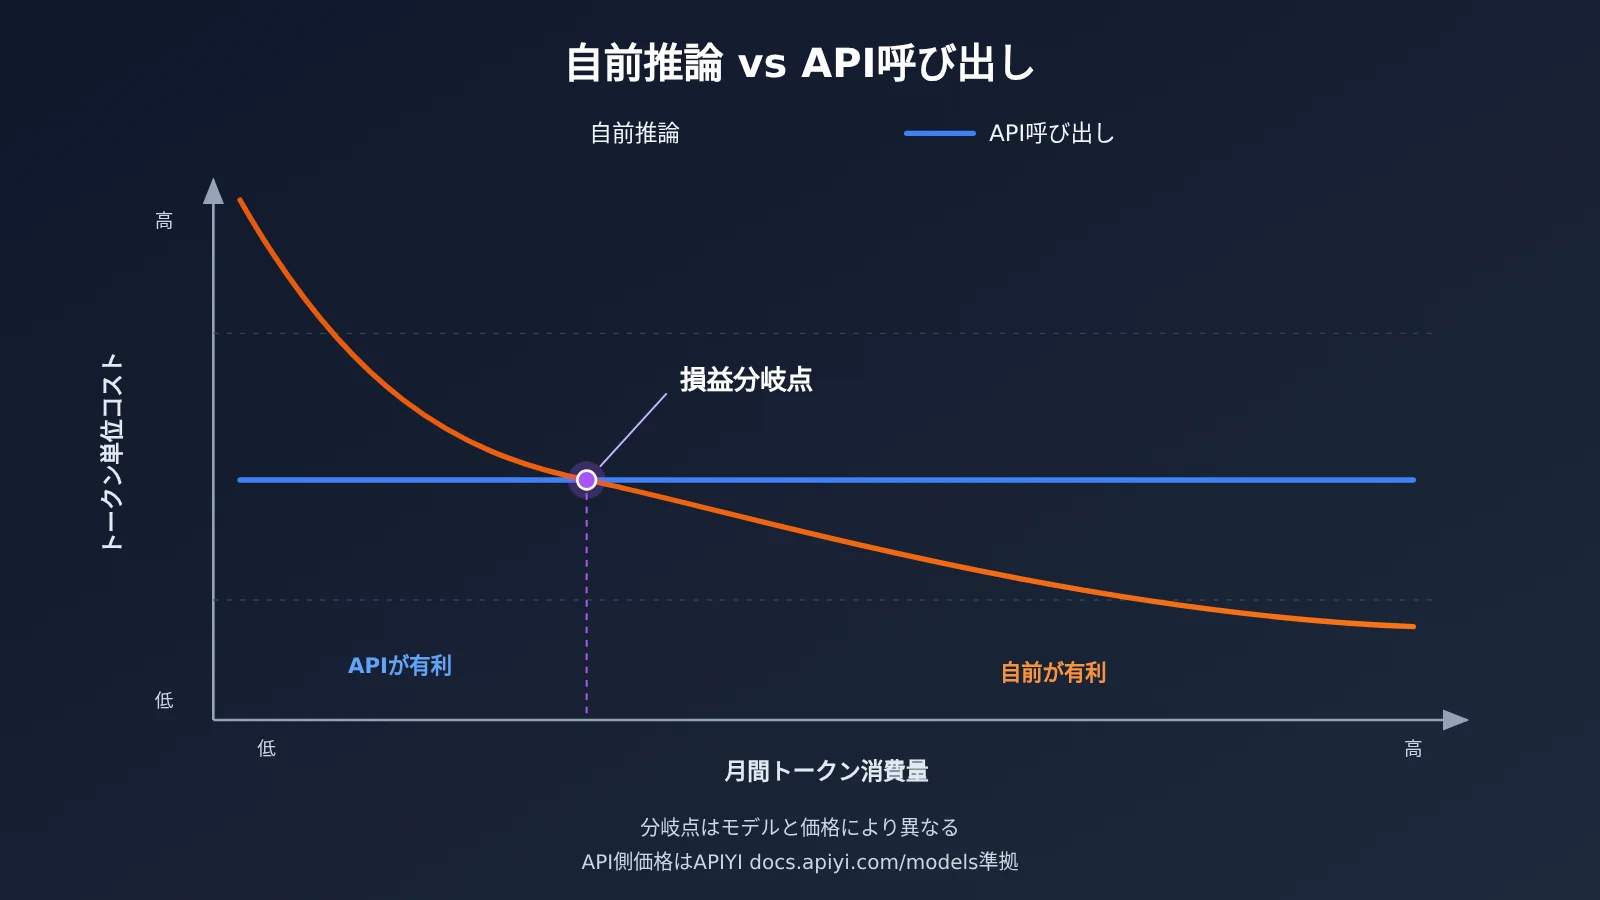
「B200 を 56 基でエンジニア 2000 人を支え、コストを約 90% 削減した」というこの事例が成立するには、いくつかの前提があります。同社の負荷は社内エンジニアによるもので、リクエスト量が多く、比較的安定しています。稼働時間は業務時間に集中し、予測しやすい状況です。モデルはオープンソースで自社デプロイ可能な GLM に置き換えられました。この 3 点によって固定費を十分に薄く摊(分散)でき、パブリック推論サービス事業者が最も頭を悩ませる稼働率の問題をちょうど回避できたのです。
逆に言えば、この事例はすべてのチームが自社構築すべきだという意味ではありません。リクエスト量が少なく変動が大きい場合や、複数のクローズドソースモデルを頻繁に切り替える必要がある場合、自社 GPU クラスタの遊休コストはすぐに API の請求額を上回ります。パブリック推論サービス事業者の価値は、まさに多数の顧客の負荷を互いに「ピークカット・谷埋め」し合うことで、全体としてより高い稼働率を得るところにあります。
| 方案 | コスト構造 | 適用シーン | 主なリスク |
|---|---|---|---|
| 自社GPUクラスタ | 固定費が高く、限界費用は低い | 使用量が多く負荷が安定し、モデルが固定された大規模チーム | 遊休による浪費、運用保守の人件費、ハードウェア更新による価値下落 |
| 単一モデルの公式API | 完全な従量課金 | 特定のクローズドソースモデルに強く依存する業務 | 価格が一律、切り替えコストが高い、リージョン可用性に制約 |
| マルチモデルAPIアグリゲーションプラットフォーム | 従量課金、統一インターフェース | 複数モデルの比較・切り替え・混合利用が必要な場合 | 課金の透明性と安定性を確認する必要がある |
| ハイブリッド構成 | 高頻度タスクは自社構築、ロングテールタスクはAPI | 中~大規模でモデルの階層化が明確な業務 | アーキテクチャの複雑度が上がる |
自社構築案のベンチマーク分析:自社構築は単位コストの下限で優位に立ちますが、その前提は稼働率が十分に高いこと、そしてチームにデプロイ、量子化、スケーリング、障害復旧を扱う能力があることです。これに対して API 案は単位コストの予測性が高く、負荷の変動が大きく、複数モデルの並行検証が必要なチームに向いています。
アグリゲーションプラットフォームのベンチマーク分析:公式 API はモデルの初回リリース速度で優位ですが、多くの場合 1 つのアカウントでカバーできるのは 1 社のモデルだけです。マルチモデルのアグリゲーションプラットフォームの利点は、1 つのインターフェースで複数モデルに接続でき、A/B 比較やコストの階層化がしやすいことです。APIYI apiyi.com のようなプラットフォームは OpenAI と Anthropic の両方のインターフェース形式に対応しており、既存コードをほとんど変更せずにモデルを切り替えられます。
モデルAPIサービス提供者の評価方法:6次元で手早く確認できるチェックリスト
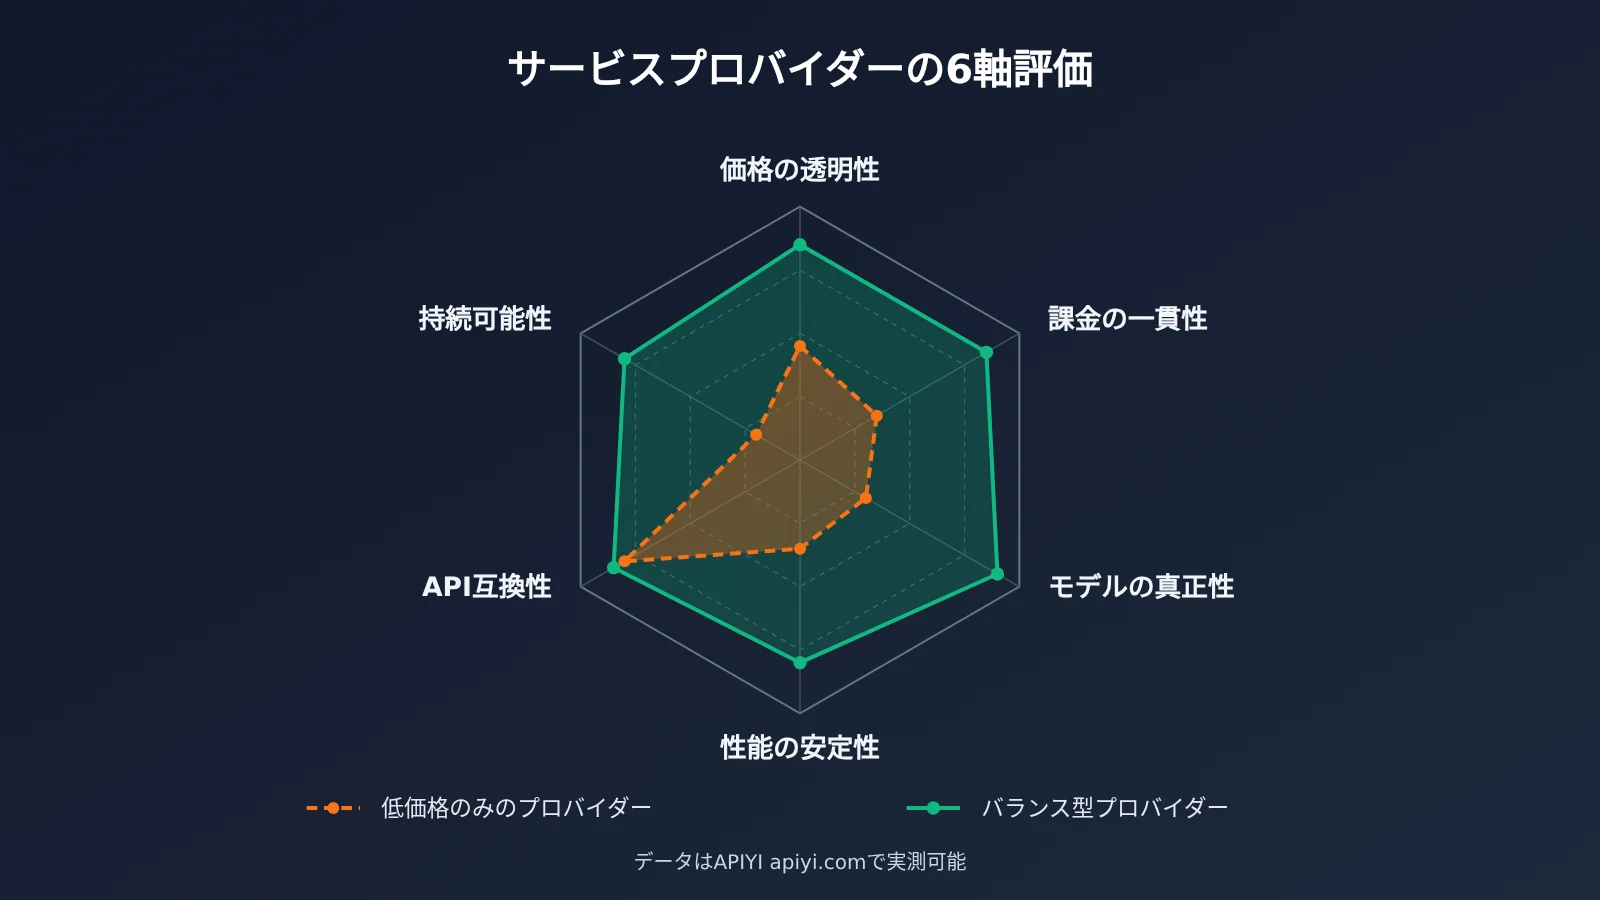
コスト構造を理解すれば、そこから一つの判断を導き出せます。長期間にわたって原価を下回る価格は持続不可能だということです。サービス提供者はどこかの工程で「コストを削る」か、補助金で一定期間しのぐかのどちらかです。提供者を評価する際は、表示価格だけに注目するのではなく、以下の6つの次元を合わせて見る必要があります。
| 次元 | 中心となる問い | 検証方法 |
|---|---|---|
| 1. 価格の透明性 | 入力・出力・キャッシュがそれぞれ明示されているか | 価格ページと照らし合わせ、項目ごとに基準を記録する |
| 2. 課金の一貫性 | 実際の課金が usage と一致しているか |
少量の呼び出しを行った後、請求明細を照合する |
| 3. モデルの真正性 | ダウングレード、混用、過度な量子化が存在しないか | 固定のテストセットで出力品質を比較する |
| 4. 性能の安定性 | 初回文字の遅延、スループット、エラー率はどうか | ピーク時と閑散時にそれぞれ1回ずつテストする |
| 5. インターフェースの互換性 | OpenAI / Anthropic 形式と互換性があるか | 既存のSDKで base_url だけを変えてテストする |
| 6. 持続可能性 | 価格が合理的なコスト範囲を明らかに下回っていないか | コスト構造と組み合わせて補助金リスクを判断する |
ステップ1:互換インターフェースで接続し、最小限の呼び出しを行う
コードを書かなくてもテストの流れは説明できます。プロジェクトですでに OpenAI SDK を使っている場合、通常は2つの設定項目を変えるだけで済みます。api_key を提供者が発行するキーに置き換え、base_url を提供者のインターフェースアドレスに置き換えます。APIYI を例にすると、OpenAI 互換形式の base_url は https://api.apiyi.com/v1 で、対話リクエストは /v1/chat/completions パスを通り、model フィールドに目的のモデル名を入力するだけです。
プロジェクトが Anthropic SDK に基づいている場合、たとえば Claude シリーズのモデルや Claude Code 系のツールを使っている場合も、同様にインターフェースアドレスを置き換え、/v1/messages パスを通る Anthropic ネイティブ形式を利用できます。具体的なアドレスとモデル名は APIYI ドキュメント https://docs.apiyi.com を基準にしてください。最小限の呼び出しを行う際は、後の初回文字遅延の測定を容易にするため、stream ストリーミング出力も同時に有効にすることをおすすめします。
ステップ2:課金の基準と usage フィールドを照合する
各呼び出しのレスポンスでは、OpenAI 形式なら usage.prompt_tokens、usage.completion_tokens が返され、一部のモデルではキャッシュヒット分の cached_tokens も返されます。Anthropic 形式では input_tokens、output_tokens、さらにキャッシュ読み書きのフィールドが対応します。単価の計算はシンプルな式で見積もれます。入力トークン数 × 入力単価+出力トークン数 × 出力単価+キャッシュ読み書きトークン数 × 該当するキャッシュ単価、という形です。
見積もり値とプラットフォームの請求明細を突き合わせて、その差が説明可能であることを確認しましょう。「請求額が usage から推計した額より常に多い」「キャッシュヒットがまったく課金に反映されない」といった状態が長く続く場合は注意が必要です。見積もりに使う単価は、APIYI の価格ページ https://docs.apiyi.com/models に公開されているデータを基準にしてください。
ステップ3:性能・品質・ピーク時間帯を測定する
性能テストでは、次の3つの指標を記録することをおすすめします。初回トークン遅延(TTFT)、出力スループット(1秒あたりのトークン数)、エラー率(タイムアウト、429 レート制限、5xx)です。平日のピーク時と夜間のアイドル時にそれぞれ1回ずつ測定し、その変動が小さいほど、サービス提供側のキャパシティ設計に余裕があると言えます。品質テストでは、コード・推論・長文をカバーする固定のプロンプト群を使い、公式チャネルや他プラットフォームの出力と相互比較することで、モデルがダウングレードされたり差し替えられたりしていないかを発見しやすくなります。
| テスト項目 | 主要パラメータ / フィールド | 合格の目安 |
|---|---|---|
| 初回トークン遅延 | stream を有効にし、最初の chunk の時刻を記録 |
ピーク時とアイドル時の差が大きすぎない |
| 出力スループット | completion_tokens ÷ 生成所要時間 |
同一モデルの他チャネルと近い |
| 課金照合 | usage の各フィールド × 価格ページの単価 |
請求明細との差が説明可能 |
| キャッシュヒット | cached_tokens またはキャッシュ読み取りフィールド |
長いプレフィックスを繰り返すリクエストでヒットする |
| 安定性 | 429 / 5xx / タイムアウトの回数 | エラー率が低く、再試行の説明がある |
🚀 クイックスタート:同じインターフェースのまま複数モデルのコストと性能を比較したい場合は、まず APIYI apiyi.com で登録してテスト用の枠を取得してください。この記事で扱う主要モデルの API 呼び出しに対応しており、OpenAI と Anthropic の両方のインターフェース形式と互換性があります。
base_urlをhttps://api.apiyi.com/v1に変更すれば、すぐに検証を始められます。各モデルの価格はhttps://docs.apiyi.com/modelsを基準にしてください。
よくある質問 FAQ
Q1:Token サービスはなぜ赤字になるのですか?
推論サービスは GPU の減価償却費やデータセンターの電力費といった固定費が中心である一方、収益はトークン量に応じた課金で成り立っています。ピーク時には計算リソースを確保しておく必要があり、閑散期にはそのリソースが遊休化するため、稼働率を長期間高い水準に保つのは困難です。さらに、オープンソースモデルの同質化による価格競争や無料枠の補助が加わり、販売価格がコストを下回りやすくなります。
Q2:出力トークンが入力トークンより一般的に高いのはなぜですか?
入力は Prefill フェーズで並列計算されるため、GPU の利用効率が高くなります。一方、出力は Decode フェーズで 1 トークンずつ生成され、KV Cache を繰り返し読み出す必要があり、主にメモリ帯域によって制限されるため、単位あたりのコストが高くなります。そのため、長い出力を伴う業務では出力単価とスループットに特に注目する必要があります。
Q3:自前で GPU を構築する方が API 呼び出しより必ず安くなりますか?
必ずしもそうとは限りません。「B200 56 台でエンジニア 2,000 人を支える」といった事例は、大規模で安定し、予測可能な社内負荷があってこそ成り立つものです。利用量が少ない、あるいは変動が大きいチームが自前構築すると遊休が深刻になり、かえって単位コストが高くなる可能性があります。まず API で実際の利用量カーブを描き、そのうえで損益分岐点を評価することをおすすめします。
Q4:極端に安い API サービス事業者は利用しても大丈夫ですか?
試すことは可能ですが、検証をしっかり行うべきです。妥当なコスト範囲を明らかに下回る価格は、通常、補助金・レート制限・モデルのダウングレード・安定性の割引のいずれかを意味します。本記事の 6 項目チェックリストに沿って品質と課金を確認する方が、表示価格だけを見るより信頼できます。
Q5:複数モデルの API パフォーマンスを低コストで比較するには?
主要なインターフェース形式に互換性のあるマルチモデルプラットフォームを使い、統一テストを行うことをおすすめします:
1. APIYI apiyi.com でアカウントを登録し、APIキーを取得する
2. ドキュメント `https://docs.apiyi.com` に従って OpenAI または Anthropic 互換インターフェースを設定する
3. 固定のテストセットで `model` フィールドを順番に切り替え、レイテンシ・品質・`usage` を記録する
同じコード一式で横断比較が完了でき、切り替えコストも非常に低くなります。
Q6:キャッシュ価格はどう調べればよいですか?プラットフォームによって基準は同じですか?
同じではありません。キャッシュ書き込みを別途課金するプラットフォームもあれば、読み取りのみ割引するプラットフォームもあり、有効期間や有効化方法も異なります。APIYI で呼び出す場合、キャッシュの読み書き価格は価格ページ `https://docs.apiyi.com/models` の実際のデータを基準とし、返却される `usage` のキャッシュ関連フィールドと合わせて課金を照合してください。
Q7:サービス事業者を評価する際に見落とされやすい指標は何ですか?
課金の一貫性とピーク時の安定性です。多くのチームは閑散時間帯に一度テストしただけで本番稼働させ、その結果ピーク時に 429 やタイムアウトに頻繁に見舞われます。また、`usage` と請求額の対応関係を一度も確認しないチームも少なくありません。この 2 項目はどちらもリリース前の定例チェック項目に組み込むべきです。
Tokenサービスのコスト構造とAPIプロバイダー評価の要点
- 赤字の根本原因:固定費が高く、収入は従量制、稼働率は変動する。この3つのミスマッチがTokenサービスの赤字を招きやすくします
- 出力のほうが高くつく:DecodeはVRAM帯域に制約されるため、長い出力を扱う業務では出力単価とスループットを厳しくチェックしましょう
- 長いコンテキストには隠れたコストがある:KV CacheがVRAMを圧迫して同時実行数を下げるため、プロバイダーは段階制料金とレート制限でバランスを取らざるを得ません
- 自社構築にはハードルがある:大規模で安定した負荷があってこそGPUの固定費を薄められます。小規模チームはAPIの利用を優先しましょう
- 評価は6つの軸で:価格の透明性、課金の一貫性、モデルの真正性、性能の安定性、インターフェース互換性、持続可能性
- 始め方:APIYIのOpenAI / Anthropic互換フォーマットを通じてすぐに実測できます。価格は
docs.apiyi.com/modelsを参照してください
まとめ:コスト構造からTokenサービスを理解し、適切なモデルAPIプロバイダーを選ぶ
Tokenサービスがなぜ赤字になるのか。突き詰めれば、推論サービスのコスト構造で決まります。
- コスト側:GPUの減価償却費とデータセンターの電力費は固定費であり、稼働率が損益を左右するレバーになります。さらに出力Tokenと長いコンテキストがコストを押し上げます
- 収入側:オープンソースモデルの同質化によって価格競争は避けにくく、補助金で量を伸ばしても粗利は圧迫されます
- 選定側:低価格=お得とは限りません。価格の透明性、課金の一貫性、モデルの真正性、性能の安定性、インターフェース互換性、持続可能性という6つの軸で総合的に判断しましょう
開発者にとって大切なのは、どのプロバイダーがいつまで持ちこたえるかを推測することではなく、実際の呼び出しデータで語ることです。まず小さなトラフィックで課金の突合と品質比較を一通り行い、そのうえでメインモデルとバックアップ経路を決めましょう。
効果の検証には APIYI(apiyi.com)がおすすめです。本記事で扱ったモデルのAPI呼び出しを提供しており、OpenAIおよびAnthropicのインターフェース形式に対応しています。導入ドキュメントは https://docs.apiyi.com をご覧ください。各モデルの入力・出力・キャッシュ価格は、価格ページ https://docs.apiyi.com/models の実際のデータを基準にしてください。
📚 参考資料
- 36Kr – Tokenが李佳琦のライブ配信ルームにまで売り込まれる中、「シリコンバレー型」の推論サービス事業者はなぜ赤字続きなのか:推論サービス事業者の収益難に関する報道
- リンク:
36kr.com/p/4055385238017664 -
説明: Tokenのコモディティ化と推論サービス事業者の赤字という業界背景を理解する
-
36Kr – 毎月1万ドルを費やし、Claudeは高すぎると判断した企業がGLMへ切り替えた事例:企業の自社推論によるコスト削減ケース
- リンク:
36kr.com/p/4055383551038595 -
説明: B200 56枚でエンジニア2000人を支える自社推論の事例。自社構築とAPIのコスト境界を理解するのに役立ちます
-
APIYI ドキュメントセンター:API接続とモデル価格
- リンク:
docs.apiyi.com - 説明: OpenAI / Anthropic 互換の接続方法を確認できます。モデル価格は
docs.apiyi.com/modelsを参照してください
著者: APIYI 技術チーム
技術相談: モデル選定や Token コスト評価に関するご質問は、APIYI 公式サイト apiyi.com からお気軽にお問い合わせください。接続に関する資料は docs.apiyi.com ドキュメントセンターでご覧いただけます