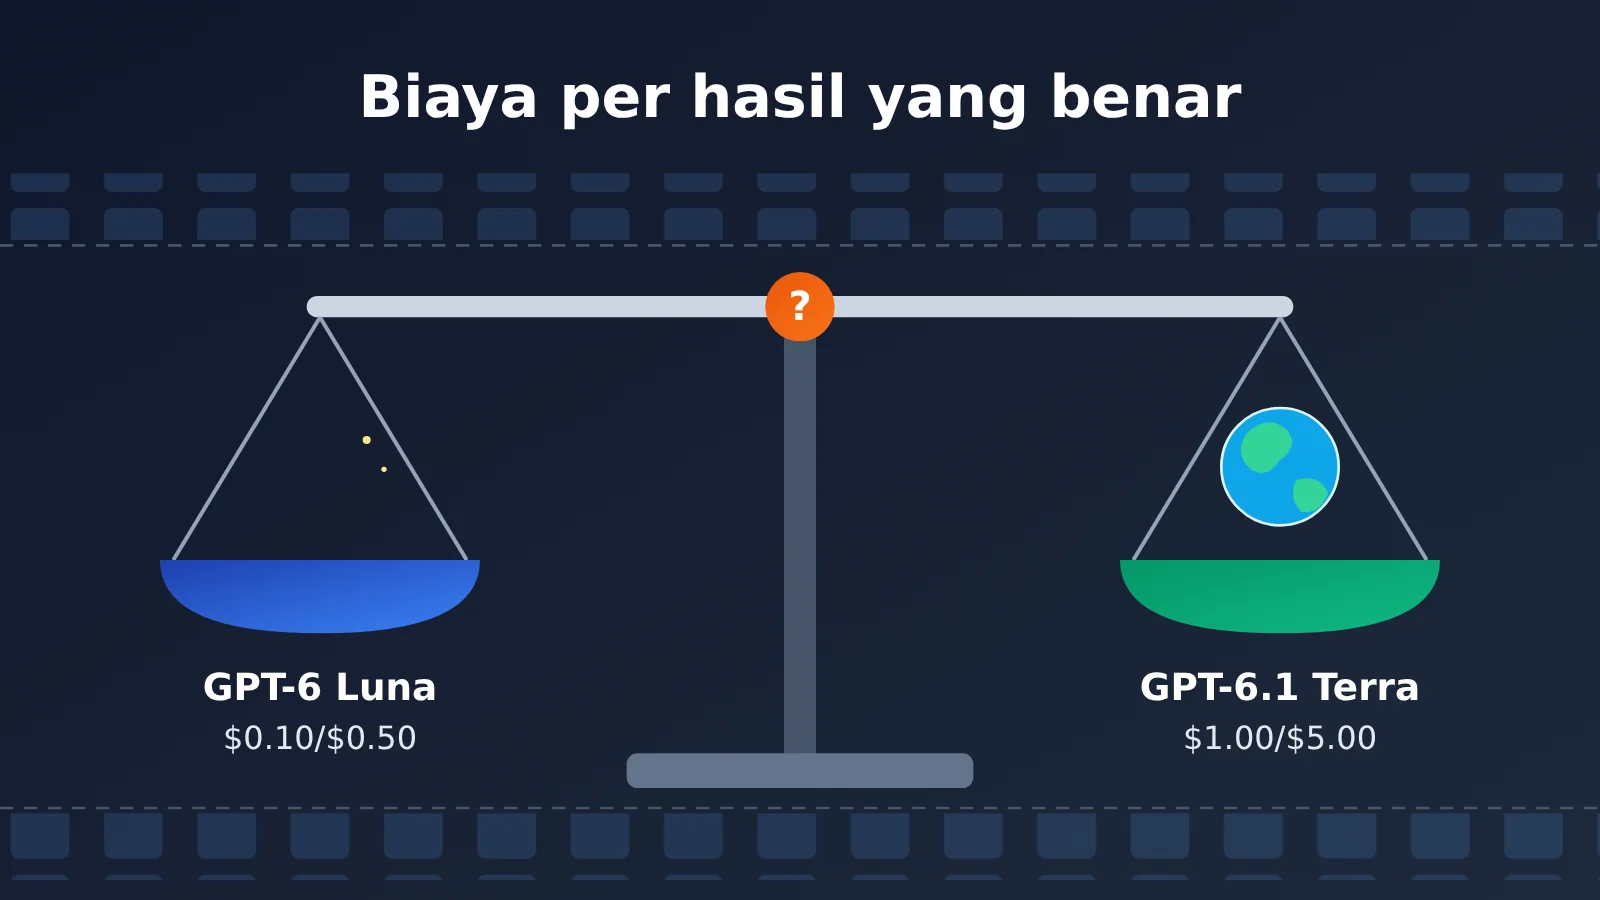
Catatan penulis: Harga per token Terra 10 kali lipat dari Luna, sementara selisih akurasinya berkisar antara 4,7 hingga 18,7 poin persentase. Artikel ini menggunakan data pengujian nyata dari Plotly, DualEntry, OSWorld, dan lainnya untuk menghitung biaya sebenarnya “per hasil yang benar” dalam otomatisasi berskala besar.
OpenAI merilis GPT-6.1 Terra pada 26 Oktober 2026, hanya selang sedikit lebih dari sebulan sejak GPT-6 Luna diluncurkan. Harga API kedua model berbeda 10 kali lipat, tetapi dalam pengujian pihak ketiga dengan kondisi yang sama, keunggulan akurasi Terra berkisar dari kurang dari 5 hingga hampir 19 poin persentase. Untuk otomatisasi berskala besar, pertanyaan yang paling banyak dibahas pengembang adalah: apakah selisih harga ini sepadan?
Ini bukan ulasan model yang hanya mengandalkan kesan. Plotly, DualEntry, dan Artificial Analysis memublikasikan hasil pengujian pada hari peluncuran Terra. OpenAI juga merilis data resmi untuk OSWorld 2.1, MMMU-Pro, dan tingkat kesalahan fakta. Artikel ini menggabungkan data tersebut untuk menjawab satu pertanyaan konkret: berapa banyak hasil benar yang benar-benar berguna yang didapat dari biaya tambahan itu?
Manfaat utama: Setelah membaca artikel ini, kamu akan tahu jenis tugas berskala besar yang menunjukkan perbedaan signifikan antara GPT-6.1 Terra dan GPT-6 Luna, serta tugas yang hasilnya hampir sama. Kamu juga akan mendapatkan kode untuk solusi gabungan: “penyaringan awal dengan Luna + validasi berbasis aturan + Terra sebagai cadangan”.
Ringkasan GPT-6.1 Terra dan GPT-6 Luna
Kedua model sama-sama berasal dari keluarga GPT-6, tetapi punya fokus yang berbeda. OpenAI menggambarkan Luna sebagai model efisien untuk tugas yang jelas, sering dilakukan, dan bervolume besar. Sementara itu, Terra unggul dalam penalaran visual, pengoperasian komputer yang akurat, dan penulisan yang alami. Model ini mengisi posisi di antara Luna dan Sol.
| Informasi | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Tanggal rilis | 22 September 2026 | 26 Oktober 2026 |
| ID API | gpt-6-luna |
gpt-6.1-terra |
| Fokus resmi | Tugas yang sering dilakukan, bervolume besar, dan punya aturan jelas | Penalaran visual, pengoperasian komputer, tugas multilangkah |
| Konteks / output maksimum | 1.050.000 / 128.000 token | 1.050.000 / 128.000 token |
| Tingkat penalaran | 6 tingkat dari none hingga max, default medium | 6 tingkat dari none hingga max, default medium |
| Contoh penggunaan | Klasifikasi label, penyortiran email, ekstraksi field | Entri faktur, pencocokan gambar produk, pengoperasian antarmuka |
Dari spesifikasinya, keduanya hampir sama: sama-sama mendukung input teks dan gambar, Structured Outputs, Function Calling, Responses API, Batch API, serta alat seperti Web Search, File Search, dan Computer Use. Perbedaan utamanya ada pada dua hal: harga dan kemampuan menangani tugas kompleks.
Perlu dicatat, panduan pemilihan model OpenAI tidak mengatakan “gunakan Luna untuk tugas batch” atau “gunakan Terra jika butuh akurasi”. Saran resminya adalah menguji kedua model dengan kumpulan input nyata yang sama, lalu memilih konfigurasi berbiaya terendah yang memenuhi kebutuhan kualitas. Prinsip ini penting untuk memahami semua data dalam artikel ini.
Perbedaan harga API GPT-6.1 Terra dan GPT-6 Luna
Berikut harga resmi OpenAI untuk Standard API dengan konteks pendek, dalam dolar AS per satu juta token:
| Komponen biaya | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| Token input | $0.10 | $1.00 | 10 kali |
| Input dari cache | $0.01 | $0.05 | 5 kali |
| Output token | $0.50 | $5.00 | 10 kali |
| Penulisan cache 30 menit | $0.125 | $1.25 | 10 kali |
| Input / output Batch | Sekitar $0.05 / $0.25 | Sekitar $0.50 / $2.50 | 10 kali |
Tarif mode Batch dan Flex sekitar setengah dari Standard, sedangkan mode Fast sekitar dua kali lipat. Ada dua hal terkait biaya yang mudah terlewat. Pertama, jika input satu permintaan melebihi 272.000 token, input dan cache untuk seluruh permintaan dikenai tarif dua kali lipat, sedangkan output dikenai tarif 1,5 kali lipat. Kedua, alat seperti pencarian web dan pengoperasian komputer dapat dikenai biaya tambahan. Token penalaran, percobaan ulang, dan pemanggilan agent dalam beberapa putaran juga dapat mengubah pemakaian aktual.
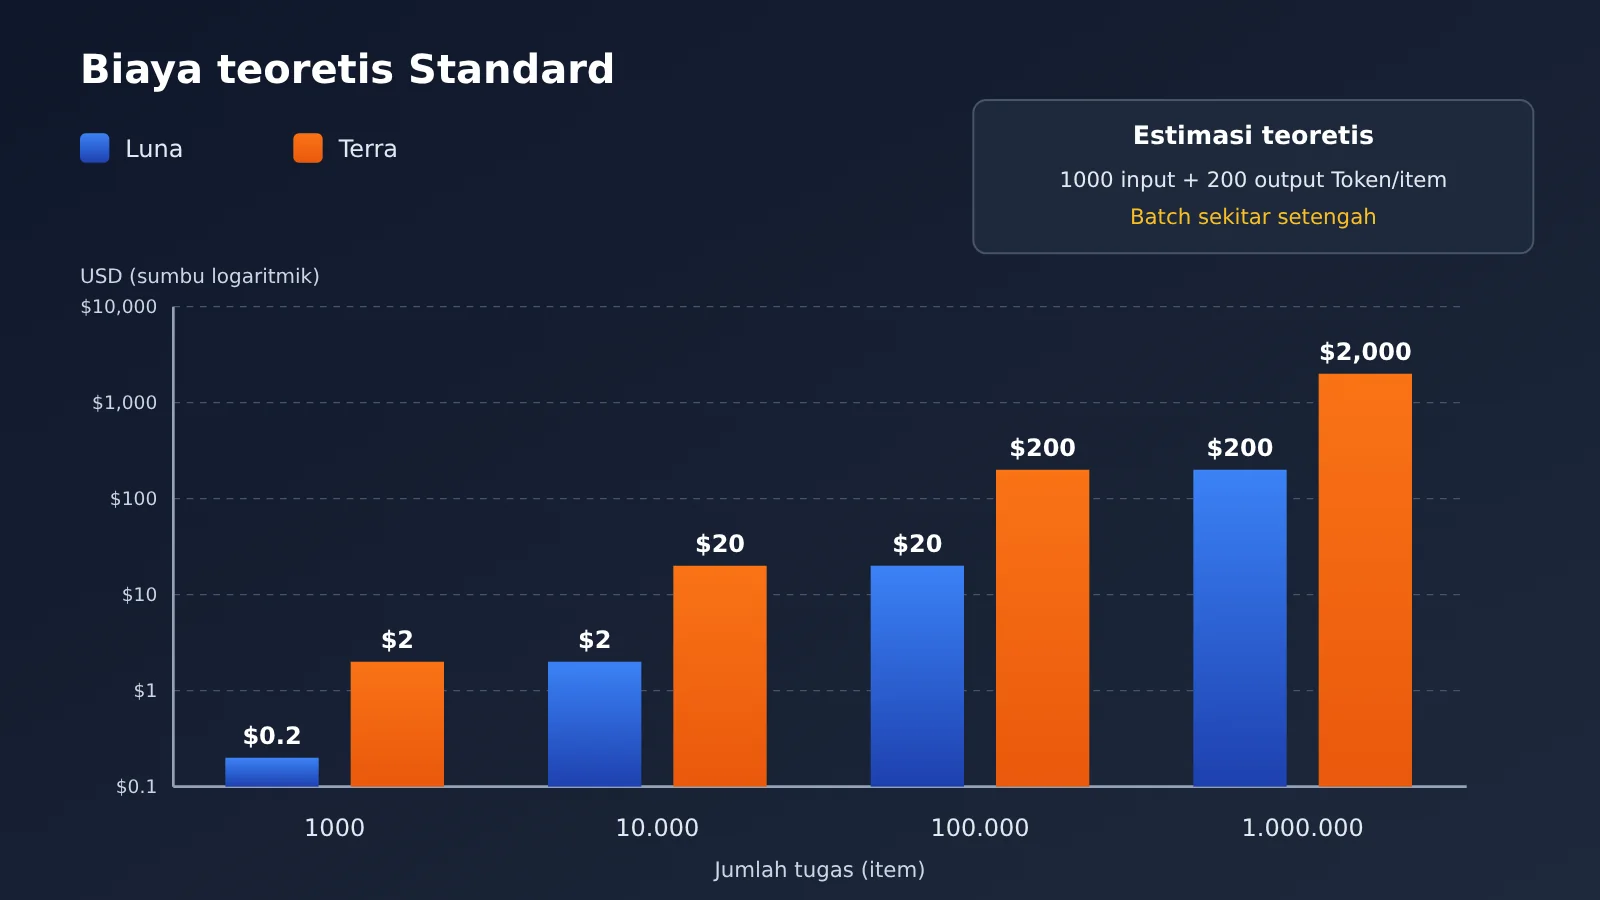
Jadi, “10 kali lebih mahal” mengacu pada harga per token dengan kondisi penagihan yang sama, bukan berarti setiap pekerjaan pasti 10 kali lebih mahal. Sebagai perhitungan teoretis, anggap setiap rekaman membutuhkan 1.000 token input dan 200 token output, tanpa cache atau percobaan ulang. Untuk memproses 100.000 rekaman dalam mode Standard, biayanya sekitar $20 dengan Luna dan $200 dengan Terra; dalam mode Batch, biayanya sekitar $10 dan $100. Ini hanya perkiraan berdasarkan harga publik, bukan tagihan hasil pengujian.
GPT-6.1 Terra vs GPT-6 Luna: Data dari 4 Pengujian Nyata
Harga satuan hanya menunjukkan “berapa biaya yang dikeluarkan”. Selanjutnya, kita perlu melihat “apa yang didapat”. Empat kelompok data berikut berasal dari lembaga yang berbeda dan menguji jenis tugas yang berbeda pula. Hasilnya menunjukkan bagaimana selisih akurasi berubah seiring tingkat kesulitan tugas.
43 soal analisis data Plotly: biaya 10 kali lipat, 2 jawaban benar lebih banyak
DataAnalyticsBench, yang dikembangkan oleh peneliti Plotly dan Mila, menyimulasikan gudang data perusahaan operator pembangkit listrik tenaga angin. Gudang ini berisi sekitar 20 juta baris data sintetis. Kedua model menggunakan perangkat yang sama untuk menjawab 43 pertanyaan, dengan hasil sebagai berikut:
| Metrik | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Jumlah jawaban benar | 38/43(88,4%) | 40/43(93,0%) |
| Biaya seluruh pengujian | $0.13 | $1.31 |
| Median waktu per soal | 18 detik | 15 detik |
| Analisis biasa / pertanyaan ambigu / permintaan yang mustahil / kualitas data | Nilai sempurna untuk semua | Nilai sempurna untuk semua |
| Jebakan statistik | 3/5 | 4/5 |
| Penemuan pola tersembunyi | 2/5 | 3/5 |
Temuan paling menarik terlihat pada hasil per kategori. Keduanya menunjukkan performa yang sama dalam analisis biasa, mengenali kebutuhan yang ambigu, menolak permintaan yang tidak bisa dipenuhi, dan menemukan masalah kualitas data dasar. Selisih hanya muncul pada dua jenis analisis yang lebih mendalam: jebakan statistik dan penemuan pola tersembunyi. Terra menjawab satu soal lebih banyak dengan benar di masing-masing kategori.
Jika dihitung secara kasar dari hasil keseluruhan, Terra menghabiskan $1.18 lebih banyak dan menghasilkan 2 jawaban benar tambahan. Artinya, biaya tambahan untuk setiap jawaban benar tambahan sekitar $0.59. Ini adalah biaya marginal yang dihitung dari total pengujian, bukan harga koreksi kesalahan yang stabil di lingkungan produksi. Jika soal tersebut berkaitan dengan keputusan bisnis, $0.59 tergolong murah. Namun, jika hanya untuk menemukan satu pola yang tidak terlalu penting dalam laporan internal, biaya 10 kali lipat itu mungkin tidak perlu.
Ada satu detail lain: Terra lebih cepat mengerjakan setiap soal karena jawabannya lebih pendek dan jumlah pemanggilannya lebih sedikit (rata-rata sekitar 4,5 pemanggilan model dan sekitar 1.460 token output), bukan karena kecepatan generasinya lebih tinggi. Kecepatan output-nya sekitar 64 token per detik. Perlu diingat, sampelnya hanya 43 soal dan Terra dijalankan melalui OpenRouter dengan konfigurasi penalaran default. Jadi, hasil ini tidak bisa dijadikan dasar untuk menyimpulkan bahwa akurasinya mencapai 93% pada semua analisis data perusahaan.
101 tugas akuntansi DualEntry: selisih melebar menjadi 11,9 poin persentase
Accounting AI Benchmark dari DualEntry lebih mendekati pekerjaan bisnis nyata. Sebanyak 101 tugas mencakup delapan kategori: klasifikasi transaksi, pencatatan jurnal akuntansi, utang usaha, piutang usaha, rekonsiliasi bank, laporan keuangan, penutupan buku akhir bulan, dan pengetahuan akuntansi. Setiap model menjalani tiga putaran, dan sebuah tugas baru dianggap lolos jika berhasil setidaknya dua kali.
Hasilnya: Luna mencapai 66,3%, Terra 78,2%, dan GPT-6.1 Sol sebagai pembanding mencapai 81,2%. Dalam rincian hasil Terra, klasifikasi transaksi mendapat 13/13, pencatatan jurnal 12/13, dan rekonsiliasi bank 10/12. Namun, utang usaha hanya mendapat 7/13, sementara piutang usaha dan penutupan buku akhir bulan masing-masing 7/12. DualEntry juga menyebutkan bahwa Terra dan Luna sama-sama berada di posisi terakhir untuk kategori utang usaha.
Untuk otomatisasi dalam jumlah besar, konsistensi lebih penting daripada akurasi dalam satu kali pengujian. Terra berhasil menjawab benar di ketiga putaran untuk 65,3% tugas, sedangkan Sol mencapai 68,3%. Angka Luna lebih rendah, tetapi sumber aslinya tidak mencantumkan nilai pastinya. Jika tugas akuntansi yang sama dijawab benar hari ini tetapi salah besok, biaya pemeriksaan manual akan cepat meningkat. Dalam pengujian ini, Terra rata-rata membutuhkan 16,1 detik per tugas dengan biaya token sekitar $0.042, atau total sekitar $12.73 untuk tiga putaran. Biaya Luna tidak diungkapkan dengan jelas dalam sumber asli, sehingga tidak diperkirakan di sini.
OSWorld 2.1 dan tingkat kesalahan fakta: kesenjangan terbesar ada pada tugas kompleks
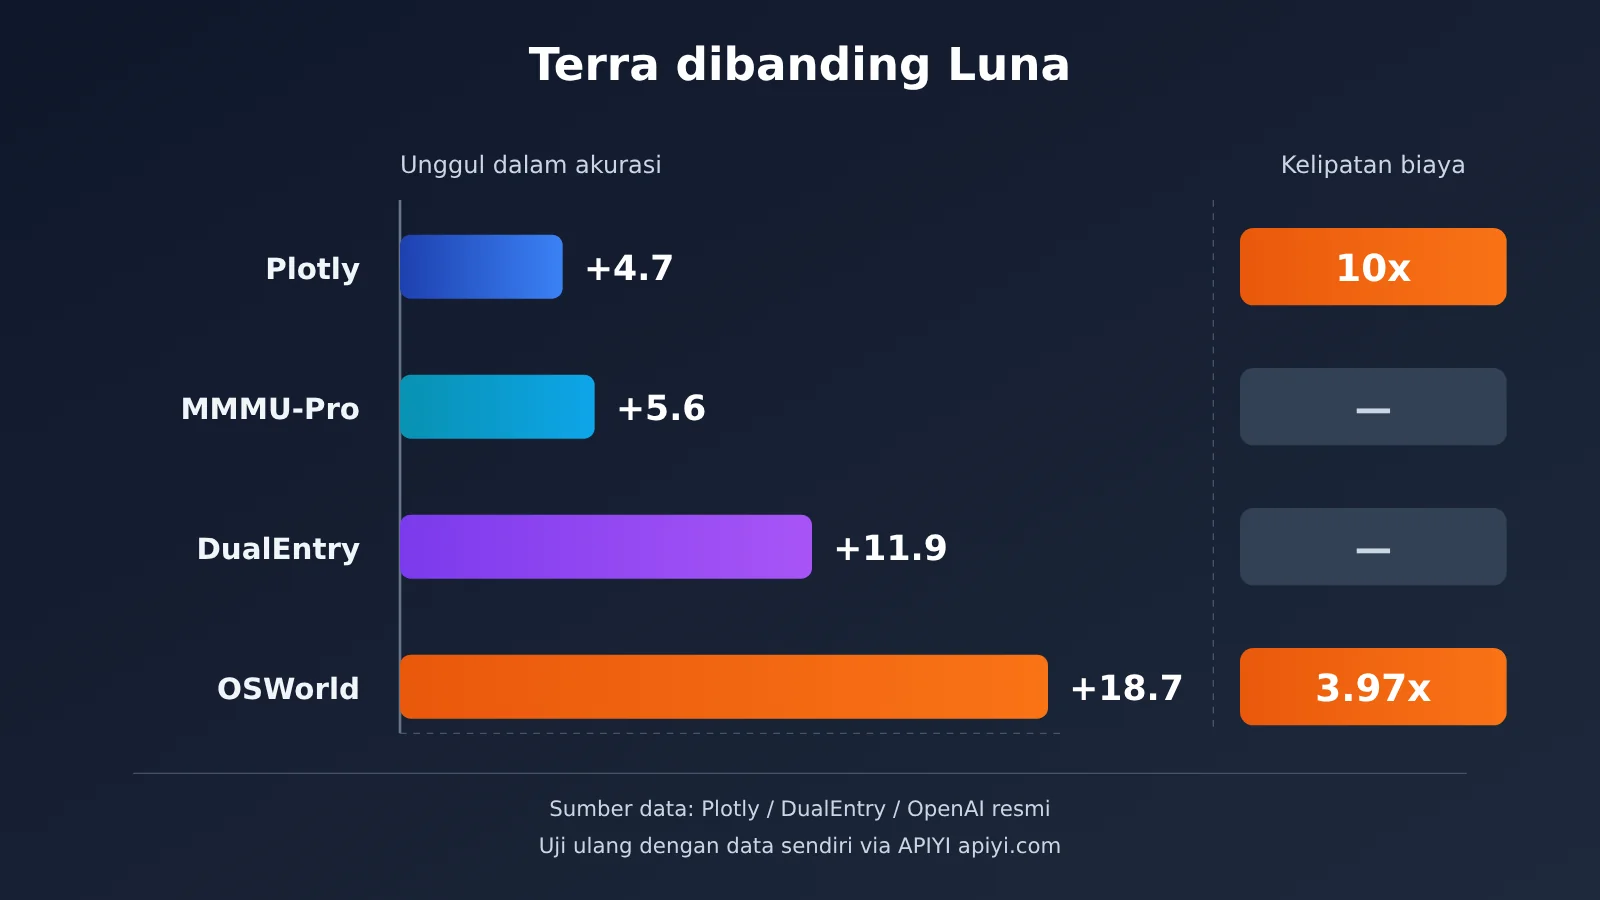
OSWorld 2.1 adalah tolok ukur pengoperasian desktop yang disertakan OpenAI dalam pengumuman peluncuran Terra. Pengujian ini menilai apakah model bisa memahami antarmuka, mengklik tombol yang tepat, dan menyelesaikan operasi bertahap. Pada tingkat penalaran tertinggi, Luna mencatat 55,5% dan Terra 74,2%, selisih 18,7 poin persentase. Estimasi biaya per tugas masing-masing adalah $0,30 dan $1,19, atau sekitar 3,97 kali lipat—bukan 10 kali lipat. Alasannya, jumlah token yang digunakan setiap model untuk menyelesaikan tugas yang sama berbeda-beda.
Hasil pengujian kesalahan fakta bahkan lebih mencolok. Pada soal fakta sulit yang dirancang khusus oleh OpenAI, tingkat kesalahan Luna pada tiga tingkat Low / Medium / Max masing-masing adalah 44,3%, 31,2%, dan 18,4%. Sementara itu, Terra mencatat 16,7%, 10,1%, dan 4,3%. Tingkat kesalahan Terra pada Low masih lebih rendah daripada Luna pada Max. Untuk pemahaman visual, skor MMMU-Pro pada tingkat penalaran tertinggi adalah 79,9% untuk Luna dan 85,5% untuk Terra.
Semua data ini berasal dari grafik resmi OpenAI, bukan pengujian ulang independen oleh pihak ketiga. Soal fakta sulit memang dirancang untuk memancing kesalahan, sehingga tidak berarti tingkat kesalahan Luna dalam penulisan sehari-hari mencapai 44,3%. Skor OSWorld juga hanya berlaku dalam kondisi pengujiannya.
Indeks komposit Artificial Analysis: tingkat penalaran juga perlu dioptimalkan
Evaluasi independen Artificial Analysis memberikan sudut pandang lain. Pada tingkat Max, indeks kecerdasan komposit Luna sekitar 38, sedangkan Terra sekitar 48. Biaya pengujian kompositnya masing-masing sekitar $0,07 dan $0,40, atau sekitar 5,7 kali lipat. Kesenjangan pada indeks agen pemrograman lebih besar lagi: Luna 31 dan Terra 48.
Namun, pemahaman dokumen panjang AA-LCR menjadi pengecualian: keduanya mencapai sekitar 83% pada pengaturan penalaran tertinggi. Selain itu, Terra pada tingkat Low dan Medium berada di garis depan Pareto “biaya–kemampuan” dalam cakupan pengujian lembaga tersebut, tetapi belum tentu paling optimal pada tingkat Max. Dengan kata lain, untuk otomatisasi dalam skala besar, yang perlu disesuaikan bukan hanya modelnya, tetapi juga tingkat penalarannya.
Panduan cepat otomatisasi batch GPT-6.1 Terra dan GPT-6 Luna
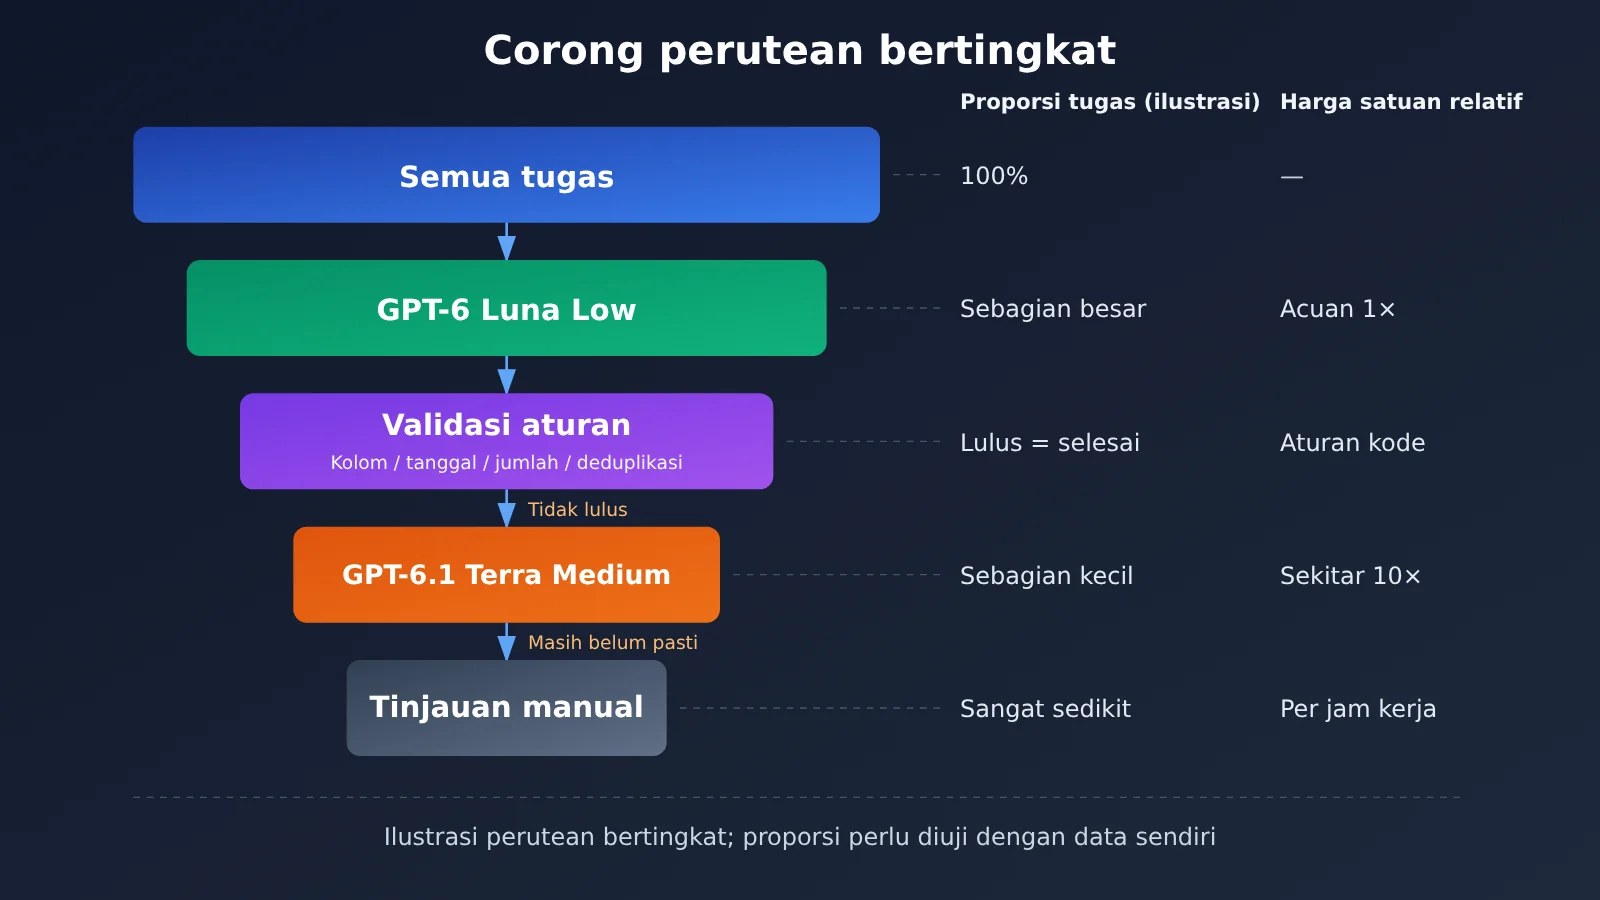
Jika data di atas digabungkan, kesimpulannya cukup praktis: serahkan sebagian besar tugas dengan aturan yang jelas kepada Luna, lalu teruskan tugas yang kompleks, berisiko tinggi, atau gagal validasi kepada Terra. Contoh minimal berikut meminta Luna mengekstrak data faktur, lalu memvalidasinya dengan aturan program. Hanya hasil yang gagal validasi yang diteruskan ke Terra.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
Lihat kode lengkap perutean bertingkat
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一层:Luna Low 处理全部输入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二层:未通过校验的升级到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三层:仍不确定的进入人工审核队列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 Mulai cepat: Rekomendasi resminya adalah memastikan kedua model berfungsi dengan satu kunci API terlebih dahulu, lalu mengujinya dengan sampel Anda sendiri. APIYI apiyi.com menyediakan antarmuka yang kompatibel dengan OpenAI; untuk beralih antara
gpt-6-lunadangpt-6.1-terra, Anda cukup mengganti parametermodel. Pengguna baru mendapat kuota uji coba gratis, cocok untuk eksperimen perbandingan skala kecil.
Kunci dari struktur ini ada pada langkah kedua. Jangan jadikan pernyataan “Luna sangat yakin” sebagai bukti bahwa hasilnya benar. Tingkat keyakinan yang dilaporkan model sendiri belum tentu dapat diandalkan. Utamakan aturan yang bisa diverifikasi: apakah ada kolom yang kosong, apakah tanggal valid, apakah jumlahnya sesuai, apakah kolom penting cocok dengan teks asli, dan apakah ada data duplikat.
Analisis dampak GPT-6.1 Terra dan GPT-6 Luna
Dampaknya bagi developer: pilih model sesuai jenis tugas
Berdasarkan posisi yang dijelaskan secara resmi dan pengujian di atas, berikut rekomendasi awal untuk beberapa tugas batch yang umum. Perlu diingat, rekomendasi ini didasarkan pada evaluasi publik, bukan bukti pengujian untuk semua skenario tersebut. Tetap lakukan validasi dengan data sendiri sebelum menerapkannya.
| Skenario bisnis | Rekomendasi awal | Alasan | Platform yang tersedia |
|---|---|---|---|
| Memberi label pada 100.000 artikel | GPT-6 Luna | Aturannya jelas dan hasilnya bisa diperiksa melalui sampel; keduanya mendapat nilai penuh dalam analisis biasa Plotly | APIYI apiyi.com, OpenAI resmi |
| Memasukkan data dari tangkapan layar faktur / pesanan | GPT-6.1 Terra | Unggul dalam kemampuan visual dan operasional, tetapi nominal tetap perlu diverifikasi secara terprogram | APIYI apiyi.com, OpenAI resmi |
| Merangkum berita AI harian | Luna untuk penyaringan awal + Terra untuk analisis mendalam | Serahkan penghapusan duplikat dan pelabelan kepada Luna, lalu penilaian tingkat kepentingan kepada Terra | APIYI, OpenAI resmi |
| Memilah dan membuat draf email layanan pelanggan | Utamakan Luna | Tiket berisiko tinggi seperti keluhan dan pengembalian dana dieskalasikan atau dialihkan ke petugas | APIYI, OpenAI resmi |
| Mengubah halaman web dan kode secara massal | Terra atau Sol | Indeks agen pemrograman: Terra 48, Luna 31 | APIYI, OpenAI resmi |
Hal lain yang mudah terlewat oleh developer adalah throughput. Pada tingkat Build yang tercantum secara resmi, batas Luna adalah 2 juta token per menit dan 20 juta token dalam antrean Batch, sedangkan Terra masing-masing 1 juta dan 3 juta. Pada tingkat Launch, batas Luna masing-masing 10 juta dan 1 miliar, sedangkan Terra 4 juta dan 200 juta. Untuk tugas batch dengan lebih dari 100.000 item, Luna dapat menampung jauh lebih banyak dalam antrean. Namun, ini adalah batas kuota, bukan kecepatan generasi, dan batas pada setiap akun bisa berbeda.
Dampak terhadap industri: dari “membandingkan harga per panggilan” ke “membandingkan biaya per hasil yang memenuhi syarat”
Pada hari peluncuran Terra, muncul dua pandangan di komunitas Reddit. Sebagian orang menilai posisi Terra kurang jelas: Luna sudah cukup murah, sedangkan Sol lebih canggih. Sebagian lainnya menunjukkan bahwa tingkat kesalahan fakta Terra Low sudah lebih rendah daripada Luna Max, sehingga perbandingan tidak bisa hanya berdasarkan harga per panggilan. Ada juga pengguna Codex yang melaporkan bahwa penggunaan kuota Terra dengan intensitas penalaran tinggi belum tentu lebih rendah daripada Sol dengan intensitas sedang. Sementara itu, pengguna Luna mendapati bahwa keuntungan kuotanya tergerus oleh pekerjaan ulang pada tugas pengembangan yang kompleks. Semua ini merupakan pengalaman individual. Selain itu, kuota langganan Codex dan penagihan token API adalah dua hal yang berbeda, sehingga tidak bisa digunakan untuk memperkirakan biaya API.
Namun, semuanya mengarah pada tren yang sama: ukuran untuk otomatisasi berskala besar bergeser dari “berapa biaya satu panggilan” menjadi “berapa biaya setiap hasil yang memenuhi syarat”. Rumus sederhana berikut bisa membantu memahaminya:
Total biaya = biaya panggilan API + biaya alat + biaya percobaan ulang + biaya peninjauan manual + kerugian akibat kesalahan
Luna unggul mutlak dalam dua komponen pertama, sedangkan Terra menekan tiga komponen terakhir melalui tingkat kesalahan yang lebih rendah. Mana yang lebih ekonomis bergantung pada besarnya kerugian akibat satu kesalahan dalam bisnis Anda. Pengamatan MultiAI dengan sampel kecil juga mendukung hal ini: saat penalaran Terra dinonaktifkan, sebagian tugas logika dan perhitungan menghasilkan kesalahan, tetapi hasilnya membaik secara signifikan setelah beralih ke Medium. Luna bekerja dengan baik untuk tugas sederhana, tetapi membuat lebih banyak kesalahan pada tugas logika multi-langkah.
Cara melakukan eksperimen perbandingan sendiri
Data publik belum menjawab beberapa pertanyaan penting: tingkat kesalahan kedua model saat mengklasifikasikan 100.000 artikel berbahasa Mandarin dari penggunaan nyata, stabilitasnya dalam jangka panjang, besarnya penghematan dari pendekatan campuran, dan apakah biaya peninjauan manual dapat mengimbangi harga Terra yang lebih tinggi. Semua ini hanya bisa dijawab melalui pengujian sendiri.
Cara yang cukup praktis adalah menyiapkan 200–500 sampel bisnis nyata yang sudah memiliki jawaban standar. Misalnya, masing-masing 100 sampel untuk klasifikasi sederhana, ekstraksi informasi penting, dan identifikasi konten kompleks, serta masing-masing 50 sampel untuk pemeriksaan fakta dan pengoperasian alat dengan beberapa langkah. Kemudian, jalankan empat konfigurasi—Luna Low, Luna Medium, Terra Low, dan Terra Medium—dengan input, petunjuk, alat, dan kriteria penilaian yang sama. Ulangi sebagian tugas beberapa kali untuk mengamati stabilitasnya.
Terakhir, fokus pada lima hasil: tingkat akurasi, biaya API per 1.000 sampel, waktu rata-rata dan waktu P95, jumlah peninjauan manual dan pengerjaan ulang, serta biaya total per 1.000 hasil yang memenuhi standar. Jika menerapkannya melalui platform pihak ketiga, gunakan aturan penagihan aktual platform tersebut sebagai acuan, dan pastikan ketentuan pemrosesan data serta persyaratan kepatuhannya.
Pertanyaan umum FAQ
Q1: Apa perbedaan utama GPT-6.1 Terra dan GPT-6 Luna?
Spesifikasi keduanya hampir sama: jendela konteksnya sama-sama 1.050.000 token dan dukungan alatnya juga identik. Bedanya, harga per token Luna 10 kali lebih murah, sehingga cocok untuk tugas berfrekuensi tinggi dengan aturan yang jelas. Terra jauh lebih unggul dalam pemahaman visual, pengoperasian komputer, analisis kompleks, dan akurasi fakta, sehingga cocok untuk tugas bertahap dengan konsekuensi kesalahan yang besar.
Q2: Terra 10 kali lebih mahal. Apakah akurasinya hanya sedikit lebih tinggi?
Tergantung jenis tugasnya. Dalam pengujian analisis data Plotly, keunggulannya hanya sekitar 4,7 poin persentase. Pada tugas akuntansi DualEntry, selisihnya 11,9 poin persentase, sedangkan pada pengoperasian desktop OSWorld mencapai 18,7 poin persentase. Selain itu, biaya per tugas di OSWorld hanya berbeda sekitar 3,97 kali, bukan selalu 10 kali lipat.
Q3: Jika intensitas penalaran Luna diatur ke max, bisakah ia menggantikan Terra?
Pengaturan ini dapat meningkatkan sebagian performa, tetapi tidak bisa menutup kesenjangan kemampuan model. Dalam pengujian resmi untuk pertanyaan faktual yang sulit, tingkat kesalahan Luna Max adalah 18,4%, masih lebih tinggi daripada Terra Low yang sebesar 16,7%. Selain itu, intensitas penalaran yang lebih tinggi meningkatkan konsumsi token dan dapat menghilangkan keunggulan biaya Luna.
Q4: Bagaimana cara membandingkan kedua model dengan cepat melalui API?
Gunakan kode yang sama dan ganti nama model untuk membandingkan hasilnya:
1. Kunjungi APIYI apiyi.com untuk mendaftar dan mendapatkan kunci API serta kuota uji coba gratis
2. Atur base_url ke `https://api.apiyi.com/v1`
3. Jalankan sampel yang sama dengan `gpt-6-luna` dan `gpt-6.1-terra`, lalu catat akurasi dan konsumsi token masing-masing
Q5: Bagaimana cara menekan biaya untuk tugas dalam jumlah besar?
Untuk tugas yang tidak memerlukan hasil secara real-time, prioritaskan Batch API. Tarifnya sekitar setengah dari Standard, dengan jendela pemrosesan resmi selama 24 jam. Batasi juga setiap input hingga 272.000 token untuk menghindari biaya tambahan untuk konteks panjang. APIYI apiyi.com menggunakan sistem bayar sesuai pemakaian, sehingga Anda bisa mencoba dalam jumlah kecil untuk mengetahui konsumsi token sebenarnya per tugas sebelum meningkatkan volumenya.
Q6: Apa saja keterbatasan hasil pengujian ini?
Plotly hanya memiliki 43 soal dan menggunakan data sintetis. Hasil OSWorld, MMMU-Pro, dan tingkat kesalahan faktual berasal dari sumber resmi OpenAI, bukan pengujian ulang independen. Skor MultiAI 24/24 dan 18/18 juga menggunakan soal yang berbeda, sehingga tidak bisa dibandingkan secara langsung. Selain itu, Structured Outputs hanya menjamin format yang benar, bukan kebenaran isi setiap bidang. Skor benchmark apa pun tidak bisa disamakan dengan akurasi sebenarnya dalam bisnis Anda.
Poin Utama GPT-6.1 Terra dan GPT-6 Luna
- Perbedaan harga 10 kali lipat: Luna mengenakan biaya input $0,10 dan output $0,50, sedangkan Terra $1,00 dan $5,00
- Selisih kecil pada tugas sederhana: Keduanya mendapat nilai sempurna untuk analisis Plotly biasa dan identifikasi pertanyaan ambigu
- Selisih besar pada tugas kompleks: Terra unggul 11,9 poin pada tugas akuntansi dan 18,7 poin pada pengoperasian desktop
- Akurasi fakta berbeda: Tingkat kesalahan Terra Low adalah 16,7%, lebih rendah daripada Luna Max yang mencapai 18,4%
- Tingkat penalaran juga perlu diatur: Terra Low / Medium lebih efisien dari segi biaya dibandingkan tingkat Max
- Perutean bertingkat paling hemat: Luna untuk penyaringan awal, validasi aturan, Terra sebagai cadangan, lalu peninjauan manusia
- Uji sebelum diterapkan: Gunakan 200 hingga 500 sampel milik sendiri untuk membandingkan empat konfigurasi di APIYI apiyi.com
Kesimpulan
Kembali ke pertanyaan awal, pilihan antara GPT-6.1 Terra dan GPT-6 Luna untuk otomatisasi skala besar bergantung pada tingkat kesulitan tugas dan dampak kesalahan:
- Tugas dengan aturan jelas dan validasi otomatis: Luna adalah titik awal yang hemat biaya. Dalam pengujian Plotly, keduanya menunjukkan performa yang sama pada analisis rutin.
- Tugas berisiko tinggi seperti pengenalan visual, operasi bertahap, dan keuangan: Biaya tambahan Terra bisa sepadan, dengan keunggulan akurasi hingga 18,7 poin persentase.
- Tujuan optimasi yang sebenarnya: Bukan harga satu kali pemanggilan API, melainkan total biaya per hasil yang memenuhi standar, termasuk percobaan ulang, peninjauan, dan kerugian akibat kesalahan.
Bagi sebagian besar tim, pendekatan yang lebih baik bukanlah memilih salah satu, melainkan menggunakan Luna untuk sebagian besar pekerjaan sederhana dan Terra untuk menangani bagian yang benar-benar sulit. Sebaiknya lakukan perbandingan skala kecil dengan sampel bisnis sendiri sebelum menentukan proporsi pembagian tugas.
Gunakan APIYI apiyi.com untuk menguji performa kedua model pada kebutuhan bisnis Anda. Anda bisa beralih model dengan satu kunci API dan membayar sesuai pemakaian, sehingga biaya per seribu tugas lebih mudah dihitung secara akurat.
📚 Referensi
- OpenAI: Introducing GPT-6.1 Terra: Pengumuman peluncuran, termasuk grafik OSWorld, MMMU-Pro, dan tingkat kesalahan faktual
- Tautan:
openai.com/index/introducing-gpt-6-1-terra -
Keterangan: Sumber informasi resmi tentang posisi Terra dan data benchmark
-
Halaman OpenAI API Pricing dan model: Harga, kemampuan, dan batas laju Luna dan Terra
- Tautan:
developers.openai.com/api/docs/pricing -
Keterangan: Dasar harga Standard, Batch, Flex, dan Fast
-
Dokumentasi OpenAI Batch API: Biaya dan jangka waktu pemrosesan batch
- Tautan:
developers.openai.com/api/docs/guides/batch -
Keterangan: Cara mengurangi biaya tugas asinkron dalam jumlah besar
-
Plotly: GPT-6.1 Terra Benchmark Results for Data Analysis: Pengujian 43 tugas analisis data dalam kondisi yang sama
- Tautan:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
Keterangan: Akurasi, biaya, waktu pemrosesan, dan skor per kategori
-
DualEntry: GPT-6.1 Terra Accounting Benchmark: Pengujian 101 tugas akuntansi
- Tautan:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
Keterangan: Akurasi, kategori tugas, dan stabilitas selama tiga putaran
-
Artificial Analysis: Evaluasi GPT-6.1 Terra: Indeks kecerdasan keseluruhan dan efisiensi biaya
- Tautan:
artificialanalysis.ai/models/releases/gpt-6-1-terra - Keterangan: Hasil pengujian independen pada berbagai tingkat penalaran
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs resmi APIYI. Untuk informasi lebih lanjut tentang integrasi model, kunjungi pusat dokumentasi di docs.apiyi.com