Catatan penulis: Tidak melihat penggunaan konteks di kotak input Codex? Akses lewat /status. Artikel ini menjelaskan cara menghitung konsumsi token dan biaya setiap putaran Codex dalam 5 langkah menggunakan log pemanggilan APIYI, serta menyediakan tabel untuk menentukan kapan perlu mengompresi konteks atau memulai percakapan baru.
Kamu menggunakan Codex yang terhubung ke APIYI dan sudah bekerja selama beberapa jam dalam satu percakapan. Di bawah kotak input hanya terlihat mode izin dan model, tetapi penggunaan konteks tidak muncul. Kamu pun ragu apakah perlu membuka percakapan baru.
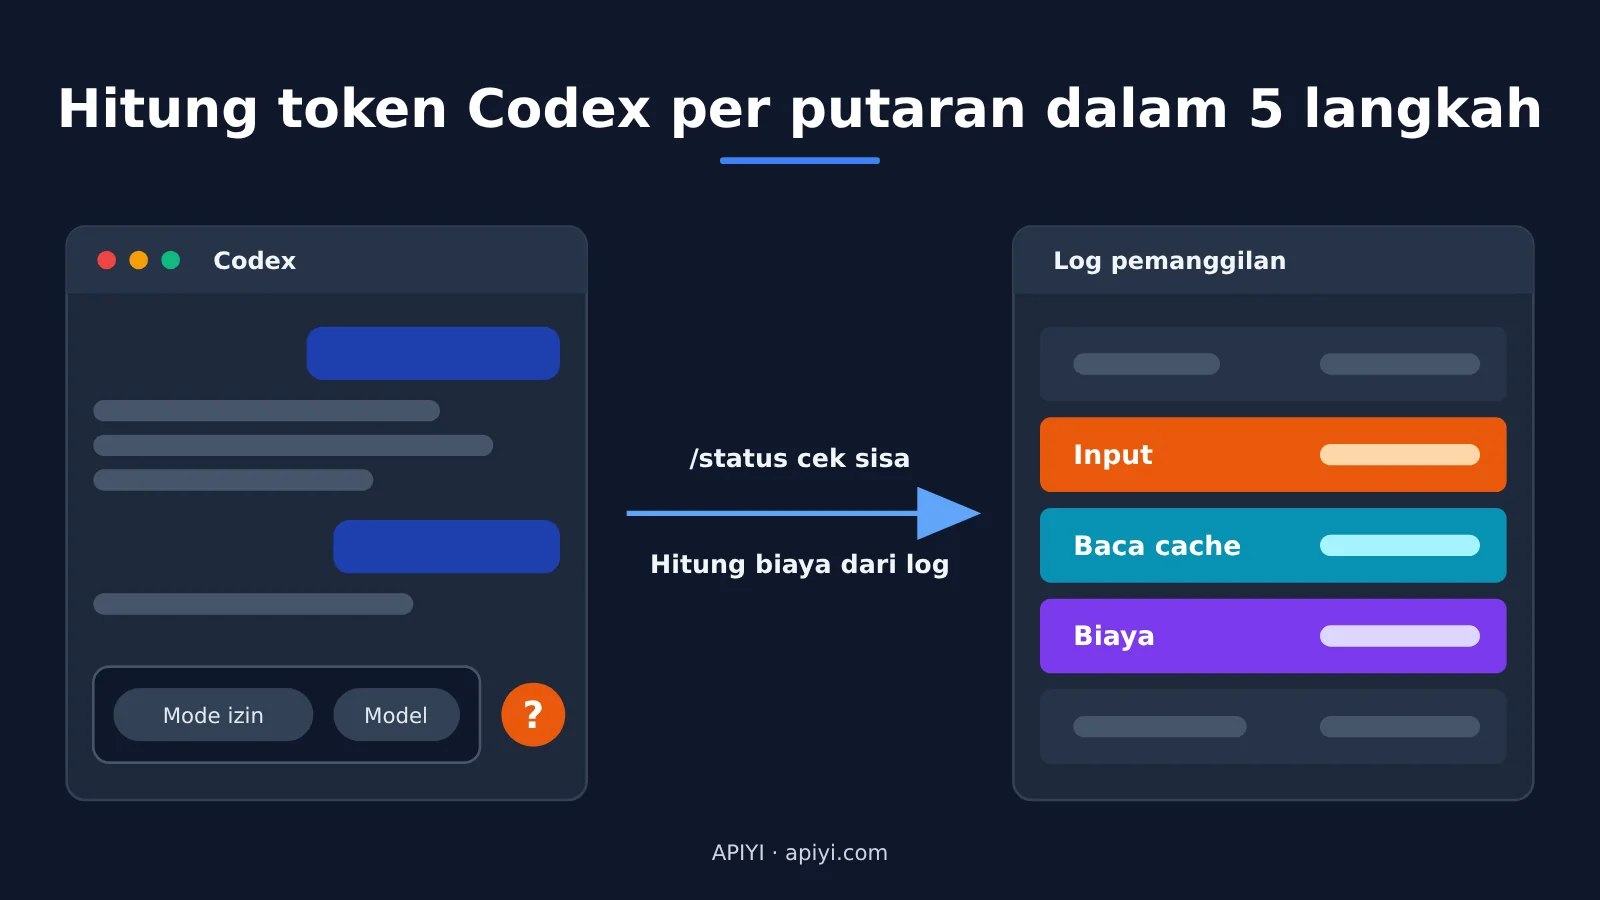
Kesimpulannya: Codex tetap menyediakan informasi penggunaan konteks, tetapi aksesnya ada di /status; data untuk menghitung biaya ada di log pemanggilan APIYI / apiyi.com. Artikel ini membahas cara melihat konsumsi token setiap putaran Codex melalui log pemanggilan APIYI dalam lima langkah: apa yang perlu dilihat, cara menjumlahkannya, serta kapan perlu mengompresi konteks atau memulai percakapan baru.
Ini bukan sekadar penjelasan konsep. Setiap langkah menjelaskan apa yang akan terlihat di antarmuka, bagian yang perlu diklik, dan kriteria untuk memastikan hasilnya benar.
Kenapa pemakaian token per giliran tidak terlihat di Codex?
Banyak orang mengira Codex telah menghapus tampilan konteks. Sebenarnya, informasi tersebut tersebar di tiga tempat, dan masing-masing menampilkan hal yang berbeda.
- Klien desktop / plugin IDE: Kolom input hanya menampilkan mode izin dan model. Ketik
/statusuntuk melihat chat ID, context usage (persentase konteks yang terpakai), dan rate limits (sisa batas penggunaan). - CLI:
/statusmenampilkan model saat ini, kebijakan persetujuan, direktori yang dapat ditulis, dan pemakaian token saat ini. Footer CLI sudah memiliki indikator konteks. Dengan/statusline, kamu bisa menambahkan context stats (statistik konteks) dan token counters (penghitung token) ke footer. Pilihan tersebut akan disimpan ditui.status_linedalamconfig.toml. codex exec --json: Saat dijalankan secara noninteraktif, Codex mengeluarkan satu baris peristiwa JSON setiap kali status berubah. Peristiwaturn.completedmenyertakanusagedengan lima field:input_tokens,cached_input_tokens,cache_write_input_tokens,output_tokens, danreasoning_output_tokens.
Selain itu, /usage hanya menampilkan aktivitas token di tingkat akun dan mengharuskan kamu login secara resmi. Jika menggunakan Key dari pihak ketiga, perintah ini tidak berlaku.
Perbandingan tiga cara melihat pemakaian token Codex
| Cara | Cakupan | Yang bisa dilihat | Yang tidak bisa dilihat |
|---|---|---|---|
| Log pemanggilan APIYI | Desktop, IDE, dan CLI | Input, output, pembacaan dan penulisan cache, serta biaya setiap permintaan | Isi percakapan; satu baris hanya mewakili satu permintaan, jadi kamu perlu menjumlahkan sendiri untuk setiap giliran |
Codex /status |
Antarmuka interaktif desktop dan CLI | Pemakaian konteks, sisa batas penggunaan, pemakaian token saat ini | Biaya |
codex exec --json |
Hanya eksekusi noninteraktif | Token input, pembacaan cache, penulisan cache, output, dan penalaran per giliran | Data TUI interaktif dan desktop |
Dari ketiga cara tersebut, hanya log yang menampilkan biaya. Syaratnya, kanal yang kamu gunakan harus menyediakan log dan rincian pemakaian. Langganan resmi tidak menyediakan rincian untuk setiap permintaan.
Langkah pertama: Tentukan cara menghitung konsumsi token Codex
Sebelum mulai menghitung, ingat satu hal: satu permintaan tidak sama dengan satu putaran percakapan.
Permintaan adalah satu kali pemanggilan model oleh Codex. Putaran adalah keseluruhan proses sejak kamu mengirim pesan sampai Codex selesai bekerja dan membalas. Dalam satu putaran, Codex membaca file, menjalankan perintah, dan mengubah kode. Setiap kali pemanggilan alat selesai, hasilnya dikirim kembali ke model bersama seluruh riwayat percakapan. Karena itu, satu putaran percakapan biasanya tercatat dalam beberapa baris log. Tugas yang kompleks bisa menghasilkan puluhan baris.
Perlu diketahui juga bahwa model tidak mengingat percakapan sebelumnya dengan sendirinya. Input pada putaran ke-N ≈ seluruh isi N-1 putaran sebelumnya + konten baru pada putaran ini. Inilah alasan utama percakapan panjang makin lama makin mahal.
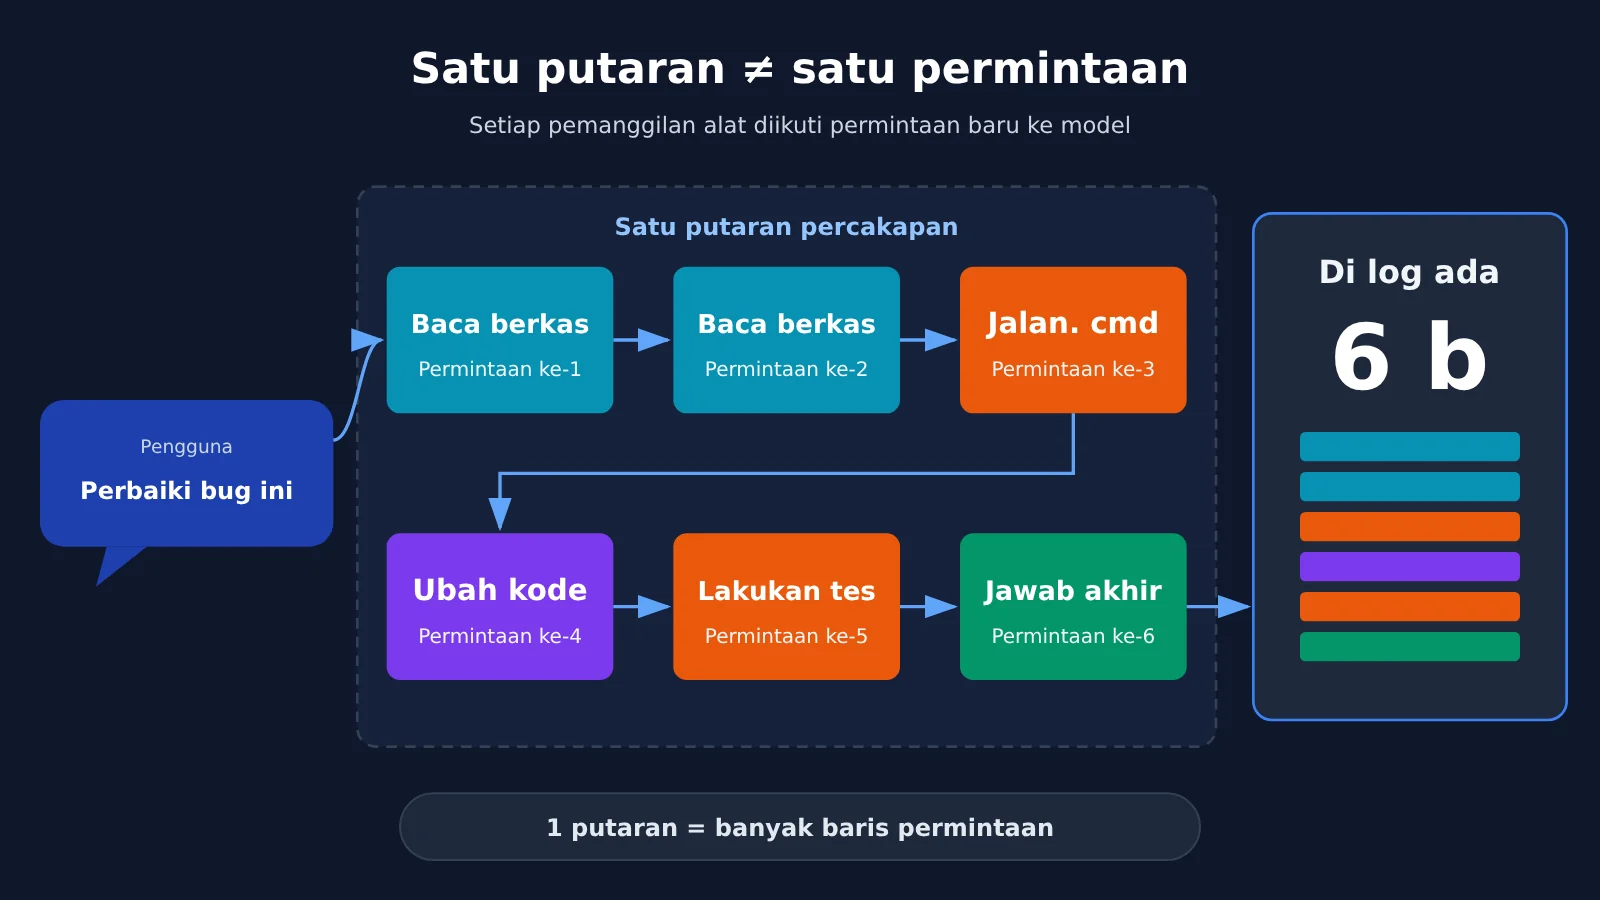
Kriteria keberhasilan: Saat melihat beberapa baris permintaan di log, kamu bisa mengenali bahwa semuanya termasuk dalam satu putaran, tanpa menghitung setiap baris sebagai satu putaran.
Langkah kedua: Buat token khusus untuk Codex
Agar statistiknya akurat, log yang difilter harus hanya berisi permintaan Codex. Jika Codex berbagi key dengan skrip atau alat lain, nantinya permintaan tidak bisa dipisahkan berdasarkan token.
- Buka halaman token di konsol APIYI, lalu klik 「Tambah Token」. Beri nama yang mudah dikenali, misalnya dengan menyertakan kata “codex”.
- Buka
config.tomlCodex, lalu tambahkan provider di bawahmodel_providersdenganbase_url = "https://api.apiyi.com/v1". Gunakanenv_keyuntuk menentukan variabel lingkungan yang menyimpan token tersebut. - Arahkan
model_providerke provider ini. Aplikasi desktop, IDE, dan CLI membaca konfigurasi yang sama, jadi cukup ubah sekali. - Gunakan key lain untuk semua alat lainnya. Jangan gunakan ulang token ini.
🎯 Saran teknis: Token khusus, penyaringan log berdasarkan token, dan ekspor adalah tiga fitur di konsol APIYI / apiyi.com yang bisa dimanfaatkan untuk statistik. Langganan resmi tidak menampilkan detail tiap permintaan, tetapi dengan token khusus, biaya Codex bisa dihitung secara terpisah.
Verifikasi: Di halaman log, klik 「Perluas」 untuk membuka filter lanjutan, lalu pilih key ini pada filter 「Token」. Daftar seharusnya hanya menampilkan permintaan dari Codex.
Langkah ketiga: Memahami setiap permintaan di log pemanggilan
Buka api.apiyi.com/log, atau pilih 「Log」 di menu sebelah kiri. Setiap baris dalam daftar mewakili satu permintaan API.
Secara default, filter di bagian atas bisa digunakan untuk memilih rentang waktu, jenis, model, dan status cache. Keterangan status cache menyebutkan “hit = membaca cache, miss = membuat cache”. Setelah mengeklik 「Perluas」, Anda juga bisa memfilter berdasarkan token, streaming, rentang petunjuk/completion, waktu byte pertama, dan kondisi lainnya.
Arti setiap kolom log
| Nama kolom | Apa yang ditampilkan | Cara memahaminya |
|---|---|---|
| Waktu | Waktu permintaan selesai | Default UTC+0, 8 jam lebih lambat dari waktu Beijing |
| Model | Misalnya gpt-5.6-terra | Cache tidak dibagikan antar-model |
| Informasi | Streaming/non-streaming, waktu byte pertama, token petunjuk/completion, jumlah biaya | Ringkasan permintaan dalam satu kolom |
| Petunjuk / Completion | Dua angka | Petunjuk = token input, completion = token output. Token penalaran biasanya dihitung sebagai completion |
| Biaya | Jumlah dalam dolar AS | Jumlah sebelum diskon, sudah termasuk pengali grup |
| Keterangan | Berbagai pengali, token penulisan cache, token pembacaan cache | Hit dan penulisan cache dicantumkan terpisah di sini, jadi tidak perlu menebak |
Untuk permintaan yang menggunakan cache, kolom 「Informasi」 menampilkan angka hit dan penulisan sekaligus. Baris tanpa detail cache hanya menampilkan kombinasi seperti “Non-streaming Byte pertama: N detik Petunjuk/Completion Jumlah biaya”. Model gambar dan video yang ditagih per permintaan juga menampilkan petunjuk dan completion, tetapi biayanya tidak dihitung berdasarkan token. Jangan gunakan perhitungan dalam artikel ini untuk model tersebut.
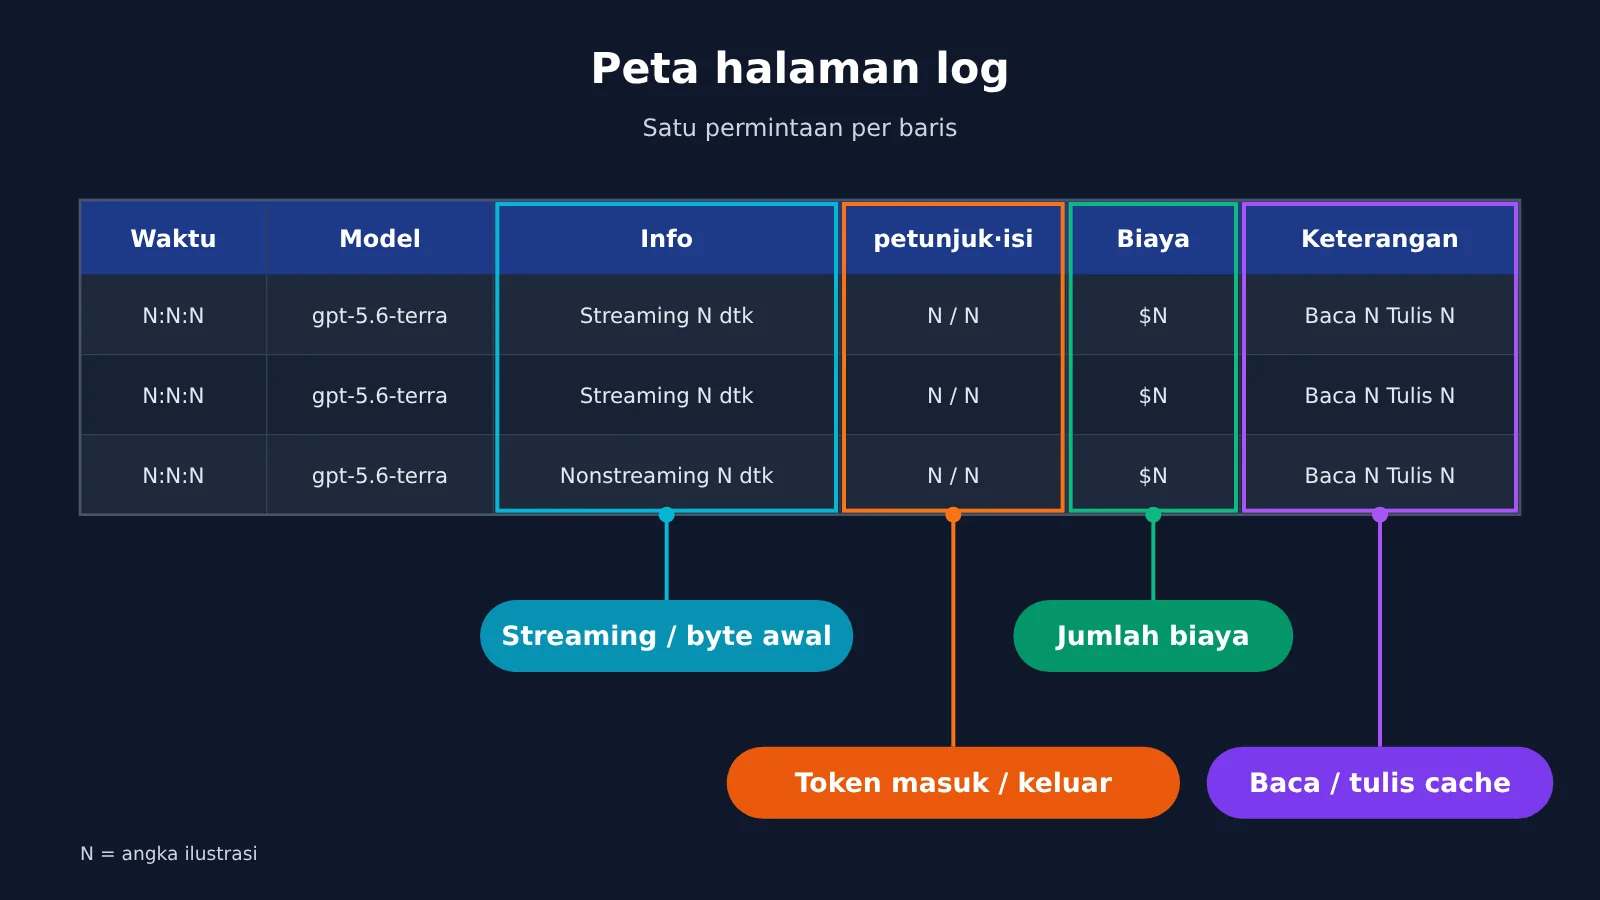
Verifikasi: Pilih sembarang baris dan pastikan Anda bisa menjelaskan jumlah input, output, hit cache, dan biaya permintaan tersebut.
Langkah keempat: Gabungkan beberapa baris log untuk menghitung konsumsi token per putaran Codex
Satu baris data hanya menunjukkan satu permintaan. Untuk melihat konsumsi satu putaran percakapan, kamu perlu menjumlahkannya.
Aturan penjumlahan: jumlahkan semua permintaan dengan token dan model yang sama dalam rentang sekitar 5 menit setelah kamu memberikan instruksi. Sesuaikan rentang waktunya dengan kebutuhan.
- Lihat langsung di halaman: Filter berdasarkan token, model, dan rentang waktu, lalu periksa prompt dan completion di setiap baris. Cocok untuk pemeriksaan sesekali.
- Ekspor dan hitung ulang: Klik「Ekspor」di kanan atas daftar, unduh Excel atau CSV, lalu kelompokkan dan jumlahkan berdasarkan waktu di spreadsheet.
- API kueri log: Panggil
GET /api/log/selfdengan token akses pribadi untuk autentikasi (diawalinap_; API Key yang diawalisk_akan menghasilkan 401). Gunakan parametertype=2(hanya konsumsi),token_name,start_timestamp, danend_timestamp(detik Unix). Perhatikan bahwa parameter paginasi menggunakan camelCase:pageSize. Jika ditulispage_size, parameter akan diabaikan tanpa pemberitahuan. - Konversi ke biaya: Nilai
quotayang dikembalikan API dibagi 500.000 menghasilkan jumlah dalam dolar AS. Fieldotherberupa string JSON yang perlu diurai lagi untuk mendapatkan detail sepertiusage.
Saat menggunakan API kueri, selalu sertakan rentang waktu. Sebaiknya jangan lebih dari 1 hari. Tanpa rentang waktu, API akan menelusuri seluruh riwayat dan akun dengan banyak data bisa mengalami timeout. Kueri log itu sendiri tidak mengonsumsi kuota.
Menghitung biaya satu putaran Codex berdasarkan harga
| Model | Input | Pembacaan cache | Output | Konteks | Contoh: total satu putaran |
|---|---|---|---|---|---|
| gpt-5.6-sol | $4 | $0.4 | $20 | 1,000,000 | sekitar $0.214 |
| gpt-5.6-terra | $2 | $0.2 | $12 | 1,000,000 | sekitar $0.107 |
| gpt-5.6-luna | $0.2 | $0.02 | $1.2 | 1,000,000 | sekitar $0.011 |
Semua harga berlaku per satu juta token dan diperiksa pada 2026-10-28. Jika input dalam satu permintaan melebihi 272.000 token, harga input menjadi dua kali lipat.
💰 Keterangan harga: Mengacu pada daftar model dan harga di platform APIYI / apiyi.com. Contoh dalam tabel dihitung berdasarkan total input 120.000 token per putaran, dengan 96.000 di antaranya terkena cache hit, serta output 4.000 token. Untuk sol: 24.000 token tanpa cache hit × $4 + 96.000 token cache hit × $0.4 + 4.000 token output × $20. Setelah dibagi satu juta, totalnya sekitar $0.214.
Angka-angka ini menunjukkan dua hal. Pertama, 96.000 token yang terkena cache hit hanya menghabiskan sekitar $0.038. Cache adalah kunci untuk menekan biaya percakapan panjang. Kedua, jika tugas yang sama dijalankan dengan luna, biayanya mendekati seperdua puluh biaya sol. Namun, halaman resmi luna menyebutkan bahwa performanya lebih lemah pada konteks yang sangat panjang, di atas 256K.
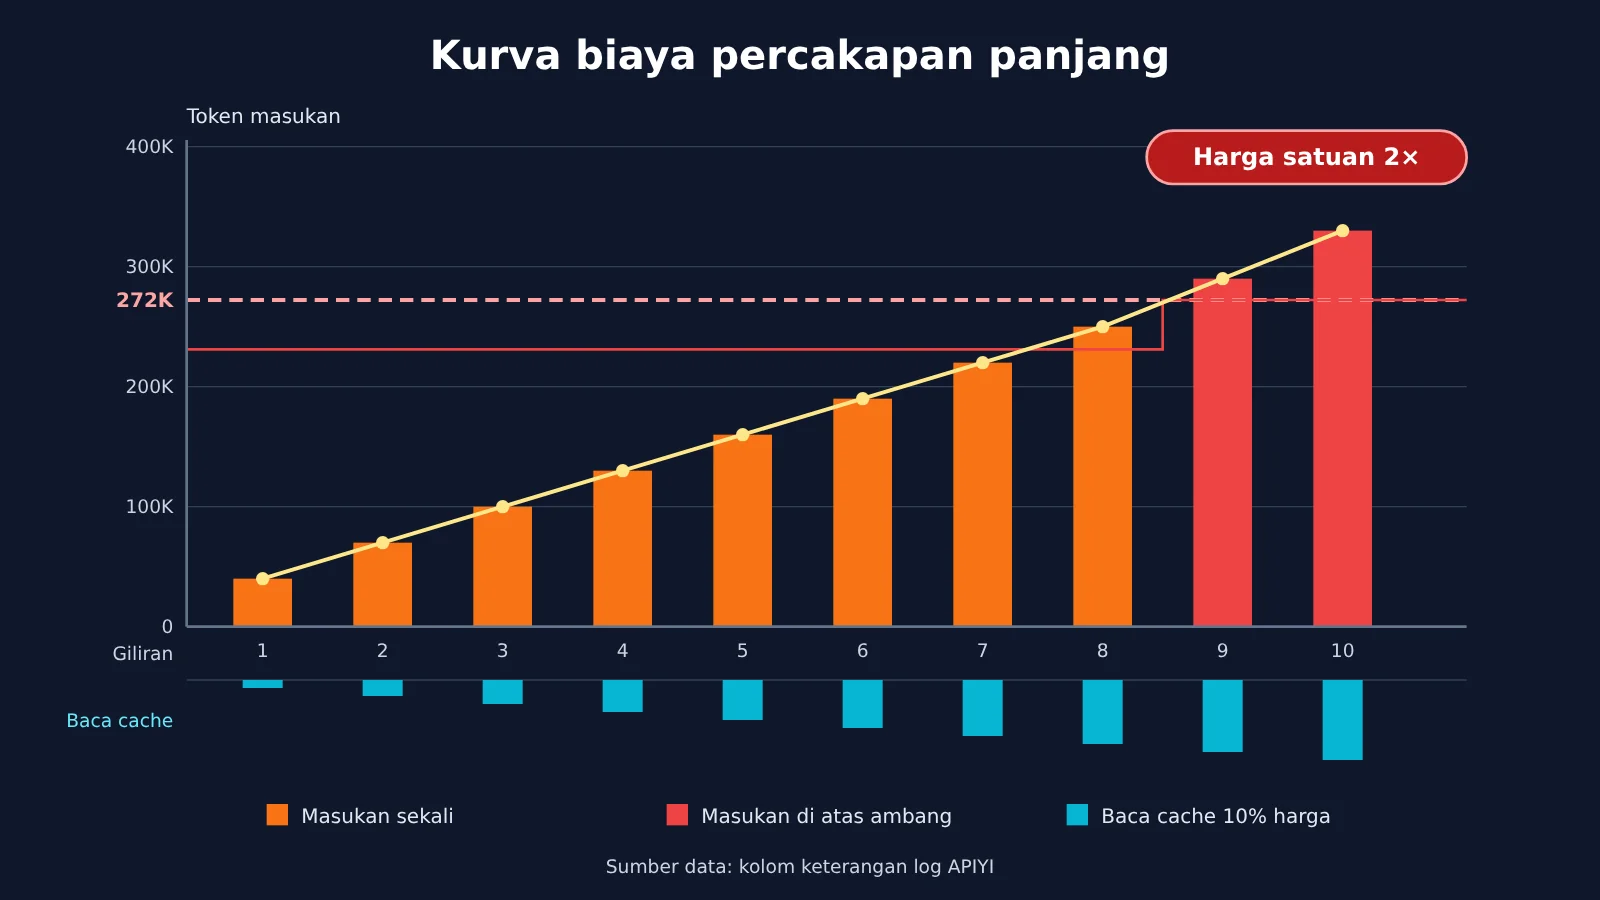
Pemeriksaan: Kamu bisa menghitung “berapa token input tambahan pada putaran ini dibandingkan putaran sebelumnya” dan menyebutkan berapa banyak token tambahan tersebut yang terkena cache hit.
Langkah kelima: Tentukan apakah perlu kompresi atau membuka sesi baru dengan data token Codex
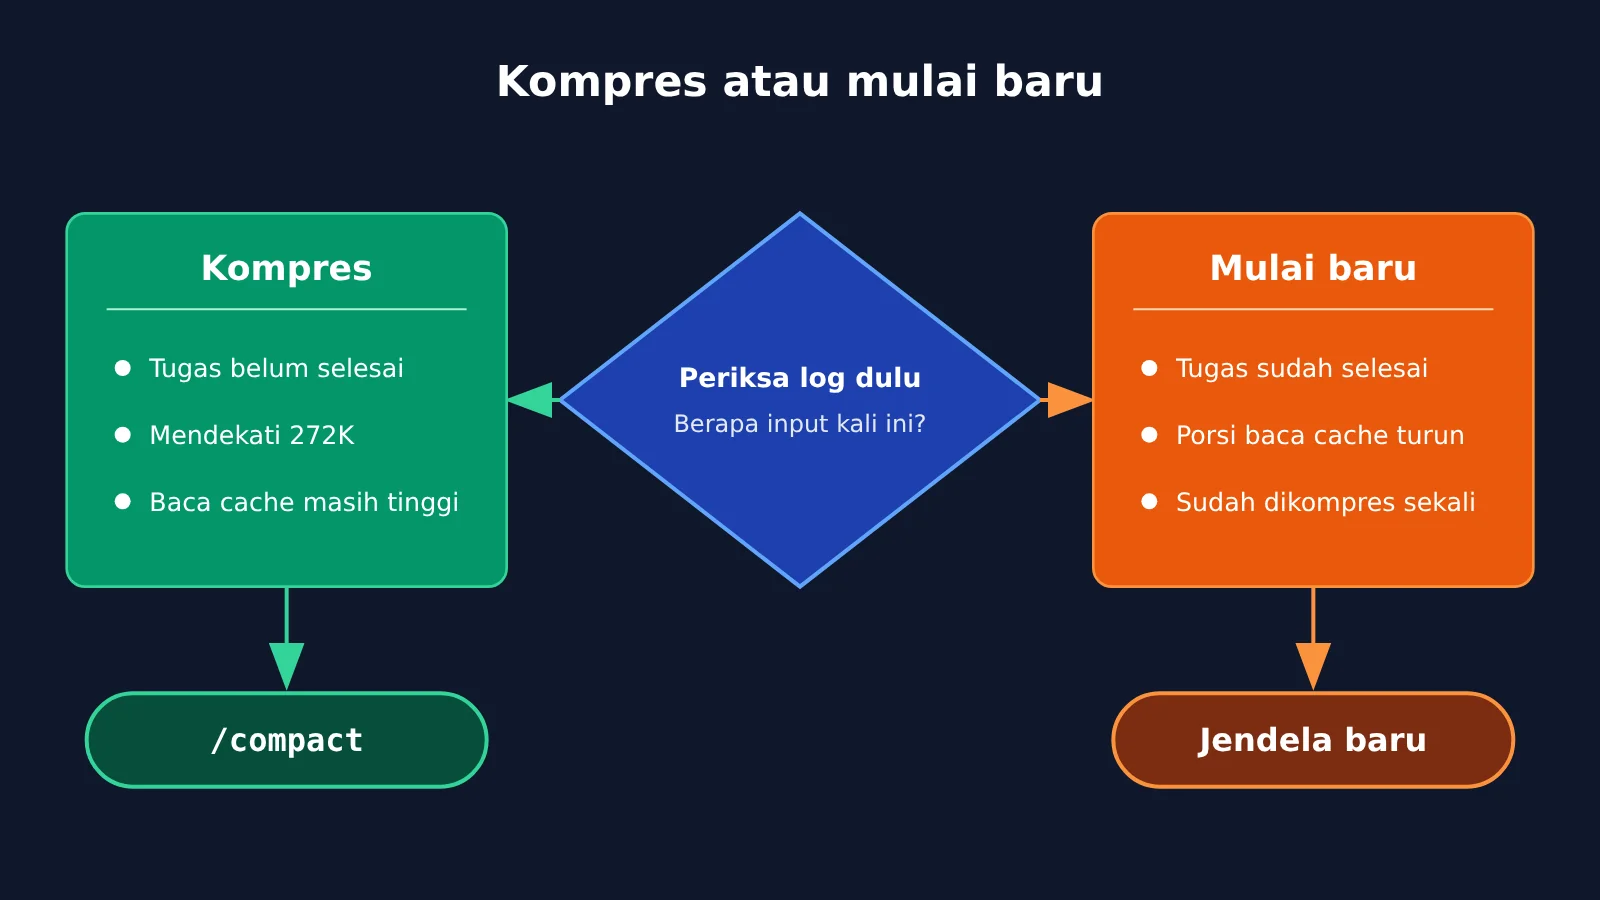
Dengan data setiap putaran, keputusan bisa dibuat berdasarkan angka. Perhatikan tiga sinyal utama:
- Pertumbuhan input: Jika input tambahan makin besar di setiap putaran, output alat dan riwayat percakapan menumpuk dengan cepat.
- Proporsi pembacaan cache: Jika proporsi pembacaan cache terhadap input di kolom keterangan turun drastis, berarti prefiks berubah dan sebagian besar input baru dikenai tarif penuh.
- Input per permintaan: Saat mendekati 272.000, permintaan berikutnya akan melewati ambang tarif.
Tabel keputusan: kompresi atau buka sesi baru
| Yang terlihat di log | Tindakan yang disarankan | Alasannya |
|---|---|---|
| Input per permintaan mendekati 272.000, tugas belum selesai | Jalankan /compact secara manual |
Menghindari tarif input dua kali lipat setelah melewati ambang |
| Input per permintaan mendekati 272.000, tugas sudah mencapai titik jeda | Buka sesi baru | Memulai ulang lebih bersih daripada melakukan kompresi |
| Proporsi pembacaan cache turun selama beberapa putaran berturut-turut | Buka sesi baru untuk topik baru | Cache sudah tidak berlaku; sebagian besar percakapan lanjutan dikenai tarif penuh |
| Penambahan input per putaran tiba-tiba membesar | Periksa output alat dan turunkan tool_output_token_limit jika perlu |
Output perintah yang panjang masuk ke riwayat |
| Input stabil dan proporsi pembacaan cache tinggi | Lanjutkan percakapan saat ini | Pada kondisi ini, percakapan panjang paling hemat biaya |
| Baru sekali dikompresi, tetapi sudah hampir penuh lagi | Buka sesi baru | Kompresi berulang membuat ringkasan makin kurang detail |
Cara mengonfigurasi kompresi konteks Codex
Kompresi mengganti putaran percakapan sebelumnya dengan ringkasan singkat untuk mengosongkan ruang di jendela konteks. Codex mendukung kompresi manual dan otomatis.
- Kompresi manual: Masukkan
/compactdi aplikasi desktop atau CLI. - Kompresi otomatis: Ambang batasnya diatur melalui
model_auto_compact_token_limit. Jika tidak diisi, nilai bawaan model akan digunakan. - Cakupan perhitungan ambang batas:
model_auto_compact_token_limit_scopedapat diatur ketotal(menghitung seluruh konteks aktif) ataubody_after_prefix(hanya menghitung bagian baru setelah prefiks yang disertakan). - Saat menggunakan base_url pihak ketiga: Jika nama model tidak ada dalam daftar bawaan Codex, sebaiknya isi
model_context_windowdan ambang kompresi otomatis secara manual. Untuk memicu kompresi sebelum melewati jenjang harga, tetapkan ambang di bawah 272.000. - Jangan sembarangan mengaktifkan
remote_compaction: Jika diatur kev2, penyedia upstream harus mendukung protokol kompresi di sisi Responses. Lebih aman membiarkannya sebagaiunsupporteddan menggunakan kompresi lokal.
Konsekuensi kompresi
Kompresi tidak gratis. Proses ini menulis ulang prefiks riwayat sehingga cache tidak lagi berlaku. Akibatnya, input pada permintaan setelah kompresi hampir seluruhnya dikenakan tarif penuh. Jadi, setelah kompresi selesai, sebaiknya langsung mulai topik baru dan jangan kembali mengulangi tugas lama. Kompresi juga bisa menghilangkan detail karena ringkasan tidak menjamin semua informasi tetap tersimpan.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Permintaan saya tidak ada di log. Apakah ada yang terlewat?
Log hanya mencatat pemanggilan yang berhasil ditagih. Permintaan yang gagal pada tahap jaringan, autentikasi, validasi parameter, dan sejenisnya tidak sampai ke penyedia layanan, tidak dikenai biaya, dan tidak muncul di log. Sebaliknya, jika ada catatan di log, berarti permintaan tersebut memang menghasilkan pemakaian. Periksa juga apakah filter token dan rentang waktunya sudah tepat.
Q2: Mengapa biayanya lebih rendah daripada perkiraan saya berdasarkan token?
Penyebab paling umum adalah cache. Kanal OpenAI menggunakan cache prefix otomatis. Cache akan aktif jika prefix stabil dan panjangnya minimal 1024 token. Bagian yang terkena cache ditagih sebesar 10% dari harga input. Di kolom keterangan pada log APIYI / apiyi.com, Anda bisa melihat jumlah token yang dibaca dari cache. Selain itu, log menampilkan jumlah sebelum diskon. Biaya sebenarnya ≈ jumlah di log ÷ (1 + rasio bonus).
Q3: Mengapa waktu di log tidak sesuai dengan waktu saya melakukan permintaan?
Secara default, log ditampilkan dalam UTC+0, sedangkan waktu Beijing adalah UTC+8. Selisihnya 8 jam. Jika Anda memfilter “sesi pukul tiga sore” berdasarkan waktu Beijing, sebagian data bisa terlihat seolah-olah hilang. Konversikan waktunya terlebih dahulu sebelum memfilter.
Q4: Berapa lama log disimpan?
Sebagai patokan, anggap log dapat diakses selama sekitar 30 hari terakhir. Masa penyimpanan sebenarnya mungkin lebih lama, tetapi platform tidak menjaminnya dan kebijakan pembersihan juga bisa berubah. Jika membutuhkan data untuk rekonsiliasi jangka panjang, simpan sendiri secara berkala menggunakan fitur “Ekspor” atau API kueri log.
Q5: Apakah log menunjukkan file yang dibaca Codex dan konten yang dikirimnya?
Tidak. Log hanya menyimpan informasi dasar yang diperlukan untuk penagihan, seperti jumlah token, biaya, dan pengali. Konten input dan output tidak dicatat. Untuk mengetahui apa yang dilakukan dalam satu sesi, periksa langsung percakapan Codex tersebut.
Q6: Adakah cara yang lebih praktis untuk mencatat pemakaian setiap sesi secara otomatis?
Jika menjalankannya melalui skrip, Anda bisa menggunakan `codex exec –json` dan membaca data usage dalam peristiwa `turn.completed`. Untuk penggunaan interaktif, Anda bisa memakai API kueri log untuk mengambil dan menggabungkan data secara berkala berdasarkan token khusus dan rentang waktu. Pengguna baru bisa mengambil kuota uji coba gratis di APIYI / apiyi.com untuk mencoba seluruh alurnya.
Poin Penting Konsumsi Token Codex per Putaran
- Fiturnya masih ada: Pemakaian konteks bisa dilihat lewat
/status. Di CLI, gunakan/statuslineuntuk menampilkannya di bagian bawah layar. - Permintaan ≠ putaran: Satu putaran percakapan mencakup beberapa pemanggilan alat dan muncul sebagai beberapa baris di log. Jumlahkan semuanya berdasarkan rentang waktu.
- Token khusus: Buat satu kunci khusus untuk Codex agar log-nya mudah difilter.
- Perhatikan kolom keterangan: Pembacaan dan penulisan cache dicantumkan terpisah. Bagian yang terkena cache dikenai 10% dari harga.
- Ambang 272K: Jika input satu permintaan melebihi 272.000 token, harga input menjadi dua kali lipat.
- Kompresi ada biayanya: Setelah kompresi, cache tidak lagi berlaku sehingga hampir seluruh input pada permintaan tersebut dikenai harga penuh. Setelah kompresi, cocok untuk langsung berganti topik.
Kesimpulan
Jika pemakaian konteks tidak terlihat di Codex, bukan berarti fiturnya dihapus—lokasinya saja yang berubah. /status menunjukkan sisa konteks, sedangkan log pemanggilan menunjukkan biaya setiap putaran. Dengan menggabungkan keduanya, kamu bisa memutuskan apakah perlu membuka jendela baru berdasarkan angka.
Kamu bisa langsung mencobanya hari ini: buat token khusus untuk Codex, lalu buka halaman log APIYI / apiyi.com. Pilih putaran percakapan terbaru dan jumlahkan beberapa baris permintaannya.
📚 Referensi
- Repositori resmi OpenAI Codex: Kode sumber CLI dan definisi event
- Tautan:
github.com/openai/codex -
Keterangan: Field usage untuk
turn.completeddidefinisikan dicodex-rs/exec/src/exec_events.rs -
Dokumentasi resmi Codex: Referensi perintah slash dan konfigurasi
- Tautan:
developers.openai.com/codex -
Keterangan: Penjelasan tentang
/status,/compact,/statusline, dan konfigurasi terkait kompresi -
Dokumentasi bantuan APIYI: Log pemanggilan, biaya cache, dan API untuk kueri log
- Tautan:
docs.apiyi.com - Keterangan: Definisi field log, aturan biaya cache sebesar 10% dari tarif normal, dan metode konversi
quota
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs resmi APIYI. Penjelasan konfigurasi lainnya tersedia di pusat dokumentasi.