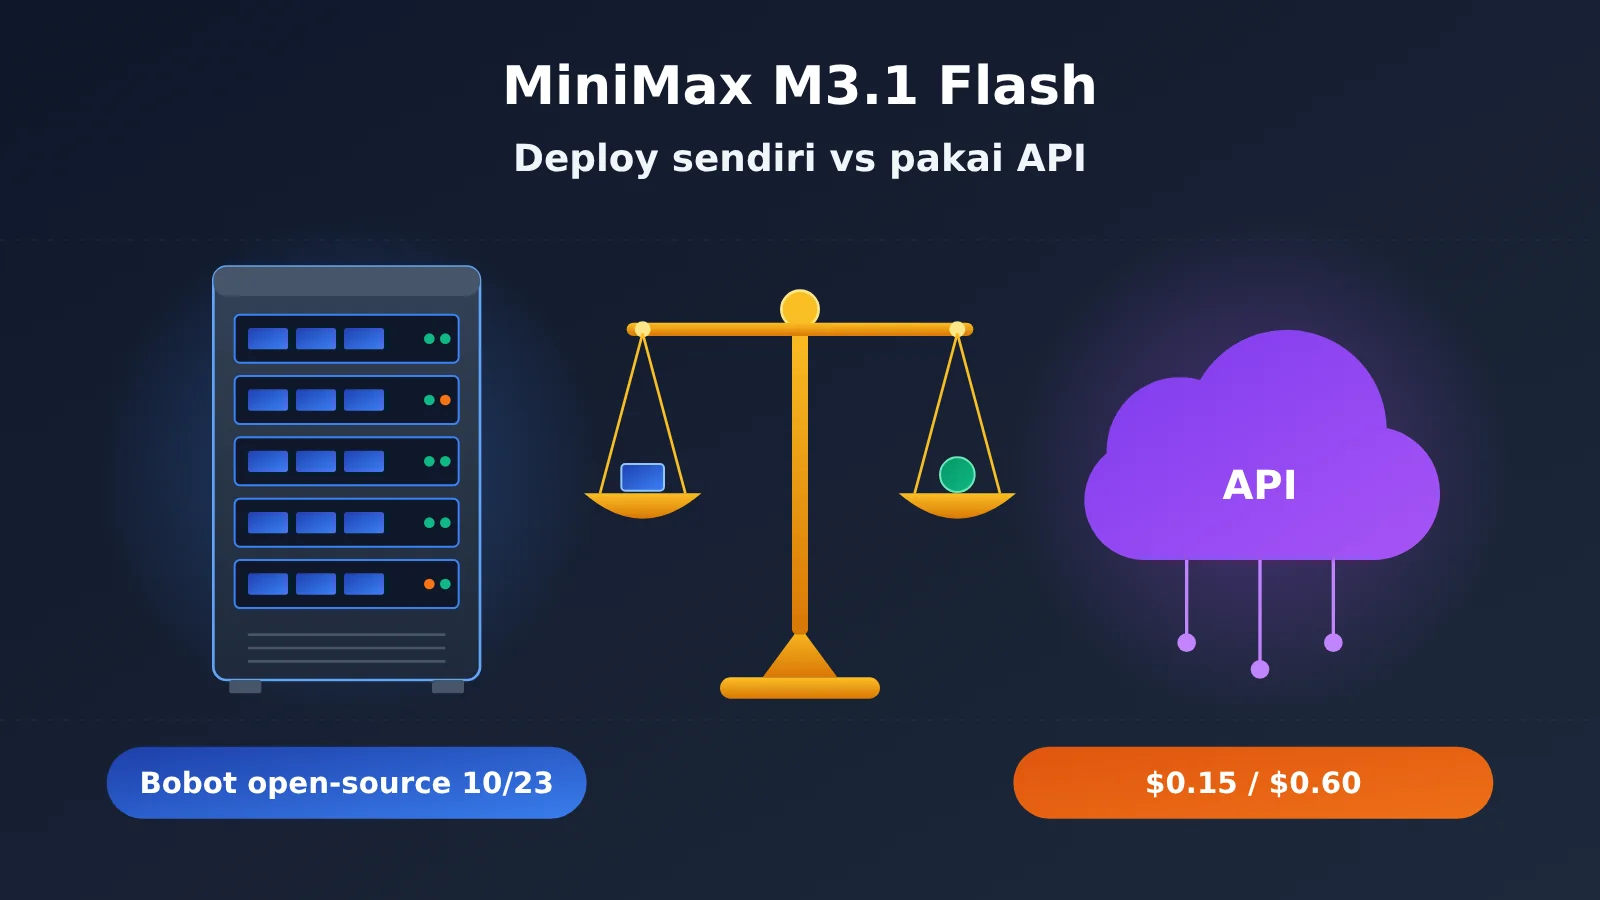
Catatan penulis: Bobot MiniMax M3.1 Flash direncanakan dirilis pada 23 Oktober. Artikel ini menjelaskan spesifikasi perangkat keras yang kira-kira dibutuhkan untuk menjalankannya secara lokal, serta membandingkan mana yang lebih hemat dari 4 aspek: “deploy sendiri” atau “langsung menggunakan API”.
Kesimpulannya: bagi sebagian besar developer individu dan tim kecil, API dengan biaya $0.15 per satu juta token input dan $0.60 per satu juta token output jauh lebih hemat dan praktis daripada deploy sendiri. Hanya ada tiga situasi yang membuat deploy sendiri layak dipertimbangkan: data tidak boleh keluar dari jaringan internal sesuai aturan, volume pemanggilan cukup besar untuk membuat server multi-GPU terus bekerja dengan kapasitas penuh, atau Anda perlu mengubah maupun melakukan fine-tuning pada model itu sendiri.
Artikel ini bukan untuk menyurutkan minat terhadap model open source. Bobot open source bermanfaat bagi industri, tetapi “bisa diunduh” dan “layak dijalankan sendiri” adalah dua hal berbeda. Situs ini sudah menerbitkan artikel tersendiri tentang berita peluncuran M3.1 Flash. Jadi, artikel ini hanya menjawab dua pertanyaan: konfigurasi seperti apa yang dibutuhkan untuk menjalankannya secara lokal, dan mana yang lebih hemat—deploy sendiri atau menggunakan API.
Manfaat utama: Setelah membaca artikel ini, Anda bisa menentukan apakah perlu menunggu bobot model ini dirilis dan informasi apa yang perlu dipastikan terlebih dahulu.
Status bobot terbuka MiniMax M3.1 Flash: mana yang sudah pasti dan mana yang belum diumumkan
Mari mulai dengan menjelaskan satu istilah. Bobot terbuka berarti file parameter model yang sudah dilatih dirilis secara publik, sehingga Anda bisa mengunduh dan menjalankannya di server sendiri. Ini berbeda dari “kode sumber terbuka” dan bukan berarti model bebas digunakan untuk keperluan komersial. Penggunaannya tetap bergantung pada lisensi.
Hingga artikel ini ditulis (22 Oktober 2026), bobot M3.1 Flash belum dirilis secara resmi. Dalam unggahan X, MiniMax menyebutkan, “Model weights will arrive on Oct 23”, yang berarti bobotnya direncanakan rilis pada 23 Oktober. Blog resmi hanya menyebutkan “akan dirilis nanti”. Menurut laporan RITS dari New York University Shanghai, per 20 Oktober belum ada repositori M3.1 Flash di organisasi MiniMax di Hugging Face.
Untuk membedakan tingkat keandalan informasi, artikel ini membagi fakta ke dalam tiga kategori: keterangan resmi (diumumkan langsung oleh MiniMax), evaluasi pihak ketiga (seperti Vals AI), dan belum diketahui/belum diumumkan.
| Informasi | Status | Kategori informasi |
|---|---|---|
| Waktu rilis bobot | Unggahan resmi di X menyebutkan 23 Oktober; blog resmi hanya menyebutkan “nanti” | Keterangan resmi (rencana, belum terealisasi) |
| Ukuran model | Arsitektur MoE, total 428B parameter dan sekitar 23B parameter aktif, sama dengan M3 | Informasi resmi, diberitakan media |
| Lisensi | Lisensi M3.1 Flash belum diumumkan | Belum diketahui/belum diumumkan |
| Persyaratan perangkat keras untuk deployment | Panduan deployment resmi belum mencantumkan M3.1 Flash | Belum diketahui/belum diumumkan |
| Laporan teknis | Belum ada penjelasan tentang perubahan Flash dibandingkan M3 | Belum diketahui/belum diumumkan |
| Model pembanding M3 | Bobotnya sudah tersedia di Hugging Face sejak Juni, dengan lisensi komunitas | Informasi resmi |
⚠️ Catatan: Setelah bobot dirilis, jadikan halaman model resmi MiniMax di Hugging Face sebagai acuan untuk ketentuan lisensi, ukuran file, dan rekomendasi perangkat keras. Versi kuantisasi yang dibagikan ulang oleh komunitas tidak termasuk dalam cakupan verifikasi resmi, jadi jangan menganggapnya sebagai konfigurasi resmi.
Konfigurasi untuk Deployment Lokal MiniMax M3.1 Flash
Pihak resmi belum mengumumkan kebutuhan perangkat keras M3.1 Flash, jadi di sini kami tidak akan berspekulasi tentang kebutuhan VRAM atau jumlah GPU. Sebagai acuan, kita bisa melihat M3 generasi sebelumnya dengan skala yang sama. Keduanya memiliki total parameter yang sama, yaitu 428B, dan parameter aktif sekitar 23B. Karena itu, M3 bisa digunakan untuk memperkirakan kebutuhan secara kasar.
Memahami “428B total parameter, 23B parameter aktif” pada MiniMax M3.1 Flash
MoE (Mixture of Experts) adalah struktur model yang terdiri atas banyak sub-jaringan “pakar”. Dalam setiap proses inferensi, hanya sebagian pakar yang dipanggil. “Sekitar 23B parameter aktif” berarti jumlah parameter yang benar-benar terlibat dalam komputasi untuk menghasilkan setiap token. Karena itu, model bisa berjalan cukup cepat.
Namun, ada hal yang mudah disalahpahami: jumlah parameter aktif yang sedikit bukan berarti kebutuhan VRAM-nya juga kecil. Semua 428B parameter harus dimuat ke VRAM (memori khusus pada GPU) agar pakar mana pun bisa dipanggil kapan saja selama inferensi. Inilah salah satu alasan utama deployment lokal Model Bahasa Besar MoE membutuhkan perangkat keras yang mumpuni.
Referensi deployment M3 dari MiniMax (hanya sebagai gambaran skala)
Berikut penjelasan beberapa istilah. MXFP8 adalah format penyimpanan 8-bit yang dapat mengurangi ukuran file model dan penggunaan VRAM. SGLang adalah framework inferensi sumber terbuka yang dapat menjalankan model sebagai layanan API yang kompatibel dengan format OpenAI. TP (Tensor Parallelism) adalah metode untuk membagi model ke beberapa GPU agar dapat berjalan bersama.
| Model | Konfigurasi referensi resmi | Ukuran bobot | Status |
|---|---|---|---|
| MiniMax-M3 | 8 × B200, presisi MXFP8, antarmuka OpenAI yang kompatibel melalui SGLang | Versi MXFP8 sekitar 440 GB | Eksperimental |
| MiniMax-M2.7 | 4 GPU NVIDIA dengan VRAM besar, TP 4 | Batas minimum VRAM yang seragam belum diumumkan | Pratinjau |
| MiniMax-M3.1 Flash | Belum tercakup dalam panduan deployment resmi | Belum diumumkan | Belum diketahui/belum diumumkan |
Perlu ditekankan lagi: data M3 pada tabel di atas bukan persyaratan resmi untuk M3.1 Flash. Data tersebut menunjukkan bahwa skema referensi resmi untuk model dengan skala yang sama membutuhkan 8 GPU kelas pusat data, sementara bobot MXFP8 saja berukuran sekitar 440 GB. Kebutuhan ini jauh melampaui kemampuan GPU konsumen dan workstation biasa. Menjalankan versi lengkapnya di rumah dengan satu atau dua GPU gaming bukanlah pilihan yang realistis.
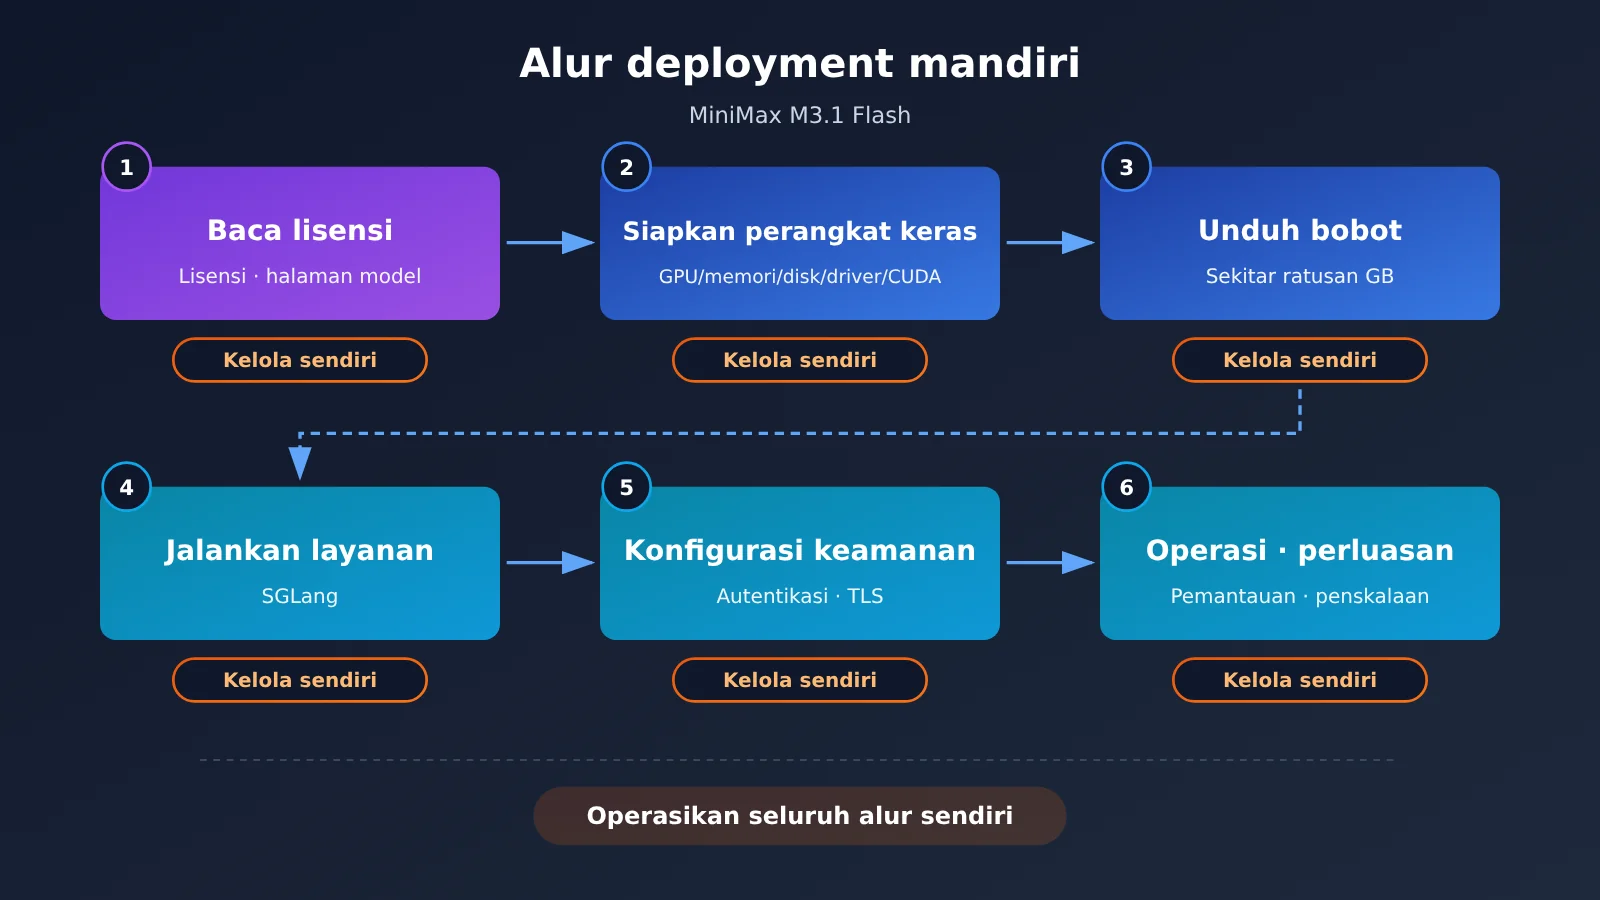
Dokumentasi deployment resmi MiniMax juga memberikan beberapa saran sebelum deployment yang berlaku untuk semua model sumber terbuka:
- Baca lisensi dan cakupan kemampuan terlebih dahulu untuk memastikan penggunaanmu diizinkan;
- Siapkan perangkat keras sesuai halaman model, termasuk GPU, memori, penyimpanan, driver, dan versi CUDA;
- Tetapkan versi yang digunakan dengan mengunci versi model dan framework inferensi. Jangan mengikuti perubahan pada cabang main/latest;
- Untuk mirror domestik, gunakan hanya sumber resmi yang tercantum di halaman model agar terhindar dari file yang telah dimodifikasi.
Lebih Hemat Mana: Men-deploy MiniMax M3.1 Flash Sendiri atau Menggunakan API?
Inilah pertanyaan utama artikel ini. Kita akan membandingkannya berdasarkan empat aspek. Cocokkan saja dengan kondisi Anda.
| Aspek pertimbangan | Lebih cocok menggunakan API | Lebih cocok men-deploy sendiri |
|---|---|---|
| Persyaratan kepatuhan data | Data boleh diproses oleh penyedia layanan cloud | Peraturan atau kontrak mengharuskan data tetap berada di jaringan internal |
| Volume penggunaan | Skala kecil hingga menengah, dengan lonjakan dan penurunan yang cukup besar | Skala besar dalam jangka panjang, sehingga server dengan banyak GPU bisa terus digunakan secara optimal |
| Kemampuan operasional tim | Tidak ada staf khusus yang menangani operasional GPU | Ada staf yang bertanggung jawab atas klaster, pemantauan, dan piket |
| Perlu mengubah model atau tidak | Kemampuan umum sudah mencukupi | Perlu melakukan fine-tuning, mengubah struktur, atau menyesuaikan model secara mendalam |
Jika dua dari tiga aspek pertama lebih cocok dengan kolom sebelah kiri, menggunakan API biasanya merupakan pilihan yang tepat.
Cara Menghitung Biaya API MiniMax M3.1 Flash
Harga resminya tetap: input $0.15, output $0.60, dan pembacaan cache $0.015 per satu juta token. Tidak ada biaya tambahan untuk konteks panjang. Token adalah satuan teks yang digunakan model untuk menghitung biaya. Menurut perkiraan resmi, sekitar 750 kata dalam bahasa Inggris setara dengan 1.000 token. Pembacaan cache berarti konten awalan yang sama dan dikirim berulang kali dikenai tarif lebih rendah.
Berikut contoh perhitungan berdasarkan harga resmi—bukan hasil pengukuran langsung: jika dalam sebulan Anda menggunakan 100 juta token input dan 20 juta token output, biayanya adalah 100 × $0.15 + 20 × $0.60 = $27. Ini sudah termasuk pemakaian yang cukup besar untuk individu atau tim kecil, dengan biaya puluhan dolar per bulan.
Perhitungan biaya untuk menjalankan model sendiri berbeda. Jika mengacu pada konfigurasi M3 dengan 8 × B200, mesin seperti ini membutuhkan biaya tetap yang terus berjalan, baik dibeli maupun disewa. Biaya tetap muncul bahkan saat tidak ada yang menggunakannya. Agar biaya ini sepadan, volume pemanggilan biasanya harus cukup besar untuk menjaga mesin tetap beroperasi dengan beban tinggi—sesuatu yang sulit dicapai kebanyakan individu dan tim kecil.
Ada satu hal yang perlu diperhatikan: proses berpikir MiniMax M3.1 Flash tidak bisa dinonaktifkan. Jika parameter effort (kedalaman berpikir) tidak disertakan, pengaturan default-nya adalah max. Konten proses berpikir juga dihitung sebagai token output. Karena itu, biaya output pada tagihan sebenarnya bisa lebih tinggi dari perkiraan. Untuk menghemat biaya, atur effort ke low atau medium.
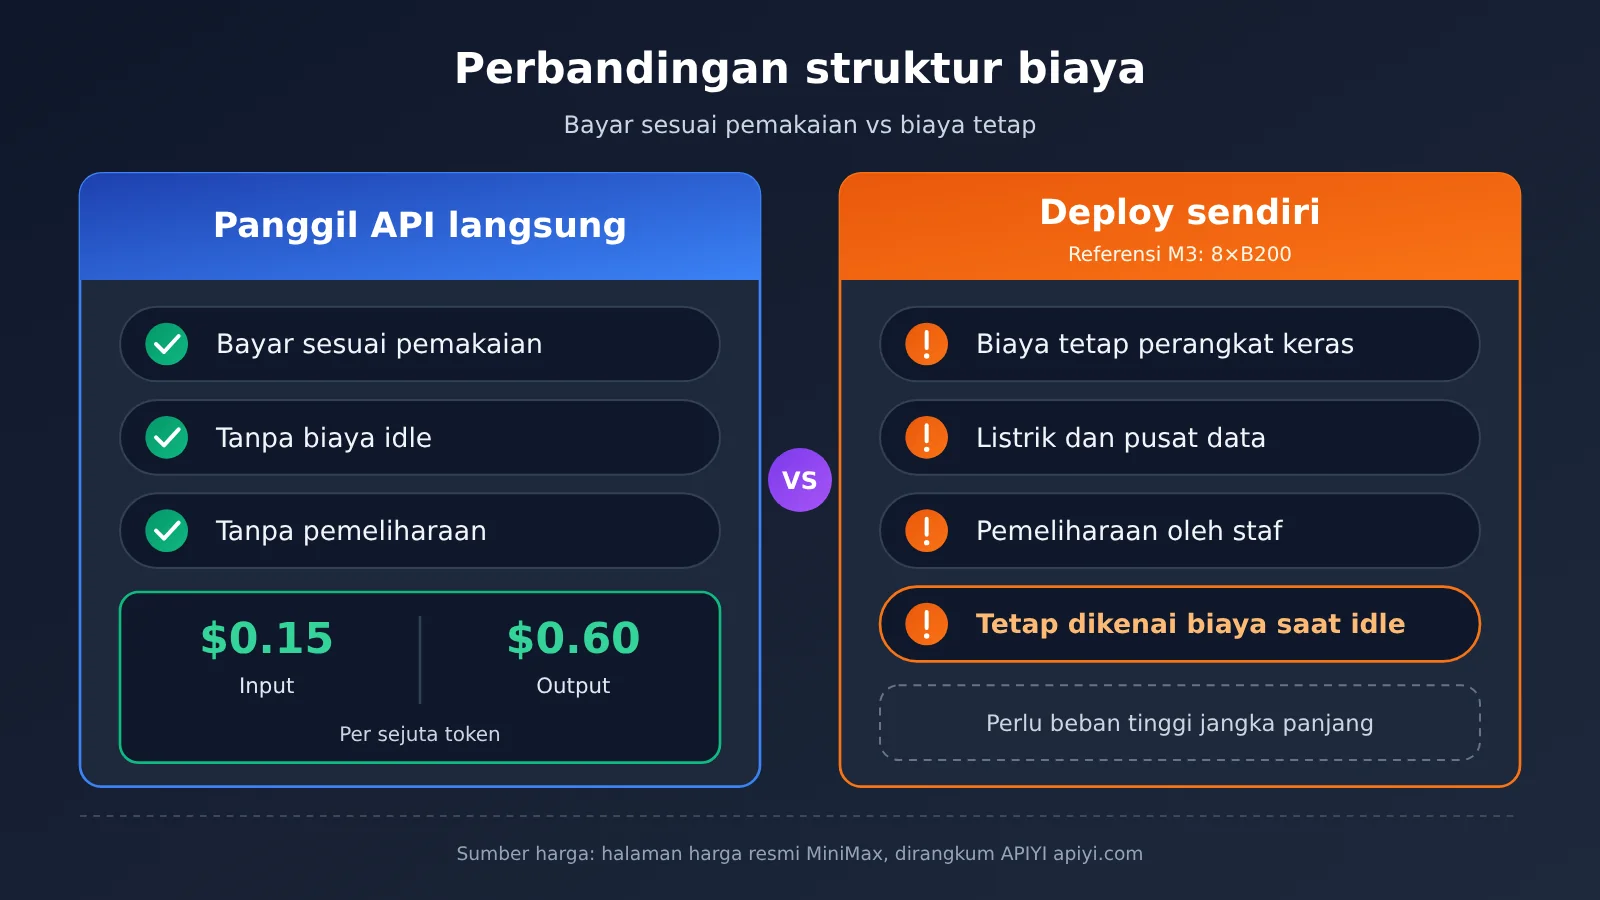
Harga pada gambar di atas bersumber dari halaman harga resmi MiniMax dan dirangkum oleh tim teknis APIYI apiyi.com. Tabel berikut mencantumkan harga resmi beberapa model yang sering dibandingkan:
| Model | Harga input (per satu juta token) | Harga output (per satu juta token) | Platform yang tersedia |
|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | API resmi MiniMax, M Plan; ketersediaan melalui APIYI mengikuti informasi di halaman harga |
| MiniMax-M3 (input ≤512K) | $0.30 | $1.20 | API resmi MiniMax, APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | Resmi dari Anthropic, APIYI apiyi.com |
| claude-opus-5 | $5 | $25 | Resmi dari Anthropic, APIYI apiyi.com |
💰 Saran untuk menghemat biaya: Jika ingin mencoba kemampuan seri MiniMax sekarang, Anda bisa menggunakan MiniMax-M3 yang sudah tersedia melalui APIYI apiyi.com untuk menjalankan alur kerja terlebih dahulu. Ketersediaan M3.1 Flash melalui APIYI mengikuti informasi di halaman harga. Kami juga akan segera menambahkannya.
Hal-hal yang perlu ditangani sendiri setelah men-deploy MiniMax M3.1 Flash
Dokumentasi resmi MiniMax menjelaskan dengan tegas: bobot model open source tidak mencakup fitur platform seperti caching dan keamanan konten. Secara default, layanan hanya menerima koneksi dari mesin lokal. Sebelum memutuskan untuk men-deploy sendiri, pastikan ada orang yang bertanggung jawab atas hal-hal berikut:
- Autentikasi: tambahkan kunci akses ke antarmuka agar orang lain tidak bisa menggunakannya sembarangan;
- Enkripsi TLS: gunakan HTTPS untuk mengenkripsi transmisi saat layanan dibuka ke jaringan luar, sehingga data tidak mudah disadap;
- Isolasi jaringan: batasi mesin dan subnet mana saja yang dapat mengakses layanan inferensi;
- Pemantauan dan peringatan: pastikan ada yang memantau utilisasi GPU, memori GPU, latensi, dan tingkat kesalahan;
- Perencanaan kapasitas dan penskalaan: siapkan rencana penskalaan sebelum antrean permintaan menumpuk pada jam sibuk;
- Pemulihan gangguan dan pembaruan: tentukan cara memulihkan layanan jika mesin mati dan cara menerapkan versi baru secara bertahap;
- Keamanan konten: Anda perlu menambahkan sendiri moderasi untuk konten masukan dan keluaran;
- Kepatuhan lisensi: baca seluruh lisensi dan kebijakan penggunaan sebelum men-deploy, mendistribusikan ulang, atau menggunakannya secara komersial.
Jika tidak ada yang bertanggung jawab atas salah satu hal dalam daftar ini, biaya operasional bisa menghapus penghematan biaya token dari deploy mandiri.
Cara menilai kemampuan MiniMax M3.1 Flash: klaim resmi vs evaluasi pihak ketiga
Sebelum memutuskan apakah akan men-deploy model ini sendiri, pahami dulu kemampuan sebenarnya. Tabel berikut merangkum data berdasarkan sumber informasinya:
| Metrik | Data | Tingkat informasi |
|---|---|---|
| Automation-Bench v1.0.6 | 62,2, sementara Claude Opus 5 mendapat 50,3 | Klaim resmi |
| BankerToolBench | 76,2, setara dengan Claude Opus 5 | Klaim resmi |
| Terminal Bench 4.0 | 38,1, sementara Claude Opus 5 mendapat 51,8 | Klaim resmi |
| SWE Refactor Bench | 23,0, sementara Claude Opus 5 mendapat 31,0 | Klaim resmi |
| Kecepatan inferensi | Blog menyebut kecepatan harian 200+ TPS dan P50 170+; halaman produk mencantumkan sekitar 150 token/detik | Klaim resmi (angka tidak konsisten) |
| Vals Index | 53,78%, peringkat ke-15 dari 22 model, dan ke-5 di antara model dengan bobot terbuka | Evaluasi pihak ketiga |
| Vals Terminal-Bench 4.0 | 25,25%, peringkat ke-22 dari 51 model | Evaluasi pihak ketiga |
| “Biaya 1/3 dari M3” | Dihitung berdasarkan tugas, tetapi metode perhitungannya tidak dipublikasikan | Tidak diketahui/tidak dipublikasikan |
TPS adalah jumlah token yang dihasilkan per detik. Semakin tinggi angkanya, semakin cepat model memberikan jawaban.
Perbandingan dengan Claude perlu diperjelas: model yang dijadikan pembanding dalam tabel resmi MiniMax adalah Claude Opus 5, bukan Opus 5.5. Claude Opus 5.5 masih menjadi model unggulan Anthropic yang paling mumpuni saat ini. MiniMax tidak membandingkan M3.1 Flash dengannya secara langsung di setiap metrik, jadi tidak tepat menyimpulkan bahwa M3.1 Flash “menyamai atau melampaui Opus 5.5”.
Bahkan jika hanya dibandingkan dengan Opus 5, M3.1 Flash masih tertinggal cukup jauh dalam tugas pemrograman dan refaktor yang melibatkan rangkaian langkah panjang, seperti Terminal Bench dan SWE Refactor. Hasil evaluasi pihak ketiga dari Vals juga menunjukkan bahwa kemampuannya dalam tugas Agent berantai panjang masih lemah.
Kapan Sebaiknya Tidak Menggunakan MiniMax M3.1 Flash atau Terburu-buru Menjalankannya di Server Sendiri
Dalam beberapa situasi berikut, sebaiknya jangan terburu-buru:
- Perencanaan kompleks dan refaktor berskala besar: Evaluasi resmi dan pengujian pihak ketiga sama-sama menunjukkan bahwa kemampuannya masih kurang kuat untuk tugas dengan rangkaian langkah panjang. Untuk tugas seperti ini, model unggulan seperti Claude Opus 5.5 biasanya lebih bisa diandalkan.
- Sangat sensitif terhadap latensi dan tidak membutuhkan penalaran mendalam: Mode berpikir tidak bisa dinonaktifkan. Bahkan jika disetel ke tingkat rendah, tetap ada biaya tambahan untuk proses berpikir.
- Sudah memiliki integrasi yang mengurai tag
<think>dari M3: Di M3.1 Flash, konten proses berpikir dikembalikan dalam kolom terpisah. Logika penguraian lama perlu diperbarui sebelum beralih. - Belum memahami lisensinya: Lisensi belum diumumkan sebelum bobot model dirilis. Jangan menjadwalkan proyek komersial dengan asumsi model ini akan dijalankan di server sendiri.
- Tidak ada yang bertugas mengelola layanan: Jika tidak ada yang bertanggung jawab atas daftar operasional di bagian sebelumnya, jangan andalkan layanan yang dikelola sendiri untuk menangani beban kerja bisnis.
- Ingin menjalankan versi lengkapnya di GPU kelas konsumen: Mengacu pada skala M3, ini tidak realistis. Tunggu informasi perangkat keras resmi dan jangan mudah percaya pada versi kuantisasi yang sumbernya tidak jelas.
Mengombinasikan MiniMax dan Claude Opus 5.5 di APIYI
Bagi kebanyakan developer, pertanyaan yang lebih praktis daripada “menjalankannya di server sendiri atau memanggil API” adalah: bagaimana membagi tugas dengan tingkat kesulitan berbeda ke model yang berbeda.
APIYI mendukung penggunaan satu kunci untuk memanggil model luar negeri seperti Claude, GPT, dan Gemini, serta model dalam negeri seperti DeepSeek dan MiniMax. Model yang saat ini bisa langsung digunakan di APIYI mencakup MiniMax-M3 (mendukung format antarmuka OpenAI dan Anthropic, serta tersedia di grup ClaudeCode), seri MiniMax-M2.7, claude-opus-5-5, dan claude-opus-5. Saat artikel ini ditulis, halaman harga APIYI belum mencantumkan MiniMax-M3.1-Flash. Pastikan ketersediaannya melalui halaman harga.
Pembagian tugas yang disarankan:
- Serahkan pekerjaan massal berbiaya rendah ke MiniMax: Pembersihan data, pembuatan ringkasan massal, konversi format, pelengkapan kode sederhana, dan tugas sejenis cocok untuk model ini karena volumenya besar dan tingkat kesulitan tiap tugas rendah. Semakin murah biaya per pemanggilan, semakin hemat.
- Serahkan perencanaan dan refaktor yang sulit ke Claude Opus 5.5: Refaktor lintas file, desain arsitektur, dan perencanaan tugas Agent yang kompleks memang lebih mahal jika dibayar per pemanggilan, tetapi biaya untuk memperbaiki kesalahan juga lebih tinggi.
- Beralih model dengan kunci yang sama: Cukup ganti nama model. Anda tidak perlu mengelola banyak akun dan alamat antarmuka yang berbeda.
🎯 Saran teknis: Gunakan kunci yang sama di APIYI apiyi.com untuk menjalankan MiniMax-M3 dan claude-opus-5-5, lalu bandingkan hasil dan tagihannya dengan tugas nyata Anda sendiri. Cara ini lebih bisa diandalkan daripada melihat skor pengujian apa pun.
Pertanyaan Umum
Q1: Kapan bobot MiniMax M3.1 Flash bisa diunduh?
Tanggal rilis yang direncanakan dalam unggahan X resmi adalah 23 Oktober, sementara blog resminya hanya menyebut “dalam waktu dekat”. Hingga artikel ini diterbitkan, bobotnya belum tersedia. Silakan cek halaman model resmi MiniMax di Hugging Face untuk informasi terbaru.
Q2: Apakah MiniMax M3.1 Flash bisa dijalankan dengan satu kartu grafis kelas konsumen?
Pihak resmi belum mengumumkan persyaratan perangkat keras untuk M3.1 Flash. Untuk M3 dengan skala yang sama, konfigurasi referensi resmi menggunakan 8 × B200 dengan bobot MXFP8 sekitar 440 GB. Jadi, versi lengkapnya pada dasarnya tidak realistis dijalankan dengan satu kartu grafis kelas konsumen.
Q3: Apakah MiniMax M3.1 Flash boleh digunakan untuk keperluan komersial setelah dirilis sebagai sumber terbuka?
Lisensinya belum diumumkan. Pihak resmi mengingatkan bahwa bobot sumber terbuka tidak berarti semua model menggunakan lisensi yang sama. Baca seluruh ketentuan lisensi sebelum melakukan deployment, mendistribusikan ulang, atau menggunakannya untuk keperluan komersial.
Q4: Bagaimana cara mencoba model MiniMax dengan biaya rendah sekarang?
Cara paling praktis adalah langsung menggunakan API. M3.1 Flash dapat diakses melalui API resmi MiniMax atau langganan M Plan (cek situs resminya untuk informasi biaya bulanan). Jika ingin mengelola beberapa model dengan satu kunci API, Anda bisa mencoba MiniMax-M3 yang sudah tersedia melalui APIYI apiyi.com. Untuk mengetahui apakah M3.1 Flash bisa diakses, cek halaman harga APIYI.
Q5: Apakah MiniMax M3.1 Flash bisa menggantikan Claude Opus 5.5?
Sebaiknya jangan menganggapnya demikian. Pihak resmi hanya membandingkannya dengan Claude Opus 5, dan M3.1 Flash masih tertinggal dalam tugas pemrograman dengan rangkaian proses yang panjang. Pendekatan yang lebih masuk akal adalah membagi tugas: gunakan MiniMax untuk pekerjaan massal, lalu Opus 5.5 untuk perencanaan dan refactoring yang sulit. Kombinasi ini bisa digunakan dengan satu kunci API di APIYI.
Poin Utama Bobot Terbuka MiniMax M3.1 Flash
- Bobot belum dirilis: Rencananya akan dirilis pada 23 Oktober. Jadikan halaman model resmi di Hugging Face sebagai acuan.
- Lisensi dan kebutuhan perangkat keras belum diumumkan: Jangan membeli perangkat atau menyusun jadwal berdasarkan spekulasi.
- Skalanya bisa mengacu pada M3: Bobot MXFP8 sekitar 440 GB yang dijalankan dengan 8 × B200 termasuk kategori pusat data.
- API lebih hemat biaya: Dengan harga $0.15/$0.60, API jauh lebih praktis daripada membangun infrastruktur sendiri bagi kebanyakan pengguna perorangan dan tim kecil.
- Penerapan mandiri hanya cocok untuk situasi tertentu: Terutama untuk kebutuhan kepatuhan yang ketat, volume pemanggilan yang sangat besar, atau kebutuhan untuk memodifikasi model.
- Pembandingnya adalah Opus 5: Opus 5.5 tetap menjadi model andalan Anthropic yang paling kuat. Tidak ada perbandingan terperinci dari pihak resmi.
- Gunakan beberapa model sekaligus: Di APIYI apiyi.com, gunakan satu kunci API untuk memadukan MiniMax dan Claude Opus 5.5.
Ringkasan
Hal-hal penting tentang bobot terbuka MiniMax M3.1 Flash:
- Status: Bobotnya direncanakan rilis pada 23 Oktober. Lisensi dan kebutuhan perangkat keras untuk penerapan belum diumumkan. Jadikan halaman model resmi sebagai acuan;
- Konfigurasi: Sebagai acuan untuk skala yang setara, M3 menggunakan konfigurasi resmi dengan 8 GPU kelas B200—bukan sesuatu yang bisa ditangani perangkat pribadi;
- Pengambilan keputusan: Pertimbangkan empat hal: kepatuhan, volume pemanggilan, kemampuan operasional, dan kebutuhan untuk memodifikasi model. Dalam kebanyakan kasus, menggunakan API secara langsung lebih hemat biaya.
Setelah bobot dirilis, baca dulu lisensi dan panduan perangkat keras resmi sebelum memutuskan untuk membangun infrastruktur sendiri. Untuk kebutuhan bisnis, pendekatan yang lebih praktis adalah menggunakan model berbeda untuk tugas dengan tingkat kesulitan yang berbeda. Anda bisa menggunakan satu kunci API di APIYI apiyi.com untuk menguji kombinasi model dari seri MiniMax dan claude-opus-5-5.
📚 Referensi
- Blog peluncuran resmi MiniMax: catatan peluncuran M3.1 Flash dan data yang dilaporkan oleh MiniMax
- Tautan:
minimax.io/blog/minimax-m31f -
Keterangan: Pernyataan resmi bahwa harga, kecepatan, dan bobot model akan diumumkan “nanti”
-
Halaman harga resmi MiniMax: tarif penggunaan berdasarkan volume untuk setiap model
- Tautan:
platform.minimax.io/docs/guides/pricing -
Keterangan: Perbandingan harga M3.1 Flash dan M3
-
Panduan deployment mandiri resmi MiniMax: konfigurasi referensi untuk deployment model open source
- Tautan:
platform.minimax.io/docs/guides/local-deploy -
Keterangan: Konfigurasi referensi 8 × B200 untuk M3 dan hal-hal yang perlu diperhatikan saat melakukan deployment mandiri
-
Halaman evaluasi Vals AI: hasil evaluasi pihak ketiga untuk M3.1 Flash
- Tautan:
vals.ai/models/minimax_MiniMax-M3.1-flash -
Keterangan: Peringkat Vals Index dan skor untuk setiap kategori
-
Hugging Face – MiniMax-M3: bobot M3 dan lisensi komunitas
- Tautan:
huggingface.co/MiniMaxAI/MiniMax-M3 -
Keterangan: Setelah bobot M3.1 Flash dirilis, model ini dapat dilihat di organisasi yang sama
-
Dokumentasi SGLang – MiniMax-M3: panduan deployment dengan kerangka kerja inferensi
- Tautan:
docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3 - Keterangan: Ukuran versi MXFP8 M3 dan cara menjalankannya
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs resmi APIYI. Informasi lebih lanjut tersedia di pusat dokumentasidocs.apiyi.com.