Catatan penulis: Artikel ini menjelaskan komponen harga GPT-6.1 Terra, pembagian tarif untuk konteks panjang, dan penghematan dari cache, menggunakan harga resmi serta tiga contoh perhitungan.
GPT-6.1 Terra dirilis pada 26 Oktober 2026 dengan fokus pada kecepatan dan efisiensi biaya. Saat pertama melihat halaman harga, banyak orang hanya mengingat “input $1”, lalu bingung ketika tagihannya tidak sesuai. Penyebabnya, harga Terra merupakan gabungan dari empat komponen biaya, dua tingkatan konteks, dan tiga mode pemrosesan.
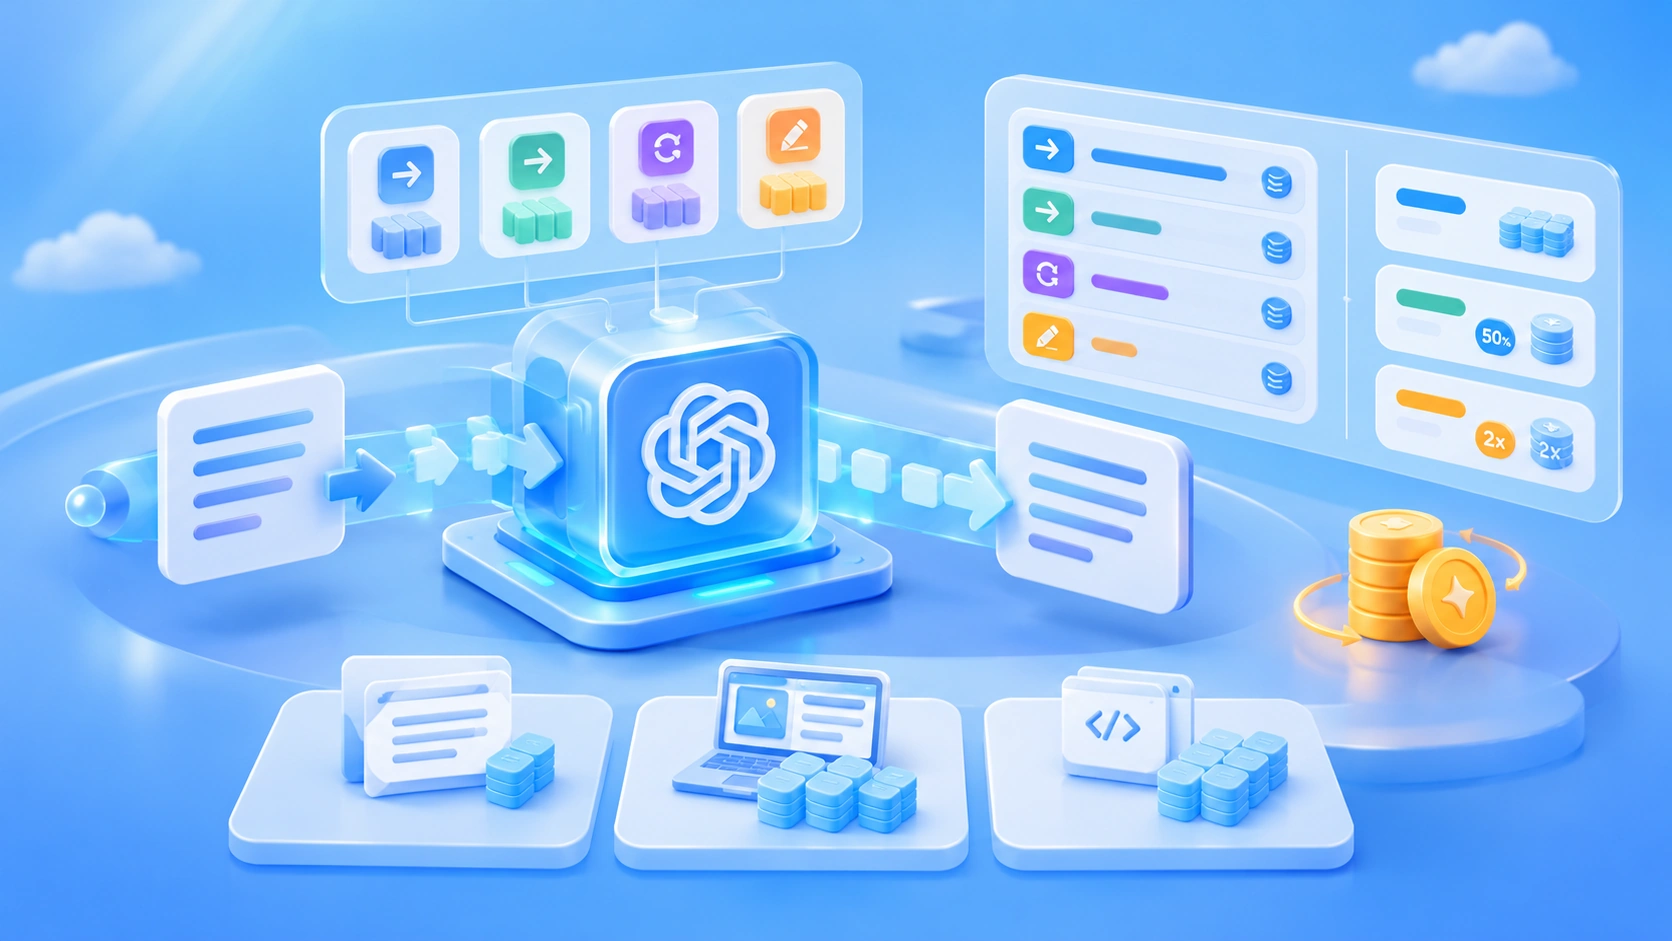
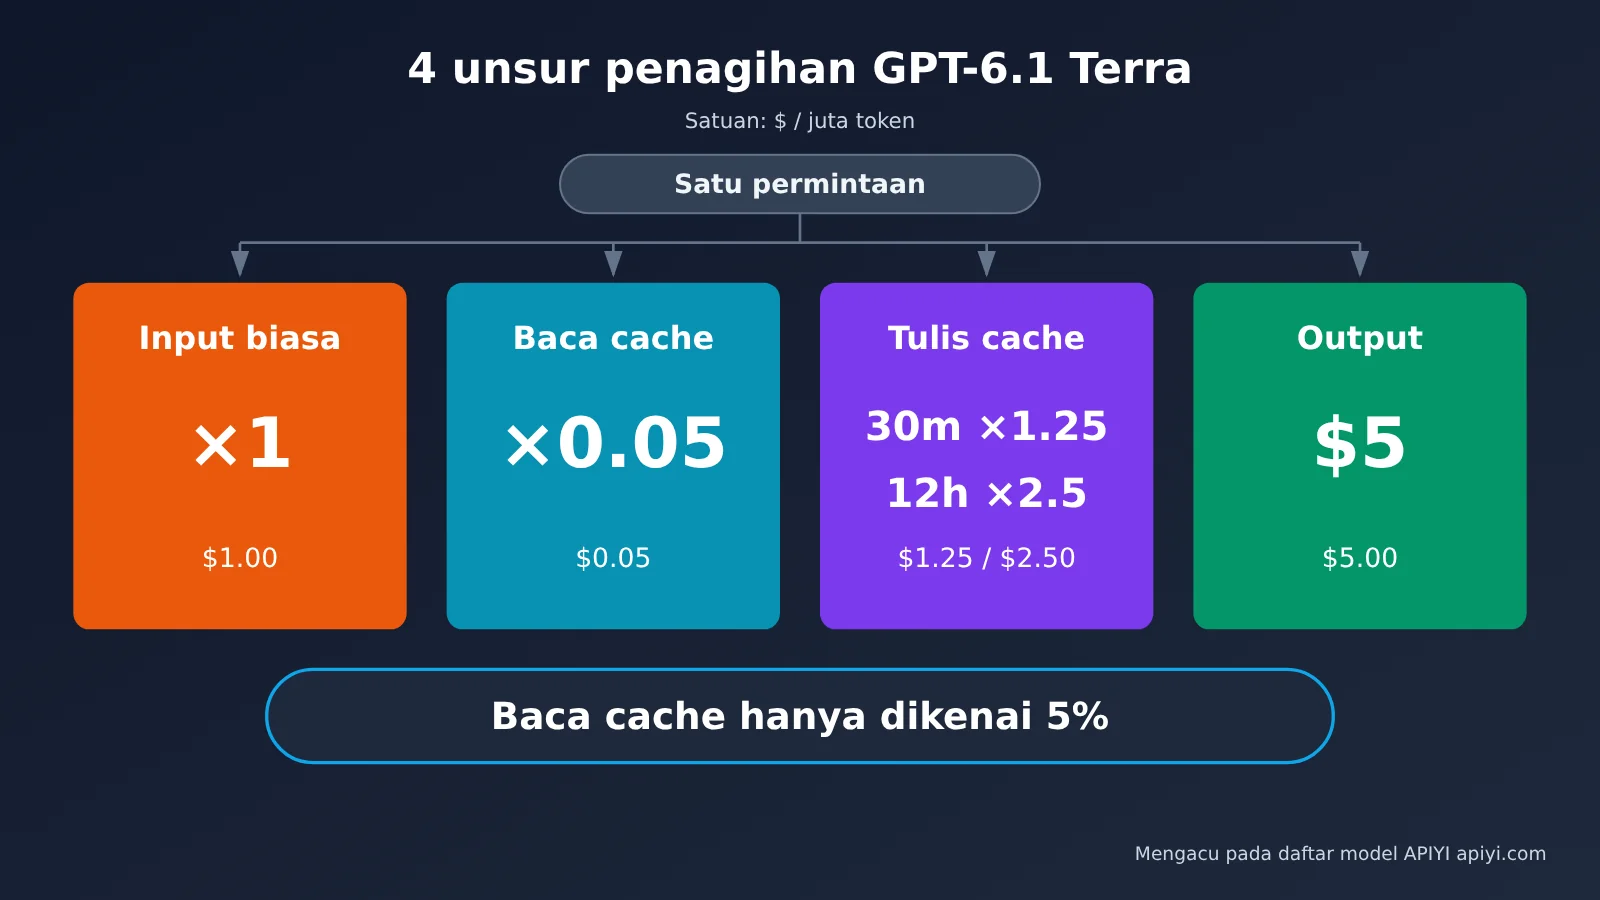
Singkatnya, begini struktur harga Terra. Setiap permintaan dikenai biaya berdasarkan empat komponen: input biasa, output, pembacaan cache, dan penulisan cache. Penulisan cache memiliki dua pilihan durasi penyimpanan: 30 menit dan 12 jam. Jika input dalam satu permintaan melebihi 272K token, seluruh permintaan beralih ke tingkatan harga kedua. Ada juga tiga mode pemrosesan: Batch/Flex mendapat diskon 50%, sedangkan Fast dikenai tarif dua kali lipat.
Catatan sumber: Harga resmi berasal dari halaman model dan halaman harga OpenAI. Data yang dilaporkan oleh penyedia berasal dari blog peluncuran pada 26 Oktober 2026. Data pihak ketiga berasal dari Artificial Analysis, diambil pada 27 Oktober 2026.
Poin Utama Harga GPT-6.1 Terra
Mari mulai dari modelnya. ID modelnya adalah gpt-6.1-terra, dan hanya tersedia satu snapshot. Jendela konteksnya 1.050.000 token, dengan input maksimum 922.000 token dan output maksimum 128.000 token per permintaan. Batas pengetahuannya adalah 2026-06-01. Model ini menerima input teks dan gambar, tetapi hanya menghasilkan teks serta tidak mendukung audio atau video.
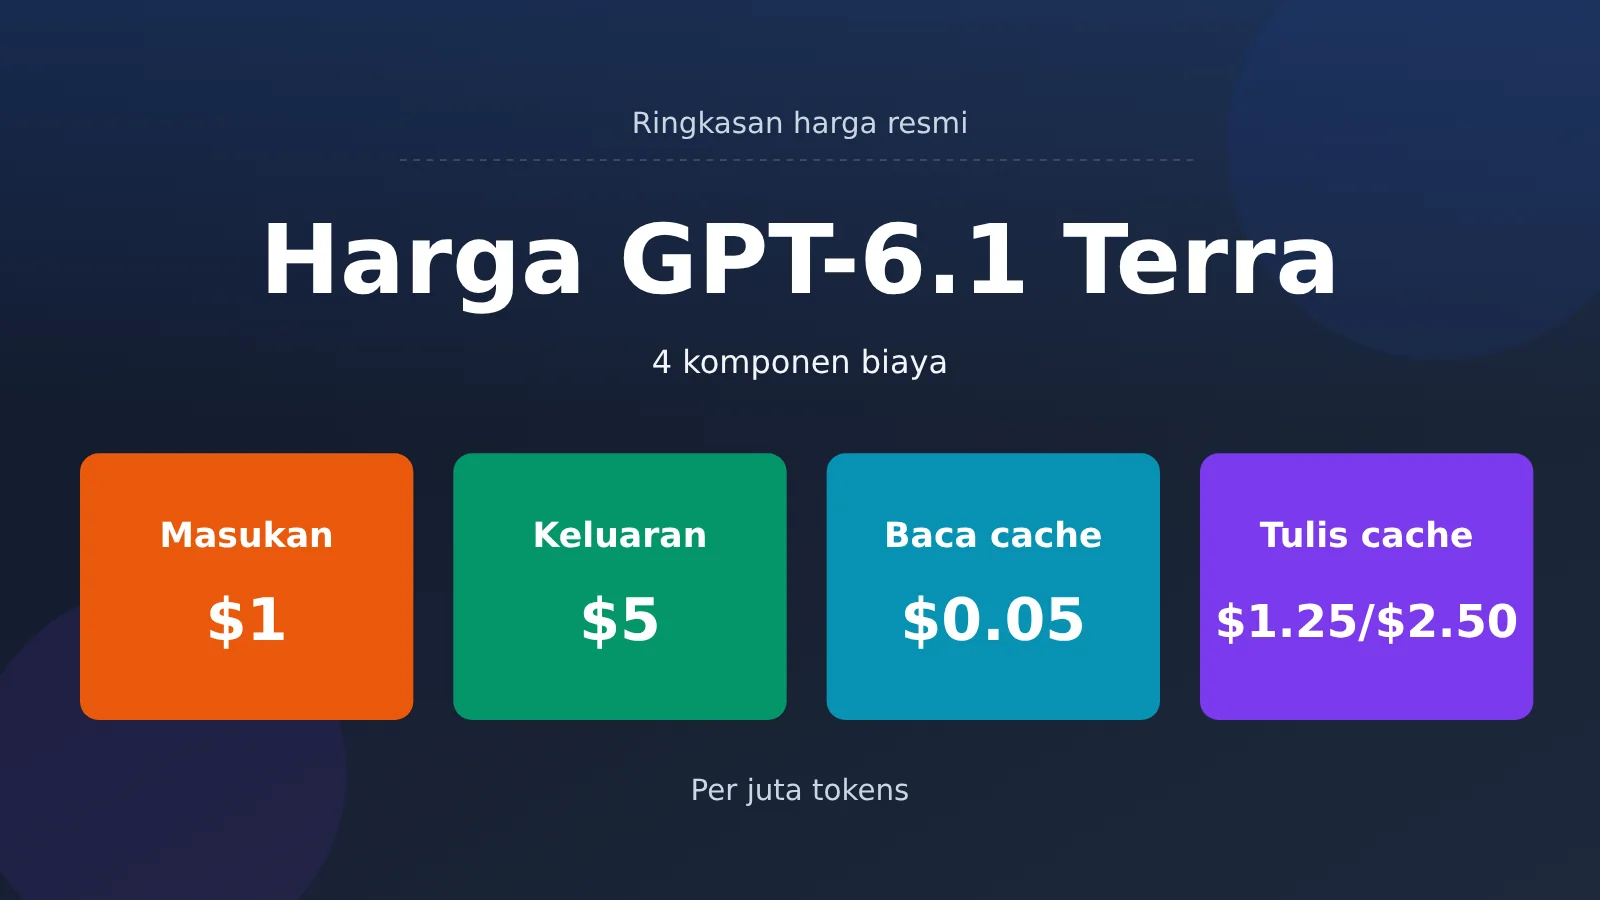
Harga standar berlaku untuk permintaan dengan input tidak lebih dari 272K token. Semua harga dihitung per satu juta token:
| Komponen biaya | Harga standar (≤272K) | Keterangan |
|---|---|---|
| Input | $1.00 | Input yang tidak ditemukan dalam cache |
| Output | $5.00 | Termasuk output yang dihasilkan melalui penalaran |
| Pembacaan cache | $0.05 | 0,05 kali harga input |
| Penulisan cache (30 menit) | $1.25 | 1,25 kali harga input |
| Penulisan cache (12 jam) | $2.50 | 2,5 kali harga input |
Detail Biaya Cache GPT-6.1 Terra
Pembacaan cache hanya dikenakan biaya sebesar 5% dari harga input. Sebagian besar model seangkatan mengenakan biaya 0,1 kali harga input. Inilah komponen dengan penurunan terbesar pada Terra dibandingkan generasi sebelumnya.
Biaya penulisan cache adalah harga total, bukan biaya tambahan di luar harga input. Token yang ditulis ke cache langsung dikenakan tarif $1.25 atau $2.50, tanpa dikenakan lagi tarif input $1.00. Ada beberapa aturan penggunaan yang perlu diperhatikan:
- Panjang minimum prefiks yang dapat disimpan dalam cache adalah 1.024 token. Prefiks yang lebih pendek tidak akan masuk ke cache.
- Masa penyimpanan 12 jam hanya dapat diatur melalui
prompt_cache_options.ttldi Responses API. - Jika
ttldiberi nilai yang tidak valid, API akan mengembalikan400 invalid_request_error.
Harga konteks panjang GPT-6.1 Terra: ambang 272K
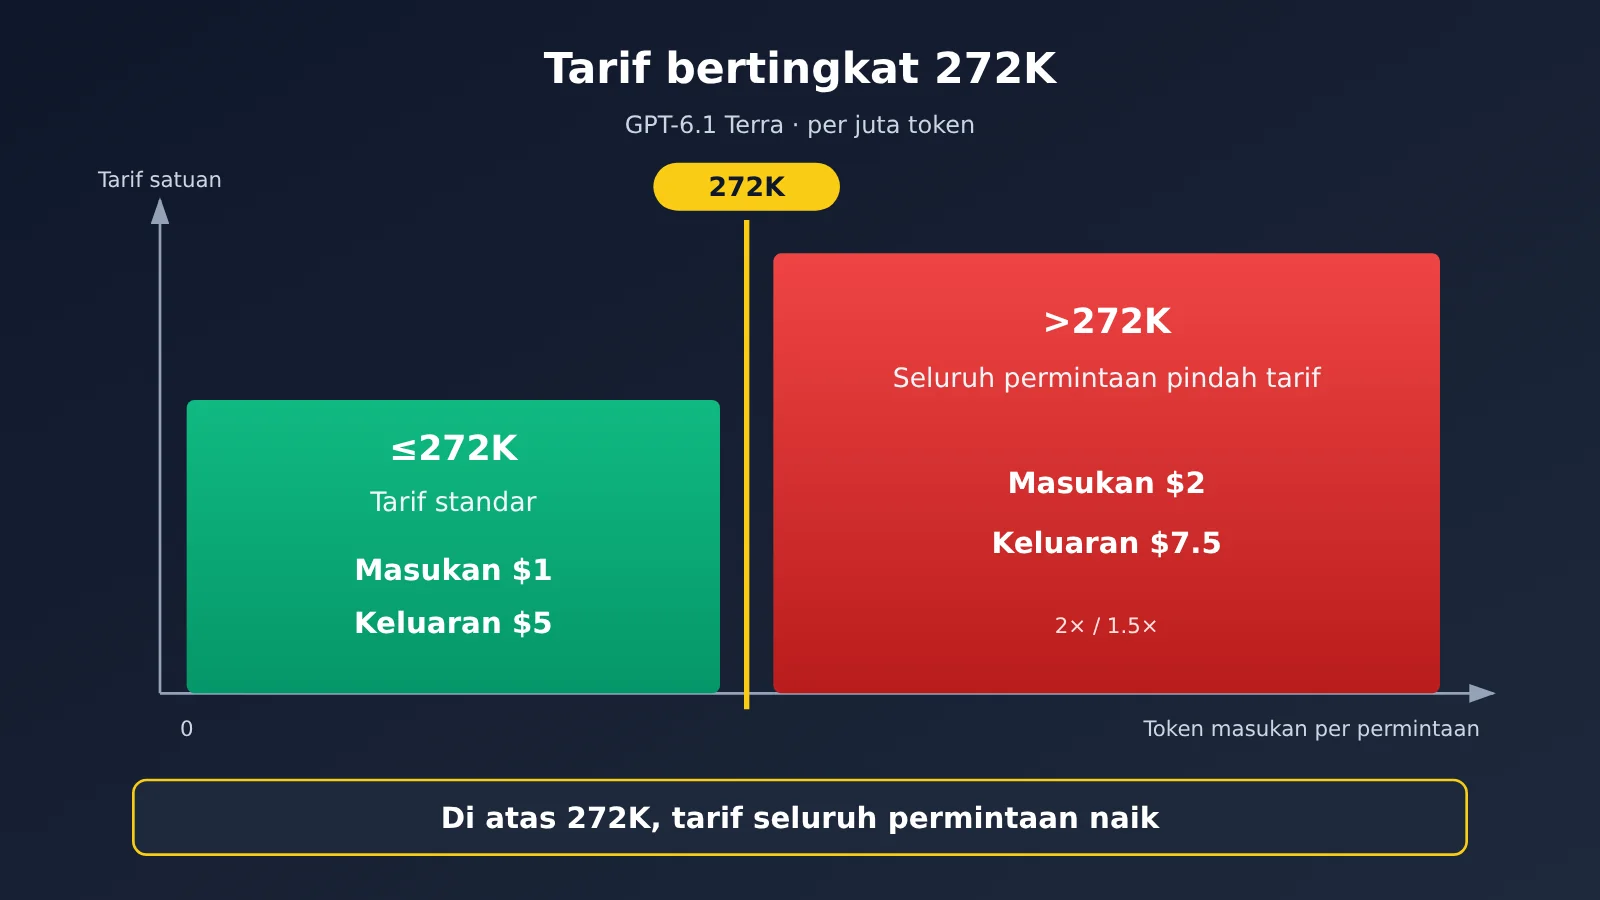
Aturan ini paling mudah terlewat. Saat input dalam satu permintaan melebihi 272K token, seluruh permintaan beralih ke tarif tingkat kedua: harga input dan cache naik dua kali lipat, sedangkan harga output naik menjadi 1,5 kali lipat. Tarif baru berlaku untuk semua token dalam permintaan, bukan hanya bagian yang melampaui batas.
| Komponen biaya | ≤272K | >272K (seluruh permintaan) | Kelipatan |
|---|---|---|---|
| Input | $1.00 | $2.00 | 2× |
| Output | $5.00 | $7.50 | 1.5× |
| Pembacaan cache | $0.05 | $0.10 | 2× |
| Penulisan cache 30 menit | $1.25 | $2.50 | 2× |
| Penulisan cache 12 jam | $2.50 | $5.00 | 2× |
Tarif GPT-6.1 Terra lainnya
| Mode | Aturan harga | Skenario penggunaan |
|---|---|---|
| Batch / Flex | Setengah harga standar: input $0.50, output $2.50, pembacaan cache $0.025, penulisan cache $0.625 (30 menit) / $1.25 (12 jam) | Pemrosesan batch offline, tugas yang tidak sensitif terhadap latensi |
| Fast | 2 kali harga standar: input $2.00, output $10.00 | Penggunaan online yang sensitif terhadap latensi |
| Ultrafast | Tidak didukung Terra, hanya tersedia untuk gpt-6-astra dan gpt-6.1-sol | — |
| Pemrosesan regional / FedRAMP | Biaya tambahan 10%, berlaku untuk model yang dirilis setelah 2026-03-05 | Residensi data, kebutuhan kepatuhan |
Kami tidak menemukan angka yang jelas untuk harga cache dalam mode Fast di halaman resmi yang kami akses, jadi kami mencatatnya sebagai “belum diungkapkan secara resmi”. Selain itu, Priority processing berganti nama menjadi Fast mode pada 2026-07-30. Perhatikan perubahan ini saat membaca dokumentasi lama.
Perbandingan Harga GPT-6.1 Terra: Generasi yang Sama dan Sebelumnya
| Model | Input | Output | Pembacaan cache | Penulisan cache 30 menit | Daftar model APIYI apiyi.com (2026-10-27) |
|---|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | $12.50 | Tersedia |
| gpt-6.1-sol | $2.00 | $10.00 | $0.10 | $2.50 | Tersedia |
| gpt-6.1-terra | $1.00 | $5.00 | $0.05 | $1.25 | Tersedia |
| gpt-6-sol | $2.00 | $10.00 | $0.20 | $2.50 | Tersedia |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.125 | Tersedia |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | $2.50 | Tersedia |
Dibandingkan GPT-5.6 Terra, harga input Terra turun 50%, harga output turun sekitar 58%, dan harga pembacaan cache turun 75%. Menurut blog resmi, harga API standarnya 50% lebih rendah daripada GPT-5.6 Terra dan GPT-6.1 Sol.
Perhitungan Harga GPT-6.1 Terra: Tiga Contoh
Perhitungan berikut menggunakan harga per satu juta token, yaitu jumlah token × harga ÷ 1.000.000.
Contoh 1: Entri faktur secara massal
Misalkan setiap permintaan menggunakan 2.000 token input (termasuk satu gambar faktur) dan menghasilkan 300 token output, dengan 5.000 pemanggilan per hari.
Tanpa cache hit:
- Input: 2.000 × $1 ÷ 1M = $0.0020
- Output: 300 × $5 ÷ 1M = $0.0015
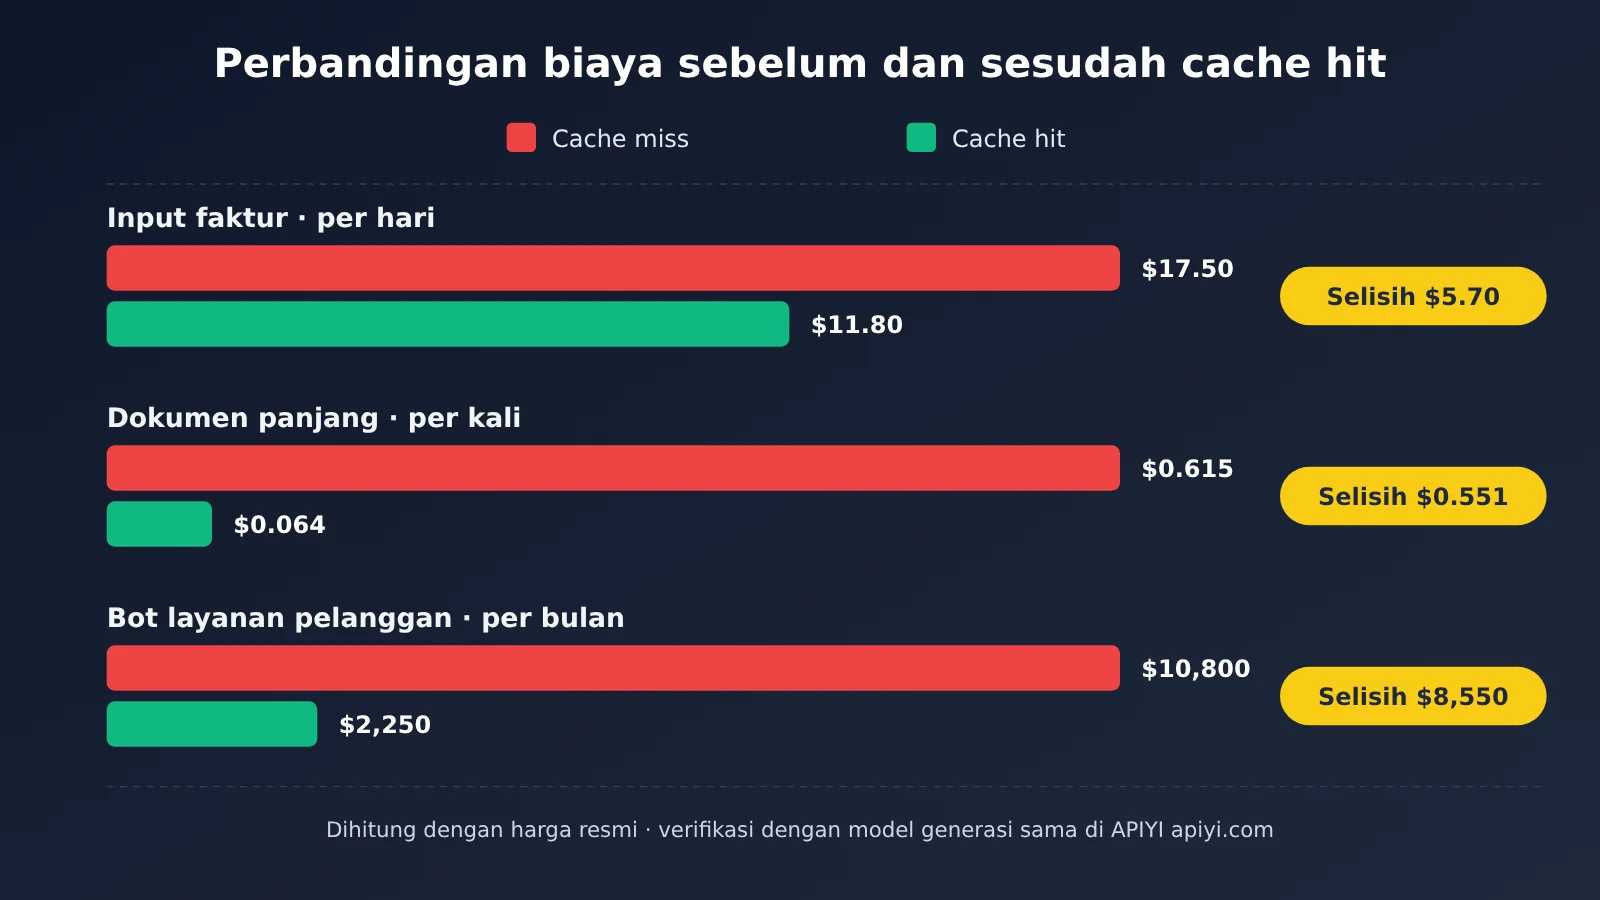
- Total per pemanggilan $0.0035, 5.000 pemanggilan per hari × $0.0035 = $17.50
Dengan cache hit: Misalkan instruksi sistem dan penjelasan kolom yang tetap berjumlah 1.200 token dan mendapat cache hit (melewati ambang 1.024 token). Sisanya, 800 token, berisi konten yang berubah seperti gambar.
- Pembacaan cache: 1.200 × $0.05 ÷ 1M = $0.00006
- Input biasa: 800 × $1 ÷ 1M = $0.0008
- Output: $0.0015
- Total per pemanggilan $0.00236, atau $11.80 per hari, lebih hemat $5.70 per hari dibandingkan tanpa cache hit
Setelah cache kedaluwarsa, isinya perlu ditulis ulang. Biaya penulisan dengan masa penyimpanan 30 menit adalah 1.200 × $1.25 ÷ 1M = $0.0015. Jika dibagi ke 5.000 pemanggilan per hari, biaya ini bisa diabaikan. Entri faktur biasanya tidak membutuhkan respons secara real-time. Jika beralih ke Batch, biaya per pemanggilan tanpa cache hit menjadi 2.000 × $0.5 ÷ 1M + 300 × $2.5 ÷ 1M = $0.00175, atau $8.75 per hari.
Contoh kedua: Meninjau dokumen panjang (masuk tingkat >272K)
Misalkan satu permintaan menggunakan 300.000 token input dan 2.000 token output. Karena input melebihi 272K, seluruh permintaan dihitung dengan tarif tingkat kedua.
Tanpa cache hit:
- Input: 300.000 × $2 ÷ 1M = $0.60
- Output: 2.000 × $7.5 ÷ 1M = $0.015
- Biaya per permintaan: $0.615
Dengan cache hit: Dokumen yang sama ditanyakan berulang kali. Misalkan prefiks dokumen sebanyak 290.000 token terkena cache hit, sedangkan pertanyaan baru menggunakan 10.000 token.
- Pembacaan cache: 290.000 × $0.10 ÷ 1M = $0.029
- Input biasa: 10.000 × $2 ÷ 1M = $0.020
- Output: $0.015
- Biaya per permintaan: $0.064, lebih murah $0.551 dibandingkan tanpa cache hit
Permintaan pertama perlu menulis data ke cache. Dengan masa penyimpanan 30 menit, biaya pertama adalah 290.000 × $2.5 ÷ 1M + $0.02 + $0.015 = $0.76. Cukup ajukan satu pertanyaan lanjutan untuk dokumen yang sama, dan total dua permintaan menjadi $0.824, lebih murah daripada $1.23 jika keduanya tanpa cache.
Ada cara yang lebih langsung untuk menghemat biaya: kurangi input hingga tidak lebih dari 272K. Dengan input 270.000 token dan output 2.000 token, biayanya adalah 270.000 × $1 ÷ 1M + 2.000 × $5 ÷ 1M = $0.28, kurang dari setengah biaya pada tingkat kedua.
Contoh tiga: Bot layanan pelanggan dengan tingkat hit cache tinggi
Misalkan setiap percakapan menerima input 50.000 token, dengan 45.000 token mengalami hit cache, dan menghasilkan 800 token output. Jumlah percakapan mencapai 200.000 per bulan.
Tanpa hit cache:
- Input 50.000 × $1 ÷ 1 juta = $0,05, output 800 × $5 ÷ 1 juta = $0,004
- Per percakapan $0,054, per bulan 200.000 × $0,054 = $10.800
Dengan hit cache:
- Pembacaan cache: 45.000 × $0,05 ÷ 1 juta = $0,00225
- Input biasa: 5.000 × $1 ÷ 1 juta = $0,005
- Output: $0,004
- Per percakapan $0,01125, per bulan $2.250, lebih hemat $8.550 per bulan dibandingkan tanpa hit cache
Jika biaya pembacaan cache dihitung sebesar 0,1 kali harga input, seperti pada sebagian besar model generasi yang sama, biayanya menjadi $0,0135 per percakapan atau $2.700 per bulan. Tarif 0,05 kali dari Terra menghasilkan penghematan tambahan sebesar $450 per bulan dalam skenario ini. Perhitungan di atas belum mencakup amortisasi biaya penulisan cache.
Biaya per Tugas GPT-6.1 Terra: Data Pihak Ketiga
Data berikut berasal dari Artificial Analysis (diambil pada 27 Oktober 2026). Ini adalah hasil evaluasi pihak ketiga, bukan biaya untuk kebutuhan Anda. Komposisi token pada tugas evaluasi berbeda dari permintaan Anda yang sebenarnya. Untuk perkiraan yang lebih akurat, hitung berdasarkan harga resmi dan distribusi token Anda sendiri.
| Model | Intelligence Index | Biaya per tugas | Kecepatan output |
|---|---|---|---|
| GPT-6.1 Terra(max) | 48 | $0.40 | 91 t/s |
| GPT-6.1 Sol | 52 | $0.72 | 69.4 t/s |
| GPT-5.6 Terra | 42 | $1.40 | 135.4 t/s |
| GPT-6 Astra | 53 | $3.26 | 67.8 t/s |
| Claude Opus 5.5(Max) | 58 | $5.98 | — |
Berdasarkan data ini, indeks Terra 5 poin lebih rendah daripada Astra, sementara biaya per tugasnya sekitar 1/8 dari Astra dan 1/15 dari Opus 5.5.
Blog resmi juga menyajikan beberapa perbandingan biaya berikut. Ini adalah klaim vendor yang belum direplikasi secara independen:
- Pada Agents’ Last Exam, skor tingkat medium 15 poin persentase lebih tinggi daripada GPT-5.6 Terra, dengan biaya sekitar sepertiganya.
- Efisiensi token tingkat max lebih dari 3 kali lipat Claude Opus 5.5, dengan biaya per tugas sekitar 9 kali lebih rendah.
Panduan cepat GPT-6.1 Terra: langkah integrasi
Per 27 Oktober 2026, gpt-6.1-terra sudah bisa dipanggil langsung melalui APIYI apiyi.com: input $1, output $5, pembacaan cache $0.05, dan penulisan cache $1.25 per satu juta token. Angka ini setara dengan pengali model 0.5 dan pengali completion 5 di platform, serta sama persis dengan tarif resmi untuk tingkat konteks ≤272K. Model satu generasi seperti gpt-6.1-sol dan gpt-6-astra, serta model generasi sebelumnya seperti gpt-5.6-terra, gpt-6-sol, dan gpt-6-luna juga sudah tersedia. Untuk model dan harga, lihat daftar model di platform. Biaya akhir untuk konteks panjang dapat dicek di tagihan konsol.
Integrasi hanya membutuhkan empat langkah:
- Daftar akun di APIYI apiyi.com, lalu buat kunci API.
- Di SDK yang kompatibel dengan OpenAI, atur
base_urlkehttps://api.apiyi.com/v1dan isiapi_keydengan kunci API kamu. - Sebelum melakukan pemanggilan, cek daftar model terkini di
api.apiyi.com/api/pricing. Pastikan harga satuan dan grup yang tersedia untukgpt-6.1-terra, lalu atur kolommodelke ID tersebut. - Atur
reasoning.effortsesuai kebutuhan tugas. Pilihannya adalahnone / low / medium / high / xhigh / max, dengan nilai defaultmedium. - Jika membutuhkan cache selama 12 jam, gunakan Responses API dan atur
prompt_cache_options.ttl. - Sebelum masuk ke produksi, periksa jumlah token yang mengenai cache melalui statistik usage yang dikembalikan, lalu gunakan rumus dalam artikel ini untuk memperkirakan biaya.
🚀 Mulai cepat: Lihat daftar model di platform untuk informasi model dan harga. Akun baru mendapat kredit percobaan sebesar $0.05. Di APIYI apiyi.com, atur
modelkegpt-6.1-terrauntuk menguji alur pemanggilan dan logika cache. Jika ingin membandingkan harga, cukup ganti kegpt-6.1-sol.
Pertanyaan Umum (FAQ)
Q1: Berapa harga GPT-6.1 Terra secara singkat?
Untuk tarif standar (input per permintaan ≤272K), harga per juta token adalah: input $1, output $5, pembacaan cache $0.05, penulisan cache 30 menit $1.25, dan 12 jam $2.50.
Q2: Jika melebihi 272K, apakah tarif tambahan hanya berlaku untuk bagian yang melebihi batas?
Tidak. Jika input per permintaan melebihi 272K, seluruh permintaan beralih ke tarif tingkat kedua: harga input dan cache menjadi dua kali lipat, sedangkan harga output menjadi 1,5 kali lipat.
Q3: Bagaimana cara memilih Batch atau Fast?
Untuk tugas offline, pilih Batch atau Flex agar semua komponen biaya mendapat diskon 50%. Untuk tugas yang sensitif terhadap latensi, pilih Fast, tetapi biayanya dua kali lipat. Terra tidak mendukung Ultrafast.
Q4: Apakah penulisan cache dikenakan biaya tambahan?
Biaya penulisan cache adalah harga total, bukan biaya tambahan. Token yang ditulis dikenakan tarif 1,25 atau 2,5 kali harga input, tanpa dikenakan lagi tarif input biasa. Jika prefiks yang sama digunakan ulang sekali saja, biayanya biasanya sudah tertutup.
Q5: Apakah Terra tersedia di APIYI?
Ya. Sejak 2026-10-27, `gpt-6.1-terra` tersedia di APIYI apiyi.com. Keempat komponen biayanya sama dengan tarif resmi untuk tingkat ≤272K. Ketersediaan model dan harga mengacu pada daftar model di platform.
Q6: Apakah biaya per tugas dari pihak ketiga bisa langsung digunakan untuk menyusun anggaran?
Sebaiknya jangan langsung digunakan. Angka tersebut berasal dari tugas evaluasi, yang struktur penggunaan tokennya bisa berbeda dari kebutuhan bisnis Anda. Cara yang lebih aman adalah menguji permintaan nyata di APIYI apiyi.com untuk mengetahui distribusi token, lalu menghitung biayanya berdasarkan tarif resmi.
Poin Penting Harga GPT-6.1 Terra
- Empat komponen biaya: input $1, output $5, pembacaan cache $0,05, serta penulisan cache dalam dua tarif: $1,25 dan $2,50.
- 272K adalah batas penentu: jika terlampaui, seluruh permintaan dikenai tarif yang lebih tinggi—input menjadi dua kali lipat dan output 1,5 kali lipat.
- Cache adalah sumber penghematan terbesar: dalam skenario layanan pelanggan, biaya bulanan turun dari $10.800 menjadi $2.250.
- Batch/Flex setengah harga, Fast dua kali lipat; Terra tidak mendukung Ultrafast.
- Biaya per tugas dari pihak ketiga hanya sebagai referensi. Untuk menyusun anggaran, lebih akurat jika dihitung sendiri berdasarkan harga resmi.
- Akses melalui platform: di APIYI apiyi.com, atur bidang
modelkegpt-6.1-terrauntuk memanggil model. Ketersediaan model dan harga mengikuti daftar model di platform.
Kesimpulan
Tagihan Terra terutama ditentukan oleh tiga hal: apakah input melebihi 272K, seberapa tinggi tingkat cache hit, dan apakah Anda memilih Batch atau Fast. Dengan mengelola ketiganya, biaya untuk volume pekerjaan yang sama bisa berbeda hingga beberapa kali lipat.
Sebaiknya, uji struktur token menggunakan permintaan nyata Anda terlebih dahulu, lalu hitung setiap komponen menggunakan rumus dalam artikel ini. Anda bisa langsung menjalankan permintaan nyata dengan gpt-6.1-terra di APIYI apiyi.com, lalu membandingkan harganya dengan gpt-6.1-sol dari generasi yang sama.
📚 Referensi
- Halaman model OpenAI GPT-6.1 Terra: spesifikasi dan parameter konteks
- Tautan:
platform.openai.com/docs/models/gpt-6.1-terra - Keterangan: konteks, modalitas input dan output, serta tingkat reasoning
- Halaman harga OpenAI: harga standar, konteks panjang, Batch/Flex/Fast
- Tautan:
platform.openai.com/docs/pricing - Keterangan: ketentuan resmi untuk semua komponen biaya
- Panduan OpenAI Prompt Caching: aturan cache
- Tautan:
platform.openai.com/docs/guides/prompt-caching - Keterangan: panjang minimum prefiks, pengaturan TTL, dan cara penagihan penulisan cache
- Blog peluncuran GPT-6.1 Terra: data biaya yang dilaporkan oleh penyedia
- Tautan:
openai.com/index/introducing-gpt-6-1-terra - Keterangan: diterbitkan pada 26 Oktober 2026; data belum direproduksi secara independen
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama APIYI di apiyi.com. Untuk informasi lebih lanjut, kunjungi pusat dokumentasi di docs.apiyi.com.