
Catatan penulis: Menjawab satu pertanyaan seputar tagihan (billing). Harga resmi model AI beberapa bulan terakhir memang turun drastis, tapi anehnya biaya untuk Agent coding tetap terasa membengkak di pos pengeluaran yang sama. Data harga di artikel ini sudah dicek silang per 26 Oktober 2026 berdasarkan daftar harga resmi yang masih bisa diakses serta halaman harga model APIYI. Angka 96% yang disebutkan di bawah adalah estimasi penulis pihak ketiga, bukan hasil pengujian langsung di artikel ini.
Dari 26 Juni 2026 hingga 29 September 2026 (sekitar empat bulan), OpenAI dan Anthropic bergantian memangkas harga. Max Woolf merangkum linimasa ini pada 25 Oktober 2026 di minimaxir.com/2026/10/cheap-llms, dengan penurunan harga mencapai 80% seperti yang tertulis di judulnya. Dalam tulisannya, ia menyebutkan bahwa pada Agent coding, pembacaan cache (cache read) menyumbang sekitar 96%–99% dari total pengeluaran token. Alasannya sederhana: setiap putaran percakapan akan membaca ulang seluruh riwayat dialog sebelumnya dari cache, dengan hit rate sekitar 90%–100% tergantung penyedia inferensi. Artikel aslinya memang tidak menyertakan log request yang bisa diverifikasi ulang. Jadi, anggap saja klaim ini sebagai rujukan pihak ketiga, bukan patokan pasti untuk pola penggunaan tim Anda sendiri.
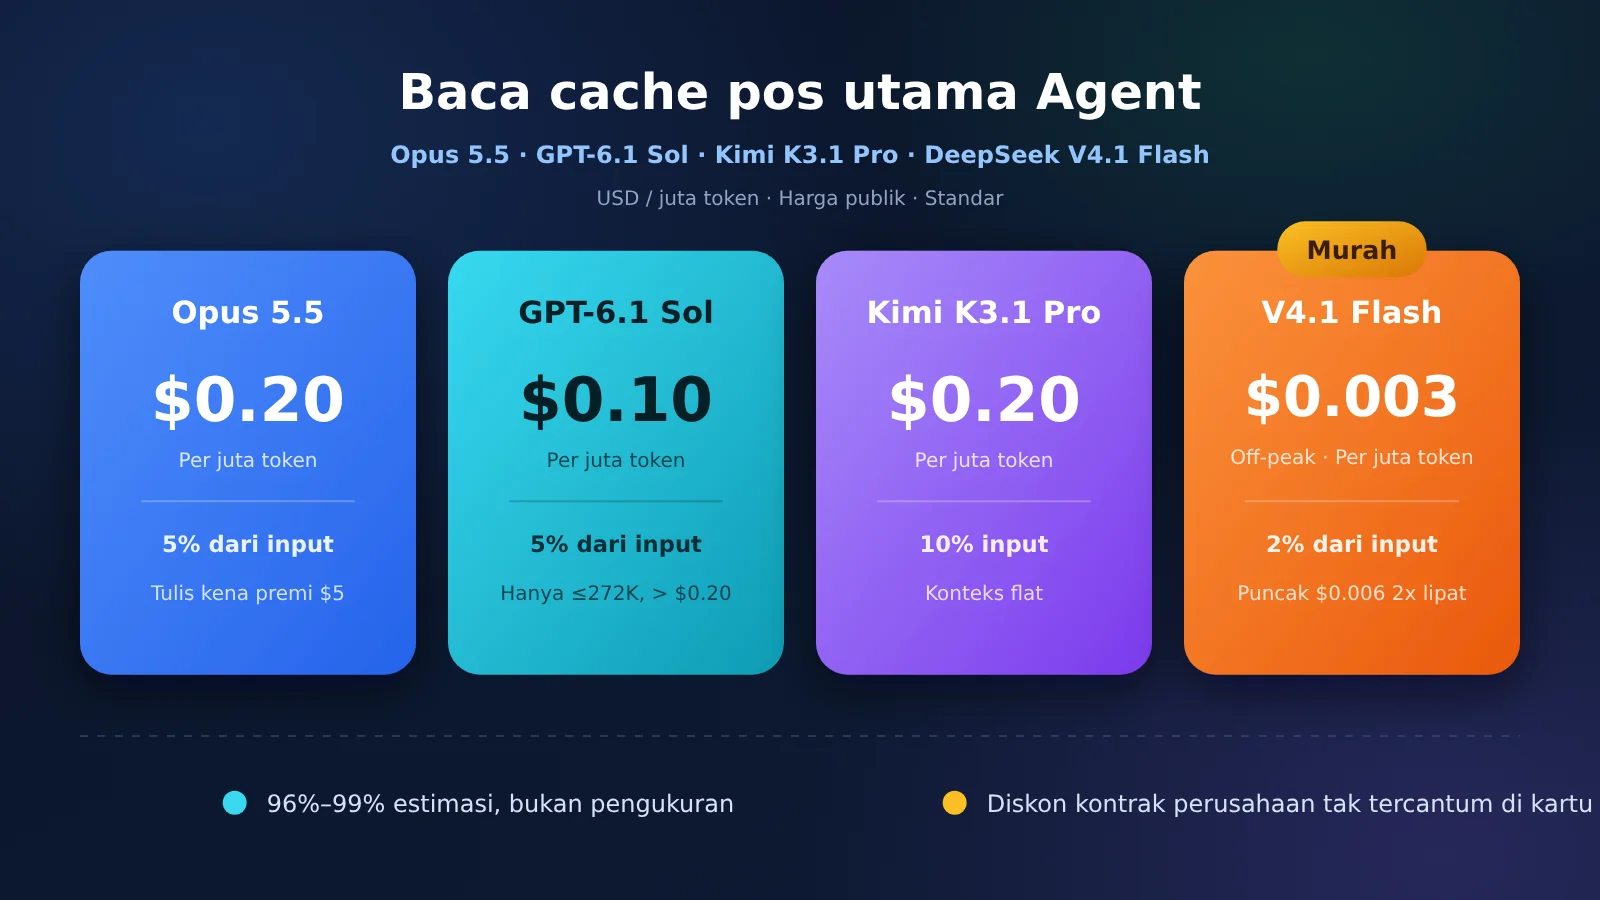
Dalam jendela waktu yang sama, tarif pembacaan cache yang masih sesuai dengan daftar harga resmi saat ini adalah: Claude Opus 5.5 di angka $0,20, GPT-6.1 Sol di angka $0,10 (untuk input di bawah 272K), Kimi K3.1 Pro di angka $0,20, dan DeepSeek V4.1 Flash sebesar $0,003 di jam non-sibuk (off-peak) serta $0,006 di jam sibuk (peak). Semua satuan dalam USD per 1 juta token.
Ini bukan sekadar tabel kompromi yang dibuat serba seimbang. Jika Anda menjalankan siklus coding dengan prefix stabil dan input umumnya di bawah 272K, di antara tiga model closed-source, prioritaskan untuk melihat biaya pembacaan cache GPT-6.1 Sol terlebih dahulu. Kalau ingin memangkas biaya hingga satu tingkat lebih rendah lagi (turun satu ordo magnitudo), lirik biaya cache DeepSeek di jam non-sibuk. Tarif pembacaan cache Opus 5.5 dan Kimi sebenarnya identik; perbedaannya baru terlihat pada tarif input yang tidak terkena cache (cache miss), output, dan biaya penulisan cache (cache write).
Poin Utama: Setelah membaca ini, Anda bisa memilih model berdasarkan hit rate cache alih-alih cuma terpaku pada harga input dasar, sekaligus paham kenapa diskon enterprise yang ramai diberitakan sering kali tidak terasa di tagihan tim kecil.
💡 Saran Praktis: Keempat model ini bisa langsung Anda uji coba lewat APIYI apiyi.com cukup dengan satu kunci API yang sama, tinggal ganti nama modelnya saja. Pengguna baru juga mendapatkan kuota uji coba gratis. Kuncinya: buat prefix petunjuk tetap stabil terlebih dahulu, lalu pantau metrik pembacaan cache di laporan penggunaan—jangan buru-buru mengambil kesimpulan hanya dari satu sesi percakapan singkat.
Di Mana Letak Perbedaan Harga Cache Read dari Keempat Provider Ini?
Pertama, mari kita lihat harga cache read, lalu bandingkan proporsinya terhadap harga input yang miss (tidak tersimpan di cache). Rasio ini menentukan seberapa “murah” biaya pemrosesan dalam percakapan panjang. Untuk konteks pendek pada Opus 5.5 dan GPT-6.1 Sol, biayanya sama-sama 5% dari harga input normal. Kimi K3.1 Pro berada di angka 10%, sedangkan DeepSeek V4.1 Flash hanya 2%. Perbedaan harga absolutnya bahkan jauh lebih mencolok: tarif off-peak Flash yang cuma $0.003 itu setara 1/33 dari tarif konteks pendek Sol ($0.10), dan 1/67 dari tarif $0.20.
| Model | Cache Read | % dari Input Miss | Input Miss | Output |
|---|---|---|---|---|
| Claude Opus 5.5 | $0.20 | 5% | $4 | $20 |
| GPT-6.1 Sol, input ≤272K | $0.10 | 5% | $2 | $10 |
| GPT-6.1 Sol, input >272K | $0.20 | 5% | $4 | $15 |
| Kimi K3.1 Pro | $0.20 | 10% | $2 | $10 |
| DeepSeek V4.1 Flash (Off-peak) | $0.003 | 2% | $0.15 | $0.60 |
| DeepSeek V4.1 Flash (Peak) | $0.006 | 2% | $0.30 | $1.20 |
Semua satuan dalam USD per 1 juta token, hanya mengambil tingkatan standar (tidak termasuk diskon Batch, mode Fast, atau biaya tambahan regional). Opus 5.5 mengacu pada daftar harga Anthropic, dengan cache hit dihitung 0,05 kali lipat dari harga input. GPT-6.1 Sol berasal dari harga standar OpenAI; konteks pendek di sini berarti input tidak melebihi 272K token. Jika melewati batas tersebut, tarif cache read, input, dan output akan naik bersamaan—dengan tarif output menjadi $15, bukan $20. Kimi mengacu pada informasi publik Moonshot, di mana harga konteksnya tidak dibagi berdasarkan tingkatan. DeepSeek berasal dari halaman harga resmi dengan nama model deepseek-flash (versi DeepSeek-V4.1-Flash-1017). Jam sibuk (peak) berlangsung Senin–Jumat pukul 01:00–04:00 dan 06:00–10:00 UTC (di luar hari libur nasional Tiongkok), atau setara pukul 09:00–12:00 dan 14:00–18:00 waktu Beijing (WITA). Jeda waktu di antaranya, yakni 12:00–14:00, tetap dihitung sebagai jam santai (off-peak). Akhir pekan dan hari libur nasional Tiongkok berlaku tarif off-peak seharian penuh.
Di halaman daftar harga model APIYI (docs.apiyi.com/models) per katalog 25 Oktober 2026, claude-opus-5-5 tertera seharga $4 / $20 / $0.20, dan gpt-6.1-sol seharga $2 / $10 / $0.10 (dengan keterangan bahwa input menjadi $4 jika melebihi 272.000 token), sedangkan kimi-k3.1-pro berada di $2 / $10 / $0.20. DeepSeek dibagi menjadi dua baris: deepseek-v4.1-flash dan deepseek-flash dipatok $0.30 / $1.20 / $0.006 (sesuai jam peak resmi), sementara deepseek-v4-1-flash-260910 dipatok $0.15 / $0.60 / $0.003 (sesuai jam off-peak resmi). Jika pihak resmi beralih otomatis berdasarkan waktu tibanya permintaan, katalog APIYI memisahkan kedua set angka tersebut menjadi baris model tersendiri. Sebelum melakukan pemanggilan model, pastikan mengacu pada nama model yang tertera di konsol.
Biaya cache read sebenarnya baru separuh dari hitungan tagihan. Biaya penulisan (cache write) menentukan apakah Anda harus membayar biaya premi lagi begitu prefix kedaluwarsa. Perlu dicatat, tingkatan pendek dan panjang pada tabel berikutnya tidak bisa dibandingkan durasi menitnya secara langsung: tingkatan pendek OpenAI berdurasi 30 menit, sedangkan tingkatan pendek Anthropic dan Kimi adalah 5 menit.
| Model | Penulisan Durasi Pendek | Penulisan Durasi Panjang | Cara Prefiks Masuk Cache |
|---|---|---|---|
| Opus 5.5 | 5 menit, $5, 1,25x harga input | 1 jam, $8, 2x harga input | Perlu menyertakan cache_control dalam permintaan |
| GPT-6.1 Sol, ≤272K | 30 menit, $2,50, 1,25x harga input | 12 jam, $5, 2,5x harga input | Biaya penulisan dicantumkan terpisah; prefiks harus stabil |
| Kimi K3.1 Pro | 5 menit, $2, sama dengan harga input | 1 jam, $4, dihitung berdasarkan rasio 2x | Default otomatis 5 menit; untuk interval lebih lama perlu menentukan 1 jam |
| V4.1 Flash | Tanpa biaya penulisan terpisah | Tidak ada | Permintaan pertama dihitung sebagai miss, setelah itu dihitung sebagai pembacaan cache |
Kartu di beranda situs resmi Kimi mencantumkan biaya penulisan cache sebesar $2, yang mengacu pada durasi default 5 menit. Sementara tarif 1 jam sebesar $4 diambil dari harga konfigurasi di dokumentasi Kimi pada APIYI, dengan catatan bahwa tingkatan durasi cache ini belum diverifikasi penyelesaian tagihannya dalam pengujian putaran saat ini. Berdasarkan keterangan resmi Kimi K3 generasi sebelumnya, penulisan 1 jam adalah 2 kali lipat dari durasi 5 menit, sehingga jika K3.1 Pro mengikuti rasio yang sama, biayanya menjadi $4. Jika terdapat perbedaan dengan konsol, acuannya tetap data di konsol. Untuk versi berkecepatan tinggi kimi-k3.1-pro-highspeed, biaya input dan outputnya berlipat ganda, tetapi pembacaan cache tetap $0,20. Ketika ada banyak prefiks yang cocok (cache hit), selisih antara kedua tingkatan durasi tersebut akan makin mengecil.
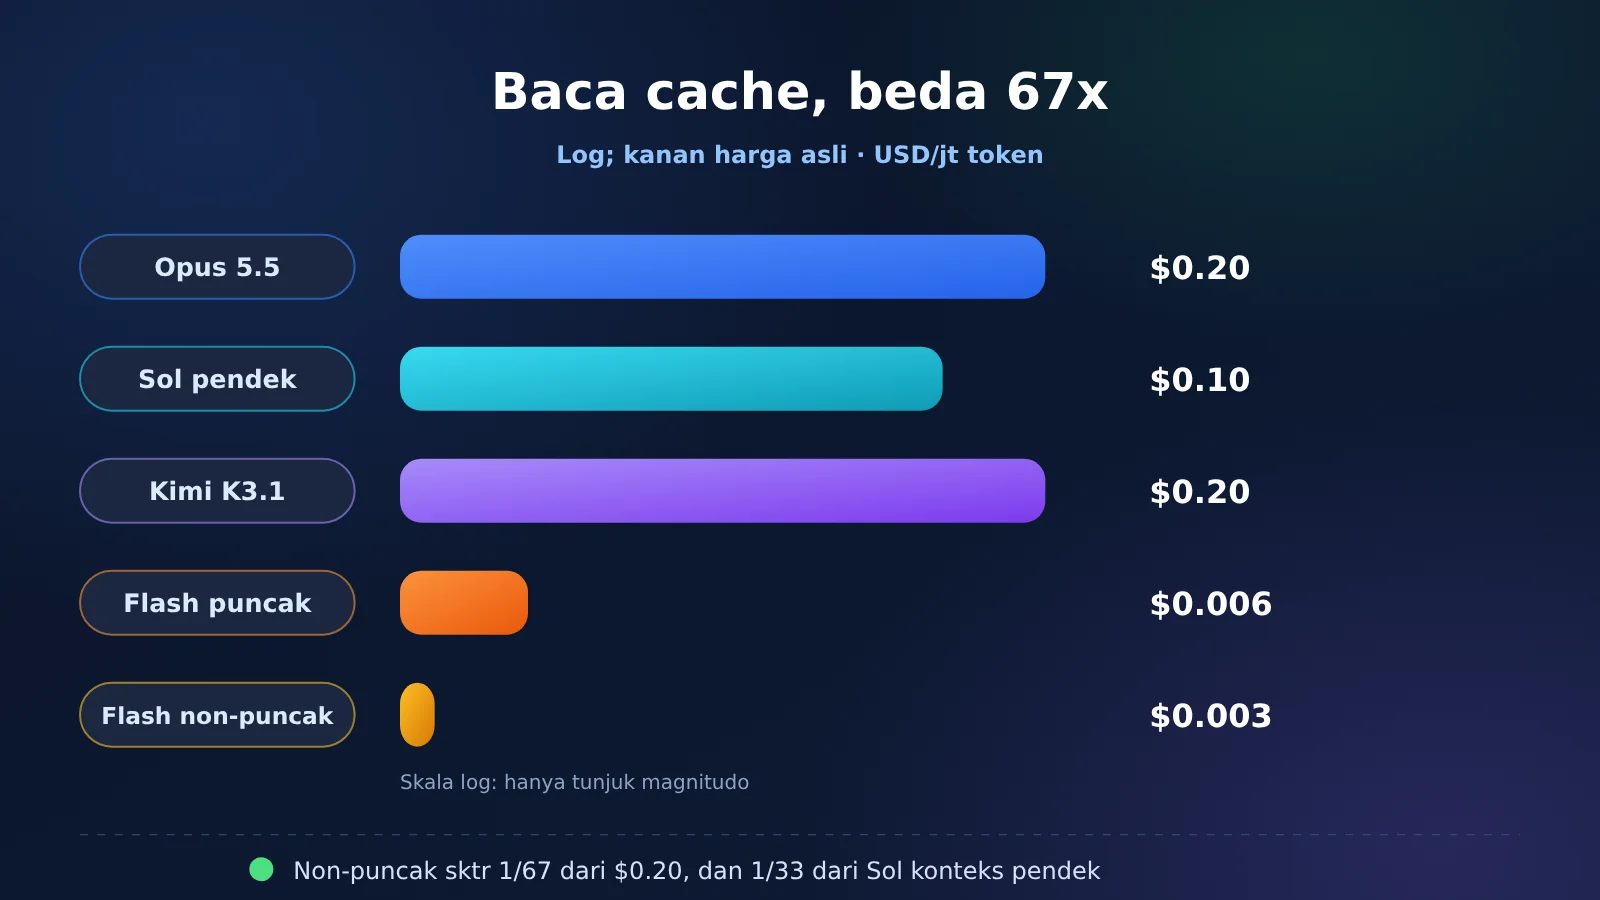
Panjang batang pada grafik di atas hanya untuk membantu melihat perbandingan skala besarannya. Perhitungan tagihan tetap menggunakan harga asli dikalikan jumlah token. Setelah beralih model menggunakan kunci API yang sama, selalu jadikan kolom pembacaan cache di konsol APIYI sebagai acuan, dan hindari memperkirakan estimasi biaya hanya dari grafik ini.
Mengapa Tagihan Coding Agent Perlu Memisahkan Pembacaan Cache?
Di setiap putaran, Agent akan mengirim ulang petunjuk sistem, definisi tools, dan riwayat percakapan sebelumnya. Bagian prefiks yang tidak berubah berpeluang ditagih berdasarkan tarif pembacaan cache (cache read). Begitu prefiksnya berubah, bagian setelah titik perubahan tersebut akan dihitung sebagai cache miss, dan beberapa penyedia layanan bahkan mengenakan biaya tambahan untuk penulisan cache (cache write). Jadi, penurunan harga input sebesar 20% tidak serta-merta berarti tagihan satu sesi coding turun 20%. Jika pembacaan cache menyumbang porsi token terbesar, kolom pembacaan cache-lah yang sebenarnya wajib Anda cermati.
Angka 96%–99% yang disebut Max Woolf merujuk pada “total pengeluaran token”. Kata expenditure dalam bahasa Inggris bisa bermakna pengeluaran biaya, tetapi bisa juga berarti konsumsi token. Artikel aslinya tidak mencantumkan angka penyebutnya (denominator). Pengukuran pihak ketiga lainnya menjelaskan metrik ini secara lebih gamblang: WorkloadBench (diperbarui 16-10-2026) mencatat bahwa dalam tugas coding berdurasi panjang, sekitar 89%–96% token petunjuk berasal dari cache. Median untuk GPT-6.1 Sol dan Claude Opus 5.5 sama-sama berada di angka 95%, dengan rentang masing-masing 91%–98% dan 94%–99% (sumber: workloadbench.brenhq.com/cache). Perlu dicatat, angka tersebut adalah proporsi dari token petunjuk—penyebutnya tidak menyertakan output, apalagi persentase dalam mata uang dolar. Jadi, kedua data ini tidak bisa digabungkan begitu saja menjadi “96% dari total tagihan”.
Porsi biaya dalam dolar biasanya jauh lebih rendah, karena tarif per token output puluhan hingga ratusan kali lipat lebih mahal dibanding pembacaan cache. Di bawah ini, kita hitung ulang menggunakan serangkaian asumsi eksplisit untuk melihat struktur biayanya. Simulasi ini murni untuk membedah komposisi pengeluaran, bukan rincian asli penulis maupun log pengujian artikel ini. Asumsikan ada 40 putaran: setiap putaran menghasilkan 120.000 token pembacaan cache, 1.500 token baru yang kena cache miss, dan 800 token output. Di awal sesi, ada 40.000 token yang ditulis ke cache satu kali. Angka 40.000 ini tidak dihitung ulang sebagai cache miss. DeepSeek tidak mengenakan biaya penulisan cache, jadi 40.000 token ini dicatat sebagai cache miss. Input per putaran sekitar 120 ribu token, yang masuk dalam rentang jendela konteks pendek Sol.
Total token mencapai 4.932.000, dengan pembacaan cache menyumbang 4.800.000 token, atau sekitar 97%. Hal ini membuktikan bahwa di bawah asumsi “prefiks panjang, banyak putaran, dan output per putaran pendek”, volume token memang bisa menyentuh rentang yang disebutkan penulis tersebut.
| Model | Pembacaan Cache | Cache Miss | Output | Penulisan atau Miss Pertama | Total | Porsi Cache dalam Dolar |
|---|---|---|---|---|---|---|
| Opus 5.5, penulisan 5 menit | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | Sekitar 47% |
| GPT-6.1 Sol, ≤272K, penulisan 30 menit | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | Sekitar 47% |
| Kimi K3.1 Pro, penulisan 5 menit | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | Sekitar 65% |
| V4.1 Flash Off-peak | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | Sekitar 30% |
| V4.1 Flash Peak | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | Sekitar 30% |
Tarif empat komponen konteks pendek untuk Opus dan Sol tepat berselisih 2 kali lipat, sehingga proporsi persentasenya identik, dengan total biaya Sol tepat separuh dari Opus. Pembacaan cache Kimi dipatok 10% dari tarif input (bukan 5%). Dengan struktur token yang sama, biaya pembacaan cache Kimi mencapai sekitar 65% dengan total $1.48, berada di antara keduanya. Untuk Flash, total biayanya sekitar $0.049 pada jam sepi (off-peak) dan naik dua kali lipat pada jam sibuk (peak). Karena tarif pembacaan cachenya hanya 2% dari cache miss, porsi biaya dolar terbesar pada skenario ini kembali ke output (sekitar 40%), sementara pembacaan cache menyumbang sekitar 30%. Di antara tiga model flagship tersebut, pembacaan cache tetap menjadi pos pengeluaran terbesar dalam simulasi tagihan ini. Flash memangkas biaya dari skala besarannya (magnitude) secara menyeluruh, bukan karena mengikuti struktur biaya 96% dalam dolar.
Kalau awalan (prefix) berubah di setiap putaran, tabel di atas jadi tidak berlaku lagi. Timestamp, urutan daftar tool yang diacak, atau nama pengguna yang disisipkan di tengah petunjuk sistem (system prompt) bakal langsung menggagalkan cache hit. Kalau sudah begitu, yang perlu dibandingkan adalah harga cache miss dan harga tulis (cache write).
Biaya penulisan 5 menit Opus adalah 1,25 kali lipat dari harga input; penulisan 30 menit Sol juga 1,25 kali lipat, sedangkan durasi 12 jam mencapai 2,5 kali lipat. Penulisan 5 menit Kimi sama dengan harga input standar tanpa ada biaya tambahan (premi) untuk durasi singkat. Sementara untuk DeepSeek, pemanggilan pertama langsung dikenakan harga cache miss.
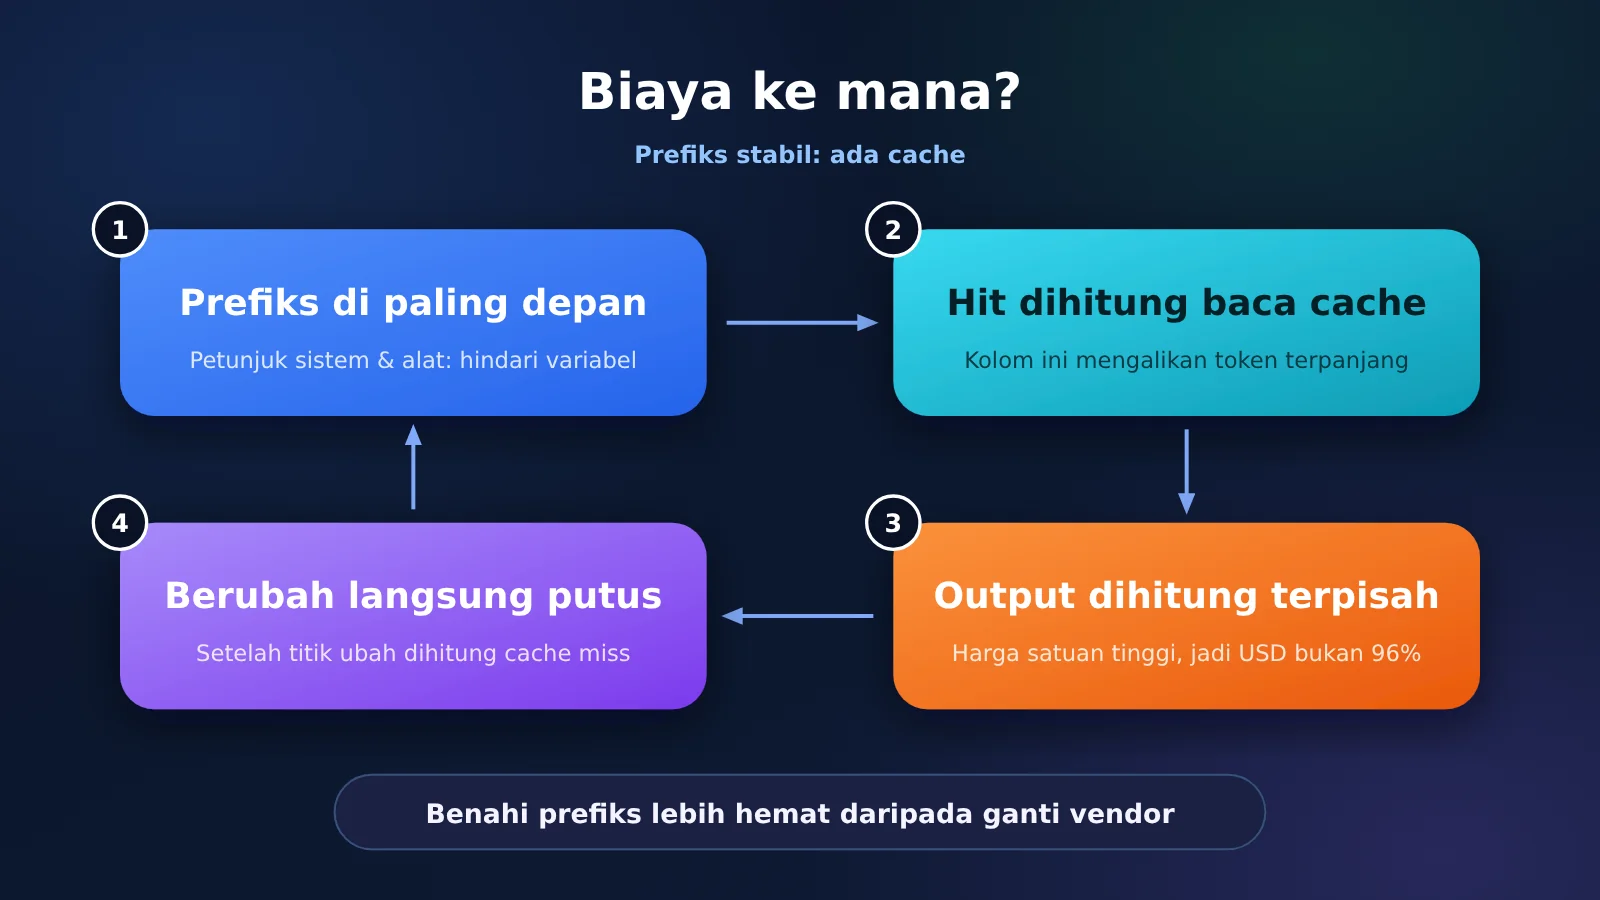
Merapikan prefix biasanya bisa menghemat biaya lebih cepat daripada buru-buru ganti penyedia model. Pastikan urutan daftar tool tetap konsisten, taruh konten dinamis di bagian paling akhir pesan, dan usahakan jeda antar-permintaan dalam sesi yang sama tidak melebihi batas TTL durasi singkat. Setelah optimasi ini selesai dilakukan, barulah bandingkan harga baca cache untuk menentukan pilihan terbaik.
Apa yang Ditunjukkan oleh Lini Masa Penurunan Harga Selama Empat Bulan Ini?
Klaim “turun hingga 80%” memang benar pada dua hal, tetapi jangan diartikan bahwa semua model dipangkas harganya sebesar 80%. Poin pertama dicatat oleh Max Woolf: pada 30-07-2026, OpenAI memangkas harga GPT-5.6 Luna dari $1 / $6 / $0,10 menjadi $0,20 / $1,20 / $0,02—biaya input dan pembacaan cache sama-sama turun sekitar 80%. Poin kedua adalah biaya pembacaan cache pada lini produk Sol, yang turun dari $0,50 pada GPT-5.6 Sol (26-06-2026) menjadi $0,10 pada GPT-6.1 Sol (29-09-2026), yang juga setara dengan penurunan 80%. Namun, serinya sendiri sudah berganti dari 5.6 ke 6.1, jadi ini bukan sekadar SKU yang sama yang ditempeli label diskon.
| Tanggal | Perubahan yang Dicatat | Input / Output / Pembacaan Cache |
|---|---|---|
| 2026-06-26 | OpenAI merilis GPT-5.6 Sol dan Luna | Sol $5 / $30 / $0,50 |
| 2026-06-30 | Anthropic merilis Sonnet 5, saat itu menyebut harga rilis bersifat sementara | $2 / $10 / $0,20 |
| 2026-07-24 | Anthropic merilis Opus 5 | $5 / $25 / $0,50 |
| 2026-07-30 | Pemotongan harga GPT-5.6 Luna | $0,20 / $1,20 / $0,02 |
| 2026-08-21 | GPT-5.6 Sol diskon sementara sekitar 20% selama tiga bulan | $4 / $20 / $0,40 |
| 2026-09-01 | Fable 5.1, pembacaan cache lebih murah dibanding Fable 5 versi Juni | $10 / $50 / $0,25 |
| 2026-09-22 | GPT-6 Sol dan Opus 5.5 dirilis di hari yang sama | Sol $2 / $10 / $0,20; Opus 5.5 $4 / $20 / $0,20 |
| 2026-09-29 | GPT-6.1 Sol, biaya pembacaan cache dipangkas setengahnya lagi | $2 / $10 / $0,10 |
Tabel di atas merupakan rangkuman dari Max Woolf, dengan urutan kolom: input, output, dan pembacaan cache. Data yang telah kami verifikasi silang adalah harga terkini pada dua baris terakhir: tarif Opus 5.5 sebesar $4 / $20 / $0,20 cocok dengan daftar harga resmi Anthropic; sedangkan GPT-6.1 Sol sebesar $2 / $10 / $0,10 sesuai dengan tier standar OpenAI untuk konteks pendek. Baris-baris sebelumnya tidak diverifikasi satu per satu ke pengumuman aslinya, jadi silakan merujuk ke artikel aslinya jika ingin mengutip secara presisi.
Woolf juga menyebutkan bahwa total biaya untuk Opus 5.5 turun sekitar 40%–60%. Dari daftar harga resmi, yang bisa kita pastikan adalah tiga harga satuan: dibanding Opus 5, biaya input dan output masing-masing turun 20% ($5 menjadi $4, $25 menjadi $20), sementara pembacaan cache turun dari $0,50 menjadi $0,20 (turun 60%). Angka 40%–60% tersebut adalah estimasi kisaran berdasarkan struktur pemakaian tipikal, bukan diskon flat dari penyedia. Pihak Anthropic sendiri menyatakan bahwa komputasi inferensi Opus 5.5 lebih hemat dibanding Opus 5, dan penetapan harganya mencerminkan hal tersebut. Tentu ini merupakan klaim langsung dari pihak vendor.
Ia juga mencatat bahwa DeepSeek V4.1 Flash di API bawaan DeepSeek dipatok sekitar $0,15 / $0,60 / $0,003. Angka ini sesuai dengan tarif resmi di luar jam sibuk (off-peak), sedangkan pada jam sibuk tarifnya naik dua kali lipat. Untuk Kimi K3.1 Pro, ia mencantumkan $2 / $10 / $0,20, sesuai dengan informasi harga di situs resminya. Mengenai skor Artificial Analysis yang disebutkan—Kimi 55, Opus 5.5 sebesar 58, dan Flash 45—angka tersebut merupakan indeks pihak ketiga, bukan hasil pengujian coding dari artikel ini, jadi jangan hanya bergantung pada selisih skor tipis ini saat memilih model.
Cara Tim Kecil Memilih Model Saat Tidak Punya Diskon Enterprise
Selain harga publik, sebenarnya ada tingkat diskon khusus yang hanya bisa dinikmati oleh klien-klien kakap. AI Weekly pada 24-10-2026 mengutip laporan The Information: OpenAI memberikan diskon lebih dari 30% untuk mengamankan kontrak tahunan senilai lebih dari $100 juta, yang membuat Replit mengalihkan sebagian besar pengeluaran AI mereka dari Anthropic ke OpenAI. Laporan tersebut menyebutkan bahwa Anthropic tidak memperpanjang diskon yang sebelumnya diberikan kepada Replit. Kendati demikian, laporan ini tidak menyertakan konfirmasi publik resmi dari ketiga pihak tersebut. CEO Replit, Amjad Masad, sempat menyatakan di TechCrunch Disrupt bahwa keputusan tersebut murni didasarkan pada pertimbangan biaya, kemitraan, dan performa. Laporan yang sama juga mencatat bahwa model Claude masih tetap tersedia sebagai opsi, namun OpenAI kini menjadi default untuk Agent mereka. Artikel tersebut juga menyebutkan bahwa beban kerja coding di Rippling beralih dari Anthropic ke OpenAI karena pertimbangan efisiensi biaya. Sekali lagi, semua ini baru sebatas laporan media, bukan rilis daftar harga resmi gabungan dari ketiga perusahaan.
Tim kecil jelas tidak bisa menyamai skala kontrak seperti itu. Tanpa komitmen tahunan sebesar $100 juta, jangan harap bisa mendapatkan diskon 30% seperti yang diberitakan. Seandainya kita hitung kasar diskon 30% tersebut langsung pada pembacaan cache (cache read) Opus sekalipun, biayanya turun dari $0,20 menjadi $0,14—angka ini masih tetap lebih mahal dibandingkan harga publik GPT-6.1 Sol untuk konteks pendek yang berada di $0,10. Laporan tersebut memang tidak merinci apakah diskon berlaku untuk pembacaan cache, cache miss, atau total tagihan. Namun, perbandingan ini memberi gambaran kasar: harga publik untuk pembacaan cache sebenarnya sudah sangat cukup bagi tim kecil untuk menentukan pilihan di tahap awal.
| Karakteristik Sesi | Rekomendasi Utama | Alasan |
|---|---|---|
| Prefiks stabil, input biasanya di bawah 272K, butuh model coding closed-source | GPT-6.1 Sol | Pembacaan cache $0,10, paling murah di antara ketiganya |
| Input satu kali panggilan melebihi 272K | Jangan patok harga $0,10 | Pembacaan cache Sol naik menjadi $0,20, output melonjak jadi $15 |
| Anggaran pembacaan cache setara Opus, tetapi ingin biaya cache miss dan output lebih murah | Kimi K3.1 Pro | Pembacaan cache sama-sama $0,20, tarif input/output di $2 / $10 tanpa pembagian tingkatan (tier) |
| Rasio cache hit tinggi, eksekusi tugas bisa menghindari jam sibuk | DeepSeek V4.1 Flash (jam santai / off-peak) | Pembacaan cache hanya $0,003, selisih tagihannya terpaut satu tingkat ordo besaran |
| Harus dijalankan di jam kerja (waktu Beijing 09:00–12:00, 14:00–18:00) | Hitung ulang Flash dengan tarif jam sibuk (peak) | Pembacaan cache menjadi $0,006, tarif satuan lainnya juga naik dua kali lipat |
| Prefiks selalu berubah di setiap putaran | Benahi prefiks terlebih dahulu | Kolom tarif pembacaan cache tidak akan memberi dampak penghematan |
Tabel di atas tidak memeringkat kemampuan atau kecerdasan model. Max Woolf berpendapat bahwa Opus 5.5 lebih unggul dibanding Fable 5.1 yang lebih mahal, namun itu adalah penilaian subjektif dari pengalaman penggunaannya. Pihak DeepSeek sendiri secara resmi mengonfirmasi bahwa deepseek-flash kini dialihkan ke DeepSeek-V4.1-Flash-1017; identifier lama deepseek-v4-flash masih bisa digunakan dan ditagih dengan tarif Flash, sementara deepseek-v4-pro masih dijual terpisah. DeepSeek tidak merilis perbandingan performa resmi antara Flash dan Pro. Rumus praktisnya sederhana: jika risiko kerugian akibat kegagalan tugas jauh lebih mahal daripada selisih harga token, pakailah model premium. Namun jika biaya kegagalan lebih murah daripada selisih tersebut, manfaatkan Flash untuk menyelesaikan perulangan (loop) tugas Anda.
💰 Optimasi Biaya: Harga katalog adalah harga patokan standar. Dasbor APIYI apiyi.com akan menampilkan harga setelah diskon berdasarkan grup akun Anda, di luar promo pengisian saldo yang aturannya tercantum transparan pada halaman harga. Ini adalah skema harga terbuka yang berlaku untuk semua orang, bukan kontrak tahunan tertutup hasil negosiasi tim sales. Pemotongan biaya aktual tetap mengacu pada nominal di dasbor.
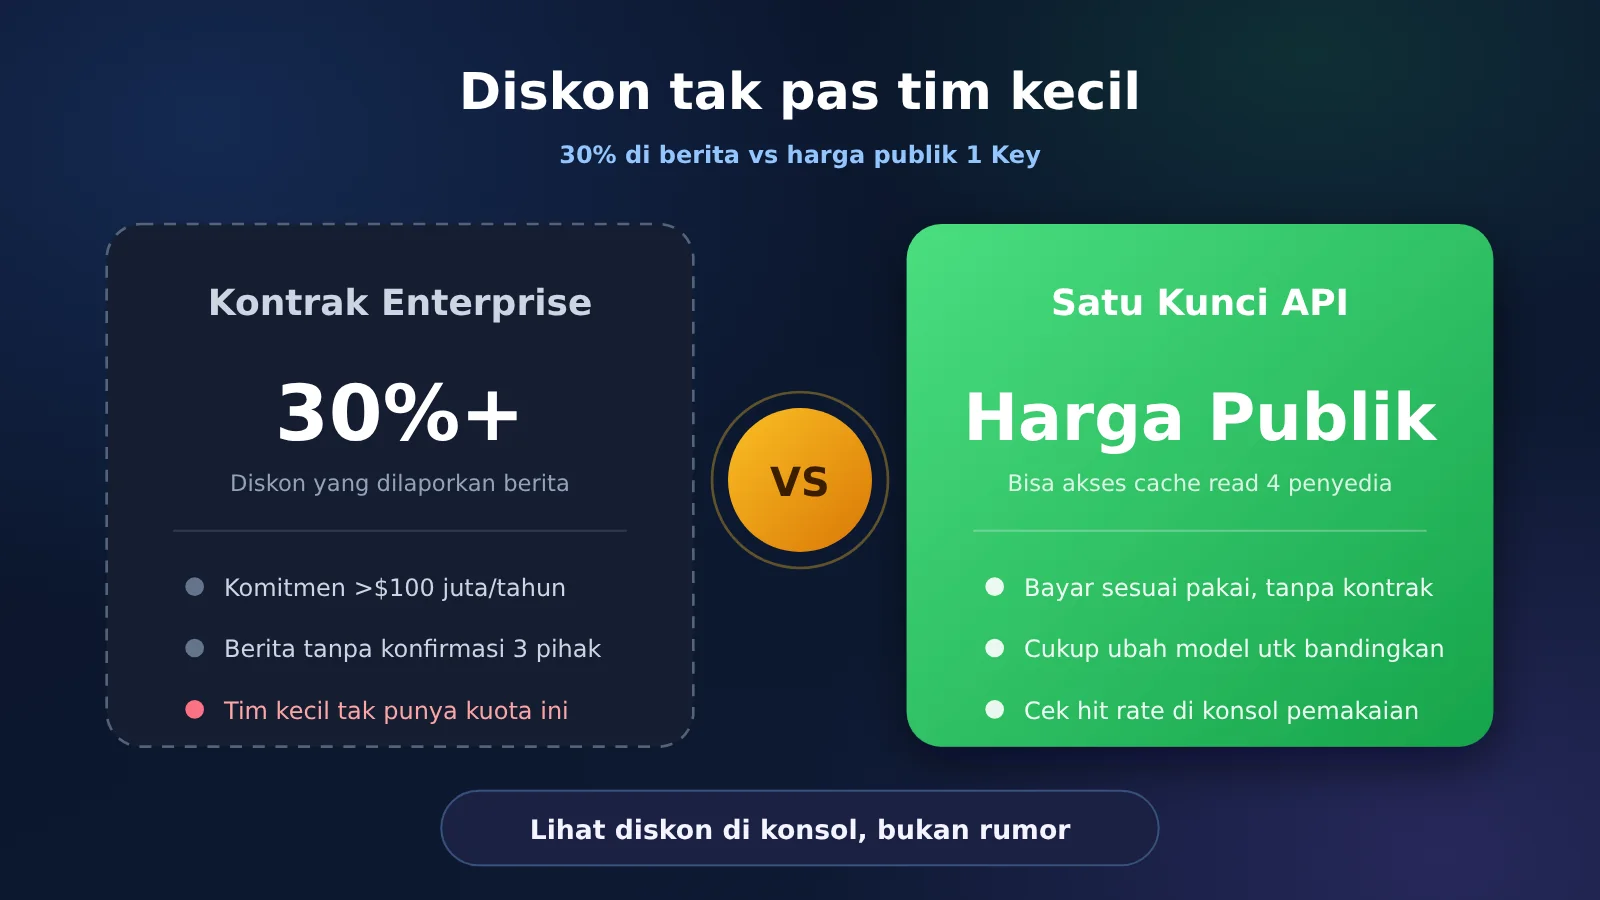
Diskon 30% dan nilai $100 juta di sisi kiri hanyalah angka dari laporan berita, bukan opsi harga yang bisa langsung kita beli. Sisi kananlah jalur realistis yang benar-benar bisa langsung diterapkan oleh tim kecil.
Cara Mengecek Cache Read dari Empat Penyedia dengan Satu Kunci API
Halaman harga menyarankan agar model GPT-5 ke atas memprioritaskan endpoint /v1/responses, karena cache multi-turn lebih mudah mengalami hit. Chat Completions tetap bisa digunakan. Contoh di bawah sengaja memakai Chat Completions agar kamu cukup mengganti nama model untuk gpt-6.1-sol, kimi-k3.1-pro, dan deepseek-flash. Namun, caching untuk Opus 5.5 bukanlah perilaku bawaan di jalur ini. Cara Anthropic mengaktifkannya saat ini adalah dengan menaruh cache_control di level teratas request, atau memasang breakpoint pada blok konten. APIYI menyediakan endpoint chat sekaligus messages untuk claude-opus-5-5. Jika ingin mendapatkan skema harga cache, gunakan messages dan sertakan cache_control. Kalau kamu hanya memakai Chat Completions, jangan menganggap tarif $0.20 di katalog sudah otomatis berlaku.
- Pasang dependensi dasar: Jika belum menginstal SDK, jalankan
pip install openaiterlebih dahulu. Di awal berkas kode, tambahkanimport osdanfrom openai import OpenAI. Simpan kunci API di environment variableAPIYI_API_KEY, jangan dimasukkan ke repositori. - Inisialisasi klien: Cukup satu baris
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"), base URL hanya perlu diatur di sini. - Kunci prefix statis: Simpan petunjuk sistem dan definisi tools di
STABLE_PREFIXtanpa diubah sama sekali; masukkan konten dinamis baru untuk putaran tersebut keuser_turn, dan pastikan posisinya selalu berada di urutan paling akhir. - Kirim request: Jalankan
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}]). Ganti parametermodelmenjadikimi-k3.1-proataudeepseek-flashuntuk menguji dua penyedia lainnya. - Baca pemakaian: Pertama ambil
details = resp.usage.prompt_tokens_details, lalucached = getattr(details, "cached_tokens", 0) or 0, dan terakhirprint(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens). Tiga angka ini berturut-turut menunjukkan token petunjuk, token yang hit cache, dan token output.
Jalankan beberapa putaran berturut-turut, lalu bagi jumlah token yang hit dengan total token petunjuk untuk menghitung persentase hit rate-mu sendiri. Kalikan jumlah token yang hit tersebut dengan harga satuan cache read masing-masing penyedia untuk mengetahui biaya riilnya dalam dolar. Dokumentasi Kimi menyatakan bahwa tier cache mereka mengacu pada harga konfigurasi, dan tagihan akhir tetap mengacu pada konsol. Jika ingin memanfaatkan tarif off-peak DeepSeek, periksa nama model di katalog seperti deepseek-v4-1-flash-260910—jangan berasumsi deepseek-flash akan otomatis berganti harga mengikuti jam.
Pastikan kunci API disimpan di environment variable APIYI_API_KEY dan tidak di-commit ke repositori. Kuota uji coba gratis sangat pas dipakai untuk menguji prefix yang sama di keempat model selama beberapa putaran, khusus untuk membandingkan struktur pemakaian tokennya. Baru tambahkan variasi dan putaran pengujian ketika diperlukan, alih-alih langsung membebani keempat model dengan data repositori yang sangat besar sejak awal.
Pertanyaan Umum Seputar Perbandingan Pembacaan Cache (Cache Read)
Q1: Apakah 96% berarti pembacaan cache menyumbang 96% dari total tagihan?
Bukan begitu kesimpulan dari artikel ini. Max Woolf menuliskan bahwa pembacaan cache mencakup 96%–99% dari total pengeluaran token, tanpa menyebutkan angka penyebut secara terbuka, sehingga ini merupakan estimasi pihak ketiga. Pengujian WorkloadBench mencatat porsi 89%–96% dari token petunjuk, belum termasuk output. Berdasarkan simulasi asumsi dalam artikel ini, porsi token memang sekitar 97%, tetapi dari segi nominal dolar, porsinya sekitar 47% di Opus dan Sol, sekitar 65% di Kimi, dan sekitar 30% di Flash.
Q2: Kenapa pembacaan cache Sol terkadang $0,10 dan terkadang $0,20?
Semua tergantung pada panjang input dalam satu kali request. Jika tidak melebihi 272K token, tarif pembacaan cache standar OpenAI adalah $0,10. Jika melebihi batas tersebut, tarifnya menjadi $0,20, di mana input yang tidak masuk cache (cache miss) juga naik menjadi $4 dan output menjadi $15. Katalog APIYI mencantumkan tarif konteks pendek sebesar $2 / $10 / $0,10, serta memberi catatan bahwa input berubah menjadi $4 setelah melebihi 272.000 token. Untuk output dan pembacaan cache pada konteks panjang tetap mengacu pada tier standar OpenAI; jika konsol menampilkannya terpisah per tier, gunakan angka di konsol sebagai acuan.
Q3: Kenapa DeepSeek punya dua skema harga pembacaan cache?
Pihak resmi menerapkan harga berdasarkan jam sibuk (peak) dan jam lengang (off-peak), di mana tarif jam lengang adalah setengah dari jam sibuk. Pembacaan cache saat jam lengang dipatok $0,003, sedangkan saat jam sibuk $0,006. Jam sibuk berlaku pada hari kerja pukul 09:00–12:00 dan 14:00–18:00 waktu Beijing (hasil konversi dari jendela waktu UTC resmi), di luar hari libur nasional Tiongkok. Akhir pekan dan hari libur nasional otomatis menggunakan tarif jam lengang sepanjang hari. Katalog APIYI menampilkan kedua kelompok angka ini dalam baris model yang terpisah.
Q4: Apakah tim kecil bisa mendapatkan diskon 30% seperti pelanggan enterprise?
Diskon yang ramai diberitakan tersebut mensyaratkan kontrak tahunan bernilai lebih dari 100 juta dolar AS, dan laporan itu pun belum dikonfirmasi secara terbuka oleh ketiga penyedia. Tim skala kecil tentu belum memiliki komitmen volume sebesar itu. Namun, membandingkan tarif pembacaan cache publik saja sudah sangat cukup untuk tahap evaluasi awal. Untuk diskon grup dan promo top-up, selalu jadikan konsol APIYI sebagai acuan, dan jangan disamakan dengan program diskon enterprise tersebut.
Q5: Bagaimana cara menghubungkan keempat penyedia hanya dengan satu kunci API?
Cukup buat satu kunci API di APIYI apiyi.com, lalu arahkan base URL request ke `https://api.apiyi.com/v1`. Model `gpt-6.1-sol`, `kimi-k3.1-pro`, dan `deepseek-flash` bisa langsung menggunakan format Chat Completions, tinggal ganti nama modelnya saja. Khusus `claude-opus-5-5`, jika ingin memanfaatkan skema harga cache, gunakan endpoint `messages` dan sertakan parameter `cache_control`. Untuk GPT-5 ke atas, jika Anda mengejar hit rate multi-turn yang lebih optimal, dokumentasi harga menyarankan beralih ke endpoint `/v1/responses`.
Q6: Karena pembacaan cache sangat murah, apakah sebaiknya langsung ganti model default ke Flash?
Lakukan hal ini hanya jika risiko atau biaya kegagalan (failure cost) lebih rendah daripada selisih harganya. Berdasarkan simulasi, estimasi tagihan di jam lengang memang sekitar seperdua puluh dari Sol ($0,0486 berbanding $1,02), dan di jam sibuk sekitar sepersepuluhnya. Namun, jika Flash membutuhkan beberapa putaran (turn) tambahan untuk menyelesaikan tugas yang sama persis, pengulangan tersebut justru akan menghabiskan selisih hematnya. Sebaiknya gunakan kuota gratis terlebih dahulu untuk membandingkan jumlah putaran penyelesaian tugas pada awalan (prefix) yang sama sebelum menetapkannya sebagai model default.
Q7: Apakah biaya penulisan cache bisa lebih mahal daripada pembacaan cache?
Bisa, terutama jika prefix sering kedaluwarsa dan frekuensi hit-nya sangat sedikit. Biaya penulisan tier pendek di Opus dan Sol adalah 1,25 kali lipat dari harga input biasa, bahkan tier 12 jam di Sol mencapai 2,5 kali lipat. Sementara di Kimi, biaya penulisan 5 menit setara dengan harga input standar. Pembacaan cache baru benar-benar menjadi penghematan utama setelah terjadi hit minimal 2 sampai 3 putaran. Untuk tugas dengan jeda request yang tidak menentu, prioritaskan pemilihan TTL yang tepat sebelum mulai membandingkan harga pembacaan cache.
Poin Utama Perbandingan Pembacaan Cache (Cache Read)
- 96% adalah estimasi pihak ketiga: Max Woolf tidak merilis log publiknya. Proporsi biaya dalam dolar harus kamu hitung sendiri dengan mengalikan volume dengan harga satuan.
- Perhatikan pembacaan cache terlebih dahulu, lalu cek apakah ada kenaikan tier: Begitu Sol melampaui 272K, biaya pembacaan cache melonjak dari $0,10 menjadi $0,20.
- Biaya pembacaan cache Opus dan Kimi sama-sama $0,20: Biaya cache miss dan output pada Kimi lebih murah, serta penulisan cache untuk tier pendek tidak dikenakan biaya tambahan.
- Keunggulan Flash ada pada perbedaan tingkat besaran harga: $0,003 saat jam sepi (off-peak) dan $0,006 saat jam sibuk (peak). Struktur biaya dolar tidak lagi didominasi oleh pembacaan cache semata.
- Diskon enterprise 30% tidak berlaku untuk tim kecil: Itu adalah angka kontrak tahunan yang ramai diberitakan. Harga publik sebenarnya sudah cukup untuk pertimbangan tahap awal.
- Satu kunci API cukup untuk mengakses keempat penyedia: Cukup ganti nama model di APIYI apiyi.com, dan hit rate yang valid mengacu langsung pada penggunaan di konsol.
Kesimpulan
Dalam empat bulan terakhir, penurunan harga publik tercatat hingga 80%, dengan penyesuaian terbesar ada pada harga resmi Luna serta biaya pembacaan cache lini Sol yang terpangkas dari $0,50 ke $0,10. Bagi Agent pembuat kode, komponen pembacaan cache tetap wajib dipisahkan dalam kalkulasi. Berdasarkan harga resmi per 26 Oktober 2026, pada konteks pendek biaya pembacaan cache GPT-6.1 Sol berada di angka $0,10, Opus 5.5 dan Kimi K3.1 Pro di $0,20, sementara DeepSeek V4.1 Flash berkisar antara $0,003 di jam sepi hingga $0,006 di jam sibuk. Angka 96%–99% hanya menjadi referensi dari analisis Max Woolf. Pada simulasi tagihan nyata, persentase token mungkin mendekati kisaran tersebut, tetapi porsi tagihan dalam dolarnya akan jauh lebih rendah.
Diskon korporat yang ramai dibicarakan menuntut komitmen kontrak tahunan—sesuatu yang sulit dijangkau tim kecil. Menghubungkan keempat model tersebut lewat satu kunci API yang sama, lalu mengalikan hit rate tim kamu dengan tarif publik pembacaan cache, jauh lebih praktis ketimbang menunggu tawaran kontrak diskon 30%. Kami sarankan untuk menguji prefix tetap yang sama di APIYI apiyi.com terlebih dahulu sebelum memutuskan model default yang akan digunakan.
Penulis: Tim Teknis APIYI
Diskusi Teknis: Jangan ragu untuk menghubungi kami melalui beranda situs web APIYI. Untuk rincian harga satuan model terbaru, silakan merujuk ke halaman harga model di pusat dokumentasi docs.apiyi.com.
Referensi
- Max Woolf, Garis Waktu Penurunan Harga dan Estimasi 96%–99%
- Tautan:
minimaxir.com/2026/10/cheap-llms -
Keterangan: 25-10-2026. Angka 96%–99% merupakan klaim dari penulis sendiri, bukan hasil pengujian di artikel ini.
-
Harga Model Anthropic
- Tautan:
platform.claude.com/docs/en/about-claude/pricing -
Keterangan: Harga input, output, pembacaan cache, dan dua tingkatan penulisan cache untuk Opus 5.5.
-
Harga Model OpenAI
- Tautan:
developers.openai.com/api/docs/pricing -
Keterangan: Konteks pendek, konteks panjang, pembacaan cache, dan penulisan cache untuk GPT-6.1 Sol. Batas 272K adalah patokan resmi untuk pemisah konteks pendek dan panjang.
-
Harga Model DeepSeek
- Tautan:
api-docs.deepseek.com/quick_start/pricing -
Keterangan: Harga cache hit jam sibuk dan non-sibuk, harga cache miss, serta harga output untuk
deepseek-flash. -
API Kimi
- Tautan:
platform.kimi.ai -
Keterangan: Harga input, output, cache hit, dan penulisan default untuk Kimi K3.1 Pro.
-
Pemberitaan AI Weekly Mengenai Kontrak Replit
- Tautan:
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
Keterangan: Diskon di atas 30% dan pengeluaran tahunan melebihi 100 juta USD ini bersumber dari laporan The Information; ketentuan tersebut belum dikonfirmasi secara publik oleh ketiga pihak terkait.
-
Proporsi Token Cache WorkloadBench
- Tautan:
workloadbench.brenhq.com/cache - Keterangan: 16-10-2026. Merupakan proporsi token petunjuk yang berasal dari cache, bukan proporsi biaya dalam nilai dolar.


