Catatan penulis: Membandingkan Gemini 4 Neon dan GPT-6.2 Sol secara terpisah pada tiga aspek—coding, diagram, dan konteks panjang—lalu memeriksa biaya per tugas, waktu eksekusi, harga resmi per unit, dan harga rak APIYI, dengan sumber dicantumkan untuk setiap angka.
Banyak tim menganggap GPT-6.2 Sol sebagai opsi yang lebih murah. Gemini 4 Neon dirilis pada 2026-11-18, dan halaman model Artificial Analysis memberikan skor kecerdasan 61, sedangkan Sol 57. Di tugas mana keempat poin ini muncul, itulah yang menentukan berapa nilainya bagi beban kerja Anda. Artikel ini melihat coding, diagram, dan konteks panjang sebagai tiga hal terpisah, lalu membagi biaya per tugas dan harga satuan menjadi dua pembukuan.
Setiap angka dalam artikel ini membawa label sumber: klaim resmi, kartu model, halaman model Artificial Analysis, artikel Artificial Analysis, tabel ringkasan APIYI, API harga. Angka yang tidak cocok antara dua metode akan dipertahankan berdampingan, tidak dirata-ratakan, dan tidak digabung menjadi angka baru.
Nilai inti: Setelah membaca, Anda dapat menjelaskan dengan jelas di item mana skor lebih Neon muncul, di item mana Sol justru lebih tinggi, berapa selisih biaya per tugas dan waktu eksekusi keduanya, serta bagaimana memanggil gpt-6.2-sol yang sudah tersedia di APIYI.
Ringkasan Cepat Perbedaan Inti Gemini 4 Neon dan GPT-6.2 Sol
Mari letakkan tujuh baris paling penting terlebih dahulu. Perhatikan levelnya: di halaman model Artificial Analysis, skor 61 milik Neon diambil dari level xhigh, sedangkan skor 57 milik Sol diambil dari level max. Keduanya adalah level tertinggi di halaman masing-masing, tetapi nama dan arti levelnya berbeda.
| Dimensi perbandingan | Gemini 4 Neon | GPT-6.2 Sol | Sumber |
|---|---|---|---|
| Skor kecerdasan komprehensif | 61 (xhigh) | 57 (max) | Halaman model Artificial Analysis |
| Pengkodean: Terminal-bench 4.1 (akurasi setelah koreksi kecurangan) | 65,2% | 61,5% | Kartu model |
| Grafik: Chartography | 73,5% | 75,1% | Kartu model |
| Konteks panjang: GraphWalks (256k hingga 1M, F1 BFS) | 95,2% | 80,1% | Kartu model |
| Biaya per tugas | 6,44 dolar | 1,01 dolar | Halaman model Artificial Analysis |
| Waktu per tugas | 21,5 menit | 8,5 menit | Halaman model Artificial Analysis |
| Harga resmi (input/output, per juta token) | 3 / 15 dolar | 2 / 10 dolar | Laporan sendiri resmi / halaman model Artificial Analysis |
Tiga catatan dasar sebelum membaca tabel perbandingan Gemini 4 Neon dan GPT-6.2 Sol
Pertama, sifat kartu model. Tabel perbandingan di kartu model DeepMind hanya memiliki tiga kolom: Gemini 4 Neon, Claude Opus 5.5, dan GPT-6.2 Sol. PDF penjelasan evaluasi yang menyertainya menyatakan bahwa hasil non-Gemini secara default berasal dari laporan masing-masing pihak. Jadi kolom Sol di kartu model merupakan angka resmi yang dirangkum Google, bukan hasil pengujian ulang oleh laboratorium yang sama pada hari yang sama.
Kedua, konsistensi skor kecerdasan. Angka 61 konsisten di blog Google (laporan sendiri resmi), kartu model (baris AA Index v5.0.1 mencantumkan 61 / 59 / 57), dan halaman model Artificial Analysis. Angka 57 milik Sol juga konsisten di kartu model dan halaman model Artificial Analysis. Indeks terkait pengkodean tidak serapi itu; akan dibahas terpisah di bawah.
Ketiga, dasar biaya. Biaya per tugas Artificial Analysis adalah jumlah yang dialokasikan ke setiap tugas setelah menjalankan seluruh rangkaian indeks; angka ini dipengaruhi oleh harga satuan dan jumlah token output. Angka ini dan harga per panggilan yang ditagih platform berdasarkan token merupakan dua perhitungan berbeda dan tidak dapat saling menggantikan.
Perbandingan kemampuan coding Gemini 4 Neon dan GPT-6.2 Sol
Untuk bagian coding, dari lima subkategori yang tercantum di kartu model, Neon lebih tinggi daripada Sol pada item yang memiliki data, tetapi besar selisihnya sangat tidak merata. Tabel di bawah ini seluruhnya berasal dari kartu model; angka Sol, sesuai catatan evaluasi, merupakan laporan sendiri dari OpenAI.
| Subkategori coding (kartu model) | Gemini 4 Neon | GPT-6.2 Sol | Selisih |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | Tidak ada data | Tidak dapat dibandingkan |
| Terminal-bench 4.1 (setelah koreksi kecurangan) | 65.2% | 61.5% | 3.7 poin persentase |
| FrontierCode 2.0 | 46.2% | 43.8% | 2.4 poin persentase |
| SWE-sweep (harness vendor) | 39.0% | 8.3% | 30.7 poin persentase |
| SWE-sweep (mini-SWE harness) | 12.8% | 11.6% | 1.2 poin persentase |
Dua harness SWE-sweep harus dibaca terpisah
SWE-sweep adalah baris yang paling mudah disalahpahami. Angka 39.0% milik Neon berasal dari harness vendor Google Antigravity; setelah diganti dengan mini-SWE harness yang seragam, angkanya menjadi 12.8%. Blog Google (laporan resmi sendiri) menggambarkan selisih dari 12.8 hingga 39.0 sebagai peningkatan yang dibuka oleh harness, jadi angka-angka ini menunjukkan efek kombinasi “model plus toolchain”.
Di bawah mini-SWE harness yang sama, Neon 12.8% versus Sol 11.6%, hanya berbeda 1.2 poin persentase. Sol di harness vendor miliknya sendiri adalah 8.3%, justru lebih rendah daripada skor mini-SWE-nya. Jika agen coding Anda tidak berjalan di Antigravity, baris mini-SWE lebih mendekati kondisi yang dapat Anda reproduksi.
Dua angka Coding Agent Index
Blog Google (laporan resmi sendiri) menulis bahwa Coding Agent Index Artificial Analysis untuk Neon adalah 58.6, dan menyebutnya peringkat 1 keseluruhan. Artikel Artificial Analysis menuliskan Neon xhigh pada Antigravity CLI sebesar 59. Kedua angka berasal dari sumber berbeda; artikel ini mempertahankan keduanya dan tidak menggabungkannya. Bahan referensi tidak memuat skor Sol pada indeks ini, sehingga item ini tidak dapat digunakan untuk membandingkan keduanya. Selain itu, FrontierCode 2.0 sebesar 46.2%, menurut laporan resmi sendiri, diukur pada level high default.
Perbandingan Kemampuan Grafik Gemini 4 Neon vs GPT-6.2 Sol
Grafik adalah kategori yang skornya lebih tinggi untuk Sol di antara ketiga item. Pada baris Chartography di kartu model, Neon 73.5%, Sol 75.1%, Sol unggul 1.6 poin persentase. Blog Google (laporan resmi sendiri) juga mencantumkan angka Neon yang sama, 73.5%, jadi kedua sumber konsisten.
LVBench, yang juga termasuk dalam pemahaman multimodal, di kartu model tercatat Neon 89.0% dan Sol 87.6%, sehingga di item ini Neon unggul 1.4 poin persentase. Kedua item bergerak ke arah berlawanan dan selisihnya tidak besar, jadi “siapa yang lebih kuat dalam tugas grafik dan visual” sulit dirangkum dalam satu kalimat; semuanya tergantung apakah tugas Anda lebih mirip membaca grafik atau menonton video panjang.
Dari sisi modalitas input, kartu model menyatakan Neon menerima teks, gambar, audio, dan video. Materi referensi tidak mencantumkan daftar modalitas input untuk Sol; jika pipeline Anda bergantung pada input audio atau video, Anda perlu memeriksa dokumentasi resmi OpenAI terlebih dahulu untuk memverifikasi dukungan Sol.
Perbandingan Konteks Panjang Gemini 4 Neon vs GPT-6.2 Sol
Untuk kategori konteks panjang, artikel ini hanya menggunakan data GraphWalks dari kartu model. Pada rentang 256k hingga 1M token dengan traversal BFS, skor F1 Neon 95.2%, Sol 80.1%, selisih 15.1 poin persentase — yang terbesar di antara ketiga item.
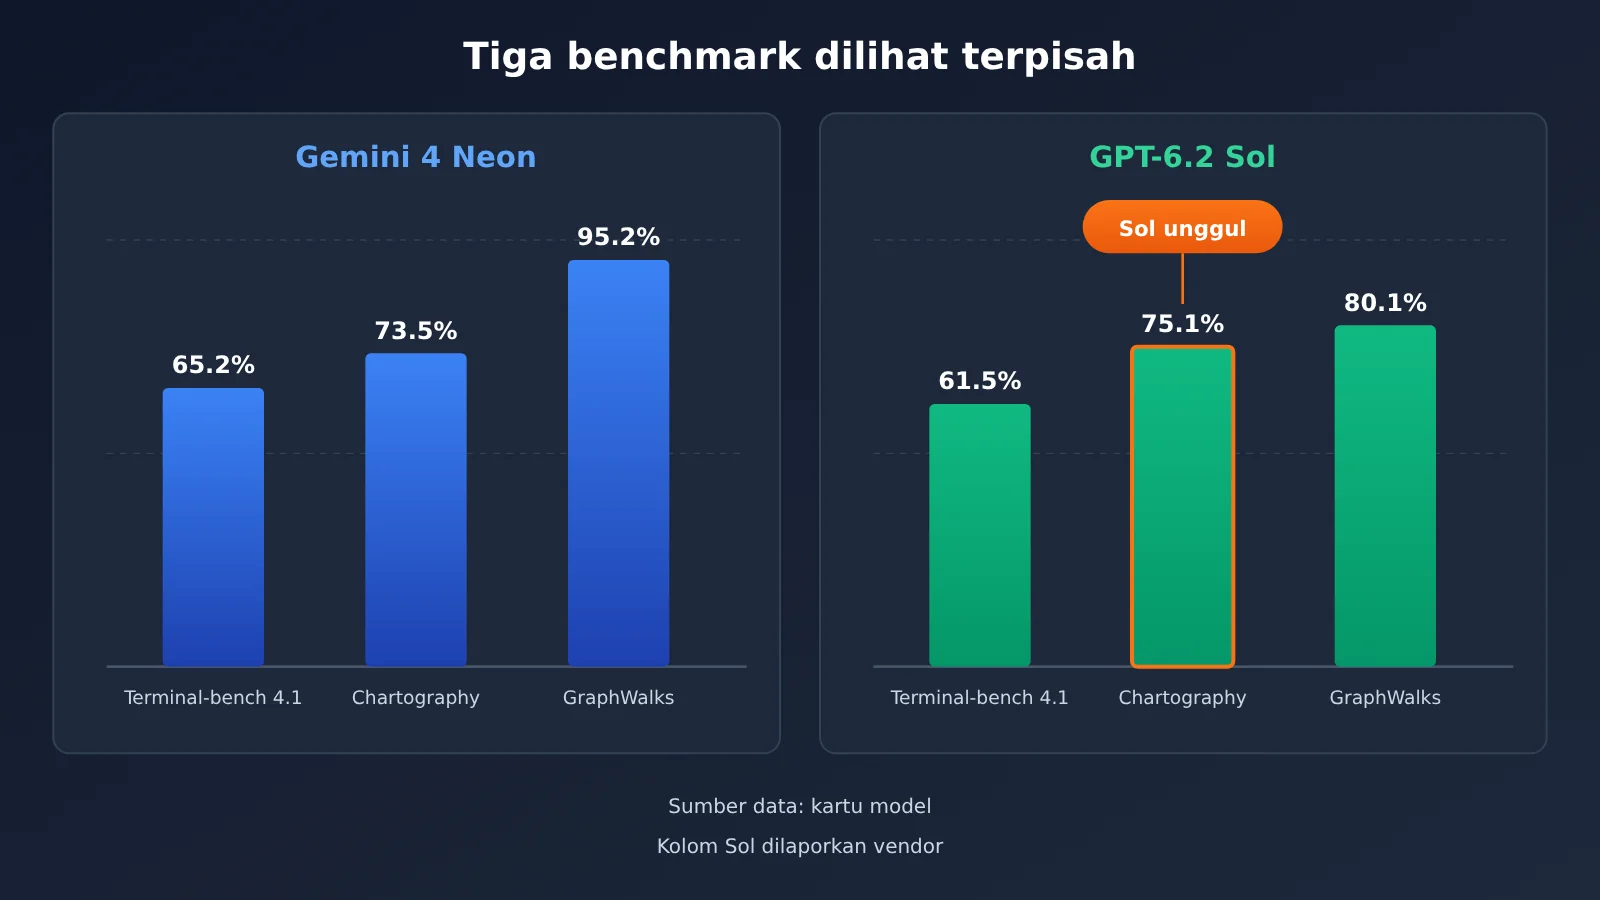
📊 Keterangan grafik: Semua angka pada gambar di atas berasal dari kartu model; kolom Sol, menurut catatan evaluasi, termasuk laporan mandiri vendor. Jika ingin memverifikasi performa Sol pada dokumen panjang Anda sendiri, Anda bisa langsung mengirim permintaan
gpt-6.2-solmelalui APIYI apiyi.com dengan kunci yang sama.
Parameter konteks panjang Gemini 4 Neon
Spesifikasi jendela konteks untuk Neon didokumentasikan secara lengkap. Kartu model menyatakan jendela terpadu maksimum 1 juta token, output sinkron default maksimum 64 ribu token, dan decoding panjang di latar belakang maksimum 1 juta. Panduan developer Google Cloud memberikan nilai presisi: batas atas terpadu 1048576 token, mencakup input dan output sekaligus, sementara output mencakup proses berpikir, pemanggilan fungsi, dan balasan akhir; satu segmen default maksimum 65536, dan decoding panjang dapat mencapai 1048576 dikurangi input.
Untuk caching, panduan developer menyatakan Neon tidak mendukung cache konteks eksplisit. Cache implisit otomatis berlaku untuk prefiks bersama di atas 4096 token, dan cache persisten aktif secara default. Untuk skenario bertanya berulang kali tentang dokumen panjang, ini berarti Anda perlu menjaga prefiks bersama tetap stabil agar bisa memanfaatkan harga cache 0.15 dolar yang tertulis di halaman harga AI Studio.
Informasi konteks panjang GPT-6.2 Sol
Materi referensi tidak memberikan batas atas jendela konteks Sol, jadi artikel ini tidak membandingkan ukuran jendela. Yang dapat dipastikan adalah penagihan: tabel ringkasan APIYI menunjukkan gpt-6.2-sol berpindah tier setelah input melebihi 272000 token, yang akan diuraikan di bagian harga nanti. Dalam tugas konteks panjang, ambang ini akan langsung memengaruhi struktur tagihan Anda.
Perbandingan biaya dan waktu Gemini 4 Neon vs GPT-6.2 Sol
Selisih biaya per tugas jauh lebih besar daripada selisih harga satuannya. Halaman model Artificial Analysis menunjukkan Neon xhigh 6,44 dolar per tugas, Sol max 1,01 dolar per tugas — yang pertama sekitar 6,4 kali yang kedua; padahal rasio harga tercantum keduanya adalah 3 banding 2 untuk input dan 15 banding 10 untuk output, sama-sama 1,5 kali.
Kelebihan sisanya berasal dari volume output. Di halaman yang sama, Neon xhigh saat menjalankan indeks menghasilkan 283 juta token, sementara Sol max mengeluarkan 60,9 juta token — yang pertama sekitar 4,6 kali lipat. Harga satuan lebih tinggi setengah, volume output beberapa kali lebih banyak; keduanya bergabung barulah menghasilkan angka 6,44 berbanding 1,01.
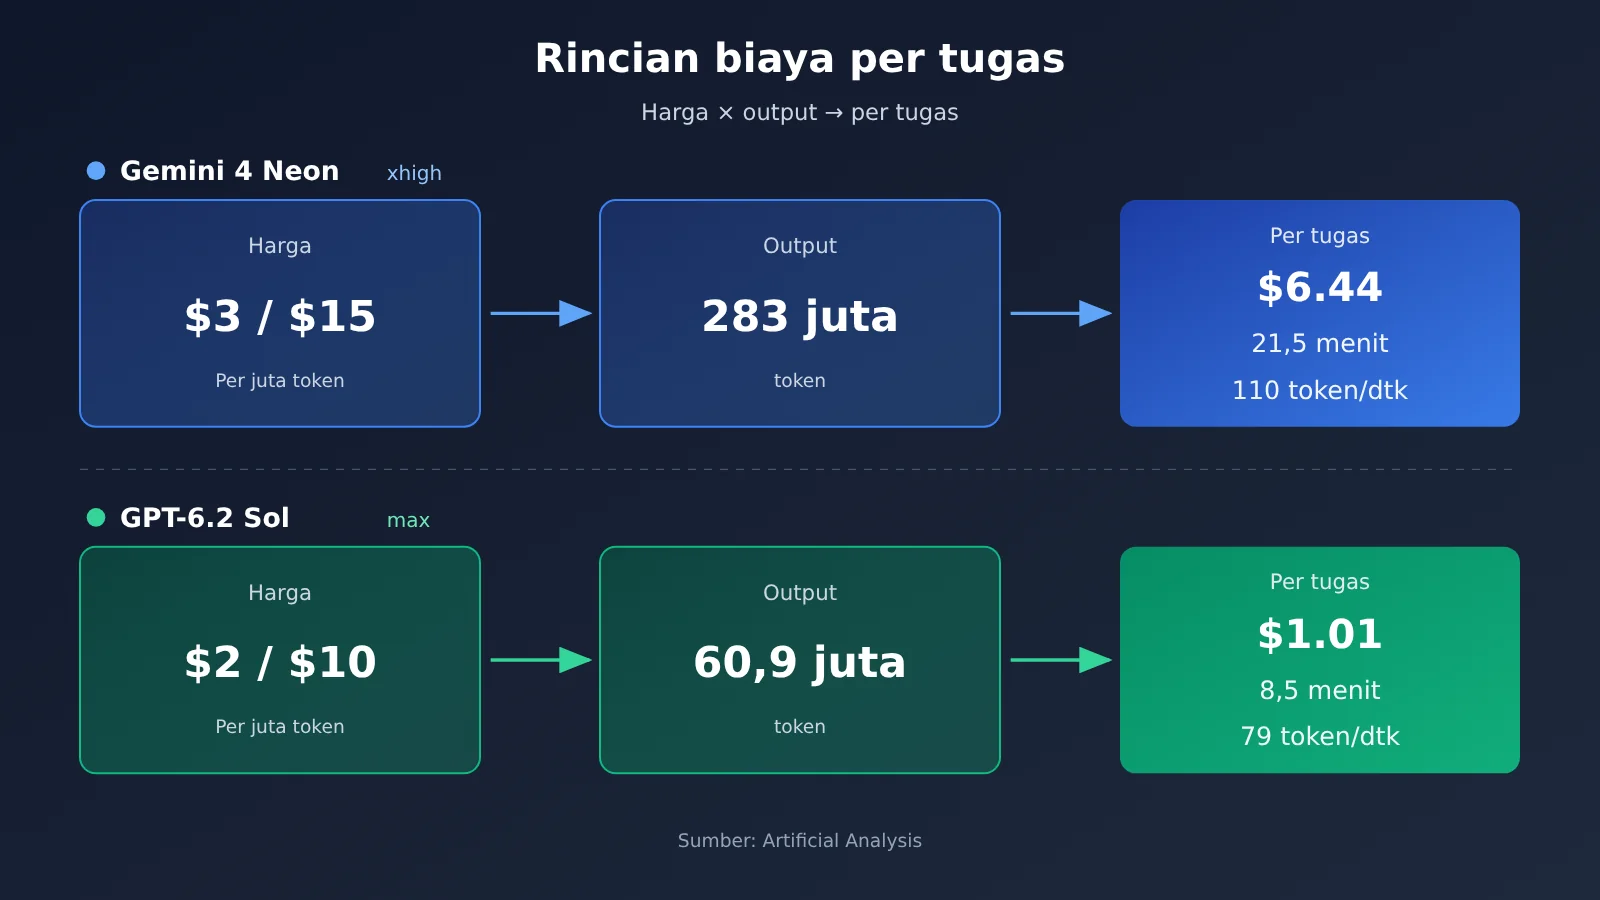
Pola yang sama berlaku untuk waktu. Kecepatan output Neon xhigh sekitar 110 token/detik, lebih tinggi daripada 79 token/detik milik Sol max, tetapi volume outputnya lebih besar, sehingga waktu per tugas menjadi 21,5 menit berbanding 8,5 menit. Untuk waktu token jawaban pertama, Neon xhigh 56,51 detik dan Sol max 75,06 detik — di sini Neon lebih cepat.
Skor kecerdasan dan waktu per tugas menurut tingkat penalaran
Kedua model punya beberapa tingkat penalaran; tabel di bawah diambil dari halaman model Artificial Analysis. Biaya per tugas hanya tersedia angkanya di baris tingkat tertinggi, sedangkan tingkat lainnya hanya menyediakan skor, waktu, dan kecepatan.
| Tingkat | Skor kecerdasan Neon | Waktu per tugas Neon | Kecepatan output Neon | Skor kecerdasan Sol | Waktu per tugas Sol | Kecepatan output Sol |
|---|---|---|---|---|---|---|
| max | Tidak ada tingkat ini | — | — | 57 | 8,5 menit | 79 token/detik |
| xhigh | 61 | 21,5 menit | 110 token/detik | 56 | 5,3 menit | 76 token/detik |
| high | 60 | 14,8 menit | 101 token/detik | 55 | 4,6 menit | 73 token/detik |
| medium | 55 | 8,3 menit | 101 token/detik | 53 | 3,2 menit | 70 token/detik |
| low | 44 | 3,7 menit | 97 token/detik | 41 | 1,5 menit | 65 token/detik |
Tabel ini bisa dibaca dengan dua cara. Berdasarkan tingkat dengan nama yang sama, tingkat high Neon 60 poin berbanding Sol 55 poin, dengan waktu 14,8 menit berbanding 4,6 menit. Berdasarkan waktu, Neon medium 8,3 menit dan Sol max 8,5 menit berdekatan, dengan skor 55 berbanding 57. Tingkat default Neon adalah high (begitu tertulis di panduan pengembang maupun halaman model terbaru AI Studio), dan inilah baris yang biasanya jadi default di banyak integrasi. Waktu token pertama untuk tiga tingkat terakhir Neon tercatat terpisah di FAQ halaman model: high 40,64 detik, medium 20,14 detik, low 13,93 detik — angka-angka ini tidak berada di kolom yang sama dengan tabel ringkasan.
Perbandingan Harga Gemini 4 Neon dan GPT-6.2 Sol: Harga Satuan Resmi dan Daftar Harga APIYI
Bagian harga satuan ini terbagi menjadi dua lapisan: harga yang tercantum di halaman penyedia model atau pihak ketiga, serta harga di daftar APIYI (apiyi.com).
| Item | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| Harga input (per juta token) | 3.00 USD (dilaporkan resmi / halaman harga AI Studio) | 2.00 USD (halaman model Artificial Analysis) |
| Harga output (per juta token) | 15.00 USD, termasuk token berpikir | 10.00 USD |
| Cache | 0.15 USD, hanya cache implisit | Diskon cache 95% (halaman model Artificial Analysis) |
| Tier gratis | Tidak ada (halaman harga AI Studio) | Tidak disebutkan dalam referensi |
| ID model APIYI | Belum tersedia | gpt-6.2-sol |
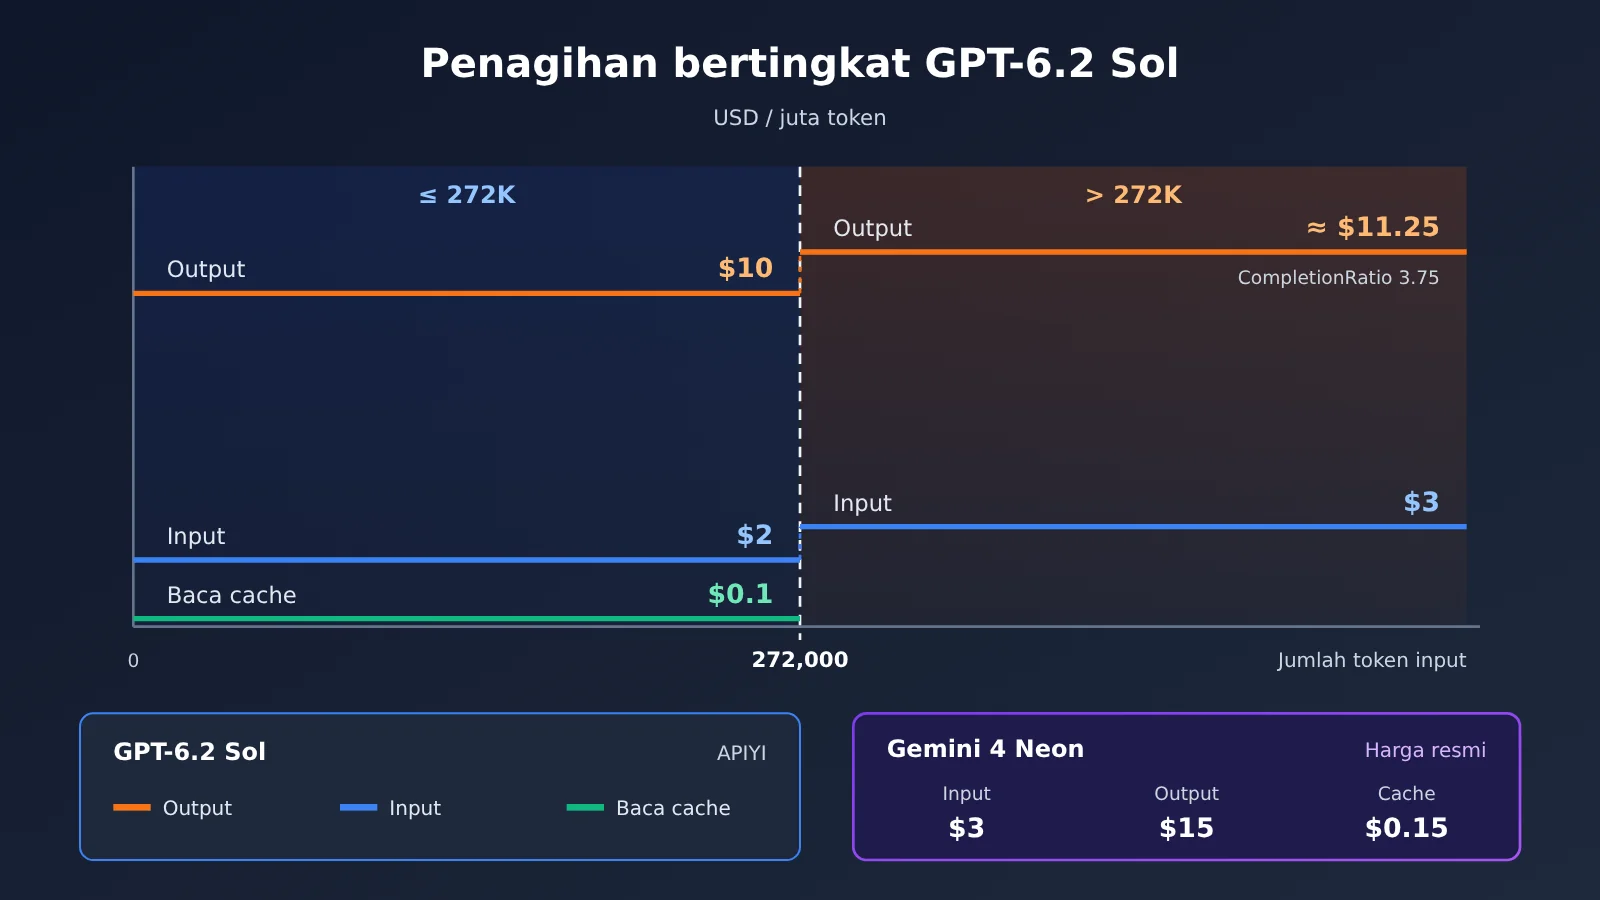
| Tier pertama APIYI (0 sampai 272000 token input) | — | Input 2 / baca cache 0.1 / output 10 USD |
| Tier tinggi APIYI (lebih dari 272000 token input) | — | Input 3 USD; output dari endpoint harga sekitar 11.25 USD |
| Endpoint APIYI | — | responses (disarankan), chat |
| Platform yang tersedia | Saluran resmi seperti Gemini API di Google AI Studio | APIYI apiyi.com, dll. |
gemini-4-neon belum ada di tabel utama maupun endpoint harga APIYI, jadi belum tersedia. Kami akan segera meluncurkan model ini; nama model dan harga mengikuti daftar model platform.
Detail lonjakan tier gpt-6.2-sol di APIYI
Tabel utama APIYI (halaman mencantumkan pembaruan pada 2026-11-16 09:39, UTC+8) menuliskan gpt-6.2-sol tier pertama input 2 USD, baca cache 0.1 USD, output 10 USD, konsisten dengan harga 2/10 di halaman model Artificial Analysis. Saat input melebihi 272000 token, teks tabel utama hanya menyebutkan input melonjak dari 2 USD ke 3 USD.
Endpoint harga yang dicek pada 2026-11-19 (versi shell-api-modelmak-v1, total 285 model) memberikan informasi lebih lengkap. Di endpoint tersebut, model_ratio bernilai 1 berarti input 2 USD per juta token, completion_ratio bernilai 5 berarti output adalah 5 kali input; setelah melebihi 272000 token, CompletionRatio berubah dari 5 menjadi 3.75. Dengan input 3 USD sebagai dasar, output menjadi sekitar 11.25 USD per juta token, bukan tetap dihitung 10 USD.
Nama grup sedikit berbeda di kedua tempat: tabel utama menulis CodexResponses, Codex_Reverse, Default, SVIP, sedangkan endpoint harga menulis CodexResponses, CodexReverse, default, svip. Perlu ditegaskan lagi, 1.01 USD dari Artificial Analysis adalah biaya menjalankan indeks yang dialokasikan ke setiap tugas, bukan biaya token aktual dari satu panggilan di platform.
Perbandingan Skenario Gemini 4 Neon vs GPT-6.2 Sol
Berikut daftar angka paling relevan menurut jenis tugas, supaya Anda bisa mencocokkan hasil evaluasi dengan beban kerja Anda sendiri. Mana yang lebih cocok bergantung pada distribusi tugas dan anggaran Anda — di sini kami hanya menyajikan perbandingan, bukan kesimpulan.
Angka terkait agen coding
- Dijalankan di dalam Google Antigravity: lihat baris harness vendor SWE-sweep, Neon 39.0%, Sol 8.3%, dan ingat bahwa Google sendiri mengatribusikan selisih ini pada harness.
- Dijalankan di harness umum: lihat baris mini-SWE, 12.8% vs 11.6%, serta Terminal-bench 4.1 dengan 65.2% vs 61.5%.
- Perubahan kecil berfrekuensi tinggi: waktu per tugas jadi lebih penting, bandingkan dengan durasi pada rentang skor setara di tabel tingkatan.
Angka terkait grafik dan dokumen panjang
- Tanya jawab atas grafik laporan keuangan dan tangkapan layar dasbor: Chartography mencatat Sol 75.1%, Neon 73.5% — arah pada item ini justru berlawanan dengan skor agregat.
- Penelusuran struktur graf atau dokumen berskala ratusan ribu token: GraphWalks mencatat Neon 95.2%, Sol 80.1%, dan perlu memasukkan lonjakan tarif Sol di APIYI untuk pemakaian di atas 272000 token ke dalam perhitungan biaya.
- Pemahaman video panjang: LVBench mencatat Neon 89.0%, Sol 87.6%, dan kartu model menyebutkan bahwa Neon mendukung input video.
Rekomendasi Keputusan Gemini 4 Neon vs GPT-6.2 Sol: Periksa Dulu Sebelum Memilih
Sebelum memilih, sebaiknya periksa situasi Anda sendiri dengan urutan berikut, bukan langsung mengambil keputusan berdasarkan angka 61 versus 57.
- Hitung berapa proporsi masing-masing dari tiga kategori tugas Anda — pengkodean, grafik/diagram, dan konteks panjang — lalu bandingkan dengan tiga tabel per komponen di atas.
- Perkirakan rata-rata volume output per tugas. Data Artificial Analysis menunjukkan bahwa selisih biaya per tugas antara kedua model terutama berasal dari volume output; semakin panjang output tugas Anda, semakin jelas selisih ini.
- Pastikan apakah panjang input akan melewati 272000 token. Setelah melewatinya, harga satuan input dan output
gpt-6.2-soldi APIYI akan berubah. - Pastikan tingkat pemikiran (thinking level). Neon hanya mendukung empat tingkat: low, medium, high, dan xhigh; mengirimkan
thinking_budgetatauMINIMALakan mengembalikan HTTP400(Panduan Pengembang). - Jalankan uji banding dalam skala kecil pada kumpulan sampel Anda sendiri, lalu catat skor, waktu eksekusi, dan penggunaan token.
💡 Saran pemilihan: Setiap komponen dari kedua model punya keunggulan dan kelemahannya masing-masing, dan hasil akhirnya bergantung pada distribusi tugas serta anggaran Anda. Sebaiknya hubungkan
gpt-6.2-solyang sudah tersedia melalui APIYI apiyi.com terlebih dahulu, catat penggunaan token dan waktu eksekusi pada sampel Anda sendiri, lalu setelah Neon tersedia, jalankan perbandingan dengan skrip yang sama.
Cara cepat memanggil GPT-6.2 Sol melalui APIYI
APIYI merekomendasikan endpoint responses untuk gpt-6.2-sol, dengan base_url yang kompatibel dengan OpenAI yaitu https://api.apiyi.com/v1. Seluruh integrasi hanya membutuhkan empat langkah:
- Siapkan kunci: Buat kunci API di konsol platform, tulis ke variabel lingkungan
APIYI_API_KEY, dan di dalam kode hanya baca dari variabel lingkungan, jangan menuliskan teks polos. - Tentukan alamat permintaan: Endpoint Responses adalah
POST https://api.apiyi.com/v1/responses, header permintaan membawaAuthorization: Bearer $APIYI_API_KEYdanContent-Type: application/json. - Susun body permintaan: Body permintaan minimal adalah
{"model": "gpt-6.2-sol", "input": "请总结这份季度报告里的三张图表"}. - Panggil dengan OpenAI SDK: Inisialisasi
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"]), lalu panggilclient.responses.create(model="gpt-6.2-sol", input=...), dan baca hasilnya darioutput_textpada objek respons.
Jika kode yang ada berbasis Chat Completions, Anda juga dapat mengirim ID model yang sama ke endpoint chat, dengan path /v1/chat/completions. Protokol native Gemini menggunakan https://api.apiyi.com ditambah versi v1beta, cocok untuk model Gemini yang sudah tersedia di platform.
Saat melakukan pengujian konteks panjang, disarankan mencatat jumlah token input setiap permintaan di log secara bersamaan, agar mudah menentukan apakah melewati ambang batas 272000. Untuk nilai spesifik parameter tingkat penalaran, ikuti dokumentasi resmi OpenAI dan halaman model di platform.
🚀 Mulai cepat: Pengguna baru dapat mengklaim kuota uji gratis di APIYI apiyi.com, memakai satu kunci untuk memanggil model yang sudah tersedia seperti OpenAI, Claude, Gemini sekaligus, jalankan dulu alur responses
gpt-6.2-solsampai berhasil, nanti jika berganti model cukup ubah fieldmodel.
Pertanyaan Umum (FAQ)
Q1: Apa posisi masing-masing Gemini 4 Neon dan GPT-6.2 Sol?
Neon merupakan turunan dari Gemini 4 Carbon (kartu model), dan panduan developer Google menempatkannya di antara Hydrogen (siklus cepat harian) dan Carbon (tugas panjang yang kompleks). GPT-6.2 Sol di halaman model Artificial Analysis diberi harga 2/10 dolar, dengan skor kecerdasan tertinggi 57 pada tier max.
Q2: Keunggulan 4 poin Neon atas Sol terutama terlihat di bagian mana?
Dari rincian per kategori di kartu model, selisih terbesar ada pada GraphWalks konteks panjang (95.2% vs 80.1%) dan SWE-sweep di bawah harness vendor (39.0% vs 8.3%). Untuk kategori Chartography, Sol justru lebih tinggi (75.1% vs 73.5%).
Q3: Kapan Gemini 4 Neon dirilis, dan di kanal mana saja model ini tersedia?
Tanggal rilis di blog Google adalah 2026-11-18. Menurut postingan peluncuran Sundar Pichai, pada hari itu model tersedia di Gemini API dalam Google AI Studio, Gemini for business, Google Antigravity untuk Google AI Pro dan Ultra berbayar, serta Gemini App untuk Pro dan Ultra. ID modelnya adalah `gemini-4-neon`.
Q4: Apakah 1.01 dolar per tugas untuk Sol bisa dipakai sebagai patokan anggaran pemanggilan?
Angka ini adalah biaya yang dialokasikan per tugas setelah Artificial Analysis menjalankan seluruh rangkaian indeks; Sol max menghasilkan 60,9 juta token dalam pengujian tersebut. Biaya aktual Anda bergantung pada jumlah token input dan output Anda serta tier penagihan. Sebaiknya estimasikan sendiri berdasarkan tier pertama di tabel ringkasan APIYI, yaitu 2 / 0.1 / 10 dolar, dan perhatikan lonjakan tier saat melewati 272000 token.
Q5: Bagaimana cara cepat memanggil kedua model ini melalui API?
`gpt-6.2-sol` sudah tersedia di APIYI. Setelah mendaftar di apiyi.com dan mengklaim kuota uji coba, atur base_url ke `https://api.apiyi.com/v1` lalu panggil endpoint `responses`. `gemini-4-neon` saat ini belum ada di tabel ringkasan maupun antarmuka harga, jadi belum tersedia; kami akan segera menghadirkan model ini. Jenis model dan harga mengacu pada daftar model di platform.
Q6: Apa saja keterbatasan data perbandingan ini?
Ada tiga hal utama:
– **Dasar pengukuran**: skor Sol di kartu model, menurut keterangan evaluasi, merupakan laporan vendor sendiri, bukan pengujian ulang pada hari yang sama.
– **Tier**: di Artificial Analysis, tier tertinggi Neon adalah xhigh, sedangkan Sol adalah max, sehingga tier-nya tidak sepenuhnya setara.
– **Angka tidak konsisten**: Coding Agent Index di blog Google adalah 58.6, sementara di artikel Artificial Analysis 59; WebExploitBench v1.2 ditulis 51.26% di blog dan 51.3% di kartu model. Artikel ini mempertahankan angka aslinya.
Poin Utama Gemini 4 Neon vs GPT-6.2 Sol
- Skor keseluruhan: Di halaman model Artificial Analysis, Neon xhigh mendapat skor 61, sedangkan Sol max 57.
- Coding: Kartu model Terminal-bench 4.1 menunjukkan 65.2% vs 61.5%; selisih SWE-sweep perlu dilihat berdasarkan harness.
- Grafik: Chartography lebih tinggi untuk Sol, 75.1% vs 73.5%.
- Konteks panjang: F1 GraphWalks dari 256k hingga 1M adalah 95.2% vs 80.1%, selisih terbesar.
- Biaya dan waktu: Per tugas 6.44 vs 1.01 dolar, 21.5 vs 8.5 menit; penyebab utamanya adalah volume output yang berbeda beberapa kali.
- Harga satuan: Neon 3/15 dolar, Sol 2/10 dolar; di APIYI,
gpt-6.2-solberpindah tier setelah melewati 272000 token input.
Ringkasan
Perbedaan antara Gemini 4 Neon dan GPT-6.2 Sol menjadi jauh lebih jelas setelah diuraikan daripada hanya melihat skor keseluruhan:
- Coding: Neon lebih tinggi pada subbagian yang datanya tersedia di kartu model, tetapi dalam harness mini-SWE yang sama selisihnya hanya 1.2 poin persentase.
- Grafik: Pada Chartography, Sol lebih tinggi; pada LVBench, Neon sedikit lebih tinggi.
- Konteks panjang: Neon unggul 15.1 poin persentase pada GraphWalks, selisih paling mencolok di antara ketiga aspek.
- Biaya: Harga satuan berbeda 1.5 kali, biaya per tugas berbeda sekitar 6.4 kali; selisih yang membesar di antaranya berasal dari jumlah token output.
Pilihan mana yang tepat kembali bergantung pada distribusi tugas dan panjang output Anda sendiri. Disarankan untuk lebih dulu menghubungkan gpt-6.2-sol melalui APIYI apiyi.com, mencatat penggunaan dan waktu pada sampel nyata, lalu setelah Neon tersedia melengkapi perbandingan dengan alur yang sama.
📚 Referensi
-
Blog Google “Introducing Gemini 4 Neon”: pengumuman resmi dan evaluasi yang dilaporkan sendiri
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Keterangan: skor komprehensif, coding, sains, dan penetapan harga semuanya merupakan klaim resmi dari pihak Google sendiri
- Tautan:
-
Kartu model DeepMind Gemini 4 Neon: sumber tabel perbandingan tiga kolom
- Tautan:
deepmind.google/models/model-cards/gemini-4-neon - Keterangan: data per item seperti Chartography, GraphWalks, SWE-sweep, dan lainnya
- Tautan:
-
Panduan pengembang Google Cloud Gemini 4 Neon: aturan jendela, tingkat pemikiran, dan cache
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Keterangan: batas atas seragam 1048576 token, aturan HTTP 400, penjelasan cache implisit
- Tautan:
-
Halaman harga Google AI Studio: harga satuan resmi Neon
- Tautan:
aistudio.google.com/docs/pricing - Keterangan: input 3, output 15, cache 0,15 dolar per juta token
- Tautan:
-
Halaman model Artificial Analysis: data bertingkat Neon dan Sol
- Tautan:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-sol - Keterangan: skor kecerdasan, biaya per tugas, waktu, dan kecepatan output
- Tautan:
-
Artikel Artificial Analysis: pembacaan pengukuran pihak ketiga terhadap Neon
- Tautan:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Keterangan: data seperti Coding Agent Index 59, dan lainnya
- Tautan:
-
Tabel utama dan antarmuka harga APIYI: model yang sudah tersedia dan harga bertingkat
- Tautan:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Keterangan: tingkatan pertama
gpt-6.2-soldan aturan lompatan tarif pada 272000 token
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Informasi lebih lanjut tentang model dan panduan integrasi dapat diakses di pusat dokumentasi docs.apiyi.com