Catatan penulis: Model yang terasa “makin bodoh” belum tentu sudah diganti. Berangkat dari riset terbaru Anthropic tentang pembuktian inferensi FlashProve, artikel ini menyusun urutan pemeriksaan faktor-faktor yang memengaruhi hasil pemanggilan API, mulai dari sisi pemanggil hingga server.
“Soal yang sama bisa dijawab di situs resminya, tapi saat dipanggil lewat API malah macet.” “Bulan ini modelnya jelas terasa makin bodoh.” Keluhan seperti ini hampir pasti pernah dialami developer yang mengintegrasikan Model Bahasa Besar lewat API. Reaksi pertama banyak orang adalah: jangan-jangan model di backend sudah diganti?
Baru-baru ini, Anthropic merilis prototipe riset sumber terbuka FlashProve, yang mencoba menggunakan bukti kriptografis untuk memverifikasi apakah suatu output benar-benar berasal dari bobot model yang ditentukan. Ini membuka jalan untuk memeriksa secara matematis apakah sebuah model telah ditukar.
Namun, ini belum menyelesaikan persoalan model yang terasa “makin bodoh”. Laporan riset tersebut menegaskan bahwa meskipun identitas bobot sudah terverifikasi, petunjuk sistem, kebijakan keamanan, pemotongan konteks, konten hasil pencarian, metode kuantisasi, dan parameter decoding tetap memengaruhi hasil akhir. Pengalaman tim Kimi juga menunjukkan bahwa cukup banyak kejanggalan skor benchmark sebenarnya disebabkan oleh penggunaan parameter decoding yang keliru.
Manfaat utama: Setelah membaca artikel ini, kamu akan mendapatkan daftar pemeriksaan saat model terasa makin bodoh: masalah mana yang bisa kamu periksa sendiri, mana yang membutuhkan bantuan penyedia layanan, dan mengapa “mengajukan beberapa pertanyaan untuk mengenali model” bukan metode yang bisa diandalkan.
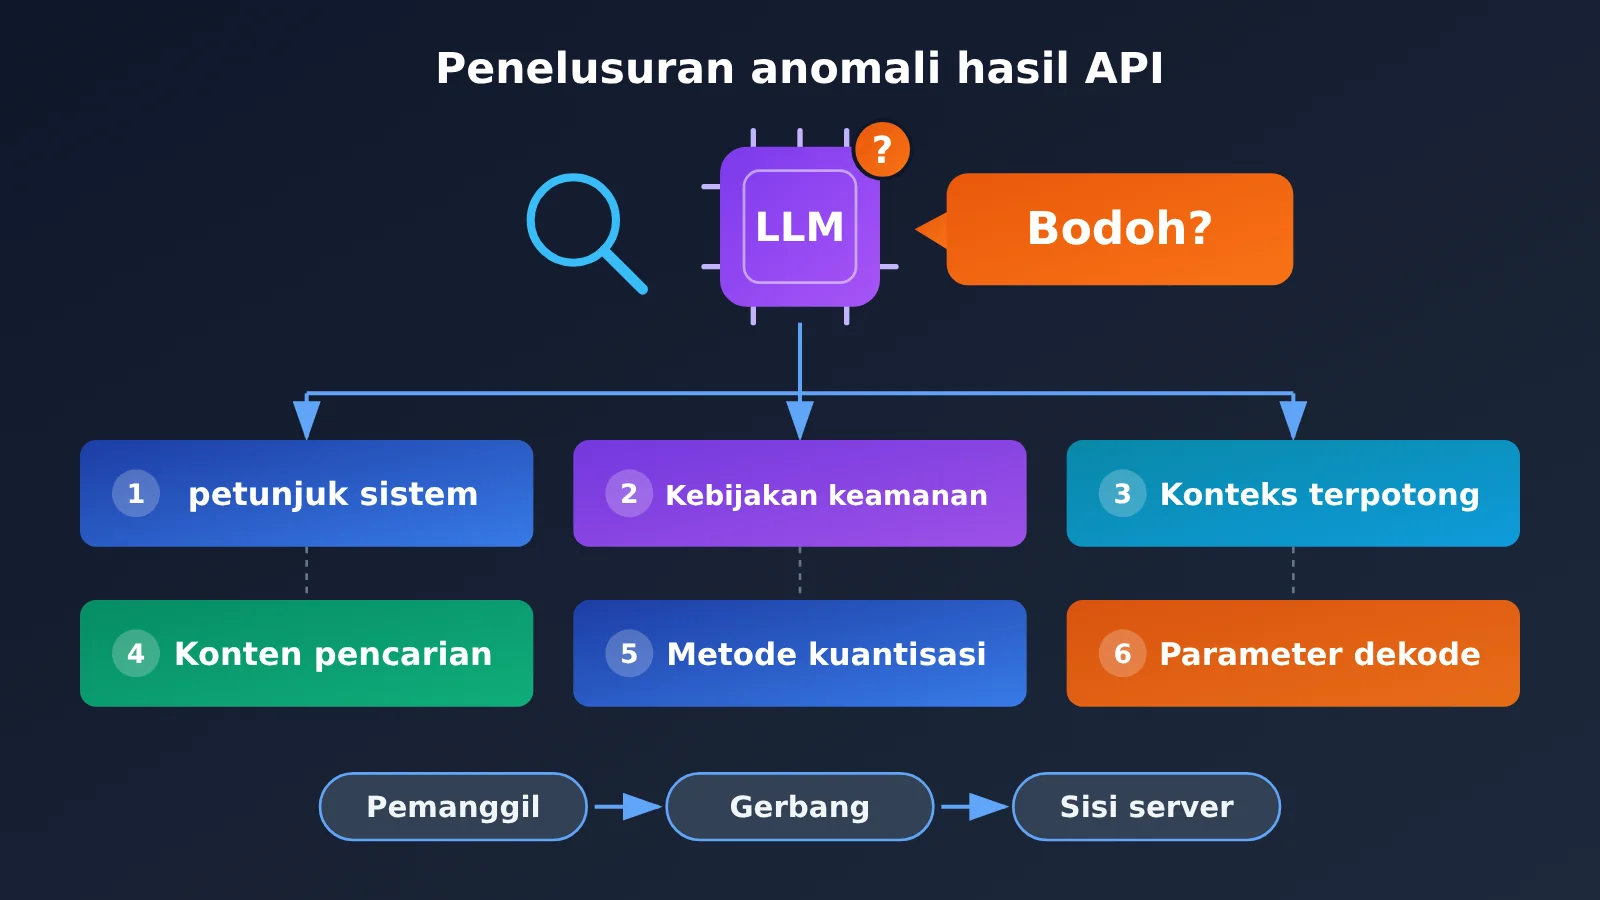
Menelusuri penyebab model terasa makin bodoh: ringkasan inti
Mari kita pahami dulu latar belakang diskusi ini. Pemicunya adalah penelitian Anthropic tentang “penalaran yang dapat dibuktikan”, yang kemudian memunculkan pertanyaan di komunitas: siapa sebenarnya yang harus disalahkan ketika model terasa makin bodoh?
| Informasi | Detail |
|---|---|
| Penerbit | Tim riset Anthropic, yang juga merilis kode, laporan teknis, dan bukti formal Lean |
| Inti penelitian | FlashProve: menghasilkan bukti kriptografis untuk penalaran model menggunakan bukti ringkas tanpa pengetahuan zkSNARK |
| Masalah yang diselesaikan | Memverifikasi apakah output berasal dari bobot tertentu tanpa mengungkap bobot atau meminta pengguna menjalankan ulang model |
| Masalah yang belum diselesaikan | Perubahan di tingkat produk, seperti petunjuk sistem, kebijakan keamanan, konteks, dan parameter decoding |
| Pelajaran bagi developer | Masalah pada kinerja model perlu ditelusuri di setiap lapisan, bukan hanya berfokus pada “apakah modelnya diganti” |
Bagaimana FlashProve membuktikan identitas model
FlashProve bekerja dalam dua tahap. Pertama, penyedia layanan membuat “komitmen” untuk bobot model. Komitmen ini seperti sidik jari kriptografis yang mengikat bobot tertentu tanpa mengungkap bobot itu sendiri. Kemudian, penyedia membuat bukti untuk input dan output yang diberikan. Dengan komitmen, petunjuk, jawaban, dan file bukti, pengguna dapat memverifikasi di komputernya sendiri apakah output tersebut benar-benar dihitung menggunakan bobot yang terikat pada komitmen.
Desain tanpa pengetahuan memastikan bahwa verifikator tidak memperoleh bobot atau nilai komputasi antara, dan tidak bisa melihat pakar mana yang digunakan pada setiap lapisan model MoE. Cara ini jauh lebih andal daripada “meminta model menyebutkan identitasnya sendiri”: nama model dalam jawaban tidak lagi dijadikan bukti identitas. Yang diperiksa adalah hubungan komputasi antara output dan bobot.
Anthropic menguji Llama 4 Maverick, yang bobot 4-bit-nya tersedia secara publik. Model mixture-of-experts ini memiliki sekitar 400 miliar parameter dan mengaktifkan sekitar 17 miliar parameter per token. Berikut data utama yang dipublikasikan:
| Metrik | Hasil eksperimen | Keterangan |
|---|---|---|
| Throughput pembuatan bukti | Sekitar 110 token/detik pada satu H100 | Kecepatan pembuatan bukti, bukan kecepatan output chat |
| Ukuran file bukti | Sekitar 19 MB per permintaan 1.024 token | Perlu dikirim bersama respons |
| Waktu verifikasi | Sekitar 17 detik pada CPU 24 thread | Tidak memerlukan GPU; bisa dilakukan di laptop |
| Pembuatan komitmen bobot | Sekitar 39 menit | Hanya perlu dilakukan sekali |
| Biaya tambahan | Waktu GPU sekitar 70–95 kali lipat dibandingkan inferensi vLLM biasa | Masih jauh dari penerapan secara luas |
Mengapa model masih bisa terasa makin bodoh meski bobotnya sudah dikonfirmasi
FlashProve memiliki satu prasyarat penting: pengguna harus mengetahui terlebih dahulu komitmen untuk “model asli”. Jika penyedia layanan hanya bisa membuktikan bahwa jawaban berasal dari model pilihannya sendiri, sementara pengguna tidak bisa memastikan bahwa model itu memang yang dibeli, bukti tersebut tetap tidak menyelesaikan masalah identitas. Idealnya, pembuat model atau lembaga tepercaya memublikasikan komitmen, lalu pengguna secara konsisten memverifikasi sidik jari tersebut.
Yang lebih penting, bobot yang tidak berubah bukan berarti layanannya juga tidak berubah. Bukti yang terikat pada bobot tidak otomatis menjawab apakah petunjuk sistem telah disesuaikan, konteks terpotong, atau parameter decoding tetap sama. Inilah sebabnya keluhan bahwa model terasa makin bodoh terus muncul: penyebabnya sering kali merupakan gabungan dari beberapa faktor.
6 penyebab umum model terasa makin bodoh
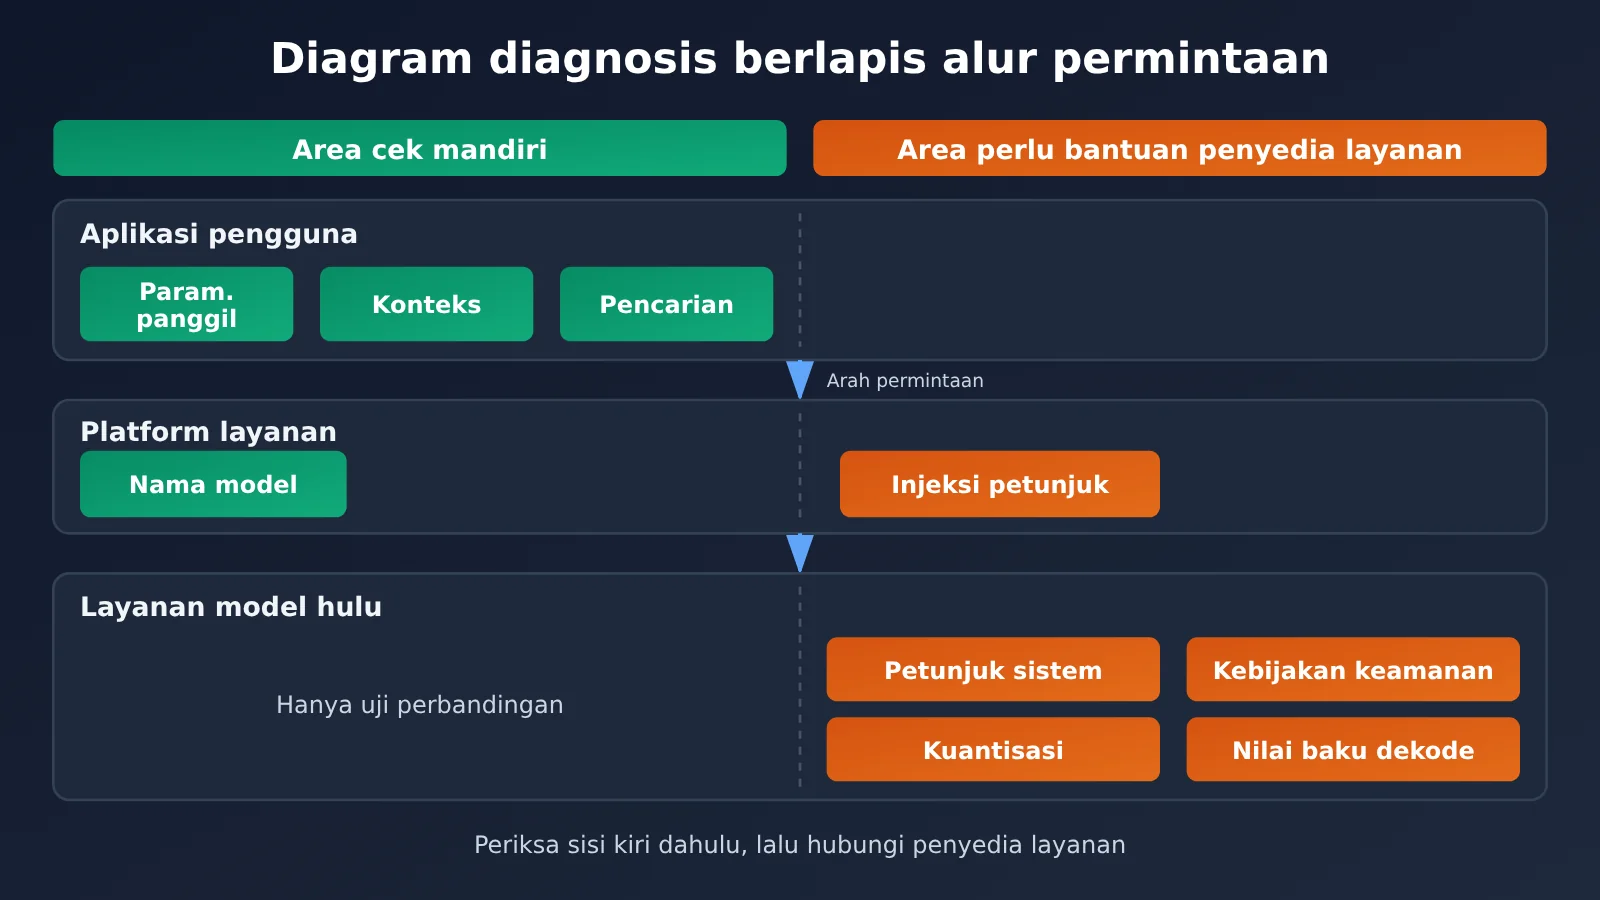
Jika faktor-faktor dalam penelitian rujukan diuraikan dan dikelompokkan berdasarkan “di sisi mana masalahnya mungkin terjadi”, terlihat bahwa cukup banyak masalah sebenarnya berada dalam kendali pengguna API sendiri.
| Faktor | Gejala umum | Kemungkinan sumber masalah | Bisa diperiksa sendiri? |
|---|---|---|---|
| Parameter decoding | Output tidak terarah, berulang, atau skor mode penalaran rendah | Terutama di sisi pengguna API, meski server juga bisa menetapkan nilai bawaan | Bisa, periksa parameter permintaan |
| Pemotongan konteks | Model “lupa” percakapan sebelumnya, jawaban tidak lengkap, atau instruksi diabaikan | Bisa terjadi di sisi pengguna API maupun server | Sebagian bisa, periksa penggunaan token |
| Petunjuk sistem | Gaya berubah, lebih sering menolak menjawab, atau format tidak sesuai | Dimasukkan oleh pengguna API atau server | Bisa memeriksa petunjuk sendiri, tetapi tidak yang ada di server |
| Kebijakan keamanan | Jenis pertanyaan tertentu tiba-tiba ditolak atau dijawab lebih hati-hati | Terutama di sisi server | Sulit, perlu penjelasan penyedia layanan |
| Konten hasil retrieval | Kualitas jawaban dalam skenario RAG naik-turun | Alur retrieval di sisi pengguna API | Bisa, periksa konten yang ditemukan |
| Metode kuantisasi | Kemampuan keseluruhan sedikit menurun, tingkat kesalahan pada penalaran panjang meningkat | Sisi deployment server | Tidak bisa, perlu bantuan penyedia layanan |
Penggunaan parameter decoding yang keliru: penyebab model terasa makin bodoh yang paling mudah terlewat
Saat memperkenalkan Kimi Vendor Verifier, tim Kimi membagikan temuan yang cukup menggambarkan masalah ini: setelah K2 Thinking dirilis, mereka menerima banyak laporan dari komunitas tentang skor benchmark yang tidak wajar. Setelah diselidiki, mereka memastikan bahwa cukup banyak kasus berasal dari penggunaan parameter decoding yang keliru. Tim kemudian membatasi parameter terkait dalam mode Thinking dan memeriksa apakah isi penalaran dikirim kembali dengan benar.
Pelajarannya bagi pengembang cukup jelas: jika parameter seperti temperature, top_p, max_tokens, dan pengaturan mode penalaran tidak sesuai dengan rekomendasi resmi, performa model bisa menyimpang jauh dari harapan. Khususnya untuk model penalaran, setiap penyedia punya persyaratan sendiri mengenai parameter sampling, anggaran penalaran, dan cara mengirim kembali isi penalaran dalam percakapan multiturn. Untuk nilai yang tepat, ikuti dokumentasi resmi masing-masing model, bukan konfigurasi yang biasa dipakai untuk model percakapan umum.
Konteks tidak terkirim lengkap: model terlihat seperti “lupa” dan makin bodoh
Masalah lain yang sering muncul berkaitan dengan konteks. Dalam percakapan multiturn, jika hanya pesan terbaru yang dikirim, wajar jika model tidak “mengingat” percakapan sebelumnya. Dalam alur kerja, jika riwayat pesan melebihi jendela konteks model, yang sering terpotong adalah instruksi sistem paling awal. Akibatnya, model tiba-tiba tidak lagi mengikuti format output yang diminta. Selain itu, pengaturan max_tokens yang terlalu kecil dapat memotong jawaban di tengah jalan, sehingga model tampak “berhenti saat baru menjawab separuh”.
Semua masalah ini bisa membuat model terasa makin bodoh. Namun, dengan memeriksa isi permintaan dan alasan penghentian dalam respons, biasanya penyebabnya bisa langsung ditemukan.
Cara memeriksa model yang terasa makin tidak pintar: urutan 3 langkah
Karena penyebabnya bisa tersebar di berbagai bagian rantai pemanggilan, mulailah pemeriksaan dari bagian yang paling murah dan paling mudah dikendalikan. Ikuti urutan berikut:
- Periksa sisi pemanggil terlebih dahulu: pastikan nama model, parameter decoding, max_tokens, petunjuk sistem, daftar pesan lengkap, serta konten yang diambil RAG sudah benar.
- Lakukan pengujian pembanding: gunakan parameter dan petunjuk yang tetap, lalu bandingkan hasilnya dengan kanal resmi atau performa yang dijelaskan dalam dokumentasi resmi. Jalankan beberapa kali untuk mengamati distribusi hasil, bukan hanya satu hasil.
- Terakhir, periksa sisi server: jika konfigurasi pemanggil sudah benar dan perbedaan dalam pengujian pembanding konsisten serta bisa direproduksi, hubungi penyedia layanan dengan membawa catatan permintaan dan hasil pengujian.
Contoh sederhana: panggilan yang dapat direproduksi dengan parameter tetap
Langkah awal yang paling praktis adalah menuliskan semua parameter secara eksplisit agar tidak bergantung pada nilai bawaan, lalu mencetak alasan penyelesaian dan penggunaan token:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Ganti dengan nama model yang ingin diperiksa
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
Jika finish_reason bernilai length, berarti jawaban terpotong oleh max_tokens. Jadi, jawaban yang tidak lengkap bukan karena modelnya menjadi kurang pintar, melainkan karena pengaturan parameter. Jumlah token input dalam usage juga membantu memastikan apakah konteks benar-benar dikirim secara lengkap.
Lihat skrip pengujian perbandingan lengkap
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Untuk mengganti model, cukup ubah parameter model
)

# Tuliskan semua parameter secara eksplisit agar tidak bergantung pada nilai bawaan
PARAMS = {
    "temperature": 0.2,   # Untuk model penalaran, gunakan nilai yang disarankan dalam dokumentasi resmi
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """Jalankan kasus yang sama beberapa kali untuk menghitung tingkat keberhasilan, jumlah jawaban terpotong, dan penggunaan token"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # Ganti dengan model yang ingin diperiksa
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
Kunci skrip ini bukan pada soal ujiannya, melainkan pada tiga hal: semua parameter ditetapkan dan disertakan dalam laporan, kasus yang sama dijalankan beberapa kali untuk melihat tingkat keberhasilan, serta finish_reason dan prompt_tokens dicatat untuk memeriksa masalah pemotongan jawaban dan konteks. Setelah ketiga kemungkinan ini disingkirkan, barulah masuk akal untuk membahas apakah ada perubahan di sisi server.
🚀 Saran pemeriksaan: APIYI apiyi.com menggunakan antarmuka yang kompatibel dengan OpenAI. Untuk mengganti model, cukup ubah parameter model sehingga skrip pengujian yang sama bisa digunakan untuk membandingkan beberapa model. Platform ini juga menyediakan log pemanggilan dan statistik penggunaan untuk meninjau konsumsi permintaan dan penggunaan token, sehingga membantu memeriksa apakah konteks dikirim secara lengkap. Untuk mengetahui kolom yang tersedia dalam log, periksa langsung halaman konsol platform.
Pembagian tugas: pemeriksaan pengguna dan bantuan penyedia layanan
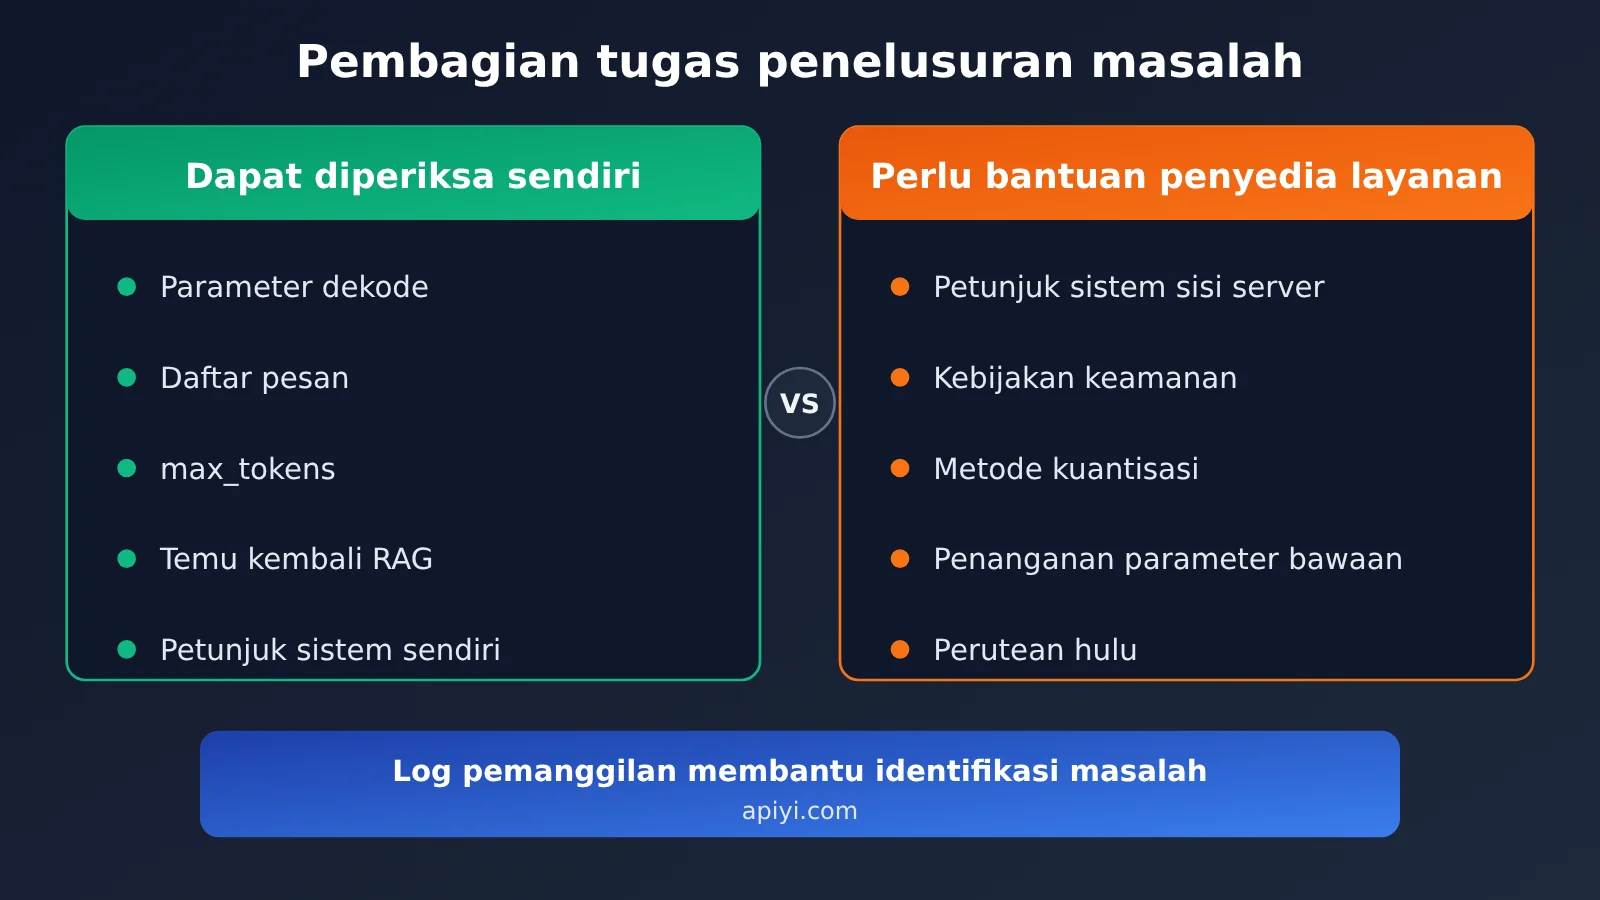
| Hal yang diperiksa | Cara pengguna memeriksa | Informasi yang diperlukan dari penyedia layanan |
|---|---|---|
| Parameter decoding | Cetak seluruh isi permintaan dan bandingkan dengan dokumentasi resmi | Apakah platform mengubah parameter atau menambahkan nilai default |
| Kelengkapan konteks | Periksa daftar pesan dan prompt_tokens | Apakah ada pemotongan konteks atau batasan jendela di sisi server |
| Mode penalaran | Periksa pengaturan berpikir dan cara isi penalaran dikembalikan | Apakah upstream mendukung parameter terkait |
| Kuantisasi dan deployment | Tidak dapat diperiksa sendiri | Presisi deployment dan penjelasan kanal upstream |
| Kebijakan keamanan | Bandingkan hasil permintaan yang sama melalui kanal resmi | Apakah ada aturan moderasi tambahan |
Saat menghubungi penyedia layanan, sertakan contoh permintaan dengan parameter tetap, hasil statistik dari beberapa kali pengujian, dan data pembanding agar komunikasi jauh lebih efisien. Jika hanya mengatakan “modelnya jadi lebih bodoh”, mereka akan kesulitan menemukan sumber masalahnya.
Mengapa “bertanya beberapa pertanyaan untuk mengidentifikasi model” tidak andal untuk menilai penurunan kemampuan model
Di komunitas, ada metode identifikasi yang populer: tanyakan kepada model pengetahuan yang hanya diketahui versi terbaru. Jika tidak bisa menjawab, model dianggap “sudah diganti”. Masalahnya, setiap jawaban memiliki unsur keacakan. Jawaban yang kebetulan salah, parameter yang berbeda, konteks yang tidak lengkap, atau perbedaan routing internal penyedia bisa sama-sama menghasilkan kesimpulan: “Ini bukan model yang saya inginkan.”
Proyek penelitian Stanford University, Model Equality Testing, menawarkan sudut pandang yang lebih ketat. Peneliti menguji 31 endpoint API komersial untuk empat model Llama pada 2024. Mereka menemukan bahwa distribusi output dari 11 endpoint berbeda secara statistik dari distribusi acuan yang menggunakan bobot yang dirilis Meta. Perhatikan bahwa metode ini membandingkan “distribusi” output, bukan benar atau salahnya jawaban atas satu atau dua pertanyaan.
Bagi pengembang, pendekatan statistik ini bisa ditiru: gunakan parameter tetap, beberapa kasus uji, dan beberapa kali pengujian untuk mengamati perbedaan yang konsisten. Ini juga alasan skrip pembanding di atas menggunakan “tingkat keberhasilan”, bukan “hasil satu kali”.
Analisis Dampak Fenomena Model yang Menjadi Kurang Pintar
Dampak bagi Developer
- Periksa lebih awal: Saat hasilnya tidak seperti biasa, periksa dulu isi permintaan Anda. Kesalahan penggunaan parameter dan konteks yang hilang adalah hal yang paling murah dan paling mungkin ditemukan.
- Tetapkan parameter secara eksplisit: Di lingkungan produksi, jangan bergantung pada nilai default. Khususnya untuk model penalaran, ikuti konfigurasi dalam dokumentasi resmi dan sertakan parameter dalam kontrol versi.
- Buat kumpulan pengujian regresi: Jalankan sekumpulan kasus uji tetap secara berkala. Saat model terasa kurang pintar, Anda punya data sebagai bukti, bukan sekadar kesan.
- Simpan catatan pemanggilan: Parameter permintaan, penggunaan token, dan alasan respons berakhir adalah bukti penting saat berkomunikasi dengan penyedia layanan.
Dampak bagi Industri
- Verifikasi beralih dari kesan ke bukti: FlashProve menunjukkan bahwa identitas bobot model dapat diverifikasi. Ke depannya, produsen model, lembaga evaluasi, dan regulator dapat menggunakannya untuk memastikan model yang benar-benar digunakan dalam layanan.
- Tuntutan transparansi akan meluas: Selain bobot model, kesesuaian petunjuk sistem, strategi decoding, dan konfigurasi deployment akan menjadi fokus pembahasan berikutnya.
- Adopsi luas masih butuh waktu: Biaya pembuktian mencapai puluhan kali biaya inferensi biasa. Teknologi ini juga masih membutuhkan dukungan konteks yang lebih panjang dan mekanisme publikasi komitmen yang tepercaya, sehingga sulit diterapkan pada pemanggilan sehari-hari dalam waktu dekat.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Jika model terasa lebih bodoh, apa yang harus diperiksa terlebih dahulu?
Periksa permintaan Anda terlebih dahulu: apakah nama model sudah benar, apakah parameter decoding seperti temperature sesuai rekomendasi resmi, apakah max_tokens terlalu kecil, dan apakah riwayat pesan dalam percakapan multigilir sudah dikirim secara lengkap. Pengalaman tim Kimi menunjukkan bahwa cukup banyak hasil benchmark yang tidak biasa disebabkan oleh penggunaan parameter decoding yang keliru. Langkah ini sering kali paling cepat membuahkan hasil.
Q2: Apakah FlashProve bisa menyelesaikan sepenuhnya perdebatan tentang model yang terasa lebih bodoh?
Tidak. FlashProve dapat memverifikasi apakah output berasal dari bobot yang ditentukan, tetapi harus ada komitmen model tepercaya sebagai pembanding. Faktor seperti petunjuk sistem, kebijakan keamanan, pemotongan konteks, metode kuantisasi, dan parameter decoding tidak otomatis tercakup dalam bukti bobot.
Q3: Bagaimana cara melakukan pengujian perbandingan yang tepercaya?
Tetapkan semua parameter dan petunjuk agar tetap sama. Siapkan beberapa kasus uji dengan jawaban yang jelas, jalankan setiap kasus beberapa kali untuk menghitung tingkat keberhasilan, lalu catat finish_reason dan penggunaan token. Melalui APIYI apiyi.com, Anda dapat menguji beberapa model menggunakan kode kompatibel OpenAI yang sama. Pengguna baru juga mendapat kuota pengujian gratis untuk verifikasi seperti ini.
Q4: Mengapa performa model penalaran melalui API bisa lebih buruk daripada versi web?
Penyebab umumnya meliputi mode berpikir yang belum diaktifkan atau anggaran berpikir yang berbeda, parameter sampling yang tidak sesuai rekomendasi resmi, cara mengirim kembali konten berpikir dalam percakapan multigilir yang keliru, serta petunjuk sistem dan alat bawaan versi web yang tidak tersedia di API. Sebaiknya periksa setiap poin berdasarkan petunjuk API dalam dokumentasi resmi model tersebut.
Q5: Setelah memastikan tidak ada kesalahan di sisi sendiri, bagaimana cara berkomunikasi dengan penyedia layanan?
Siapkan contoh permintaan dengan parameter tetap, hasil statistik dari beberapa kali pengujian, data pembanding dari kanal resmi, serta rentang waktu terjadinya masalah. Di konsol APIYI apiyi.com, Anda dapat melihat log pemanggilan dan statistik penggunaan. Sertakan catatan yang relevan agar penyebab masalah bisa ditemukan jauh lebih cepat.
Poin penting untuk menyelidiki penurunan performa model
- Penurunan performa model belum tentu berarti model telah diganti: Petunjuk sistem, konteks, dan parameter decoding juga dapat memengaruhi hasil.
- Kesalahan penggunaan parameter cukup umum: Tim Kimi mengonfirmasi bahwa sebagian besar kejanggalan dalam skor benchmark berasal dari kesalahan penggunaan parameter decoding.
- Lakukan pemeriksaan secara bertahap: Periksa sisi pemanggil terlebih dahulu, lalu lakukan uji perbandingan, dan terakhir periksa kemungkinan masalah di sisi server.
- Satu soal saja tidak cukup andal: Bandingkan distribusi keluaran dari beberapa kali pengujian, bukan hanya satu atau dua jawaban.
- Pembuktian bobot memiliki batas: FlashProve hanya memverifikasi identitas bobot dan tidak mencakup perubahan konfigurasi di tingkat produk.
- Gunakan alat pengujian yang seragam: Manfaatkan antarmuka kompatibel dan log dari APIYI apiyi.com untuk membandingkan berbagai model.
Kesimpulan
Masalah penurunan performa model selama ini lebih sering diperdebatkan berdasarkan tangkapan layar dan kesan subjektif. FlashProve dari Anthropic menawarkan cara yang dapat diverifikasi untuk memeriksa apakah model telah diganti. Namun, ini juga mengingatkan kita bahwa di luar bobot, ada lapisan konfigurasi yang turut memengaruhi hasil.
- Periksa sendiri terlebih dahulu: Parameter decoding, max_tokens, daftar pesan, dan konten yang diambil melalui RAG adalah titik awal pemeriksaan dengan biaya paling rendah.
- Lakukan perbandingan: Bandingkan hasilnya dengan performa resmi menggunakan parameter tetap, beragam kasus uji, dan pengujian berulang. Gunakan data sebagai pengganti perkiraan.
- Hubungi penyedia layanan: Setelah memastikan tidak ada kesalahan di sisi pemanggil, sertakan catatan permintaan dan hasil statistik untuk membantu penyedia menemukan masalah di sisi server.
Sebaiknya masukkan skrip perbandingan dalam artikel ini ke pengujian regresi rutin. Gunakan APIYI apiyi.com untuk memverifikasi performa beberapa model dengan cepat memakai satu set kode yang sama. Platform ini menyediakan kuota uji gratis dan antarmuka terpadu yang kompatibel dengan OpenAI.
📚 Referensi
- 36氪 / APPSO – Ulasan riset provable inference Anthropic: Prinsip FlashProve, data eksperimen, dan pembahasan penyebab penurunan kemampuan model
- Tautan:
36kr.com/p/4056019887510401 -
Keterangan: Sumber utama fakta dan data dalam artikel ini, termasuk pengantar Kimi Vendor Verifier dan Model Equality Testing
-
Anthropic Research – Provable Inference: Halaman riset resmi FlashProve
- Tautan:
anthropic.com/research/provable-inference - Keterangan: Berisi laporan teknis, kode sumber terbuka, dan pembuktian formal
Penulis: Tim teknis APIYI
Diskusi teknis: Jika mengalami kendala saat menyelidiki hasil pemanggilan model yang tidak sesuai harapan, hubungi kami melalui halaman utama APIYI di apiyi.com. Untuk panduan integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com.