Catatan penulis: Penelitian Stanford menemukan bahwa 44% kesimpulan populer tentang LLM sudah kedaluwarsa, dengan rata-rata masa berlaku hanya 15,7 bulan. Artikel ini mengubah temuan tersebut menjadi daftar periksa pengujian ulang yang bisa langsung digunakan tim pengembang untuk memilih model.
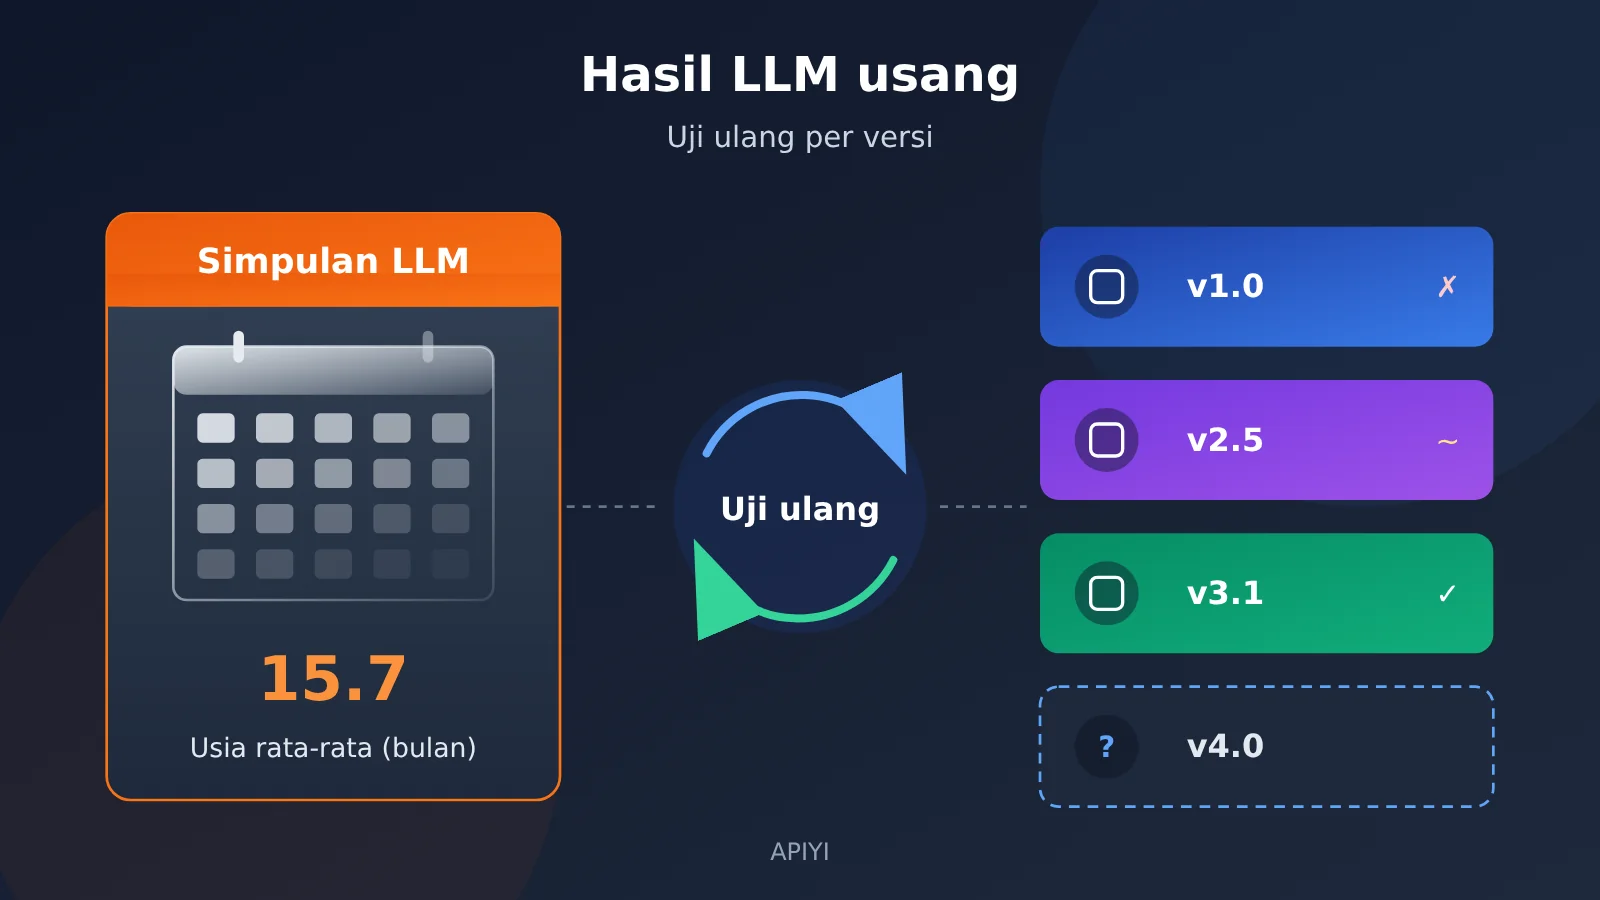
“Model tertentu tidak bisa menghitung jumlah huruf r dalam strawberry”, “informasi di tengah konteks yang panjang bisa hilang”, atau “model suka mengarang referensi”—mungkin kamu sudah sering mendengar pernyataan ini dalam makalah, grup teknologi, atau rapat pemilihan model. Peneliti Stanford Owen Queen dan James Zou menguji ulang 50 kesimpulan tentang LLM yang banyak dikutip menggunakan 20 model. Mereka menemukan bahwa 44% sudah kedaluwarsa, dan kesimpulan yang waktu kedaluwarsanya dapat diperkirakan rata-rata hanya bertahan 15,7 bulan.
Ini bukan sekadar pembahasan umum tentang “model yang makin canggih”. Penelitian tersebut menyajikan data yang jelas: jenis kesimpulan mana yang paling cepat kedaluwarsa, mana yang lebih tahan lama, dan seberapa besar perbedaan antara model dalam generasi yang sama. Artikel ini akan mengubah rekomendasi para peneliti untuk kalangan akademis menjadi proses yang bisa diikuti tim pengembang saat memilih model.
Manfaat utama: Setelah membaca artikel ini, kamu akan tahu pernyataan “model tidak pandai melakukan X” mana yang paling tidak bisa diandalkan, sekaligus membangun kebiasaan saat memilih model: mencatat nama model, versi, dan tanggal, menyimpan petunjuk, serta menguji ulang pada model yang dituju.
Poin Utama Penelitian tentang Kesimpulan LLM yang Kedaluwarsa
Tabel berikut merangkum angka-angka terpenting dari penelitian ini. Model yang diteliti dirilis antara Juli 2024 hingga September 2026 oleh 8 pengembang berbeda. Laporan terkait diterbitkan pada 3 November 2026.
| Poin | Data penelitian | Implikasi untuk pemilihan model |
|---|---|---|
| Proporsi kesimpulan yang kedaluwarsa | Dari 50 kesimpulan, 44% telah kedaluwarsa dan 34% melemah secara signifikan | Sebagian besar kelemahan model yang beredar di internet tidak lagi bisa langsung dijadikan acuan |
| Proporsi yang masih berlaku | Hanya 16% tetap berlaku, sementara 6% justru menguat | Sejumlah kecil kecenderungan yang “membandel” perlu diperhatikan dalam jangka panjang |
| Masa berlaku rata-rata | Dari 22 kesimpulan yang waktu kedaluwarsanya dapat diperkirakan, rata-ratanya adalah 15,7 bulan | Kesimpulan evaluasi yang berusia lebih dari setahun perlu disikapi dengan hati-hati |
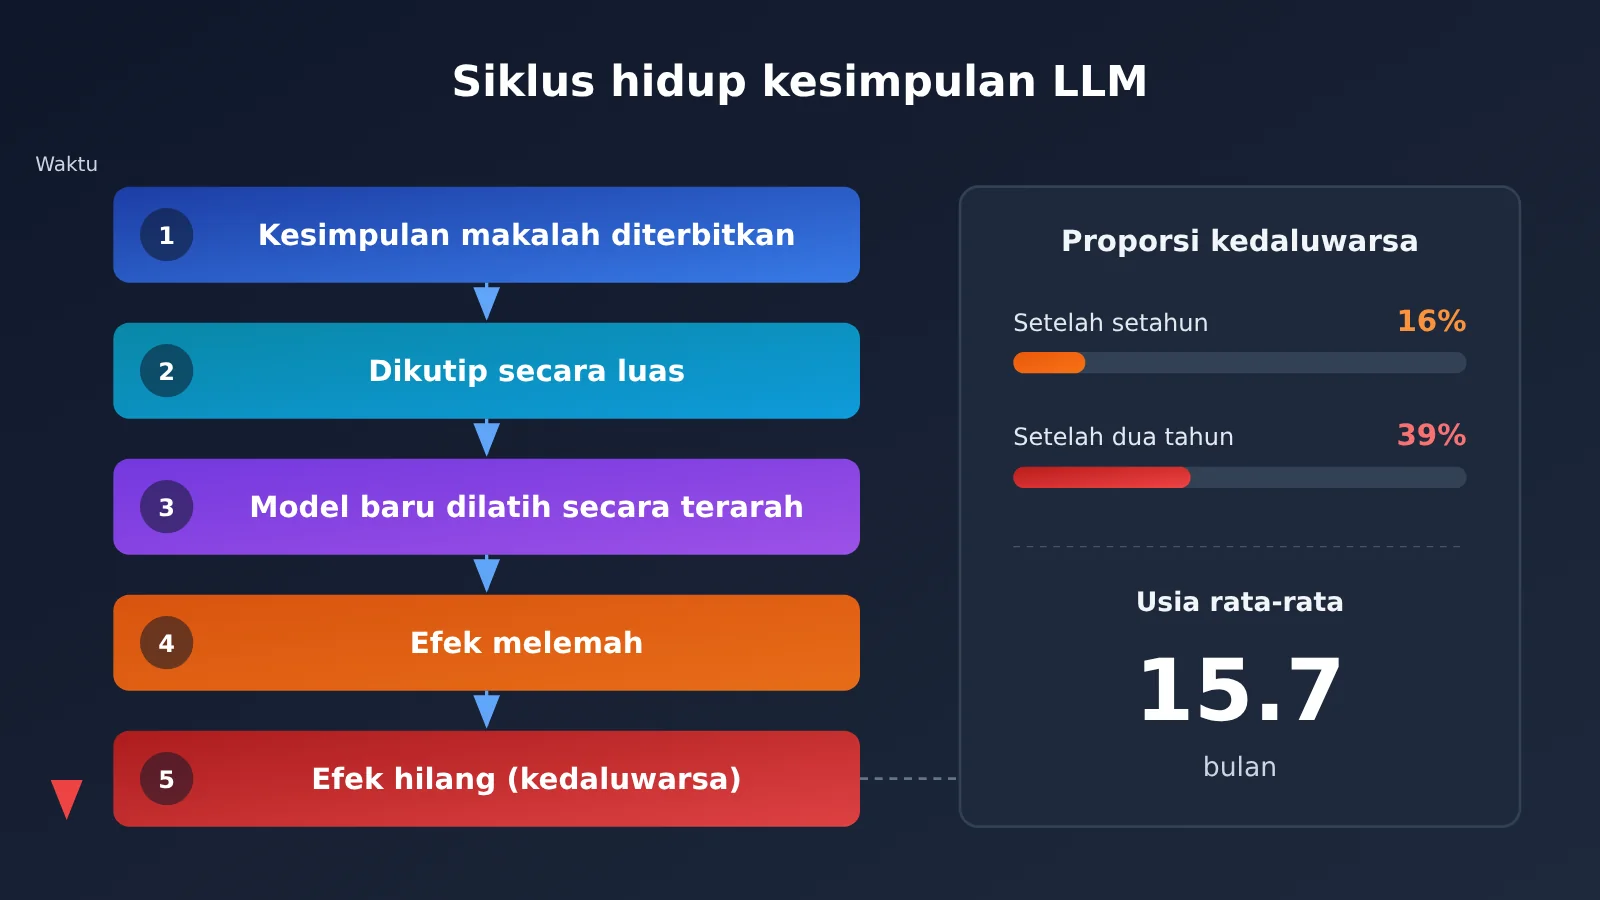
| Akumulasi seiring waktu | Setelah satu tahun, 16% kedaluwarsa; setelah dua tahun, angkanya naik menjadi 39% | Semakin lama usia sebuah kesimpulan, semakin perlu diuji ulang |
| Perbedaan model dalam generasi yang sama | Pada model yang dirilis Juli–September 2026, jumlah kesimpulan yang kedaluwarsa berkisar antara 11 hingga 30 | Kemampuan model tidak bisa disimpulkan dari waktu rilisnya |
Dua Temuan Penting tentang Kesimpulan LLM yang Kedaluwarsa
Temuan pertama berkaitan dengan arti “kedaluwarsa”. Dalam penelitian ini, istilah tersebut berarti efek yang mendasari kesimpulan awal pada dasarnya sudah hilang pada model baru, bukan sekadar membaik. Sebanyak 34% kesimpulan lainnya “melemah secara signifikan”: masalahnya masih ada, tetapi skalanya jauh lebih kecil daripada yang dijelaskan dalam makalah awal. Jika kedua kelompok ini digabungkan, hampir 80% kesimpulan populer tidak lagi bisa diterapkan begitu saja pada model saat ini.
Temuan kedua adalah bahwa “masa berlaku” sebuah kesimpulan sangat berkaitan dengan jenisnya. Kesimpulan tentang kelemahan kemampuan, yang menjelaskan “apa yang tidak bisa dilakukan” model, paling cepat kedaluwarsa. Sementara itu, kesimpulan tentang preferensi, yang menjelaskan “apa yang cenderung dilakukan” model, bertahan lebih lama. Menurut peneliti, kesalahan terkait kemampuan biasanya memiliki “jawaban yang benar”, sehingga pengembang punya sasaran pelatihan yang jelas untuk dioptimalkan. Preferensi dan kecenderungan tidak memiliki jawaban baku, sehingga secara alami lebih sulit “diperbaiki”.
Kesimpulan tentang LLM mana yang paling cepat usang
Memahami jenis kesimpulan adalah langkah awal untuk menentukan prioritas pengujian ulang. Berdasarkan isi laporan penelitian, tabel berikut membagi kesimpulan yang umum ditemukan menjadi dua kelompok: “mudah usang” dan “relatif bertahan lama”.
| Jenis kesimpulan | Contoh | Status dalam penelitian | Prioritas pengujian ulang |
|---|---|---|---|
| Kelemahan penalaran dan kemampuan | Menghitung huruf dalam strawberry, aritmetika dalam basis bilangan yang tidak familier, kehilangan informasi di tengah konteks panjang, meninggalkan jawaban yang benar setelah dibantah pengguna | Dari 9 kesimpulan tentang penalaran, 5 sudah usang; tidak ada yang bertahan atau menguat | Tertinggi: wajib diuji ulang sebelum dikutip |
| Akurasi fakta dan halusinasi | Mengarang referensi ilmiah | Pada sebagian model, angkanya sudah turun mendekati 0; pada model tertentu masih tinggi | Tinggi: perbedaannya sangat besar, setiap model harus diuji |
| Penalaran kombinatorial | Pertanyaan dua langkah, “kutukan pembalikan”, jawaban yang bertentangan pada pasangan pertanyaan tentang waktu | Sudah melemah, tetapi masih terdeteksi | Menengah-tinggi: masalahnya masih ada, tetapi tingkatnya banyak berubah |
| Preferensi saat menjadi penilai | Lebih menyukai jawabannya sendiri, memberi skor serupa untuk makalah yang diterima dan ditolak, terpengaruh oleh cara abstrak medis dirumuskan | Bertahan atau menguat | Menengah: risiko jangka panjang yang perlu dikonfirmasi secara berkala |
| Sanjungan dan kecenderungan menyenangkan pengguna | Mengikuti pendapat pengguna | Cukup banyak ditemukan di antara kesimpulan yang bertahan atau menguat | Menengah: prioritaskan untuk aplikasi layanan pelanggan dan konsultasi |
| Kecenderungan distribusi output | Kecenderungan politik ke kiri, jawaban yang sangat mirip untuk pertanyaan terbuka, distribusi angka acak yang tidak merata | Bertahan atau menguat | Menengah: perlu diperhatikan dalam pembuatan konten dan pengambilan sampel |
Perlu dicatat bahwa untuk kesimpulan tentang penalaran, isi laporan menyatakan “5 dari 9 sudah usang, dan tidak ada yang bertahan atau menguat”, sedangkan keterangan gambar menyebutkan “semua 9 kesimpulan telah memudar”. Jika keduanya digabungkan, artinya 5 sudah usang dan sisanya juga melemah, tanpa satu pun yang tetap seperti semula. Karena kami belum dapat melihat daftar lengkap 50 kesimpulan dan metode pengujian ulang dalam makalah aslinya, klasifikasi pastinya tetap harus mengacu pada makalah tersebut.
Mengapa kesimpulan tentang preferensi LLM lebih bertahan lama
Dari 11 kesimpulan yang bertahan atau menguat, 3 berkaitan dengan “LLM sebagai penilai”, 3 berkaitan dengan sanjungan dan kecenderungan menyenangkan pengguna, sementara sisanya menyangkut kecenderungan politik, kemiripan jawaban untuk pertanyaan terbuka, dan distribusi angka acak yang tidak merata. Masalah-masalah ini punya satu kesamaan: sulit menentukan output seperti apa yang “benar”, sehingga sulit pula menghilangkannya melalui pelatihan yang terarah.
Bagi tim pengembang, ini berarti urutan risiko yang mungkin bertentangan dengan dugaan. Masalah yang sering dibicarakan seperti “model tidak bisa menghitung huruf” mungkin sudah lama teratasi. Sebaliknya, yang benar-benar perlu diwaspadai adalah kecenderungan sistematis yang tidak begitu mencolok. Jika Anda menggunakan LLM untuk penilaian, pemberian skor, atau rekomendasi otomatis, masalah preferensi sebaiknya dimasukkan ke dalam pengujian regresi rutin.
Kesimpulan tentang bias sosial pada LLM menunjukkan hasil yang beragam
Peneliti secara khusus menunjukkan bahwa kesimpulan tentang bias sosial tidak bergerak ke arah yang sama. Kecenderungan politik ke kiri masih ada, stereotip gender dan bias asosiasi implisit sudah melemah, sedangkan bias terhadap pengguna bahasa Inggris Afrika-Amerika bahkan menunjukkan pembalikan arah dalam data tren. Ini sekali lagi menunjukkan bahwa pernyataan umum seperti “model memiliki bias tertentu secara luas” hanya bermakna jika dikaitkan dengan model dan waktu yang spesifik.
Mengapa performa LLM tidak bisa ditebak dari vendor atau tanggal rilis
Saat memilih model, banyak tim berpegang pada asumsi sederhana: model baru pasti lebih baik daripada model lama, model dari vendor yang sama akan punya performa serupa, dan model besar pasti lebih andal daripada model kecil. Data penelitian justru membantah asumsi tersebut.
Contoh paling jelas terlihat dalam pengujian referensi yang dikarang. Dalam studi asli Walters dan Wilder pada 2023, GPT-3.5 mengarang 55% referensinya. Peneliti Stanford menguji model-model terkini dengan petunjuk yang sama: hasilnya 0% untuk GPT-6.1 Sol dan 1% untuk Claude Sonnet 5.5. Namun, 69% referensi dari Qwen3.7-Flash masih dikarang, meski model ini juga dirilis pada 2026. Angka itu bahkan lebih tinggi daripada GPT-3.5 tiga tahun sebelumnya.
Perbedaan dalam periode rilis yang sama juga mengejutkan. Di antara model yang dirilis pada Juli hingga September 2026, jumlah kesimpulan yang “dibantah” berkisar dari 11 pada DeepSeek V4 Pro hingga 30 pada GPT-6.1 Sol. Penelitian tersebut menegaskan bahwa tanggal rilis, vendor, maupun ukuran model tidak bisa digunakan untuk memprediksi pola ini secara andal.
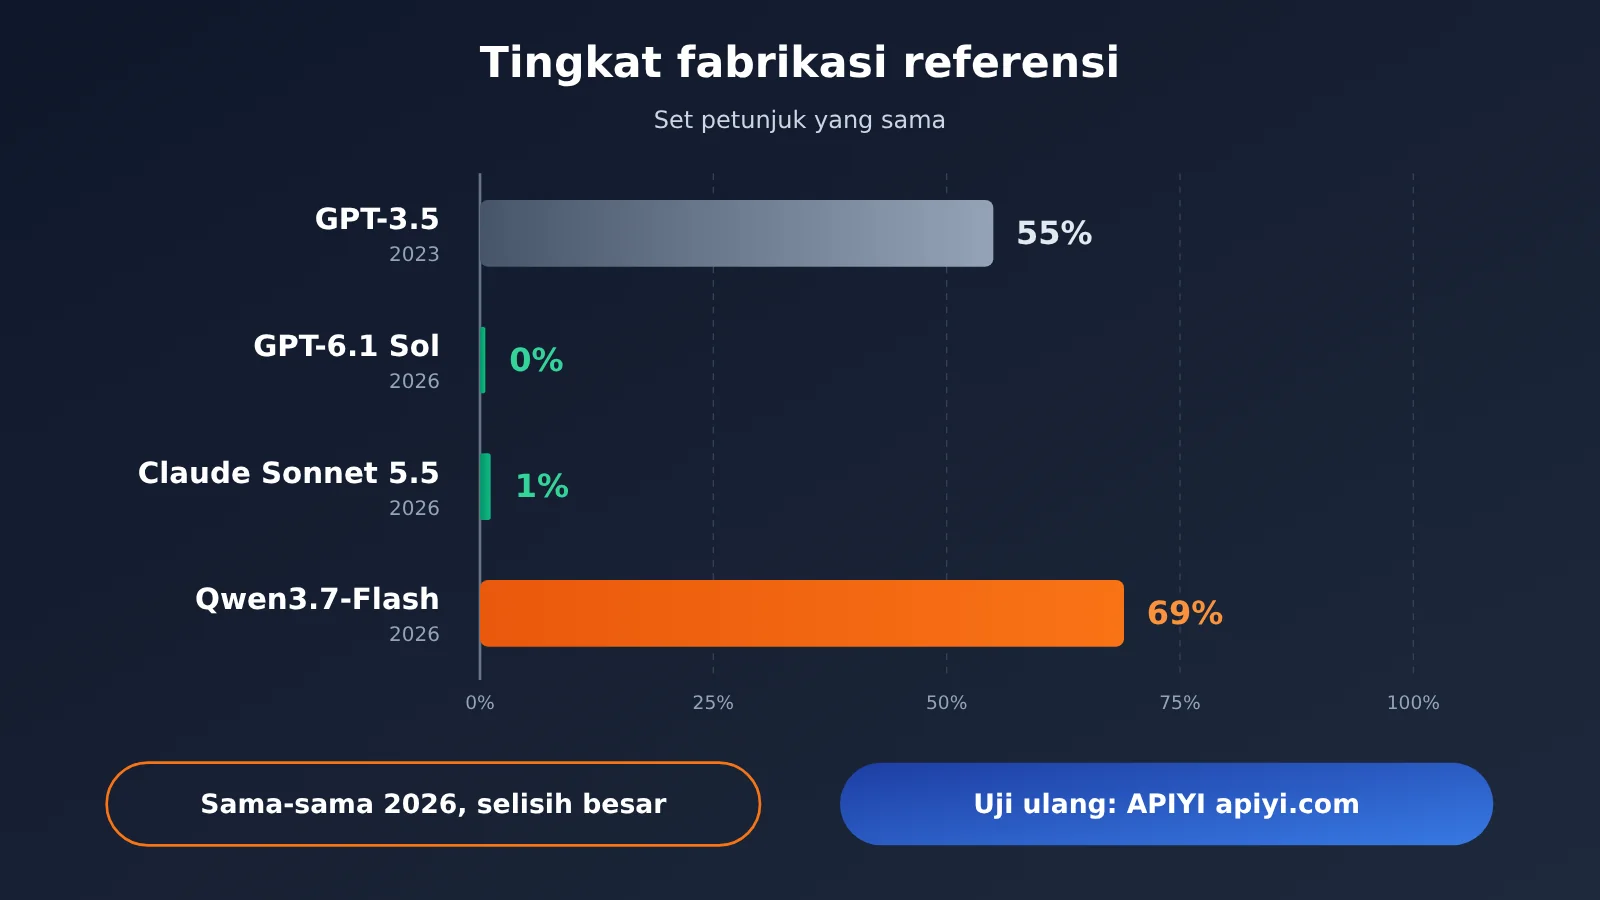
Pesan utama grafik ini: model dari periode yang sama bisa menunjukkan hasil yang sangat bertolak belakang dalam pengujian yang sama. Jika ingin mereplikasi perbandingan ini di tim, kamu bisa menggunakan platform antarmuka terpadu seperti APIYI apiyi.com untuk menguji beberapa kandidat model dengan kumpulan petunjuk yang sama. Untuk mengetahui model yang tersedia, lihat daftar model resmi platform tersebut.
Peneliti juga mengingatkan agar peningkatan ini tidak diartikan sebagai “masalah sudah sepenuhnya teratasi”. Pada pertanyaan dua langkah, yang membutuhkan penggabungan dua fakta yang diketahui, Claude Sonnet 5.5 masih menjawab sekitar 10% pertanyaan gabungan dengan salah meskipun mampu menjawab kedua subpertanyaannya secara terpisah. Sementara itu, makalah asli melaporkan angka 43% untuk ChatGPT. Angkanya memang turun drastis, tetapi jika bisnis kamu bergantung pada penggabungan fakta dalam beberapa langkah, 10% masih cukup untuk menyebabkan insiden di lingkungan produksi.
Panduan cepat menguji ulang pilihan LLM: daftar 5 langkah
Saran para peneliti untuk kalangan akademis adalah memperlakukan kesimpulan empiris tentang LLM sebagai “pengamatan terhadap model tertentu pada waktu tertentu”, bukan sebagai kebenaran universal. Makalah sebaiknya mencatat model, versi, dan tanggal, serta memublikasikan petunjuk dan kode analisis agar pengujian ulang pada model mendatang lebih mudah dilakukan. Saran ini bisa langsung diterapkan dalam proses pemilihan model di tim pengembang.
Langkah 1: Lengkapi metadata untuk setiap kesimpulan tentang LLM
Baik kesimpulan berasal dari makalah, blog, pengalaman rekan kerja, maupun pengujian sendiri, lengkapi dulu kolom-kolom dalam tabel berikut. Kesimpulan yang tidak memiliki informasi penting hanya bisa dianggap sebagai “petunjuk yang perlu diverifikasi”, bukan dasar pengambilan keputusan.
| Kolom metadata | Informasi yang dicatat | Mengapa perlu dicatat |
|---|---|---|
| Nama model | Nama model lengkap, bukan sekadar “model dari vendor tertentu” | Perbedaan antar-model dari vendor yang sama bisa sangat besar |
| Versi spesifik | Nomor versi atau identitas snapshot | Kinerja model dengan nama yang sama bisa berubah setelah diperbarui |
| Tanggal pengujian | Tanggal lengkap hingga hari | Untuk menilai “usia” kesimpulan, dengan masa berlaku rata-rata 15,7 bulan sebagai acuan |
| Petunjuk lengkap | Petunjuk sistem, masukan pengguna, dan contoh | Hasil tidak bisa direproduksi jika petunjuknya berbeda |
| Parameter pemanggilan | Temperatur, panjang keluaran maksimum, dan sebagainya | Parameter sampling dapat memengaruhi kesimpulan tentang stabilitas |
| Kriteria penilaian | Apa yang dianggap lulus dan gagal | Tanpa kriteria, hasil pengujian dari orang yang berbeda tidak bisa dibandingkan |
| Ukuran sampel | Jumlah kasus uji yang dicoba | Tangkapan layar dari satu percakapan tidak bisa mewakili proporsi hasil |
Langkah 2: Tentukan prioritas pengujian ulang LLM berdasarkan jenis kesimpulan
Setelah mendapatkan sebuah kesimpulan, tentukan dulu jenisnya. Kesimpulan tentang kelemahan kemampuan—seperti kesulitan menghitung, salah berhitung, gagal mengingat, atau mengubah jawaban saat dibantah—secara default dianggap “kemungkinan besar sudah usang” dan wajib diuji ulang sebelum dikutip. Kesimpulan tentang kecenderungan preferensi—seperti mengutamakan diri sendiri, menjilat, atau menghasilkan keluaran yang seragam—secara default dianggap “kemungkinan besar masih ada” dan perlu dimasukkan ke dalam pengujian regresi jangka panjang.
Pertimbangkan juga usia kesimpulannya. Menurut data penelitian, kesimpulan yang berusia lebih dari satu tahun memiliki kemungkinan sekitar 16% sudah usang; setelah lebih dari dua tahun, angkanya naik menjadi 39%. Jika model yang dibahas dalam kesimpulan sudah digantikan oleh model kandidat Anda, lakukan pengujian ulang, seberapa pun terkenalnya kesimpulan tersebut.
Langkah 3: Ubah kesimpulan menjadi kasus uji LLM yang dapat dijalankan
Pernyataan seperti “model kurang mampu memahami dokumen panjang” tidak bisa langsung diuji dan perlu diubah menjadi kasus yang spesifik. Misalnya, tempatkan satu fakta penting di awal, tengah, dan akhir dokumen panjang, lalu ajukan pertanyaan untuk setiap posisi dan hitung tingkat jawaban yang benar. Atau, minta model memberikan jawaban yang benar terlebih dahulu, lalu simulasikan bantahan dari pengguna dan hitung seberapa sering model mengubah jawabannya.
Saat menyusun kasus uji, gunakan data yang sedekat mungkin dengan data bisnis Anda, alih-alih hanya memakai ulang contoh sederhana dari makalah. Soal-soal klasik yang dinyatakan “usang” dalam penelitian mungkin sudah digunakan secara khusus untuk melatih model. Lolos pada soal klasik tidak berarti model juga akan lolos pada data bisnis Anda.
Langkah 4: Uji ulang semua kandidat LLM dengan kumpulan petunjuk yang sama
Kunci pengujian ulang adalah mengendalikan variabel: gunakan kumpulan petunjuk, parameter, dan kriteria penilaian yang sama, lalu ubah hanya modelnya. Jika setiap model memerlukan SDK dan penanganan autentikasi tersendiri, biaya pengujian ulang bisa menjadi begitu tinggi sehingga tim enggan melakukannya.
🚀 Saran praktis: APIYI apiyi.com menggunakan standar OpenAI API yang seragam. Dengan satu token, Anda dapat memanggil lebih dari 200 model. Untuk beralih antar kandidat model, cukup ubah parameter model, sementara petunjuk dan parameter lainnya tetap sama. Ini cocok untuk pengujian ulang yang membandingkan beberapa model. Untuk model dan versi yang didukung, silakan merujuk pada daftar model resmi platform.
Langkah 5: Buat arsip kesimpulan LLM dan tinjau secara berkala
Simpan hasil setiap pengujian ulang sebagai “arsip kesimpulan” yang setidaknya berisi kesimpulan asli, metadata, hasil pengujian ulang, dan tanggal peninjauan berikutnya. Dengan mengacu pada rata-rata masa berlaku 15,7 bulan, sebaiknya tinjau kesimpulan yang menjadi dasar bisnis inti setiap tiga atau enam bulan. Saat berencana meningkatkan versi model, lakukan pengujian ulang menyeluruh tanpa pengecualian.
| Skenario | Cakupan pengujian ulang yang disarankan | Waktu pengujian ulang |
|---|---|---|
| Pemilihan pertama | Semua kesimpulan yang memengaruhi keputusan + kasus penggunaan bisnis inti | Sebelum peninjauan pemilihan |
| Peningkatan versi model | Semua kasus uji regresi | Sebelum versi baru diterapkan |
| Mengutip kesimpulan eksternal | Hanya kesimpulan yang relevan | Sebelum dimasukkan ke dokumen rancangan |
| Operasional rutin | Kasus terkait kecenderungan preferensi + kasus berisiko tinggi | Setiap tiga atau enam bulan |
| Muncul anomali di lingkungan produksi | Kemampuan yang terkait dengan anomali | Segera |
💡 Saran memilih model: Saat memilih model, jangan mulai dengan bertanya “model mana yang paling kuat”. Tentukan dulu jenis kesalahan yang paling berisiko bagi bisnis Anda, lalu uji ulang kandidat model dengan fokus pada risiko tersebut. Melalui antarmuka terpadu APIYI apiyi.com, Anda dapat membandingkan beberapa kandidat model dalam alur pengujian yang sama dan mengurangi variabel tambahan pada tahap integrasi.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa yang dimaksud dengan kesimpulan tentang LLM yang “kedaluwarsa”?
Dalam penelitian Stanford ini, “kedaluwarsa” berarti efek yang mendasari suatu kesimpulan empiris tentang LLM hampir tidak lagi ditemukan pada model baru. Ini berbeda dari “melemah”, yang berarti masalahnya masih ada, tetapi jauh berkurang. Dari 50 kesimpulan, 44% kedaluwarsa dan 34% melemah.
Q2: Apa perbedaan antara kesimpulan tentang kelemahan kemampuan dan kecenderungan preferensi LLM?
Kesimpulan tentang kelemahan kemampuan menjelaskan apa yang “tidak bisa dilakukan” model, seperti menghitung huruf, melakukan aritmetika, atau mempertahankan informasi dalam konteks panjang. Masalah ini memiliki jawaban benar yang jelas dan relatif mudah diperbaiki melalui pelatihan khusus, sehingga kesimpulannya paling cepat kedaluwarsa. Kesimpulan tentang kecenderungan preferensi menjelaskan bagaimana model “cenderung bertindak”, seperti lebih menyukai jawabannya sendiri atau menyenangkan pengguna secara berlebihan. Karena tidak ada jawaban baku, kecenderungan ini lebih bertahan lama.
Q3: Kapan penelitian tentang kedaluwarsanya kesimpulan LLM ini diterbitkan?
Laporan terkait diterbitkan pada 3 November 2026. Penelitian ini menguji 20 model dari 8 pengembang, yang dirilis antara Juli 2024 dan September 2026. Karena model berkembang dengan cepat, data yang dikutip dalam artikel ini juga memiliki batas masa berlaku. Sebaiknya periksa makalah aslinya sebelum menggunakannya.
Q4: Tim mana yang paling perlu menguji ulang LLM berdasarkan versinya?
Terutama tim dalam situasi berikut:
– **Tim yang sedang memilih atau mengganti model**: agar tidak mencoret kandidat berdasarkan kesan tentang kelemahannya dua tahun lalu
– **Tim yang menggunakan LLM untuk menilai dan memberi skor**: kecenderungan seperti lebih menyukai jawaban sendiri dan terpengaruh oleh pilihan kata masih ada
– **Aplikasi yang sensitif terhadap akurasi fakta**: tingkat fabrikasi referensi pada model dari generasi yang sama berkisar antara 0% hingga 69%
– **Produk percakapan untuk layanan pelanggan atau konsultasi**: kecenderungan untuk menyenangkan dan mengiyakan pengguna secara berlebihan perlu dipantau dalam jangka panjang
Q5: Bagaimana cara menguji ulang beberapa LLM dengan biaya rendah?
Kuncinya adalah menggunakan lapisan akses terpadu agar lebih mudah “hanya mengganti model, tanpa mengubah variabel lain”:
1. Kunjungi APIYI apiyi.com, daftar akun, dan dapatkan kunci API
2. Pastikan model dan versi kandidat tersedia dalam daftar model resmi
3. Gunakan kumpulan petunjuk dan parameter yang sama, ubah hanya parameter model untuk memanggil setiap model secara bergantian, lalu catat hasil dan metadatanya
Dengan begitu, Anda bisa fokus merancang kasus pengujian, alih-alih berulang kali mengintegrasikan antarmuka dari berbagai penyedia.
Q6: Bisakah skor model baru di papan peringkat langsung digunakan sebagai pengganti pengujian ulang?
Sebaiknya jangan bergantung sepenuhnya pada skor tersebut. Penelitian menunjukkan bahwa tanggal rilis, penyedia, dan ukuran model tidak dapat secara andal memprediksi kinerja model pada kesimpulan tertentu. Perbedaan antarmodel yang dirilis dalam periode yang sama pun sangat besar. Papan peringkat cocok untuk penyaringan awal, tetapi keputusan akhir sebaiknya didasarkan pada hasil pengujian ulang menggunakan data bisnis Anda sendiri.
Q7: Apa saja keterbatasan penelitian LLM ini?
Pertama, daftar lengkap 50 kesimpulan dan metode pengujian ulang perlu dilihat dalam makalah asli, karena laporan sekunder tidak mencakup semua detail. Kedua, ada perbedaan antara uraian dan keterangan gambar dalam laporan terkait kesimpulan tentang penalaran, sehingga perlu merujuk pada sumber aslinya. Terakhir, hasil penelitian ini juga merupakan pengamatan terhadap “model tertentu pada waktu tertentu”. Mengikuti logika penelitinya sendiri, hasil tersebut juga bisa kedaluwarsa seiring waktu.
Poin Utama: Temuan tentang LLM Bisa Kedaluwarsa
- Banyak temuan sudah kedaluwarsa: Dari 50 temuan populer tentang LLM, 44% sudah kedaluwarsa dan 34% tidak lagi berlaku sekuat sebelumnya
- Masa berlakunya singkat: Temuan yang masa berlakunya bisa diperkirakan rata-rata hanya bertahan 15,7 bulan; setelah dua tahun, hampir 40% kedaluwarsa
- Temuan tentang kelemahan kemampuan paling cepat kedaluwarsa: Klaim tentang menghitung huruf, aritmetika, dan hilangnya informasi dalam konteks panjang perlu diprioritaskan untuk diuji ulang
- Kecenderungan preferensi lebih bertahan lama: Preferensi terhadap diri sendiri, perilaku menjilat, dan kemiripan output perlu masuk ke dalam pengujian regresi jangka panjang
- Tidak bisa disimpulkan dari vendor atau waktu rilis: Di antara model yang sama-sama dirilis pada 2026, tingkat referensi yang dikarang berkisar dari 0% hingga 69%
- Metadata adalah prasyarat: Tanpa nama model, versi, tanggal, atau petunjuk, temuan sulit direproduksi
- Antarmuka terpadu menekan biaya pengujian ulang: Dengan APIYI apiyi.com, perbandingan antar-model bisa dilakukan hanya dengan mengubah parameter
model
Kesimpulan
Temuan tentang LLM rata-rata kedaluwarsa dalam 15,7 bulan. Angka ini mengingatkan kita bahwa:
- Temuan punya masa berlaku: Setiap klaim tentang LLM perlu dipandang sebagai “pengamatan terhadap model tertentu pada waktu tertentu”
- Jenis temuan menentukan prioritas: Uji ulang temuan tentang kelemahan kemampuan terlebih dahulu, dan pantau kecenderungan preferensi dalam jangka panjang
- Versi sangat menentukan: Vendor, waktu rilis, dan ukuran model tidak bisa menggantikan pengujian langsung terhadap versi tertentu
Saat berikutnya mendengar “model tertentu tidak bagus dalam X” di rapat pemilihan model, coba ajukan tiga pertanyaan: Versi yang mana? Kapan diuji? Apakah petunjuknya masih tersedia? Jika jawabannya tidak ada, masukkan klaim tersebut ke daftar pengujian ulang.
APIYI apiyi.com dapat digunakan untuk mengintegrasikan model kandidat ke dalam alur pengujian yang sama, lalu menguji ulang beberapa model dengan cepat menggunakan kumpulan petunjuk yang sama. Untuk model yang tersedia, lihat daftar resmi.
📚 Referensi
- THE DECODER – Rapid LLM development is outrunning the research meant to explain it, study finds: Laporan tentang penelitian Stanford mengenai kesimpulan LLM yang sudah tidak berlaku
- Tautan:
the-decoder.com/rapid-llm-development-is-outrunning-the-research-meant-to-explain-it-study-finds -
Keterangan: Memuat data utama, termasuk 44% kesimpulan yang sudah tidak berlaku, rata-rata masa berlaku 15,7 bulan, kasus referensi yang dikarang, dan perbedaan antarmodel dalam generasi yang sama
-
Makalah asli oleh Owen Queen dan James Zou: Penelitian ulang oleh peneliti Stanford terhadap 50 kesimpulan tentang LLM
- Tautan: Cari melalui nama penulis dan judul makalah di platform pencarian akademik
- Keterangan: Artikel ini belum memperoleh teks lengkap makalah asli. Untuk daftar 50 kesimpulan dan metode pengujian ulang, silakan merujuk ke makalah aslinya
Penulis: Tim teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama APIYI di apiyi.com. Untuk informasi lebih lanjut tentang integrasi model, kunjungi pusat dokumentasi di docs.apiyi.com