Catatan penulis: Berangkat dari struktur biaya layanan inferensi, artikel ini menjelaskan mengapa layanan Token mudah merugi dan memberikan daftar periksa yang bisa langsung dipraktikkan untuk menilai penyedia API model.
Token bahkan sudah dijual lewat siaran langsung, tetapi kinerja keuangan penyedia layanan inferensi seperti SiliconFlow masih belum menggembirakan. Di berita lain, sebuah perusahaan menganggap Claude terlalu mahal dan beralih ke GLM; dengan 56 unit B200, perusahaan itu mendukung 2.000 engineer dan menurunkan biaya AI sekitar 90%. Jika kedua hal itu dilihat bersama, struktur biaya layanan Token memang memiliki pola tersendiri. Artikel ini akan berangkat dari struktur biaya layanan inferensi, menjelaskan mengapa layanan Token bisa merugi, lalu berfokus pada pertanyaan yang benar-benar menjadi perhatian developer: bagaimana menilai apakah sebuah penyedia API model benar-benar andal.
Ini bukan artikel lain yang sekadar mengulas gosip industri. Pembahasannya dibangun di sekitar variabel teknis, termasuk depresiasi GPU, utilisasi, selisih biaya Prefill dan Decode, KV Cache, cache hit rate, dan strategi subsidi. Setelah membacanya, Anda bisa langsung memakainya dalam evaluasi pemilihan layanan.
Nilai inti: Setelah membaca artikel ini, Anda akan memahami komposisi biaya di balik harga Token dan menguasai metode evaluasi penyedia layanan dengan 6 dimensi. Anda juga akan tahu cara memeriksa apakah penagihan transparan dengan menggunakan data pemanggilan yang nyata.
Mengapa Layanan Token Bisa Rugi: Poin Inti Struktur Biaya Inferensi
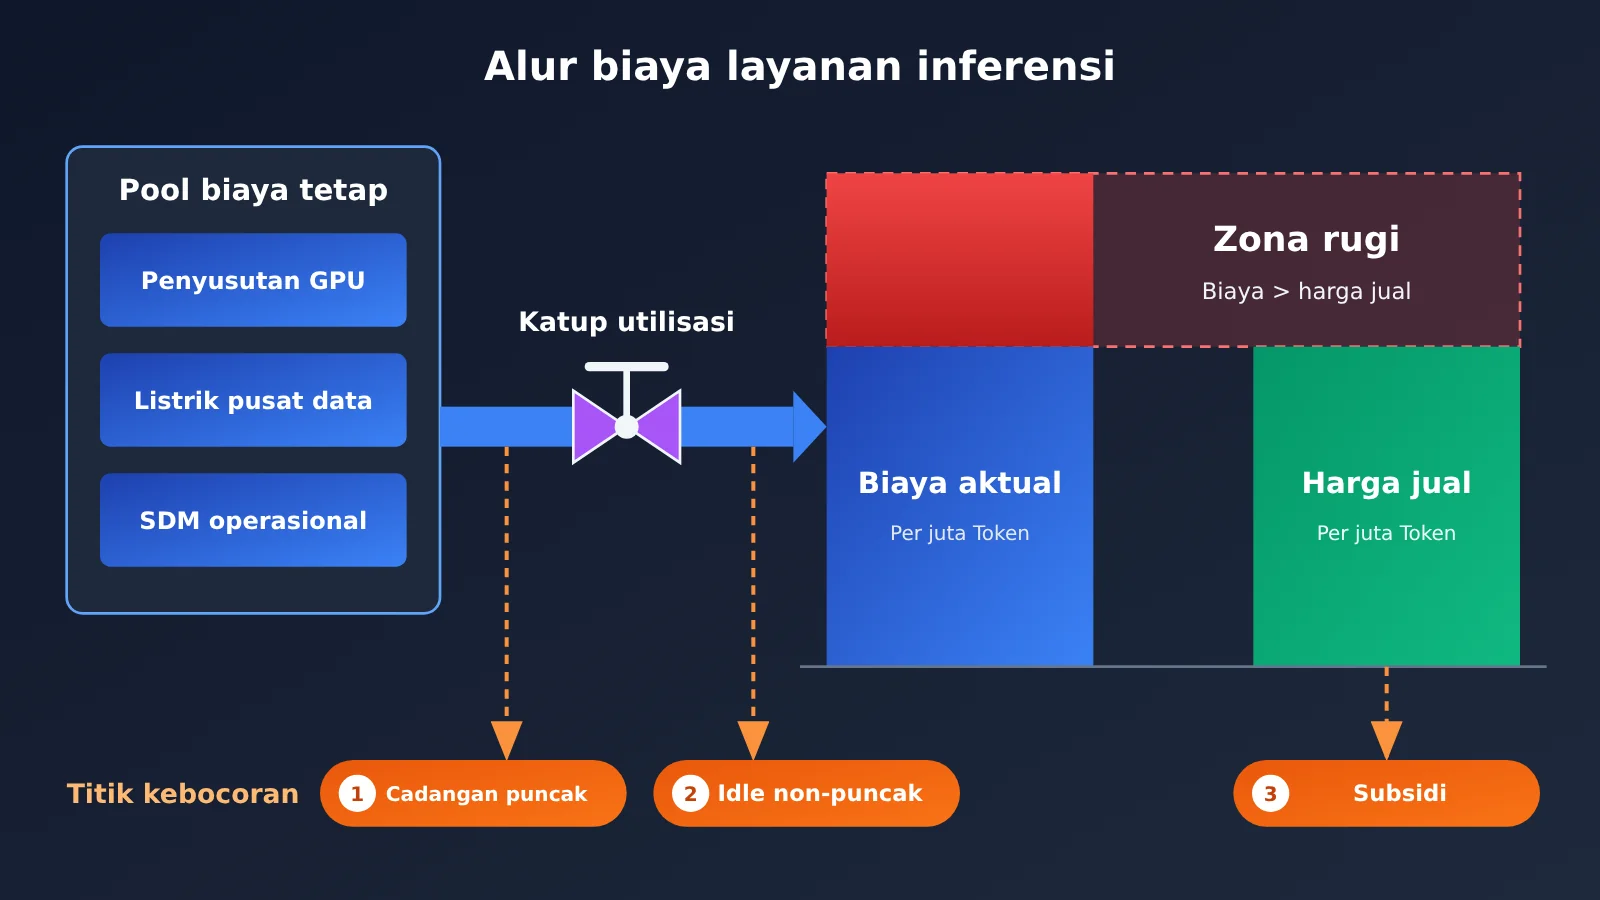
Mari langsung ke kesimpulannya. Sebagian besar biaya layanan inferensi adalah biaya tetap, sementara pendapatannya ditagih berdasarkan jumlah Token. Keduanya dihubungkan oleh “utilisasi”. Jika utilisasi tidak naik, atau harga ditekan persaingan hingga mendekati biaya marginal, pembukuan akan menunjukkan kerugian.
| Elemen biaya | Penjelasan | Dampak terhadap harga per Token |
|---|---|---|
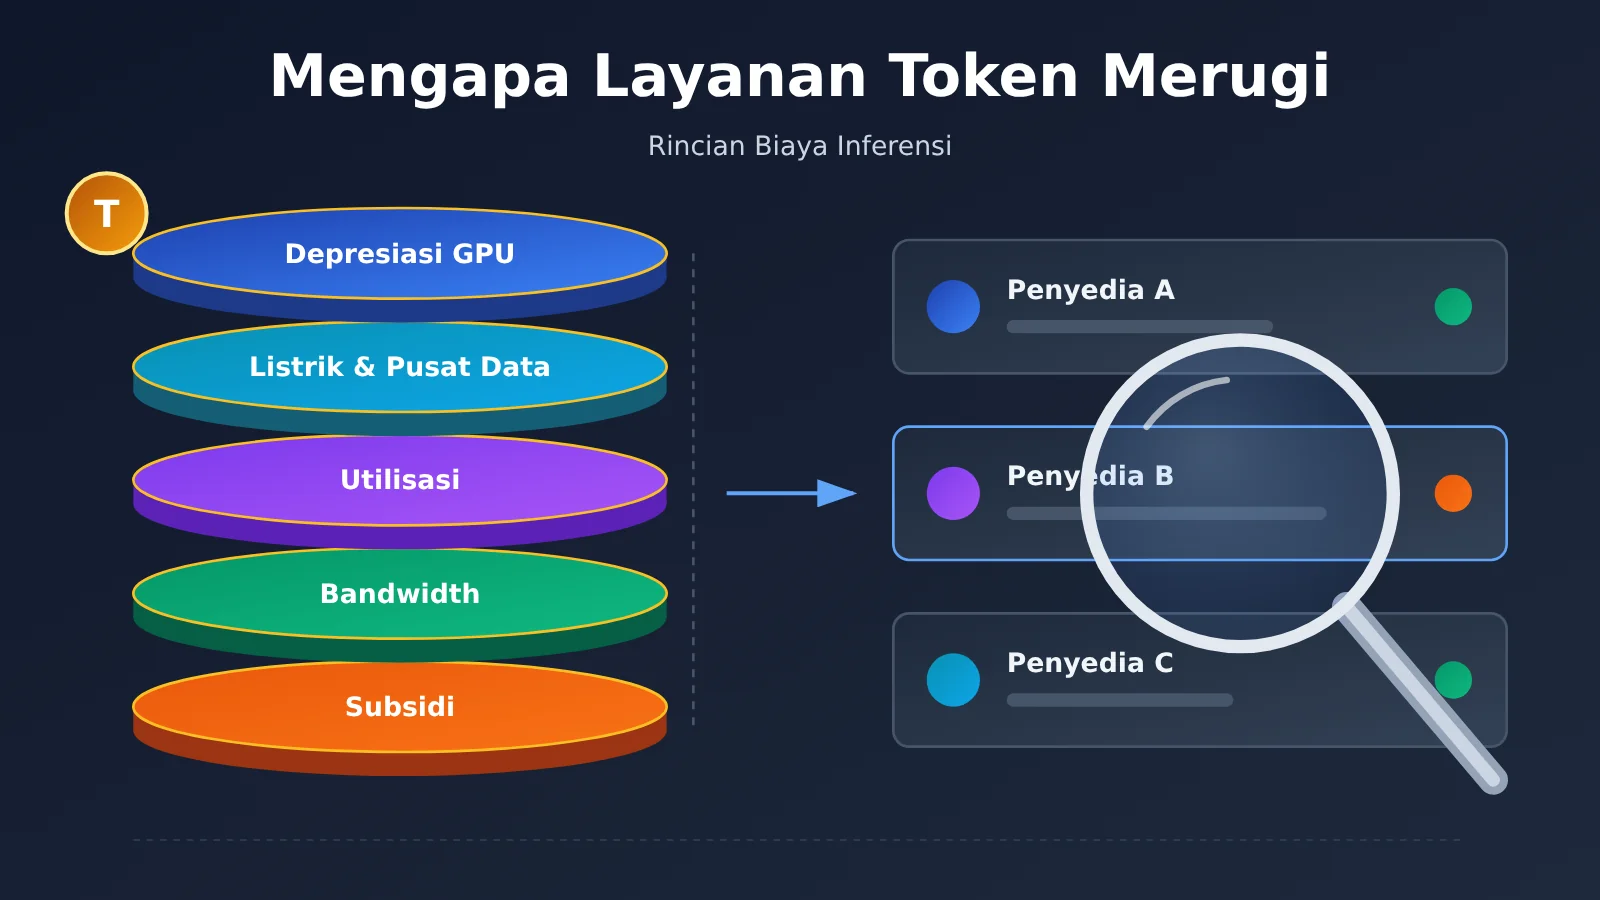
| Belanja modal dan depresiasi GPU | Biaya pembelian atau sewa jangka panjang GPU kelas atas, diamortisasi sesuai masa pakai | Biaya tetap; semakin rendah utilisasi, semakin tinggi alokasi biaya per Token |
| Pusat data, listrik, jaringan | Colocation, pendinginan, bandwidth, pemulihan bencana lintas wilayah | Biaya semi-tetap; baru bisa terbagi ke volume lebih besar setelah skala operasi membesar |
| Utilisasi GPU | Proporsi waktu GPU benar-benar menjalankan inferensi dan tingkat saturasi batching | Tuas utama laba-rugi; selisih beban puncak dan lembah langsung menggerus keuntungan |
| Struktur Prefill / Decode | Input diproses paralel, output dihasilkan Token demi Token | Token output lebih mahal; skenario output panjang memberi tekanan besar |
| Konteks panjang dan KV Cache | Memori GPU terpakai cache, sehingga menurunkan kapasitas konkurensi | Permintaan konteks panjang mengurangi jumlah pengguna yang bisa dilayani |
| Subsidi dan akuisisi pelanggan | Kuota gratis, harga rendah untuk menarik trafik, bagi hasil kanal | Jangka pendek menaikkan volume, jangka panjang menurunkan margin kotor |
Penjelasan Rinci Poin Penting Struktur Biaya Layanan Token
Ketidaksesuaian antara biaya tetap dan pendapatan berbasis pemakaian adalah alasan pertama. Satu server GPU dengan konfigurasi penuh, entah ada permintaan atau tidak, tetap menanggung depresiasi, biaya listrik, dan biaya pusat data. Pengguna hanya membayar Token yang benar-benar dikonsumsi. Pada jam sibuk siang hari, perlu disediakan cukup komputasi untuk menjamin latensi; pada jam sepi malam, komputasi itu menganggur. Biaya periode idle pada akhirnya harus dialokasikan ke Token yang terjual pada jam sibuk. Jika penetapan harga hanya mengacu pada “biaya teoretis saat kapasitas penuh”, operasional nyata hampir pasti rugi.
Persaingan harga menekan harga satuan ke arah biaya marginal adalah alasan kedua. Bobot model open-source tersedia untuk semua orang; banyak penyedia layanan inferensi menerapkan model yang sama, ruang diferensiasinya sangat kecil, sehingga harga wajar menjadi alat persaingan utama. Memasukkan Token ke promosi live streaming menunjukkan komoditas jenis ini sudah mendekati “komoditas terstandarisasi”. Dalam kondisi seperti ini, penyedia layanan sulit menutup biaya tetap lewat premi harga, dan hanya bisa bersaing pada skala serta efisiensi penjadwalan.
Rincian Biaya Layanan Inferensi: Bagaimana Harga Satuan Token Dihitung
Untuk memahami mengapa layanan Token bisa merugi, kita perlu memecah satu permintaan inferensi menjadi dua tahap. Setiap tahap mengonsumsi sumber daya yang berbeda, sehingga dasar penetapan biayanya juga berbeda. Inilah alasan banyak penyedia layanan menetapkan harga terpisah untuk input, output, dan cache.
Prefill dan Decode: Mengapa Token Output Lebih Mahal
Sebuah permintaan pertama masuk ke tahap Prefill. Model memproses seluruh Token input secara paralel, komputasinya padat tetapi efisien, sehingga daya komputasi GPU dapat dimanfaatkan sepenuhnya. Setelah itu masuk ke tahap Decode, di mana model hanya menghasilkan satu Token setiap kali, dan harus membaca ulang KV Cache sebelumnya secara berulang. Tahap ini lebih dibatasi oleh bandwidth memori, sehingga daya komputasi GPU sulit dimanfaatkan secara maksimal.
Jadi untuk jumlah Token yang sama, biaya satuan output biasanya jauh lebih tinggi daripada input. Penetapan harga penyedia layanan mainstream juga umumnya menetapkan harga satuan output lebih tinggi daripada input. Jika bisnis Anda didominasi output panjang, seperti pembuatan kode, penulisan teks panjang, atau penalaran multi-putaran Agent, biaya akan terkonsentrasi di sisi output. Saat mengevaluasi penyedia layanan, prioritaskan melihat harga satuan output dan throughput output.
KV Cache dan Konteks Panjang: Pajak Memori yang Tak Terlihat
Biaya permintaan konteks panjang bukan hanya “input yang banyak”. KV Cache akan memakan lebih banyak memori seiring bertambahnya panjang konteks, dan jumlah permintaan yang dapat dilayani satu kartu secara bersamaan akan menurun. Artinya, satu pengguna dengan konteks sangat panjang bisa menempati posisi konkurensi beberapa pengguna biasa. Biaya ini belum tentu sepenuhnya tercermin dalam harga satuan, sehingga penyedia layanan hanya bisa menyeimbangkannya melalui penetapan harga bertingkat, pembatasan laju, atau batasan panjang konteks.
Cache Hit: Alat Penghemat Biaya Sekaligus Jebakan Harga
Caching petunjuk (Prompt Caching) memungkinkan prefiks yang berulang tidak dihitung ulang, dan bagian yang hit ditagih dengan harga baca cache yang lebih rendah. Untuk bisnis seperti Agent dan RAG yang system prompt-nya panjang dan berulang, tingkat cache hit akan sangat memengaruhi tagihan akhir. Perlu diperhatikan, setiap penyedia layanan memiliki dasar penetapan biaya yang berbeda untuk penulisan cache, pembacaan cache, dan masa berlaku cache, bahkan ada yang harus diaktifkan secara eksplisit. Saat mengevaluasi, pastikan apakah field usage yang dikembalikan menyertakan statistik Token terkait cache.
| Dasar Penetapan Biaya | Karakteristik Konsumsi Sumber Daya | Hal yang Perlu Dikonfirmasi Saat Evaluasi |
|---|---|---|
| Token Input | Komputasi paralel Prefill, efisiensi cukup tinggi | Apakah harga dibedakan berdasarkan panjang konteks |
| Token Output | Decode dihasilkan satu per satu, dibatasi bandwidth memori | Harga satuan output, throughput output (Token/s) |
| Penulisan Cache | Penulisan cache pertama kali, sebagian platform menagih terpisah | Apakah penulisan dikenakan biaya tambahan, berapa lama masa berlakunya |
| Pembacaan Cache | Prefiks hit, melewati komputasi berulang | Diskon bagian yang hit, apakah usage ditampilkan |
| Token Pemikiran Inferensi | Proses pemikiran internal model penalaran | Apakah dihitung sebagai output, apakah anggaran dapat dibatasi |
💰 Penjelasan Dasar Harga: Tabel di atas hanya menjelaskan dimensi penetapan biaya, tidak mencakup harga spesifik. Untuk harga satuan input, harga satuan output, serta harga baca-tulis cache model yang terlibat dalam artikel ini, silakan mengacu pada data aktual di halaman harga APIYI
https://docs.apiyi.com/models. Dasar penetapan biaya dapat berbeda antar model dan antar grup, harap periksa satu per satu sebelum memesan.
Inferensi Mandiri vs Memanggil API: Bagaimana Menghitung Biaya Token
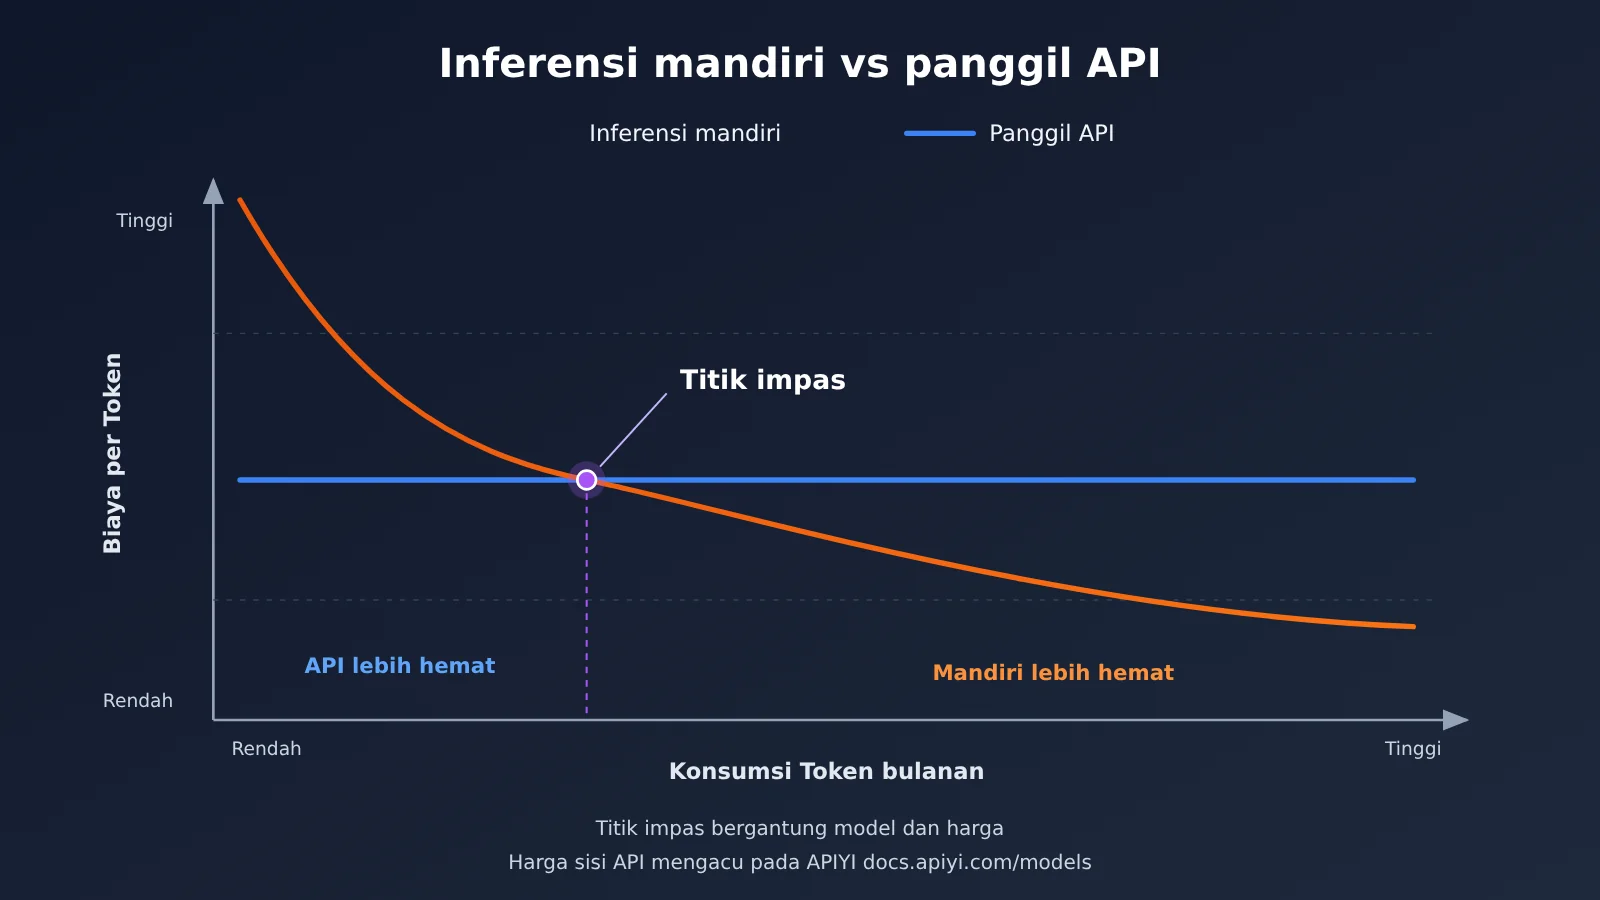
Kasus “56 unit B200 menopang 2000 insinyur dan menekan biaya sekitar 90%” bisa terwujud karena beberapa prasyarat. Beban kerja perusahaan ini berasal dari insinyur internal, dengan volume permintaan besar dan relatif stabil. Jam kerja terkonsentrasi sehingga mudah diprediksi. Modelnya diganti dengan GLM open source yang dapat diterapkan sendiri. Ketiga hal ini membuat biaya tetap dapat teramortisasi dengan baik, tepat menghindari masalah tingkat pemanfaatan yang paling merepotkan penyedia layanan inferensi publik.
Sebaliknya, kasus ini tidak berarti semua tim harus membangun sendiri. Jika volume permintaan kecil, fluktuasinya besar, atau perlu sering berganti di antara beberapa model closed-source, biaya klaster GPU yang menganggur akan cepat melampaui tagihan API. Nilai penyedia layanan inferensi publik justru terletak pada penggunaan beban banyak pelanggan untuk saling “memangkas puncak dan mengisi lembah”, sehingga tingkat pemanfaatan keseluruhan lebih tinggi.
| Solusi | Struktur Biaya | Skenario Penggunaan | Risiko Utama |
|---|---|---|---|
| Klaster GPU mandiri | Biaya tetap tinggi, biaya marginal rendah | Tim besar dengan penggunaan tinggi, beban stabil, dan model tetap | Pemborosan akibat idle, tenaga operasional, depresiasi perangkat keras |
| API resmi satu model | Pembayaran murni sesuai penggunaan | Bisnis yang sangat bergantung pada satu model closed-source | Harga tunggal, biaya peralihan tinggi, ketersediaan regional terbatas |
| Platform agregator API multi-model | Pembayaran sesuai penggunaan, antarmuka terpadu | Perlu membandingkan, beralih, dan menggunakan beberapa model secara campuran | Perlu memverifikasi transparansi penagihan dan stabilitas |
| Arsitektur hibrida | Tugas frekuensi tinggi dibangun sendiri, tugas ekor panjang lewat API | Skala bisnis menengah-besar, pelapisan model jelas | Kompleksitas arsitektur meningkat |
Analisis pembanding solusi mandiri: Solusi mandiri unggul pada batas bawah biaya per unit, tetapi dengan syarat tingkat pemanfaatan cukup tinggi dan tim mampu menangani deployment, kuantisasi, penskalaan naik-turun, serta pemulihan dari kegagalan. Sebagai perbandingan, solusi API memiliki biaya per unit yang lebih mudah diprediksi dan lebih cocok untuk tim dengan beban fluktuatif yang perlu memvalidasi beberapa model secara paralel.
Analisis pembanding platform agregator: API resmi unggul dalam kecepatan peluncuran model, tetapi dalam banyak kasus satu akun hanya mencakup model dari satu penyedia. Keuntungan platform agregator multi-model adalah satu set antarmuka terhubung ke banyak model, sehingga memudahkan perbandingan A/B dan pelapisan biaya. Platform seperti APIYI apiyi.com kompatibel dengan format antarmuka OpenAI dan Anthropic, sehingga perubahan pada kode yang ada sangat kecil untuk beralih model.
Cara mengevaluasi penyedia layanan API model: checklist cepat 6 dimensi
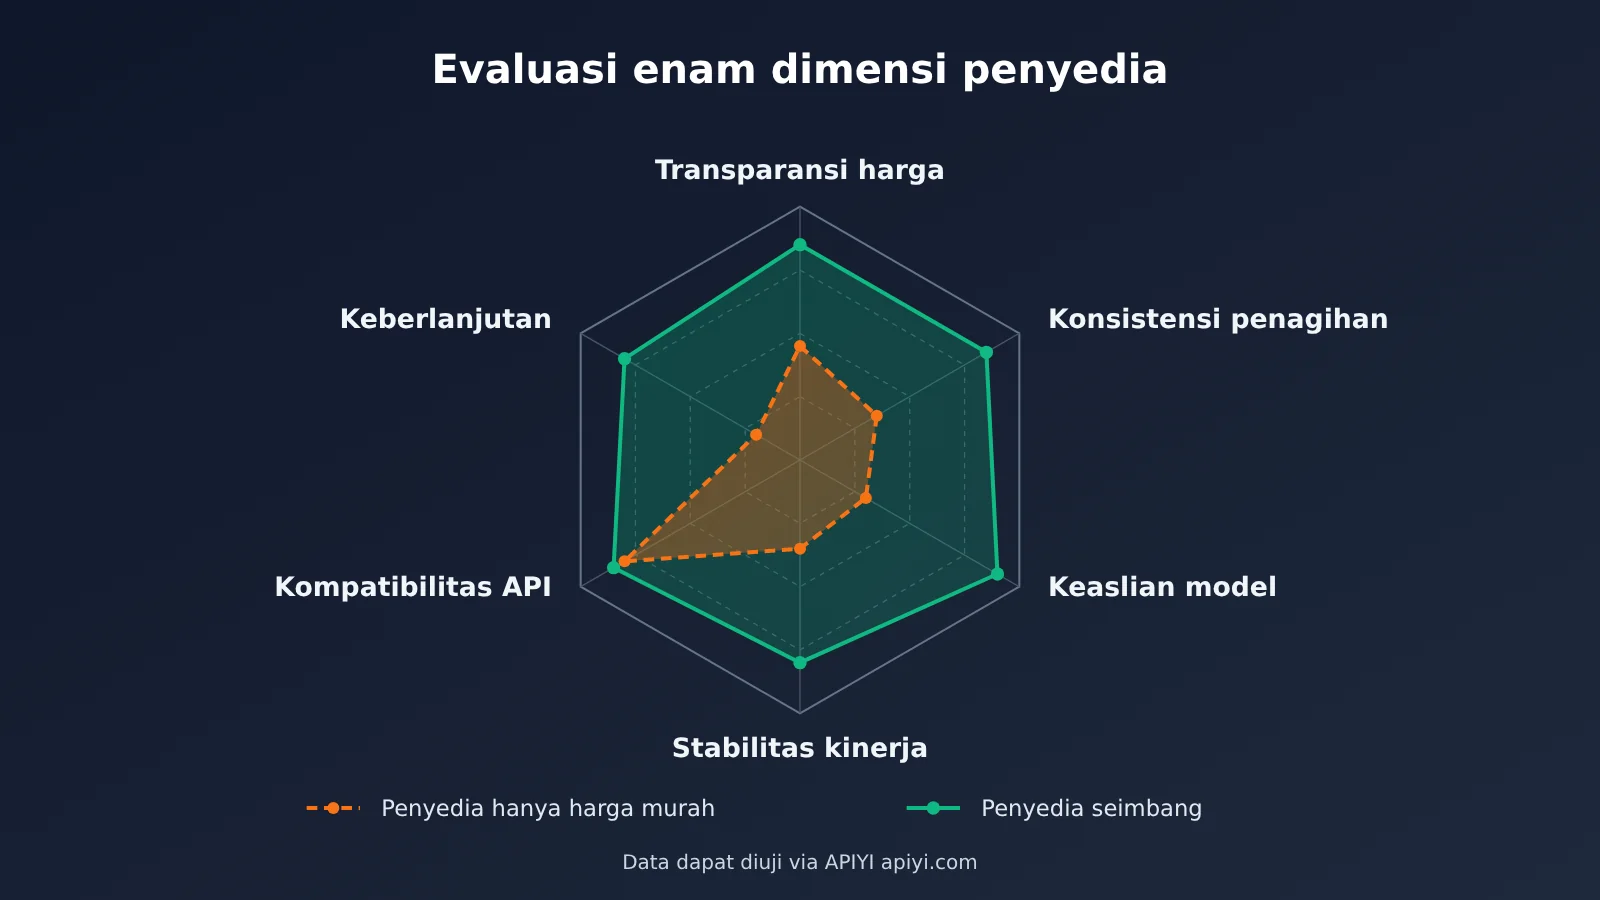
Setelah memahami struktur biaya, kita bisa menarik satu kesimpulan: harga yang lebih rendah dari biaya dalam jangka panjang tidak berkelanjutan. Penyedia pasti menghemat di salah satu bagian, atau bertahan untuk sementara dengan subsidi. Saat menilai penyedia, jangan hanya melihat harga yang tertera; keenam dimensi berikut perlu dilihat bersama-sama.
| Dimensi | Pertanyaan inti | Cara verifikasi |
|---|---|---|
| 1. Transparansi harga | Apakah input, output, dan cache diumumkan secara terpisah | Cocokkan dengan halaman harga, catat dasar perhitungan tiap item |
| 2. Konsistensi penagihan | Apakah tagihan aktual sesuai dengan usage |
Lakukan pemanggilan dalam batch kecil lalu cocokkan rincian tagihan |
| 3. Keaslian model | Apakah ada degradasi, pencampuran, atau kuantisasi berlebihan | Bandingkan kualitas output dengan set pengujian tetap |
| 4. Stabilitas performa | Bagaimana latensi token pertama, throughput, dan tingkat error | Uji satu putaran pada jam sibuk dan jam sepi |
| 5. Kompatibilitas antarmuka | Apakah kompatibel dengan format OpenAI / Anthropic | Uji dengan SDK yang ada, hanya mengganti base_url |
| 6. Keberlanjutan | Apakah harga jelas lebih rendah dari rentang biaya yang wajar | Nilai risiko subsidi berdasarkan struktur biaya |
Langkah pertama: Hubungkan lewat antarmuka kompatibel dan lakukan pemanggilan minimal
Tanpa menulis kode pun, alur pengujian bisa dijelaskan dengan gamblang. Jika proyek Anda sudah menggunakan SDK OpenAI, biasanya Anda hanya perlu mengubah dua item konfigurasi: ganti api_key dengan kunci yang diberikan penyedia, dan ganti base_url dengan alamat antarmuka penyedia. Sebagai contoh di APIYI, base_url format kompatibel OpenAI adalah https://api.apiyi.com/v1, permintaan percakapan melewati jalur /v1/chat/completions, dan isi kolom model dengan nama model target.
Jika proyek Anda berbasis SDK Anthropic, misalnya menggunakan model seri Claude atau alat seperti Claude Code, Anda juga dapat mengganti alamat antarmuka dan menggunakan format native Anthropic melalui jalur /v1/messages. Alamat dan nama model yang spesifik mengacu pada dokumentasi APIYI di https://docs.apiyi.com. Saat melakukan pemanggilan minimal, sebaiknya aktifkan juga output streaming stream agar nanti mudah mengukur latensi token pertama.
Langkah Kedua: Verifikasi Dasar Perhitungan Biaya dan Field usage
Pada setiap respons pemanggilan, format OpenAI akan mengembalikan usage.prompt_tokens dan usage.completion_tokens, sementara sebagian model juga menyertakan cached_tokens untuk cache yang terpakai. Format Anthropic menggunakan input_tokens, output_tokens, serta field baca-tulis cache. Anda bisa memperkirakan biaya sekali panggil dengan rumus sederhana: jumlah token input dikali harga satuan input, ditambah jumlah token output dikali harga satuan output, lalu ditambah jumlah token baca-tulis cache dikali harga satuan cache yang sesuai.
Bandingkan hasil perkiraan dengan rincian tagihan platform; selisihnya seharusnya bisa dijelaskan. Jika dalam jangka panjang muncul pola “tagihan lebih besar dari perhitungan usage”, atau cache hit tidak pernah tercermin di tagihan, itu tanda perlu waspada. Harga satuan yang dipakai untuk perkiraan harus mengacu pada data yang dipublikasikan di halaman harga APIYI https://docs.apiyi.com/models.
Langkah Ketiga: Uji Performa, Uji Kualitas, Uji Jam Sibuk
Untuk pengujian performa, sebaiknya catat tiga metrik: latensi token pertama (TTFT), throughput output (token per detik), dan tingkat kesalahan (timeout, rate limit 429, 5xx). Lakukan satu putaran pengujian pada jam sibuk hari kerja dan satu putaran lagi pada jam sepi malam; semakin kecil fluktuasinya, semakin memadai perencanaan kapasitas penyedia layanan. Untuk pengujian kualitas, gunakan satu set petunjuk tetap yang mencakup kode, penalaran, dan teks panjang, lalu bandingkan hasilnya secara silang dengan kanal resmi atau platform lain. Ini membantu mendeteksi model yang mengalami degradasi atau penggantian.
| Item pengujian | Parameter / field kunci | Referensi kelayakan |
|---|---|---|
| Latensi token pertama | Aktifkan stream, catat waktu chunk pertama |
Selisih jam sibuk dan jam sepi tidak terlalu besar |
| Throughput output | completion_tokens ÷ durasi generasi |
Mirip dengan kanal lain untuk model yang sama |
| Verifikasi biaya | Setiap field usage × harga satuan di halaman harga |
Selisih dengan rincian tagihan dapat dijelaskan |
| Cache hit | cached_tokens atau field baca cache |
Permintaan berulang dengan prefix panjang menunjukkan hit |
| Stabilitas | Jumlah 429 / 5xx / timeout | Tingkat kesalahan rendah dan ada penjelasan retry |
🚀 Mulai cepat: Jika ingin membandingkan biaya dan performa beberapa model di bawah satu set antarmuka yang sama, Anda bisa mendaftar lebih dulu melalui APIYI apiyi.com dan mendapatkan kuota pengujian. Platform menyediakan pemanggilan API model-model utama yang dibahas di artikel ini, kompatibel dengan format antarmuka OpenAI dan Anthropic. Cukup ganti
base_urlmenjadihttps://api.apiyi.com/v1untuk mulai verifikasi. Harga setiap model mengacu padahttps://docs.apiyi.com/models.
FAQ (Pertanyaan yang Sering Diajukan)
Q1: Mengapa layanan Token bisa merugi?
Layanan inferensi didominasi biaya tetap seperti depresiasi GPU dan listrik pusat data, sementara pendapatannya dihitung berdasarkan jumlah Token. Saat jam sibuk perlu menyiapkan cadangan komputasi, saat sepi komputasi menganggur, sehingga tingkat utilisasi sulit dipertahankan tinggi dalam jangka panjang. Ditambah lagi perang harga akibat homogenisasi model open-source dan subsidi kuota gratis, harga jual mudah tertekan di bawah biaya.
Q2: Mengapa Token output umumnya lebih mahal daripada Token input?
Input dihitung secara paralel pada fase Prefill, sehingga efisiensi pemanfaatan GPU tinggi. Output dihasilkan satu per satu pada fase Decode, yang memerlukan pembacaan KV Cache berulang-ulang dan terutama dibatasi oleh bandwidth memori, sehingga biaya per unitnya lebih tinggi. Karena itu, bisnis dengan output panjang perlu memberi perhatian khusus pada harga satuan output dan throughput.
Q3: Apakah membangun GPU sendiri pasti lebih murah daripada memanggil API?
Belum tentu. Kasus seperti “56 unit B200 menopang 2000 engineer” bergantung pada beban internal yang berskala besar, stabil, dan dapat diprediksi. Tim dengan penggunaan kecil atau fluktuatif justru mengalami banyak waktu menganggur setelah membangun sendiri, sehingga biaya per unitnya malah lebih tinggi. Sebaiknya gunakan API terlebih dahulu untuk memetakan kurva penggunaan riil, baru kemudian mengevaluasi titik impasnya.
Q4: Apakah penyedia layanan API dengan harga sangat murah bisa dipakai?
Boleh diuji, tetapi perlu lebih banyak verifikasi. Harga yang jelas jauh di bawah rentang biaya wajar biasanya berarti salah satu dari: subsidi, pembatasan laju (rate limit), penurunan kualitas model, atau diskon stabilitas. Melakukan pemeriksaan kualitas dan penagihan sesuai daftar 6 dimensi dalam artikel ini lebih andal daripada hanya melihat harga yang tertera.
Q5: Bagaimana cara membandingkan performa API beberapa model dengan biaya rendah?
Disarankan menggunakan platform multi-model yang kompatibel dengan format antarmuka populer untuk pengujian terpadu:
1. Daftar akun di APIYI apiyi.com dan dapatkan API Key
2. Konfigurasikan antarmuka kompatibel OpenAI atau Anthropic sesuai dokumentasi `https://docs.apiyi.com`
3. Gunakan set pengujian tetap dan bergantian mengubah field `model`, catat latensi, kualitas, dan `usage`
Dengan satu set kode yang sama, perbandingan horizontal bisa diselesaikan dengan biaya peralihan yang sangat rendah.
Q6: Bagaimana cara mengecek harga cache? Apakah standarnya sama di tiap platform?
Tidak sama. Sebagian platform menagih penulisan cache secara terpisah, sebagian hanya memberi diskon untuk pembacaan, dan masa berlaku serta cara mengaktifkannya pun berbeda. Saat memanggil melalui APIYI, harga baca-tulis cache mengacu pada data aktual di halaman harga `https://docs.apiyi.com/models`, dan cocokkan penagihan dengan field cache pada `usage` yang dikembalikan.
Q7: Metrik apa yang paling sering terlewat saat mengevaluasi penyedia layanan?
Konsistensi penagihan dan stabilitas pada jam sibuk. Banyak tim hanya melakukan satu kali pengujian di jam sepi lalu langsung meluncurkan, sehingga saat jam sibuk sering mengalami 429 atau timeout. Tidak sedikit pula tim yang tidak pernah mencocokkan hubungan antara `usage` dan tagihan. Kedua hal ini sebaiknya dimasukkan ke dalam pemeriksaan tetap sebelum peluncuran.
Poin Penting: Biaya Layanan Token dan Evaluasi Penyedia Layanan API
- Akar kerugian: biaya tetap yang tinggi, pendapatan berbasis pemakaian, dan utilisasi yang berfluktuasi — ketidakcocokan ketiganya membuat layanan Token mudah merugi
- Output lebih mahal: Decode dibatasi oleh bandwidth memori GPU, jadi bisnis dengan output panjang harus mencermati harga satuan output dan throughput
- Konteks panjang punya biaya tersembunyi: KV Cache memakan memori GPU, menurunkan konkurensi, sehingga penyedia hanya bisa menyeimbangkan lewat tiering dan pembatasan laju
- Membangun sendiri ada ambangnya: hanya beban kerja besar dan stabil yang bisa menyerap biaya tetap GPU; tim kecil sebaiknya memakai API
- Evaluasi dari enam dimensi: transparansi harga, konsistensi penagihan, keaslian model, stabilitas performa, kompatibilitas antarmuka, dan keberlanjutan
- Cara memulai: uji langsung lewat APIYI yang kompatibel dengan format OpenAI / Anthropic, harga mengacu pada
docs.apiyi.com/models
Kesimpulan: Memahami Layanan Token dari Struktur Biaya, Memilih Penyedia API Model yang Tepat
Mengapa layanan Token bisa merugi? Pada akhirnya semua ditentukan oleh struktur biaya layanan inferensi:
- Sisi biaya: depresiasi GPU dan listrik pusat data adalah biaya tetap, utilisasi menjadi tuas laba-rugi, sementara output Token dan konteks panjang semakin menaikkan biaya
- Sisi pendapatan: homogenisasi model open source membuat perang harga sulit dihindari, subsidi untuk menarik volume justru menekan margin kotor
- Sisi pemilihan: harga murah tidak berarti hemat; nilailah secara menyeluruh lewat 6 dimensi — transparansi harga, konsistensi penagihan, keaslian model, stabilitas performa, kompatibilitas antarmuka, dan keberlanjutan
Bagi developer, daripada menebak penyedia mana yang bisa bertahan lama, lebih baik berbicara dengan data pemanggilan nyata. Jalankan dulu trafik kecil untuk memverifikasi penagihan dan membandingkan kualitas, baru kemudian tentukan model utama dan kanal cadangan.
Disarankan untuk memverifikasi hasilnya dengan cepat melalui APIYI apiyi.com. Platform ini menyediakan pemanggilan API untuk model-model yang dibahas di artikel ini, kompatibel dengan format antarmuka OpenAI dan Anthropic, dokumentasi integrasi dapat dilihat di https://docs.apiyi.com. Harga input, output, dan cache semua model mengacu pada data aktual di halaman harga https://docs.apiyi.com/models.
📚 Referensi
- 36氪 – Token sudah dijual sampai ke livestream Li Jiaqi, kenapa “SiliconFlow” dan kawan-kawan masih merugi?:Laporan tentang kesulitan profitabilitas penyedia layanan inferensi
- Tautan:
36kr.com/p/4055385238017664 -
Keterangan: Memahami latar belakang industri soal komoditisasi Token dan kerugian penyedia layanan inferensi
-
36氪 – Ada yang membakar 10 ribu dolar per bulan, merasa Claude terlalu mahal, perusahaan ini beralih ke GLM:Studi kasus perusahaan yang membangun inferensi sendiri untuk menekan biaya
- Tautan:
36kr.com/p/4055383551038595 -
Keterangan: Studi kasus 56 unit B200 yang menopang inferensi mandiri untuk 2000 engineer, berguna untuk memahami batas biaya antara membangun sendiri dan menggunakan API
-
Pusat Dokumentasi APIYI:Integrasi antarmuka dan harga model
- Tautan:
docs.apiyi.com - Keterangan: Lihat cara integrasi yang kompatibel dengan OpenAI / Anthropic, harga model mengacu pada
docs.apiyi.com/models
Penulis: Tim Teknis APIYI
Diskusi Teknis: Untuk pertanyaan seputar pemilihan model dan evaluasi biaya Token, silakan hubungi kami melalui situs resmi APIYI di apiyi.com, materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com