Catatan penulis: Dari input, output, penalaran, cache, percobaan ulang, hingga validasi dan eskalasi, gunakan 7 langkah untuk mengubah “berapa harga per juta token” menjadi “berapa biaya per tugas yang selesai”.
Banyak tim saat memilih model pertama-tama melihat harga satuan input dan output di tabel harga, lalu menyimpulkan “model ini setengah lebih murah.” Setelah satu bulan berjalan dan tagihan keluar, ternyata model murah tidak menghemat biaya, bahkan terkadang lebih mahal. Artikel ini memperkenalkan metode estimasi biaya dengan satuan “satu tugas yang diterima”, untuk membantu Anda melihat lebih jelas biaya-biaya di luar harga satuan token.
Ini bukan artikel yang menyuruh Anda membeli model mahal. Model murah memang lebih hemat di banyak skenario. Masalahnya, hanya dengan memasukkan percobaan ulang, token penalaran, cache, dan verifikasi manual ke dalam perhitungan, kita baru bisa menilai apakah model itu benar-benar hemat.
Nilai inti: Setelah membaca artikel ini, Anda akan mendapatkan lembar kerja biaya tugas yang dapat dipakai ulang, tahu data apa yang perlu dikumpulkan, bagaimana menerapkan rumus, dan bagian mana yang paling mudah terlewat dalam perhitungan.
Poin Utama Total Biaya Tugas
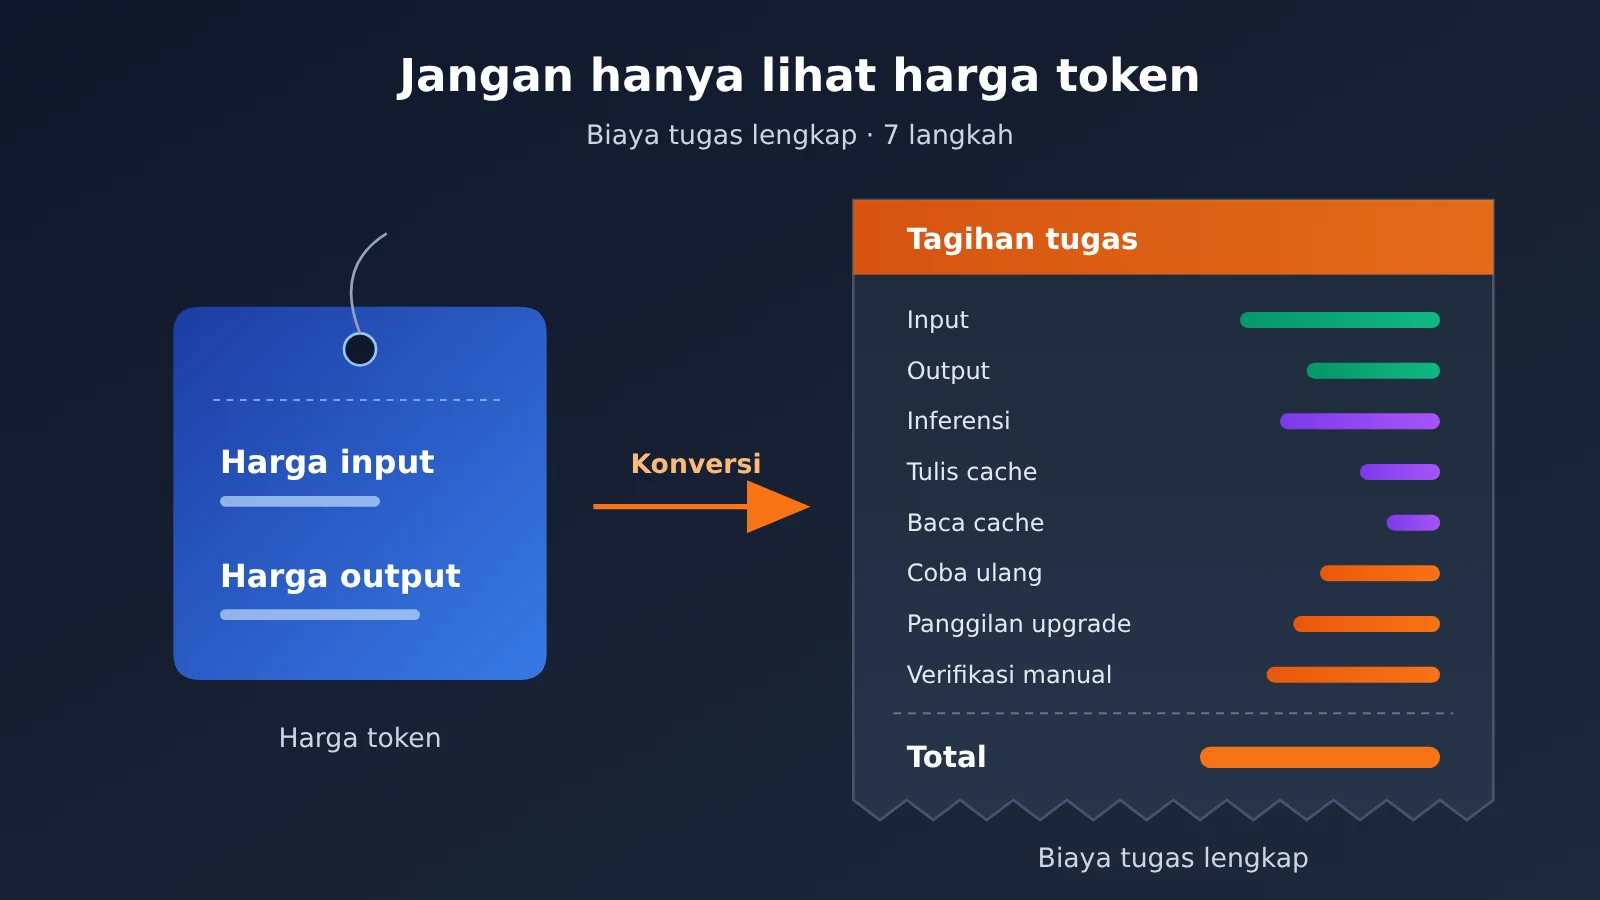
Untuk memperkirakan total biaya sebuah tugas, pertama-tama kita harus mengakui satu fakta: tabel harga memberi kita “harga satuan bahan mentah”, sementara yang sebenarnya kita pedulikan adalah “harga satuan produk jadi”. Satu tugas sering kali terdiri dari beberapa pemanggilan, berbagai jenis token, dan sejumlah biaya non-model; tabel berikut mencantumkan komponen biaya yang paling umum.
| Komponen biaya | Penjelasan | Alasan sering terlewat dalam perhitungan |
|---|---|---|
| Token input biasa | Petunjuk sistem, input pengguna, konteks pencarian, riwayat percakapan | Dalam percakapan multi-putaran, riwayat ikut dihitung berulang kali |
| Token output | Konten terlihat yang akhirnya dikembalikan model | Output terstruktur sering lebih panjang dari perkiraan |
| Token penalaran | Konsumsi pemikiran internal model penalaran, biasanya ditagih sebagai output | Tidak terlihat oleh pengguna, tetapi muncul di tagihan |
| Penulisan dan pembacaan cache | Pembuatan cache dan cache hit untuk awalan yang berulang | Dasar penghitungan penulisan dan pembacaan berbeda dari input biasa |
| Pemanggilan ulang | Permintaan ulang setelah timeout, kesalahan format, atau kegagalan validasi | Jarang muncul saat pengujian, tetapi muncul dalam skala besar setelah produksi |
| Pemanggilan eskalasi | Meneruskan ke model yang lebih kuat setelah model kecil gagal | Strategi routing akan menambahkan biaya dua kali pemanggilan |
| Tingkatan konteks panjang | Harga satuan berubah setelah melewati ambang konteks tertentu | Hanya terpicu pada sedikit permintaan input panjang, mudah diabaikan |
| Biaya validasi manual | Hasil perlu diperiksa atau dikerjakan ulang oleh manusia | Tidak ada di tagihan API, tetapi nyata adanya |
Penjelasan Rinci Poin Penting Total Biaya Tugas: Mengapa Harga Satuan Menyesatkan
Kesalahpahaman pertama berasal dari token penalaran. Model penalaran menghabiskan sebagian pemikiran internal sebelum memberikan jawaban; bagian ini biasanya ditagih dengan harga satuan output, dan panjangnya berubah sesuai pengaturan intensitas penalaran. Dalam diskusi publik, cukup banyak artikel yang secara khusus membandingkan dua tingkat intensitas penalaran, high dan xhigh, pada model yang sama. Kesimpulannya mengarah ke satu hal yang sama: apakah penalaran tambahan itu sepadan harus dilihat dari seberapa besar peningkatan tingkat keberhasilan tugas, bukan hanya dari apakah harga satuannya sama.
Kesalahpahaman kedua berasal dari “format benar tidak berarti hasil benar”. Saat melakukan ekstraksi teks, model mengembalikan JSON yang valid dengan mudah, tetapi apakah nilai field benar-benar berasal dari teks asli, atau apakah ada yang tertukar, perlu validasi tambahan. Jika hasil ekstraksi dari model murah memiliki proporsi tinggi yang perlu dikerjakan ulang secara manual, maka uang yang dihemat pada tagihan API kemungkinan besar akan kembali berlipat ganda dalam bentuk biaya tenaga kerja.
Kesalahpahaman ketiga berasal dari klaim pemasaran vendor. Saat merilis model, ada yang sekaligus mengumumkan penurunan harga satuan token dan “penurunan biaya tugas”, tetapi keduanya tidak setara. Penurunan biaya tugas bisa berasal dari output yang lebih pendek, lebih sedikit percobaan ulang, atau juga bergantung pada pola penggunaan cache tertentu; beban kerja Anda belum tentu bisa mereproduksi proporsi penurunan yang sama.
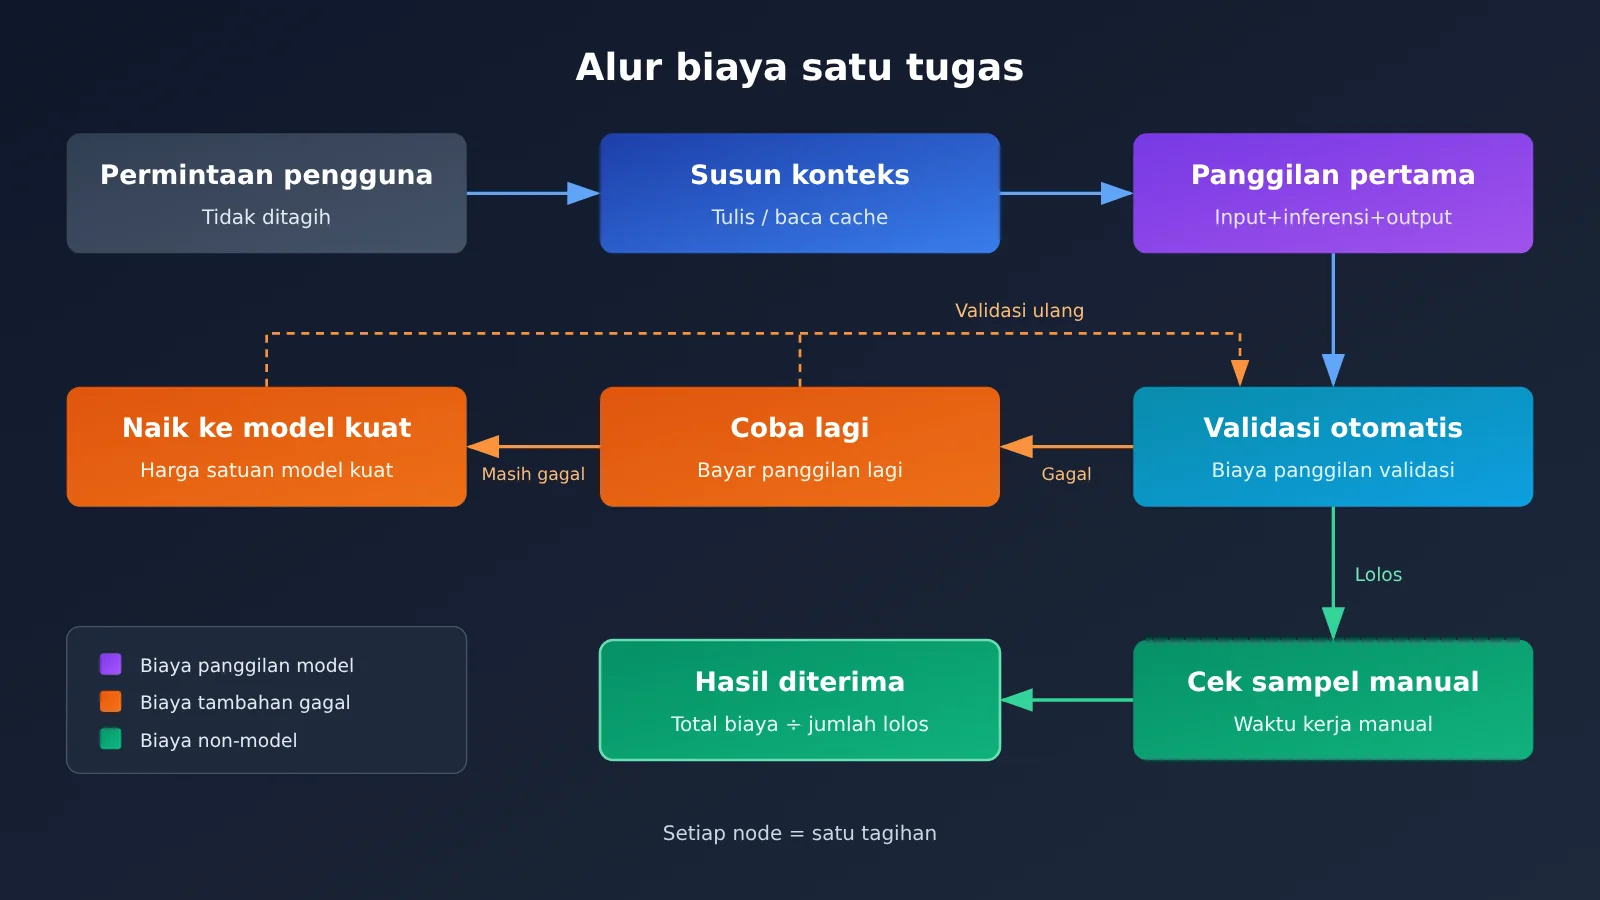
Cara Mengestimasi Biaya Lengkap Satu Tugas: Panduan Cepat
Alur berikut tidak memerlukan penulisan kode; cukup gunakan spreadsheet. Ide intinya adalah menghitung dulu struktur token untuk satu kali pemanggilan, lalu mengalikannya dengan berbagai probabilitas, dan terakhir membaginya dengan jumlah hasil yang diterima.
7 Langkah Mengestimasi Biaya Lengkap Satu Tugas
- Definisikan batas “satu tugas”: misalnya “memproses satu tiket dan menghasilkan field terstruktur yang siap dimasukkan ke basis data”, bukan “memanggil API sekali”. Batas yang berbeda membuat cakupan biaya sangat berbeda.
- Pecah struktur token per pemanggilan: catat panjang rata-rata untuk petunjuk sistem, konteks retrieval, input pengguna, output yang terlihat, dan token penalaran; sebaiknya gunakan nilai P50 dan P95.
- Tandai bagian yang bisa di-cache: petunjuk sistem yang tetap, definisi alat, dan contoh few-shot biasanya bisa menggunakan cache; catat frekuensi penulisan cache dan perkiraan hit rate.
- Pahami dasar penagihan: harga satuan untuk input, output, penulisan cache, dan pembacaan cache, serta apakah ada tingkatan konteks panjang. Semua harga satuan mengacu pada data aktual di halaman harga APIYI docs.apiyi.com/models.
- Ukur tingkat kegagalan dengan sampel nyata: jalankan setidaknya satu batch sampel representatif; hitung proporsi kegagalan format, kegagalan validasi, dan timeout, lalu konversikan menjadi tingkat percobaan ulang dan tingkat eskalasi.
- Tambahkan biaya non-model: proporsi inspeksi manual, waktu validasi per entri, dan jika perlu konversikan ke nilai uang.
- Hitung biaya “per hasil yang diterima”: bagi total biaya dengan jumlah hasil yang lolos penerimaan akhir; inilah metrik yang bisa dipakai untuk membandingkan model.
Field Lembar Kerja Biaya Lengkap Tugas
Setelah langkah-langkah di atas dituangkan ke dalam tabel, sebaiknya setidaknya mencakup field-field berikut. Penamaan field dapat disesuaikan dengan kebiasaan tim, yang penting setiap item memiliki sumber data.
| Field | Arti | Sumber Data |
|---|---|---|
in_cached |
Jumlah token input yang mengenai cache | Field usage pada log pemanggilan |
in_uncached |
Jumlah token input normal yang tidak mengenai cache | Log pemanggilan |
cache_write |
Jumlah token yang ditulis ke cache kali ini | Log pemanggilan |
out_visible |
Jumlah token output yang terlihat | Log pemanggilan |
out_reasoning |
Jumlah token reasoning | Log pemanggilan (hanya untuk model reasoning) |
retry_rate |
Proporsi yang perlu dicoba ulang | Statistik pengujian sampel |
escalate_rate |
Proporsi yang perlu ditingkatkan ke model yang lebih kuat | Log strategi routing |
accept_rate |
Proporsi yang akhirnya diterima | Verifikasi otomatis plus pemeriksaan sampel manual |
| Harga satuan masing-masing | Harga satuan input, output, penulisan cache, pembacaan cache | Data aktual dari halaman harga APIYI |
🚀 Saran cepat untuk memulai: Jika Anda ingin membandingkan biaya tugas dari beberapa model sekaligus, sebaiknya jalankan masing-masing dengan kumpulan sampel yang sama di APIYI apiyi.com. Platform ini menyediakan pemanggilan API untuk model-model populer yang dibahas dalam artikel ini, kompatibel dengan dua format antarmuka OpenAI dan Anthropic. Saat berganti model, cukup ubah nama modelnya, sehingga memudahkan perbandingan dalam satu lembar kerja yang sama. Untuk cara integrasi dan base_url, silakan mengacu pada dokumentasi APIYI di docs.apiyi.com.
Contoh perhitungan biaya lengkap untuk sebuah tugas
Berikut demonstrasi menggunakan tugas ekstraksi field dari tiket kerja. Untuk menghindari penggunaan angka harga yang belum terverifikasi, contoh ini hanya memberikan jumlah token dan rumusnya; silakan isi harga satuan dengan data aktual model terkait di halaman harga APIYI docs.apiyi.com/models.
| Tahap | Komposisi token (rata-rata) | Probabilitas kejadian | Rumus biaya |
|---|---|---|---|
| Pemanggilan pertama | Cache hit 6,000 + input biasa 2,000 + output terlihat 800 + reasoning 1,500 | 100% | 6,000×harga baca cache + 2,000×harga input + 2,300×harga output |
| Penulisan cache | 6,000 (ditulis ulang setelah cache kedaluwarsa) | Diamortisasi sesuai frekuensi penulisan | 6,000×harga tulis cache ÷ jumlah permintaan yang dicakup per penulisan |
| Pemanggilan ulang (retry) | Sama dengan pemanggilan pertama | 10% | Biaya pemanggilan pertama × 0.1 |
| Pemanggilan eskalasi | Input model kuat 8,000 + output dan reasoning total 2,000 | 5% | Setelah harga satuan model kuat dimasukkan × 0.05 |
| Pemeriksaan sampel manual | Tidak mengonsumsi token | Sampel 5% | Biaya manual per verifikasi × 0.05 |
Jumlahkan kelima baris di atas untuk mendapatkan “biaya ekspektasi per tiket”. Kemudian bagi dengan tingkat penerimaan akhir, misalnya 95%, untuk mendapatkan “biaya per hasil yang diterima”. Perhatikan bahwa retry di sini dihitung berdasarkan biaya penuh pemanggilan pertama, karena saat retry konteks biasanya dikirim ulang apa adanya.
Ada satu fenomena yang patut dicermati dalam contoh ini: output yang terlihat hanya 800 token, tetapi token reasoning mencapai 1,500. Saat dihitung dengan harga satuan output, bagian reasoning justru menjadi porsi terbesar di sisi output. Jika hanya memperkirakan berdasarkan output yang terlihat, biaya sisi output akan diremehkan lebih dari setengahnya.
Perbandingan Miskonsepsi Umum tentang Biaya Total Tugas
Untuk kebutuhan yang sama, dua pendekatan berpikir — “hanya melihat harga satuan” dan “melihat biaya total tugas” — sering menghasilkan kesimpulan pemilihan model yang saling bertolak belakang. Tabel berikut merangkum beberapa skenario tipikal.
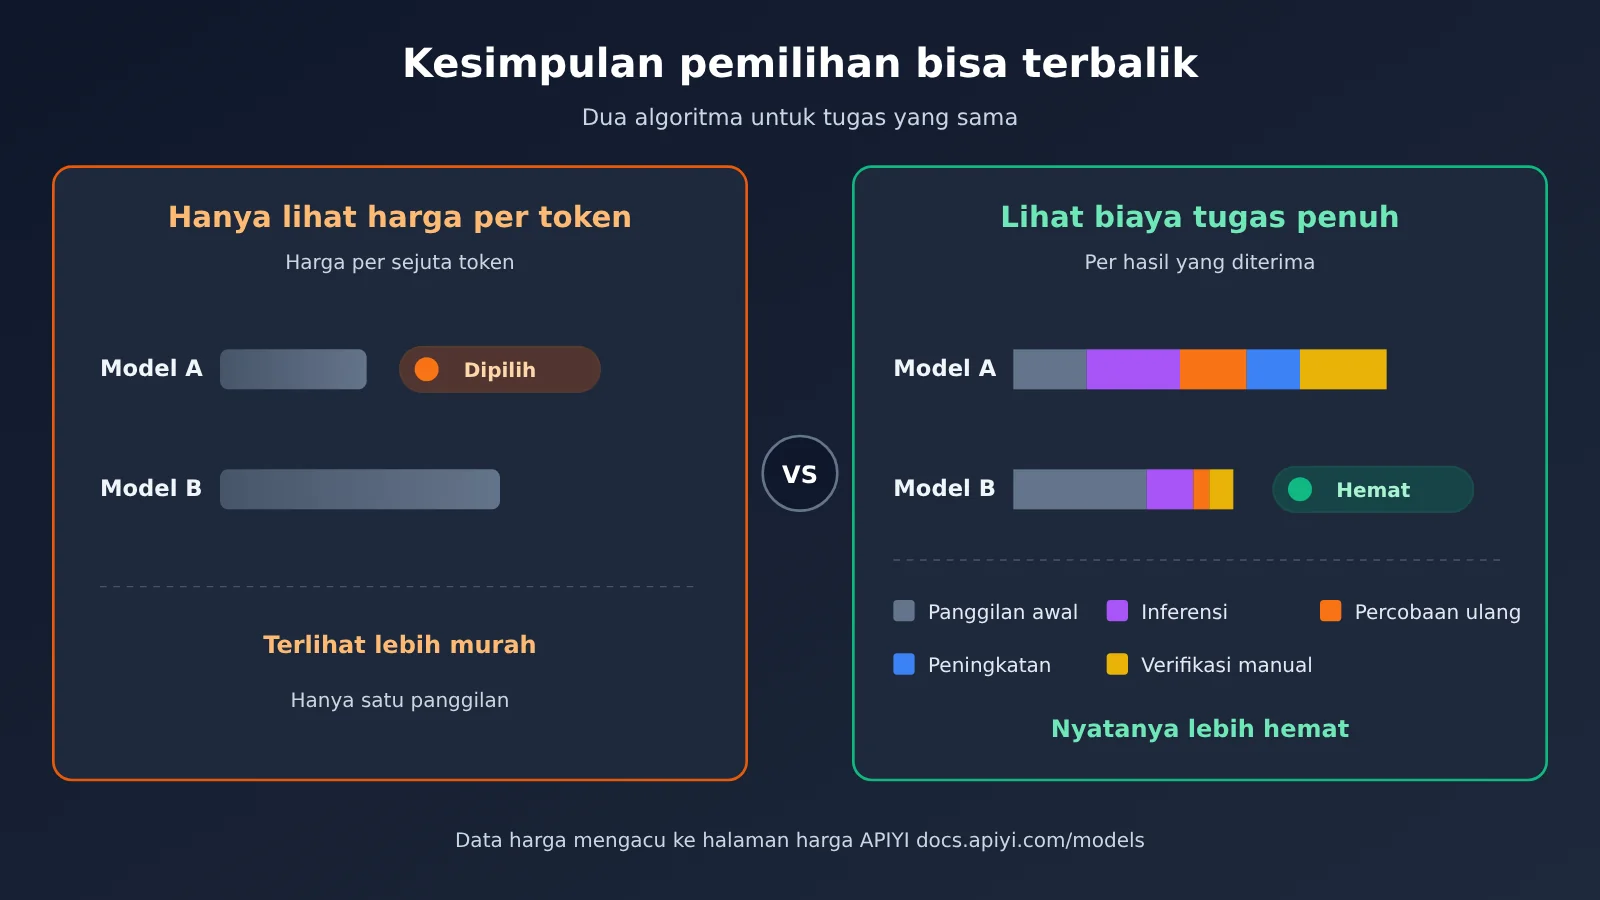
| Skenario | Kesimpulan jika hanya melihat harga satuan | Kesimpulan setelah melihat biaya total tugas | Variabel kunci |
|---|---|---|---|
| Ekstraksi terstruktur | Pilih model ringan termurah | Jika tingkat kesalahan field tinggi, model kuat bisa jadi lebih hemat | Tingkat penerimaan, rework manual |
| Agent coding | Pilih model dengan harga satuan output rendah | Pemanggilan tool multi-putaran membuat konteks membengkak, strategi cache lebih krusial | Rasio cache hit, jumlah putaran |
| Analisis dokumen panjang | Estimasi berdasarkan panjang input rata-rata | Sejumlah kecil permintaan sangat panjang memicu harga bertingkat konteks panjang | Ambang batas konteks, panjang P95 |
| Pemilihan intensitas reasoning | Harga satuan model sama, pilih tingkat tertinggi | Reasoning tingkat tinggi memakai lebih banyak token, perlu dilihat apakah tingkat kelulusan meningkat | Token reasoning, tingkat kelulusan |
| Tugas batch offline | Dihitung berdasarkan harga satuan pemanggilan real-time | Jalur batch processing bisa punya dasar penghitungan harga yang berbeda | Apakah mendukung Batch |
💡 Catatan perbandingan: Kesimpulan dalam tabel adalah penalaran pada level metode; model mana yang sebenarnya lebih hemat bergantung pada sampel Anda. Sebaiknya jalankan beberapa model dengan sampel yang sama di APIYI apiyi.com, isi tabel dengan harga satuan aktual dari halaman harga, lalu ambil keputusan.
Detail konteks panjang dan cache dalam biaya total tugas
Tingkat harga konteks panjang adalah pos yang paling mudah memunculkan “probabilitas kecil, nominal besar”. Sumber publik menyebutkan bahwa sebagian model menerapkan harga satuan berbeda setelah input melewati ambang batas tertentu (misalnya ada artikel yang membahas ambang 272K pada GPT-6 Sol). Jika distribusi panjang permintaan Anda memiliki ekor panjang, pastikan untuk menghitung secara terpisah porsi permintaan yang melewati ambang batas tersebut, bukan sekadar memakai panjang rata-rata.
Cache adalah pedang bermata dua. Pembacaan cache biasanya lebih murah daripada input biasa, tetapi harga satuan penulisan cache pada sebagian penyedia bisa lebih tinggi daripada input biasa, dan cache juga memiliki masa kedaluwarsa. Jika interval permintaan Anda panjang dan prefix sering berubah, biaya penulisan bisa meniadakan penghematan dari pembacaan. Untuk harga penulisan cache, harga pembacaan, dan dasar penghitungan tagihan yang spesifik, acuannya adalah yang tercantum di halaman harga APIYI docs.apiyi.com/models.
5 Cara Praktis untuk Menurunkan Total Biaya Tugas
Setelah perhitungannya jelas, arah optimalisasi biasanya ikut terlihat. Beberapa cara berikut umumnya efektif di banyak skenario, tetapi efeknya harus diverifikasi dengan lembar kerja, bukan sekadar mengandalkan perkiraan.
| Cara | Item biaya yang terpengaruh | Catatan |
|---|---|---|
| Gunakan prefiks tetap dan aktifkan cache | Token masukan | Letakkan konten yang mudah berubah di akhir petunjuk untuk meningkatkan hit rate |
| Batasi format dan panjang keluaran | Token keluaran | Gunakan keluaran terstruktur untuk membatasi field dan hindari penjelasan bertele-tele |
| Rutekan berdasarkan tingkat kesulitan tugas | Panggilan eskalasi, token penalaran | Aturannya harus jelas, dan auditlah “hasil keliru yang diterima” |
| Lakukan validasi otomatis di awal | Verifikasi manual, pengerjaan ulang | Validasi sumber bukti, bukan hanya format JSON |
| Kendalikan intensitas penalaran | Token penalaran | Tentukan tingkatannya berdasarkan pass rate, jangan langsung pakai tingkat tertinggi secara default |
Terkait rutekan, ada satu risiko yang sering terlewat: hasil yang “berhasil” dikembalikan oleh model kecil bisa saja menyimpan kesalahan, dan kesalahan itu tidak memicu eskalasi. Jadi, saat mengevaluasi strategi rutekan, selain tingkat eskalasi, lakukan juga pengambilan sampel acak terhadap hasil yang langsung lolos dari model kecil, lalu masukkan kesalahan yang lolos ke dalam perhitungan biaya.
FAQ – Pertanyaan yang Sering Diajukan
Q1: Apa yang dimaksud dengan biaya penuh per tugas?
Biaya penuh per tugas adalah seluruh biaya yang dikeluarkan untuk menyelesaikan satu tugas dalam makna bisnis, dan hasilnya diterima. Biaya ini mencakup semua biaya input, output, inferensi, dan cache dari seluruh pemanggilan, ditambah biaya percobaan ulang, eskalasi, serta verifikasi manual. Angka ini jauh lebih mendekati tagihan sebenarnya dibandingkan sekadar harga satuan token.
Q2: Apa perbedaan antara biaya penuh per tugas dan harga satuan token?
Harga satuan token ibarat harga bahan baku, sedangkan biaya penuh per tugas adalah harga produk jadi. Model dengan harga satuan rendah bisa jadi justru memiliki biaya penuh per tugas lebih tinggi jika membutuhkan lebih banyak percobaan ulang, inferensi lebih panjang, atau lebih banyak pengerjaan ulang manual. Sebaliknya, model dengan harga satuan tinggi bisa lebih hemat jika tingkat keberhasilan sekali jalannya tinggi.
Q3: Berapa jumlah sampel minimal untuk mengestimasi biaya penuh per tugas?
Tidak ada angka pasti. Kuncinya adalah sampel harus mencakup distribusi nyata, terutama input panjang, kasus sulit, dan kondisi batas. Jika sampel terlalu sedikit, tingkat percobaan ulang dan tingkat penerimaan akan sangat berfluktuasi. Sebaiknya lakukan estimasi awal dengan batch kecil, lalu koreksi memakai log nyata pada masa awal peluncuran.
Q4: Skenario mana yang paling perlu menghitung biaya penuh per tugas?
Terutama beberapa kategori berikut:
– **Ekstraksi data terstruktur**: saat kesalahan field harus diperbaiki manual, porsi biaya tenaga kerja sangat besar
– **Agent coding**: pemanggilan tool multi-putaran membuat konteks tumbuh cepat
– **Tanya jawab dokumen panjang**: permintaan long tail bisa memicu harga bertingkat untuk konteks panjang
– **Routing multi-model**: pemanggilan eskalasi menumpuk dua kali biaya
Q5: Bagaimana cara cepat mendapatkan harga satuan dan dasar penagihan tiap model?
Sebaiknya langsung lihat halaman harga APIYI di docs.apiyi.com/models. Di sana tercantum harga satuan input, output, dan cache untuk model yang didukung platform. Saat mengestimasi, gunakan data aktual dari halaman tersebut sebagai acuan. APIYI kompatibel dengan format antarmuka OpenAI dan Anthropic. Setelah menyelesaikan integrasi sesuai dokumentasi di docs.apiyi.com, Anda bisa menguji beberapa model dengan batch sampel yang sama, lalu memasukkan data usage dari log pemanggilan langsung ke lembar kerja.
Q6: Bisakah penggunaan produk berbasis langganan dibandingkan langsung dengan penagihan API?
Tidak disarankan membandingkan secara langsung. Produk berbasis langganan biasanya dibatasi oleh kuota atau jumlah pemakaian, sedangkan API ditagih berdasarkan token. Satuan ukur dan skenario penggunaannya berbeda. Jika ingin membandingkan, Anda perlu lebih dulu mengonversi jumlah tugas yang benar-benar dapat dikerjakan dalam langganan tersebut, bukan mengasumsikan jumlah pesan yang tetap.
Q7: Apa saja keterbatasan estimasi biaya penuh per tugas?
Estimasi ini bergantung pada representativitas sampel. Sampel yang terlalu sederhana akan meremehkan biaya. Konversi biaya verifikasi manual juga bersifat subjektif dan bisa sangat berbeda antar tim. Selain itu, harga satuan model dan aturan penagihan dapat berubah, sehingga lembar kerja perlu diperbarui secara berkala dengan harga dan log terbaru, bukan dihitung sekali lalu dipakai jangka panjang.
Biaya Lengkap Tugas: Poin-Poin Utama (Key Takeaways)
- Satuan perbandingan harus diganti: bandingkan model dengan “biaya per hasil yang diterima”, bukan harga per juta token
- Token penalaran wajib dicatat terpisah: biasanya ditagih sebagai output, dan bisa melebihi output yang terlihat
- Cache harus dihitung untuk penulisan dan pembacaan: penulisan cache bisa lebih mahal daripada input biasa, dan tingkat hit menentukan apakah itu hemat
- Percobaan ulang dan eskalasi adalah pos tersembunyi terbesar: tingkat kegagalan setelah rilis sering lebih tinggi daripada yang terlihat saat pengujian
- JSON yang valid tidak sama dengan data yang benar: verifikasi sumber bukti, dan masukkan kerja ulang manual ke dalam biaya
- Konteks panjang harus dilihat ekor panjangnya: gunakan panjang P95 untuk memeriksa apakah harga bertingkat terpicu
- Harga satuan mengacu pada halaman harga: saat mengestimasi, selalu cek data aktual di halaman harga APIYI docs.apiyi.com/models
Ringkasan
Poin inti dalam mengestimasi biaya lengkap sebuah tugas:
- Definisikan batas tugas lebih dulu: gunakan satuan hasil bisnis, bukan satuan satu kali pemanggilan
- Uraikan semua komponen biaya: input, output, penalaran, cache, percobaan ulang, eskalasi, dan verifikasi manual — tidak ada yang boleh terlewat
- Ukur probabilitas dengan sampel nyata: tingkat percobaan ulang, tingkat eskalasi, dan tingkat penerimaan menentukan pengali biaya akhir
“Jangan hanya melihat harga satuan token” bukan berarti harga satuan tidak penting, melainkan ia hanyalah satu variabel dalam rumus. Bangun lembar kerja, isi dengan sampel dan log Anda sendiri, dan kesimpulan pemilihan model akan lebih andal daripada peringkat mana pun.
Disarankan untuk membandingkan beberapa model dengan batch sampel yang sama melalui APIYI apiyi.com, dipadukan dengan harga satuan aktual di halaman harga docs.apiyi.com/models untuk menghitung biaya lengkap tugas. Platform ini kompatibel dengan format API OpenAI dan Anthropic, sehingga biaya berganti model sangat rendah.
📚 Referensi
- Seri artikel penetapan harga model dan biaya tugas Ofox.ai Blog: Beberapa artikel membahas hubungan antara penagihan cache, ambang batas konteks panjang, intensitas penalaran, dan biaya tugas
- Tautan:
ofox.ai/blog/page/12 -
Penjelasan: Cocok untuk memahami perbedaan antara “penurunan harga satuan” dan “penurunan biaya tugas”
-
Artikel perutean model dan ekstraksi terstruktur Ofox.ai Blog: Membahas aturan peningkatan dari model kecil ke model kuat, serta “JSON yang valid tidak sama dengan data yang benar”
- Tautan:
ofox.ai/blog/page/11 -
Penjelasan: Cocok sebagai referensi saat merancang strategi perutean dan alur validasi
-
Halaman harga model APIYI: Harga satuan terkait input, output, dan cache dari model yang didukung platform
- Tautan:
docs.apiyi.com/models -
Penjelasan: Semua konten terkait harga dan dasar penagihan dalam artikel ini mengacu pada data aktual di halaman ini
-
Pusat dokumentasi APIYI: Metode integrasi, format antarmuka, dan penjelasan parameter
- Tautan:
docs.apiyi.com - Penjelasan: Berisi penjelasan integrasi format kompatibel OpenAI dan Anthropic
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman utama situs resmi APIYI apiyi.com, lebih banyak materi integrasi dapat diakses di pusat dokumentasi docs.apiyi.com