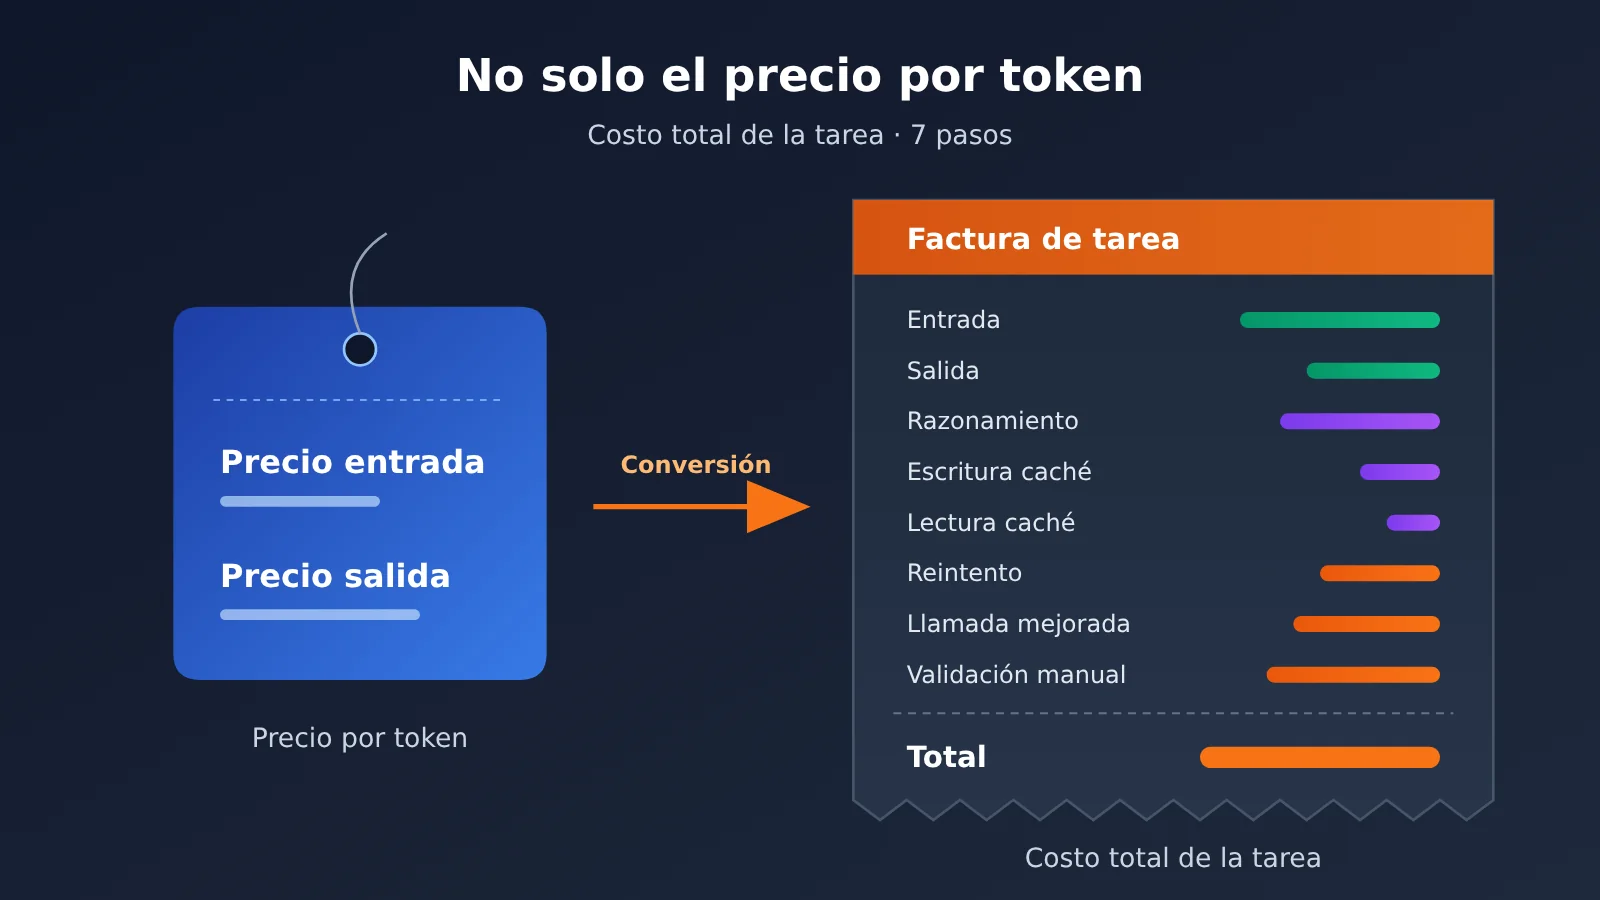
Nota del autor: desde la entrada y la salida, pasando por el razonamiento, la caché y los reintentos, hasta el escalado de validación, estos 7 pasos convierten «cuánto cuesta cada millón de tokens» en «cuánto cuesta completar una tarea».
Muchos equipos, al elegir un modelo, lo primero que miran es el precio unitario de entrada y salida en la tabla de precios, y concluyen que «este cuesta la mitad». Un mes después del lanzamiento llega la factura y descubren que el modelo barato no ahorró dinero; a veces incluso salió más caro. Este artículo presenta un método de estimación de costos por «tarea aceptada» que te ayuda a ver esa parte del gasto que queda fuera del precio por token.
Este no es un artículo que te empuje a comprar modelos caros: los modelos baratos, en muchos escenarios, de hecho compensan más. El problema es que solo metiendo en la cuenta los reintentos, los tokens de razonamiento, la caché y la validación manual puedes juzgar si de verdad compensa.
Valor principal: al terminar, tendrás una hoja de trabajo reutilizable para el costo por tarea, sabrás qué datos reunir, cómo aplicar las fórmulas y qué partes se pasan por alto con más facilidad.
Costo total de la tarea: puntos clave
Estimar el costo total de una tarea exige aceptar algo desde el principio: la tabla de precios da el «precio unitario de la materia prima», pero lo que de verdad te importa es el «precio unitario del producto final». Una tarea suele estar formada por varias llamadas, distintos tipos de tokens y varios gastos que no son del modelo. En la tabla siguiente tienes las partidas de costo más habituales.
| Partida de costo | Descripción | Motivo por el que se suele pasar por alto |
|---|---|---|
| Tokens de entrada normales | Indicaciones del sistema, entrada del usuario, contexto recuperado, historial de conversación | En conversaciones de varios turnos, el historial se vuelve a contar una y otra vez |
| Tokens de salida | Contenido visible que devuelve finalmente el modelo | Las salidas estructuradas suelen ser más largas de lo previsto |
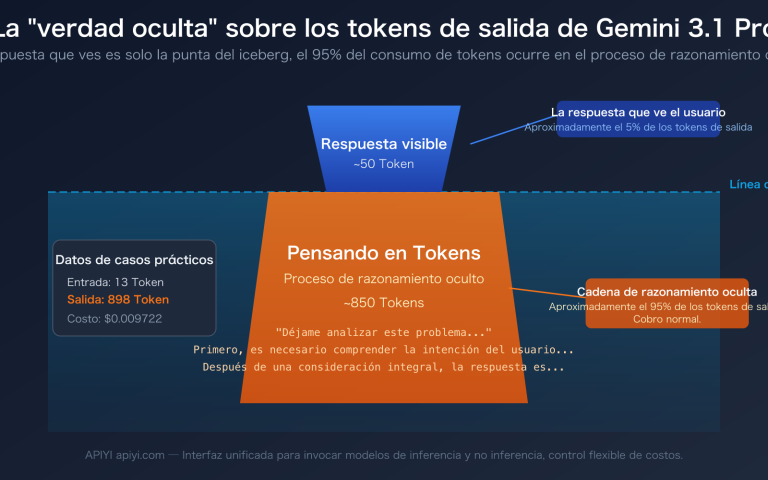
| Tokens de razonamiento | Consumo de pensamiento interno de los modelos de razonamiento; normalmente se factura como salida | El usuario no los ve, pero aparecen en la factura |
| Escritura y lectura de caché | Creación y acierto de caché para prefijos repetidos | La forma de tarificar escritura y lectura no es la misma que la de la entrada normal |
| Llamadas de reintento | Nuevas solicitudes tras un timeout, un error de formato o un fallo de validación | En pruebas apenas aparecen; al pasar a producción ocurren a escala |
| Llamadas de escalado | Cuando falla un modelo pequeño, se pasa a uno más potente | La estrategia de enrutamiento suma el costo de dos llamadas |
| Escalones por contexto largo | El precio unitario cambia al superar cierto umbral de contexto | Solo se activa en unas pocas solicitudes con entradas largas y es fácil pasarlo por alto |
| Costo de validación manual | Hay que revisar los resultados o rehacer el trabajo | No sale en la factura de la API, pero existe de verdad |
Claves del costo total de una tarea: por qué el precio unitario engaña
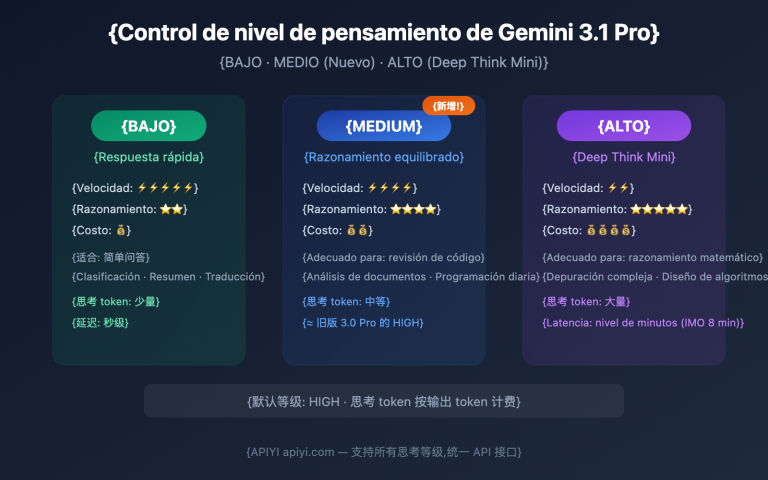
El primer engaño viene de los tokens de razonamiento. Los modelos de razonamiento consumen una parte de pensamiento interno antes de dar la respuesta; esa parte normalmente se factura al precio de salida y su longitud varía según la intensidad de razonamiento configurada. En las discusiones públicas hay bastantes artículos que comparan expresamente los niveles high y xhigh de intensidad de razonamiento de un mismo modelo, y todos llegan a la misma conclusión: para saber si merece la pena el razonamiento adicional hay que mirar cuánto sube la tasa de éxito de la tarea, no solo si el precio unitario es el mismo.
El segundo engaño viene de que «el formato sea correcto» no equivale a «el resultado sea correcto». Al hacer extracción de texto, que el modelo devuelva un JSON válido es fácil, pero hay que validar aparte si los valores de los campos vienen realmente del texto original o si se han asignado al campo equivocado. Si un modelo barato deja una proporción alta de extracciones que necesitan retrabajo manual, es muy probable que ese ahorro en la factura de la API se pague con creces en costos de trabajo manual.
El tercer engaño viene del mensaje comercial de los proveedores. Cuando se lanza un modelo, a veces se anuncia a la vez una bajada del precio por token y una «reducción del costo por tarea», pero no son equivalentes. La reducción del costo por tarea puede venir de salidas más cortas, de menos reintentos o de depender de un uso concreto de la caché; puede que tu carga de trabajo no reproduzca esa misma proporción.
Cómo estimar el costo total de una tarea: inicio rápido
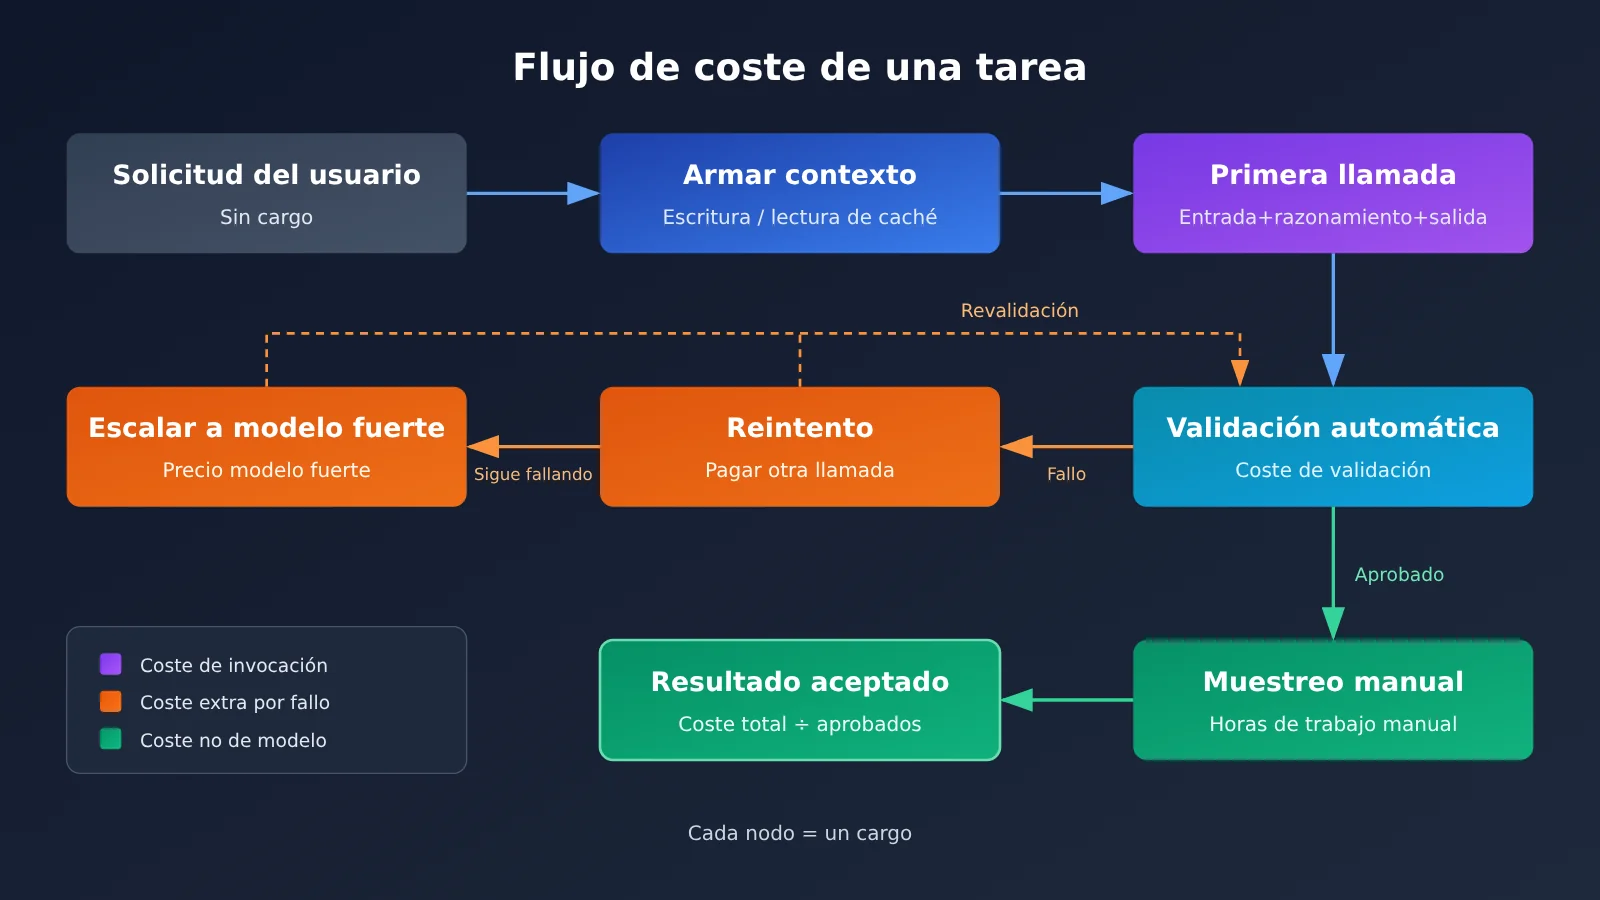
Este flujo no requiere escribir código; basta con una hoja de cálculo. La idea central es calcular primero la estructura de tokens de una llamada, luego multiplicarla por distintos tipos de probabilidad y, por último, dividir entre la cantidad de resultados aceptados.
Los 7 pasos para estimar el costo total de una tarea
- Definir el límite de “una tarea”: por ejemplo, “procesar un ticket y generar campos estructurados listos para almacenar”, no “llamar una vez a la API”. Si el límite cambia, el criterio de costo cambia por completo.
- Desglosar la estructura de tokens de una llamada: registra la longitud media de la indicación del sistema, el contexto recuperado, la entrada del usuario, la salida visible y los tokens de razonamiento; mejor con valores P50 y P95.
- Marcar las partes que se pueden almacenar en caché: las indicaciones del sistema fijas, las definiciones de herramientas y los ejemplos few-shot suelen aprovechar la caché; registra la frecuencia de escritura en caché y la tasa de aciertos estimada.
- Aclarar el criterio de facturación: precio unitario de entrada, salida, escritura en caché y lectura de caché, y si existe una tarifa escalonada por contexto largo. Todos los precios deben tomarse de los datos reales de la página de precios de APIYI: docs.apiyi.com/models.
- Medir la tasa de fallos con muestras reales: ejecuta al menos un lote representativo de muestras y calcula la proporción de fallos de formato, fallos de validación y tiempos de espera agotados; conviértela en tasa de reintentos y tasa de escalado.
- Sumar los costos que no son del modelo: porcentaje de muestreo manual, tiempo de validación por elemento y, si hace falta, su equivalente en dinero.
- Calcular el costo por “resultado aceptado”: divide el costo total entre la cantidad de resultados que superan la validación final. Ese es el indicador que realmente permite comparar modelos.
Campos de la hoja de trabajo de coste completo por tarea
Llevemos los pasos anteriores a una tabla. Se recomienda incluir al menos los siguientes campos. Los nombres pueden adaptarse a las convenciones de cada equipo; lo clave es que cada elemento tenga una fuente de datos.
| Campo | Significado | Origen de los datos |
|---|---|---|
in_cached |
Número de tokens de entrada que aciertan en la caché | Campo usage del registro de llamadas |
in_uncached |
Número de tokens de entrada normales sin acierto en caché | Registro de llamadas |
cache_write |
Número de tokens escritos en la caché en esta ocasión | Registro de llamadas |
out_visible |
Número de tokens de salida visibles | Registro de llamadas |
out_reasoning |
Número de tokens de razonamiento | Registro de llamadas (solo en modelos de razonamiento) |
retry_rate |
Proporción que requiere reintento | Estadísticas de pruebas de muestra |
escalate_rate |
Proporción que necesita escalar a un modelo más potente | Registro de la política de enrutamiento |
accept_rate |
Proporción finalmente aceptada | Validación automática más muestreo manual |
| Precio unitario de cada concepto | Precio unitario de entrada, salida, escritura en caché y lectura de caché | Datos reales de la página de precios de APIYI |
🚀 Consejo para empezar rápido: si vas a comparar el coste por tarea de varios modelos a la vez, lo recomendable es ejecutar la misma tanda de muestras por separado en APIYI (apiyi.com). La plataforma ofrece las llamadas API de los modelos principales que se tratan en este artículo, es compatible con los formatos de interfaz de OpenAI y Anthropic, y al cambiar de modelo solo hay que modificar el nombre del modelo, lo que facilita la comparación dentro de una misma hoja de trabajo. Para la forma de integración y el base_url, consulta la documentación de APIYI en docs.apiyi.com.
Ejemplo completo de cálculo de costos de una tarea
A continuación, usamos una tarea de extracción de campos de tickets para hacer una demostración. Para no utilizar cifras de precios no verificadas, el ejemplo solo proporciona la cantidad de tokens y la fórmula; en el precio unitario, introduce los datos reales del modelo correspondiente que aparecen en la página de precios de APIYI, docs.apiyi.com/models.
| Etapa | Composición de tokens (promedio) | Probabilidad de ocurrencia | Fórmula de costo |
|---|---|---|---|
| Llamada inicial | Acierto de caché 6,000 + entrada normal 2,000 + salida visible 800 + razonamiento 1,500 | 100% | 6,000 × precio de lectura de caché + 2,000 × precio de entrada + 2,300 × precio de salida |
| Escritura de caché | 6,000 (se reescribe después de que expira la caché) | Amortizado según la frecuencia de escritura | 6,000 × precio de escritura de caché ÷ número de solicitudes cubiertas por cada escritura |
| Llamada de reintento | Igual que la llamada inicial | 10% | Costo de la llamada inicial × 0.1 |
| Llamada de escalado | Entrada del modelo fuerte 8,000 + salida y razonamiento 2,000 en total | 5% | Tras sustituir el precio unitario del modelo fuerte × 0.05 |
| Muestreo manual | No consume tokens | Muestreo del 5% | Costo laboral de verificación por registro × 0.05 |
Suma las cinco filas anteriores y obtendrás el “costo esperado por ticket”. Luego divídelo entre la tasa de aceptación final, por ejemplo 95%, y obtendrás el “costo por resultado aceptado”. Ojo: aquí el reintento se calcula con el costo completo de la llamada inicial, porque al reintentar normalmente se vuelve a enviar el contexto tal cual.
En este ejemplo hay un detalle que llama la atención: la salida visible es de solo 800 tokens, pero los tokens de razonamiento son 1,500; al facturar con el precio de salida, la parte de razonamiento termina siendo la mayor dentro del lado de la salida. Si estimas solo con la salida visible, subestimarás el costo del lado de la salida en más de la mitad.
Costo completo de la tarea: comparación de conceptos erróneos comunes
Para una misma necesidad, usar dos enfoques —“mirar solo el precio unitario” y “mirar el costo completo de la tarea”— a menudo lleva a conclusiones de elección opuestas. La siguiente tabla resume varios escenarios típicos.
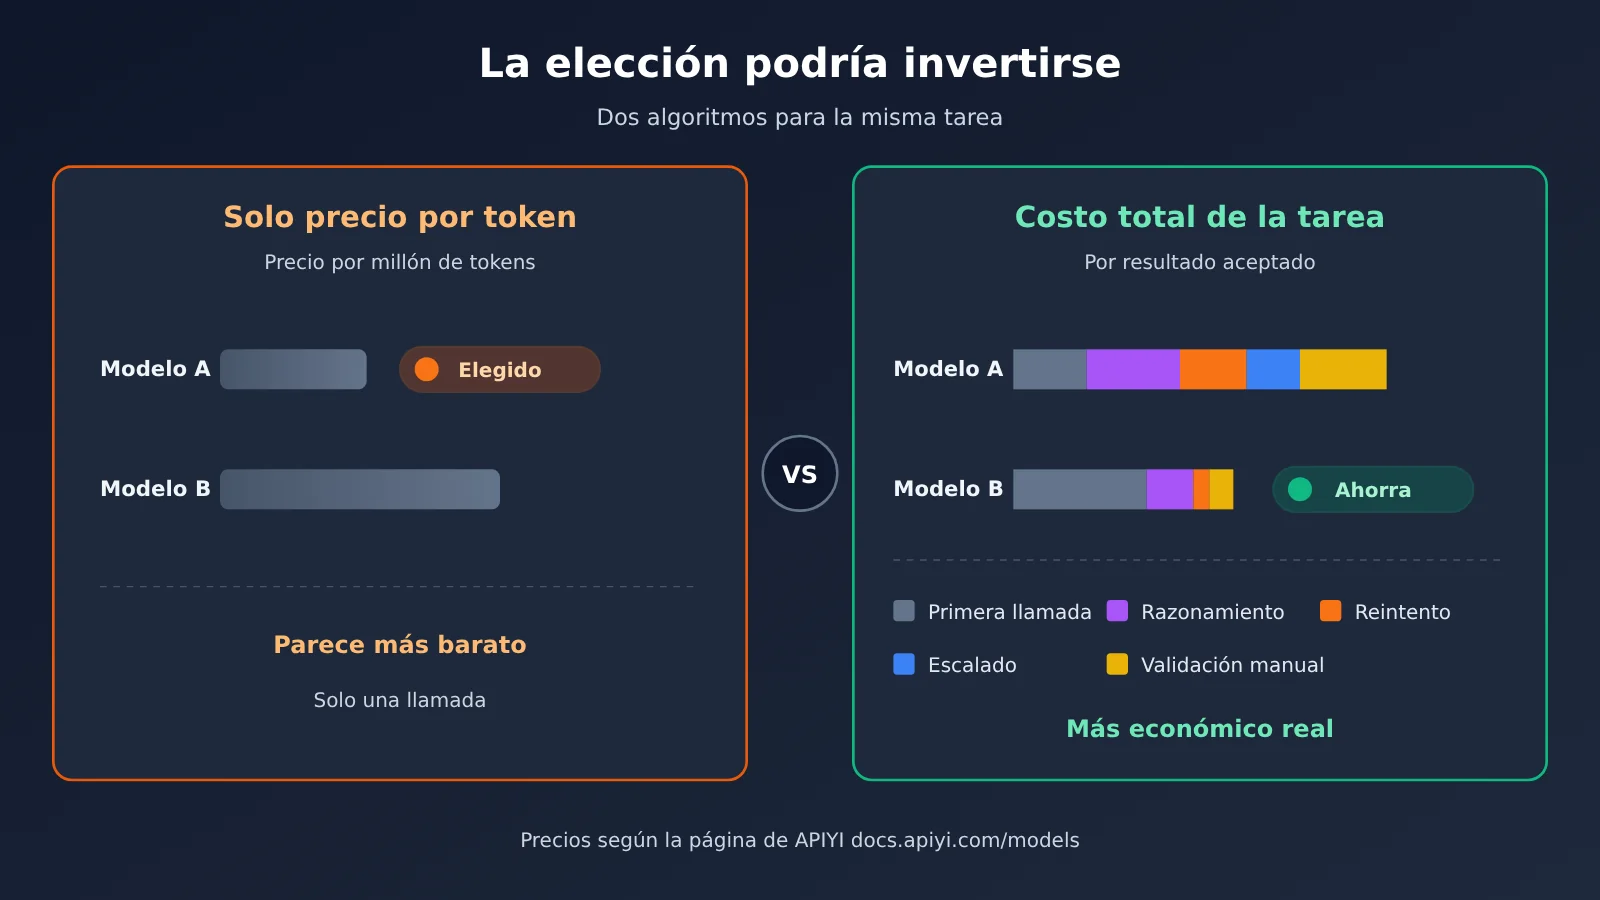
| Escenario | Conclusión si solo se mira el precio unitario | Conclusión al mirar el costo completo de la tarea | Variables clave |
|---|---|---|---|
| Extracción estructurada | Elegir el modelo ligero más barato | Si la tasa de error en los campos es alta, un modelo más potente puede resultar más económico | Tasa de aceptación, retrabajo manual |
| Agente de código | Elegir el modelo con menor precio unitario de salida | Las llamadas a herramientas en varias rondas inflan el contexto; la estrategia de caché es más decisiva | Tasa de aciertos de caché, número de rondas |
| Análisis de documentos largos | Estimar según la longitud media de entrada | Unas pocas solicitudes muy largas activan el precio escalonado de contexto largo | Umbral de contexto, longitud P95 |
| Elección de la intensidad de razonamiento | Con el mismo precio unitario del modelo, elegir el nivel más alto | El razonamiento de nivel alto usa más tokens; hay que ver si mejora la tasa de aprobación | Tokens de razonamiento, tasa de aprobación |
| Tareas por lotes offline | Calcular según el precio unitario de las llamadas en tiempo real | El canal de procesamiento por lotes puede tener criterios de facturación distintos | Si admite Batch |
💡 Nota de comparación: las conclusiones de la tabla son una deducción a nivel metodológico; qué modelo resulta más rentable depende de tu muestra. Te recomendamos probar varios modelos con la misma muestra en APIYI apiyi.com, completar la tabla con los precios unitarios reales de la página de precios y después decidir.
Detalles de contexto largo y caché en el costo completo de la tarea
El escalonado por contexto largo es el apartado donde más fácilmente se produce un “baja probabilidad, importe alto”. Hay información pública que menciona que algunos modelos aplican un precio unitario distinto cuando la entrada supera cierto umbral (por ejemplo, hay artículos que comentan el umbral de 272K de GPT-6 Sol). Si la distribución de longitudes de tus solicitudes tiene cola larga, es imprescindible contabilizar por separado las solicitudes que superan el umbral, en lugar de despacharlo sin más con la longitud media.
La caché, por su parte, es un arma de doble filo. La lectura de caché suele ser más barata que la entrada normal, pero en algunos proveedores el precio unitario de escritura en caché puede ser superior al de la entrada normal, y la caché tiene caducidad. Si tus solicitudes tienen intervalos largos y el prefijo cambia a menudo, el costo de escritura puede anular el ahorro que aporta la lectura. El precio de escritura en caché, el de lectura y los criterios de facturación concretos deben tomarse según lo indicado en la página de precios de APIYI docs.apiyi.com/models.
5 formas prácticas de reducir el costo total de una tarea
Una vez que haces los números, la dirección de la optimización suele quedar clara. Los siguientes métodos funcionan en la mayoría de los escenarios, pero conviene verificar su efecto con la hoja de cálculo, no guiarse por la intuición.
| Método | Costo sobre el que actúa | Consideraciones |
|---|---|---|
| Prefijo fijo y activar la caché | tokens de entrada | Coloca el contenido volátil al final de la indicación para aumentar la tasa de aciertos de la caché |
| Limitar el formato y la longitud de salida | tokens de salida | Usa salida estructurada para restringir los campos y evitar explicaciones largas |
| Enrutar según la dificultad de la tarea | llamadas de escalado, tokens de razonamiento | Las reglas deben ser claras y hay que auditar los «resultados erróneos aceptados» |
| Validación automática previa | validación manual, retrabajo | Valida la fuente de la evidencia, no solo el formato JSON |
| Controlar la intensidad de razonamiento | tokens de razonamiento | Usa la tasa de aprobación para decidir el nivel; no actives el nivel más alto por defecto |
Sobre el enrutamiento hay un riesgo que suele pasarse por alto: entre los resultados que un modelo pequeño devuelve como «exitosos» puede haber errores ocultos, y esos errores no activan el escalado. Por eso, al evaluar una estrategia de enrutamiento, además de la tasa de escalado, conviene revisar por muestreo esa parte de los resultados que el modelo pequeño aprobó directamente y contabilizar en el costo los errores que se colaron.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es el coste total de la tarea?
El coste total de la tarea es el gasto completo necesario para realizar una tarea con significado de negocio y que su resultado sea aceptado. Incluye los costes de entrada, salida, razonamiento y caché de todas las llamadas, así como los gastos de reintentos, escalados y verificación manual. Se acerca mucho más a la factura real que el simple precio unitario por token.
Q2: ¿Cuál es la diferencia entre el coste total de la tarea y el precio unitario por token?
El precio unitario por token es el precio de la materia prima; el coste total de la tarea es el precio del producto terminado. Un modelo con precio unitario bajo puede acabar con un coste total más alto si necesita más reintentos, razonamiento más largo o más retrabajo manual; y un modelo con precio unitario alto también puede salir más económico si su tasa de acierto a la primera es elevada.
Q3: ¿Cuántas muestras se necesitan como mínimo para estimar el coste total de la tarea?
No hay una cifra fija; lo clave es que las muestras cubran la distribución real, especialmente las entradas largas, los casos difíciles y las situaciones límite. Con pocas muestras, la tasa de reintentos y la tasa de aceptación fluctúan mucho. Se recomienda empezar con una estimación en pequeño lote y luego corregirla con los registros reales durante las primeras semanas en producción.
Q4: ¿En qué escenarios es más necesario calcular el coste total de la tarea?
Principalmente en estos casos:
– **Extracción de datos estructurados**: cuando los errores en campos requieren corrección manual, el coste de personal tiene un peso muy alto
– **Agentes de programación**: las llamadas múltiples a herramientas hacen que el contexto crezca rápidamente
– **Preguntas y respuestas sobre documentos largos**: las peticiones de cola larga pueden activar precios escalonados por contexto extenso
– **Enrutamiento entre varios modelos**: el escalado de llamadas suma dos veces el coste
Q5: ¿Cómo obtener rápidamente el precio unitario y los criterios de facturación de cada modelo?
Se recomienda consultar directamente la página de precios de APIYI, docs.apiyi.com/models, donde se detallan los precios de entrada, salida y caché de los modelos compatibles con la plataforma; para las estimaciones, toma como referencia los datos reales de esa página. APIYI es compatible con los formatos de interfaz de OpenAI y Anthropic; una vez completada la integración según la documentación de docs.apiyi.com, puedes probar varios modelos con el mismo lote de muestras y volcar directamente los datos de `usage` de los registros de llamadas en la hoja de cálculo.
Q6: ¿Se puede comparar directamente el uso de un producto por suscripción con la facturación por API?
No se recomienda compararlos directamente. Los productos por suscripción suelen limitarse por cuota o número de usos, mientras que la API factura por token; las unidades de medida y los escenarios de aplicación son distintos. Si quieres compararlos, primero debes convertir el volumen real de tareas disponibles de la suscripción, en lugar de suponer un número fijo de mensajes.
Q7: ¿Qué limitaciones tiene la estimación del coste total de la tarea?
Depende de la representatividad de las muestras: si son demasiado sencillas, se subestima el coste. La conversión del coste de verificación manual también tiene un componente subjetivo y varía mucho entre equipos. Además, los precios unitarios y las reglas de facturación de los modelos pueden cambiar, así que la hoja de cálculo debe actualizarse periódicamente con los precios y registros más recientes, en lugar de calcularse una vez y reutilizarse durante mucho tiempo.
Costo total de la tarea: puntos clave (Key Takeaways)
- Cambia la unidad de comparación: compara modelos por el “costo por resultado aceptado”, no por el precio por millón de tokens
- Los tokens de razonamiento deben registrarse aparte: normalmente se facturan como salida y pueden superar la salida visible
- La caché hay que contarla en escritura y lectura: la escritura puede costar más que la entrada normal, y la tasa de aciertos determina si compensa
- Reintentos y escalado son el gran costo oculto: la tasa de fallos después del despliegue suele ser mayor que la observada en las pruebas
- Un JSON válido no equivale a datos correctos: verifica la procedencia de la evidencia y cuenta el retrabajo manual en el costo
- En contextos largos, mira la cola larga: usa la longitud P95 para comprobar si se activa el precio escalonado
- El precio unitario se rige por la página de precios: al estimar, consulta siempre los datos reales en la página de precios de APIYI, docs.apiyi.com/models
Resumen
Puntos clave para estimar el costo total de una tarea:
- Define primero los límites de la tarea: toma como unidad el resultado de negocio, no la llamada individual
- Desglosa todos los costos: entrada, salida, razonamiento, caché, reintentos, escalado y validación manual; no puede faltar ninguno
- Mide probabilidades con muestras reales: las tasas de reintento, escalado y aceptación determinan el multiplicador del costo final
“No mires solo el precio por token” no significa que el precio unitario no importe, sino que es solo una variable de la fórmula. Arma la hoja de cálculo, rellénala con tus propias muestras y registros, y la conclusión de selección será más fiable que cualquier ranking.
Recomendamos usar APIYI apiyi.com para comparar varios modelos con el mismo lote de muestras y calcular el costo total de la tarea con los precios reales de la página docs.apiyi.com/models. La plataforma es compatible con los formatos de API de OpenAI y Anthropic, y cambiar de modelo cuesta muy poco.
📚 Referencias
- Serie de artículos sobre precios de modelos y costos de tareas del blog de Ofox.ai: varios artículos que analizan la facturación de caché, los umbrales de contexto largo, la intensidad de razonamiento y su relación con el costo de las tareas
- Enlace:
ofox.ai/blog/page/12 -
Descripción: útil para entender la diferencia entre «bajar el precio unitario» y «reducir el costo de la tarea»
-
Artículos sobre enrutamiento de modelos y extracción estructurada del blog de Ofox.ai: analizan las reglas para pasar de modelos pequeños a modelos más potentes, y que «un JSON válido no equivale a datos correctos»
- Enlace:
ofox.ai/blog/page/11 -
Descripción: útil como referencia al diseñar estrategias de enrutamiento y flujos de validación
-
Página de precios de modelos de APIYI: precios unitarios de entrada, salida y caché de los modelos compatibles con la plataforma
- Enlace:
docs.apiyi.com/models -
Descripción: todo el contenido de este artículo relacionado con precios y criterios de facturación se basa en los datos reales de esta página
-
Centro de documentación de APIYI: métodos de conexión, formato de la interfaz y descripción de parámetros
- Enlace:
docs.apiyi.com - Descripción: incluye las instrucciones de conexión en formatos compatibles con OpenAI y Anthropic
Autor: equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página principal del sitio oficial de APIYI, apiyi.com; para más material de conexión, visita el centro de documentación docs.apiyi.com