Autorhinweis: Von Eingabe, Ausgabe und Inferenz über Caching und Wiederholungen bis hin zu Validierung und Eskalation – in sieben Schritten verwandeln wir die Frage „Wie viel kostet eine Million Token?“ in „Wie viel kostet eine abgeschlossene Aufgabe?“.
Viele Teams schauen bei der Modellauswahl zuerst auf die Preise für Ein- und Ausgabe in der Preisliste und ziehen daraus den Schluss: „Dieses Modell ist halb so teuer.“ Als einen Monat nach dem Launch die Rechnung kommt, zeigt sich jedoch, dass das günstigere Modell keine Kosten gespart hat – manchmal ist es sogar teurer. Dieser Artikel stellt eine Methode zur Kostenschätzung mit „einer einzelnen akzeptierten Aufgabe“ als Einheit vor, die Ihnen hilft, die Kosten jenseits des Token-Preises sichtbar zu machen.
Dies ist kein Artikel, der Ihnen teurere Modelle aufschwatzen will. Günstigere Modelle sind in vielen Szenarien tatsächlich wirtschaftlicher. Der Punkt ist: Erst wenn Wiederholungsversuche, Inferenz-Token, Caching und manuelle Prüfung mit eingerechnet werden, lässt sich beurteilen, ob sich ein Modell wirklich rechnet.
Der zentrale Nutzen: Nach der Lektüre haben Sie ein wiederverwendbares Arbeitsblatt für Aufgabenkosten zur Hand. Sie wissen, welche Daten Sie sammeln müssen, wie Sie die Formel anwenden und welche Kostenposten am leichtesten übersehen werden.
Gesamtkosten einer Aufgabe: Kernpunkte
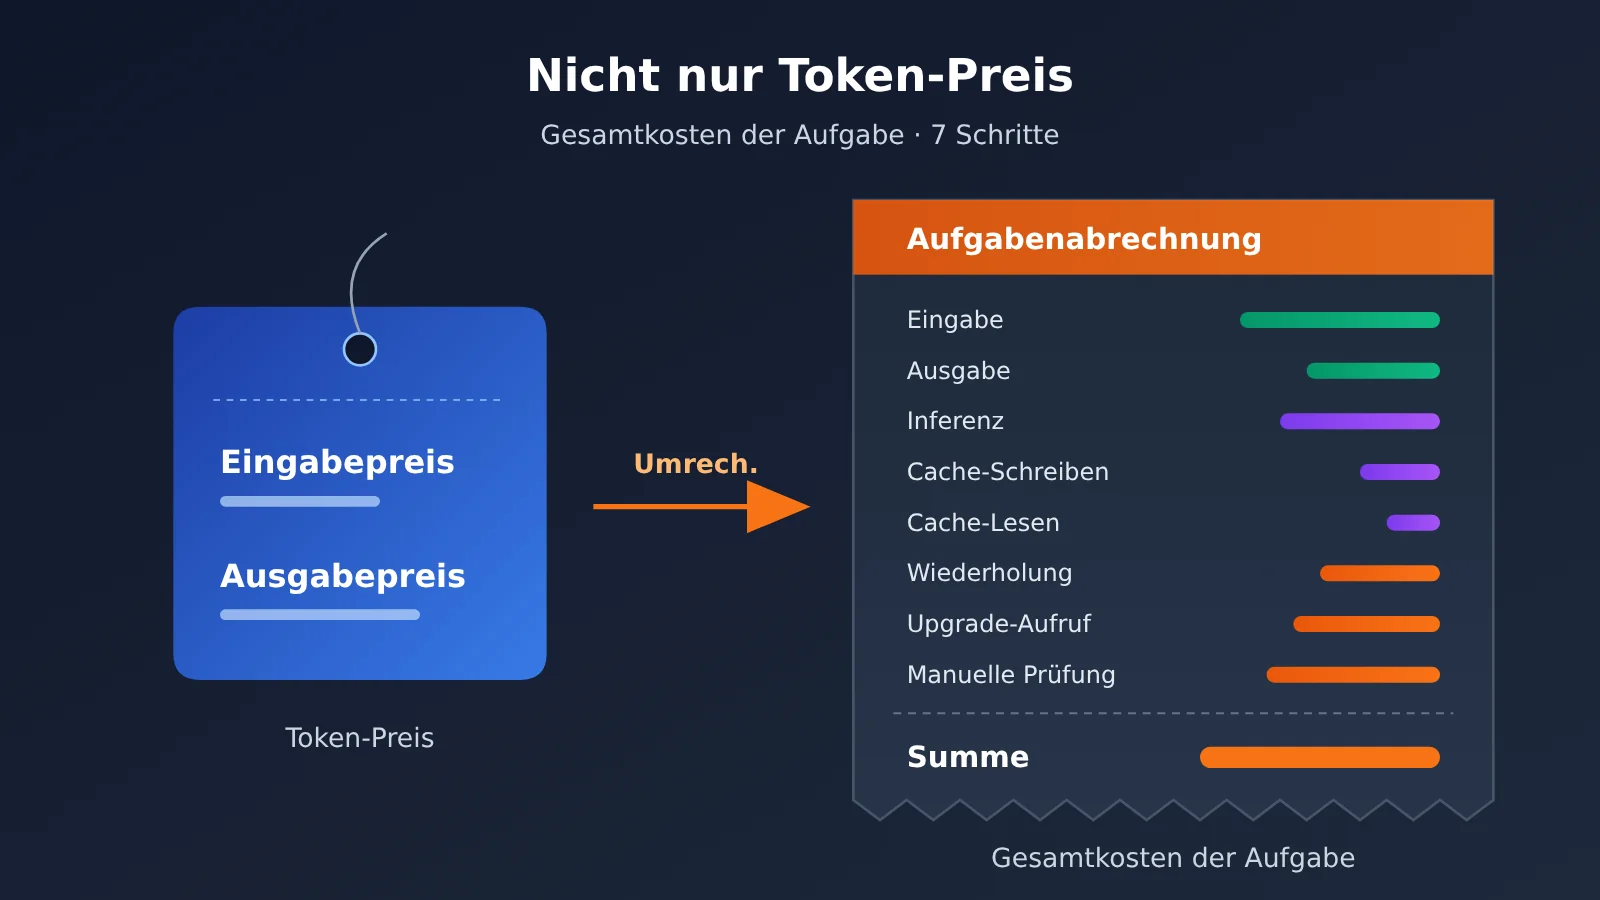
Bei der Schätzung der Gesamtkosten einer Aufgabe muss man zunächst eine Tatsache anerkennen: Die Preisliste nennt den „Preis pro Einheit Rohmaterial“, doch was Sie wirklich interessiert, ist der „Preis pro Einheit des fertigen Ergebnisses“. Eine Aufgabe besteht oft aus mehreren Aufrufen, verschiedenen Token-Arten und einigen Kosten, die nicht vom Modell stammen. Die folgende Tabelle listet die häufigsten Kostenpositionen auf.
| Kostenposition | Beschreibung | Warum sie leicht übersehen wird |
|---|---|---|
| Normale Eingabe-Token | System-Eingabeaufforderung, Nutzereingabe, Retrieval-Kontext, Gesprächsverlauf | In Mehrrunden-Dialogen wird der Verlauf wiederholt mitgezählt |
| Ausgabe-Token | Die sichtbaren Inhalte, die das Modell am Ende zurückgibt | Strukturierte Ausgaben sind oft länger als erwartet |
| Reasoning-Token | Interner Denkaufwand von Reasoning-Modellen, wird üblicherweise wie Ausgabe abgerechnet | Für Nutzer unsichtbar, aber auf der Rechnung sichtbar |
| Cache-Schreiben und -Lesen | Cache-Erstellung und Cache-Treffer bei wiederholten Präfixen | Schreiben und Lesen werden anders abgerechnet als normale Eingaben |
| Wiederholungsaufrufe | Erneute Anfragen nach Timeouts, Formatfehlern oder fehlgeschlagener Validierung | Tritt in Tests selten auf, im Produktivbetrieb jedoch in großem Umfang |
| Eskalationsaufrufe | Wenn ein kleines Modell scheitert, wird an ein stärkeres Modell übergeben | Bei Routing-Strategien fallen die Kosten für beide Aufrufe an |
| Langkontext-Staffelung | Der Token-Preis ändert sich, sobald ein bestimmter Kontextschwellenwert überschritten wird | Wird nur bei wenigen Anfragen mit langen Eingaben ausgelöst und leicht übersehen |
| Kosten für manuelle Prüfung | Ergebnisse müssen von Menschen geprüft oder nachgebessert werden | Steht nicht auf der API-Rechnung, ist aber real vorhanden |
Die wichtigsten Details zu den Gesamtkosten: Warum Stückpreise in die Irre führen
Die erste Irreführung kommt von den Reasoning-Token. Reasoning-Modelle verbrauchen vor der Antwort eine Phase internen Nachdenkens; dieser Teil wird üblicherweise zum Preis für Ausgabe-Token abgerechnet, und seine Länge variiert je nach Einstellung der Reasoning-Intensität. In öffentlichen Diskussionen gibt es zahlreiche Artikel, die gezielt die beiden Reasoning-Stufen high und xhigh desselben Modells vergleichen, und alle kommen zum selben Schluss: Ob sich das zusätzliche Reasoning lohnt, hängt davon ab, wie stark es die Erfolgsquote bei der Aufgabe steigert – nicht davon, ob der Token-Preis gleich bleibt.
Die zweite Irreführung lautet: „Formatkorrekt ist nicht gleich inhaltlich korrekt“. Bei der Textextraktion ist es für ein Modell leicht, gültiges JSON zurückzugeben, aber ob die Feldwerte tatsächlich aus dem Ausgangstext stammen und nicht falsch zugeordnet wurden, muss zusätzlich validiert werden. Wenn bei einem günstigen Modell ein hoher Anteil der Extraktionsergebnisse manuell nachgebessert werden muss, dann gibt es das auf der API-Rechnung gesparte Geld sehr wahrscheinlich bei den Personalkosten doppelt wieder aus.
Die dritte Irreführung kommt aus den Marketingaussagen der Anbieter. Bei der Veröffentlichung eines Modells wird manchmal gleichzeitig eine Senkung des Token-Preises und ein „Rückgang der Aufgabenkosten“ angekündigt, doch beides ist nicht dasselbe. Sinkende Aufgabenkosten können aus kürzeren Ausgaben, weniger Wiederholungsversuchen oder einer speziellen Cache-Nutzung resultieren; Ihr Workload wird dieselben prozentualen Einsparungen nicht unbedingt reproduzieren.
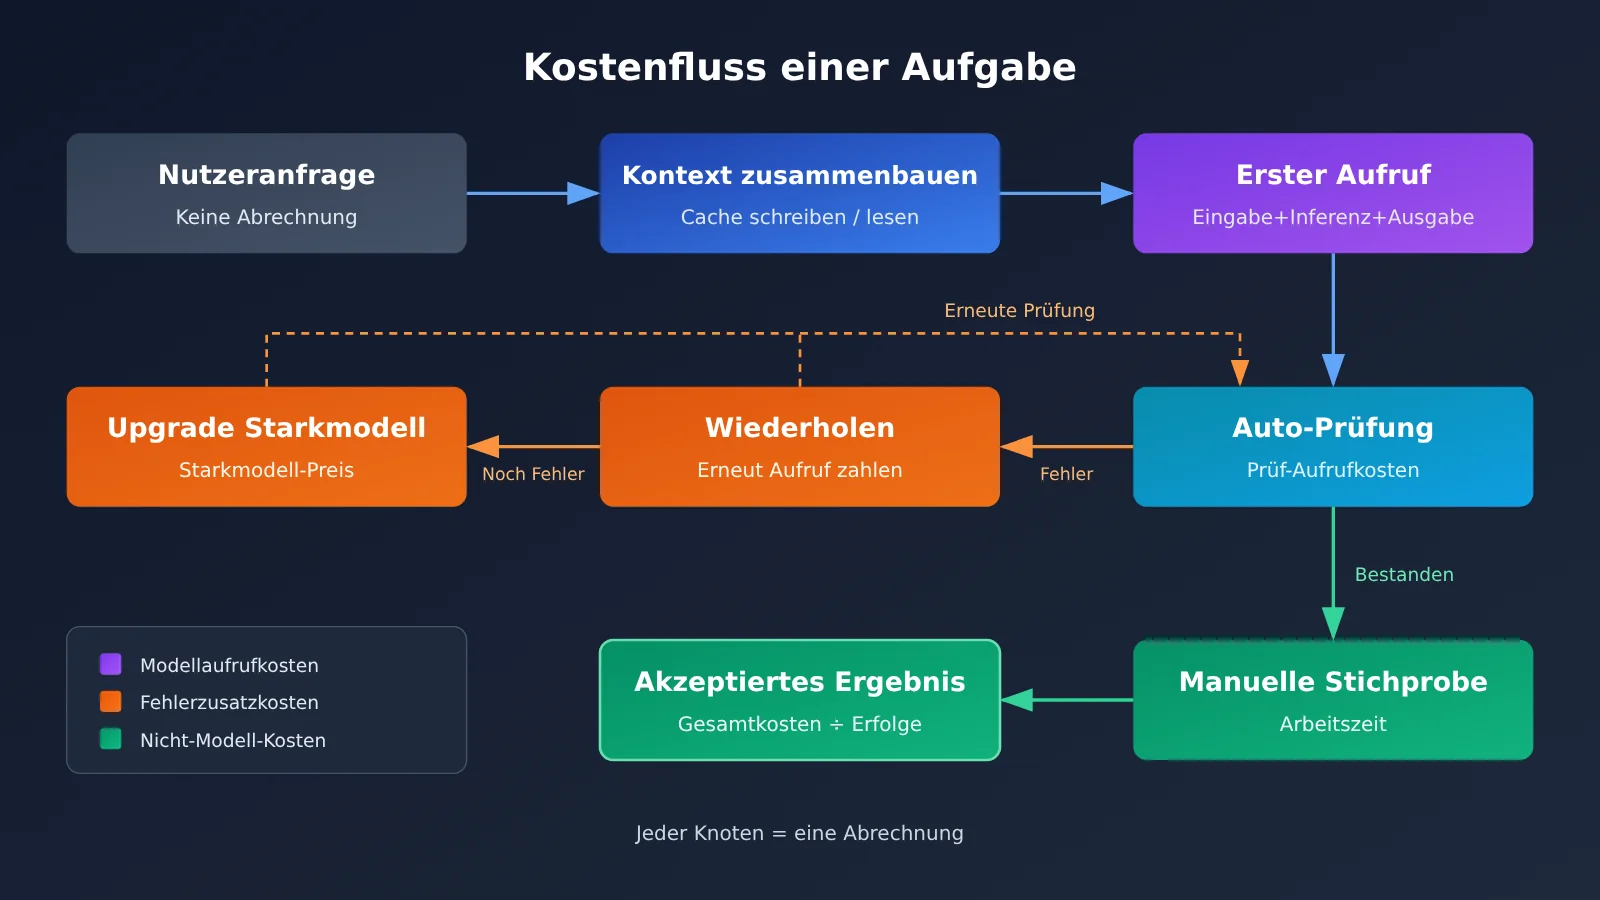
Schnellstart: Die vollständigen Kosten einer Aufgabe schätzen
Dieser Ablauf funktioniert ohne Programmierung – eine Tabellenkalkulation reicht aus. Der Kern besteht darin, zuerst die Token-Struktur eines einzelnen Aufrufs zu ermitteln, diese mit den jeweiligen Wahrscheinlichkeiten zu multiplizieren und das Ergebnis anschließend durch die Anzahl der akzeptierten Ergebnisse zu teilen.
Die 7 Schritte zur Schätzung der vollständigen Aufgabenkosten
- Den Rahmen einer „Aufgabe“ definieren: Zum Beispiel „ein Ticket bearbeiten und speicherbare strukturierte Felder ausgeben“ statt „eine Schnittstelle einmal aufrufen“. Je nach Definition unterscheidet sich die Kostenbasis grundlegend.
- Die Token-Struktur eines einzelnen Aufrufs aufschlüsseln: Erfassen Sie separat die durchschnittliche Länge von System-Eingabeaufforderung, abgerufenem Kontext, Benutzereingabe, sichtbarer Ausgabe und Reasoning-Token – am besten jeweils als P50- und P95-Wert.
- Cachefähige Teile kennzeichnen: Feste System-Eingabeaufforderungen, Tool-Definitionen und Few-Shot-Beispiele lassen sich in der Regel cachen. Halten Sie fest, wie häufig der Cache geschrieben wird und wie hoch die geschätzte Trefferquote ist.
- Die Abrechnungsgrundlage klären: Die Preise für Eingabe, Ausgabe, Cache-Schreiben und Cache-Lesen sowie mögliche Preisstufen für lange Kontexte. Alle Preise richten sich nach den tatsächlichen Daten auf der APIYI-Preisseite docs.apiyi.com/models.
- Die Fehlerrate mit echten Stichproben messen: Führen Sie mindestens einen Satz repräsentativer Beispiele aus und erfassen Sie die Anteile von Formatfehlern, Validierungsfehlern und Timeouts. Rechnen Sie diese in Wiederholungs- und Eskalationsraten um.
- Nicht modellbezogene Kosten hinzufügen: Anteil manueller Stichprobenprüfungen, Zeitaufwand pro Validierung und bei Bedarf die Umrechnung in Geldbeträge.
- Die Kosten „pro akzeptiertem Ergebnis“ berechnen: Teilen Sie die Gesamtkosten durch die Anzahl der Ergebnisse, die die finale Abnahme bestehen. Nur dieser Wert eignet sich für einen Vergleich zwischen Modellen.
Felder der vollständigen Aufgabenkostentabelle
Übertragen Sie die oben beschriebenen Schritte in eine Tabelle. Sie sollte mindestens die folgenden Felder enthalten. Die Feldnamen können Sie an die Gepflogenheiten Ihres Teams anpassen – entscheidend ist, dass jeder Eintrag eine Datenquelle hat.
| Feld | Bedeutung | Datenquelle |
|---|---|---|
in_cached |
Anzahl der Eingabe-Token, die den Cache treffen | usage-Feld im Aufrufprotokoll |
in_uncached |
Anzahl der normalen Eingabe-Token, die den Cache nicht treffen | Aufrufprotokoll |
cache_write |
Anzahl der bei diesem Aufruf in den Cache geschriebenen Token | Aufrufprotokoll |
out_visible |
Anzahl der sichtbaren Ausgabe-Token | Aufrufprotokoll |
out_reasoning |
Anzahl der Reasoning-Token | Aufrufprotokoll (nur bei Reasoning-Modellen) |
retry_rate |
Anteil der Anfragen, die wiederholt werden müssen | Statistik aus Stichprobentests |
escalate_rate |
Anteil der Anfragen, die auf ein stärkeres Modell hochgestuft werden müssen | Protokoll der Routing-Strategie |
accept_rate |
Anteil der Ergebnisse, die letztendlich akzeptiert werden | Automatische Validierung plus manuelle Stichproben |
| Einzelpreise | Einzelpreise für Eingabe, Ausgabe, Cache-Schreiben und Cache-Lesen | Tatsächliche Daten von der Preisseite von APIYI |
🚀 Tipp zum schnellen Einstieg: Wenn Sie die Aufgabenkosten mehrerer Modelle gleichzeitig vergleichen möchten, empfiehlt es sich, auf APIYI apiyi.com dieselbe Stichprobe jeweils einmal durchlaufen zu lassen. Die Plattform bietet API-Aufrufe für die in diesem Artikel behandelten gängigen Modelle und ist sowohl mit dem OpenAI- als auch dem Anthropic-Schnittstellenformat kompatibel. Beim Wechsel des Modells müssen Sie nur den Modellnamen ändern – das erleichtert den Vergleich in derselben Tabelle. Angaben zur Anbindung und zur
base_urlentnehmen Sie bitte der APIYI-Dokumentation unter docs.apiyi.com.
Vollständiges Kostenberechnungsbeispiel für eine Aufgabe
Im Folgenden zeigen wir das anhand einer Aufgabe zur Feld-Extraktion aus einem Ticket. Um keine ungeprüften Preisangaben zu verwenden, nennt das Beispiel nur Token-Mengen und Formeln – die Einheitspreise tragen Sie bitte aus den tatsächlichen Daten des jeweiligen Modells auf der APIYI-Preisseite docs.apiyi.com/models ein.
| Schritt | Token-Zusammensetzung (Durchschnitt) | Eintrittswahrscheinlichkeit | Kostenformel |
|---|---|---|---|
| Erster Aufruf | Cache-Treffer 6.000 + reguläre Eingabe 2.000 + sichtbare Ausgabe 800 + Reasoning 1.500 | 100 % | 6.000 × Cache-Lesepreis + 2.000 × Eingabepreis + 2.300 × Ausgabepreis |
| Cache-Schreiben | 6.000 (erneutes Schreiben nach Ablauf des Caches) | amortisiert über die Schreibhäufigkeit | 6.000 × Cache-Schreibpreis ÷ Anzahl der Anfragen, die ein Schreibvorgang abdeckt |
| Wiederholungsaufruf | identisch mit dem ersten Aufruf | 10 % | Kosten des ersten Aufrufs × 0,1 |
| Eskalationsaufruf | starkes Modell: Eingabe 8.000 + Ausgabe und Reasoning zusammen 2.000 | 5 % | nach Einsetzen der Preise des starken Modells × 0,05 |
| Manuelle Stichprobenprüfung | verbraucht keine Tokens | Stichprobe 5 % | Personalkosten pro Prüfung × 0,05 |
Addiert man diese fünf Zeilen, erhält man die „erwarteten Kosten pro Ticket“. Teilt man das Ergebnis anschließend durch die endgültige Akzeptanzrate – beispielsweise 95 % –, ergibt sich „die Kosten pro akzeptiertem Ergebnis“. Beachten Sie, dass Wiederholungen hier mit den vollen Kosten des ersten Aufrufs angesetzt werden, weil der Kontext beim erneuten Versuch in der Regel unverändert noch einmal gesendet wird.
An diesem Beispiel fällt ein Punkt auf: Die sichtbare Ausgabe umfasst nur 800 Tokens, die Reasoning-Tokens aber 1.500. Rechnet man sie zum Ausgabepreis ab, stellt das Reasoning den größeren Teil der Ausgabeseite dar. Schätzt man nur anhand der sichtbaren Ausgabe, werden die Kosten auf der Ausgabeseite um mehr als die Hälfte unterschätzt.
Vollständige Aufgabenkosten: häufige Denkfehler im Vergleich
Für dieselbe Anforderung führen zwei Denkweisen – „nur den Stückpreis betrachten“ und „die vollständigen Aufgabenkosten betrachten“ – oft zu gegensätzlichen Empfehlungen bei der Auswahl. Die folgende Tabelle fasst einige typische Szenarien zusammen.
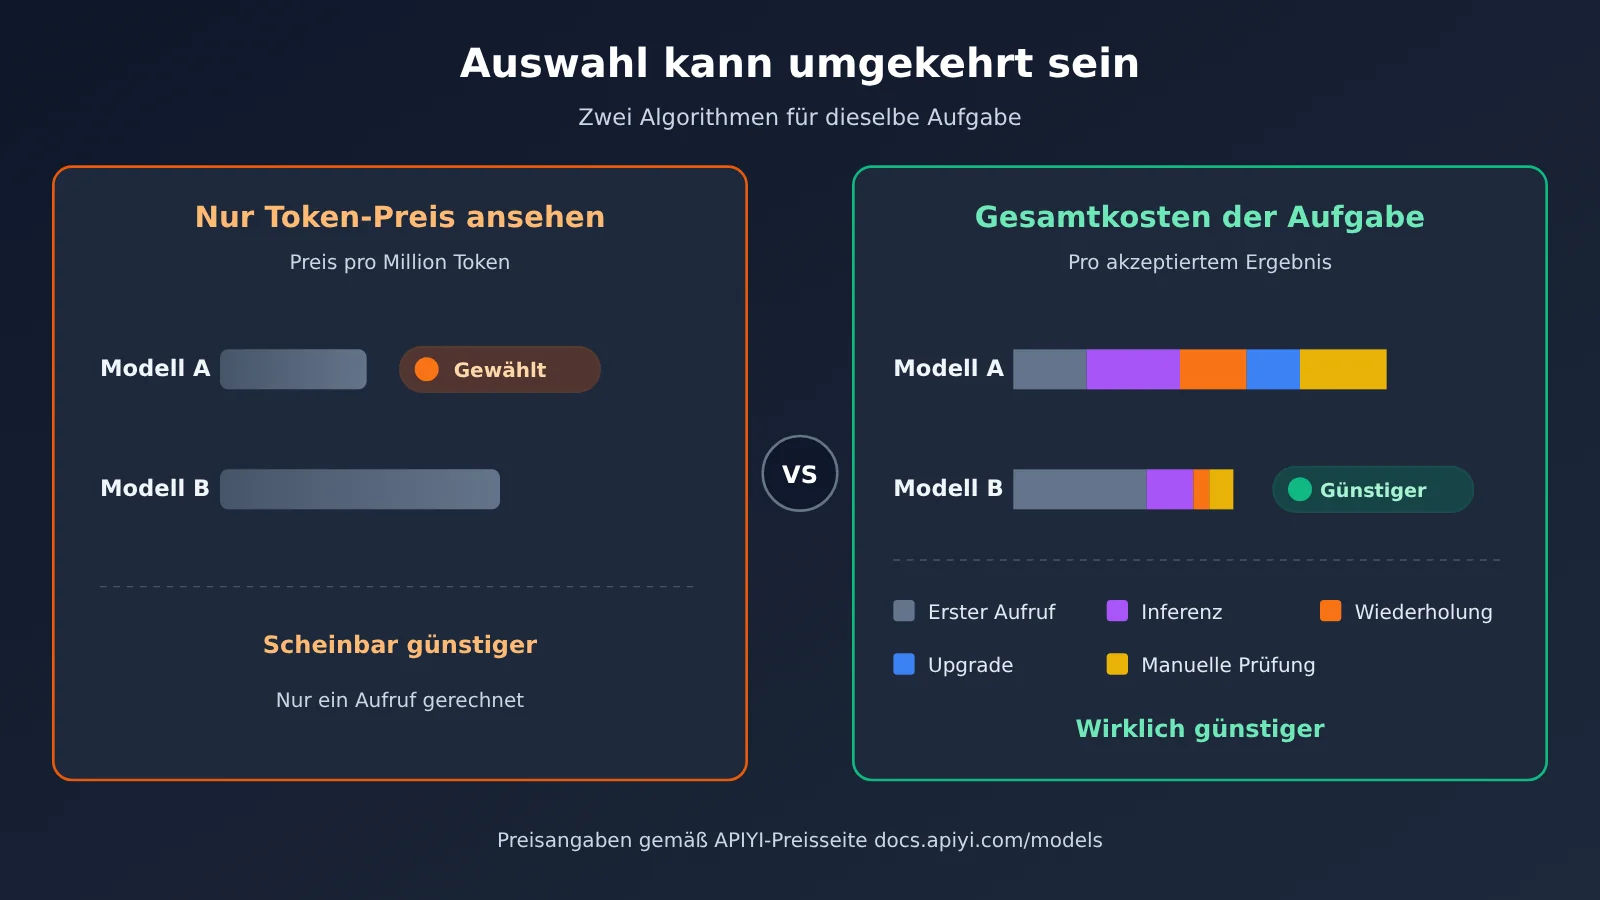
| Szenario | Ergebnis bei reiner Stückpreisbetrachtung | Ergebnis bei Betrachtung der vollständigen Aufgabenkosten | Entscheidende Variablen |
|---|---|---|---|
| Strukturierte Extraktion | Das günstigste leichte Modell wählen | Bei hoher Feldfehlerrate kann ein stärkeres Modell unterm Strich günstiger sein | Akzeptanzrate, manuelle Nacharbeit |
| Coding-Agent | Modell mit niedrigerem Ausgabestückpreis wählen | Mehrere Tool-Aufrufe blähen den Kontext auf; die Caching-Strategie ist entscheidender | Cache-Trefferquote, Anzahl der Runden |
| Analyse langer Dokumente | Schätzung anhand der durchschnittlichen Eingabelänge | Wenige sehr lange Anfragen lösen die gestaffelten Preise für lange Kontexte aus | Kontextschwelle, P95-Länge |
| Wahl der Reasoning-Intensität | Beim selben Modell ist der Stückpreis gleich, also die höchste Stufe wählen | Bei hoher Stufe fallen mehr Reasoning-Token an; zu prüfen ist, ob die Erfolgsquote steigt | Reasoning-Token, Erfolgsquote |
| Batch-Offline-Aufgaben | Kalkulation nach dem Stückpreis für Echtzeitaufrufe | Der Batch-Kanal kann eine andere Preislogik haben | Batch-Unterstützung |
💡 Hinweis zum Vergleich: Die Schlussfolgerungen in der Tabelle sind methodische Überlegungen. Welches Modell tatsächlich günstiger ist, hängt von deinen Testdaten ab. Es empfiehlt sich, auf APIYI apiyi.com mehrere Modelle mit denselben Testdaten laufen zu lassen, die Tabelle mit den tatsächlichen Preisen von der Preisseite zu füllen und dann zu entscheiden.
Lange Kontexte und Caching bei den vollständigen Aufgabenkosten
Die Preisstaffel für lange Kontexte ist der Posten, bei dem am ehesten „geringe Wahrscheinlichkeit, hoher Betrag“ gilt. Öffentlich zugängliche Informationen weisen darauf hin, dass bei einigen Modellen ein anderer Stückpreis gilt, sobald die Eingabe eine bestimmte Schwelle überschreitet (so wird in einem Artikel beispielsweise die 272K-Schwelle von GPT-6 Sol diskutiert). Wenn die Längenverteilung deiner Anfragen einen Long Tail aufweist, solltest du die Anfragen oberhalb der Schwelle separat erfassen und nicht einfach mit der Durchschnittslänge abtun.
Caching ist dagegen ein zweischneidiges Schwert. Das Lesen aus dem Cache ist normalerweise günstiger als eine normale Eingabe, aber bei manchen Anbietern kann der Stückpreis für das Schreiben in den Cache höher sein als für normale Eingaben, und der Cache läuft mit der Zeit ab. Wenn deine Anfragen in großen Abständen erfolgen und sich das Präfix häufig ändert, können die Schreibkosten die Einsparungen durch das Lesen wieder aufheben. Die genauen Preise für Cache-Schreiben und -Lesen sowie die Abrechnungslogik sind der Preisseite von APIYI unter docs.apiyi.com/models zu entnehmen.
Fünf praktische Maßnahmen zur Senkung der Gesamtkosten einer Aufgabe
Sobald die Rechnung klar ist, wird meist auch die Richtung für die Optimierung klar. Die folgenden Maßnahmen funktionieren in den meisten Szenarien, aber prüfen Sie die Wirkung mit dem Arbeitsblatt statt nach Gefühl.
| Maßnahme | Betroffene Kostenposition | Hinweise |
|---|---|---|
| Feste Präfixe, Caching aktivieren | Eingabe-Token | Veränderliche Inhalte ans Ende der Eingabeaufforderung stellen, um die Trefferquote zu erhöhen |
| Ausgabeformat und -länge begrenzen | Ausgabe-Token | Felder durch strukturierte Ausgaben einschränken, um lange Erklärungen zu vermeiden |
| Routing nach Aufgabenkomplexität | Eskalationsaufrufe, Reasoning-Token | Regeln müssen klar sein, und „akzeptierte fehlerhafte Ergebnisse“ müssen geprüft werden |
| Automatische Vorabprüfung | Manuelle Prüfung, Nacharbeit | Quelle der Belege prüfen, nicht nur das JSON-Format |
| Reasoning-Intensität steuern | Reasoning-Token | Stufe anhand der Erfolgsquote festlegen, nicht standardmäßig die höchste Stufe aktivieren |
Beim Routing gibt es ein oft übersehenes Risiko: In den Ergebnissen, die ein kleines Modell „erfolgreich“ zurückgibt, können Fehler stecken, die keine Eskalation auslösen. Prüfen Sie bei der Bewertung einer Routing-Strategie daher nicht nur die Eskalationsrate, sondern auch Stichproben der Ergebnisse, die das kleine Modell direkt durchgelassen hat, und rechnen Sie die durchgerutschten Fehler in die Kosten ein.
Häufige Fragen (FAQ)
F1: Was sind die vollständigen Aufgabenkosten?
Die vollständigen Aufgabenkosten bezeichnen alle Kosten, die anfallen, um eine fachlich definierte Aufgabe abzuschließen und ein akzeptiertes Ergebnis zu erhalten. Sie umfassen die Eingabe-, Ausgabe-, Reasoning- und Cache-Kosten sämtlicher Aufrufe sowie die Aufwände für Wiederholungsversuche, Eskalationen und manuelle Prüfung – und liegen damit deutlich näher an der echten Rechnung als ein reiner Token-Stückpreis.
F2: Worin unterscheiden sich vollständige Aufgabenkosten und Token-Stückpreis?
Der Token-Stückpreis ist der Preis für den Rohstoff, die vollständigen Aufgabenkosten sind der Preis für das Fertigprodukt. Ein Modell mit niedrigem Stückpreis kann unterm Strich teurer sein, wenn mehr Wiederholungsversuche, längeres Reasoning oder mehr manuelle Nacharbeit nötig sind. Umgekehrt kann ein Modell mit hohem Stückpreis günstiger ausfallen, wenn es die Aufgabe häufig beim ersten Anlauf besteht.
F3: Wie viele Stichproben braucht man mindestens, um die vollständigen Aufgabenkosten zu schätzen?
Eine feste Zahl gibt es nicht. Entscheidend ist, dass die Stichproben die reale Verteilung abdecken – vor allem lange Eingaben, schwierige Fälle und Randfälle. Bei zu wenigen Samples schwanken Wiederholungs- und Akzeptanzrate stark. Empfehlung: zuerst mit einem kleinen Batch schätzen und die Werte in der Anfangsphase nach dem Go-live anhand echter Logs korrigieren.
F4: In welchen Szenarien lohnt es sich besonders, die vollständigen Aufgabenkosten zu berechnen?
Vor allem in den folgenden Fällen:
– **Strukturierte Datenextraktion**: Müssen Feldfehler manuell korrigiert werden, ist der Anteil der Personalkosten sehr hoch
– **Coding-Agent**: Mehrere Tool-Aufrufe in Folge lassen den Kontext schnell wachsen
– **Fragen zu langen Dokumenten**: Long-Tail-Anfragen können die gestaffelten Preise für langen Kontext auslösen
– **Multi-Modell-Routing**: Ein Eskalationsaufruf summiert zwei Kostenblöcke
F5: Wie bekomme ich schnell die Stückpreise und Abrechnungsregeln der einzelnen Modelle?
Am besten schauen Sie direkt auf die Preisseite von APIYI unter docs.apiyi.com/models. Dort sind die Eingabe-, Ausgabe- und Cache-Preise der auf der Plattform unterstützten Modelle aufgeführt; für die Schätzung sollten Sie die tatsächlichen Werte dieser Seite zugrunde legen. APIYI ist kompatibel mit den Schnittstellenformaten von OpenAI und Anthropic. Nach der Anbindung gemäß der Dokumentation unter docs.apiyi.com können Sie mehrere Modelle mit derselben Stichprobe testen und die `usage`-Daten aus den Aufruf-Logs direkt in Ihre Tabelle übernehmen.
F6: Lassen sich der Verbrauch von Abo-Produkten und die API-Abrechnung überhaupt vergleichen?
Ein direkter Vergleich ist nicht empfehlenswert. Abo-Produkte sind meist über Kontingente oder Nutzungszahlen begrenzt, die API wird dagegen nach Token abgerechnet – die Maßeinheiten und Einsatzszenarien unterscheiden sich. Wer vergleichen will, muss zuerst das tatsächlich nutzbare Aufgabenvolumen des Abos umrechnen und darf nicht einfach von einer festen Nachrichtenzahl ausgehen.
F7: Welche Grenzen hat die Schätzung der vollständigen Aufgabenkosten?
Sie hängt davon ab, wie repräsentativ die Stichproben sind – sind sie zu einfach, werden die Kosten unterschätzt. Auch die Umrechnung der manuellen Prüfkosten ist subjektiv, und die Unterschiede zwischen Teams sind groß. Zudem können sich Modellpreise und Abrechnungsregeln ändern. Die Tabelle muss daher regelmäßig mit aktuellen Preisen und Logs aktualisiert werden, statt nach einer einmaligen Berechnung dauerhaft weiterverwendet zu werden.
Gesamtkosten einer Aufgabe: Die Kernpunkte (Key Takeaways)
- Vergleichsbasis wechseln: Vergleichen Sie Modelle anhand der Kosten pro akzeptiertem Ergebnis, nicht anhand des Preises pro Million Tokens.
- Reasoning-Tokens separat erfassen: Sie werden in der Regel als Ausgabe abgerechnet und können die sichtbare Ausgabe übersteigen.
- Cache: Schreiben und Lesen getrennt kalkulieren: Schreibvorgänge können teurer als normale Eingaben sein; die Trefferquote entscheidet, ob sich das lohnt.
- Wiederholungen und Eskalationen sind ein versteckter Kostentreiber: Die Fehlerrate im Produktivbetrieb liegt oft höher als in Tests beobachtet.
- Gültiges JSON ist nicht gleich korrekte Daten: Prüfen Sie die Herkunft der Belege und rechnen Sie manuelle Nacharbeit in die Kosten ein.
- Bei langem Kontext auf den Long Tail achten: Prüfen Sie anhand der P95-Länge, ob gestaffelte Preise greifen.
- Stückpreise laut Preisseite: Für Schätzungen immer die tatsächlichen Werte auf der APIYI-Preisseite docs.apiyi.com/models heranziehen.
Zusammenfassung
Die Kernpunkte für die Schätzung der Gesamtkosten einer Aufgabe:
- Zuerst den Aufgabenumfang definieren: Die Einheit ist das Geschäftsergebnis, nicht der einzelne Aufruf.
- Alle Kostenpositionen aufschlüsseln: Eingabe, Ausgabe, Reasoning, Cache, Wiederholungen, Eskalationen und manuelle Prüfung – nichts davon darf fehlen.
- Wahrscheinlichkeiten mit echten Stichproben messen: Wiederholungsrate, Eskalationsrate und Akzeptanzrate bestimmen, um welchen Faktor sich die Endkosten erhöhen.
„Schauen Sie nicht nur auf den Token-Stückpreis“ bedeutet nicht, dass der Stückpreis unwichtig ist – er ist nur eine Variable in der Formel. Bauen Sie ein Arbeitsblatt auf und füllen Sie es mit Ihren eigenen Stichproben und Logs. So wird die Modellauswahl verlässlicher als jede Rangliste.
Empfohlen: Vergleichen Sie über APIYI apiyi.com mehrere Modelle mit derselben Stichprobe und ziehen Sie für die Kostenkalkulation die tatsächlichen Stückpreise auf der Preisseite docs.apiyi.com/models heran. Die Plattform ist mit den API-Formaten von OpenAI und Anthropic kompatibel; der Modellwechsel ist mit geringen Wechselkosten verbunden.
📚 Referenzen
- Ofox.ai Blog – Artikelserie zu Modellpreisen und Aufgabenkosten: Mehrere Beiträge beleuchten den Zusammenhang zwischen Cache-Abrechnung, Langkontext-Schwellenwerten, Inferenzintensität und Aufgabenkosten
- Link:
ofox.ai/blog/page/12 -
Hinweis: Gut geeignet, um den Unterschied zwischen „gesenktem Stückpreis“ und „sinkenden Aufgabenkosten“ zu verstehen
-
Ofox.ai Blog – Artikel zu Modell-Routing und strukturierter Extraktion: Diskutiert die Eskalationsregeln von kleinen hin zu starken Modellen sowie die Faustregel „gültiges JSON ist nicht gleich korrekte Daten“
- Link:
ofox.ai/blog/page/11 -
Hinweis: Nützlich als Referenz beim Entwurf von Routing-Strategien und Validierungsabläufen
-
APIYI Modellpreisseite: Einheitspreise für Input, Output und Caching der unterstützten Modelle
- Link:
docs.apiyi.com/models -
Hinweis: Alle Angaben zu Preisen und Abrechnungslogik in diesem Artikel richten sich nach den tatsächlichen Daten auf dieser Seite
-
APIYI Dokumentationszentrum: Integrationswege, Schnittstellenformate und Parameterbeschreibungen
- Link:
docs.apiyi.com - Hinweis: Enthält Integrationshinweise für OpenAI- und Anthropic-kompatible Formate
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com – weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com