Nota do autor: da entrada, saída, raciocínio, cache e retentativas até validação e escalonamento, use 7 etapas para converter “quanto custa por milhão de tokens” em “quanto custa por tarefa concluída”.
Muitas equipes, ao escolher um modelo, olham primeiro para o preço unitário de entrada e saída na tabela de preços e concluem: “este custa metade”. Um mês depois, quando a fatura chega, descobrem que o modelo barato não economizou dinheiro — às vezes, até saiu mais caro. Este artigo apresenta um método de estimativa de custo por “tarefa aceita”, para ajudar você a enxergar a parcela de custo que fica além do preço unitário por token.
Este não é um artigo para convencer você a comprar um modelo caro; modelos baratos realmente compensam em muitos cenários. A questão é que só dá para saber se ele compensa de verdade quando entram na conta as retentativas, os tokens de raciocínio, o cache e a validação humana.
Valor central: ao terminar a leitura, você terá uma planilha de custo por tarefa reutilizável e saberá quais dados coletar, como aplicar as fórmulas e quais etapas são mais fáceis de ficar de fora da conta.
Pontos-chave do custo total da tarefa
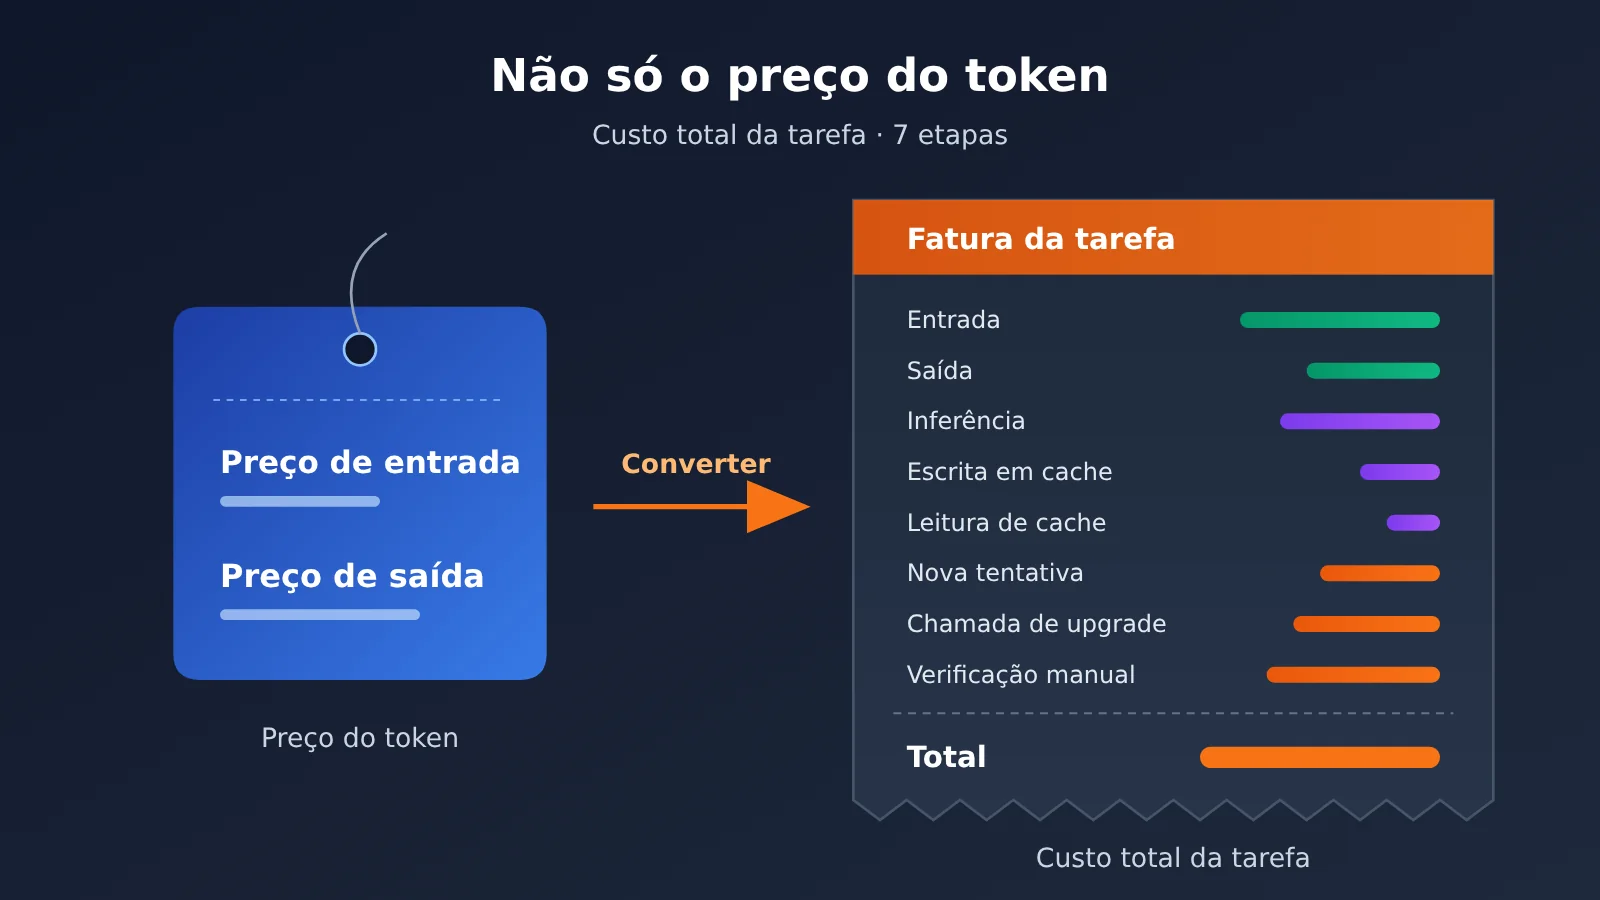
Para estimar o custo total de uma tarefa, primeiro é preciso encarar um fato: a tabela de preços mostra o “preço unitário da matéria-prima”, mas o que você realmente quer saber é o “preço unitário do produto final”. Uma tarefa costuma envolver várias chamadas, diferentes tipos de token e uma série de custos que não são do modelo. A tabela abaixo lista os itens de custo mais comuns.
| Item de custo | Descrição | Por que costuma passar batido |
|---|---|---|
| Tokens de entrada comuns | Comando de sistema, entrada do usuário, contexto recuperado, histórico da conversa | Em conversas de várias rodadas, o histórico é contado repetidamente |
| Tokens de saída | Conteúdo visível retornado pelo modelo | Saídas estruturadas costumam ser mais longas do que o esperado |
| Tokens de raciocínio | Consumo interno de pensamento dos modelos de raciocínio, geralmente cobrado como saída | O usuário não vê, mas aparece na fatura |
| Escrita e leitura de cache | Criação e acerto de cache para prefixos repetidos | As regras de cobrança de escrita e leitura são diferentes das de entrada comum |
| Chamadas de repetição | Nova requisição após timeout, erro de formato ou falha de validação | Quase não aparecem em teste, mas surgem em escala em produção |
| Chamadas de escalonamento | Transferência para um modelo mais forte após falha do modelo menor | A política de roteamento soma o custo das duas chamadas |
| Faixas de contexto longo | Mudança no preço unitário após certo limite de contexto | Só é acionada em poucas requisições com entradas longas, por isso passa fácil |
| Custo de validação humana | Resultados que precisam de conferência ou retrabalho | Não entra na fatura da API, mas existe de verdade |
Detalhes importantes do custo total da tarefa: por que o preço unitário engana
A primeira armadilha vem dos tokens de raciocínio. Modelos de raciocínio consomem um trecho de pensamento interno antes de dar a resposta; essa parte geralmente é cobrada pelo preço unitário de saída, e o tamanho varia conforme a configuração de intensidade de raciocínio. Em discussões públicas, há vários artigos comparando especificamente os níveis high e xhigh de intensidade de raciocínio do mesmo modelo, e todos chegam à mesma conclusão: vale a pena o raciocínio extra depende de quanto a taxa de sucesso da tarefa aumenta, não apenas de o preço unitário ser o mesmo.
A segunda armadilha vem da ideia de que “formato correto não significa resultado correto”. Em extração de texto, o modelo retornar um JSON válido é fácil, mas é preciso verificar se os valores dos campos realmente vêm do texto original e se não houve troca de informações. Se um modelo barato tem uma proporção alta de resultados de extração que precisam de retrabalho humano, o dinheiro economizado na fatura da API provavelmente voltará em dobro no custo de mão de obra.
A terceira armadilha vem do discurso de marketing dos fornecedores. Alguns modelos são lançados anunciando ao mesmo tempo redução do preço unitário por token e “queda no custo da tarefa”, mas as duas coisas não são equivalentes. A queda no custo da tarefa pode vir de uma saída mais curta, de menos repetições ou depender de um uso específico de cache; sua carga de trabalho pode não reproduzir a mesma proporção.
Como estimar o custo total de uma tarefa: guia rápido
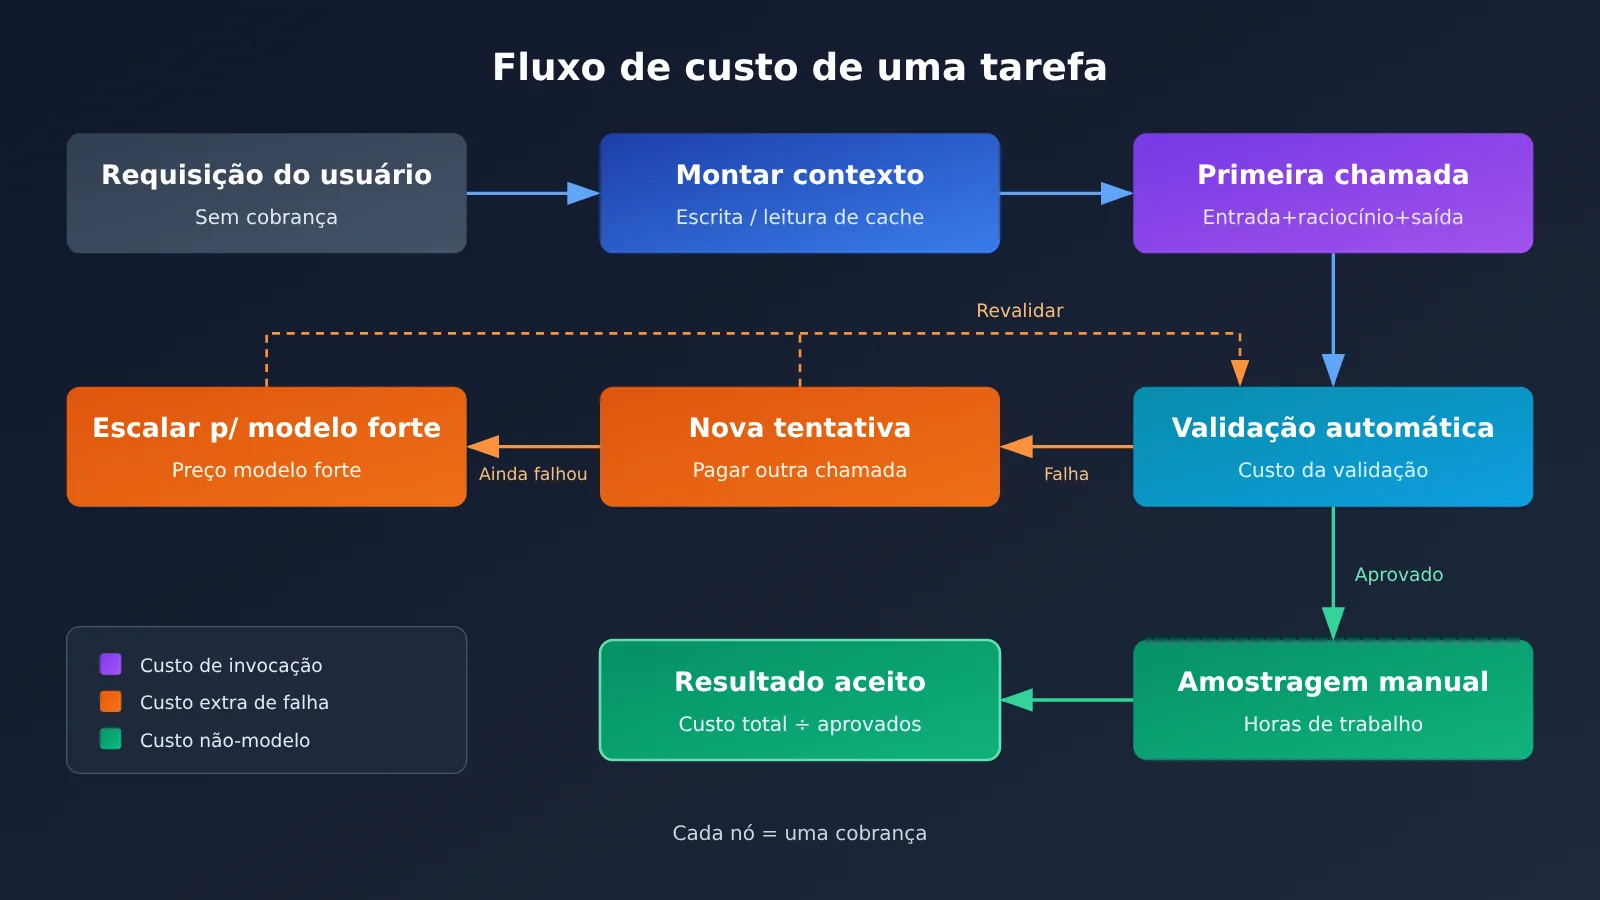
Esse fluxo não exige escrever código: dá para fazer tudo numa planilha. A ideia central é primeiro calcular a estrutura de tokens de uma única chamada, depois multiplicar pelas probabilidades de cada tipo e, por fim, dividir pelo número de resultados aceitos.
Os 7 passos para estimar o custo total de uma tarefa
- Defina a fronteira de “uma tarefa”: por exemplo, “processar um ticket e gerar campos estruturados prontos para gravação”, e não “chamar uma API uma vez”. Fronteiras diferentes levam a bases de custo completamente diferentes.
- Decomponha a estrutura de tokens de uma chamada: registre separadamente o tamanho médio do comando de sistema, do contexto recuperado, da entrada do usuário, da saída visível e dos tokens de raciocínio — de preferência com os valores P50 e P95.
- Marque o que é cacheável: comandos de sistema fixos, definições de ferramentas e exemplos few-shot geralmente podem usar cache. Anote a frequência de escrita em cache e a taxa de acerto estimada.
- Confirme a regra de cobrança: preço unitário de entrada, saída, escrita em cache e leitura de cache, além de verificar se existe escalonamento por contexto longo. Considere os preços reais da página de preços da APIYI em docs.apiyi.com/models.
- Meça a taxa de falha com amostras reais: rode pelo menos um lote representativo de amostras e conte a proporção de falhas de formato, falhas de validação e timeouts, convertendo isso em taxa de retry e taxa de escalonamento.
- Some os custos que não são do modelo: proporção de inspeção manual, tempo de validação por item e, se necessário, converta em valor monetário.
- Calcule o custo “por resultado aceito”: divida o custo total pelo número de resultados que passaram na aceitação final. Esse é o indicador que realmente permite comparar modelos.
Campos da planilha de custo completo da tarefa
Ao transformar os passos acima em uma tabela, recomenda-se incluir pelo menos os campos a seguir. Os nomes dos campos podem ser ajustados conforme o hábito da equipe; o importante é que cada item tenha uma fonte de dados.
| Campo | Significado | Fonte de dados |
|---|---|---|
in_cached |
Número de tokens de entrada que atingiram o cache | campo usage nos logs de chamada |
in_uncached |
Número de tokens de entrada comuns que não atingiram o cache | logs de chamada |
cache_write |
Número de tokens gravados no cache nesta chamada | logs de chamada |
out_visible |
Número de tokens de saída visíveis | logs de chamada |
out_reasoning |
Número de tokens de raciocínio | logs de chamada (apenas para modelos de raciocínio) |
retry_rate |
Proporção que precisa de nova tentativa | estatísticas de testes com amostras |
escalate_rate |
Proporção que precisa ser escalada para um modelo mais forte | logs da política de roteamento |
accept_rate |
Proporção final aceita | validação automática + amostragem manual |
| Preço unitário de cada item | Preço unitário de entrada, saída, gravação em cache e leitura de cache | dados reais da página de preços do APIYI |
🚀 Dica para começar rápido: Se você quiser comparar ao mesmo tempo o custo de tarefa de vários modelos, recomenda-se executar o mesmo conjunto de amostras separadamente no APIYI apiyi.com. A plataforma oferece chamadas de API dos principais modelos abordados neste artigo, compatível com os dois formatos de interface da OpenAI e da Anthropic; para trocar de modelo, basta alterar o nome do modelo, o que facilita a comparação na mesma planilha. Para o modo de integração e o base_url, consulte a documentação do APIYI em docs.apiyi.com.
Exemplo de cálculo completo do custo de uma tarefa
A seguir, usamos uma tarefa de extração de campos de ticket como demonstração. Para evitar o uso de números de preço não verificados, o exemplo fornece apenas a quantidade de tokens e as fórmulas; preencha o preço unitário com os dados reais do modelo correspondente na página de preços da APIYI, docs.apiyi.com/models.
| Etapa | Composição de tokens (média) | Probabilidade de ocorrência | Fórmula de custo |
|---|---|---|---|
| Primeira chamada | Acerto de cache 6,000 + entrada normal 2,000 + saída visível 800 + raciocínio 1,500 | 100% | 6,000 × preço de leitura de cache + 2,000 × preço de entrada + 2,300 × preço de saída |
| Escrita de cache | 6,000 (reescrita após expiração do cache) | Amortizado pela frequência de escrita | 6,000 × preço de escrita de cache ÷ número de requisições cobertas por cada escrita |
| Chamada de nova tentativa | Igual à primeira chamada | 10% | Custo da primeira chamada × 0.1 |
| Chamada de escalonamento | Entrada no modelo forte 8,000 + saída e raciocínio totalizando 2,000 | 5% | Após substituir o preço unitário do modelo forte × 0.05 |
| Inspeção manual por amostragem | Não consome tokens | Amostragem de 5% | Custo humano de verificação por item × 0.05 |
Somando as cinco linhas acima, obtemos o “custo esperado por ticket”. Em seguida, divida pela taxa de aceitação final, por exemplo 95%, e você chega ao “custo por resultado aceito”. Observe que, aqui, a nova tentativa é calculada pelo custo completo da primeira chamada, porque, ao tentar novamente, o contexto geralmente é reenviado exatamente como estava.
Há um fenômeno que vale a pena observar neste exemplo: a saída visível tem apenas 800 tokens, mas os tokens de raciocínio são 1,500; ao cobrar pelo preço unitário de saída, a parte de raciocínio acaba sendo a maior parcela do lado da saída. Se você estimar apenas pela saída visível, o custo do lado da saída será subestimado em mais da metade.
Custo total da tarefa: comparação dos equívocos mais comuns
Para a mesma necessidade, duas abordagens — “olhar só o preço unitário” e “olhar o custo total da tarefa” — frequentemente levam a conclusões opostas na escolha do modelo. A tabela abaixo resume alguns cenários típicos.
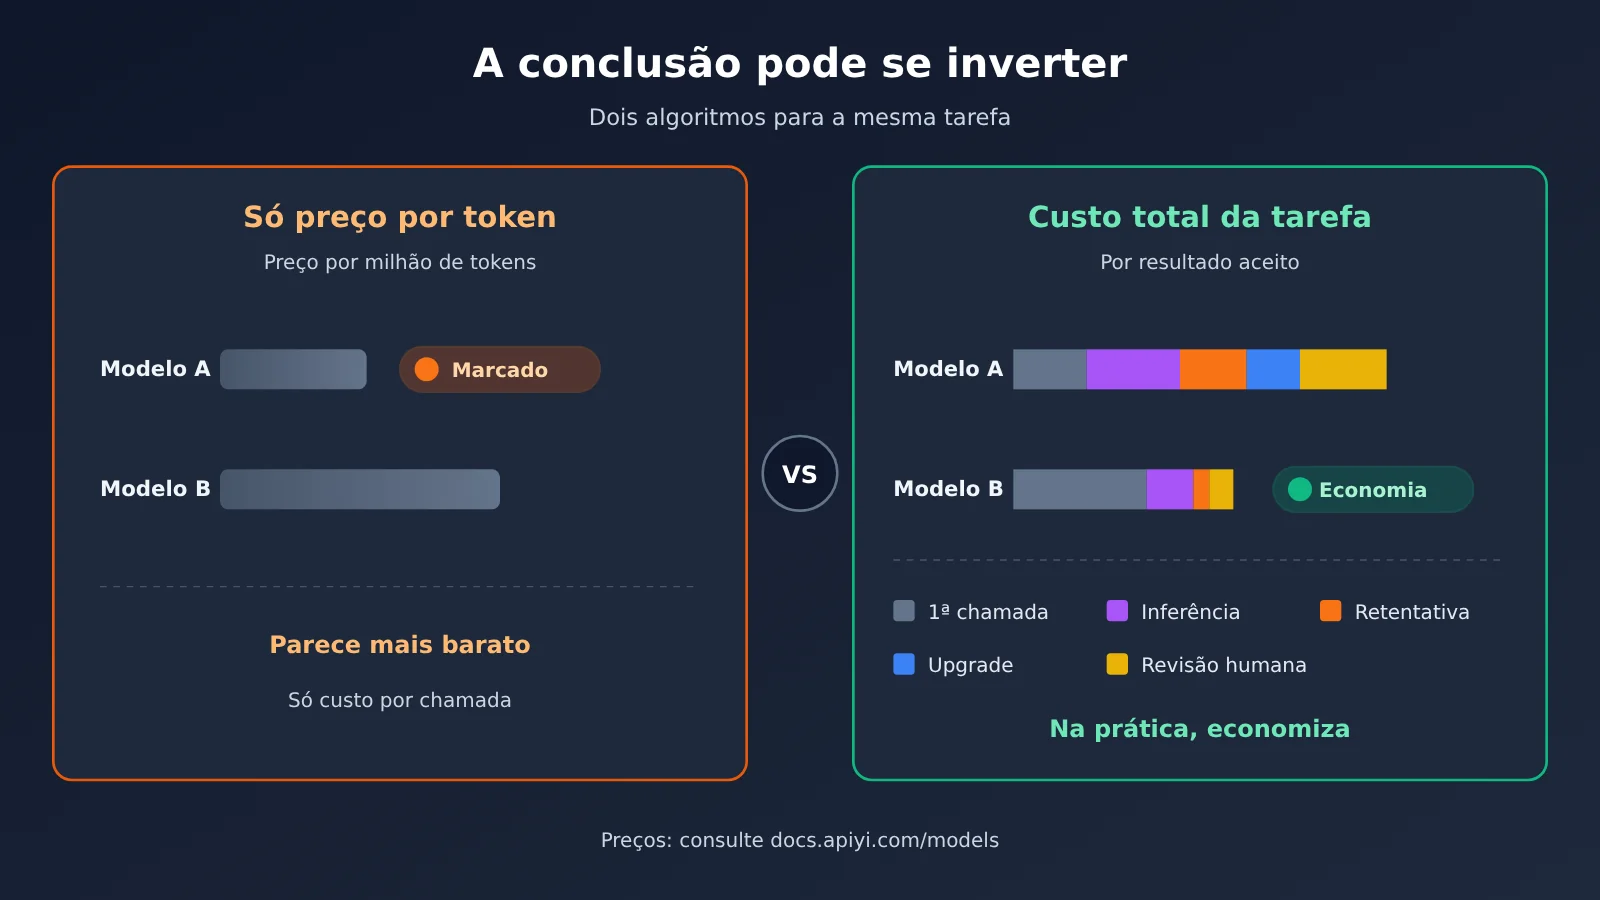
| Cenário | Conclusão olhando só o preço unitário | Conclusão olhando o custo total da tarefa | Variáveis-chave |
|---|---|---|---|
| Extração estruturada | Escolher o modelo leve mais barato | Se a taxa de erro nos campos for alta, um modelo mais forte pode sair mais em conta | Taxa de aceitação, retrabalho manual |
| Agente de código | Escolher o modelo com menor preço de saída | Múltiplas rodadas de chamadas de ferramentas inflam o contexto; a estratégia de cache passa a ser mais decisiva | Taxa de acerto do cache, número de rodadas |
| Análise de documentos longos | Estimar pela média do comprimento de entrada | Poucas requisições muito longas acionam o preço escalonado de contexto longo | Limiar de contexto, comprimento P95 |
| Escolha da intensidade de raciocínio | Como o preço unitário do mesmo modelo é igual, escolher o nível mais alto | Raciocínio alto consome mais tokens; é preciso ver se a taxa de aprovação melhora | Tokens de raciocínio, taxa de aprovação |
| Tarefas em lote offline | Calcular pelo preço unitário de chamada em tempo real | O canal de processamento em lote pode ter regras de cobrança diferentes | Se suporta Batch |
💡 Nota sobre a comparação: as conclusões da tabela são uma dedução metodológica; qual modelo realmente compensa depende da sua amostra. A sugestão é rodar vários modelos com a mesma amostra no APIYI apiyi.com, preencher a tabela com os preços unitários reais da página de preços e só então decidir.
Detalhes de contexto longo e cache no custo total da tarefa
O escalonamento por contexto longo é o item em que mais facilmente ocorre “baixa probabilidade, valor alto”. Materiais públicos mencionam que alguns modelos passam a aplicar um preço unitário diferente quando a entrada ultrapassa determinado limiar (por exemplo, há artigos discutindo o limiar de 272K do GPT-6 Sol). Se a distribuição do comprimento das suas requisições tem cauda longa, é essencial contabilizar separadamente a parcela de requisições que ultrapassa o limiar, em vez de resumir tudo pela média de comprimento.
O cache, por sua vez, é uma faca de dois gumes. A leitura de cache costuma ser mais barata que a entrada normal, mas em alguns fornecedores o preço de escrita no cache pode ser maior que o da entrada comum, e o cache tem prazo de expiração. Se os seus intervalos entre requisições são longos e o prefixo muda com frequência, o custo de escrita pode anular a economia da leitura. Os valores concretos de escrita e leitura de cache e as regras de cobrança devem ser conferidos no que está indicado na página de preços do APIYI, docs.apiyi.com/models.
5 maneiras práticas de reduzir o custo total da tarefa
Depois de fazer as contas direito, o rumo da otimização geralmente também fica claro. As abordagens abaixo funcionam na maioria dos cenários, mas é preciso validar o efeito com a planilha, e não com base na intuição.
| Abordagem | Item de custo afetado | Pontos de atenção |
|---|---|---|
| Prefixo fixo e cache ativado | tokens de entrada | Coloque o conteúdo volátil no final do comando para aumentar a taxa de acerto do cache |
| Limitar formato e comprimento da saída | tokens de saída | Use saída estruturada para restringir os campos e evitar explicações prolixas |
| Roteamento por dificuldade da tarefa | chamadas de escalonamento, tokens de raciocínio | As regras precisam ser claras, e é preciso auditar os “resultados errados aceitos” |
| Validação automática prévia | verificação manual, retrabalho | Valide a origem das evidências, não apenas o formato JSON |
| Controlar a intensidade do raciocínio | tokens de raciocínio | Use a taxa de aprovação para decidir o nível, sem deixar o mais alto como padrão |
Sobre o roteamento, existe um risco frequentemente ignorado: entre os resultados que o modelo pequeno retorna “com sucesso” pode haver erros escondidos, e esses erros não disparam escalonamento. Por isso, ao avaliar uma estratégia de roteamento, além da taxa de escalonamento, é preciso fazer uma amostragem daquela parte dos resultados que o modelo pequeno aprovou diretamente, incorporando ao custo os erros que passaram despercebidos.
Perguntas Frequentes (FAQ)
Q1: O que é o custo total da tarefa?
O custo total da tarefa é o custo completo de concluir uma tarefa com significado de negócio e ter o resultado aceito. Ele inclui os custos de entrada, saída, raciocínio e cache de todas as chamadas, além das despesas com retentativas, escalonamentos e verificação humana — sendo, portanto, mais próximo da fatura real do que o simples preço unitário por token.
Q2: Qual é a diferença entre o custo total da tarefa e o preço unitário por token?
O preço unitário por token é o preço da matéria-prima; o custo total da tarefa é o preço do produto acabado. Um modelo com preço unitário baixo pode ter custo total da tarefa maior se exigir mais retentativas, raciocínio mais longo ou mais retrabalho humano; já um modelo com preço unitário alto pode sair mais em conta se tiver alta taxa de acerto na primeira tentativa.
Q3: Quantas amostras são necessárias, no mínimo, para estimar o custo total da tarefa?
Não há um número fixo — o essencial é que as amostras cubram a distribuição real, especialmente entradas longas, casos difíceis e situações de fronteira. Com poucas amostras, as taxas de retentativa e de aceitação oscilam muito; recomenda-se estimar primeiro com um lote pequeno e depois corrigir com logs reais no início da operação.
Q4: Em quais cenários é mais necessário calcular o custo total da tarefa?
Principalmente nos seguintes casos:
– **Extração de dados estruturados**: quando erros de campo exigem correção manual, o custo humano tem peso elevado
– **Agente de codificação**: múltiplas rodadas de chamadas de ferramentas fazem a janela de contexto crescer rapidamente
– **Perguntas e respostas sobre documentos longos**: requisições de cauda longa podem acionar preços escalonados de contexto longo
– **Roteamento entre múltiplos modelos**: chamadas de escalonamento somam duas vezes os custos
Q5: Como obter rapidamente o preço unitário e os critérios de cobrança de cada modelo?
Recomenda-se consultar diretamente a página de preços do APIYI em docs.apiyi.com/models, que lista os preços unitários de entrada, saída e cache dos modelos suportados pela plataforma; para estimativas, use os dados reais dessa página como referência. O APIYI é compatível com os formatos de interface da OpenAI e da Anthropic; após concluir a integração conforme a documentação em docs.apiyi.com, você pode testar vários modelos com o mesmo lote de amostras e preencher diretamente na planilha os dados de usage dos logs de chamadas.
Q6: É possível comparar diretamente o consumo de produtos por assinatura com a cobrança por API?
Não é recomendável comparar diretamente. Produtos por assinatura geralmente são limitados por cota ou número de usos, enquanto a API cobra por token — as unidades de medida e os cenários de aplicação são diferentes. Se for necessário comparar, é preciso primeiro converter o volume real de tarefas disponíveis na assinatura, sem presumir uma quantidade fixa de mensagens.
Q7: Quais são as limitações da estimativa de custo total da tarefa?
Ela depende da representatividade das amostras; amostras muito simples subestimam o custo. A conversão do custo de verificação humana também tem subjetividade e varia muito entre equipes. Além disso, os preços unitários dos modelos e as regras de cobrança podem mudar, então a planilha precisa ser atualizada periodicamente com os preços e logs mais recentes, em vez de ser calculada uma vez e reutilizada por muito tempo.
Custo total da tarefa — pontos-chave (Key Takeaways)
- Mude a unidade de comparação: compare modelos pelo “custo por resultado aceito”, não pelo preço por milhão de tokens
- Tokens de raciocínio precisam ser contados à parte: eles normalmente são cobrados como saída e podem ultrapassar a saída visível
- Cache envolve escrita e leitura: a escrita pode custar mais caro que a entrada comum, e a taxa de acerto é o que define se compensa
- Retentativas e escalonamento são o grande custo oculto: em produção, a taxa de falha costuma ser maior do que a observada nos testes
- JSON válido não significa dado correto: valide a origem das evidências e inclua o retrabalho manual no custo
- Contexto longo é uma questão de cauda longa: use o comprimento P95 para verificar se você cai na faixa de preço escalonada
- O preço unitário vem da página de preços: na hora de estimar, consulte sempre os dados reais na página de preços da APIYI, docs.apiyi.com/models
Resumo
Os pontos centrais para estimar o custo total de uma tarefa:
- Defina primeiro a fronteira da tarefa: a unidade é o resultado de negócio, não a chamada individual
- Decomponha todos os itens de custo: entrada, saída, raciocínio, cache, retentativas, escalonamento e validação humana — nenhum pode faltar
- Meça as probabilidades com amostras reais: as taxas de retentativa, escalonamento e aceitação determinam o multiplicador do custo final
Dizer “não olhe só o preço por token” não quer dizer que o preço unitário não importa, e sim que ele é apenas uma variável da fórmula. Monte a planilha e preencha com suas próprias amostras e logs: a conclusão de escolha do modelo será mais confiável do que qualquer ranking.
Recomendo usar a APIYI (apiyi.com) para comparar vários modelos com o mesmo lote de amostras e, junto com os preços unitários reais da página de preços docs.apiyi.com/models, calcular o custo total da tarefa. A plataforma é compatível com os formatos de interface da OpenAI e da Anthropic, então o custo de trocar de modelo é muito baixo.
📚 Referências
- Série de artigos do blog Ofox.ai sobre precificação de modelos e custo por tarefa: vários artigos discutem a relação entre cobrança de cache, limiares de contexto longo, intensidade de raciocínio e custo por tarefa
- Link:
ofox.ai/blog/page/12 -
Descrição: útil para entender a diferença entre “redução do preço unitário” e “queda no custo da tarefa”
-
Artigo do blog Ofox.ai sobre roteamento de modelos e extração estruturada: discute regras de escalonamento de modelos pequenos para modelos mais fortes, além de “JSON válido não significa dados corretos”
- Link:
ofox.ai/blog/page/11 -
Descrição: boa referência ao projetar estratégias de roteamento e fluxos de validação
-
Página de preços de modelos da APIYI: preços unitários de entrada, saída e relacionados a cache dos modelos suportados pela plataforma
- Link:
docs.apiyi.com/models -
Descrição: todo o conteúdo deste artigo referente a preços e critérios de cobrança tem como base os dados reais desta página
-
Central de documentação da APIYI: formas de integração, formatos de interface e descrição de parâmetros
- Link:
docs.apiyi.com - Descrição: inclui instruções de integração nos formatos compatíveis com OpenAI e Anthropic
Autor: Equipe de tecnologia da APIYI
Contato técnico: fique à vontade para falar conosco pela página inicial do site oficial da APIYI, apiyi.com; há mais materiais de integração disponíveis na central de documentação em docs.apiyi.com