著者注:入力・出力・推論・キャッシュ・リトライから検証とアップグレードまで、7つのステップで「100万トークンあたりいくらか」を「1回のタスク完了あたりいくらか」に換算します。
多くのチームがモデルを選ぶとき、まず目にするのは価格表の入力単価と出力単価で、「こちらのほうが半分安い」という結論を出します。しかしリリースから1か月後に請求書を見ると、安いはずのモデルがコストを抑えられておらず、むしろ高くついていることも少なくありません。本記事では、「1回の受理されたタスク」を単位とするコスト見積もり手法を紹介し、トークン単価の裏側にあるコストを明らかにします。
これは高価なモデルを勧める記事ではありません。安価なモデルが多くの場面で本当に割安になるのは事実です。問題は、リトライ・推論トークン・キャッシュ・人手による検証まで含めて計算しなければ、それが本当に割安かどうかを判断できないという点にあります。
核心的な価値:本記事を読み終えるころには、再利用可能なタスクコストのワークシートが手に入り、どんなデータを集めればよいか、どう計算式に当てはめればよいか、そしてどの工程が見落とされやすいかが分かるようになります。
タスク全体コストの核心ポイント
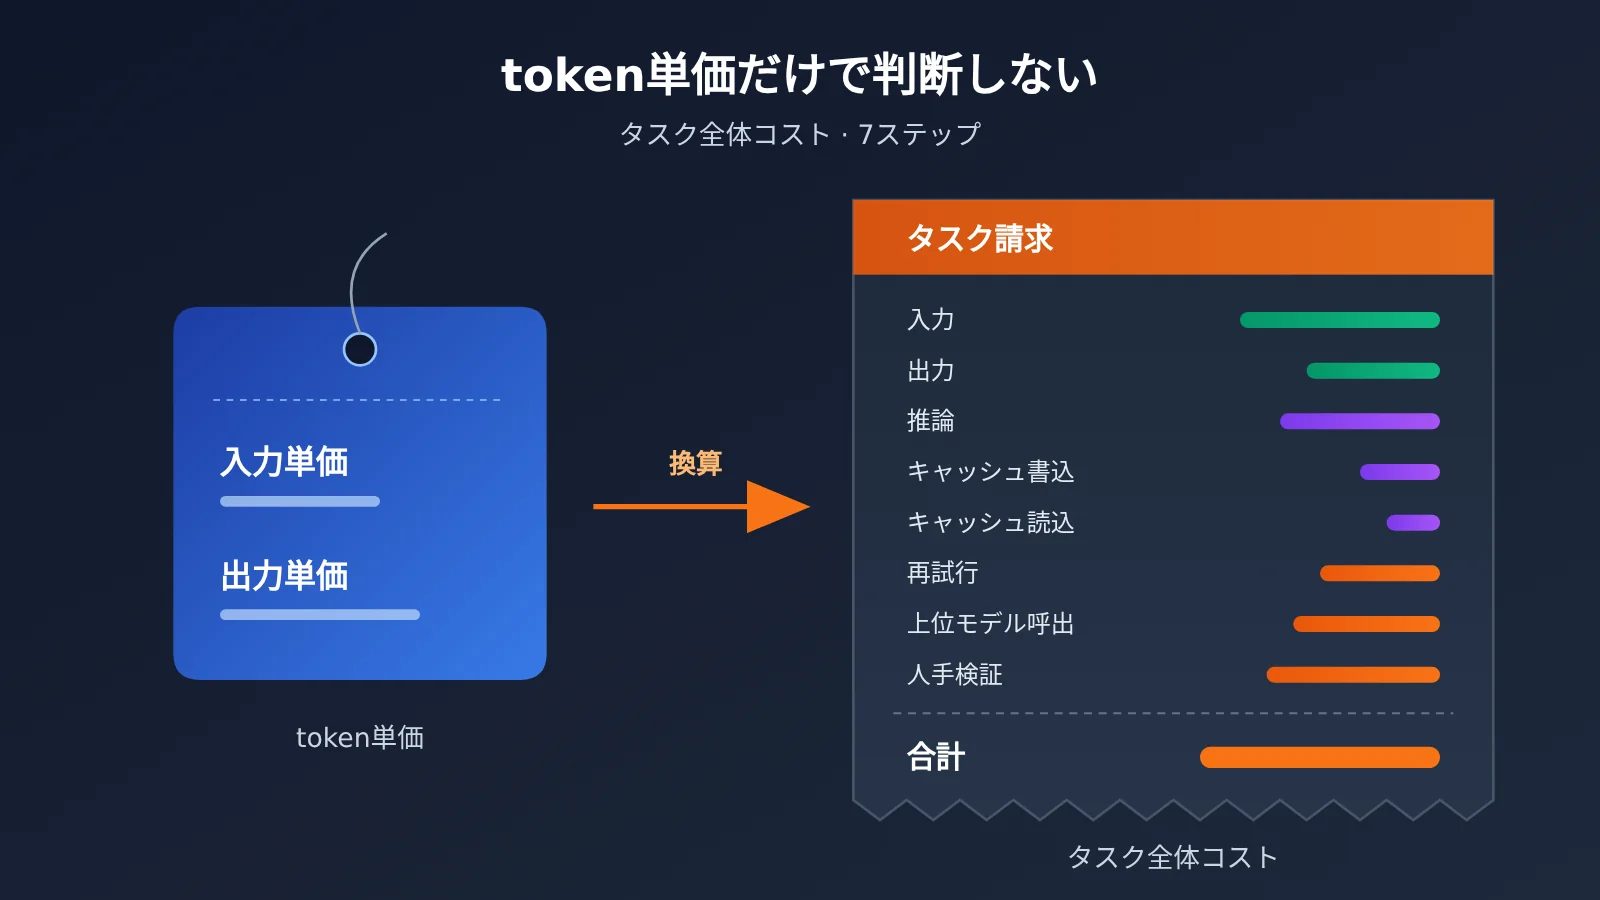
タスク全体のコストを見積もるには、まず1つの事実を認める必要があります。料金表が示すのは「原材料の単価」であり、本当に知りたいのは「完成品の単価」だということです。1回のタスクは多くの場合、複数回の呼び出し、複数種類のトークン、いくつかのモデル以外のコストで構成されます。次の表に、最も一般的なコスト項目を挙げます。
| コスト項目 | 説明 | 見落とされやすい理由 |
|---|---|---|
| 通常入力トークン | システムプロンプト、ユーザー入力、検索コンテキスト、履歴対話 | マルチターン対話では履歴が繰り返し計上される |
| 出力トークン | モデルが最終的に返す可視コンテンツ | 構造化出力は想定より長くなりがち |
| 推論トークン | 推論系モデルが内部で思考する際の消費。通常は出力として課金 | ユーザーには見えないが請求書には現れる |
| キャッシュの書き込みと読み取り | 繰り返し現れるプレフィックスのキャッシュ作成とヒット | 書き込みと読み取りで課金基準が通常入力と異なる |
| 再試行呼び出し | タイムアウト、形式エラー、検証失敗後の再リクエスト | テスト時にはほとんど発生せず、本番運用後に規模化して現れる |
| 昇格呼び出し | 小規模モデルの失敗後に、より強力なモデルへ引き継ぐ | ルーティング戦略により2回分の呼び出しコストが重なる |
| 長いコンテキストの段階料金 | あるコンテキスト閾値を超えると単価が変わる | 少数の長い入力リクエストでのみ発生するため見落としやすい |
| 人手による検証コスト | 結果を人が確認したり作り直したりする | API請求額には含まれないが、実在する |
タスク全体コストの重点解説:なぜ単価は誤解を招くのか
最初の誤解は推論トークンから生まれます。推論系モデルは回答を出す前に内部思考を一定量消費し、この部分は通常、出力の単価で課金されます。しかも長さは推論強度の設定によって変わります。公開討論では、同じモデルの high と xhigh という2段階の推論強度を比較する記事が少なくありませんが、結論はいずれも同じ点を指摘しています。増えた推論に見合う価値があるかどうかは、単価が同じかどうかではなく、タスクの通過率がどれだけ向上したかで判断すべきです。
2つ目の誤解は「形式が正しいことは、結果が正しいことを意味しない」という点です。テキスト抽出では、モデルが有効な JSON を返すのは簡単ですが、フィールドの値が本当に原文由来なのか、取り違えがないのかは別途検証する必要があります。安価なモデルの抽出結果の高い割合で人手による作り直しが必要なら、API請求額で節約した金額は、人件費として倍返しになる可能性が高いです。
3つ目の誤解はベンダーの宣伝表現から生まれます。モデル発表時に、トークン単価の引き下げと「タスクコストの低下」を同時にうたうことがありますが、この2つは等価ではありません。タスクコストの低下は、出力長の短縮や再試行の減少による場合もあれば、特定のキャッシュ利用方法に依存する場合もあります。あなたのワークロードで同じ比率を再現できるとは限りません。
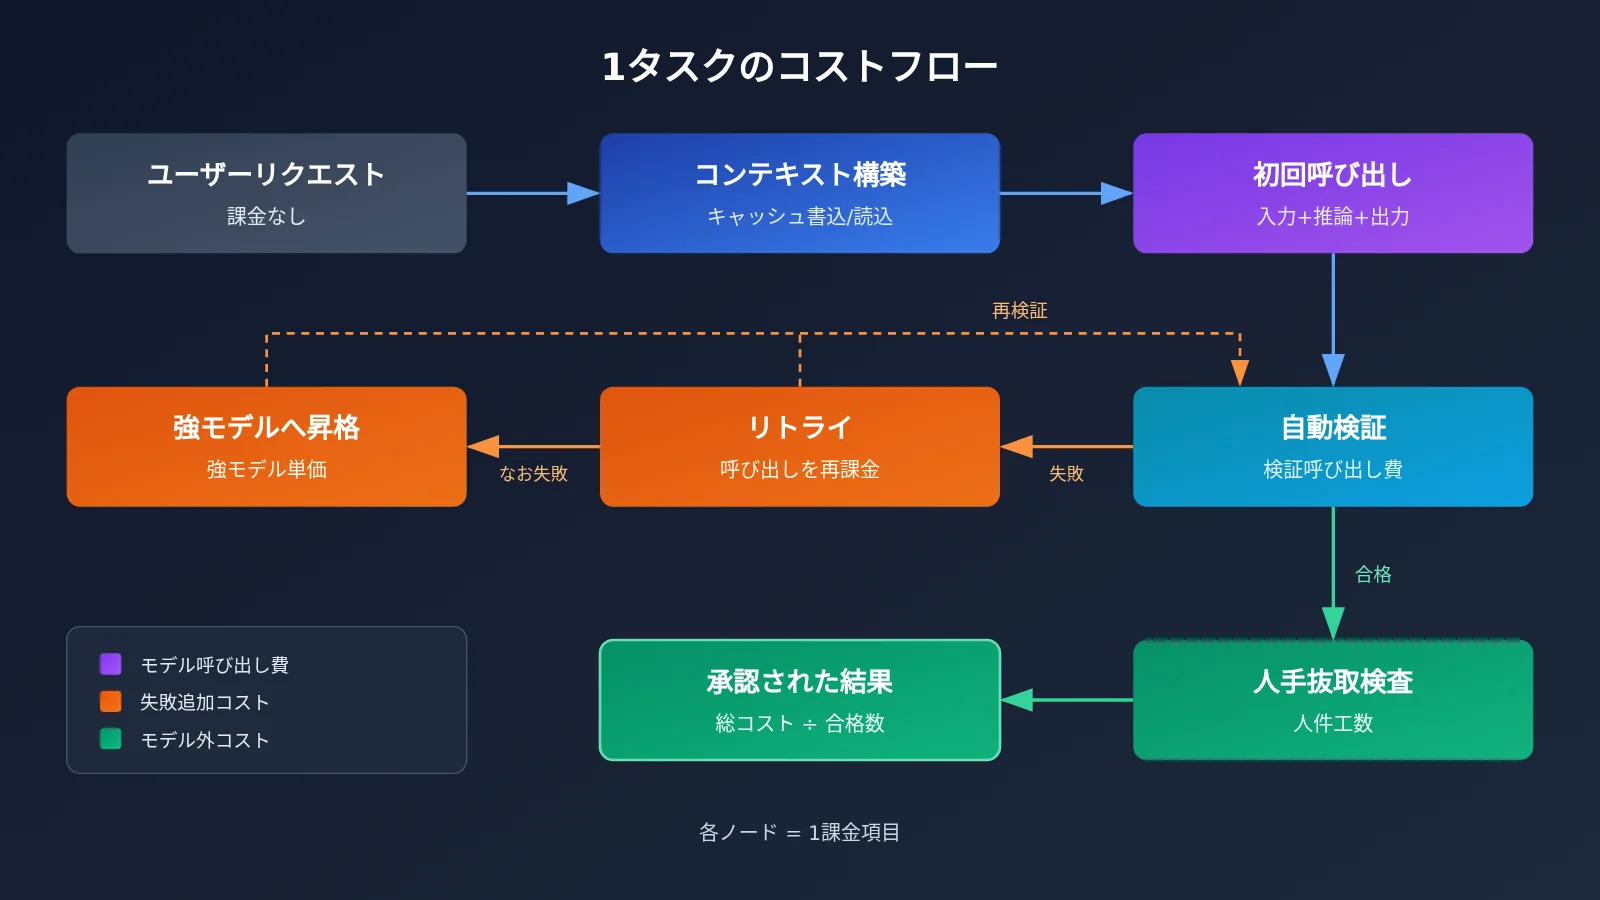
1回のタスクにかかる全体コストを見積もる方法 クイックスタート
以下の手順はコードを書かずに、表計算ソフト1つで完了できます。考え方はシンプルです。まず1回の呼び出しにおけるトークン構成を算出し、次に各種の確率を掛け合わせ、最後に受け入れられた結果の件数で割ります。
タスク全体のコストを見積もる7つのステップ
- 「1回のタスク」の境界を定義する:たとえば「1件のチケットを処理し、データベースに登録できる構造化フィールドを出力する」ことであり、「APIを1回呼び出す」ことではありません。境界の取り方によって、コストの算定基準はまったく変わります。
- 1回の呼び出しにおけるトークン構成を分解する:システムプロンプト、検索コンテキスト、ユーザー入力、可視出力、推論トークンの平均長をそれぞれ記録します。P50とP95の2つの値で測るのがおすすめです。
- キャッシュ可能な部分を洗い出す:固定のシステムプロンプト、ツール定義、少数ショット例は通常キャッシュを利用できます。キャッシュ書き込み頻度と推定ヒット率を記録しましょう。
- 課金仕様を確認する:入力、出力、キャッシュ書き込み、キャッシュ読み取りの単価、およびロングコンテキストの段階料金の有無を確認します。すべての単価はAPIYIの価格ページ docs.apiyi.com/models の実際のデータを基準にしてください。
- 実際のサンプルで失敗率を測る:少なくとも代表的なサンプル群を1バッチ実行し、フォーマット失敗、検証失敗、タイムアウトの割合を集計して、リトライ率とエスカレーション率に換算します。
- モデル以外のコストを加える:人手による抜き取り検査の割合、1件あたりの検証時間を考慮し、必要に応じて金額に換算します。
- 「受け入れられた結果1件あたり」のコストを計算する:総コストを最終検収に合格した結果の件数で割ります。これこそが、モデル比較に使える指標です。
タスク完全コストワークシートのフィールド
これまでのステップを表に落とし込みましょう。少なくとも以下のフィールドを含めることをおすすめします。フィールド名はチームの習慣に合わせて調整してかまいませんが、重要なのは各項目にデータソースがあることです。
| フィールド | 意味 | データソース |
|---|---|---|
in_cached |
キャッシュにヒットした入力トークン数 | 呼び出しログの usage フィールド |
in_uncached |
キャッシュにヒットしなかった通常の入力トークン数 | 呼び出しログ |
cache_write |
今回キャッシュに書き込んだトークン数 | 呼び出しログ |
out_visible |
可視出力トークン数 | 呼び出しログ |
out_reasoning |
推論トークン数 | 呼び出しログ(推論モデルのみ) |
retry_rate |
リトライが必要な割合 | サンプルテストの統計 |
escalate_rate |
強力なモデルへのエスカレーションが必要な割合 | ルーティングポリシーのログ |
accept_rate |
最終的に採用された割合 | 自動検証+人手によるサンプリング検査 |
| 各単価 | 入力、出力、キャッシュ書き込み、キャッシュ読み取りの単価 | APIYI の価格ページの実データ |
🚀 クイックスタートのヒント:複数のモデルのタスクコストを同時に比較したい場合は、APIYI apiyi.com 上で同じサンプルセットをそれぞれ実行してみることをおすすめします。プラットフォームでは本記事で扱う主要モデルの API 呼び出しを提供しており、OpenAI と Anthropic の2種類のインターフェース形式に対応しています。モデルを切り替えるときはモデル名を変更するだけで、同じワークシート上で比較できます。接続方法と base_url は APIYI のドキュメント docs.apiyi.com を参照してください。
タスク全体のコスト計算例
ここでは、チケットのフィールド抽出タスクを例に説明します。検証されていない価格数値を使わないよう、この例ではトークン量と計算式のみを示します。単価には、APIYI の価格ページ docs.apiyi.com/models に記載されている該当モデルの実際のデータを入れてください。
| 段階 | トークンの構成(平均値) | 発生確率 | コスト計算式 |
|---|---|---|---|
| 初回呼び出し | キャッシュヒット 6,000 + 通常入力 2,000 + 可視出力 800 + 推論 1,500 | 100% | 6,000×キャッシュ読み取り単価 + 2,000×入力単価 + 2,300×出力単価 |
| キャッシュ書き込み | 6,000(キャッシュ失効後に再書き込み) | 書き込み頻度に応じて按分 | 6,000×キャッシュ書き込み単価 ÷ 1回の書き込みでカバーできるリクエスト数 |
| リトライ呼び出し | 初回呼び出しと同じ | 10% | 初回呼び出しコスト × 0.1 |
| エスカレーション呼び出し | 強力なモデルへの入力 8,000 + 出力と推論の合計 2,000 | 5% | 強力なモデルの単価を代入したうえで × 0.05 |
| 人手による抜き取り検査 | トークンを消費しない | 抜き取り 5% | 1件あたりの検証にかかる人件費 × 0.05 |
上記の5行を合計すると、「チケット1件あたりの期待コスト」が得られます。さらに、それを最終的な採用率(たとえば 95%)で割ると、「採用された結果1件あたりのコスト」が得られます。ここではリトライを初回呼び出しの全コストで計算している点に注意してください。リトライ時には、通常はコンテキストがそのまま再送されるためです。
この例には注目すべき現象があります。可視出力はわずか 800 トークンですが、推論トークンは 1,500 あり、出力単価で課金する場合、推論部分が出力側の大部分を占めます。可視出力だけから見積もると、出力側のコストは半分以上も過小評価されてしまいます。
タスク全体コスト よくある誤解との比較
同じ要件でも、「単価だけを見る」考え方と「タスク全体コストを見る」考え方では、しばしば逆の選定結論になります。次の表は、いくつかの典型的なシナリオをまとめたものです。
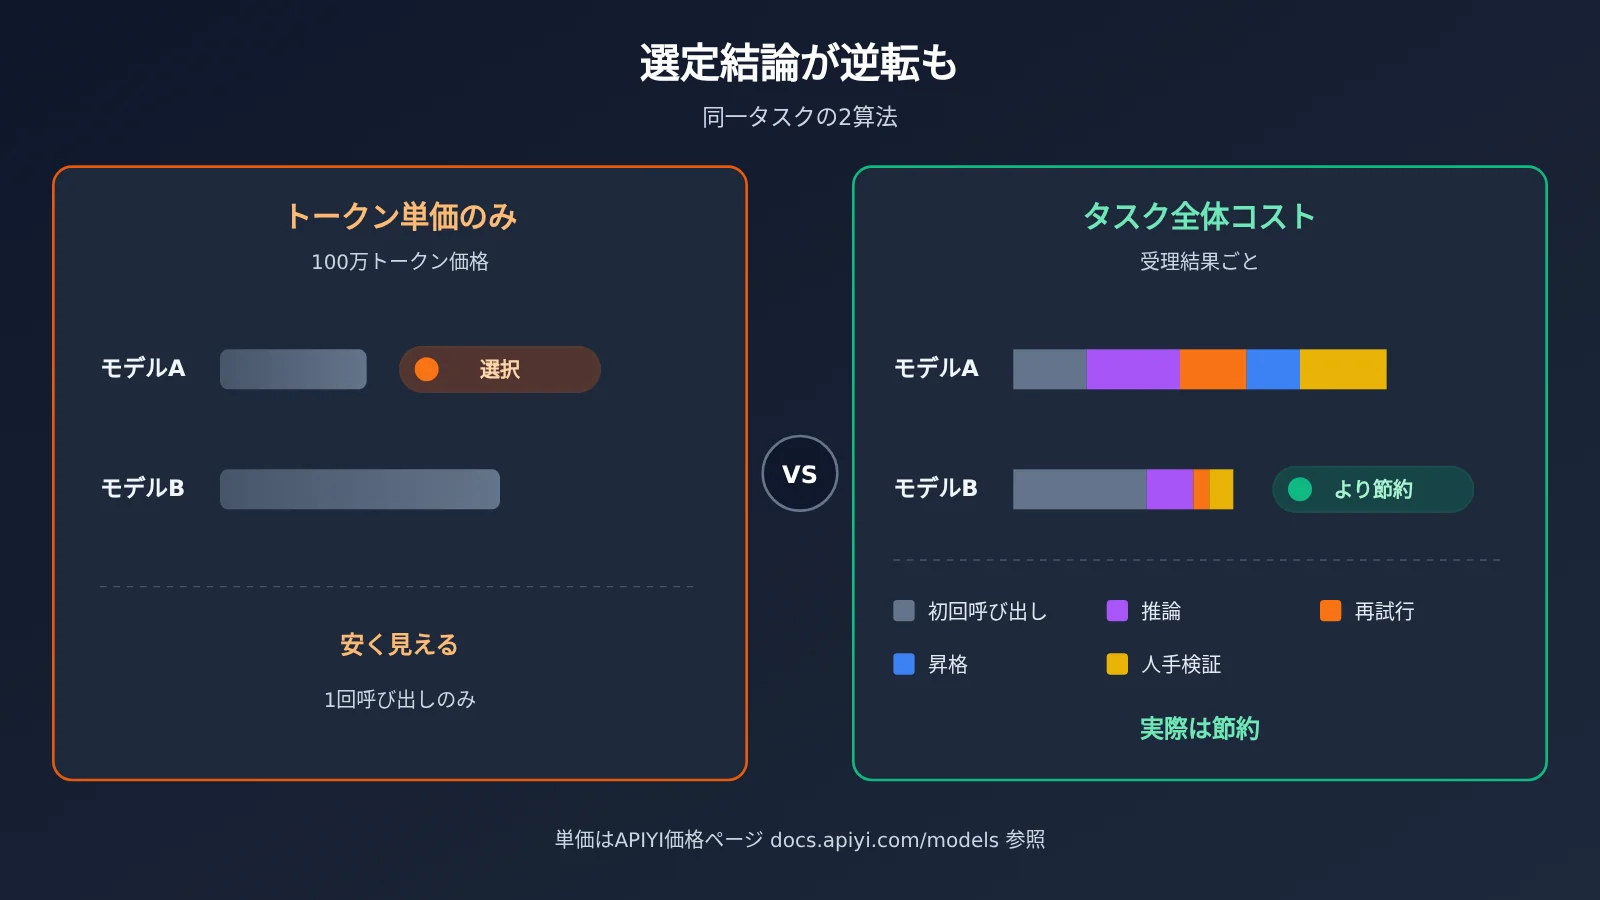
| シナリオ | 単価だけを見た結論 | タスク全体コストで見た結論 | 主要な変数 |
|---|---|---|---|
| 構造化抽出 | 最も安い軽量モデルを選ぶ | フィールドの誤り率が高いなら、高性能モデルのほうがかえって安くつく可能性がある | 受容率、人手による手戻り |
| コーディングAgent | 出力単価の低いモデルを選ぶ | マルチターンのツール呼び出しでコンテキストが膨張するため、キャッシュ戦略のほうが重要になる | キャッシュヒット率、ターン数 |
| 長文書分析 | 平均入力長で見積もる | ごく少数の超長いリクエストが長コンテキストの段階価格を発動させる | コンテキスト閾値、P95長 |
| 推論強度の選択 | 同じモデルなら単価は同じなので最上位を選ぶ | 上位の推論はトークン数が増えるため、通過率が上がるかどうかを見る必要がある | 推論トークン、通過率 |
| バッチオフラインタスク | リアルタイム呼び出しの単価で計算する | バッチ処理チャネルでは課金体系が異なる場合がある | Batchサポートの有無 |
💡 比較のポイント:表の結論は方法論レベルの推論であり、実際にどのモデルがお得かはあなたのサンプル次第です。APIYI apiyi.com 上で同じサンプルを使って複数モデルを実行し、価格ページの実際の単価を当てはめて表を埋めたうえで判断することをおすすめします。
タスク全体コストにおける長コンテキストとキャッシュの詳細
長コンテキストの段階価格は、最も「低確率・高額」になりやすい項目です。公開情報によれば、一部のモデルでは入力が一定の閾値(たとえば GPT-6 Sol の 272K 閾値を論じた記事もあります)を超えると、異なる単価が適用されます。リクエスト長の分布にロングテールがあるなら、平均長でひとまとめにせず、閾値を超えるリクエストを必ず個別に集計してください。
キャッシュは諸刃の剣でもあります。キャッシュ読み取りは通常の入力より安いことが多い一方、一部のベンダーではキャッシュ書き込みの単価が通常入力より高く、しかもキャッシュには有効期限があります。リクエストの間隔が長く、プレフィックスが頻繁に変わる場合、書き込みコストが読み取りによる節約分を打ち消してしまうかもしれません。キャッシュの書き込み価格・読み取り価格・課金の考え方については、APIYI の価格ページ docs.apiyi.com/models の記載を基準にしてください。
タスク完了コストを下げる5つの実践的手法
コストを正確に算出できれば、最適化の方向性もおのずと見えてきます。以下に紹介する手法は多くの場面で有効ですが、感覚に頼らず、ワークシートで効果を検証することが大切です。
| 手法 | 影響するコスト項目 | 注意点 |
|---|---|---|
| 固定プレフィックスの設定とキャッシュの有効化 | 入力トークン | 変わりやすい内容はプロンプトの末尾に置き、キャッシュのヒット率を高める |
| 出力フォーマットと長さの制限 | 出力トークン | 構造化出力でフィールドを制約し、冗長な説明を避ける |
| タスク難易度に応じたルーティング | アップグレード呼び出し、推論トークン | ルールを明確にし、「受け入れられた誤った結果」を監査する |
| 事前の自動検証 | 人手による検証、手戻り | JSON 形式だけでなく、根拠の出所まで検証する |
| 推論強度の制御 | 推論トークン | 合格率でレベルを決め、デフォルトで最高設定にしない |
ルーティングについては、見落とされがちなリスクが1つあります。小規模モデルが「成功」として返した結果の中に誤りが潜んでいることがあり、しかもそうした誤りはアップグレードを引き起こしません。そのためルーティング戦略を評価する際は、アップグレード率だけでなく、小規模モデルがそのまま通過させた結果の一部を抜き取り検査し、見逃された誤りをコストに換算して織り込む必要があります。
よくある質問(FAQ)
Q1:タスク完全コストとは何ですか?
タスク完全コストとは、ビジネス上の意味を持つタスクを1回完了し、その結果が受け入れられるまでにかかったすべてのコストを指します。すべての呼び出しにおける入力・出力・推論・キャッシュの費用に加え、リトライ、エスカレーション、人手による検証のコストも含まれます。単純なtoken単価よりも、実際の請求額に近い指標です。
Q2:タスク完全コストとtoken単価の違いは何ですか?
token単価は原材料の価格、タスク完全コストは完成品の価格です。単価が安いモデルでも、リトライが増えたり、推論が長くなったり、人手による手直しが増えれば、タスク完全コストはかえって高くなる可能性があります。逆に単価が高いモデルでも、一発で通る確率が高ければ、むしろ安く済むことがあります。
Q3:タスク完全コストを見積もるには、最低どれくらいのサンプルが必要ですか?
決まった数字はありません。重要なのは、サンプルが実際の分布をカバーしていることで、特に長い入力、難しい例、境界ケースを含めることが大切です。サンプルが少なすぎるとリトライ率や受け入れ率が大きく変動するため、まず小規模なバッチで概算し、リリース初期に実際のログで補正することをおすすめします。
Q4:どのようなシーンでタスク完全コストを計算する必要がありますか?
主に以下のようなケースが挙げられます。
– **構造化データ抽出**:フィールドの誤りを人手で修正する必要がある場合、人件費の割合が高くなります
– **コーディングAgent**:複数ラウンドのツール呼び出しによってコンテキストが急速に増加します
– **長文書の質問応答**:ロングテールのリクエストが長いコンテキストの段階料金を引き起こす可能性があります
– **マルチモデルルーティング**:エスカレーション呼び出しで2回分の費用が重なります
Q5:各モデルの単価と課金ルールを素早く確認するには?
APIYIの料金ページ docs.apiyi.com/models を直接確認することをおすすめします。ここにはプラットフォームが対応しているモデルの入力・出力・キャッシュ関連の単価が掲載されています。見積もりの際は、このページの実際のデータを基準にしてください。APIYIはOpenAIおよびAnthropicのインターフェース形式に互換性があります。ドキュメント docs.apiyi.com に沿って接続を完了すれば、同じサンプルセットで複数のモデルをテストし、呼び出しログのusageデータをそのままワークシートに記入できます。
Q6:サブスクリプション型製品の利用量とAPI課金は、同じ土俵で比較できますか?
直接比較することはおすすめしません。サブスクリプション型製品は通常、枠や利用回数の制限で提供され、APIはtokenで課金されるため、両者の計量単位や適用シーンは異なります。比較する場合は、サブスクリプションで実際に利用可能なタスク量を換算する必要があり、固定のメッセージ数を前提にしてはいけません。
Q7:タスク完全コストの見積もりには、どのような限界がありますか?
サンプルの代表性に依存するため、サンプルが簡単な例に偏るとコストを過小評価してしまいます。人手による検証コストの換算にも主観が入り、チームによって大きく異なります。また、モデルの単価や課金ルールは変更される可能性があるため、ワークシートは一度計算したら長期間そのまま使うのではなく、最新の価格とログで定期的に更新する必要があります。
タスクのトータルコスト 重要なポイント Key Takeaways
- 比較の単位を変える:モデルの比較は「100万トークンあたりの単価」ではなく、「受け入れられた結果1件あたりのコスト」で行う
- 推論トークンは必ず別項目で記録する:通常は出力として課金され、しかも可視出力を超えることがある
- キャッシュは書き込みと読み取りの両方を計算する:書き込みは通常の入力より高価な場合があり、ヒット率が採算を左右する
- リトライとアップグレードは隠れた主要コスト:本番稼働後の失敗率は、テスト時に観測される値より高くなりがち
- 有効なJSONは正しいデータとは限らない:根拠の出所を検証し、人手による手戻りもコストに算入する
- 長いコンテキストではロングテールに注目する:P95の長さで段階料金に該当するか確認する
- 単価は価格ページを正とする:見積もり時はAPIYIの価格ページ docs.apiyi.com/models の実データを統一して確認する
まとめ
タスクのトータルコストを見積もる核心ポイント:
- まずタスクの境界を定義する:単一の呼び出し単位ではなく、業務上の成果を単位とする
- すべてのコスト項目を分解する:入力、出力、推論、キャッシュ、リトライ、アップグレード、人手検証を漏れなく含める
- 実際のサンプルで確率を測る:リトライ率、アップグレード率、採用率が最終コストの倍率を決める
「トークン単価だけを見るな」とは、単価が重要でないという意味ではありません。単価は計算式の中の一つの変数にすぎません。ワークシートを組み立て、自分のサンプルとログで埋めていけば、モデル選定の結論はどんなランキングよりも信頼できるものになります。
APIYI apiyi.com で同じサンプル群を使って複数モデルを比較し、価格ページ docs.apiyi.com/models の実際の単価と合わせてタスクコストを試算することをおすすめします。プラットフォームはOpenAIとAnthropicのAPI形式に対応しており、モデル切り替えのコストは非常に低く抑えられます。
📚 参考資料
- Ofox.ai Blog モデル価格とタスクコストの連載記事:キャッシュ課金、長コンテキストのしきい値、推論強度とタスクコストの関係を論じた複数の記事
- リンク:
ofox.ai/blog/page/12 -
説明: 「単価の引き下げ」と「タスクコストの低下」の違いを理解するのに最適です
-
Ofox.ai Blog モデルルーティングと構造化抽出の記事:小型モデルから強力モデルへの切り替えルール、そして「有効な JSON が正しいデータとは限らない」という点を論じています
- リンク:
ofox.ai/blog/page/11 -
説明: ルーティング戦略や検証フローを設計する際の参考にどうぞ
-
APIYI モデル価格ページ:プラットフォームが対応するモデルの入力・出力・キャッシュ関連の単価
- リンク:
docs.apiyi.com/models -
説明: 本記事における価格と課金基準に関する内容は、すべてこのページの実際のデータに準拠しています
-
APIYI ドキュメントセンター:接続方法、インターフェース形式、パラメータの説明
- リンク:
docs.apiyi.com - 説明: OpenAI および Anthropic 互換形式の接続方法を掲載しています
作者:APIYI 技術チーム
技術交流:APIYI 公式サイト apiyi.com のトップページからお気軽にお問い合わせください。接続に関する資料はドキュメントセンター docs.apiyi.com でもご覧いただけます