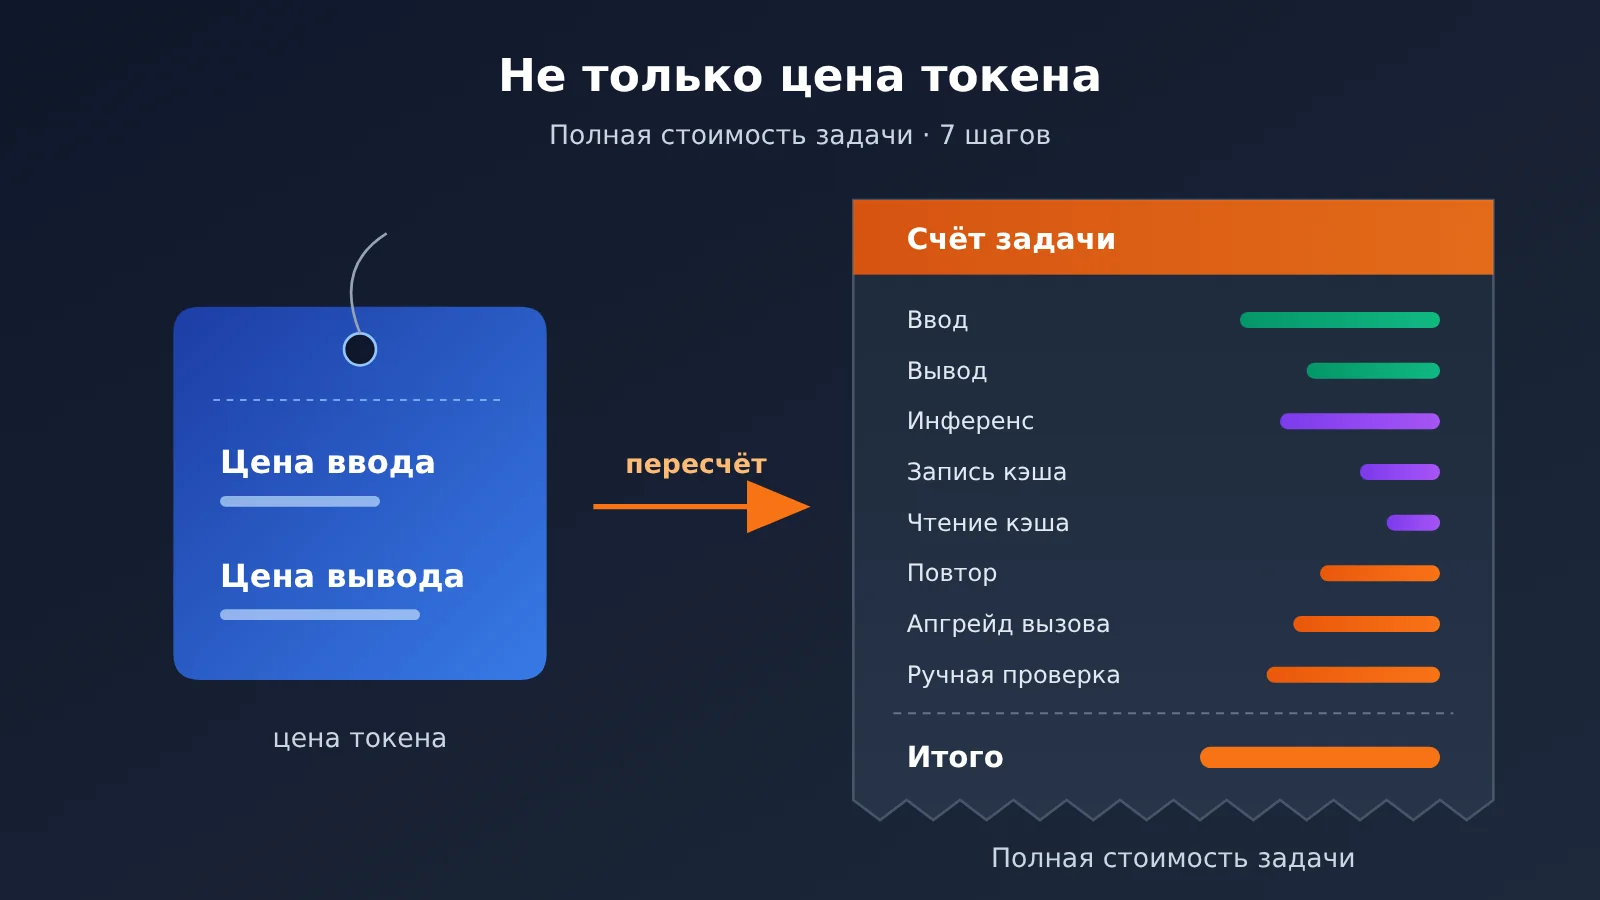
Примечание автора: от входных данных, выходных данных, рассуждений, кэша и повторных попыток до проверки и эскалации — за семь шагов переводим «сколько стоит миллион токенов» в «сколько стоит одно выполненное задание».
Многие команды при выборе модели первым делом смотрят на цену входных и выходных токенов в прайс-листе и делают вывод: «Эта модель дешевле вдвое». Через месяц после запуска приходит счёт — и выясняется, что дешёвая модель не экономит деньги, а иногда обходится даже дороже. В этой статье — методика оценки стоимости в расчёте на одну принятую задачу, которая поможет увидеть расходы за пределами цены за токен.
Это не статья, которая уговаривает покупать дорогие модели: во многих сценариях дешёвые модели действительно выгоднее. Но чтобы понять, выгодна ли модель на самом деле, нужно учесть повторные попытки, токены рассуждения, кэш и ручную проверку.
Главная ценность: после прочтения у вас будет многоразовый рабочий лист расчёта стоимости задачи. Вы будете знать, какие данные собирать, как подставлять их в формулу и какие этапы чаще всего упускают.
Полная стоимость задачи: ключевые моменты
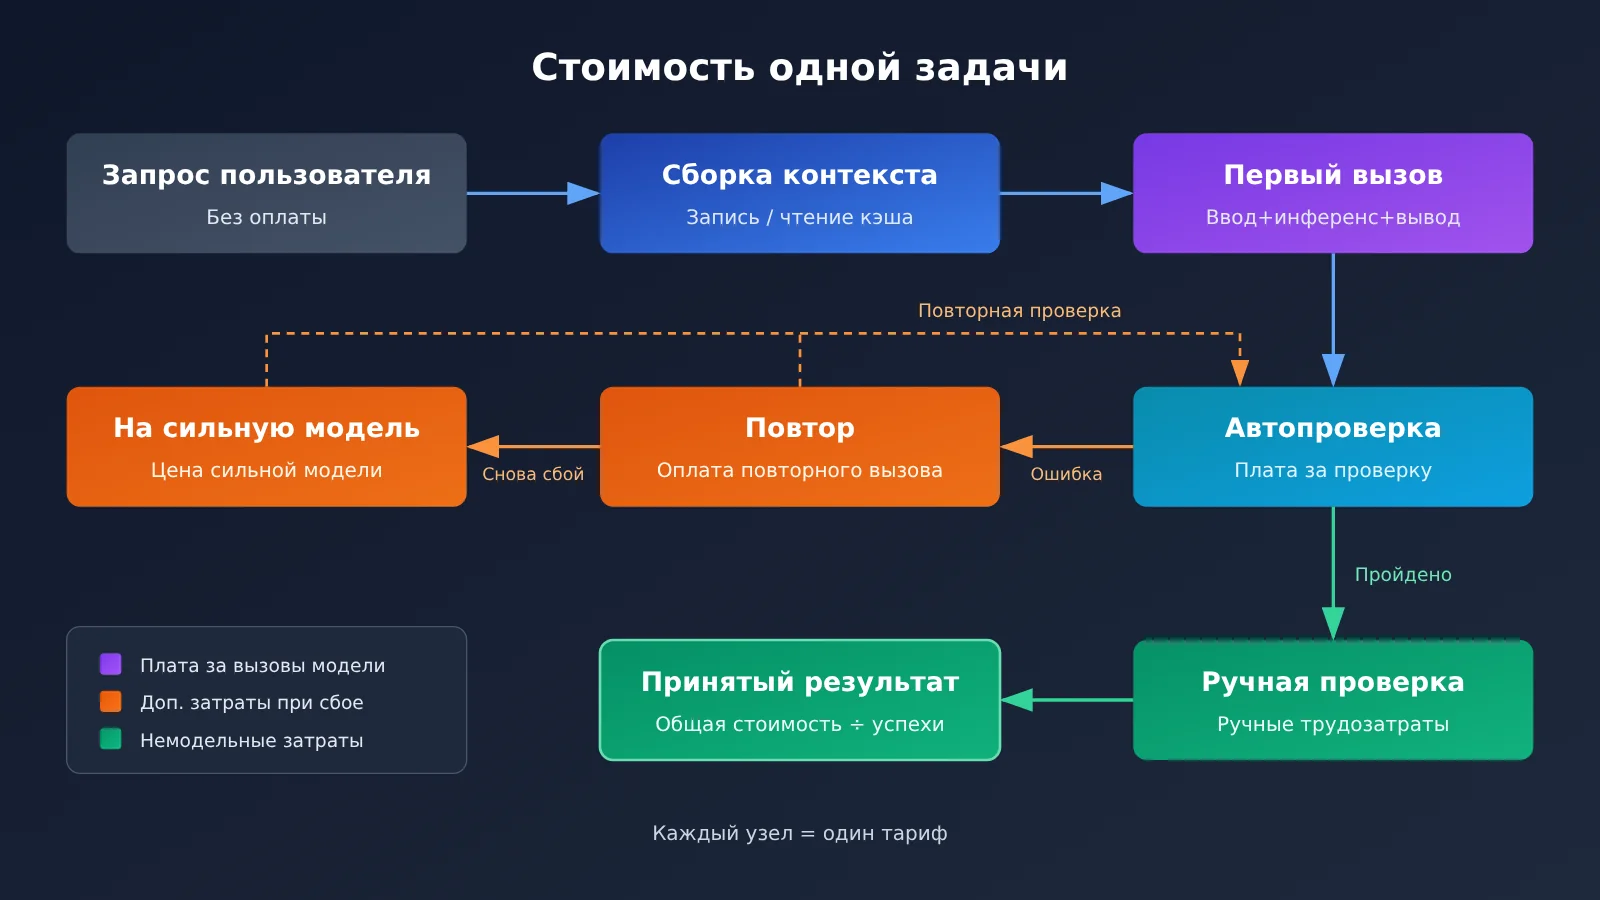
Чтобы оценить полную стоимость задачи, сначала придётся признать простой факт: в прайс-листе указана «цена за сырьё», а вас на самом деле интересует «цена готового продукта». Одна задача часто состоит из нескольких вызовов, разных типов токенов и нескольких затрат вне модели. В таблице ниже перечислены самые распространённые статьи расходов.
| Статья расходов | Описание | Почему её легко пропустить |
|---|---|---|
| Обычные входные токены | Системный промпт, ввод пользователя, контекст поиска, история диалога | В многораундовом диалоге история учитывается снова и снова |
| Выходные токены | Видимый контент, который в итоге возвращает модель | Структурированный вывод часто оказывается длиннее, чем ожидалось |
| Токены рассуждения | Внутренние рассуждения reasoning-модели, обычно тарифицируются как выходные | Пользователь их не видит, но в счёте они появляются |
| Запись в кэш и чтение из кэша | Создание и попадание в кэш для повторяющегося префикса | Запись и чтение тарифицируются иначе, чем обычный ввод |
| Повторные вызовы | Повторный запрос после тайм-аута, ошибки формата или неудачной проверки | На тестах почти не встречаются, а в продакшене возникают массово |
| Эскалация вызова | Передача задачи более сильной модели после неудачи слабой | Политика маршрутизации складывает стоимость двух вызовов |
| Ступени длинного контекста | Изменение цены за единицу после превышения порога контекста | Срабатывает только на небольшом числе запросов с длинным вводом, поэтому легко упустить |
| Стоимость ручной проверки | Результат нужно проверить человеку или отправить на доработку | Не входит в счёт за API, но реально существует |
Подробнее о полной стоимости задачи: почему цена за единицу вводит в заблуждение
Первое заблуждение связано с токенами рассуждения. Reasoning-модель перед ответом тратит часть на внутренние рассуждения; обычно они тарифицируются по цене выходных токенов, а их длина зависит от настройки интенсивности рассуждений. В публичных обсуждениях немало статей сравнивают одну и ту же модель в режимах high и xhigh — вывод везде один: стоят ли дополнительные рассуждения своих денег, зависит от того, насколько выросла доля успешно выполненных задач, а не от того, одинакова ли цена за единицу.
Второе заблуждение — «правильный формат не означает правильный результат». При извлечении данных из текста модели легко вернуть валидный JSON, но нужно дополнительно проверять, действительно ли значения полей взяты из исходного текста и нет ли перепутанных данных. Если дешёвая модель выдаёт результат, который в заметной доле случаев приходится переделывать вручную, сэкономленное в счёте за API с лихвой вернётся через затраты на ручной труд.
Третье заблуждение — маркетинговые формулировки вендоров. Некоторые модели при запуске одновременно объявляют о снижении цены за токен и о «снижении стоимости задачи», но это не одно и то же. Снижение стоимости задачи может быть связано с меньшей длиной вывода, меньшим числом повторов или зависеть от конкретного использования кэша — ваша рабочая нагрузка не обязательно воспроизведёт ту же пропорцию.
Как оценить полную стоимость одной задачи: быстрый старт
Этот процесс не требует написания кода — достаточно одной электронной таблицы. Основная идея: сначала посчитать структуру токенов одного вызова, затем умножить на соответствующие вероятности и в конце разделить на количество принятых результатов.
7 шагов для оценки полной стоимости задачи
- Определите границы «одной задачи»: например, «обработать один тикет и выдать структурированные поля, готовые для загрузки в базу», а не «вызвать API один раз». От границ зависит сам подход к расчёту затрат.
- Разложите структуру токенов одного вызова: отдельно зафиксируйте среднюю длину системного промпта, контекста из поиска, пользовательского ввода, видимого вывода и reasoning-токенов — лучше в двух значениях: P50 и P95.
- Отметьте части, которые можно кэшировать: фиксированный системный промпт, определения инструментов и few-shot примеры обычно можно отправлять через кэш; фиксируйте частоту записи в кэш и ожидаемую долю попаданий.
- Уточните правила тарификации: цену за входные и выходные токены, запись в кэш и чтение из кэша, а также наличие ступенчатых тарифов для длинного контекста. Все цены сверяйте с фактическими данными на странице тарифов APIYI: docs.apiyi.com/models.
- Измерьте долю ошибок на реальных примерах: прогоните хотя бы одну репрезентативную выборку и посчитайте долю ошибок формата, ошибок валидации и тайм-аутов, а затем переведите её в частоту повторных попыток и эскалаций.
- Добавьте затраты вне модели: долю ручной выборочной проверки, время на проверку одной записи и, при необходимости, пересчитайте это в деньги.
- Посчитайте стоимость «каждого принятого результата»: разделите общую стоимость на количество результатов, прошедших финальную приёмку. Именно этот показатель стоит использовать для сравнения моделей.
Поля таблицы полной стоимости задачи
Перенесите шаги выше в таблицу. Рекомендую включить как минимум такие поля. Названия можно адаптировать под привычки команды — главное, чтобы для каждого пункта был указан источник данных.
| Поле | Что означает | Источник данных |
|---|---|---|
in_cached |
Количество входных токенов, попавших в кэш | Поле usage в логах вызовов |
in_uncached |
Количество обычных входных токенов, не попавших в кэш | Логи вызовов |
cache_write |
Количество токенов, записанных в кэш в этом вызове | Логи вызовов |
out_visible |
Количество видимых выходных токенов | Логи вызовов |
out_reasoning |
Количество токенов рассуждения | Логи вызовов (только для reasoning-моделей) |
retry_rate |
Доля случаев, требующих повторной попытки | Статистика по тестовой выборке |
escalate_rate |
Доля случаев, требующих переключения на более сильную модель | Логи стратегии маршрутизации |
accept_rate |
Доля ответов, принятых в итоге | Автоматическая проверка плюс ручная выборочная проверка |
| Цены за единицу | Цены за вход, выход, запись в кэш и чтение из кэша | Фактические данные со страницы цен APIYI |
🚀 Совет для быстрого старта: если нужно сравнить стоимость задачи сразу для нескольких моделей, прогоните на APIYI apiyi.com один и тот же набор примеров по каждой модели. Платформа даёт доступ к API основных моделей из этой статьи и совместима с форматами OpenAI и Anthropic — при смене модели достаточно изменить её название, так удобнее сравнивать всё в одной таблице. Способ подключения и base_url смотрите в документации APIYI docs.apiyi.com.
Пример полного расчёта стоимости задачи
Покажем это на задаче извлечения полей из тикета. Чтобы не приводить непроверенные цифры, в примере даны только объёмы токенов и формулы, а цены подставляйте реальные — для нужной модели со страницы цен APIYI docs.apiyi.com/models.
| Этап | Состав токенов (в среднем) | Вероятность | Формула стоимости |
|---|---|---|---|
| Первый вызов | попадание в кеш 6,000 + обычный ввод 2,000 + видимый вывод 800 + рассуждение 1,500 | 100% | 6,000×цена чтения кеша + 2,000×цена ввода + 2,300×цена вывода |
| Запись в кеш | 6,000 (перезапись после истечения кеша) | амортизируется по частоте записи | 6,000×цена записи в кеш ÷ число запросов, покрываемых одной записью |
| Повторный вызов | такой же, как первый вызов | 10% | стоимость первого вызова × 0.1 |
| Вызов с переходом на сильную модель | ввод сильной модели 8,000 + вывод и рассуждение вместе 2,000 | 5% | после подстановки цены сильной модели × 0.05 |
| Ручная выборочная проверка | токены не расходуются | проверяется 5% | стоимость ручной проверки одной записи × 0.05 |
Складываем эти пять строк — получаем «ожидаемую стоимость одного тикета». Дальше делим её на итоговый коэффициент принятия, например 95%, и получаем «стоимость одного принятого результата». Обратите внимание: повторный вызов здесь считается по полной стоимости первого, потому что при повторе контекст обычно отправляется заново в том же виде.
В этом примере есть примечательный момент: видимый вывод — всего 800 токенов, а токенов рассуждения — 1,500. При оплате по цене вывода именно рассуждение становится основной статьёй расходов на стороне вывода. Если оценивать только по видимому выводу, стоимость стороны вывода окажется заниженной более чем вдвое.
Полная стоимость задачи: сравнение распространённых заблуждений
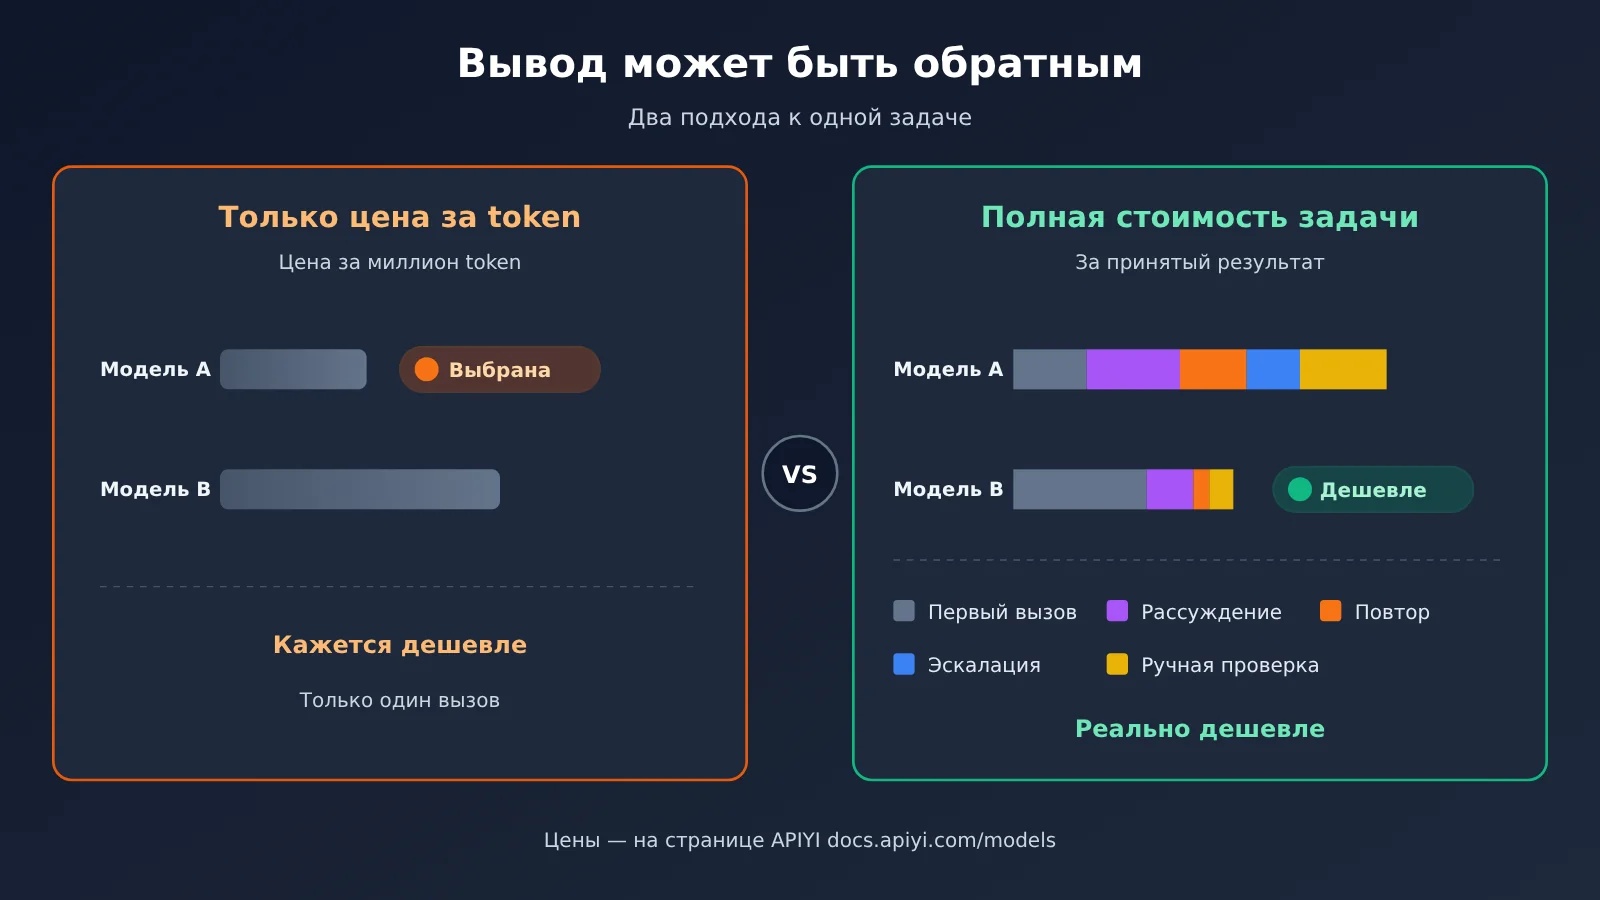
Одна и та же задача, рассмотренная с двух позиций — «смотреть только на цену за единицу» и «считать полную стоимость задачи», — часто приводит к противоположным выводам о выборе модели. В таблице ниже собраны несколько типичных сценариев.
| Сценарий | Вывод, если смотреть только на цену за единицу | Вывод с учётом полной стоимости задачи | Ключевые переменные |
|---|---|---|---|
| Структурированное извлечение | Выбрать самую дешёвую лёгкую модель | Если доля ошибок в полях высока, более сильная модель может оказаться экономнее | Доля принятых результатов, ручная доработка |
| Агент для программирования | Выбрать модель с низкой ценой за выходные токены | Многократные вызовы инструментов раздувают контекст, и стратегия кэширования важнее | Доля попаданий в кэш, число раундов |
| Анализ длинных документов | Оценивать по средней длине входа | Несколько сверхдлинных запросов запускают ступенчатую цену за длинный контекст | Порог контекста, длина P95 |
| Выбор интенсивности рассуждений | У одной и той же модели цена за единицу одинакова — выбираем самый высокий уровень | На высоком уровне больше токенов рассуждений; нужно проверить, растёт ли доля успешных прохождений | Токены рассуждений, доля успешных прохождений |
| Пакетные офлайн-задачи | Считать по цене за вызов в реальном времени | У канала пакетной обработки могут быть другие правила тарификации | Поддерживается ли Batch |
💡 Пояснение к сравнению: выводы в таблице — это рассуждение на уровне метода; какая модель выгоднее в конкретном случае, зависит от вашей выборки. Рекомендуем на APIYI apiyi.com прогнать несколько моделей на одной и той же выборке, подставить в таблицу фактические цены со страницы цен и только потом принимать решение.
Детали длинного контекста и кэширования в полной стоимости задачи
Ступенчатая тарификация длинного контекста — это пункт, где чаще всего возникают «редкие, но дорогие» случаи. В открытых источниках упоминается, что для некоторых моделей при превышении входом определённого порога (например, в одной статье обсуждался порог 272K у GPT-6 Sol) может применяться другая цена за единицу. Если в распределении длины ваших запросов есть длинный хвост, обязательно отдельно посчитайте запросы, выходящие за порог, а не ограничивайтесь средней длиной.
Кэширование — палка о двух концах. Чтение из кэша обычно дешевле обычного ввода, но у некоторых провайдеров запись в кэш может стоить дороже обычного ввода, к тому же у кэша есть срок жизни. Если запросы идут с большими интервалами, а префикс часто меняется, затраты на запись могут перекрыть экономию от чтения. Конкретные цены на запись и чтение кэша, а также правила тарификации смотрите в пометках на странице цен APIYI docs.apiyi.com/models.
5 практических способов снизить полную стоимость задачи
Когда расчёт сделан, направления оптимизации обычно становятся понятны. Перечисленные ниже приёмы работают в большинстве сценариев, но проверять их эффект нужно в таблице расчёта, а не на глаз.
| Приём | Статья затрат | На что обратить внимание |
|---|---|---|
| Фиксированный префикс и включение кэша | Входные токены | Перенесите изменчивый контент в конец промпта, чтобы повысить долю попаданий в кэш |
| Ограничение формата и длины вывода | Выходные токены | Ограничивайте поля через структурированный вывод, избегайте пространных объяснений |
| Маршрутизация по сложности задачи | Эскалация вызова, токены рассуждений | Правила должны быть чёткими, а «принятые ошибочные результаты» — проверяться отдельно |
| Предварительная автоматическая проверка | Ручная проверка, переделки | Проверяйте источники доказательств, а не только формат JSON |
| Управление интенсивностью рассуждений | Токены рассуждений | Выбирайте уровень по проценту успешных прохождений, не включайте максимальный по умолчанию |
В маршрутизации есть один часто упускаемый риск: среди результатов, которые небольшая модель «успешно» вернула, могут скрываться ошибки — и такие ошибки не запускают эскалацию. Поэтому при оценке стратегии маршрутизации недостаточно смотреть только на долю эскалаций: нужно выборочно проверять ту часть результатов, которую небольшая модель пропустила напрямую, и закладывать пропущенные ошибки в стоимость.
Частые вопросы (FAQ)
Вопрос 1: Что такое полная стоимость задачи?
Полная стоимость задачи — это все затраты на выполнение задачи в бизнес-смысле, когда результат принят. Она включает стоимость ввода, вывода, рассуждений и кэширования по всем вызовам, а также расходы на повторные попытки, эскалацию и ручную проверку. Это куда ближе к реальному счёту, чем просто цена за токен.
Вопрос 2: Чем полная стоимость задачи отличается от цены за токен?
Цена за токен — это стоимость сырья, а полная стоимость задачи — стоимость готового продукта. Модель с низкой ценой за токен может в итоге обойтись дороже, если требует больше повторов, более длинных рассуждений или больше ручной доработки. А модель с высокой ценой при высоком проценте успеха с первого раза может оказаться экономнее.
Вопрос 3: Сколько минимум нужно примеров, чтобы оценить полную стоимость задачи?
Фиксированного числа нет — главное, чтобы выборка покрывала реальное распределение, особенно длинные входы, сложные случаи и граничные ситуации. При слишком маленькой выборке доля повторов и доля принятых результатов сильно колеблется. Рекомендую сначала оценить на небольшой партии, а в первые дни после запуска скорректировать расчёты по реальным логам.
Вопрос 4: В каких сценариях полную стоимость задачи нужно считать в первую очередь?
В основном в следующих:
— **Извлечение структурированных данных**: когда ошибки в полях приходится исправлять вручную, доля трудозатрат человека очень высока
— **Агенты для написания кода**: многократные вызовы инструментов быстро раздувают контекст
— **Вопросы по длинным документам**: редкие длинные запросы могут упираться в ступенчатые тарифы за длинный контекст
— **Маршрутизация между моделями**: при эскалации вызова费用 складываются дважды
Вопрос 5: Как быстро узнать цены и правила тарификации по каждой модели?
Советую сразу заглянуть на страницу цен APIYI — docs.apiyi.com/models. Там указаны цены на ввод, вывод и кэширование для поддерживаемых платформой моделей; при оценке ориентируйтесь на фактические данные с этой страницы. APIYI совместим с форматами интерфейсов OpenAI и Anthropic: после подключения по документации docs.apiyi.com можно прогнать одну и ту же партию примеров через несколько моделей и сразу занести данные `usage` из логов вызовов в таблицу.
Вопрос 6: Можно ли напрямую сравнивать расход по подписке и оплату по API?
Напрямую сравнивать не советую. Продукты по подписке обычно ограничены квотой или числом использований, а API тарифицируется по токенам — единицы измерения и сценарии применения у них разные. Если всё же хочется сравнить, сначала нужно пересчитать реальный объём задач, доступный по подписке, а не предполагать фиксированное количество сообщений.
Вопрос 7: Какие ограничения есть у оценки полной стоимости задачи?
Она зависит от репрезентативности выборки: если примеры слишком простые, стоимость занижается. Пересчёт трудозатрат на ручную проверку тоже субъективен и сильно различается от команды к команде. Кроме того, цены моделей и правила тарификации могут меняться, поэтому таблицу нужно регулярно обновлять по актуальным ценам и логам, а не считать один раз и пользоваться годами.
Полная стоимость задачи: ключевые выводы
- Меняем единицу сравнения: сравнивайте модели по «стоимости одного принятого результата», а не по цене за миллион токенов
- Токены рассуждений нужно учитывать отдельно: обычно они тарифицируются как выходные и могут превышать видимый вывод
- Кэш считаем и на запись, и на чтение: запись может стоить дороже обычного ввода, а выгодность определяется долей попаданий
- Повторы и эскалации — скрытая основная статья расходов: после запуска доля сбоев часто выше, чем на тестах
- Валидный JSON — ещё не верные данные: проверяйте источник доказательств и закладывайте в стоимость ручную переработку
- Длинный контекст — смотрим на хвост распределения: по P95 длины проверяйте, не срабатывает ли ступенчатая цена
- Цена за единицу — по странице цен: при оценке берите фактические данные со страницы цен APIYI docs.apiyi.com/models
Итог
Главное в оценке полной стоимости задачи:
- Сначала определите границы задачи: единица — бизнес-результат, а не отдельный вызов
- Разложите все статьи затрат: вход, выход, рассуждения, кэш, повторы, эскалации, ручная проверка — ничего нельзя пропустить
- Измеряйте вероятности на реальной выборке: доля повторов, доля эскалаций и доля принятых результатов определяют множитель итоговой стоимости
«Не смотрите только на цену за токен» не значит, что цена не важна — просто это лишь одна переменная в формуле. Соберите таблицу расчёта, заполните её данными из своей выборки и логов — и вывод о выборе модели будет надёжнее любого рейтинга.
Рекомендуем на APIYI apiyi.com сравнить несколько моделей на одной и той же выборке и посчитать полную стоимость задачи по фактическим ценам со страницы docs.apiyi.com/models. Платформа совместима с форматами API OpenAI и Anthropic, так что переключение моделей почти ничего не стоит.
📚 Справочные материалы
- Серия статей Ofox.ai Blog о ценах на модели и стоимости задач: в нескольких материалах рассматривается связь между тарификацией кэширования, порогами длинного контекста, уровнем推理 и стоимостью задач.
- Ссылка:
ofox.ai/blog/page/12 -
Пояснение: полезно для понимания разницы между «снижением цены за единицу» и «снижением стоимости задачи»
-
Статьи Ofox.ai Blog о маршрутизации моделей и структурированном извлечении данных: обсуждаются правила перехода от небольших моделей к мощным, а также тезис «корректный JSON — не то же самое, что правильные данные».
- Ссылка:
ofox.ai/blog/page/11 -
Пояснение: пригодится при проектировании стратегии маршрутизации и процесса валидации
-
Страница цен на модели APIYI: цены за вход, выход и кэширование для поддерживаемых платформой моделей.
- Ссылка:
docs.apiyi.com/models -
Пояснение: все цены и правила тарификации в этой статье приведены по фактическим данным на этой странице
-
Центр документации APIYI: способы подключения, формат интерфейса и описание параметров.
- Ссылка:
docs.apiyi.com - Пояснение: содержит инструкции по подключению в форматах, совместимых с OpenAI и Anthropic.
Автор: техническая команда APIYI
Обсуждение технологий: свяжитесь с нами на главной странице сайта APIYI apiyi.com; больше материалов по подключению — в центре документации docs.apiyi.com.