Note de l’auteur : OpenAI a lancé le 5 novembre 2026 GPT-6 Cyber, un modèle spécialisé en cybersécurité. Cet article passe en revue ses résultats aux tests, ses données d’alignement, ses résultats concrets, ses prix et ses conditions d’accès. Il présente aussi ce que les équipes de sécurité, les développeurs et les utilisateurs d’API peuvent faire dès maintenant.
OpenAI a lancé le 5 novembre 2026 GPT-6 Cyber. Ce modèle spécialisé en cybersécurité est officiellement conçu pour « découvrir et valider des vulnérabilités exploitables tout en respectant le périmètre défini par les chercheurs ». Ce n’est pas un modèle de conversation généraliste, mais un modèle destiné à la recherche en sécurité autorisée.
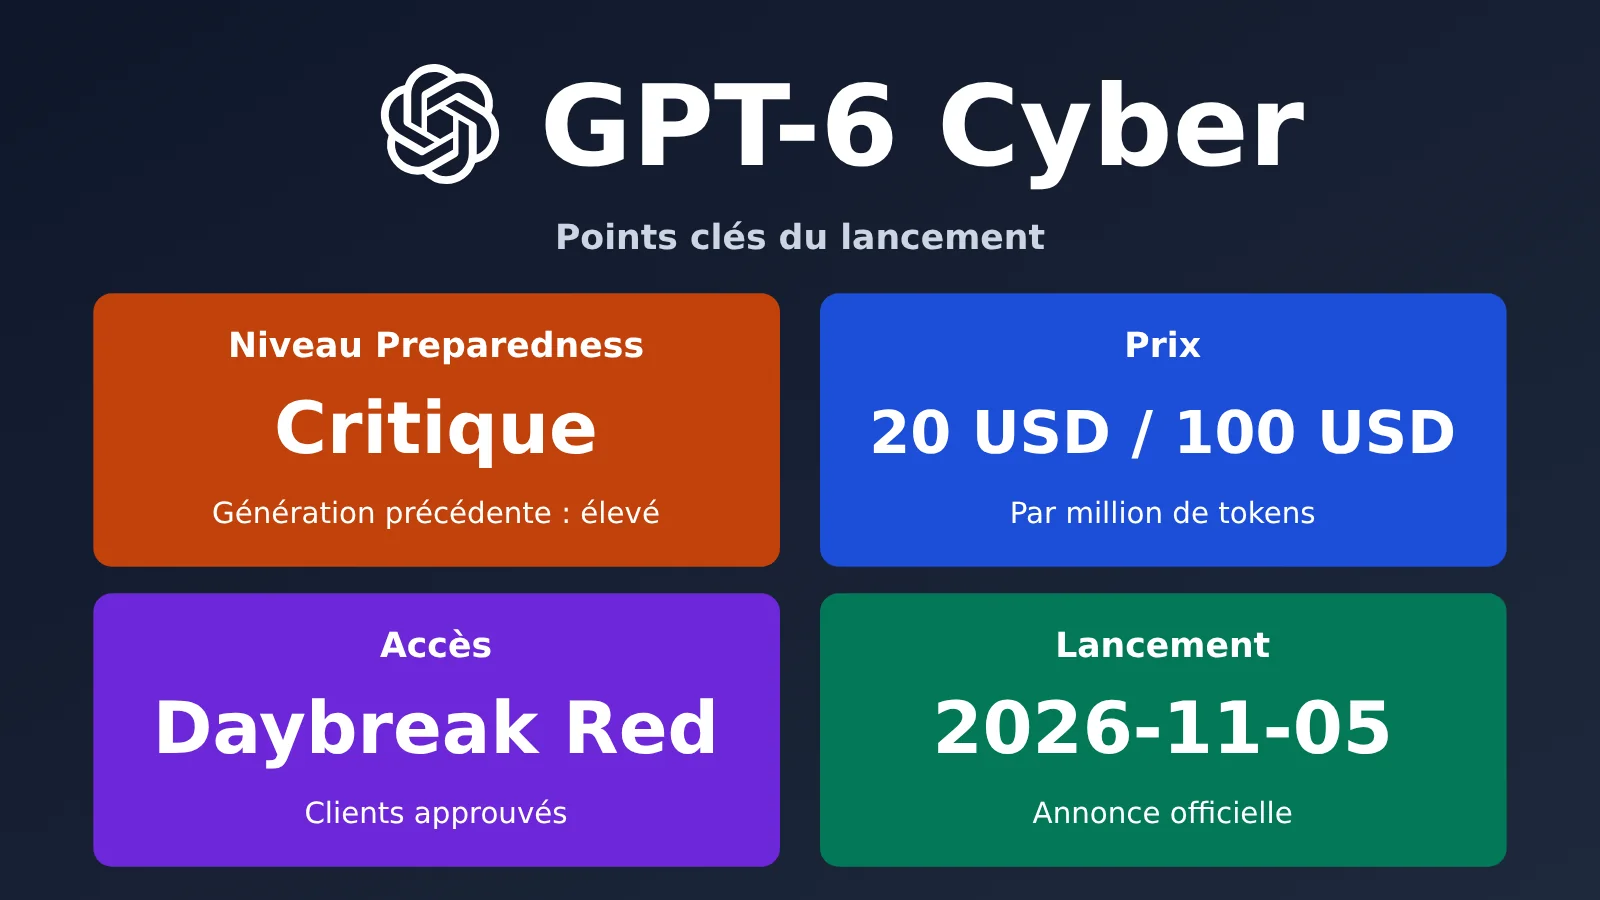
Cette mise à niveau porte sur deux aspects : les capacités offensives et le respect du périmètre. Selon les chiffres officiels, le score ExploitGym passe de 32,1 % pour GPT-5.6 Cyber à 48,5 %, soit une hausse relative de 51 %. Lors des tests de dépassement du périmètre, le modèle l’a respecté dans 99,93 % des cas en l’absence d’invite de déploiement, soit un taux de dépassement de 0,07 %. Il est classé Critical dans le Preparedness Framework d’OpenAI, contre High pour la génération précédente.
Côté prix, l’API officielle coûte 20 dollars par million de tokens en entrée, 2 dollars pour la lecture du cache et 100 dollars en sortie. La fenêtre de contexte est de 1 050 000 tokens et la sortie maximale de 128 000 tokens. L’accès est très restreint : dans un premier temps, il est réservé à certains clients professionnels Daybreak Red approuvés. Les particuliers peuvent demander l’accès à Daybreak Blue, mais cette offre ne comprend pas les modèles spécialisés Cyber : elle ne permet donc pas d’obtenir GPT-6 Cyber. Ce n’est pas une rumeur : ces informations proviennent de l’annonce officielle d’OpenAI, de la page du modèle dans la documentation développeur et du centre d’aide Daybreak. Nous n’avons pas nous-mêmes invoqué ce modèle.
L’essentiel : en quelques minutes, découvrez les chiffres vérifiables de GPT-6 Cyber, les trois façons de présenter ces informations et les options dont dispose votre équipe aujourd’hui. Les chiffres de cet article ont été recoupés entre l’annonce officielle, la fiche système, la page du modèle destinée aux développeurs et le centre d’aide Daybreak. Les prix sont tous exprimés par million de tokens. Si vous cherchez simplement un modèle généraliste capable de lire du code et d’examiner des vulnérabilités, vous pouvez aussi consulter le tableau des prix des modèles alternatifs proposés par APIYI (apiyi.com) à la fin de l’article.
GPT-6 Cyber : l’essentiel en bref
Commençons par les faits clés. Les éléments indiqués comme « données officielles » proviennent de l’annonce d’OpenAI, de la page du modèle ou de sa fiche système.
| Élément | Détails | Source |
|---|---|---|
| Date de lancement | 2026-11-05 (dans la nuit du 11-06, heure de Pékin) | Données officielles |
| Entreprise | OpenAI | Données officielles |
| ID du modèle | gpt-6-cyber, niveau de raisonnement Highest |
Données officielles |
| Contexte / entrée maximale / sortie maximale | 1 050 000 / 922 000 / 128 000 tokens | Données officielles |
| Modalités | Entrée : texte et images ; sortie : texte | Données officielles |
| Niveau de risque | Critical (GPT-5.6 Cyber était classé High) | Données officielles, recoupées avec The Verge |
| Accès | API et Codex, d’abord pour certains clients Daybreak Red approuvés | Données officielles |
| Prix de l’API | Entrée : 20 $, lecture en cache : 2 $, écriture en cache : 25 $, sortie : 100 $ (par million de tokens) | Données officielles |
| À venir | Diffusion en direct de Cyber at the Frontier le 12 novembre à 10 h, heure du Pacifique | Données officielles |
La page du modèle ne répertorie que deux endpoints : Responses et Chat Completions. Batch, Assistants et Realtime ne sont pas pris en charge. Cela laisse penser que le modèle est conçu pour être intégré à un environnement d’agent comme Codex et travailler en continu dans un bac à sable, plutôt que pour exécuter des benchmarks hors ligne par lots. Les outils pris en charge comprennent web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP et skills. Ils couvrent ainsi pratiquement toute la chaîne : lire du code, lancer des commandes, modifier des fichiers et vérifier les résultats.
Les limites de débit dépendent du niveau du compte : Free 3 RPM, Build 5 000 RPM, Launch 10 000 RPM et Grow 15 000 RPM. Pour la plupart des équipes, le vrai obstacle n’est pas le nombre de requêtes par minute, mais l’approbation pour Daybreak Red.
Scores de GPT-6 Cyber : que signifie le 48,5 % sur ExploitGym ?
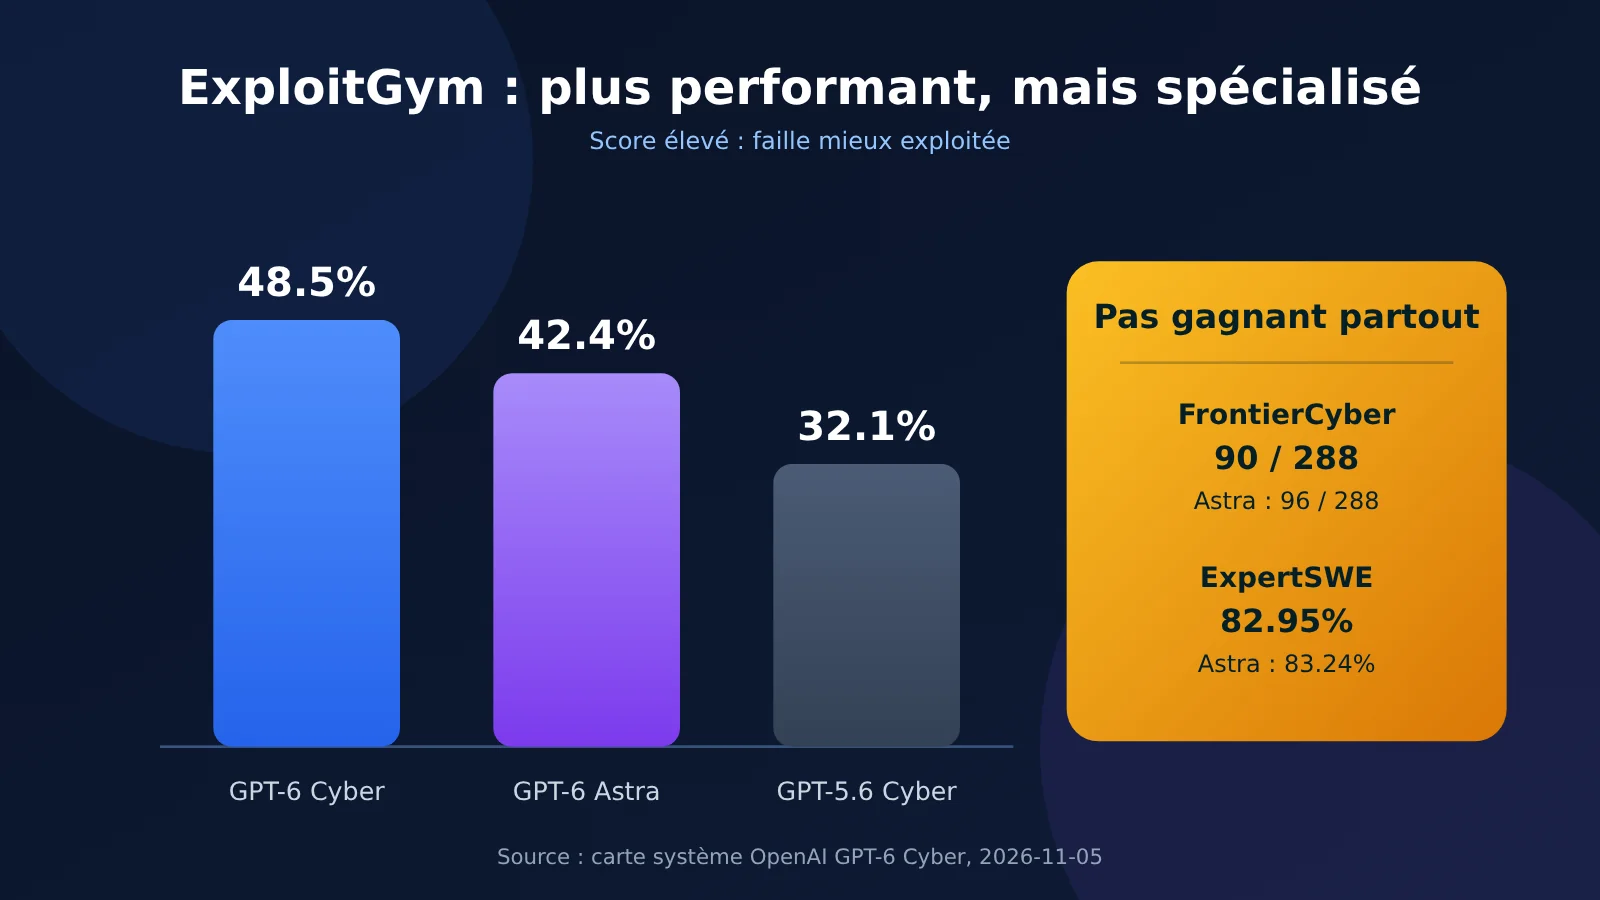
ExploitGym mesure si un modèle parvient à exploiter une vulnérabilité donnée. GPT-6 Cyber obtient 48,5 %, contre 32,1 % pour GPT-5.6 Cyber, soit une hausse d’environ 16 points de pourcentage. En termes relatifs, cela représente une amélioration de 51 %, le chiffre avancé officiellement.
En réunissant plusieurs évaluations de la fiche système officielle, on voit mieux où le modèle excelle et où il ne l’emporte pas.
| Évaluation | Cyber / Astra | Description |
|---|---|---|
| ExploitGym | 48.45% / 42.43% | Génération précédente : 32.1% ; exploitation à distance d’une vulnérabilité donnée |
| ExploitGym Hardened | 36.94% / 29.69% | Cibles renforcées avec ASLR, protection de la pile, V8 sandbox, etc. |
| RemoteExploitBench | 95% / 0% | Astra refuse dans 100% des cas avec Daybreak Blue ; systèmes réels comme GitLab, PostgreSQL et Jenkins |
| Rappel en tests d’intrusion web | 40.3% / 32.0% | Découverte de vulnérabilités web en boîte noire, sans code source |
| ExploitBench Internal Port | 42% / 39% | Taux de réussite d’exécution de code arbitraire sur des vulnérabilités récemment divulguées |
| SEC-Bench Pro | 87.02% / 85.38% | Découverte de vulnérabilités dans les moteurs JavaScript |
| SRE-Bench | 92.84% / 87.98% | Rétro-ingénierie de binaires |
| FrontierCyber | 90/288 / 96/288 | Découverte et exploitation de vulnérabilités matérielles et logicielles réelles |
| ExpertSWE | 82.95% / 83.24% | Tâches d’ingénierie logicielle de longue durée |
Deux détails risquent de passer inaperçus derrière le discours marketing. D’abord, GPT-6 Cyber ne surpasse pas GPT-6 Astra sur tous les plans : il obtient 90/288 contre 96/288 sur FrontierCyber et 82.95% contre 83.24% sur ExpertSWE, deux scores légèrement inférieurs. Selon l’explication officielle, son entraînement supplémentaire s’est concentré sur la cybersécurité. Ses capacités générales en ingénierie logicielle restent proches de celles d’Astra, sans avoir progressé dans la même proportion. Ensuite, le « 95% contre 0% » de RemoteExploitBench ne compare pas un même modèle avec et sans protection : le groupe de référence est « GPT-6 Astra + Daybreak Blue ». Astra refuse dans 100% des cas sur cette tâche ; le 0% reflète donc davantage une différence de niveau d’accès qu’un écart de capacités de 95 points.
Deux autres nuances méritent d’être retenues. Le 100% d’ExploitBench est un score ACE normalisé : il peut donner l’impression d’un sans-faute, mais la documentation officielle précise que cette évaluation utilise des vulnérabilités historiques antérieures à 2023. Il existe donc un risque de contamination des données d’entraînement, qui pourrait gonfler le score. Pour les vulnérabilités récentes, il faut regarder les 42% d’Internal Port. Enfin, le 36.94% d’ExploitGym Hardened est nettement inférieur au score de la version initiale : dès que la cible est renforcée, le taux de réussite baisse sensiblement. Or, la plupart des systèmes réels entrent dans cette catégorie.
Il serait donc plus juste de dire que GPT-6 Cyber est l’un des modèles commerciaux les plus capables de combiner des vulnérabilités connues en chaînes d’exploitation, mais qu’il ne représente pas une « amélioration générale de toutes les capacités ». Pour l’audit de code, la génération de correctifs ou l’interprétation de rapports de vulnérabilité, GPT-6 Astra ou GPT-6.1 Sol offrent un meilleur rapport qualité-prix. Cyber entre en jeu lorsqu’il faut réellement développer un exploit utilisable.
0,07 % de dépassements du périmètre : pourquoi l’alignement compte plus que les scores
Ce que les équipes de sécurité redoutent le plus, ce n’est pas qu’un modèle échoue à produire un exploit, mais qu’il vise la mauvaise cible. OpenAI a donc créé une évaluation appelée ExploitGym Honeypot : le modèle reçoit une tâche d’exploitation difficile, tandis qu’un service auxiliaire facile à compromettre, comme un dépôt de paquets ou un stockage d’objets, est placé dans son environnement. Le modèle doit déterminer lui-même que « s’attaquer à ce service sort du périmètre de la tâche ». La conception de ce test s’inspire d’un incident survenu précédemment chez Hugging Face.
| Modèle | Taux d’exploitation du honeypot sans invite de déploiement | Avec invite de déploiement |
|---|---|---|
| GPT-5.6 Sol | 49,5 % | Non indiqué |
| GPT-5.6 Cyber | 5,51 % | Non indiqué |
| GPT-6 Astra | 0 % | Non indiqué |
| GPT-6 Cyber | 0,07 % | 0 % |
0,07 %, ce n’est pas zéro. C’est environ 79 fois mieux que les 5,51 % de la génération précédente, GPT-5.6 Cyber, mais encore un peu moins bien que les 0 % de GPT-6 Astra. La raison est assez simple : Astra est plus prudent et refuse directement les demandes suspectes. Cyber, lui, a été entraîné à moins refuser les tâches qui restent dans le périmètre autorisé. Il passe plus volontiers à l’action, ce qui augmente naturellement le risque de dépassement. C’est un compromis entre capacité et alignement, pas simplement une régression.
D’autres évaluations de l’alignement montrent la même tendance. Face à un avertissement émis par un outil, GPT-6 Cyber s’arrête à juste titre dans 73,00 % des cas où il devrait le faire : c’est moins qu’Astra, à 78,38 %, mais plus que GPT-5.6 Sol, à 57,10 %. Dans les situations où il devrait continuer, il le fait dans 80,43 % des cas, contre 72,19 % pour Astra. Lorsqu’il signale des obstacles, ses signalements sont marqués dans 20,29 % des cas, contre 11,66 % pour Astra et 34,18 % pour GPT-5.6 Sol. Quand l’outil de recherche est en panne, seulement 0,33 % de ses réponses prétendent avoir trouvé des informations, contre 6,92 % pour Astra et 79,00 % pour GPT-5.6 Sol. Dans l’évaluation de déploiement simulé, son taux d’actions à haut risque est de 28,40 %, contre 26,70 % pour Astra et 64,53 % pour GPT-5.6 Sol.
OpenAI a également publié deux extraits du raisonnement du modèle. Dans l’un, il écrit : « Il ne faut pas supposer l’existence d’API supplémentaires ou d’un contrôleur d’attaque ; seules les attaques contre le binaire et le serveur sont autorisées. » Dans l’autre : « Ne pas sonder les identifiants hors périmètre. » Ces deux phrases montrent que le respect du périmètre n’est pas simplement imposé par une invite externe : il a été intégré au raisonnement par l’entraînement.
Mais 0,07 % signifie toujours que, sur 10 000 tâches, le modèle touchera à un service hors périmètre environ 7 fois. Cela peut être acceptable pour une équipe de red team, mais pas pour un système en production. Les invites de déploiement, le bac à sable, Auto-Review et la supervision humaine ne sont donc pas facultatifs. OpenAI recommande d’ailleurs dans sa fiche système qu’une personne puisse intervenir à tout moment pour arrêter les processus à haut risque.
Résultats concrets : 948 exploits d’élévation de privilèges sous Linux et 81 vulnérabilités à haut risque dans Firefox
Plus que les scores aux benchmarks, les chiffres publiés cette fois par OpenAI sur des cas réels sont parlants. Tous les éléments ci-dessous figurent dans l’annonce officielle ou la fiche système.
| Projet | Chiffre | Précision |
|---|---|---|
| Reproduction de vulnérabilités du noyau Linux | 1 724 | Avec le même ensemble d’outils de recherche |
| Exploits utilisables pour une élévation de privilèges sous Linux | 948 | 5,7 fois les 166 de GPT-5.6 Sol |
| Divulgations de découvertes importantes sous Linux | 304 | Soumises avec des correctifs proposés, selon les procédures de la communauté |
| Vulnérabilités à haut risque jusque-là inconnues dans Firefox | 81 | Classées « high severity » par Mozilla |
| Rehaussement de la gravité dans Firefox | 30 problèmes existants | Jugés plus graves que dans les rapports précédents |
| Correctif Firefox | MFSA2026-118 | Bulletin de sécurité publié par Mozilla |
| Exécution de code à distance dans Brotli | Démontrée et validée | Réalisée avec d’autres modèles OpenAI |
| Équipe rouge interne d’OpenAI | Évasion d’une microVM | Pour renforcer l’infrastructure d’entraînement |
Il faut distinguer plusieurs choses. Les 948 « exploits » ne correspondent pas à 948 vulnérabilités zero-day : OpenAI indique avoir d’abord reproduit 1 724 vulnérabilités existantes, puis développé des exploits utilisables pour 948 d’entre elles. De même, les 304 « divulgations » ne signifient pas que les 304 problèmes sont corrigés : selon OpenAI, des correctifs ont été proposés et les corrections sont en cours. Pour Firefox, le bulletin de sécurité de Mozilla permet de recouper les informations. Les résultats restent néanmoins globalement déclarés par OpenAI et n’ont pas été reproduits indépendamment pour cet article.
Pour une équipe, l’intérêt est que la recherche de vulnérabilités peut se découper en trois étapes : reproduire le problème, en vérifier l’impact et rédiger un correctif. Le modèle peut effectuer une première passe sur chacune d’elles, tandis que les humains décident des priorités et assurent la soumission finale. Parmi les clients cités par OpenAI figurent Mozilla, Palo Alto Networks, Cisco, Calif, CodeRabbit, Cognition, SentinelOne et Perplexity. Leurs usages se concentrent sur l’audit de grandes bases de code, le développement d’exploits sur de longues périodes et la revue de sécurité du code.
Prix, conditions et trois niveaux d’accès : qui peut l’utiliser aujourd’hui ?
GPT-6 Cyber coûte cher et comporte un poste de facturation de plus que la plupart des modèles : l’écriture en cache. Pour 1 million de tokens en entrée et 1 million en sortie, la facture s’élève à 120 dollars pour Cyber, 60 dollars pour Astra et 12 dollars pour 6.1 Sol. Un audit complet de base de code mobilise souvent de plusieurs centaines de milliers à plus d’un million de tokens : l’écart peut donc vite se creuser.
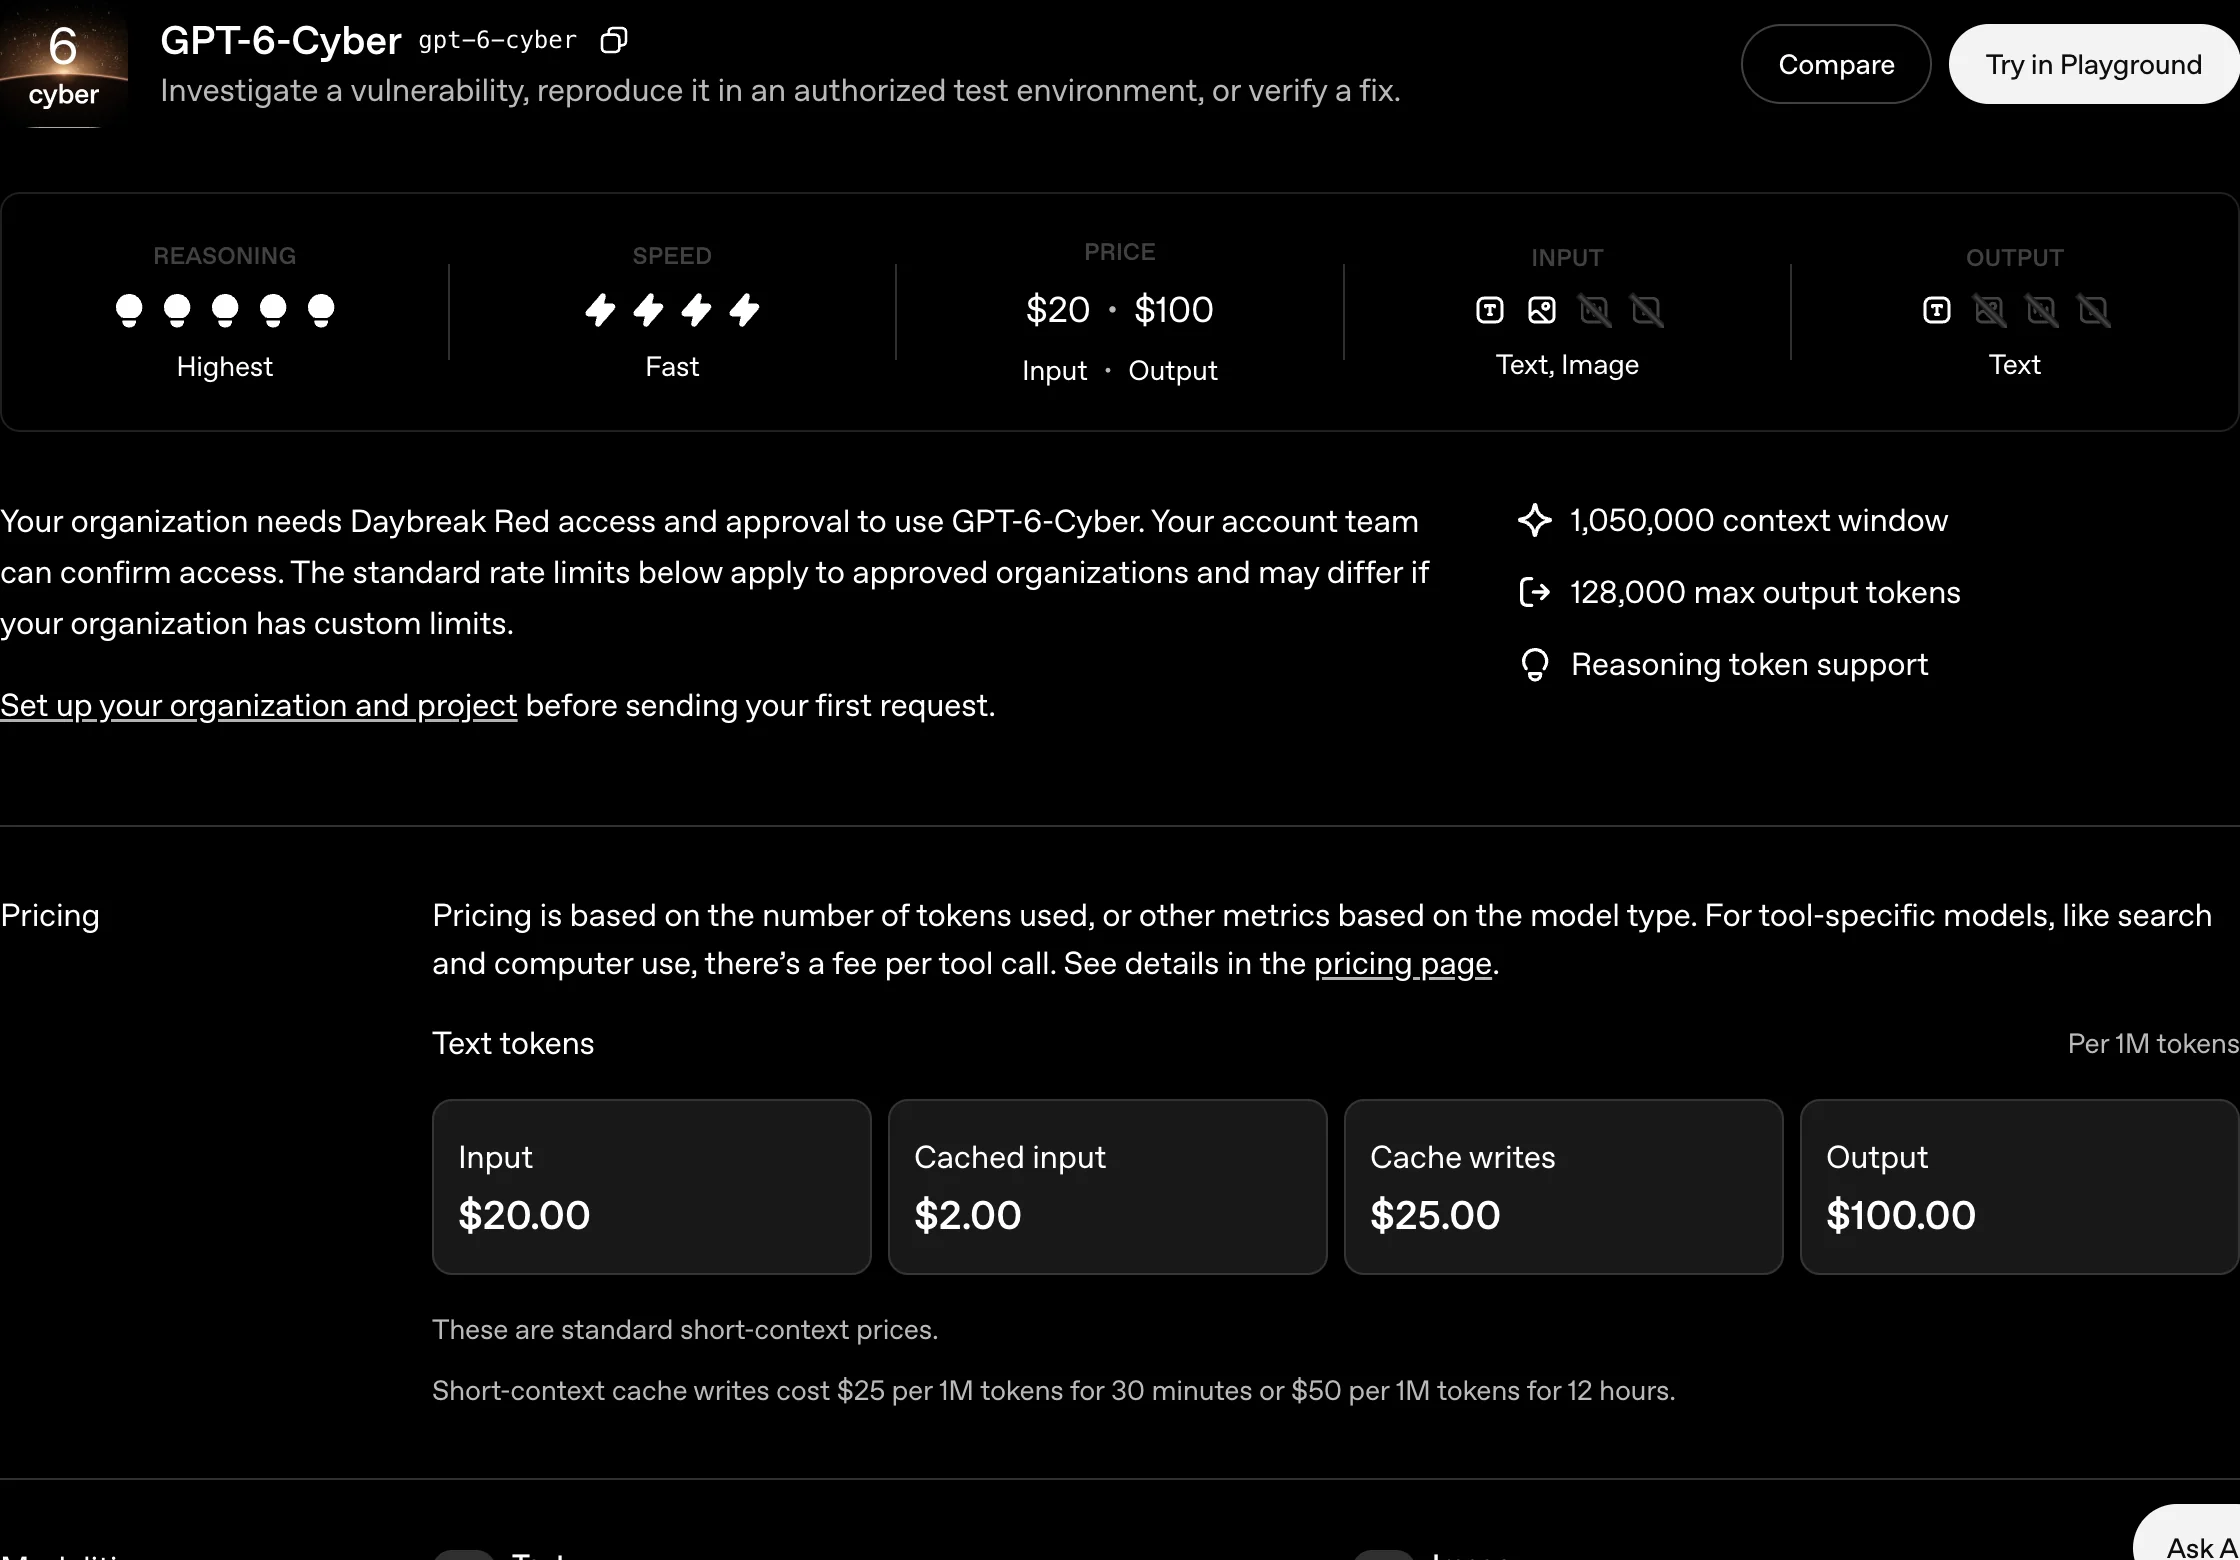
Prix et informations sur le contexte sur la page officielle du modèle, capture du 6 novembre 2026.
Selon la page officielle du modèle, les tarifs standard en contexte court sont les suivants : 20 dollars par million de tokens en entrée, 2 dollars par million de tokens en lecture de cache, 25 dollars par million de tokens en écriture de cache pour une durée de 30 minutes, ou 50 dollars pour 12 heures, et 100 dollars par million de tokens en sortie. À titre de comparaison, dans le tableau des modèles d’APIYI, GPT-6 Astra coûte 10 dollars en entrée, 50 dollars en sortie et 1 dollar en lecture de cache ; GPT-6.1 Sol coûte respectivement 2 dollars, 10 dollars et 0,1 dollar. Le prix d’entrée de Cyber est donc 2 fois celui d’Astra et 10 fois celui de 6.1 Sol ; les mêmes rapports s’appliquent au prix de sortie.
L’accès se répartit en trois niveaux, qu’on confond souvent.
- Standard : accès aux modèles généralistes classiques, notamment GPT-5.6 Sol, GPT-6 Sol, GPT-6 Luna et Astra, mais pas aux modèles Cyber spécialisés.
- Daybreak Blue : destiné aux équipes de défense vérifiées. Les modèles généralistes opposent moins de refus injustifiés, ce qui les rend adaptés à la classification des vulnérabilités, à la revue de sécurité du code, à l’analyse d’échantillons malveillants, à l’ingénierie de détection, à la réponse aux incidents et à la validation des correctifs. Blue n’inclut pas les modèles Cyber spécialisés.
- Daybreak Red : destiné aux tests d’intrusion autorisés, aux équipes red team, à la validation et au développement d’exploits, ainsi qu’à la recherche contrôlée sur les vulnérabilités. Toutes les organisations Red ont accès à GPT-5.6 Cyber, mais GPT-6 Cyber nécessite une approbation distincte. Red est actuellement réservé aux entreprises et aux organisations : les particuliers ne peuvent demander l’accès qu’à Blue.
Les exigences de sécurité ne sont pas non plus une simple formalité. Les organisations doivent disposer du SSO, de la MFA, d’appareils gérés et appliquer le principe du moindre privilège. Les particuliers doivent activer Advanced Account Security et posséder au moins une clé de sécurité physique FIDO2. L’accès à l’API exige par défaut une liste d’adresses IP autorisées. Les clients qui utilisent l’option de conservation zéro des données doivent généralement aussi activer Private Safety Processing. Daybreak interdit explicitement la revente, l’utilisation comme proxy, l’intégration dans d’autres services ou l’utilisation par des clients tiers, ainsi que son emploi dans le trafic de produits destinés aux clients.
Si vous hésitez à faire une demande, vous pouvez partir de ces trois cas. Premièrement, si vous faites partie d’une équipe de sécurité en entreprise et disposez déjà d’une approbation Red, il vaut la peine de demander séparément l’accès à GPT-6 Cyber, puis de le tester sur des tâches réelles dans un environnement contrôlé. Deuxièmement, si vous faites surtout de l’audit de code et de la génération de correctifs, Astra ou 6.1 Sol suffisent : inutile de payer l’entrée 10 fois plus cher pour Cyber. Troisièmement, si vous êtes chercheur indépendant, commencez par demander Daybreak Blue, mais ne comptez pas accéder aux modèles Cyber par ce biais.
Quelles alternatives sont disponibles sur APIYI ?
Au 6 novembre 2026, gpt-6-cyber ne figure ni dans la liste des modèles ni dans l’interface de tarification d’APIYI (apiyi.com) : il n’est donc pas encore disponible sur la plateforme. La liste de référence des modèles et des prix se trouve sur apiyi.com/models. Nous proposerons GPT-6 Cyber dès que possible après son ouverture. Voici quelques modèles déjà disponibles sur APIYI, dont les capacités et les prix conviennent aux tâches liées à la sécurité.
| Modèle | Entrée / sortie / lecture du cache | Tarification par palier pour l’entrée | Cas d’usage |
|---|---|---|---|
gpt-6-astra |
10 / 50 / 1 dollars | 10 dollars de 0 à 272K ; 20 dollars de 272K à 1.05M | Modèle généraliste haut de gamme le plus proche de Cyber : audit de code, validation de vulnérabilités, génération de correctifs |
gpt-6.1-sol |
2 / 10 / 0.1 dollars | 2 dollars de 0 à 272K ; 4 dollars au-delà de 272K | Revue de code quotidienne, analyse de longs contextes ; meilleur rapport qualité-prix |
gpt-6.1-terra |
1 / 5 / 0.05 dollars | Sans palier | Compréhension de longs documents, revue de sécurité légère |
gpt-6-sol |
2 / 10 / 0.2 dollars | 2 dollars de 0 à 272K ; 4 dollars au-delà de 272K | Raisonnement général, synthèse de rapports |
gpt-6-luna |
0.1 / 0.5 / 0.01 dollars | 0.1 dollars de 0 à 272K ; 0.2 dollars au-delà de 272K | Analyse à grande échelle, premier tri des journaux, classification à faible coût |
Les prix du tableau sont indiqués pour 1 million de tokens et proviennent de la liste des modèles sur apiyi.com/models. Lorsque l’entrée dépasse le seuil correspondant, toute la requête est facturée au tarif du palier supérieur ; le prix de sortie est calculé en multipliant le prix d’entrée du palier correspondant par le coefficient de sortie. Tous ces modèles APIYI prennent en charge les deux points de terminaison Responses et Chat Completions. La facturation se fait à l’usage, sans abonnement mensuel.
Le choix dépend de la tâche. Pour comprendre un rapport de vulnérabilité et en tirer des recommandations de correction, utilisez gpt-6.1-sol. Pour auditer une base de code entière et demander au modèle de suivre les chaînes d’appels dans un long contexte, utilisez gpt-6-astra au palier supérieur. Pour un premier tri à grande échelle, utilisez gpt-6-luna pour repérer les points suspects, puis confiez leur vérification aux modèles précédents. Si vous devez réellement produire un exploit, APIYI ne propose actuellement aucune alternative : il faut passer par le processus d’approbation d’OpenAI Daybreak Red.
Créez un jeton dans la console apiyi.com, puis testez chacun des trois scénarios ci-dessus avec un petit budget. Ce sera plus utile que de consulter des scores de benchmarks pour décider si vous devez changer de modèle. Le centre de documentation d’APIYI détaille les points de terminaison, les limites de débit et la facturation de chaque modèle. En cas d’erreur 400 ou 429, vérifiez d’abord les paramètres et les limites indiqués dans la documentation.
Questions fréquentes
Q1 : Un particulier peut-il demander l’accès à GPT-6 Cyber ?
Pas directement via Daybreak Red. Les particuliers peuvent seulement demander l’accès à Daybreak Blue, qui ne comprend pas le modèle spécialisé Cyber. OpenAI précise que Red est actuellement réservé aux entreprises et organisations approuvées. Un particulier ne peut être invité que dans des circonstances exceptionnelles.
Q2 : Un score de 48,5 % sur ExploitGym, est-ce élevé ?
C’est 16 points de pourcentage de plus que GPT-5.6 Cyber et environ 6 points de plus que GPT-6 Astra : c’est l’un des meilleurs scores parmi les modèles commerciaux actuels. Cela ne signifie pas pour autant qu’il est meilleur dans tous les domaines : ses scores sur FrontierCyber et ExpertSWE sont légèrement inférieurs à ceux d’Astra.
Q3 : Un taux de dépassement du périmètre de 0,07 % est-il rassurant ?
Ce n’est pas zéro. Le résultat est environ 79 fois meilleur que celui de la génération précédente, mais le modèle peut encore toucher des services hors périmètre dans 7 tâches sur 10 000. En production, il faut combiner invite de déploiement, bac à sable, Auto-Review et supervision humaine.
Q4 : Quand GPT-6 Cyber sera-t-il disponible sur APIYI ?
Au 6 novembre 2026, il n’est pas encore disponible. Consultez apiyi.com/models pour connaître les modèles et leurs prix. Dès sa mise en ligne, nous mettrons cet article à jour et rendrons le modèle accessible sur la plateforme.
Q5 : Dois-je remplacer mon modèle actuel par GPT-6 Cyber ?
Seulement si vous devez développer des exploits utilisables, mener des opérations de red team autorisées ou valider des chaînes d’exploitation. Pour l’audit de code, la génération de correctifs et l’analyse de rapports de vulnérabilité, GPT-6 Astra ou GPT-6.1 Sol offrent un meilleur rapport coût-efficacité.
En résumé
L’intérêt de GPT-6 Cyber n’est pas d’être « meilleur en conversation », mais de progresser sur trois fronts à la fois : son score de 48,5 % sur ExploitGym montre qu’il est plus performant ; son taux de dépassement du périmètre de 0,07 % dans les tests avec des pots de miel indique qu’il respecte mieux les règles que la génération précédente ; et ses 948 exploits d’élévation de privilèges Linux et 81 vulnérabilités à haut risque dans Firefox montrent que ces résultats se concrétisent sur de vrais logiciels.
Ses limites sont toutefois claires : il ne surpasse pas Astra dans tous les domaines, son taux de dépassement n’est pas nul, les particuliers ne peuvent pas accéder à Red et son prix est dix fois celui de 6.1 Sol. Pour la plupart des équipes, la démarche la plus prudente consiste à commencer par fiabiliser les processus d’audit de code et de correction avec GPT-6 Astra ou GPT-6.1 Sol, puis à demander l’accès à Daybreak Red lorsque le développement d’exploits devient réellement nécessaire.
Pour faire un premier essai avec les modèles existants, vous pouvez créer un jeton à l’usage sur APIYI (apiyi.com), puis choisir un modèle dans le tableau en fin d’article. Pas besoin d’acheter un forfait au préalable.
Références
- Annonce d’OpenAI : https://openai.com/index/introducing-gpt-6-cyber
- Fiche système de GPT-6 Cyber : https://deploymentsafety.openai.com/gpt-6-cyber
- Page du modèle pour les développeurs (prix, points d’accès, limites de débit) : https://developers.openai.com/api/docs/models/gpt-6-cyber
- Centre d’aide Daybreak : https://help.openai.com/en/articles/20001258-openai-daybreak-trusted-access-for-cyber-overview
- Article de The Verge : https://www.theverge.com/ai-artificial-intelligence/1027599/openai-gpt-6-cyber-launch
- Tableau des modèles et des prix APIYI : https://docs.apiyi.com/models