Note de l’auteur : OpenAI annonce son intention d’acquérir Pierre. Cet article passe en revue ses cinq produits : Trees et Diffs, déjà utilisés par Codex, ainsi que Highlights, DiffsHub et le service payant Code Storage. De quoi repérer les composants open source que vous pouvez utiliser dès maintenant.
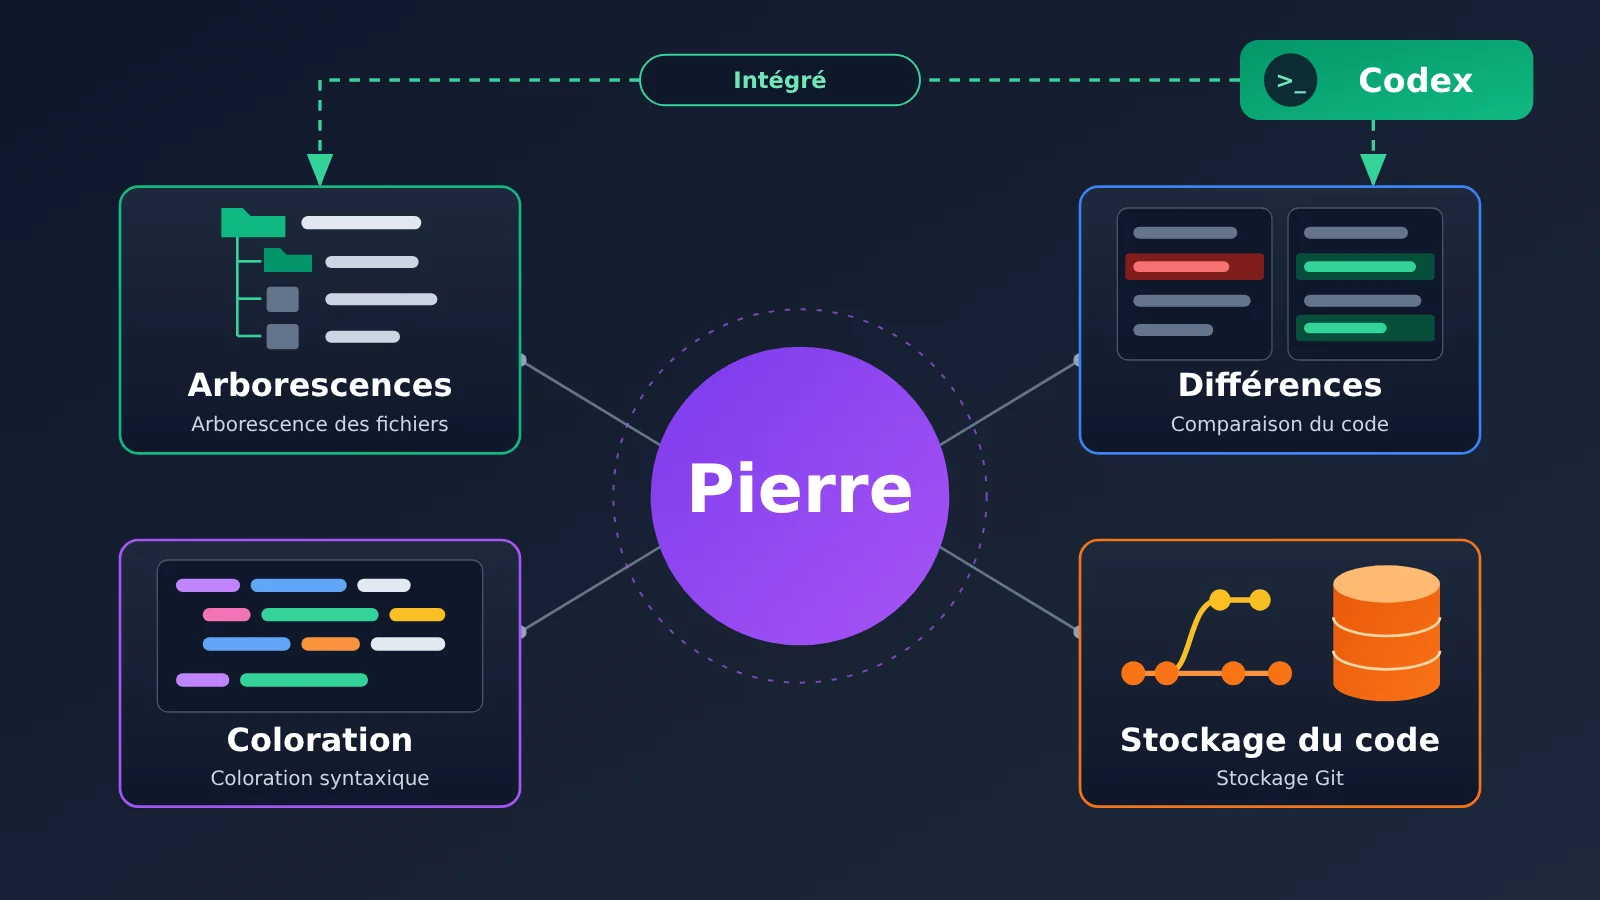
Le 4 novembre 2026, OpenAI a annoncé son intention d’acquérir Pierre Computer Company, une entreprise spécialisée dans les outils pour développeurs. Beaucoup ont d’abord pensé qu’OpenAI achetait une autre entreprise d’hébergement Git, mais ce n’est pas tout à fait ça. Pierre dispose d’un ensemble de technologies couvrant la navigation dans le code, la comparaison des différences, l’édition en ligne, la coloration syntaxique et le stockage Git. Deux de ses produits sont déjà intégrés à l’application Codex.
Ce n’est ni une rumeur ni une simple brève d’actualité. L’annonce officielle d’OpenAI confirme que Codex utilise les bibliothèques Trees et Diffs de Pierre. Les dépôts open source et les paquets NPM de Pierre sont également accessibles au public. Précisons toutefois que la transaction n’a pas encore été finalisée et que son montant n’a pas été communiqué.
L’essentiel : à la fin de cet article, vous disposerez d’une carte claire des produits et technologies de Pierre. Vous saurez distinguer les composants open source, les outils en ligne et le service de stockage payant, ainsi que les composants que vous pouvez intégrer dès aujourd’hui à vos projets.
L’essentiel du rachat de Pierre en un coup d’œil
Commençons par distinguer les faits confirmés des informations qui ne le sont pas encore. Le tableau ci-dessous reprend uniquement les éléments explicitement mentionnés dans l’annonce d’OpenAI et sur les canaux officiels de Pierre.
| Sujet | Informations confirmées | Informations non publiées ou non confirmées |
|---|---|---|
| État de la transaction | Projet de rachat annoncé le 2026-11-04, sous réserve des conditions habituelles de clôture et des approbations réglementaires | Date de clôture, montant du rachat, valorisation |
| Situation actuelle de Codex | L’application Codex utilise déjà les bibliothèques Trees et Diffs | Transfert éventuel du code des utilisateurs de Codex vers Code Storage |
| Projets à venir | Exploration progressive de l’intégration des fonctionnalités de Code Storage à Codex | Calendrier d’intégration complet et nouveaux tarifs |
| Engagement open source | Les projets open source de Pierre restent ouverts, et OpenAI continue d’y contribuer | Plans de maintenance à long terme des différentes versions |
| Clients existants | Les clients actuels de Code Storage pourront continuer à l’utiliser après la transaction | Politique tarifaire à long terme et modalités de migration des données |
Jusqu’à la clôture de la transaction, les deux entreprises continuent de fonctionner indépendamment. Axios voit dans cette opération une incursion de Codex dans le domaine de la collaboration autour du code, dominé de longue date par GitHub. Il s’agit toutefois d’une analyse du média sur l’évolution de la concurrence : OpenAI n’a pas annoncé le lancement d’une solution complète destinée à remplacer GitHub.
Panorama technique de Pierre : composants open source, outil en ligne et stockage payant
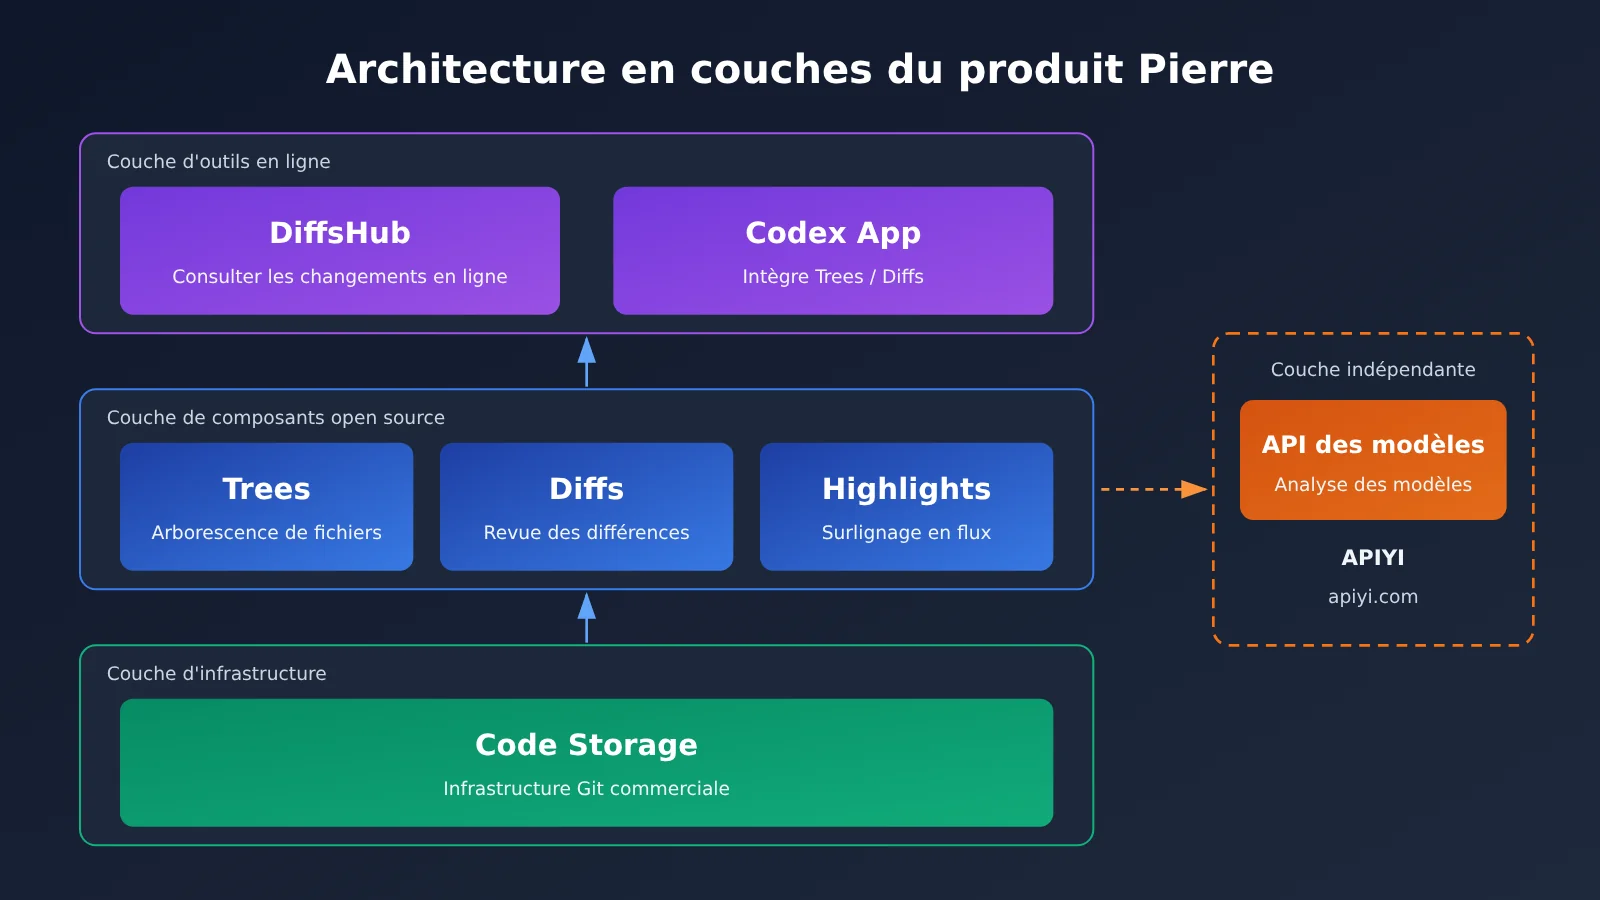
Pour comprendre Pierre, le plus simple est de décomposer son offre en trois niveaux. Pierre n’est pas une entreprise spécialisée dans l’entraînement de grands modèles de langage et ne vend pas d’API de modèles. Elle développe les logiciels et l’infrastructure nécessaires pour afficher, modifier, stocker et gérer du code. Son site officiel la présente comme une « infrastructure de bas niveau et composable pour les charges de travail pilotées par des machines ».
| Produit | Niveau | Problème résolu | Accès |
|---|---|---|---|
| Trees | Composant open source | Comment parcourir les fichiers d’un projet | pnpm add @pierre/trees |
| Diffs | Composant open source | Comment consulter, comparer et modifier les changements de code | pnpm add @pierre/diffs |
| Highlights | Fonction de coloration syntaxique (bêta) | Comment afficher rapidement la coloration syntaxique en streaming | Voir la documentation officielle de Diffs |
| DiffsHub | Outil en ligne | Comment parcourir les changements de code GitHub dans une page web | Visiter diffshub.com |
| Code Storage | Service commercial | Comment stocker du code à grande échelle via Git et une API | Facturation à l’usage, avec un minimum mensuel |
La partie open source se trouve dans le dépôt GitHub pierrecomputer/pierre, sous licence Apache 2.0. Au 2026-11-05, le dépôt comptait environ 6 500 étoiles, 266 forks et 1 320 commits. Ces chiffres sont susceptibles d’évoluer. Attention : ce dépôt ne contient pas l’ensemble du code backend commercial de Code Storage.
Pierre Diffs à la loupe : Edit Mode, interface de revue et Merge Conflict
Le paquet open source de Diffs s’appelle @pierre/diffs. Au moment de la vérification, le site officiel indiquait la version v1.6.4 et le point d’entrée React @pierre/diffs/react. Il permet d’afficher dans une page web des fichiers de code, des patches et les différences entre deux versions. Il propose deux vues : Split, côte à côte, et Stacked/Unified, qui regroupe les changements verticalement. Les différences peuvent être mises en évidence à l’intérieur d’une ligne, caractère par caractère ou mot par mot. Les développeurs peuvent fournir deux versions d’un fichier ou directement un fichier Patch.
Diffs Edit Mode : modifier le code directement dans la vue des différences
OpenAI a spécialement mentionné cette fonctionnalité dans son annonce : la personne qui effectue la revue peut modifier une ligne de code directement dans la vue Diff. Edit Mode prend en charge les sélections et les sélections multiples, l’indentation automatique, Undo/Redo, la recherche dans le fichier, les marqueurs de lint, les actions d’édition personnalisées, ainsi que les curseurs locaux et distants. Le projet fournit EditProvider et les API Editor associées. Certaines fonctionnalités d’édition sont encore indiquées comme étant en bêta.
Cette fonctionnalité répond à un problème concret : dans un processus traditionnel, lorsqu’une ligne de code générée par une IA pose problème, il faut passer à l’éditeur complet, retrouver le fichier, le modifier, puis revenir à l’interface de revue. Edit Mode réunit la détection et la correction des problèmes dans une même interface. C’est particulièrement utile lorsqu’un agent génère de nombreuses modifications que des humains vérifient progressivement.
Interface de revue de code Diffs : un framework Annotation extensible
Diffs fournit un framework Annotation flexible qui permet d’associer à des lignes de code précises des commentaires, des résultats de vérifications CI, des remarques de revue par IA ou des sorties d’outils tiers. Les développeurs peuvent aussi ajouter à la vue des différences des boutons personnalisés comme Accept Change et Reject Change, permettre les réponses aux commentaires et joindre des explications aux lignes sélectionnées.
Il faut toutefois bien distinguer les rôles : Diffs est un composant d’affichage et d’interaction, pas un modèle d’IA qui détecte automatiquement les vulnérabilités. C’est votre système qui détermine d’où viennent les remarques : il peut par exemple faire appel à une API de Grand modèle de langage pour générer des suggestions, puis les transmettre à Diffs pour les afficher.
Diffs Merge Conflict : une gestion structurée des conflits
Face à un conflit de fusion, un Diff textuel classique ne peut afficher qu’une série de marqueurs de conflit. Diffs propose une interface dédiée qui présente la zone concernée sous forme structurée, avec les ajouts et les suppressions. L’utilisateur peut choisir de conserver la version actuelle, d’adopter la version entrante ou de garder les deux, puis prévisualiser le fichier après résolution.
Sur le plan technique, la documentation officielle indique que Diffs prend en charge Vanilla JavaScript et React. Il utilise Shiki pour la coloration syntaxique, ainsi que CSS Grid et Shadow DOM pour organiser une partie de la structure de rendu. Il fournit aussi des outils SSR, un Worker Pool et un rendu virtualisé. Ce dernier évite au navigateur d’afficher en une seule fois une grande quantité de contenu invisible.
Pierre Trees et Highlights : grandes arborescences de fichiers et coloration en streaming
Trees : un composant d’arborescence conçu pour les grands dépôts
Le paquet open source de Trees s’appelle @pierre/trees. Au moment de la vérification, la version affichée sur le site officiel était la v1.0.0-beta.6. Il gère le volet de navigation des fichiers à gauche dans des outils comme Codex : développement et réduction des dossiers, recherche et filtrage par nom ou par chemin, compression automatique des chaînes de dossiers vides à un seul sous-dossier, glisser-déposer de fichiers et de dossiers, création et renommage, menus contextuels et icônes de fichiers personnalisables.
La fonctionnalité la plus pertinente pour la programmation avec l’IA est l’affichage de l’état Git. Les fichiers peuvent être accompagnés des indicateurs M (modifié), A (ajouté et indexé), D (supprimé), R (renommé) et U (non suivi). Les dossiers parents contenant des fichiers modifiés peuvent également afficher un indicateur. Lorsqu’un agent modifie des dizaines de fichiers d’un coup, un coup d’œil à l’arborescence suffit pour repérer où se trouvent les changements.
Côté performances, Trees utilise la virtualisation automatique pour afficher en priorité les lignes visibles à l’écran. Le site officiel présente une arborescence contenant 2 956 fichiers une fois entièrement développée, ainsi qu’un rendu virtualisé de plusieurs dizaines de milliers d’éléments. Il s’agit de démonstrations officielles, pas de tests de performance indépendants : elles ne garantissent donc pas un résultat identique sur tous les appareils. Pour l’accessibilité, Trees propose notamment la navigation avec les touches fléchées, la gestion du focus avec Tab et les rôles ARIA tree/treeitem. Selon l’équipe officielle, sa conception suit les recommandations pertinentes de WCAG 2.1.
Highlights : un outil de coloration qui suit le rythme des agents
Highlights est actuellement présenté en version bêta dans la documentation officielle de Diffs. Celle-ci indique qu’il intègre des analyseurs lexicaux pour 152 langages. Basé sur WebAssembly, il fonctionne dans le navigateur, Node.js et Cloudflare Workers, et produit du HTML ou des objets Token compatibles avec Shiki.
Ses quatre principales API ont chacune un rôle précis : codeToHtml() traite le code complet, codeToTokens() produit des Token organisés par ligne, StreamTokenizer convient à la réception progressive de contenu et renvoie les lignes terminées, tandis que LiveTokenizer effectue des mises à jour incrémentales pour les documents en cours d’édition. En bref, Highlights résout un problème d’affichage : comment maintenir la coloration à jour pendant qu’un agent génère du code en streaming. Il n’améliore pas les capacités de programmation du modèle lui-même.
DiffsHub : remplacez github.com par diffshub.com
DiffsHub est l’outil en ligne de Pierre qui montre Trees et Diffs en action dans des situations réelles. Remplacez github.com par diffshub.com dans les liens GitHub de Pull Request, Commit, Comparison, Patch ou Diff pour parcourir les mêmes modifications dans l’interface de Pierre. Les exemples officiels incluent notamment les dépôts oven-sh/bun et nodejs/node.
Pour accéder à un dépôt privé, vous devez fournir votre propre Personal Access Token GitHub disposant des autorisations nécessaires. Le site officiel précise que le Token est conservé dans le localStorage du navigateur, ce qui ne signifie pas que Pierre peut accéder librement aux dépôts privés. Le site avertit également que les navigateurs mobiles peuvent planter face à des Diff extrêmement volumineux. DiffsHub n’est ni un substitut à GitHub, ni la bibliothèque open source Diffs elle-même.
En quoi Pierre Code Storage diffère-t-il d’un dépôt GitHub classique ?
Si Trees et Diffs constituent l’interface qui permet de « voir le code », Code Storage est l’infrastructure qui le stocke. C’est aussi le point stratégique de cette transaction. Il s’agit d’un service de stockage distribué et programmable basé sur Git, conçu pour les produits d’IA qui doivent créer, lire, modifier et synchroniser un grand nombre de dépôts.
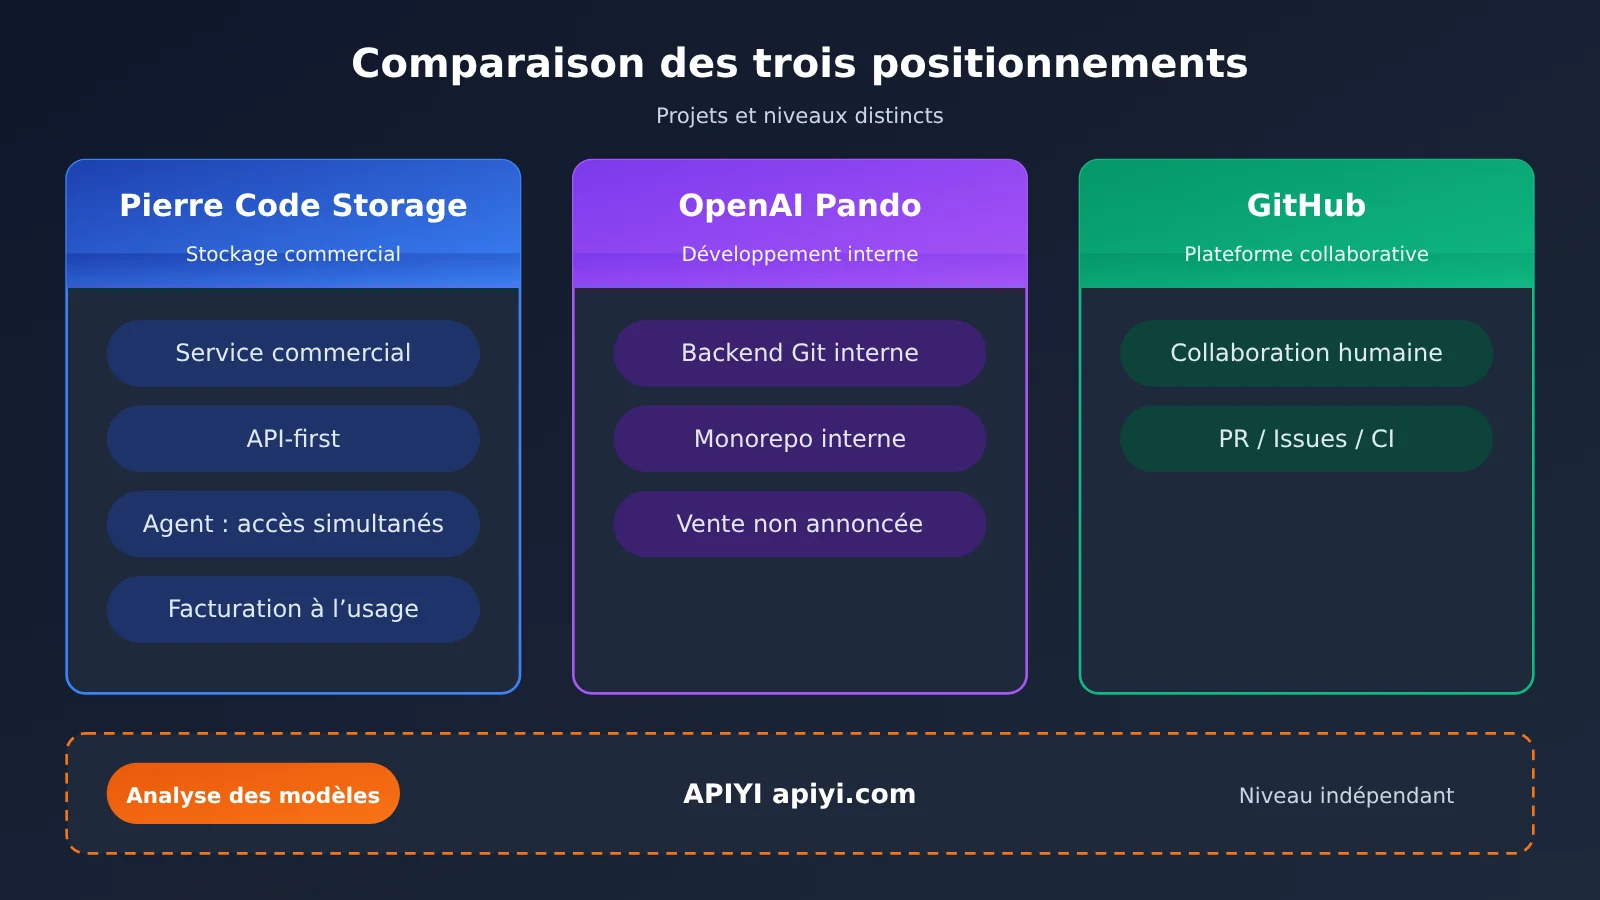
GitHub s’articule avant tout autour de la collaboration humaine : dépôts, PR, Issues et CI/CD. Code Storage met l’accent sur une approche sans interface graphique et API-first. Il permet de créer des dépôts, des commits et des branches, ou d’effectuer des merges via une API. Il permet aussi d’écrire directement dans des fichiers, de les lire en streaming et de filtrer une base de code avec Grep et Glob. Le service propose des branches temporaires (Ephemeral Branches), des webhooks, Git LFS et une synchronisation avec GitHub, GitLab et Bitbucket. Les commandes Git standard Clone, Push et Fetch sont également disponibles via HTTPS.
Dans la discussion consacrée à Code Storage sur Hacker News (66 points, 42 commentaires), Pierre a donné un exemple : après la modification de 10 fichiers par un agent, une soumission via l’API REST de GitHub demande de récupérer le SHA de la branche, de créer une branche, des blobs, un arbre et un commit, puis de mettre à jour la référence. Cela représente environ 15 requêtes. En cas de forte charge, il faut aussi gérer les erreurs 422 liées à la cohérence éventuelle. Avec Code Storage, un seul appel à createCommitFromDiff suffit pour soumettre le diff complet. Il s’agit de l’explication donnée par le fournisseur dans la communauté, et non d’un test comparatif indépendant.
| Indicateur (données publiées par le fournisseur) | Valeur | Nature de la donnée |
|---|---|---|
| Taille maximale par dépôt | 32 To | Spécification du produit |
| Stockage total et nombre de dépôts | Pas de limite générale | Spécification du produit |
| Écritures simultanées | 30+ | Spécification du produit |
| Requêtes Git par dépôt | Plus de 500 par seconde observées | Donnée observée par le fournisseur, non garantie |
| Requêtes API | Plus de 15 000 par seconde observées | Donnée observée par le fournisseur, non garantie |
| Disponibilité | SLA de 99,99 % | Engagement de service, et non taux de disponibilité historique mesuré de façon indépendante |
Côté architecture, le fournisseur indique utiliser un protocole de validation Git en trois phases et une architecture de type « Spoke-like » fondée sur un quorum, afin de garantir la cohérence et la durabilité dans un environnement distribué. Il n’a toutefois pas publié la topologie complète du cluster. Pour les entreprises, il annonce également SOC 2 Type II, une prise en charge liée à HIPAA, le chiffrement par locataire et des tests d’intrusion annuels. Il reste conseillé de vérifier les rapports et les clauses contractuelles avant tout achat.
Les cas clients ont eux aussi été publiés par Pierre. Celui de Lovable fait état de plus de 8 millions de nouveaux dépôts par semaine, avec un pic de création de 250 dépôts par seconde. Poke utilise Git pour stocker la mémoire de ses agents et la configuration de ses workflows, et annonce une latence Push P95 de 90 millisecondes. Chez Skydive, plus de 150 agents disposent chacun d’un dépôt privé pour conserver leur définition d’identité, leur configuration MCP, leurs Skills et leur mémoire persistante. Ces exemples illustrent une tendance : les dépôts Git ne servent plus seulement à « stocker du code », mais aussi à « stocker l’état des agents ».
Dernières évolutions du SDK, du CLI et des Agent Skills de Pierre
Le 3 novembre 2026, la veille de l’annonce de l’acquisition, Pierre a publié un nouveau SDK et un nouveau CLI unifiés. Le principal changement : le SDK, le CLI et l’API HTTP utilisent les mêmes noms d’opérations. Par exemple, pour créer une branche, on utilise respectivement pierre.repos.branches.create(), pierre repos:branches create et /api/repos/{repo_name}/branches/create. Un agent peut ainsi passer d’une interface à l’autre en s’appuyant sur le même « catalogue d’opérations ».
# SDK TypeScript (Node.js 22 / 24 / 26)
npm install @pierre/sdk

# SDK Python (Python 3.10+)
pip install pierre-sdk

# SDK Go (Go 1.25+)
go get github.com/pierrecomputer/sdk/go

# CLI
npm install -g @pierre/cli

# Installer les Pierre Skills pour les agents de programmation
npx skills add pierrecomputer/skills

# Créer une branche à partir de main avec le CLI
pierre repos:branches create feature/preview --repo-name my-repo --base-ref main
L’authentification utilise deux variables d’environnement, PIERRE_ORG et PIERRE_PRIVATE_KEY. Pour chaque opération, le SDK émet un jeton valable 5 minutes, dont les permissions correspondent à l’opération. Le nouveau SDK remplace les anciens packages @pierre/storage, pierre-storage et code-storage-go. Ceux-ci restent utilisables, mais ne recevront plus de nouvelles versions. À noter : ce SDK et ce CLI sont destinés à Code Storage. Cela ne signifie pas que le CLI Codex d’OpenAI dispose de nouvelles commandes intégrées.
Comment fonctionne la tarification de Pierre Code Storage ?
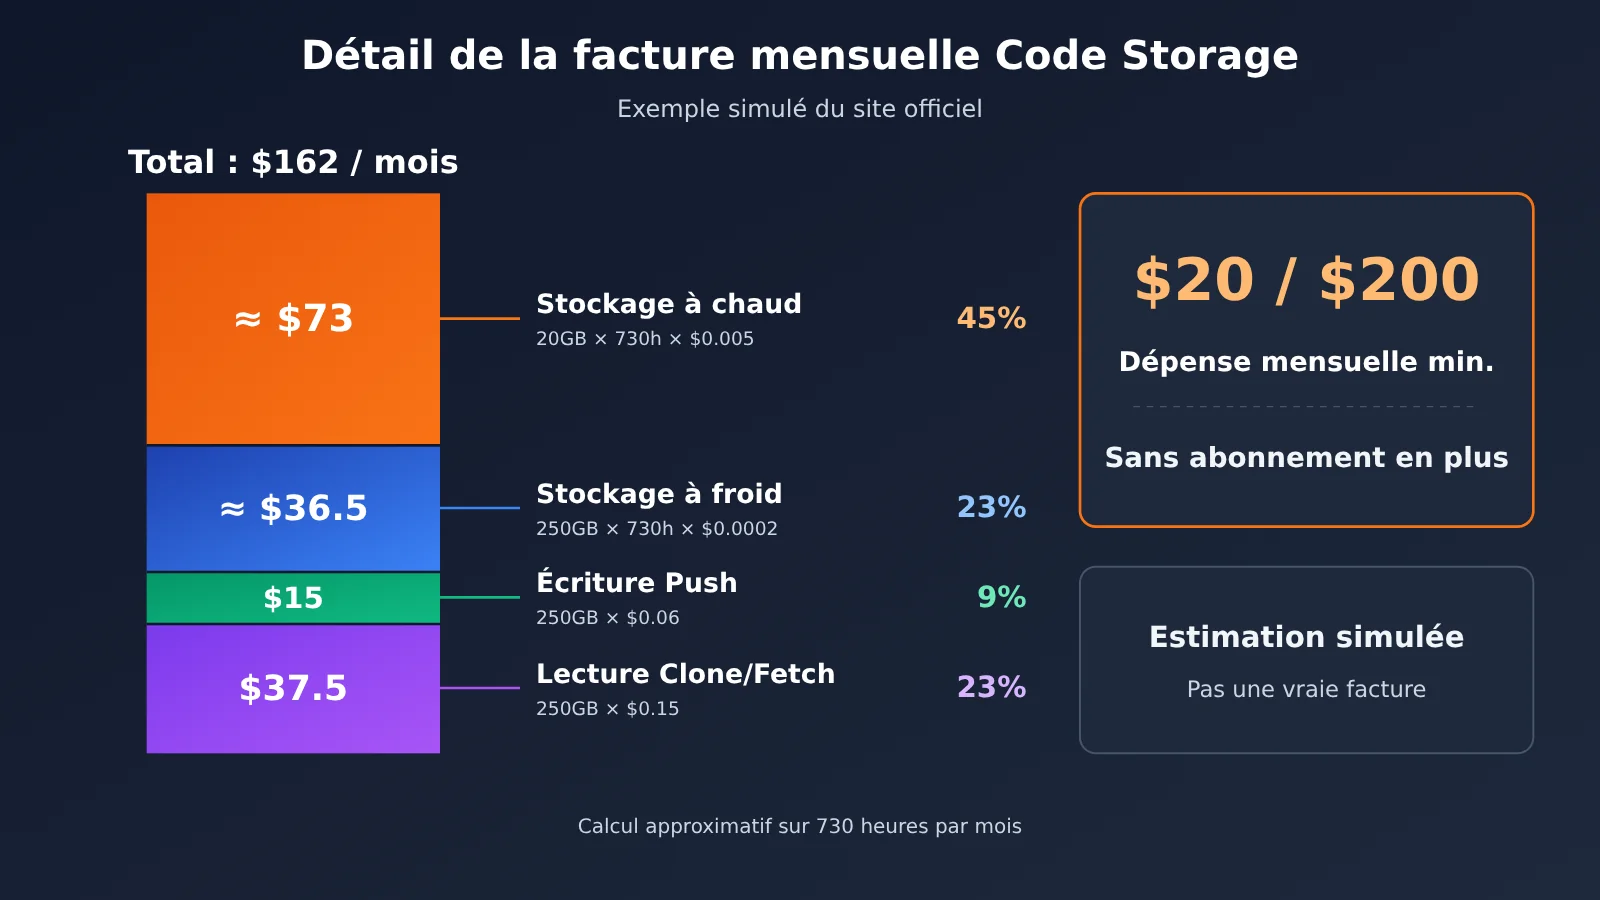
La tarification de Code Storage prête facilement à confusion. Les montants affichés pour Starter ($20/mois) et Scale ($200/mois) correspondent à une dépense mensuelle minimale, et non à un abonnement fixe ajouté aux frais d’utilisation. Ainsi, si un utilisateur Starter dépasse $20 d’utilisation dans le mois, il paie sa consommation réelle ; sinon, il est facturé $20.
| Poste de facturation | Prix | Détails |
|---|---|---|
| Starter | Dépense minimale de $20/mois | Multilocataire, assistance par courriel |
| Scale | Dépense minimale de $200/mois | Option monolocataire, SSO, assistance 24 h/24 et 7 j/7 |
| Enterprise | Contrat personnalisé | Options réseau, notamment VPC ; prix non publics |
| Stockage chaud Hot | $0.005/Go/heure | Données consultées au cours des 7 derniers jours |
| Stockage froid Cold | $0.0002/Go/heure | Données non consultées depuis plus de 7 jours |
| Écriture Push | $0.06/Go | Facturation mensuelle |
| Lecture Clone/Fetch | $0.15/Go | Facturation mensuelle |
L’exemple du simulateur officiel donne une estimation d’environ $162/mois pour 20 Go de stockage chaud, 250 Go de stockage froid, ainsi que 250 Go d’écriture et 250 Go de lecture. Sur la base d’environ 730 heures par mois, cela représente environ $73 pour le stockage chaud, $36.5 pour le stockage froid, $15 pour l’écriture et $37.5 pour la lecture, soit exactement $162 au total. Le trafic de lecture représente une part importante de la facture : c’est l’une des raisons pour lesquelles certains développeurs critiquent les frais de trafic réseau sur HN. Il s’agit toutefois d’une estimation simulée, pas d’une facture réelle. De plus, cette tarification est entièrement distincte de celle de l’abonnement Codex et des tokens des modèles OpenAI.
Prise en main rapide de la stack Pierre : créer un prototype de revue par IA avec Diffs
Les composants Pierre ne fournissent pas de modèle. Une solution pratique consiste donc à récupérer les modifications avec git diff, à appeler l’API d’un grand modèle de langage pour générer des commentaires ligne par ligne, puis à transmettre les résultats à Diffs sous forme d’annotations. Le schéma ci-dessous illustre cette architecture : il ne signifie pas qu’OpenAI propose une API intégrée correspondante.
| Couche | Produits représentatifs | Rôle dans le processus de revue | Plateformes disponibles |
|---|---|---|---|
| Stockage | Code Storage / GitHub | Conserver les dépôts, les branches et l’historique | Pierre officiel, plateformes d’hébergement Git |
| Modèle | GPT, Claude, Gemini, etc. | Lire le Diff et générer des commentaires de revue | APIYI apiyi.com, API officielles des fournisseurs |
| Interface | Diffs + Trees | Afficher les modifications, ajouter les commentaires et modifier les lignes sur place | @pierre/diffs, @pierre/trees |
Cet exemple minimal tient en une quinzaine de lignes : il transmet le diff au modèle et lui demande de retourner du JSON.
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible avec OpenAI
)

diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Remplacer par n’importe quel modèle disponible sur la plateforme
    messages=[{"role": "user", "content": f"逐行审查以下 diff,返回 JSON 列表 [{{file, line, comment}}]:\n{diff}"}]
)
print(resp.choices[0].message.content)
Voir le code complet (avec analyse JSON et solution de repli)
import json
import subprocess
from typing import List, Dict
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是资深代码审查员。只针对 diff 中新增或修改的行给出意见,"
    "严格输出 JSON 数组,每项包含 file、line、severity、comment 四个字段。"
)

def get_diff(base: str = "HEAD~1") -> str:
    result = subprocess.run(
        ["git", "diff", base], capture_output=True, text=True, check=True
    )
    return result.stdout

def review_diff(diff: str, model: str = "gpt-4o-mini") -> List[Dict]:
    if not diff.strip():
        return []
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": diff[:60000]},  # Troncature simple pour éviter un contenu trop long
        ],
        temperature=0.2,
    )
    text = resp.choices[0].message.content.strip()
    text = text.removeprefix("```json").removesuffix("```").strip()
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        return [{"file": "", "line": 0, "severity": "info", "comment": text}]

if __name__ == "__main__":
    annotations = review_diff(get_diff())
    # Écrire les résultats dans un fichier ; le front-end utilise les annotations de @pierre/diffs pour les associer aux lignes correspondantes
    with open("review_annotations.json", "w", encoding="utf-8") as f:
        json.dump(annotations, f, ensure_ascii=False, indent=2)
    print(f"生成 {len(annotations)} 条审查意见")
Pour le front-end, installez @pierre/diffs, puis associez les commentaires de review_annotations.json aux fichiers et numéros de ligne correspondants dans la vue Diff. Utilisez ensuite Edit Mode pour permettre aux personnes qui effectuent la revue de modifier le code sur place. Pour les paramètres précis des composants, consultez la documentation officielle sur diffs.com/docs.
🚀 Pour commencer : pour créer ce type de prototype, vous pouvez accéder aux modèles via APIYI apiyi.com. Une seule clé permet de passer de GPT à Claude ou Gemini, et de comparer facilement la qualité de leurs revues sur votre dépôt de code. Les nouveaux utilisateurs bénéficient aussi d’un crédit d’essai gratuit.
Analyse des effets de l’acquisition de Pierre
Pour les développeurs
- Des composants open source utilisables dès maintenant : Diffs et Trees sont déjà utilisés en production dans Codex. Sous licence Apache-2.0, ils conviennent à la création de barres latérales pour assistants de programmation IA, de plateformes de revue internes ou d’espaces de travail pour agents. OpenAI s’est aussi engagé à continuer de les proposer en open source.
- La revue devient un goulot d’étranglement plus tôt dans le processus : OpenAI indique que le nombre hebdomadaire de PR en interne a plus que doublé par rapport à la période précédente du quatrième trimestre. À mesure que la génération de code s’accélère, une interface de revue qui permet de bien comprendre le code et de le modifier rapidement devient essentielle pour gagner en efficacité.
- Une nouvelle piste pour stocker l’état des agents : les exemples de Poke et Skydive montrent que Git peut servir à stocker la mémoire et la configuration des agents, avec un historique et des possibilités de retour arrière intégrés.
Pour le secteur
- Codex couvre une plus grande partie du cycle de développement : il s’étend désormais de la génération et de la revue au stockage. Mais au 5 novembre 2026, rien n’indique que l’intégration à GitHub sera supprimée.
- Ne confondez pas Pando et Code Storage : Pando, présenté par OpenAI le 2 novembre, est un backend Git développé en interne pour prendre en charge son monorepo. C’est un projet distinct de Code Storage de Pierre.
- Les retours de la communauté ne permettent pas encore de conclure : dans les discussions sur HN, certains s’interrogent sur l’archivage en stockage à froid et les différences de positionnement avec GitHub, tandis que d’autres critiquent la facturation du trafic. Quelques dizaines de commentaires ne représentent pas toute la communauté des développeurs, et il n’existe pas encore d’évaluation indépendante à grande échelle.
Questions fréquentes (FAQ)
Q1 : Pierre est-elle une entreprise d’hébergement Git ?
Pas tout à fait. Pierre propose aussi des composants front-end open source (Diffs, Trees), des fonctions de coloration syntaxique (Highlights), un outil en ligne (DiffsHub) et un service commercial de stockage Git (Code Storage). La présenter uniquement comme une plateforme d’hébergement Git ferait passer à côté des technologies d’interface que Codex utilise déjà.
Q2 : OpenAI a-t-elle déjà finalisé l’acquisition de Pierre ?
Non. Le 4 novembre 2026, OpenAI a seulement annoncé son intention de l’acquérir. La transaction reste soumise aux conditions habituelles de clôture et aux autorisations réglementaires. Son montant et sa date de finalisation n’ont pas été communiqués. D’ici là, les deux entreprises continuent de fonctionner indépendamment.
Q3 : Les 20 $/mois de Code Storage correspondent-ils à un nouveau tarif pour Codex ?
Non. Il s’agit de la dépense mensuelle minimale du forfait Starter de Pierre Code Storage. Elle n’a aucun lien avec les abonnements Codex ni avec le prix des tokens des modèles. L’annonce de l’acquisition ne mentionne d’ailleurs aucun nouveau tarif pour les forfaits Codex.
Q4 : Quels composants Pierre puis-je utiliser directement dans mon projet ?
Les plus simples à intégrer sont `@pierre/diffs` et `@pierre/trees`. Ce sont deux packages NPM publics compatibles avec Vanilla JS et React. Highlights est actuellement indiqué comme étant en version bêta dans la documentation de Diffs. DiffsHub est un outil en ligne, tandis que Code Storage est payant.
Q5 : Comment ajouter des commentaires de revue par IA à l’interface de Diffs ?
Diffs ne gère que l’affichage et les interactions : vous devez générer les commentaires vous-même. Comme dans l’exemple de cet article, vous pouvez envoyer un `git diff` à un grand modèle de langage, puis rattacher les commentaires renvoyés à chaque ligne sous forme d’Annotation. Pour invoquer le modèle, vous pouvez utiliser l’interface compatible OpenAI d’APIYI, apiyi.com : il suffit de modifier le base_url pour réutiliser votre code existant. Après inscription, un crédit gratuit permet de tester le processus de bout en bout.
Q6 : APIYI peut-elle se connecter directement à Pierre Code Storage ?
Non, aucune intégration de ce type n’existe actuellement. APIYI, apiyi.com, propose un service d’agrégation d’API de grands modèles de langage, qui correspond à la couche modèle du processus de revue. Code Storage doit être intégré séparément à l’aide du SDK ou de la CLI officielle de Pierre. Les deux peuvent être combinés dans une même architecture, mais ce ne sont pas le même produit.
Pierre Trees, Diffs et Code Storage : l’essentiel
- Trois couches : Pierre se compose de composants open source, d’outils en ligne et d’un service de stockage payant. Ce n’est pas une plateforme Git unique.
- Intégration confirmée : Codex App utilise déjà Trees et Diffs ; l’intégration de Code Storage est prévue ultérieurement.
- Points forts de Diffs : modification en ligne avec Edit Mode, interface de revue avec Annotation et gestion structurée des conflits de fusion.
- Points forts de Trees : rendu virtualisé des grandes arborescences de fichiers et affichage natif des statuts Git M/A/D/R/U.
- Positionnement de Code Storage : une infrastructure Git conçue autour d’une API ; les données de performance sont toutes déclarées par le fournisseur.
- Tarification : 20 $/200 $ correspondent à une consommation mensuelle minimale. La facturation dépend du stockage et du trafic, sans abonnement supplémentaire.
- Pour commencer : installez le composant Diffs, puis accédez aux modèles via APIYI apiyi.com pour créer un prototype de revue.
Conclusion
L’essentiel de la technologie Pierre tient en trois points :
- La couche d’interface a fait ses preuves : Trees et Diffs fonctionnent déjà dans Codex et sont des composants open source que vous pouvez intégrer gratuitement dès aujourd’hui.
- La couche de stockage est l’enjeu stratégique : Code Storage transforme Git en infrastructure programmable pour les agents, mais les données sur son échelle et ses performances restent déclarées par le fournisseur.
- Il faut bien distinguer les périmètres : l’acquisition envisagée n’a pas encore été finalisée, Pando n’a aucun lien avec Code Storage, et la tarification du stockage est distincte de celle des modèles.
Si vous développez un outil de programmation assistée par IA ou une plateforme interne de revue de code, le plus pragmatique est de commencer par créer l’interface avec @pierre/diffs et @pierre/trees, puis d’intégrer un grand modèle de langage pour générer des commentaires de revue. Pour vérifier rapidement les résultats, vous pouvez passer par APIYI apiyi.com : une seule interface permet de comparer les performances de plusieurs modèles sur votre base de code.
📚 Références
- Annonce de l’acquisition par OpenAI : OpenAI to acquire Pierre Computer Company, Inc.
- Lien :
openai.com/index/openai-to-acquire-pierre -
Description : source officielle sur l’état de la transaction, les composants déjà utilisés par Codex et les engagements en matière d’open source
-
Site officiel et documentation de Diffs : présentation du composant Diffs, d’Edit Mode et de Highlights
- Lien :
diffs.com/docs -
Description : exemples interactifs et documentation complète de l’API
-
Site officiel de Trees : démonstration du composant d’arborescence de fichiers
- Lien :
trees.software -
Description : informations sur l’état Git, la virtualisation et l’accessibilité
-
Tarifs de Code Storage : tarification officielle et simulateur de prix
- Lien :
code.storage/pricing -
Description : minimum mensuel de facturation et détail de la facturation à l’usage
-
Notes de version de Pierre SDK and CLI : mise à jour du 2026-11-03
- Lien :
code.storage/changelog/pierre-sdk-and-cli -
Description : commandes d’installation, exigences système et noms unifiés
-
Dépôt open source de Pierre : code source sous licence Apache-2.0
- Lien :
github.com/pierrecomputer/pierre -
Description : code source des composants et actualités de la communauté
-
Scaling Git at OpenAI : présentation de Pando, développé par OpenAI
- Lien :
openai.com/index/scaling-git-at-openai - Description : pour distinguer Pando de Code Storage
Auteur : équipe technique APIYI
Échanges techniques : si vous souhaitez comparer plusieurs grands modèles de langage dans un projet de revue de code par IA, rendez-vous sur APIYI apiyi.com pour obtenir un crédit de test et échanger avec nous.