Note de l’auteur : OpenAI prévoit d’acquérir Pierre, mais la transaction n’est pas encore finalisée. Cet article fait le point sur les faits confirmés et analyse ce que l’extension de Codex à la gestion du code source et à la revue de code signifie sur le plan stratégique.
Le 4 novembre 2026, OpenAI a annoncé son intention d’acquérir l’entreprise d’outils pour développeurs Pierre Computer Company, Inc. : le champ d’action de Codex s’étend de « l’écriture de code » à « la gestion et la revue de code ». Trees et Diffs de Pierre sont déjà utilisés dans l’application Codex : cette transaction n’est donc pas le premier rapprochement technique entre les deux entreprises.
Ce n’est pas une simple acquisition d’outils, mais cela ne signifie pas non plus qu’OpenAI a déjà lancé une alternative à GitHub. L’idée d’un « défi à GitHub » relève surtout de l’analyse concurrentielle de médias comme Axios. Dans sa communication officielle, OpenAI met plutôt l’accent sur le développement des capacités de Codex à créer, comprendre et examiner le code.
À retenir : cet article vous aidera à comprendre ce qui est confirmé, ce qui reste inconnu et pourquoi la concurrence dans la programmation assistée par l’IA commence à s’étendre à la gestion du code source.
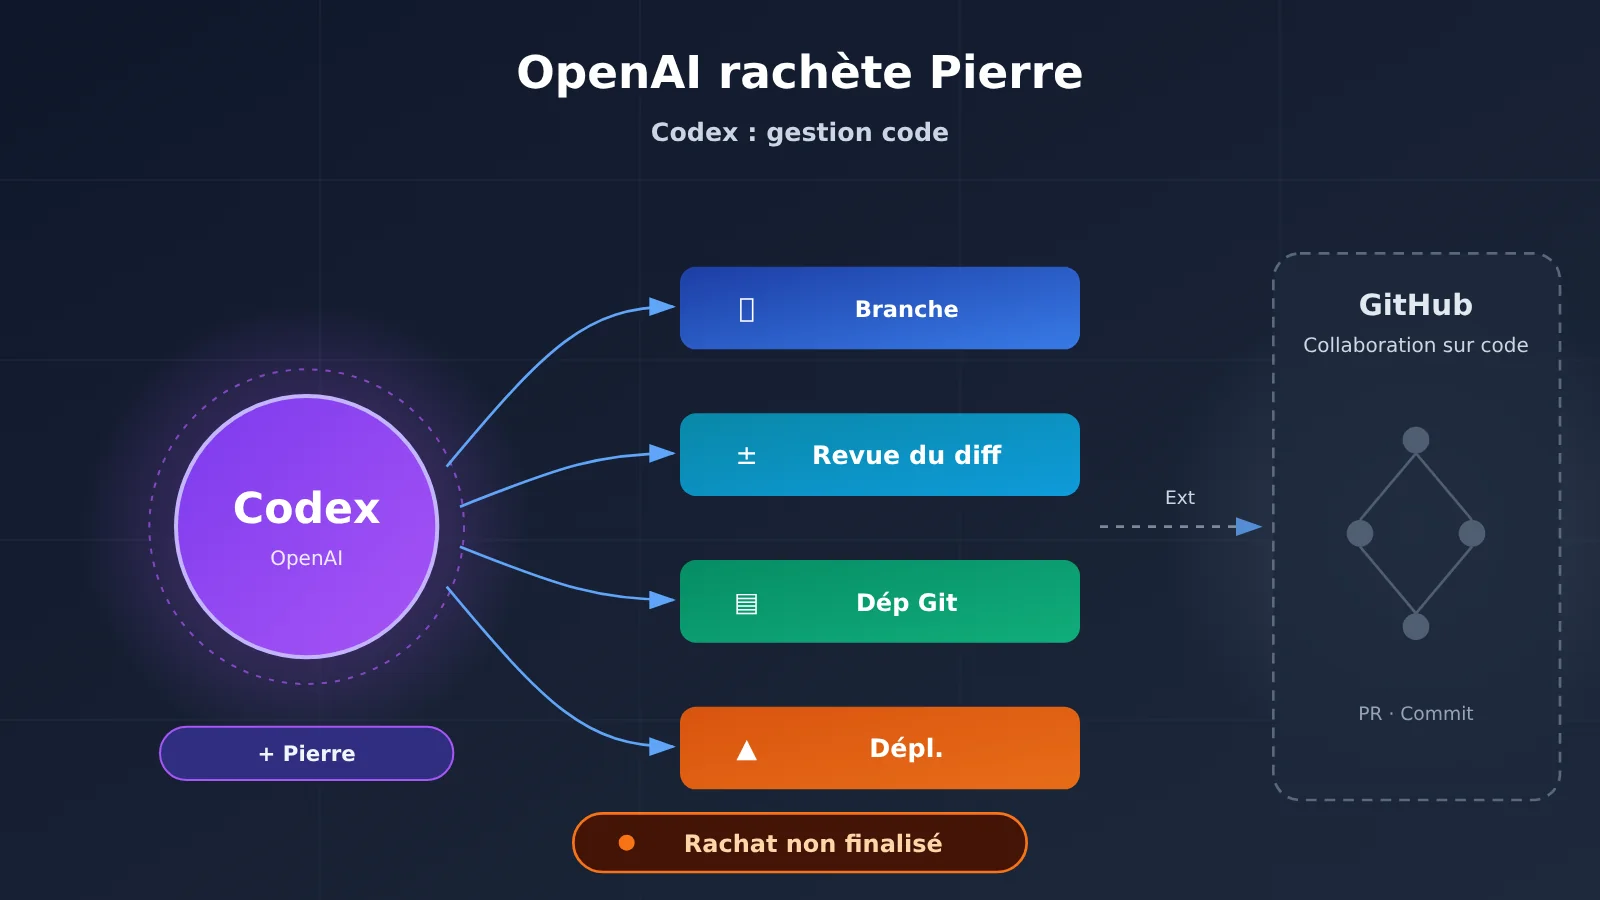
L’essentiel de l’acquisition de Pierre par OpenAI
| Élément | Informations publiées | Points à garder en tête |
|---|---|---|
| Date de l’annonce | 4 novembre 2026 | Annonce officielle d’OpenAI |
| Statut de la transaction | Acquisition prévue, pas encore finalisée | Soumise aux conditions habituelles, notamment aux autorisations réglementaires |
| Organisation des activités | Les deux entreprises continuent d’opérer indépendamment jusqu’à la finalisation | Le plan d’intégration des équipes n’a pas été communiqué |
| Montant de la transaction | Non divulgué | La valorisation et la répartition du capital ne sont pas non plus connues |
| Engagement open source | Les projets open source de Pierre le resteront | Les plans de maintenance à long terme des différentes versions restent flous |
| Clients existants | Ils pourront continuer à utiliser Code Storage après la finalisation | La politique tarifaire à long terme reste floue |
Quelle est l’entreprise que souhaite acquérir OpenAI ?
Pierre n’est pas une entreprise spécialisée dans les grands modèles de langage et ne vend pas d’API de modèles comme GPT ou Claude. Elle fournit des logiciels et des infrastructures pour afficher, modifier, stocker et gérer du code. Sur son site, elle présente son activité comme un ensemble de produits de base composables, conçus pour les charges de travail pilotées par des machines.
| Produit | Fonction principale | Lien avec Codex |
|---|---|---|
| Trees | Navigation dans l’arborescence des fichiers, recherche et indication du statut Git | Déjà utilisé dans Codex App |
| Diffs | Affichage des différences, annotations ligne par ligne et édition dans les diffs | Déjà utilisé dans Codex App |
| Highlights | Coloration syntaxique rapide lors de la saisie ou de la génération de code en flux | Composant mentionné dans l’annonce officielle |
| DiffsHub | Consultation des modifications de code dans les PR et commits publics de GitHub | Produit indépendant de Pierre |
| Code Storage | Stockage du code et de son historique via API et Git | Intégration progressive prévue, sans calendrier communiqué |
Au 5 novembre 2026, le dépôt open source de Pierre sur GitHub comptait environ 6 500 étoiles et utilisait la licence Apache License 2.0. Cela ne signifie pas que l’intégralité du code du service commercial Code Storage est open source.
Premier signal : les agents changent le rythme de production du code sur GitHub
Pour comprendre le moment choisi par OpenAI pour acquérir Pierre, on peut d’abord examiner le rapport Octoverse publié par GitHub le 28 octobre 2026. Sur la période étudiée, du 1er octobre 2025 au 30 septembre 2026, l’ampleur de la production logicielle et la participation des agents sont frappantes.
| Indicateur Octoverse | Données officielles | Précisions |
|---|---|---|
| Push de code | 17,9 milliards | Sur les 12 derniers mois |
| Commits | 34,3 milliards | Total des dépôts publics et privés |
| Pull Requests fusionnées | 1,3 milliard | Environ 3,5 millions par jour en moyenne |
| Tâches GitHub Actions | 45,4 milliards | Environ 1 440 par seconde en moyenne |
| Part des PR initiées par des agents | De 17 % à plus de 40 % | Comparaison entre mars et septembre 2026 |
| Nouveaux dépôts avec un fichier de configuration d’agent | 8 fois plus de commits en moyenne que les autres nouveaux dépôts | Montre une corrélation, sans prouver directement un lien de causalité |
Les 40 % correspondent à la part des PR initiées par des agents. Cela ne signifie pas que 40 % du code a été entièrement écrit par l’IA de façon autonome, ni que toutes ces PR ont été fusionnées. Ces données suffisent toutefois à montrer que les agents commencent à jouer un rôle important dans le processus de production logicielle.
Lorsqu’un développeur lance plusieurs agents en parallèle, chaque tâche peut créer une branche distincte, effectuer fréquemment des opérations Clone et Fetch, puis soumettre de petites modifications à répétition. La pression ne vient donc pas seulement du volume total de code, mais aussi des lectures et écritures concurrentes, de la gestion des branches, de l’isolation des tâches et de la revue humaine.
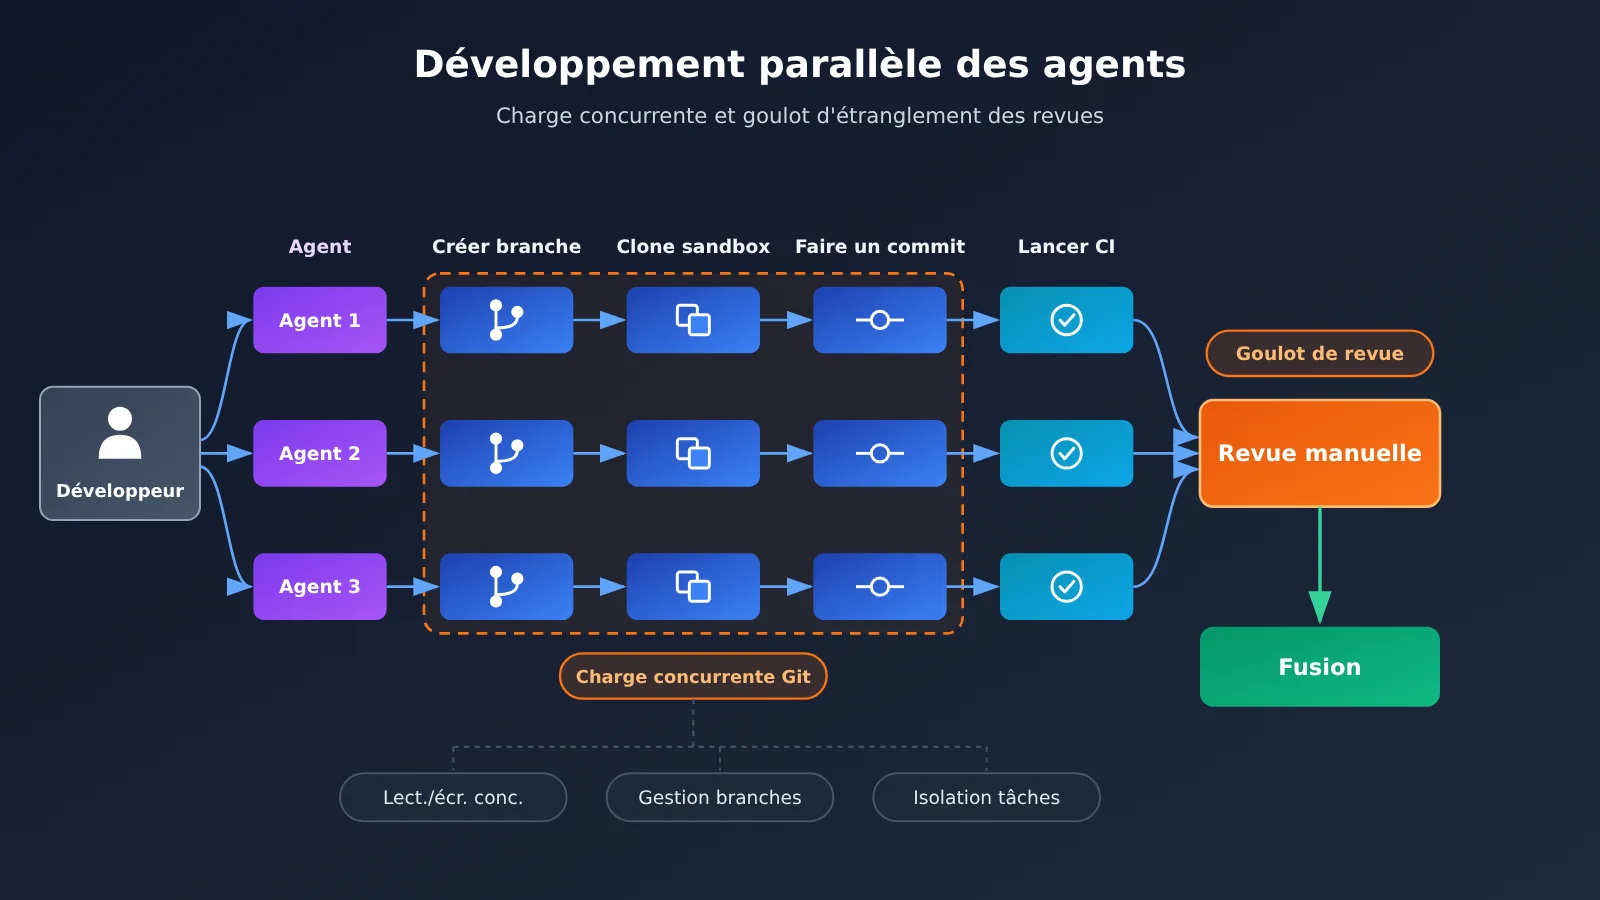
OpenAI a observé une évolution similaire en interne. Dans un article publié en juillet 2026, l’entreprise indiquait que le nombre hebdomadaire de Pull Requests internes avait plus que doublé par rapport au quatrième trimestre précédent. L’IA a amélioré l’efficacité de la production de code, mais les besoins accrus en revue qui en découlent pourraient devenir un nouveau goulot d’étranglement.
Deuxième signal : Codex utilise déjà Trees et Diffs de Pierre
Le principal risque est de voir dans cette acquisition uniquement des « projets futurs ». En réalité, Trees et Diffs sont déjà intégrés à l’application Codex : le premier permet de parcourir l’arborescence des fichiers, le second d’afficher les différences de code. Cette collaboration technique antérieure donne à l’acquisition des airs d’approfondissement d’une relation produit existante.
Le mode Edit Mode de Diffs mérite une attention particulière : il permet de modifier une ligne de code directement dans la vue des différences. Après les nombreuses modifications générées par un agent, il n’est souvent pas nécessaire de tout reprendre : il suffit de comprendre rapidement les changements, de repérer les points importants et de les corriger.
Diffs est toutefois un composant d’affichage et de modification du code, pas un modèle d’IA chargé de la révision ni un service d’hébergement de dépôts Git. Les fonctions de révision de code de Codex existaient déjà : elles permettent d’examiner les PR, de comprendre les commentaires existants et d’aider à préparer des correctifs.
Lors de tests de règles menés en juillet 2026, OpenAI a indiqué que l’approche utilisant les règles du dépôt avait détecté 98 % des problèmes ciblés par ces règles, contre 58,3 % pour l’approche de référence. Ce chiffre provient d’un jeu de test conçu à cet effet et ne représente pas le taux de détection de Codex pour tous les défauts. OpenAI précise aussi que la révision par l’IA ne remplace ni les tests, ni la protection des branches, ni les approbations humaines nécessaires.
Troisième signal : avec Code Storage, l’acquisition de Pierre par OpenAI touche au stockage du code source
Si Trees et Diffs améliorent la façon de consulter et de modifier le code, Code Storage touche à l’endroit où il est stocké. Basé sur Git, il permet de créer des dépôts, de gérer des branches et de lire ou d’écrire des fichiers via une API. Il prend aussi en charge Clone, Push, Fetch, les webhooks et Git LFS.
Code Storage peut également se synchroniser avec GitHub, GitLab et Bitbucket, et propose des SDK pour TypeScript, Python et Go. Les spécifications publiées sur le site de Pierre annoncent notamment une limite de 32 To par dépôt et un engagement de disponibilité de 99,99 % dans le SLA. Il s’agit toutefois de chiffres communiqués par le fournisseur, et non de résultats de tests indépendants.
Les études de cas clients publiées par Pierre montrent aussi de nouveaux usages de Git à l’ère des agents :
- Lovable : selon Pierre, sa charge de travail génère plus de 8 millions de nouveaux dépôts Git par semaine, avec un pic de création de 250 dépôts par seconde.
- Poke : stocke les préférences des utilisateurs, les workflows, la configuration des outils et la mémoire des agents dans un système de stockage d’état natif Git.
- Skydive : chaque agent possède son propre dépôt privé pour conserver sa définition de rôle, ses Skills et sa mémoire persistante.
Ces exemples proviennent tous du fournisseur et ne peuvent pas être considérés comme des résultats d’audit indépendant. Ils offrent néanmoins une perspective intéressante : le dépôt Git n’est plus seulement une base de code destinée à la collaboration humaine. Il commence aussi à servir de couche d’état traçable et récupérable pour le travail des agents.
À ce jour, OpenAI a confirmé qu’elle explorerait progressivement l’intégration des capacités de Code Storage dans Codex, sans annoncer de calendrier pour une intégration complète. Rien n’indique que Codex ait déjà migré l’ensemble du code de ses utilisateurs vers Code Storage. Il ne faut pas non plus interpréter le minimum de dépenses mensuelles de 20 dollars de l’offre Starter comme de nouveaux frais pour Codex.
Signal 4 : Pando et Pierre répondent à des besoins différents
Le 2 novembre 2026, deux jours avant l’annonce de l’acquisition, OpenAI a présenté Pando, un backend Git développé en interne. Avec Codex et l’augmentation du développement en parallèle, le dépôt monolithique interne d’OpenAI connaissait des ralentissements des opérations Push et Fetch ainsi que des échecs de Merge. À certaines périodes, sa fiabilité était inférieure à 90 %.
Pando et Pierre sont deux projets distincts. OpenAI n’a pas acquis Pando, et Pierre n’a pas développé Pando.
| Critère | Pando | Pierre |
|---|---|---|
| Origine | Développé en interne par OpenAI | Entreprise externe dont l’acquisition est prévue |
| Forme du produit | Backend Git | Composants interactifs et service Code Storage |
| Priorité actuelle | Soutenir le développement dans le dépôt monolithique interne d’OpenAI | Fournir une infrastructure de code aux développeurs et aux produits d’IA |
| Données publiées | Latence médiane des Push réduite de près de 80 %, près de 1 PB de données Git fournies chaque jour | Spécifications de Code Storage et cas clients, principalement déclarés par le fournisseur |
| Disponibilité externe | OpenAI étudie comment rendre la technologie disponible ; les détails du produit n’ont pas été publiés | Composants open source et Code Storage déjà disponibles publiquement |
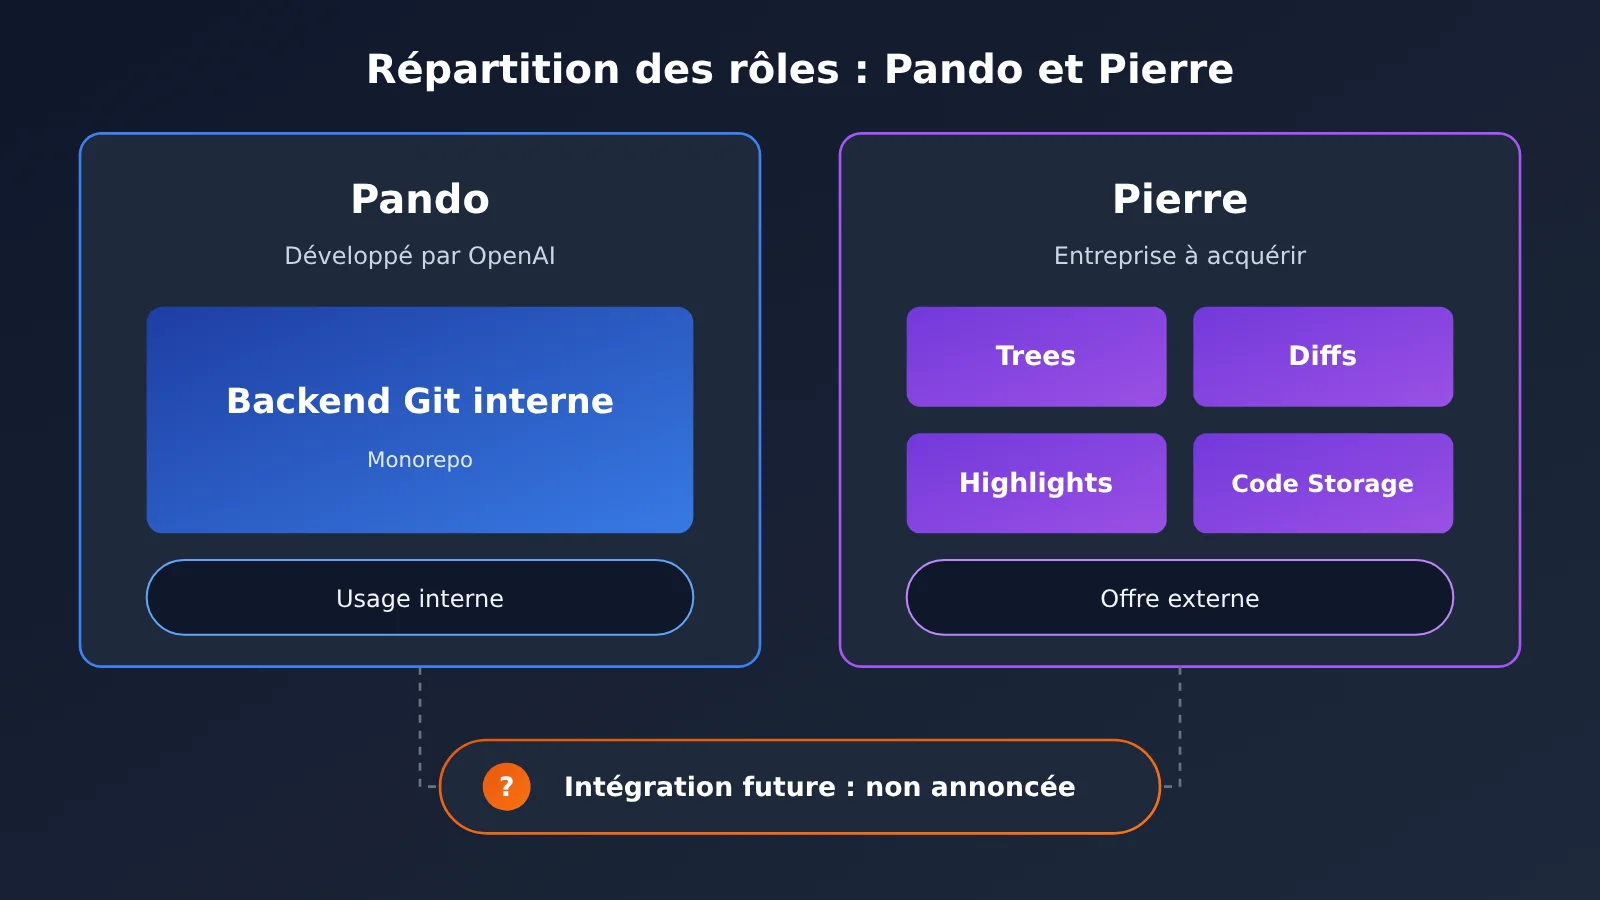
Puisque Pando existe déjà, pourquoi acquérir Pierre ? À notre avis, Pando démontre qu’OpenAI sait résoudre ses problèmes internes de passage à l’échelle de Git, tandis que Pierre apporte des composants interactifs pour les développeurs et des produits externes destinés aux agents. L’un apporte surtout une expérience en infrastructure interne, l’autre des capacités produit tournées vers l’extérieur : ils pourraient donc être complémentaires.
Cette analyse repose uniquement sur les informations disponibles. OpenAI n’a pas encore précisé si les deux projets partageront une architecture, si leurs technologies seront fusionnées ou s’ils répondront à des charges de travail différentes.
Signal n° 5 : Codex passe de l’écriture de code à l’ensemble du processus de développement
Dans son annonce, OpenAI explique vouloir faire de Codex un espace où développeurs et agents prennent ensemble en charge de grands projets logiciels, de la création de la première branche par un agent jusqu’au déploiement du code. L’entreprise évoque aussi la nécessité de relier le code aux décisions prises par les personnes au sein des organisations.
Cette ambition révèle une logique commerciale plus profonde. Les capacités du modèle restent importantes, mais la génération de code ne suffit pas : les utilisateurs doivent encore stocker, réviser, discuter et livrer ce code dans d’autres outils. Plus un acteur maîtrise le contexte de travail, plus il a de chances de transformer son produit d’agent en plateforme utilisée sur la durée.
En juin 2026, OpenAI a indiqué que Codex comptait plus de 5 millions d’utilisateurs hebdomadaires, dont environ 20 % de non-développeurs. Ce chiffre ne reflète pas nécessairement la situation actuelle, mais il montre que Codex dispose déjà d’une base d’utilisateurs importante.
Analyse des effets du rachat de Pierre par OpenAI
Pour GitHub : la concurrence s’installe, mais le remplacement n’est pas d’actualité
Selon Axios, cette acquisition pousse Codex plus loin sur le marché de l’hébergement de code et de la collaboration, dominé depuis longtemps par GitHub, propriété de Microsoft. Le média cite également Origin de Cursor et le projet entrepreneurial de Thomas Dohmke, ancien PDG de GitHub, parmi les concurrents sur ce terrain. Il s’agit d’une analyse concurrentielle de la presse : OpenAI n’a pas annoncé vouloir remplacer GitHub dans l’immédiat.
| Dimension | GitHub | Pierre Code Storage |
|---|---|---|
| Positionnement | Plateforme complète de collaboration pour les développeurs | Infrastructure headless, conçue en priorité autour d’une API |
| Utilisateurs principaux | Développeurs et équipes | Systèmes logiciels, produits d’IA et agents |
| Collaboration | PR, issues, revue de code, CI/CD | Fournit les fonctions de dépôt ; l’interface de collaboration est construite par les produits en amont |
| Dimension communautaire | Communauté open source, identité des développeurs et liens sociaux | La communauté n’est pas au cœur du produit |
| Relation avec les autres plateformes | Plateforme d’hébergement de code et de collaboration à part entière | Peut se synchroniser avec GitHub, GitLab et Bitbucket |
L’avantage de GitHub ne se limite pas au stockage de code : il comprend aussi les processus d’équipe, la communauté open source et les relations entre développeurs accumulés au fil du temps. Code Storage et GitHub ne sont pas des produits équivalents et, à court terme, ils pourraient coexister dans un même workflow grâce à la synchronisation.
Pour les développeurs : évaluer le workflow, pas seulement le modèle
- La revue devient plus importante : plus les agents produisent de modifications, plus la lisibilité des Diff et l’efficacité de l’intervention humaine sont essentielles.
- Les règles doivent être conservées dans le dépôt : des fichiers comme AGENTS.md aident les agents à réviser le code en respectant les contraintes de l’équipe.
- Pour les données, il faut examiner les conditions : les modalités d’isolation et d’utilisation des données après l’intégration ne sont pas encore claires. On ne peut donc pas en déduire que le code des clients servira à l’entraînement.
Conseil pratique : les plateformes évoluent encore. Les équipes peuvent commencer par conserver leurs règles de revue dans le dépôt, puis comparer les résultats de différents modèles sur de vrais Diff. Avec APIYI apiyi.com, elles peuvent passer d’un modèle courant à un autre via une même interface et limiter les adaptations nécessaires aux tests.
Pour le secteur de la programmation assistée par IA : la concurrence monte d’un cran
Jusqu’ici, les produits de programmation assistée par IA se distinguaient surtout par leurs capacités de génération et de complétion de code. Avec l’arrivée d’agents capables de travailler en parallèle, le stockage du code source, l’isolation des permissions, l’expérience de revue et le processus de livraison pourraient devenir de nouveaux facteurs de différenciation.
Créer un prototype de revue de Diff avec une API de modèle
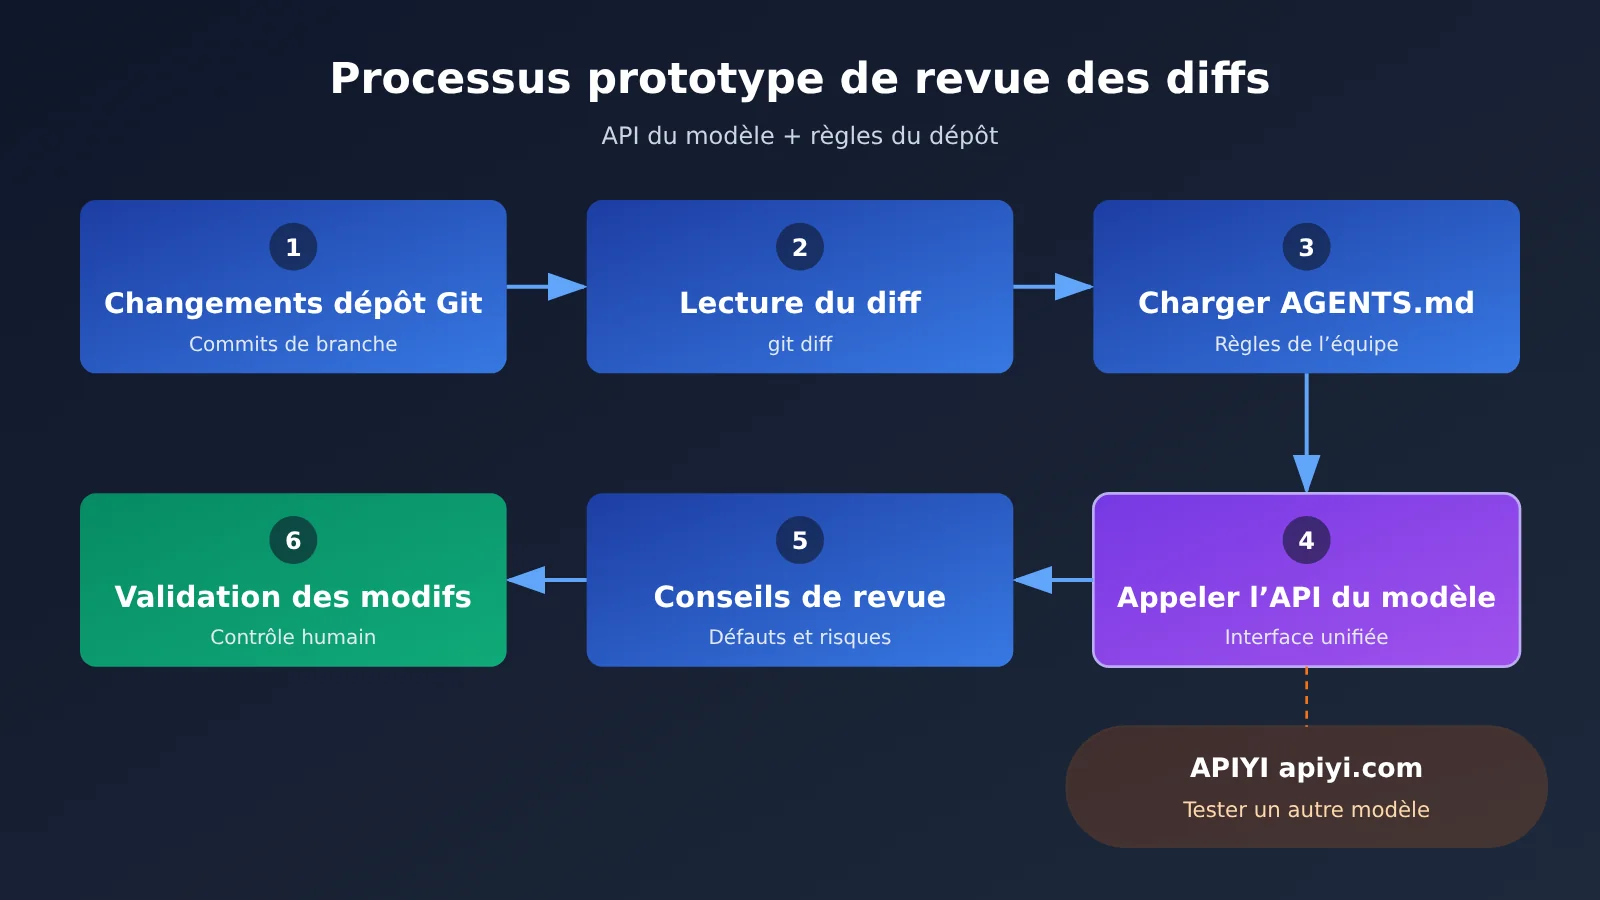
Il faut distinguer trois éléments : Codex est un agent de programmation, l’API des modèles GPT fournit les capacités de raisonnement et Code Storage gère l’infrastructure des dépôts Git. L’annonce de l’acquisition ne présentait ni nouveau modèle ni API intégrée. L’exemple ci-dessous montre simplement comment analyser un Diff Git local à l’aide d’une interface de modèle générique.
import subprocess
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

diff = subprocess.run(
    ["git", "diff", "main...HEAD"],
    capture_output=True, text=True, check=True
).stdout

response = client.chat.completions.create(
    model="gpt-4o-mini",  # Peut être remplacé par le modèle à tester
    messages=[
        {"role": "system", "content": "你是代码审查助手,请指出缺陷和风险。"},
        {"role": "user", "content": diff[:20000]}
    ]
)
print(response.choices[0].message.content)
Voir le code complet avec les règles du dépôt
import subprocess
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)


def get_diff(base_ref: str = "main") -> str:
    """Lit les différences de code entre la branche actuelle et la branche de référence."""
    result = subprocess.run(
        ["git", "diff", f"{base_ref}...HEAD"],
        capture_output=True,
        text=True,
        check=True,
    )
    return result.stdout


def review_diff(model: str = "gpt-4o-mini", max_chars: int = 20000) -> str:
    """Examine les différences de code selon les règles du dépôt ; le résultat doit être confirmé par un humain."""
    diff = get_diff()
    if not diff.strip():
        return "没有检测到代码变更。"

    rules_path = Path("AGENTS.md")
    rules = rules_path.read_text(encoding="utf-8") if rules_path.exists() else "无"

    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "system",
                "content": (
                    "你是代码审查助手。请按严重程度列出缺陷,"
                    f"并参考以下仓库规则:\n{rules}"
                ),
            },
            {"role": "user", "content": diff[:max_chars]},
        ],
    )
    return response.choices[0].message.content


if __name__ == "__main__":
    print(review_diff())
Pour démarrer rapidement : vous pouvez d’abord obtenir des crédits de test gratuits sur APIYI apiyi.com, puis comparer les résultats sur quelques Diff historiques contenant des problèmes connus. Ce type de prototype permet de valider une idée, mais ne remplace pas les tests, la protection des branches ni l’approbation humaine.
Questions fréquentes (FAQ)
Q1 : L’acquisition de Pierre par OpenAI est-elle finalisée ?
Non. OpenAI a annoncé le 4 novembre 2026 son intention d’acquérir Pierre. La transaction reste soumise aux conditions habituelles, notamment à l’approbation des autorités réglementaires. Les deux entreprises continuent de fonctionner indépendamment jusqu’à sa finalisation. Le montant de l’acquisition et la date de finalisation n’ont pas été rendus publics.
Q2 : OpenAI rachète-t-elle Pierre pour remplacer GitHub ?
OpenAI ne l’a pas affirmé. L’idée de « défier GitHub » relève surtout de l’interprétation des médias sur le plan concurrentiel. L’entreprise n’a pas non plus annoncé la fin de l’intégration avec GitHub ni la migration de tous les projets Codex vers Pierre.
Q3 : Quelles fonctionnalités de Pierre Codex utilise-t-il déjà ?
OpenAI a confirmé que Codex App utilise déjà Trees et Diffs, respectivement pour la navigation dans les fichiers et l’affichage des différences. Une intégration plus poussée de Code Storage est prévue ultérieurement, mais le calendrier complet n’a pas encore été publié.
Q4 : Quel est le lien entre Pando et Pierre Code Storage ?
Il s’agit de deux projets distincts. Pando est un backend Git développé par OpenAI, tandis que Code Storage est une infrastructure Git commerciale développée par Pierre. Aucune information officielle ne précise si les deux seront intégrés à l’avenir.
Q5 : Comment créer rapidement un prototype de revue de code avec une API ?
Voici les étapes à suivre :
1. Rendez-vous sur apiyi.com pour vous inscrire auprès d’APIYI et obtenir une clé API.
2. Utilisez `git diff` pour lire les modifications et les fournir en entrée au modèle.
3. Comparez les résultats de différents modèles à l’aide des règles d’AGENTS.md, puis faites confirmer les conclusions par une personne.
Q6 : Cette acquisition aura-t-elle une incidence sur le prix des API des modèles ou sur leurs modalités d’accès ?
L’annonce ne présente aucun nouveau modèle et ne communique pas non plus de nouveaux tarifs pour les API des modèles. Le prix de Code Storage n’est pas non plus celui des tokens des modèles. APIYI, via apiyi.com, propose un service d’agrégation d’API de modèles. À ce jour, aucune source fiable n’indique que ce service donne accès à Pierre Code Storage.
Acquisition de Pierre par OpenAI : points clés
- État de la transaction : OpenAI a annoncé son intention d’acquérir Pierre, mais la transaction n’est pas encore finalisée.
- Intégration existante : Trees et Diffs sont déjà utilisés dans l’application Codex.
- Prochaines étapes : Code Storage sera intégré progressivement, sans calendrier complet annoncé.
- Périmètre des projets : Pando est un backend développé par OpenAI, distinct de Pierre.
- Contexte du secteur : selon les données de GitHub, les PR initiées par des agents représentent désormais plus de 40 % du total.
- Concurrence : l’idée qu’OpenAI cherche à « défier GitHub » relève de l’interprétation des médias ; aucun produit complet de remplacement n’a encore été présenté.
- Conseil pratique : APIYI apiyi.com permet de comparer l’efficacité de différents modèles pour la revue de diffs.
En résumé
L’acquisition de Pierre par OpenAI n’est pas encore finalisée et la forme que prendront les futurs produits reste incertaine. La transaction donne toutefois une indication claire de la direction suivie :
- Les besoins ont changé : les agents accentuent à la fois la pression liée au développement en parallèle et celle liée à la revue de code.
- Le produit étend son périmètre : Codex évolue de la génération de code vers un processus de développement logiciel plus complet.
- La concurrence gagne de nouveaux terrains : la gestion du code source, la collaboration, la revue et la livraison pourraient devenir autant de nouveaux fronts concurrentiels.
Pour les développeurs, il n’y a aucune raison de se précipiter pour migrer leurs dépôts. Il est plus pragmatique de suivre les prochaines annonces officielles, de mettre en place des règles de revue et des contrôles qualité, puis d’évaluer les capacités des modèles sur de véritables modifications de code.
Si vous mettez en place un processus de revue de code, vous pouvez utiliser APIYI apiyi.com pour tester rapidement différents modèles avant de choisir la solution adaptée à votre équipe.
📚 Références
- OpenAI to acquire Pierre Computer Company, Inc. : annonce officielle de l’acquisition par OpenAI
- Lien :
openai.com/index/openai-to-acquire-pierre -
Détails : état de la transaction, intégration des produits et stratégie officielle
-
Scaling Git at OpenAI : article d’ingénierie d’OpenAI
- Lien :
openai.com/index/scaling-git-at-openai -
Détails : contexte de Pando, objectifs d’architecture et données de production
-
GitHub 2026 Octoverse : rapport annuel officiel de GitHub
- Lien :
github.blog/news-insights/octoverse/octoverse-commits-pushes-reach-new-highs-in-2026-as-developers-build-with-agents -
Détails : volume d’activité lié au code et proportion de PR initiées par des agents
-
Exclusive: OpenAI targets Microsoft’s GitHub with deal : article exclusif d’Axios
- Lien :
axios.com/2026/11/04/openai-pierre-computer-github -
Détails : analyse du paysage concurrentiel sous l’angle des médias
-
Code Storage : produit et tarifs : documentation officielle de Pierre
- Lien :
code.storage -
Détails : fonctionnalités du produit, caractéristiques du service et cas clients
-
Custom Code Review rules for Codex : blog des développeurs d’OpenAI
- Lien :
developers.openai.com/blog/custom-code-review-rules-for-codex - Détails : règles de revue de code de Codex et contexte des tests
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus de ressources, consultez le centre de documentation docs.apiyi.com.