Note de l’auteur : les scores des classements publics peuvent être artificiellement gonflés. Cet article explique le benchmaxing, propose 5 vérifications de fiabilité et présente 4 étapes pour créer un jeu de test privé à partir de vos propres tâches.
Commençons par la conclusion : les scores des classements peuvent servir de point de départ à votre enquête, mais pas de conclusion pour choisir un modèle. Les modèles les mieux classés ne sont souvent séparés que par quelques points, ce qui suffit parfois à changer le nom en tête du classement. Avec des écarts aussi faibles, une optimisation ciblée sur les épreuves peut facilement influencer le classement. Ce phénomène est appelé benchmaxing.
Ce qui compte vraiment, c’est la performance des modèles candidats sur vos propres tâches métier. Cet article ne classe pas les modèles et ne cherche pas à déterminer qui « triche ». Il se divise en trois parties : comment repérer des scores potentiellement gonflés, comment construire un petit jeu de test privé à partir de tickets réels, et dans quels cas les classements ne couvrent pas les indicateurs qui vous intéressent.
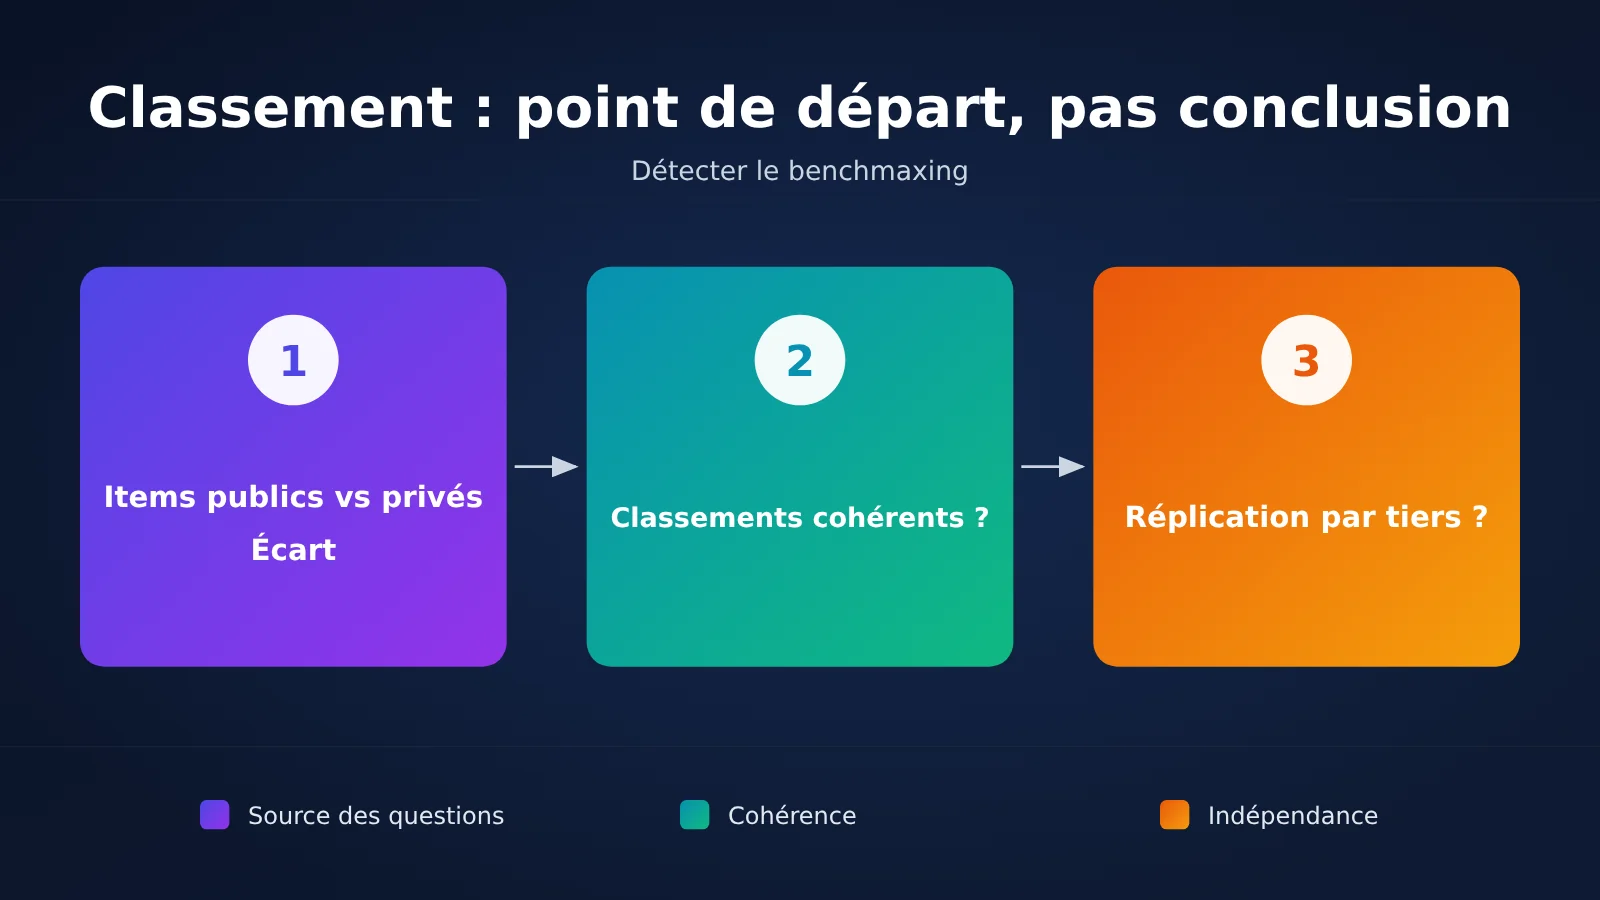
Qu’est-ce que le benchmaxing ? 3 raisons pour lesquelles les scores peuvent être gonflés
Selon un article de MindStudio daté du 1er novembre 2026, le benchmaxing consiste à entraîner ou à ajuster un modèle pour obtenir de bons scores sur des tests de référence connus, plutôt que pour améliorer ses capacités générales. Le signe typique : le modèle brille dans les classements, mais ses performances chutent nettement face à de nouvelles questions qui évaluent pourtant les mêmes capacités.
| Cause | Comment cela se produit | Indice pour le repérer |
|---|---|---|
| Les questions se retrouvent dans les données d’entraînement | Des questions du test de référence, ou des variantes très proches, sont intégrées volontairement ou non au corpus d’entraînement | Le score est élevé sur les questions d’origine, mais baisse lorsqu’elles sont reformulées |
| Ajustement ciblé sur les types de questions | Le modèle est optimisé pour les formats et les schémas de raisonnement privilégiés par un test donné | Il se distingue dans un seul classement, mais reste moyen dans les autres |
| Les questions publiques circulent depuis longtemps | Les questions sont discutées sur des forums et des blogs, puis finissent dans les données collectées sur le Web | Plus un test public est ancien, plus les scores approchent de la saturation |
Le benchmaxing n’est pas forcément mal intentionné
L’article souligne que ces trois situations peuvent se produire sans intention malveillante. Un laboratoire peut sincèrement penser qu’il améliore les capacités générales de raisonnement, alors que son modèle s’est en réalité surajusté à quelques types de questions bien connus. Plus un test reste public longtemps, moins il ressemble à une mesure des capacités et plus il s’apparente à un examen blanc que le modèle aurait déjà passé.
Pour juger, il faut donc regarder les faits plutôt que les intentions. La vraie question est de savoir si le score se traduit par de bons résultats sur de nouvelles questions, et non de deviner si quelqu’un l’a fait exprès.
Pourquoi le benchmaxing apparaît : rythme des sorties et comparaisons
Les scores sont le moyen le plus simple pour les laboratoires de démontrer leurs progrès aux investisseurs, aux développeurs et au grand public, sans avoir à se soumettre à un audit indépendant complet. Un chiffre comme « 59 points à l’indice composite » trouve facilement sa place dans un communiqué de presse et se compare tout aussi facilement à celui d’un concurrent. Plus le chiffre est simple, plus la pression est forte pour l’optimiser.
Le rythme des sorties constitue un deuxième facteur. Selon le même article de MindStudio, un modèle de la famille Google Gemini a obtenu 50 à l’Artificial Analysis Index. Environ un mois plus tard, le modèle suivant de la même entreprise a atteint 59 et pris la tête du classement. Ces données ne proviennent pour l’instant que de cette seule source et n’ont pas été vérifiées indépendamment dans cet article. L’idée de l’article d’origine est la suivante : quand les itérations se comptent en semaines et que quelques points séparent les modèles en tête, tout moyen de creuser l’écart devient tentant.
Classer les faits avant de lire les classements
Avant de citer un score, il faut déterminer à quelle catégorie il appartient. Le tableau ci-dessous l’illustre avec les cas abordés dans cet article :
| Type de fait | Exemple dans cet article | Traitement de la fiabilité |
|---|---|---|
| Déclaration officielle / prédiction orale | Musk affirme que Grok 5 pourrait obtenir un score « proche du maximum » à Humanity’s Last Exam ; il indique aussi que Grok 4 a obtenu environ 52 % à la partie textuelle de ce test | Il s’agit d’une prédiction et d’une déclaration de l’entreprise, pas de résultats de tests indépendants |
| Test indépendant par un tiers | L’Artificial Analysis Index combine des tests de raisonnement, de programmation, de sciences et de mathématiques | Peut servir de signal de référence, à condition de préciser la date de consultation |
| Article d’un seul média | Le score de Grok 4.7 à l’indice, son résultat à Terminal-Bench et la progression de Gemini de 50 à 59 | MindStudio est la seule source ; ces données n’ont pas été vérifiées indépendamment |
| Inconnu | La date précise et l’étendue du passage d’Artificial Analysis à des questions privées | Se référer à ses explications officielles ; cet article ne formule aucune hypothèse |
Selon MindStudio, Grok 4.7 se classe derrière les modèles en tête aussi bien à l’indice composite indépendant qu’à Terminal-Bench. L’article d’origine utilise cet « écart entre les attentes publiques et les tests indépendants » comme un signal à examiner, tout en précisant qu’il ne signifie pas que les pratiques de xAI sont plus problématiques que celles des autres fournisseurs. Nous reprenons ce signal dans le même esprit, sans en tirer de conclusion.
5 critères pour juger la fiabilité d’un score
La réponse des organismes d’évaluation indépendants est simple : ne pas publier les questions. Si elles ne sont jamais rendues publiques, personne ne peut entraîner un modèle spécifiquement pour y répondre. Selon MindStudio, des organismes comme Artificial Analysis utilisent désormais des questions privées. Pour une même catégorie de compétences, l’écart entre le score obtenu sur des questions publiques et celui obtenu sur de nouvelles questions privées est considéré comme l’un des signaux les plus fiables pour repérer le benchmaxing.
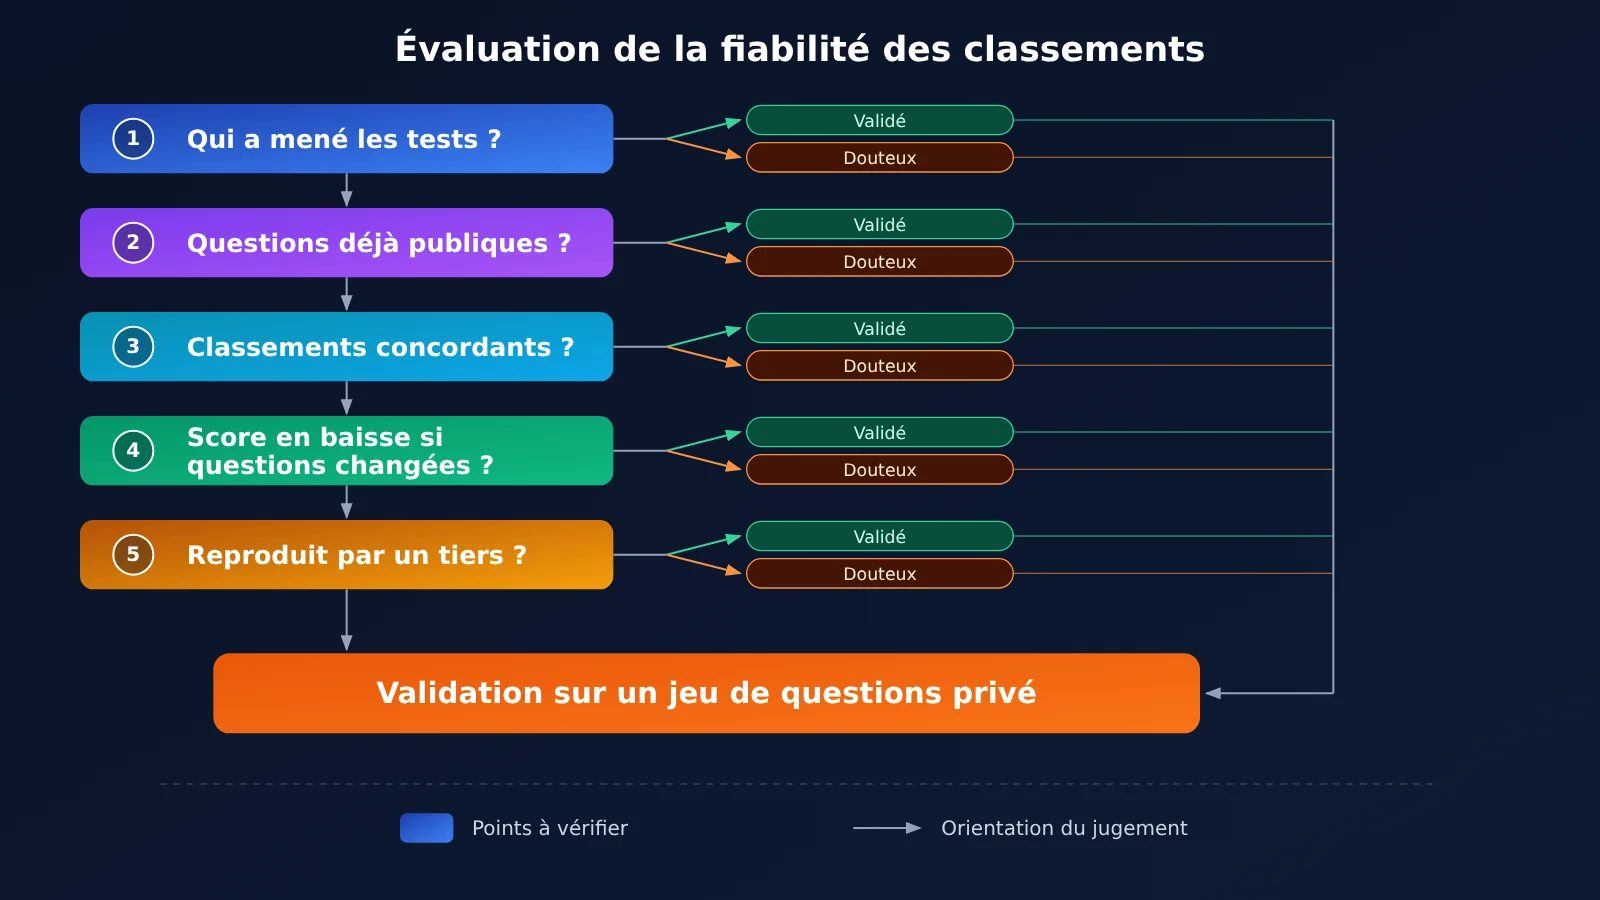
À partir des recommandations de l’article original, voici une liste de 5 points à vérifier :
| N° | Point à vérifier | Comment faire | Signal positif | Signal d’alerte |
|---|---|---|---|---|
| 1 | Qui a réalisé le test ? | Vérifier si le résultat vient d’un rapport technique du fournisseur ou d’une page d’évaluation tierce | Test réalisé de façon indépendante par un tiers | Résultat déclaré uniquement par le fournisseur |
| 2 | Les questions ont-elles déjà été publiées ? | Vérifier si le benchmark a été publié avant la date limite des données d’entraînement du modèle | Questions privées ou publiées après l’entraînement | Anciennes questions publiques depuis plusieurs années |
| 3 | Les résultats sont-ils cohérents entre les classements ? | Comparer plusieurs benchmarks de raisonnement, de programmation, de mathématiques, etc. | Classements globalement cohérents | Résultat remarquable dans un seul classement |
| 4 | Le score baisse-t-il quand on change les questions pour une même compétence ? | Comparer les jeux publics et privés, ainsi que les questions originales et reformulées | Faible écart après changement des questions | Baisse nette après changement des questions |
| 5 | Des tiers ont-ils reproduit les résultats ? | Chercher des rapports de reproduction indépendants et vérifier les paramètres d’évaluation | Reproduction par plusieurs parties, paramètres transparents | Résultats impossibles à reproduire ou paramètres non divulgués |
Pourquoi un indice composite est plus difficile à optimiser artificiellement
Selon l’article original, la valeur de l’Artificial Analysis Index tient au fait qu’il combine plusieurs types de tests en un seul score. Il est possible de surajuster un modèle à un test donné, mais le faire simultanément pour plusieurs tests de raisonnement, de programmation, de sciences et de mathématiques est bien plus difficile, surtout lorsque certaines questions ne sont pas publiques. Le point 3, la cohérence entre les classements, mérite donc une attention particulière.
Créer un jeu de tests privé à partir de ses propres tâches : 4 étapes
Même le classement le plus rigoureux évalue les modèles sur des tâches qui ne sont pas les vôtres. Pour choisir un modèle, mieux vaut s’appuyer sur votre propre jeu de tests privé. Son avantage : aucun laboratoire n’a jamais vu ces cas.
| Étape | Objectif | Marche à suivre | Résultat |
|---|---|---|---|
| ① Échantillonner | Sélectionner des cas issus de l’activité réelle | Utiliser des tickets réels, des échecs relevés dans les journaux de production et des échanges liés à des réclamations ; répartir les cas par type de tâche et commencer avec 20 à 50 cas par catégorie | Jeu de tests initial avec étiquettes |
| ② Définir les critères d’acceptation | Déterminer à l’avance ce qui est « suffisamment bon » | Privilégier les résultats vérifiables, comme les champs JSON, les étiquettes de classification ou la réussite des tests unitaires ; pour les réponses ouvertes, utiliser une grille d’évaluation et contrôler manuellement une proportion fixe des résultats | Script et grille d’évaluation |
| ③ Tester plusieurs modèles | Comparer les modèles en gardant les mêmes conditions | Utiliser la même invite, les mêmes paramètres et le même évaluateur ou les mêmes règles d’évaluation ; consigner les scores, la latence et le nombre de tokens utilisés | Tableau comparatif des résultats |
| ④ Mettre à jour régulièrement | Éviter que le jeu de tests ne devienne un simple examen blanc | Ajouter chaque mois de nouveaux cas d’échec, retirer ceux sur lesquels tous les modèles obtiennent le score maximal et conserver un jeu de validation non utilisé pour ajuster les paramètres | Jeu de tests versionné |
Échantillonnage et critères de validation du jeu de tests privé
Lors de l’échantillonnage, les échecs sont plus instructifs que les réussites. Les conversations où l’utilisateur a dû reformuler sa demande, où un humain a pris le relais ou qui ont reçu une mauvaise évaluation font particulièrement ressortir les différences entre les modèles. Définissez les critères de validation avant de lancer les tests : sinon, vous risquez de les ajuster en fonction des résultats.
La notion de « suffisant » doit se traduire en chiffres. Par exemple : « le taux d’exactitude des champs extraits atteint un seuil donné » ou « aucun fait erroné n’est relevé dans les réponses du service client lors d’un contrôle humain par sondage ». Adaptez la proportion de contrôles au risque : contrôlez davantage les activités à haut risque et privilégiez l’évaluation automatique pour les tâches à faible risque.
Comment contrôler les variables lors d’une comparaison entre modèles
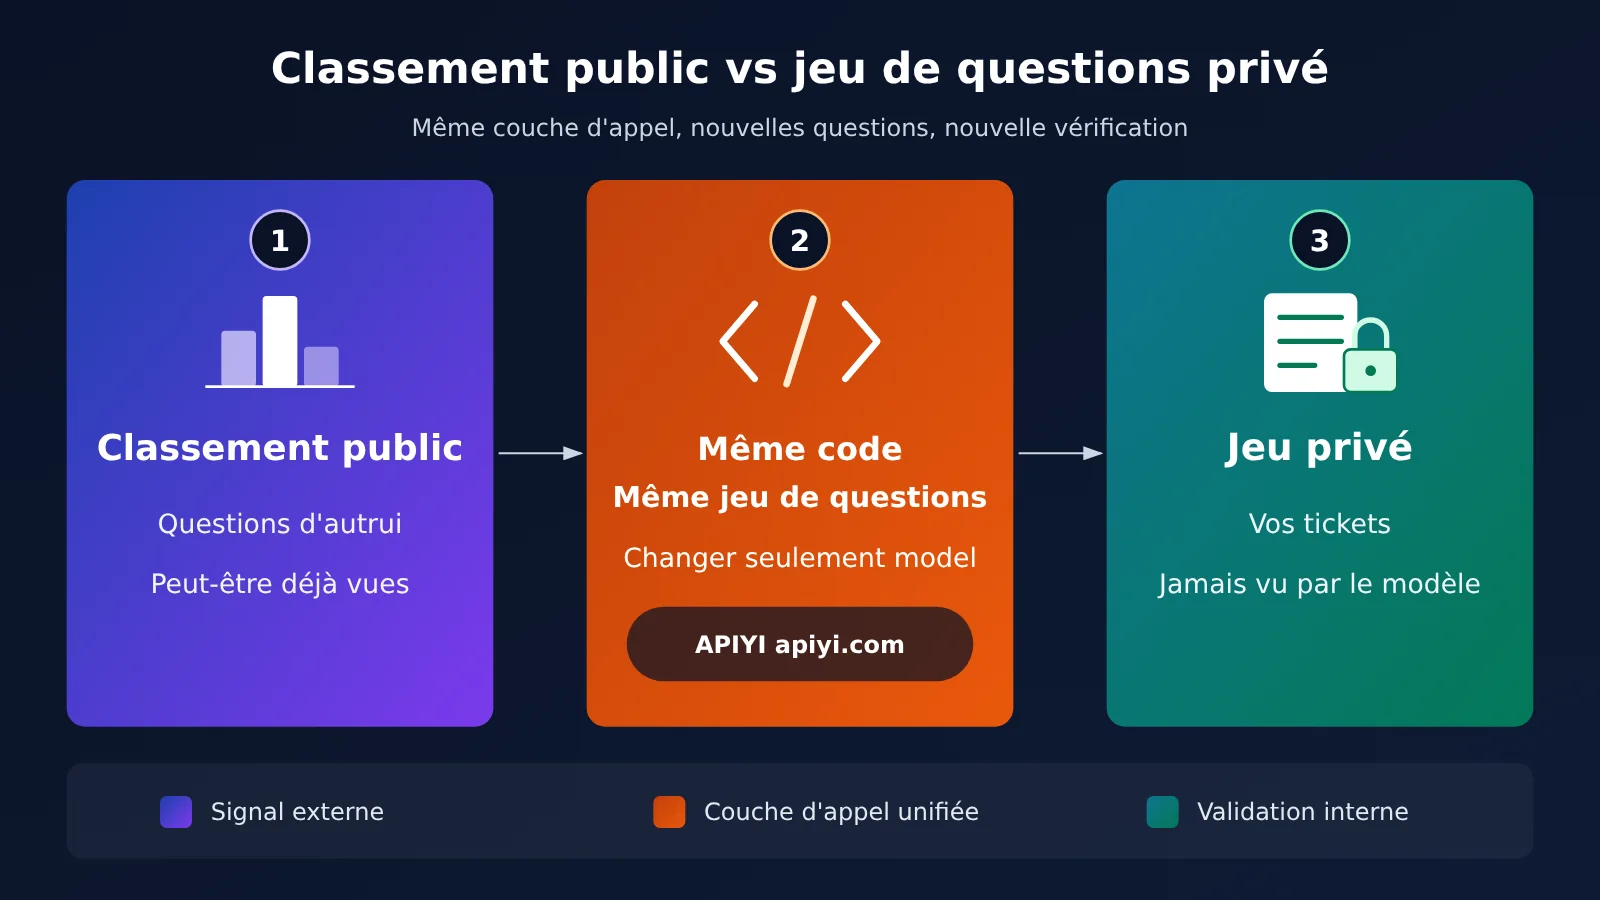
L’erreur la plus courante consiste à ne pas contrôler les variables : par exemple, utiliser une invite soigneusement optimisée pour le modèle A et une invite par défaut pour le modèle B. La bonne approche consiste à utiliser le même code et le même jeu de tests, en ne changeant que le nom du modèle.
Si les modèles candidats proviennent de plusieurs fournisseurs, maintenir plusieurs SDK peut vite devenir fastidieux. APIYI est compatible avec le format OpenAI : un seul jeton permet d’invoquer des modèles de plusieurs fournisseurs, et il suffit de modifier le paramètre model pour passer de l’un à l’autre. C’est pratique pour exécuter le même jeu de tests avec un seul script d’évaluation. Voici la configuration :
- SDK Python officiel d’OpenAI : lors de l’initialisation du client, définissez
base_urlsurhttps://api.apiyi.com/v1et renseignez le jeton de la plateforme dansapi_key - Changement de modèle dans la boucle d’évaluation : modifiez uniquement le champ
model, en utilisant les noms indiqués dans la liste des modèles d’APIYI sur apiyi.com - Paramètres d’échantillonnage fixes : définissez
temperature=0et la même valeurmax_tokenspour tous les modèles afin de limiter l’effet de l’aléatoire - Suivi de la consommation : lisez le champ
usagede la réponse et additionnez les tokens consommés par chaque modèle sur l’ensemble du jeu de tests
🚀 Pour démarrer rapidement : sélectionnez d’abord 3 à 4 modèles bien classés qui ont passé les 5 vérifications ci-dessus. Avec APIYI sur apiyi.com, invoquez-les à tour de rôle avec le même jeton : une après-midi suffit pour obtenir une première comparaison sur 50 demandes réelles.
Évitez de trop ajuster vos paramètres à votre propre jeu de test
Vous aussi, vous risquez de faire du benchmaxing sur votre propre jeu de test. Ajuster l’invite à répétition jusqu’à ce qu’un modèle obtienne un score parfait sur ces 50 cas revient, au fond, à faire comme les fournisseurs qui optimisent leurs modèles pour les classements. Voici quelques garde-fous :
- Constituez un jeu de validation : mettez environ trois cas sur dix de côté, ajustez les paramètres uniquement sur le jeu de développement, puis prenez votre décision finale à partir du jeu de validation
- Figez les invites : une fois la comparaison officielle lancée, figez les invites par numéro de version et relancez tous les modèles au moindre changement
- Renouvelez les cas : à chaque mise à jour du jeu de test, ajoutez des cas d’échec récents pour qu’il évolue avec vos besoins métier
Quand il ne faut pas se fier uniquement aux scores des classements
Même si les scores d’un classement sont parfaitement fiables, ils ne mesurent pas forcément ce qui compte pour vous. Dans les situations suivantes, un classement peut tout au plus servir de point de repère :
| Situation | Pourquoi les classements ne suffisent pas | Évaluations complémentaires |
|---|---|---|
| Tâches spécialisées et peu courantes | Les termes propres à un secteur, les formats internes et les langues moins répandues figurent rarement dans les benchmarks généraux | Un jeu de test privé composé de données métier brutes |
| Appels d’outils et agents | Un échange de questions-réponses en un tour ne permet pas de mesurer la stabilité des appels en plusieurs étapes ni le respect du format des paramètres | Taux de réussite des tâches de bout en bout et taux d’erreur de format des appels de fonction |
| Coût et latence | Les classements évaluent les capacités, sans tenir compte du coût par requête ni du délai avant le premier token | Relever aussi la consommation de tokens et le temps de réponse sur le jeu de test |
| Stabilité | Une seule exécution ne reflète pas les variations en production | Exécuter plusieurs fois chaque cas et vérifier la cohérence des résultats |
Un principe pratique : une fois le niveau de capacité requis atteint, comparez le rapport qualité-prix et la stabilité. Le premier et le troisième du classement peuvent tous deux répondre à vos besoins sur votre jeu de test. Dans ce cas, celui qui offre une latence plus faible et des coûts plus maîtrisables sera souvent le meilleur choix. Avec l’accès unifié proposé par APIYI, apiyi.com, vous pouvez comparer côte à côte les capacités, le temps de réponse et la consommation dans un même tableau de résultats.
Questions fréquentes (FAQ)
Q1 : Le benchmaxing est-il une forme de triche ?
Pas nécessairement. Des questions peuvent se retrouver dans les données d’entraînement parce qu’un robot d’exploration les a collectées par inadvertance. De même, une équipe peut optimiser son modèle pour certains types de questions en pensant sincèrement améliorer ses capacités de raisonnement. Pour juger le résultat, regardez si les scores se maintiennent avec de nouvelles questions, sans tirer de conclusion sur les intentions.
Q2 : Dans quels cas les scores des classements restent-ils fiables ?
Les scores restent un indicateur pertinent lorsque les questions sont privées ou apparues après la date limite des données d’entraînement, que les tests sont exécutés par un tiers indépendant, que plusieurs classements arrivent aux mêmes conclusions et que les résultats ont été reproduits. Un indice qui combine plusieurs types de tests est plus difficile à gonfler artificiellement qu’un benchmark isolé.
Q3 : Combien de questions faut-il prévoir au minimum pour un jeu de test privé ?
Il n’existe pas de norme universelle. En pratique, commencez par 20 à 50 exemples réels par type de tâche : c’est suffisant pour repérer des écarts marqués. Si les différences sont moins nettes, ajoutez des questions tout en réservant un jeu de données de validation.
Q4 : Comment comparer les modèles de plusieurs fournisseurs avec un seul code ?
Le plus simple est d’utiliser une interface compatible avec OpenAI. Après avoir obtenu un jeton auprès d’APIYI sur apiyi.com, indiquez l’adresse de la plateforme dans `base_url`. Il suffit ensuite de changer le paramètre `model` dans une boucle pour comparer les modèles sur le même jeu de questions. Consultez la liste de la plateforme pour connaître les modèles disponibles.
Q5 : Grok 5 obtient-il un score proche de la perfection sur Humanity’s Last Exam ?
À la date de cet article, il s’agit d’une prédiction publique d’Elon Musk, pas d’un résultat de test. Si ce score est effectivement atteint à l’avenir, il restera conseillé de le vérifier à l’aide de la liste de contrôle en 5 points, notamment en évaluant la même capacité sur de nouvelles questions privées. Utilisez aussi votre propre jeu de questions sur APIYI, apiyi.com, pour vérifier si le modèle convient à vos besoins métier.
Benchmaxing et évaluation sur ses propres tâches : points clés
- Définition : le benchmaxing consiste à optimiser un modèle pour des questions de test connues, ce qui peut gonfler son score au-delà de ses capacités réelles.
- Causes : les questions peuvent se retrouver dans les données d’entraînement, le modèle peut être affiné pour certains types de questions et les tests publics peuvent circuler pendant longtemps. Aucune de ces situations n’exige d’intention malveillante.
- Signal principal : une baisse de score sur de nouvelles questions testant la même capacité est le signe d’alerte le plus direct.
- 5 vérifications : qui a effectué le test, les questions étaient-elles publiques, les résultats sont-ils cohérents sur plusieurs classements, le score baisse-t-il avec de nouvelles questions, un tiers a-t-il reproduit les résultats ?
- 4 étapes pour créer son jeu de test : sélectionner des exemples, définir les critères d’acceptation, tester plusieurs modèles et mettre à jour régulièrement le jeu. Gardez aussi un jeu de réserve pour éviter de surajuster votre propre évaluation.
- Invocation unifiée : avec l’interface compatible OpenAI d’APIYI apiyi.com, il suffit de modifier le paramètre
modelpour changer de modèle.
En résumé : les classements sont un point de départ, pas une conclusion
Vous pouvez commencer dès aujourd’hui par trois actions. Premièrement, passez en revue les scores des classements qui vous intéressent à l’aide des 5 vérifications, en précisant le type de fait et la date de référence. Deuxièmement, choisissez 50 cas d’échec dans les journaux du dernier mois et définissez les critères d’acceptation avant de tester les modèles. Troisièmement, évaluez 3 à 4 modèles candidats avec le même code et les mêmes paramètres, en consignant les scores, la latence et la consommation.
Vous pouvez utiliser APIYI apiyi.com pour comparer plusieurs modèles avec un seul jeton, puis mettre à jour votre jeu de test chaque mois. Votre choix doit reposer sur vos propres tests, pas sur ceux des autres.
📚 Références
- MindStudio : What Is Benchmaxing? Why AI Labs Are Hiding Test Questions (2026-11-01)
- Lien :
mindstudio.ai/blog/ai-benchmark-maxing-private-tests -
Description : définition et causes du benchmaxing, tendance aux questions privées, et source unique des données sur Gemini et Grok citées dans l’article
-
Site officiel d’Artificial Analysis : évaluations indépendantes des modèles et indice synthétique
- Lien :
artificialanalysis.ai - Description : consultez ses communications officielles pour connaître le calendrier et l’étendue du passage aux questions privées
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI sur apiyi.com. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.