Note de l’auteur : pour comparer le coût des modèles, se fier uniquement au prix par million de tokens peut conduire à faire le mauvais choix. Cet article propose une méthode de calcul fondée sur « prix unitaire × consommation réelle de tokens », ainsi que les étapes pour la vérifier sur un petit échantillon de vos propres tâches.
Quand elles choisissent un modèle, beaucoup d’équipes commencent par consulter la grille tarifaire. Elles voient que le modèle A coûte quelques centimes par million de tokens, contre plusieurs dollars pour le modèle B, et en concluent que le premier est plus économique. Mais la facture de fin de mois ne correspond pas toujours aux attentes : parfois, le modèle « bon marché » coûte même plus cher. Cet article présente une méthode de calcul du coût réel : « prix unitaire × consommation réelle de tokens, avec ajustement pour le cache », pour vous aider à faire les comptes dès le choix du modèle.
Ce n’est pas un énième récapitulatif des tarifs. Les grilles tarifaires changent, mais la méthode de calcul reste valable. Nous partirons de cas observés dans des analyses publiques pour en dégager une méthode générale, que vous pourrez ensuite vérifier sur vos propres tâches.
Ce que vous allez en tirer : à la fin de cet article, vous saurez expliquer pourquoi « prix affiché bas » ne signifie pas forcément « facture basse », et mesurer le coût par tâche de chaque modèle candidat à partir de 20 à 50 requêtes réelles.
Les points clés du coût réel d’un modèle
| Point clé | Explication | Impact sur le choix |
|---|---|---|
| Le prix unitaire n’est qu’un facteur | Facture = somme des quantités de tokens de chaque catégorie × leur prix respectif | Comparer uniquement les prix unitaires revient à ne regarder qu’une moitié de la formule |
| Différences de tokenisation | Un même texte peut être découpé en un nombre différent de tokens selon le modèle | Le coût d’entrée doit être calculé à partir du nombre de tokens réellement comptés par chaque modèle |
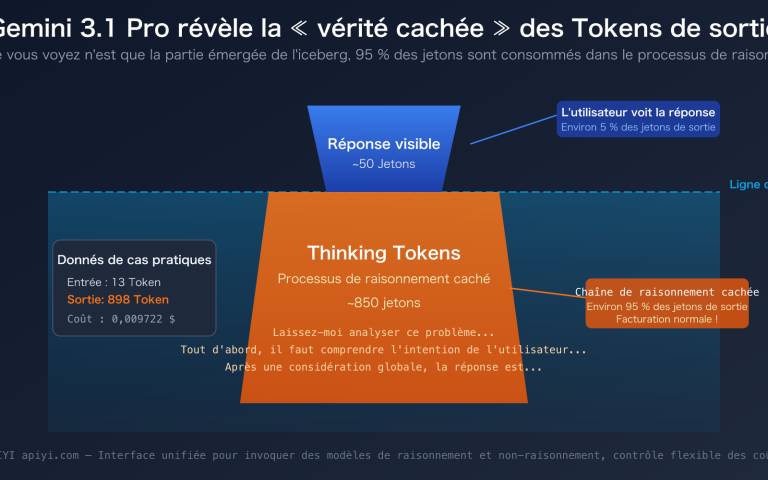
| Tokens de raisonnement | Le processus de réflexion des modèles de raisonnement est généralement facturé comme de la sortie, sans être visible pour l’utilisateur | Une réponse visible très courte peut tout de même coûter cher |
| Accès au cache | Lorsqu’un préfixe répété est trouvé dans le cache, il est facturé à un tarif réduit | La différence est significative avec de longues invites système ou des conversations à plusieurs tours |
| Taux de réussite et nouvelles tentatives | Une réponse incorrecte ou au mauvais format nécessite une nouvelle exécution | Coût effectif = coût par exécution ÷ taux de réussite |
Pourquoi le prix par million de tokens ne suffit pas à calculer le coût réel
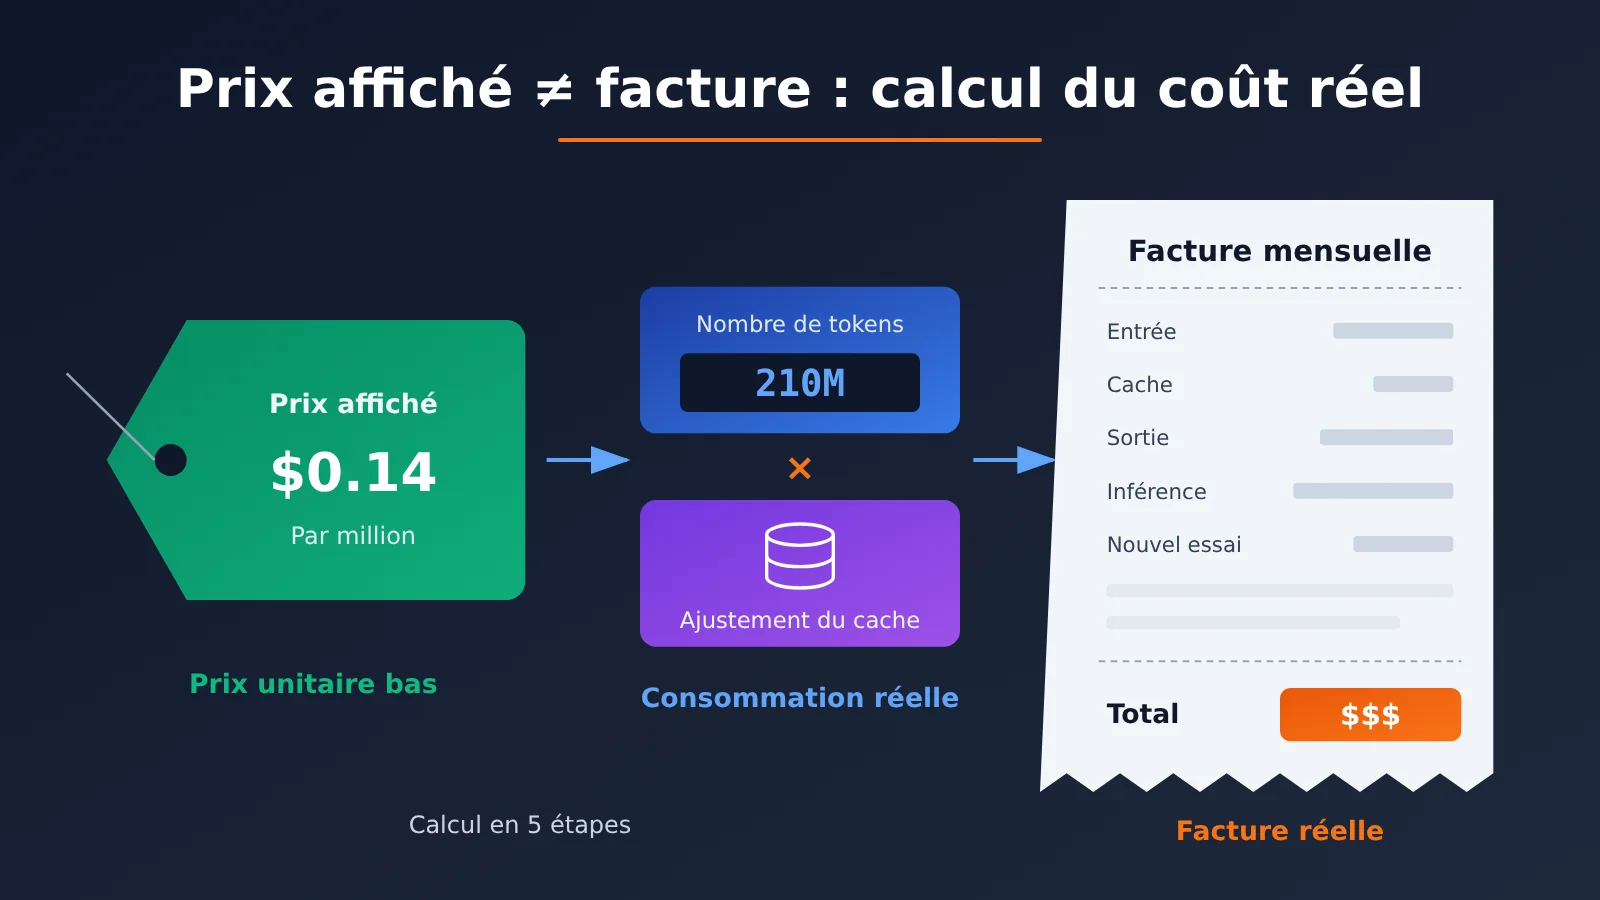
Le prix par million de tokens indique « combien coûte chaque token », alors que la facture indique « combien coûte l’exécution d’une tâche ». Entre les deux, une variable essentielle entre en jeu : le nombre de tokens nécessaires pour accomplir cette tâche. Et l’écart entre les modèles sur ce point dépasse souvent celui des prix unitaires.
Un calcul publié le 1er août 2026 sur un blogue tiers en donne un exemple : DeepSeek V4 Flash et Gemini 3.6 Flash obtiennent le même score de 50 points sur Artificial Analysis. Le premier est affiché à $0.14/M, le second à $1.50/M, soit un prix unitaire environ 10 fois plus élevé. Pourtant, sur la même série de tests, le premier a consommé environ 210 millions de tokens, contre 59 millions pour le second, soit plus de trois fois plus. Cette consommation absorbe une grande partie de l’avantage sur le prix unitaire : l’écart réel est loin d’être de 10 fois.
La tokenisation constitue une autre source d’écart. Dans un article du 12 août 2026, la même source a soumis un document identique à 9 modèles pour en compter les tokens. Résultat : de 614 à 957 tokens, soit environ 56 % d’écart entre le minimum et le maximum. Autrement dit, même si deux modèles appliquent exactement le même prix d’entrée, le coût d’une même invite peut varier de plus de moitié.
💡 À propos des données : ces chiffres proviennent de calculs ponctuels publiés sur un blogue tiers. Les tâches évaluées, les versions des modèles et les prix évoluent ; ces données montrent que le phénomène existe, mais ne peuvent pas être utilisées directement pour établir votre budget. Testez vous-même les modèles sur vos propres tâches.
Composition de la facture : quels types de tokens entrent dans le coût réel ?
Pour calculer précisément les coûts, il faut d’abord savoir quels postes figurent sur la facture. Chez la plupart des fournisseurs, ils se répartissent comme suit. Les noms exacts et la facturation séparée de chaque poste dépendent de la documentation officielle de chacun.
| Poste de facturation | Signification | Tarification courante | Point facile à négliger |
|---|---|---|---|
| Entrée hors cache | Nouvelle invite envoyée, absente du cache | Tarif d’entrée | Le coût d’un même texte varie selon le tokenizer |
| Entrée lue depuis le cache | Partie du préfixe identique à celle d’une requête précédente | Tarif de lecture du cache, généralement bien inférieur au tarif d’entrée | Le préfixe doit être strictement identique pour bénéficier du cache |
| Écriture dans le cache | Certains fournisseurs facturent séparément la première écriture dans le cache | Peut être supérieure au tarif d’entrée standard | Peut coûter plus cher si le taux de réussite du cache est faible |
| Sortie visible | Réponse finalement affichée à l’utilisateur | Tarif de sortie | Le tarif de sortie est généralement plusieurs fois supérieur au tarif d’entrée |
| Tokens de raisonnement | Processus de réflexion interne du modèle | Généralement facturés au tarif de sortie | Ils ne figurent pas dans la réponse, mais sont facturés |
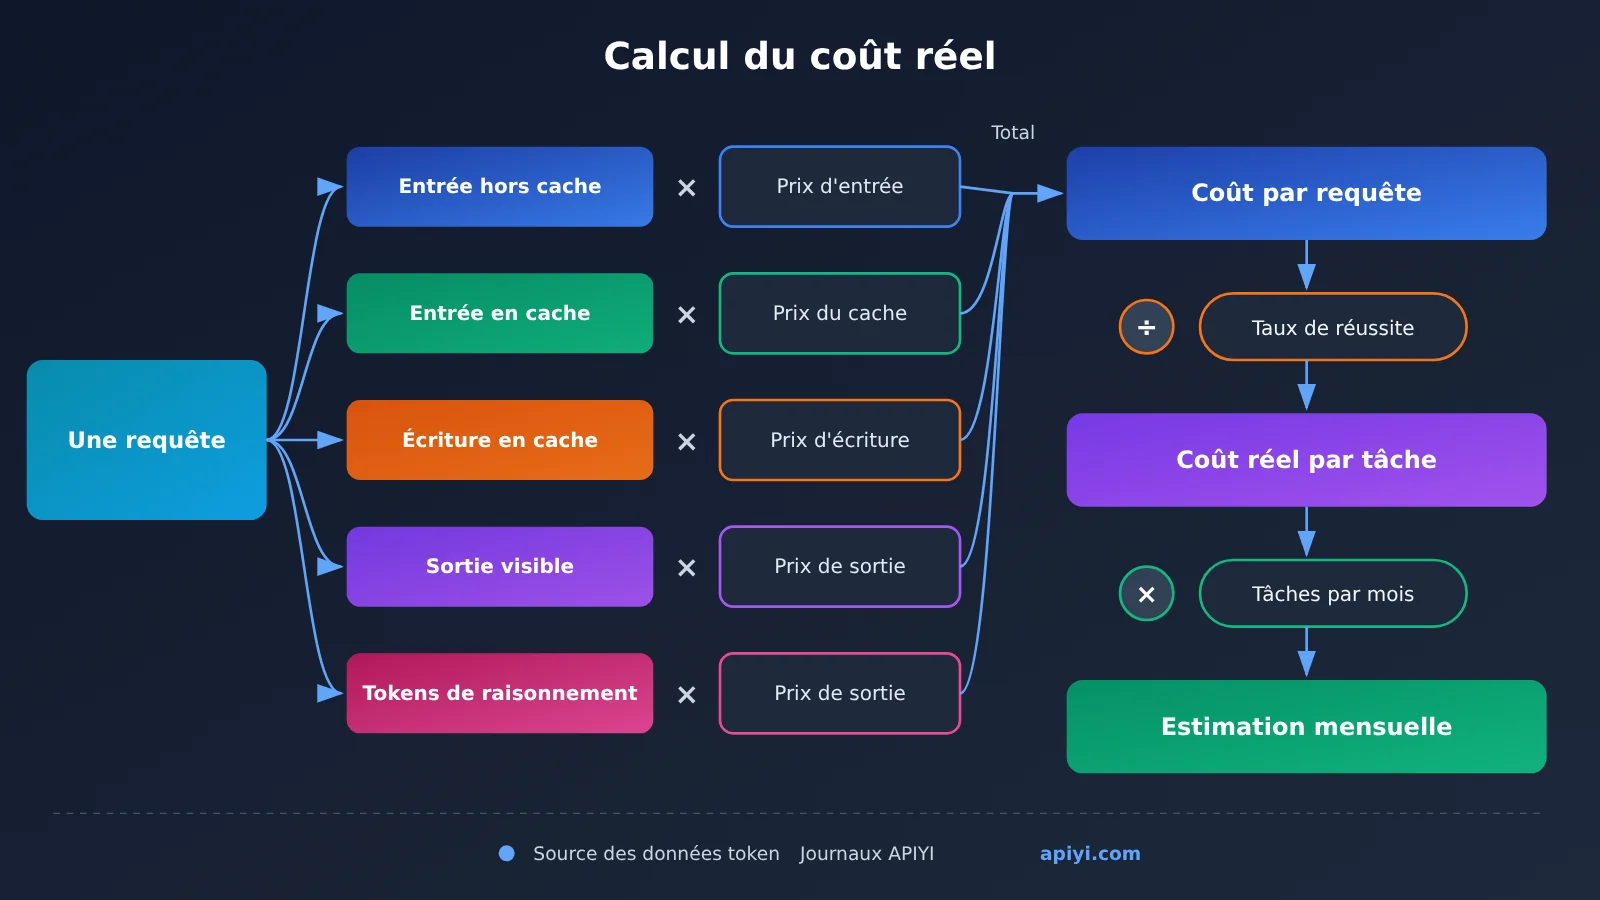
En réunissant ces postes dans une formule, on obtient le cadre de calcul central de cet article :
- Coût par requête = tokens d’entrée hors cache × tarif d’entrée + tokens lus depuis le cache × tarif de lecture du cache + tokens écrits dans le cache × tarif d’écriture + (sortie visible + tokens de raisonnement) × tarif de sortie
- Coût effectif par tâche = coût par requête × nombre moyen d’appels ÷ taux de réussite des tâches
- Estimation mensuelle = coût effectif par tâche × nombre de tâches mensuelles
L’effet du cache est souvent sous-estimé. Un article de la même source, daté du 6 août 2026, indique que le tarif d’une lecture depuis le cache de DeepSeek V4 Flash est environ 50 fois inférieur au tarif hors cache, et que les tarifs du cache peuvent varier jusqu’à 28 fois entre hébergeurs. Autrement dit, la facture d’un même modèle peut être complètement différente selon le canal utilisé. Il faut donc vérifier le tarif du cache auprès du canal que vous utilisez réellement.
L’effet amplificateur des tokens de raisonnement sur le coût réel
Les modèles de raisonnement sont souvent à l’origine de factures élevées malgré un tarif affiché attractif. L’utilisateur pose une seule question et reçoit une réponse de 200 caractères, mais le modèle peut avoir consommé plusieurs milliers de tokens pour réfléchir en interne. Ces tokens sont généralement facturés au tarif de sortie, qui est déjà plusieurs fois supérieur au tarif d’entrée.
Des estimations publiques réalisées par des tiers illustrent ce phénomène. Un article publié le 4 août 2026 indique que Qwen 3.8 Max obtient 3 points de plus que DeepSeek V4 Flash sur Artificial Analysis, mais que, sur les 3 tâches testées, son coût est environ 345 fois supérieur et sa vitesse environ 6 fois moindre. Un autre article de la même série, utilisant la même méthode d’évaluation, rapporte les résultats suivants : Kimi K3 obtient 57 points pour $2,437, DeepSeek V4 Flash 50 points pour $72, et Qwen 3.7 Max 46 points pour $1,604. Il arrive donc bien qu’un modèle moins performant coûte plus cher, souvent à cause du nombre de tokens consommés.
Des écarts existent aussi entre différentes versions d’un même fournisseur. Selon un article, Claude Opus 4.5 à 4.8 et Opus 5 affichent tous le même tarif de $5/$25, mais les tests révèlent un écart de consommation d’environ 1,30 fois. Même si le prix reste inchangé, la facture peut donc varier de 30 % : un détail facile à oublier lors d’une mise à niveau du modèle.
Estimer les coûts réels à partir de la consommation de tokens : 5 étapes pour démarrer
Voici une méthode d’estimation sur un petit échantillon, sans script complexe. Elle repose sur un seul principe : pour une même tâche et une même entrée, comptabiliser séparément les tokens d’entrée, de sortie, de cache et de raisonnement.
Étape 1 : préparer un échantillon de tâches représentatif
Sélectionnez 20 à 50 requêtes issues de votre environnement de production ou de besoins réels, en couvrant les principaux types de tâches : questions-réponses courtes, documents longs, conversations à plusieurs tours, etc. Conservez l’intégralité de l’invite système et du contexte dans vos échantillons, car c’est surtout sur ces préfixes répétés que le cache est utilisé. Ne vous contentez pas de tester avec un simple « Bonjour » : cela ne permettrait pas de mesurer les différences de tokenisation ni l’effet du cache.
Étape 2 : Garder les variables constantes et appeler chaque modèle candidat
Utilisez la même invite système, la même entrée utilisateur, la même valeur max_tokens et la même température pour chaque modèle candidat. Si un modèle de raisonnement permet de régler l’intensité du raisonnement, notez le niveau utilisé : le nombre de tokens de raisonnement peut varier considérablement d’un niveau à l’autre.
À cette étape, un point d’accès unique simplifie les choses. Avec une plateforme d’agrégation comme APIYI apiyi.com, vous pouvez passer d’un fournisseur à l’autre avec la même clé API et les mêmes appels compatibles OpenAI. Il suffit de changer le nom du modèle pour effectuer toute la comparaison, sans créer de compte, ajouter des fonds ni adapter le SDK pour chaque fournisseur.
Étape 3 : Relever chaque catégorie de tokens
Après chaque appel, relevez le nombre de tokens dans le champ usage de la réponse. Dans le format compatible OpenAI, les champs courants comprennent :
usage.prompt_tokens: nombre total de tokens en entréeusage.prompt_tokens_details.cached_tokens: part des tokens trouvés dans le cacheusage.completion_tokens: nombre total de tokens en sortieusage.completion_tokens_details.reasoning_tokens: part des tokens de raisonnement
Les noms des champs varient selon les fournisseurs. Par exemple, le format Anthropic utilise cache_read_input_tokens et cache_creation_input_tokens pour distinguer la lecture et l’écriture dans le cache. Consultez la documentation de chaque fournisseur pour connaître les détails.
Si vous ne souhaitez pas analyser les réponses vous-même, vous pouvez aussi consulter les relevés de la plateforme. APIYI fournit des journaux et des statistiques d’utilisation pour chaque appel, ce qui permet de comparer la consommation des différents modèles sur un même lot d’échantillons. Avant de faire vos calculs, vérifiez dans la console et les explications tarifaires de la plateforme si les tokens de cache et de raisonnement sont affichés séparément, et si les accès au cache font l’objet d’une tarification distincte.
🚀 Pour commencer : lancez une première comparaison à petite échelle avec 20 échantillons sur APIYI apiyi.com. Vous pourrez ainsi estimer l’ordre de grandeur de la consommation de tokens de chaque modèle avant de décider s’il faut élargir l’échantillon. Avec un solde unique, les coûts des tests sur plusieurs modèles sont regroupés dans un seul compte, ce qui facilite aussi la vérification des dépenses.
Étape 4 : Récapituler les résultats dans le tableau de calcul
Reportez les résultats relevés dans le tableau ci-dessous, à raison d’une ligne par modèle. Pour chaque tarif unitaire, indiquez la date de consultation et la source.
| Champ | Informations à renseigner | Source des données |
|---|---|---|
| Modèle et version | Numéro de version exact ou suffixe de date | Paramètres d’invocation |
| Tarifs unitaires et date de consultation | Une colonne pour l’entrée, la sortie, la lecture du cache et l’écriture dans le cache | Page officielle des tarifs ou page tarifaire de la plateforme utilisée |
| Nombre moyen de tokens d’entrée hors cache | Moyenne de l’échantillon | usage dans la réponse ou journaux de la plateforme |
| Nombre moyen de tokens d’entrée servis depuis le cache | Moyenne de l’échantillon, avec calcul du taux de succès du cache | usage dans la réponse ou journaux de la plateforme (par exemple, statistiques d’utilisation d’APIYI) |
| Nombre moyen de tokens de sortie visibles | Nombre total de tokens de sortie moins les tokens de raisonnement | usage dans la réponse |
| Nombre moyen de tokens de raisonnement | À relever séparément pour les modèles de raisonnement | usage dans la réponse |
| Taux de réussite des tâches | Proportion de tâches jugées conformes, manuellement ou selon des règles | Résultats de l’évaluation |
| Coût effectif par tâche | À calculer selon la formule présentée plus haut | Calcul récapitulatif |
Étape 5 : Décider en fonction du coût effectif par tâche
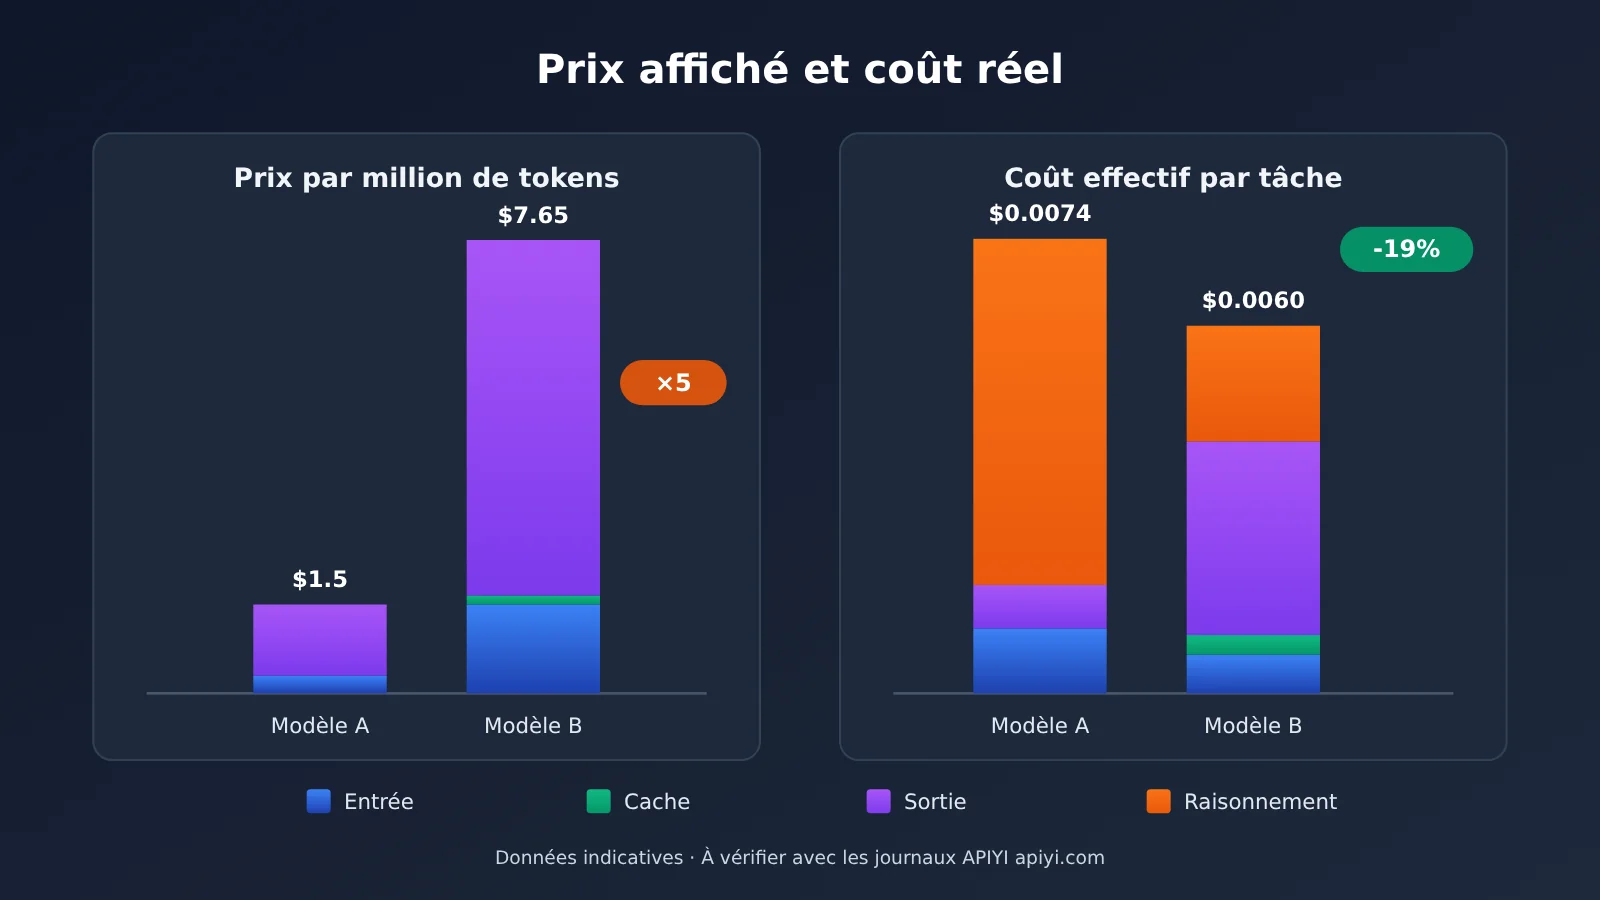
Au final, ce n’est pas le tarif unitaire qu’il faut comparer, mais le « coût effectif par tâche ». L’exemple ci-dessous utilise des tarifs fictifs pour illustrer le calcul : ces chiffres ne correspondent aux tarifs réels d’aucun modèle.
Supposons que le modèle A soit facturé $0.3/M en entrée et $1.2/M en sortie. Le modèle B coûte $1.5/M en entrée, $6/M en sortie et $0.15/M pour la lecture du cache : son tarif est 5 fois supérieur à celui de A.
| Élément de calcul | Modèle A (tarif bas) | Modèle B (tarif élevé) |
|---|---|---|
| Tokens d’entrée hors cache | 3,000 | 400 |
| Tokens d’entrée servis depuis le cache | 0 | 2,000 |
| Tokens de sortie visibles + de raisonnement | 500 + 4,000 | 500 + 300 |
| Coût d’entrée | $0.0009 | $0.0006 + $0.0003 |
| Coût de sortie | $0.0054 | $0.0048 |
| Coût par requête | $0.0063 | $0.0057 |
| Taux de réussite des tâches | 85% | 95% |
| Coût effectif par tâche | Environ $0.0074 | Environ $0.0060 |
Dans cet exemple, la tokenisation du modèle B est plus compacte : le nombre total de tokens d’entrée est inférieur de 600. La majeure partie de sa longue invite système a été servie depuis le cache, et son raisonnement est nettement plus court. Résultat : malgré un tarif 5 fois plus élevé, le coût effectif de B est inférieur d’environ 19% à celui de A. Dans la réalité, la conclusion peut être inverse : c’est pourquoi il faut refaire les mesures avec vos propres tâches.
Points à vérifier pour calculer le coût réel
La méthode de calcul n’a rien de compliqué, mais quelques pièges peuvent fausser les résultats. Avant de commencer, vérifiez les points suivants :
- Indiquez toujours la date des prix : les tarifs des modèles changent souvent. Les sources mentionnent par exemple que DeepSeek V4 Pro 0813 applique une tarification heures pleines/heures creuses depuis le 16 août 2026. Pour un même modèle, le prix peut varier selon l’heure et le canal utilisé.
- Vérifiez la version désignée par l’alias du modèle : un article mentionne qu’un nom de modèle apparemment « très courant » pointe en réalité vers une ancienne version. Lors de vos tests, notez l’identifiant du modèle renvoyé dans la réponse pour éviter de tester la version A et de déployer la version B.
- Les accès au cache dépendent de la cohérence du préfixe : si vous placez du contenu dynamique, comme un horodatage ou un identifiant utilisateur, au début de l’invite, le préfixe change à chaque appel et le cache ne peut presque jamais être utilisé. Pour vos tests, utilisez la même structure d’invite qu’en production.
- Considérez les benchmarks tiers comme des indications : les scores globaux d’organismes comme Artificial Analysis, ainsi que les coûts calculés par tâche, reflètent la répartition des tâches dans leurs évaluations. Ils ne correspondent pas nécessairement à votre contexte métier.
- Incluez les nouvelles tentatives dans le calcul : les requêtes relancées après une limitation de débit 429, une erreur de format ou une réponse non conforme génèrent elles aussi des frais. Calculez le taux de réussite à partir des résultats réellement jugés satisfaisants.
💰 Conseil pour optimiser les coûts : une fois les tests terminés, vous pouvez utiliser le « coût effectif par tâche réussie » comme principal critère de sélection, et les scores de benchmark ainsi que la latence comme contraintes. Sur APIYI apiyi.com, il suffit de modifier le nom du modèle pour en changer. Vous pouvez ainsi ajuster rapidement la configuration en production si vos conclusions évoluent, tout en continuant à suivre la consommation réelle dans les journaux d’appels.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que le « coût réel » d’un modèle ?
Le coût réel est le montant effectivement payé pour accomplir une tâche précise, et non le prix affiché par million de tokens. Pour l’obtenir, on multiplie le nombre réel de tokens de chaque catégorie (entrée hors cache, entrée en cache, écriture en cache, sortie visible et raisonnement) par son tarif unitaire, puis on tient compte du taux de réussite et des nouvelles tentatives pour calculer le coût effectif par tâche.
Q2 : Pourquoi un même document produit-il un nombre de tokens différent selon le modèle ?
Chaque modèle utilise un tokenizer différent, qui découpe le chinois, le code et la ponctuation plus ou moins finement. Dans une estimation publiée, un même document représentait entre 614 et 957 tokens selon les 9 modèles testés. Il faut donc calculer le coût d’entrée à partir du nombre de tokens indiqué par chaque modèle, sans appliquer le décompte d’un modèle aux autres.
Q3 : Faut-il toujours inclure les tokens de raisonnement dans le coût ?
Oui. La plupart des fournisseurs les comptent comme des tokens de sortie et les facturent au tarif correspondant. Ils n’apparaissent pas dans le corps de la réponse, mais peuvent représenter la majeure partie de la sortie. Pour évaluer un modèle de raisonnement, il est conseillé de relever séparément les `reasoning_tokens` et de comparer les modèles à un même niveau d’intensité de raisonnement.
Q4 : Combien peut-on économiser grâce au cache ?
Cela dépend des tarifs de cache du fournisseur et de votre taux d’accès au cache. Les sources indiquent que le tarif de DeepSeek V4 Flash pour les entrées en cache représente environ 1/50 du tarif hors cache, mais les prix du cache peuvent varier jusqu’à 28 fois selon l’hébergeur. Les gains sont les plus importants avec de longues invites système, des préfixes fixes de base de connaissances ou des conversations à plusieurs tours. Consultez les tarifs du service utilisé pour obtenir les chiffres applicables.
Q5 : Comment estimer rapidement le coût de plusieurs modèles sur un petit échantillon ?
Le plus simple est d’utiliser une plateforme qui donne accès à plusieurs modèles via une interface unifiée :
1. Inscrivez-vous sur APIYI apiyi.com et obtenez une clé API
2. Préparez de 20 à 50 exemples de tâches réelles, en gardant les mêmes invites et paramètres
3. Appelez chaque modèle en changeant son nom, puis regroupez les différentes catégories de tokens à partir des journaux d’appels et des statistiques d’utilisation
4. Calculez le coût effectif par tâche à l’aide du modèle présenté dans cet article
Vous pouvez ainsi effectuer toute la comparaison avec un seul compte et une seule méthode d’appel, sans avoir à ouvrir des comptes et à rapprocher les factures chez plusieurs fournisseurs.
Q6 : Peut-on utiliser directement le « coût par tâche » indiqué par un blog tiers ?
Mieux vaut ne pas l’utiliser directement pour établir un budget. Ces données permettent de repérer des modèles susceptibles de présenter des différences de consommation de tokens et de réduire la liste des candidats. Mais les tâches évaluées, les versions des modèles, les prix et les conditions de cache diffèrent de votre contexte : il faut donc vérifier les chiffres avec vos propres échantillons.
Q7 : Quelles sont les limites de cette méthode d’estimation ?
Un petit échantillon ne reflète que les types de tâches qu’il couvre. Il faut refaire les tests si la répartition des tâches change. De plus, les journaux de certaines plateformes ne distinguent pas nécessairement les tokens de cache et de raisonnement : il faut alors les récupérer soi-même dans le champ `usage` de la réponse du modèle. Les prix et les versions des modèles évoluent également ; il est donc conseillé de relancer les tests après chaque changement de tarif ou mise à niveau.
Points clés pour calculer le coût réel d’un modèle
- Le prix unitaire ne représente que la moitié du calcul : la facture dépend du prix unitaire multiplié par le nombre de tokens réellement consommés.
- Les différences de tokenisation comptent : pour un même document, le nombre de tokens peut varier de plus de 50 % selon le modèle.
- Les tokens de raisonnement augmentent le coût de sortie : même invisible, le processus de réflexion est facturé comme une sortie.
- Le prix du cache varie selon le canal : le taux de réussite du cache et son prix unitaire déterminent ensemble le coût des invites longues.
- Décidez en fonction du coût réel par tâche réussie : intégrez le taux de réussite et les nouvelles tentatives.
- Refaites les tests depuis un point d’accès unique : grâce à l’interface unifiée et aux journaux d’invocation d’APIYI, il est plus simple de tester plusieurs modèles sur les mêmes échantillons.
En résumé
Pour estimer le coût réel d’un modèle à partir de la consommation de tokens et du cache, retenez trois points :
- Décomposez la facture : comptabilisez séparément les tokens d’entrée hors cache, les lectures et écritures du cache, les tokens de sortie visibles et les tokens de raisonnement, puis multipliez chaque catégorie par son prix unitaire.
- Testez avec vos propres tâches : les benchmarks et les prix publiés par des tiers ne sont que des points de référence. Seules les mesures réalisées sur une même tâche et une même entrée sont fiables.
- Comparez le coût réel par tâche réussie : prenez en compte le taux de réussite et les nouvelles tentatives, puis établissez votre budget selon le volume mensuel de tâches.
Les prix des modèles évoluent et de nouveaux modèles apparaissent régulièrement, mais cette méthode de calcul reste réutilisable. Avant votre prochain choix, testez d’abord 20 échantillons réels sur plusieurs modèles, puis décidez lequel mettre en production. Pour passer rapidement d’un modèle à l’autre entre différents fournisseurs, vous pouvez utiliser l’accès unifié d’APIYI sur apiyi.com et vérifier la consommation réelle de chaque modèle directement dans les journaux d’invocation.
📚 Ressources
- Ofox.ai Blog, page 23 : résumés d’articles comparant la consommation de tokens de DeepSeek V4 Flash et Gemini 3.6 Flash, les différences de prix du cache et les estimations de coûts de la série Qwen
- Lien :
ofox.ai/blog/page/23/ -
Remarque : articles publiés en août 2026 ; les données proviennent de calculs ponctuels réalisés par un tiers et sont fournies à titre indicatif
-
Ofox.ai Blog, page 22 : comparaison du nombre de tokens d’un même document sur 9 modèles, écarts de consommation entre les versions de Claude et tarification de DeepSeek V4 Pro selon l’heure
- Lien :
ofox.ai/blog/page/22/ -
Remarque : des exemples concrets pour comprendre les différences de tokenisation et de consommation entre versions
-
Ofox.ai Blog, page 25 : comparaison du coût d’une tâche entre Kimi K3, GLM-5.2 et Opus 4.8
- Lien :
ofox.ai/blog/page/25/ - Remarque : les prix et les scores évoluent ; consultez les pages tarifaires officielles des fournisseurs avant toute utilisation
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI sur apiyi.com. Pour plus de ressources sur l’intégration, consultez la documentation sur docs.apiyi.com.