Note de l’auteur : une fois les poids ouverts de Kimi K3.1 Pro récupérés, commencez par vérifier si la licence encadre votre usage, puis évaluez le seuil d’auto-hébergement lié aux 1.56 TB de poids. Cet article donne, selon les cas, une méthode pour trancher ces deux points.
Le 4 novembre 2026, Moonshot a publié sur Hugging Face les poids ouverts complets de Kimi K3.1 Pro. Cette date correspond à celle promise le 23 octobre, lors de la mise en ligne du modèle dans son application et via son API. Le dépôt moonshotai/Kimi-K3.1-Pro est librement téléchargeable, sans formulaire de demande. Une fois les poids récupérés, les équipes en entreprise se posent généralement deux questions : notre usage risque-t-il de déclencher des restrictions de licence ? De quelles ressources faut-il disposer pour un auto-hébergement ?
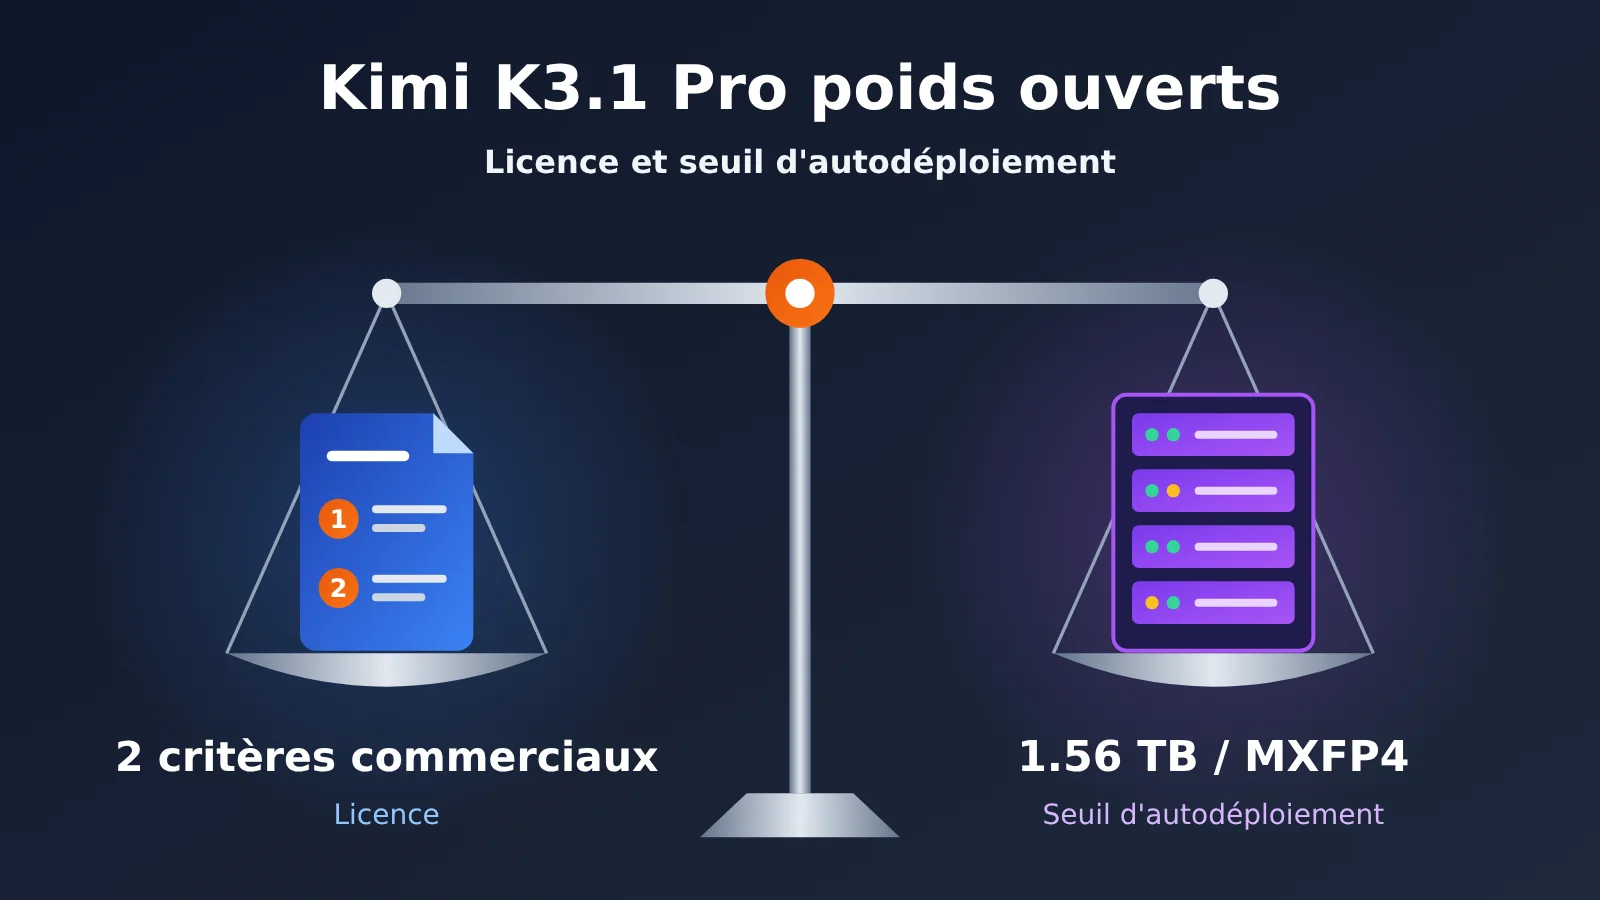
Il ne s’agit pas d’une lecture optimiste du type « poids ouverts = utilisation commerciale sans restriction ». La licence comporte deux conditions commerciales assorties de seuils de montant et de nombre d’utilisateurs, et elles ne visent pas les mêmes acteurs. Côté auto-hébergement, les fichiers de poids représentent à eux seuls 1.56 TB, ce qui place déjà la barre assez haut.
L’essentiel : à la fin de cet article, vous saurez distinguer à qui s’applique chacune des deux conditions de licence, vérifier que l’usage interne n’est soumis à aucune de ces deux conditions, et évaluer de façon préliminaire la faisabilité d’un auto-hébergement en fonction du volume des poids, du format de précision et des frameworks d’inférence recommandés.
Kimi K3.1 Pro : l’essentiel des poids ouverts
Commençons par un tableau qui résume les informations les plus utiles pour les décisions d’entreprise.
| Point clé | Explication | Ce que cela implique pour la décision |
|---|---|---|
| Date de publication | API en ligne le 23 octobre, poids publiés le 4 novembre | Promesse tenue aux dates annoncées, 12 jours d’écart |
| Licence | Identique mot pour mot à celle de Kimi K3, seul le nom a changé | Les équipes qui ont déjà évalué K3 peuvent reprendre directement leurs conclusions juridiques |
| Droits d’usage | Utilisation, modification, fine-tuning et redistribution gratuits | Aucun obstacle de licence pour un déploiement interne |
| Deux conditions commerciales | Les entreprises à fort chiffre d’affaires qui revendent des services de modèle doivent signer un accord séparé ; les produits à très grande échelle doivent afficher une attribution bien visible | Cela ne concerne qu’une minorité d’activités externes de grande envergure |
| Volume des poids | 96 fragments safetensors, 1.56 TB au total | Nécessite une capacité de déploiement de niveau multi-machines et multi-GPU |
| Format de précision | Poids MXFP4 + activations MXFP8, entraînement avec prise en compte de la quantification | C’est la précision native utilisée par le service officiel |
Le contexte de la publication de Kimi K3.1 Pro
D’après les statistiques d’ArtificialWatch, entre juillet et début novembre, les laboratoires d’IA ont explicitement promis une date d’ouverture des poids lors de leur annonce à 5 reprises, et les 5 promesses ont été tenues à temps. Entre la mise en ligne de l’API et la publication des poids, l’écart va de 0 à 25 jours, avec une médiane de 12 jours. Moonshot en compte deux : Kimi K3 et Kimi K3.1 Pro ont tous deux livré leurs poids le 12e jour après la mise en ligne. Pour les équipes qui doivent planifier un auto-déploiement à l’avance, c’est un signal de rythme utile à garder en tête.
Le modèle lui-même est issu d’un post-entraînement sur la base de Kimi K3, avec une seule modification d’architecture : les couches d’attention complètes ont été remplacées par des couches Gated DeepSeek Sparse Attention, afin de réduire le coût de calcul sur les longs contextes. On compte actuellement 93 couches au total, dont 69 couches KDA et 24 couches Gated DSA. Le modèle totalise 2 800 milliards de paramètres, avec 104 milliards activés par token, une longueur de contexte de 1 048 576 tokens et la prise en charge des entrées texte et image.
Décryptage des conditions de licence de Kimi K3.1 Pro, une par une
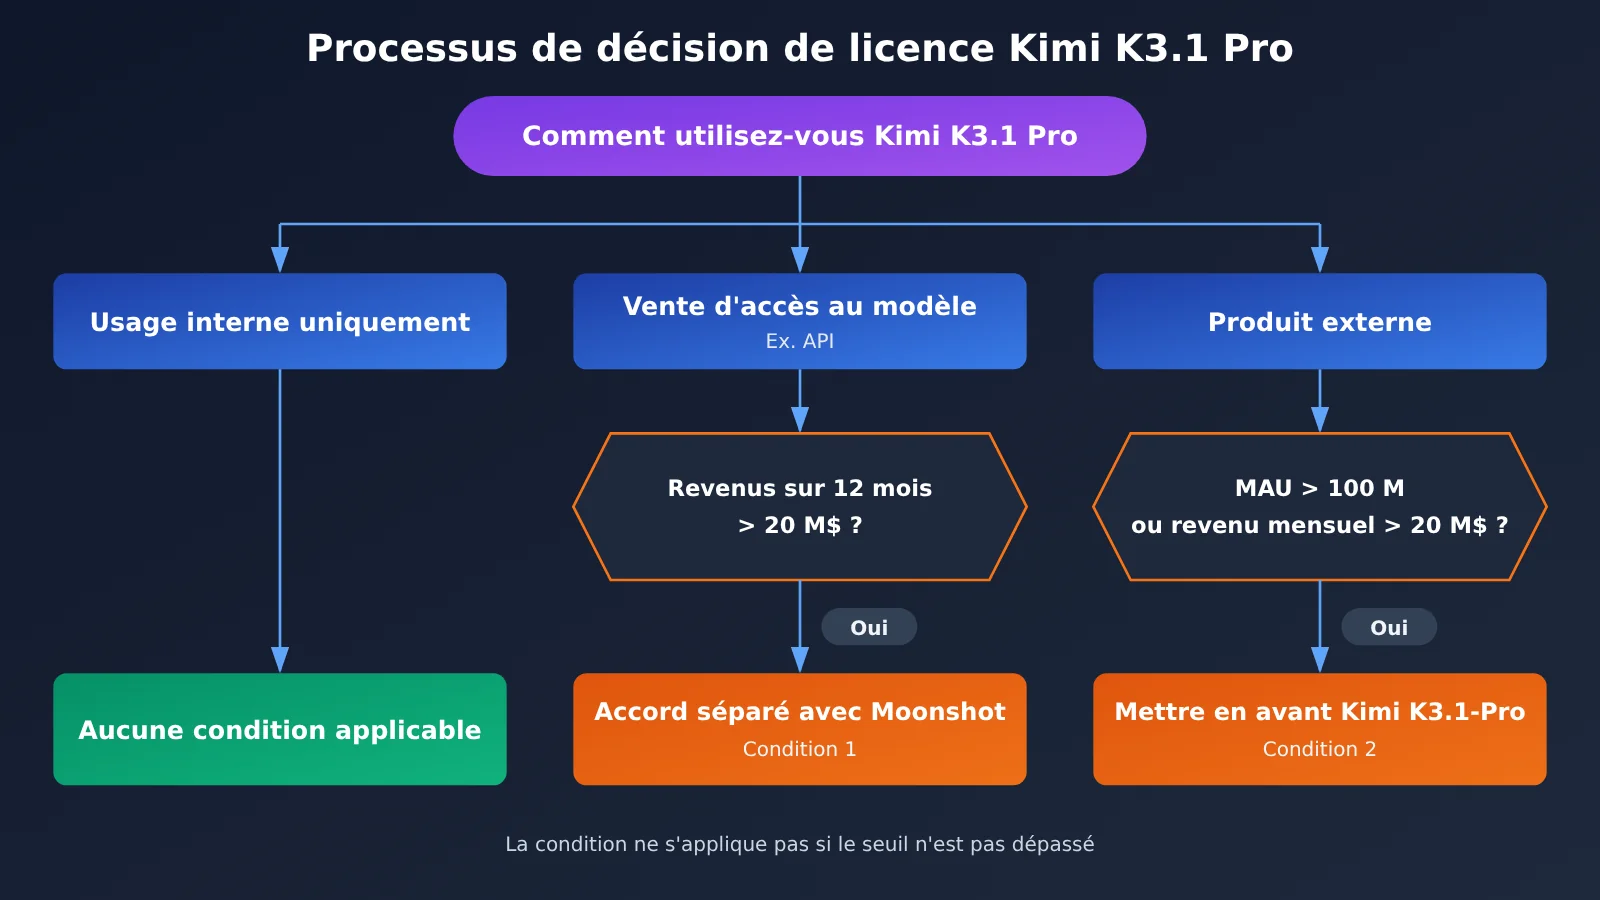
La licence accorde par défaut un périmètre de droits plutôt large : utilisation, modification, fine-tuning et redistribution sont gratuits. Les restrictions ne viennent que de deux conditions additionnelles, et ces deux conditions ne visent pas les mêmes acteurs : il faut donc les examiner séparément.
Condition une : les entreprises qui vendent l’accès au modèle sous forme de service
La première condition vise les entreprises qui « vendent l’accès au modèle comme un service », la forme typique étant la mise à disposition d’une API. Si une telle entreprise dépasse 20 millions de dollars de revenus sur n’importe quelle période de 12 mois, elle doit signer un accord séparé avec Moonshot avant tout usage commercial. Deux points clés ici : d’abord « vendre l’accès au modèle », ensuite « n’importe quelle période de 12 mois », c’est-à-dire une fenêtre glissante, et non une année civile.
Les termes précis de cet accord ne sont pas publics à ce jour : ni le coût, ni le mode de partage des revenus, ni le processus de validation ne sont connus. Le texte d’origine laisse aussi une marge d’interprétation sur ce qu’on entend par « revenus » : s’agit-il du chiffre d’affaires global de l’entreprise, ou seulement de la part liée au service de modèle ? Si votre activité approche de ce seuil, faites vérifier le texte du LICENSE par votre service juridique plutôt que de vous fier à des interprétations de seconde main.
Condition deux : obligation d’attribution pour les produits à très grande échelle
La deuxième condition porte sur la taille du produit. Un produit qui dépasse 100 millions d’utilisateurs actifs mensuels, ou 20 millions de dollars de revenus mensuels, doit afficher clairement la mention « Kimi K3.1-Pro ». Cette obligation ne demande qu’une attribution, pas la signature d’un accord supplémentaire. Attention : ici le seuil de revenus se calcule au mois, alors que la condition une parle de « 12 mois » — de quoi s’emmêler les pinceaux quand on remplit une checklist de conformité.
Tableau comparatif des scénarios de licence Kimi K3.1 Pro
Les appréciations ci-dessous s’appuient sur la façon dont la licence est rapportée dans les sources publiques ; avant un usage commercial réel, référez-vous au texte du LICENSE et à l’avis de votre service juridique.
| Scénario d’usage | Déclenche la condition une (accord séparé) ? | Déclenche la condition deux (attribution visible) ? | Points clés |
|---|---|---|---|
| Usage interne à l’entreprise (base de connaissances, assistant interne, outils de R&D) | Non | Non | La documentation indique explicitement qu’aucune des deux conditions ne s’applique à un usage interne |
| Fine-tuning interne pour usage propre | Non | Non | Le fine-tuning fait partie des droits gratuits |
| API exposée à l’extérieur, revenus inférieurs à 20 M$ sur les 12 derniers mois | Non | Selon la taille du produit | Il faut surveiller en continu les revenus sur 12 mois glissants |
| API exposée à l’extérieur, revenus supérieurs à 20 M$ sur n’importe quelle période de 12 mois | Oui | Selon la taille du produit | Un accord doit être signé avant tout usage commercial |
| Produit grand public, plus de 100 M d’utilisateurs actifs mensuels ou plus de 20 M$ de revenus mensuels | Selon que vous vendez ou non l’accès au modèle | Oui | Le nom du modèle doit être affiché de manière visible dans le produit |
| Redistribution de poids fine-tunés | Non | Non | La redistribution est gratuite ; vérifiez les obligations associées dans le LICENSE |
Évaluation du seuil de déploiement autonome de Kimi K3.1 Pro
L’absence d’obstacle au niveau de la licence ne signifie pas pour autant que l’équipe pourra le déployer. Le tableau ci-dessous récapitule les spécifications liées au déploiement, issues de la fiche modèle et des rapports publics.
| Élément de spécification | Valeur | Implications pour le déploiement |
|---|---|---|
| Fichiers de poids | 96 fragments safetensors, 1,56 To au total | Même volume que Kimi K3 : le téléchargement et le stockage doivent être planifiés séparément |
| Paramètres totaux / paramètres activés | 2,8 billions / 104 milliards par token | Structure MoE : le calcul par passage est bien inférieur au total des paramètres, mais tous les poids doivent être chargés |
| Précision des poids et des activations | Poids MXFP4, activations MXFP8 | Le framework d’inférence et le matériel doivent prendre en charge ces deux formats |
| Longueur de contexte | 1 048 576 tokens | Un long contexte augmente sensiblement l’occupation du KV Cache |
| Structure d’attention | 69 couches KDA + 24 couches Gated DSA | Les nouvelles couches d’attention creuse nécessitent une adaptation du framework |
| Modalités d’entrée | Texte + image | La chaîne de prétraitement multimodal doit elle aussi être déployée |
| Framework d’inférence recommandé | vLLM, SGLang, TokenSpeed | Privilégier les frameworks recommandés par la fiche modèle |
Ce que la quantification MXFP4 en cours d’entraînement implique pour la précision au déploiement
C’est le point le plus souvent mal interprété. Selon la fiche modèle, Kimi K3.1 Pro est entraîné dès le départ avec des poids MXFP4 et des activations MXFP8, autrement dit en quantification consciente (quantization-aware training). Les fichiers de 1,56 To ne sont donc pas une version « allégée » compressée après l’entraînement : c’est bien la précision que Moonshot utilise lui-même pour fournir le service.
Trois conséquences concrètes en découlent :
- La précision en autonome est identique à celle du service officiel : tant que le framework prend correctement en charge ces formats, il n’y a en théorie aucune perte de quantification du type « la version autonome est moins bonne que l’API officielle ».
- Déquantifier vers une précision supérieure n’est pas recommandé : convertir les poids en BF16 ou autre ne restaurera aucune capacité supplémentaire et fera au contraire exploser la mémoire vidéo nécessaire.
- La compatibilité matériel/framework est le point critique : MXFP4/MXFP8 exige le support du framework d’inférence et de la carte accélératrice ; au moment du choix, vérifiez que la version du framework a bien été adaptée à ce modèle.
Estimation préliminaire de la dimension matérielle de Kimi K3.1 Pro
Les documents publics ne fournissent ni configuration matérielle officielle ni données de coût ; ce qui suit n’est qu’une estimation fondée sur le volume des fichiers. Le simple chargement des poids exige déjà plus de 1,56 To de mémoire agrégée, et si l’on ajoute le KV Cache, les valeurs d’activation et les frais du framework, les besoins réels sont plus élevés. Pour exploiter pleinement un contexte d’un million de tokens, la demande augmentera encore. Cela signifie qu’une solution mono-machine mono-carte est en pratique irréaliste : l’équipe doit posséder de l’expérience en déploiement multi-cartes, voire multi-machines, avec parallélisme tensoriel ou parallélisme d’experts. Pour le type de carte, le nombre de cartes et le coût précis, je conseille de se référer à la documentation de déploiement officielle du framework d’inférence et de se fier aux résultats de tests de charge à petite échelle.
Par ailleurs, Moonshot a publié en parallèle un Kimi K3.1 Pro Highspeed annoncé comme 2 à 3 fois plus rapide, mais on ne sait pas encore s’il s’agit d’un checkpoint distinct, et aucun dépôt correspondant n’existe sur Hugging Face. Les équipes qui espèrent reproduire la vitesse du Highspeed avec des poids ouverts devront attendre des précisions supplémentaires de l’éditeur.
Parcours de prise en main rapide de Kimi K3.1 Pro
Compte tenu du volume important des poids, mieux vaut procéder dans l’ordre « valider d’abord les capacités, puis décider d’un éventuel auto-hébergement », afin d’éviter d’investir trop tôt dans l’achat de matériel.
Étape 1 : valider les capacités de Kimi K3.1 Pro via l’API
Avant d’engager des ressources de déploiement de l’ordre de 1,56 To, le moyen le moins coûteux de valider consiste à faire tourner vos propres échantillons métier via l’API. Concrètement :
- Préparez 50 à 200 échantillons métier réels, couvrant des entrées typiques comme les documents longs, les contenus mixtes texte-image et le code.
- Appelez le modèle via l’interface compatible OpenAI, en définissant le paramètre
modelsur le nom du modèle Kimi K3.1 Pro fourni par la plateforme, et notez la qualité des sorties ainsi que la latence. - Faites tourner en parallèle 1 à 2 modèles alternatifs sur le même lot d’échantillons pour obtenir des données de comparaison transversales.
🚀 Démarrage rapide : APIYI apiyi.com propose un appel unifié compatible avec les formats d’interface OpenAI et Anthropic ; vos SDK existants n’ont qu’à remplacer
base_urlet la clé API pour se connecter. Pour savoir si Kimi K3.1 Pro est déjà disponible et quel est le nom de modèle correspondant, référez-vous à la liste de la page tarifs https://docs.apiyi.com/models ; les paramètres de connexion sont détaillés dans le centre de documentation docs.apiyi.com.
Étape 2 : liste de vérification avant l’auto-hébergement de Kimi K3.1 Pro
Une fois la validation des capacités effectuée et le besoin d’auto-hébergement réellement confirmé, passez en revue chaque point de la liste ci-dessous :
- Conformité : en vous appuyant sur le tableau des scénarios ci-dessus, déterminez si votre activité relève d’un usage interne ou d’un service destiné à des tiers, et faites relire le texte original de la LICENSE par votre service juridique.
- Stockage et téléchargement : prévoyez au moins 1,56 To de stockage rapide, et planifiez le téléchargement et la vérification d’intégrité des 96 shards.
- Choix du framework : retenez vLLM, SGLang ou TokenSpeed, en vérifiant que la version retenue prend déjà en charge la couche Gated DSA et les formats MXFP4/MXFP8.
- Planification du contexte : fixez la fenêtre de contexte maximale en fonction des besoins réels de votre activité ; inutile d’ouvrir un million de tokens par défaut, cela permet d’économiser le KV Cache.
- Tests de charge et régression : utilisez les échantillons collectés à l’étape 1 pour des tests comparatifs, afin de vérifier que les sorties de votre déploiement local correspondent à celles de l’API.
Kimi K3.1 Pro : auto-hébergement ou appel via API
| Dimension | Auto-hébergement des poids ouverts | Appel via API |
|---|---|---|
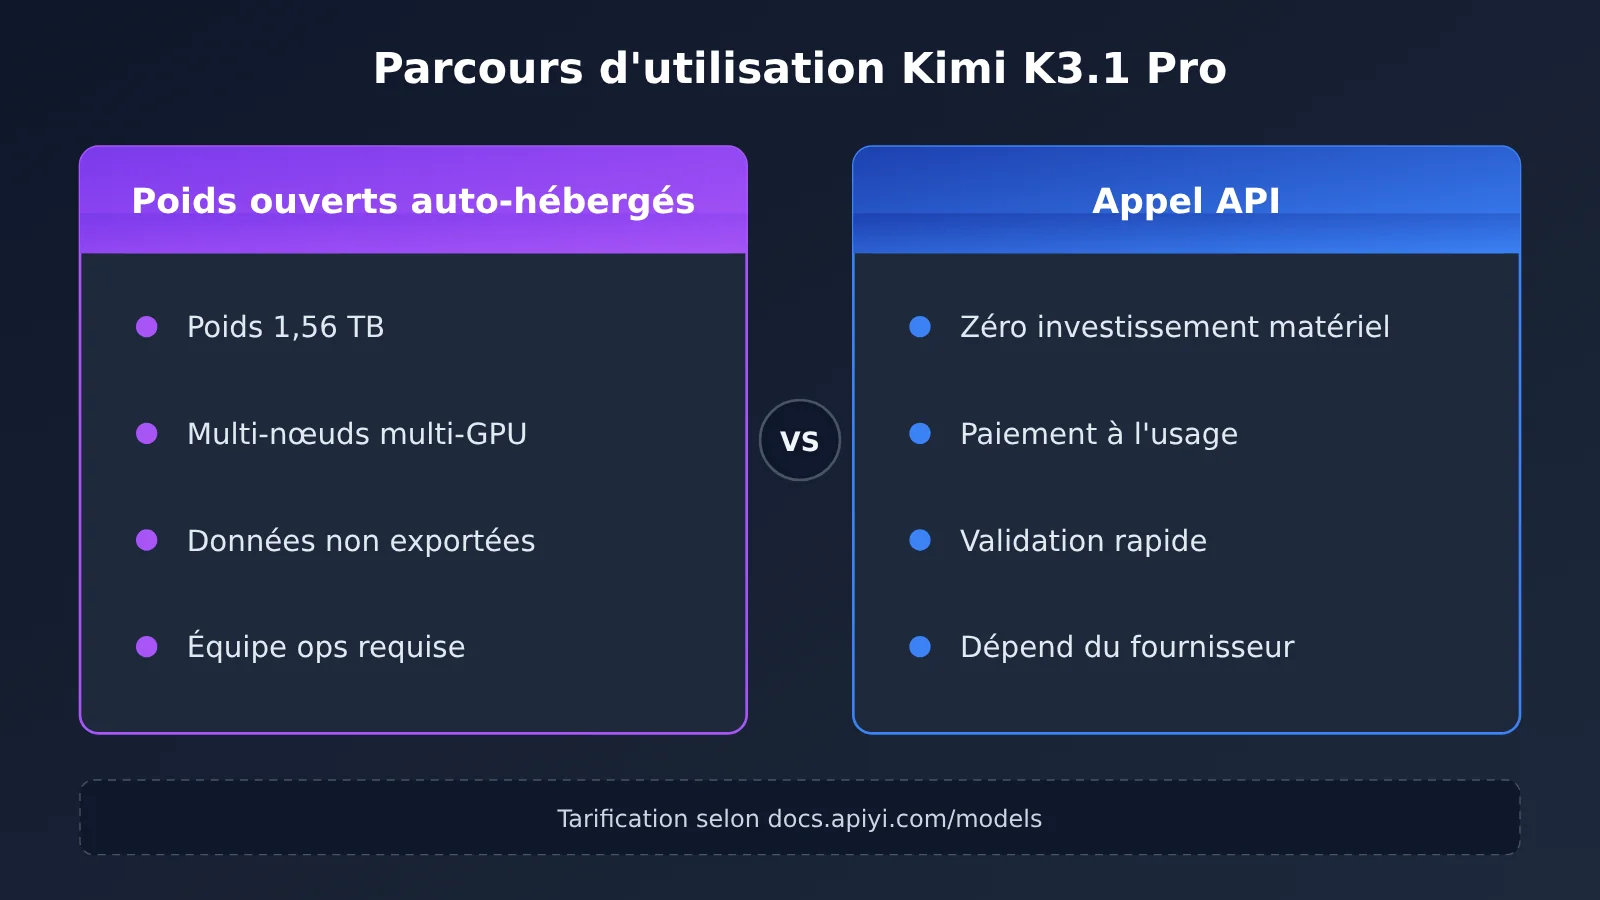
| Investissement initial | Élevé : nécessite plusieurs machines, plusieurs GPU et du stockage | Faible : paiement à l’usage |
| Contrôle des données | Les données restent entièrement sur le réseau interne | Les données doivent être envoyées au fournisseur |
| Impact de la licence | L’usage interne n’est pas soumis aux deux conditions | Le fournisseur assume les obligations de conformité pour le service à des tiers |
| Délai de mise en production | Plusieurs semaines de déploiement et d’optimisation | Intégration possible le jour même |
| Exigences d’exploitation | Nécessite une équipe dédiée à l’inférence | Quasiment aucune maintenance |
| Phase adaptée | Scénarios à grande échelle et à forte exigence de conformité | Validation des capacités, activités de petite et moyenne taille |
| Canaux disponibles | Hugging Face moonshotai/Kimi-K3.1-Pro |
API officielle Moonshot ; APIYI apiyi.com (disponibilité à vérifier dans la liste des modèles) |
💰 À propos des coûts : pour les tarifs d’entrée/sortie et les prix du cache des appels API, référez-vous aux données en temps réel de la page tarifaire d’APIYI https://docs.apiyi.com/models ; cet article ne donne aucun chiffre non vérifié. Les prix de l’API officielle Moonshot sont également ceux publiés par Moonshot.
Comment interpréter les données de classement de Kimi K3.1 Pro
Des rapports publics indiquent que Kimi K3.1 Pro est actuellement le « modèle à poids ouverts le mieux classé ». Cette affirmation repose sur une définition statistique précise : il faut la considérer comme un signal de référence, et non comme une conclusion sur les capacités du modèle.
| Indicateur | Valeur | Périmètre statistique |
|---|---|---|
| ArtificialWatch Bench Index | 69.9, 11e sur 44 modèles | Percentile sur tous les classements publics qui l’ont évalué, puis médiane ; modèles à poids ouverts et propriétaires mélangés |
| Position parmi les modèles à poids ouverts | 1er | Légèrement devant DeepSeek V4.1 Flash (68) |
| Coding Index | 45.1, 21e sur 45 modèles | Classements de programmation, derrière quatre autres modèles à poids ouverts |
Trois points méritent attention. Premièrement, le percentile médian reflète la « position relative » du modèle dans plusieurs classements ; il ne correspond pas à une capacité absolue sur une tâche précise. Deuxièmement, l’écart entre 69.9 et 68 est faible et ne suffit pas à démontrer une différence notable entre les deux modèles dans votre activité. Troisièmement, le classement global de Kimi K3.1 Pro est très bon, mais son Coding Index est relativement en retrait : les équipes dont l’usage principal est la génération de code devraient mener des évaluations ciblées.
FAQ — Questions fréquentes
Q1 : Les poids ouverts de Kimi K3.1 Pro peuvent-ils être utilisés commercialement et gratuitement ?
Dans la plupart des cas, oui. L’utilisation, la modification, le fine-tuning et la redistribution sont gratuits. Seuls deux cas demandent un traitement particulier : les entreprises qui revendent l’accès au modèle et dont le chiffre d’affaires dépasse 20 millions de dollars sur une période de 12 mois consécutifs doivent signer un accord séparé ; et les produits qui dépassent 100 millions d’utilisateurs actifs mensuels ou 20 millions de dollars de revenus mensuels doivent afficher une attribution bien visible.
Q2 : Quelle est la différence entre la licence de Kimi K3.1 Pro et celle de Kimi K3 ?
D’après la comparaison mot à mot des deux documents réalisée par ArtificialWatch, le contenu des deux licences est identique : seul le nom a changé. Les équipes qui ont déjà bouclé leur évaluation de conformité pour K3 peuvent donc réutiliser directement leurs conclusions, mais un passage rapide du service juridique reste recommandé.
Q3 : Un déploiement interne de Kimi K3.1 Pro déclenche-t-il des restrictions de licence ?
Non. La documentation précise clairement qu’aucune des deux conditions commerciales ne s’applique à un usage interne. Pour une base de connaissances interne, un assistant de R&D, de l’analyse de données ou tout autre scénario du même genre, vous pouvez utiliser et fine-tuner le modèle directement.
Q4 : De quel matériel faut-il pour auto-héberger Kimi K3.1 Pro ?
L’équipe officielle n’a publié ni configuration précise ni estimation de coût. Les poids seuls représentent déjà 1,56 To, et avec le KV Cache les besoins grimpent encore : il faut donc plusieurs GPU, voire un cluster multi-machines, avec un framework d’inférence compatible avec les formats MXFP4/MXFP8. Le mieux est de valider d’abord la valeur métier via une API comme APIYI apiyi.com, puis de décider si l’investissement matériel en vaut la peine.
Q5 : Comment appeler rapidement Kimi K3.1 Pro via API ?
Vous pouvez passer par l’API officielle de Moonshot ou par une plateforme d’agrégation. APIYI est compatible avec les formats d’API OpenAI et Anthropic, ce qui limite les modifications à apporter au code existant. Les modalités d’intégration sont décrites sur docs.apiyi.com ; pour savoir si le modèle est déjà disponible et connaître la tarification, référez-vous à https://docs.apiyi.com/models.
Q6 : La version Highspeed de Kimi K3.1 Pro peut-elle être auto-hébergée ?
Pour l’instant, ce n’est pas certain. Moonshot n’a pas précisé si Highspeed correspond à un checkpoint distinct, et aucun dépôt correspondant n’existe sur Hugging Face. Aujourd’hui, seul le modèle standard `moonshotai/Kimi-K3.1-Pro` est téléchargeable.
Q7 : Quelles sont les limites connues de Kimi K3.1 Pro ?
Il y en a quatre principales : le seuil matériel pour l’auto-hébergement est élevé, sans recommandation officielle de configuration ; le contenu de la clause « accord séparé » n’est pas public ; l’indice de programmation le place derrière quatre autres modèles ouverts ; et la disponibilité de la version Highspeed reste inconnue. Si votre activité touche à ces points, prévoyez du temps pour l’évaluation.
Kimi K3.1 Pro : points clés à retenir
- Ouverture à la date promise : les poids sont publiés le 4 novembre, soit 12 jours après la mise en ligne de l’API, et le dépôt n’impose aucune condition de candidature.
- Licence permissive : utilisation, modification, fine-tuning et redistribution sont gratuits ; le contenu est identique mot pour mot à la licence de K3.
- Deux conditions visant des cibles différentes : l’une s’applique aux fournisseurs de services de modèles à revenus élevés, l’autre aux produits à très grande échelle.
- Usage interne non restreint : aucune des deux conditions commerciales ne s’applique aux scénarios internes à l’entreprise.
- Précision MXFP4 native : entraînement avec prise en compte de la quantification, la précision en auto-hébergement est identique à celle du service officiel.
- Le vrai obstacle, c’est le matériel : les 1,56 To de poids nécessitent plusieurs machines et plusieurs cartes, et l’équipe officielle ne donne aucune recommandation de configuration.
- Valider avant de déployer : on peut d’abord vérifier les résultats avec ses propres échantillons métier via APIYI apiyi.com, histoire de réduire le risque d’investissement initial.
En résumé
L’essentiel de l’ouverture des poids de Kimi K3.1 Pro :
- Lire la licence : commencez par déterminer si votre activité relève de l’usage interne, d’une API exposée ou d’un produit grand public à grande échelle, puis comparez avec les deux conditions commerciales. L’usage interne de la plupart des entreprises n’est pas concerné.
- Seuil de déploiement : les 1,56 To de poids MXFP4 correspondent à la précision native du service officiel ; la difficulté réside dans les ressources multi-machines/multi-cartes et dans l’adaptation des frameworks.
- Méthodologie du classement : le 69,9 du Bench Index est une agrégation des percentiles médians de plusieurs classements ; il ne faut y voir qu’un signal de référence, et les scénarios de programmation demandent une évaluation à part.
Pour la plupart des équipes, l’approche la plus sûre consiste à faire tourner d’abord ses échantillons métier via l’API, à confirmer les résultats et le volume d’appels, puis seulement à évaluer si l’investissement dans des ressources d’auto-hébergement en vaut la peine. Nous recommandons de passer par APIYI apiyi.com pour réaliser la comparaison entre plusieurs modèles via une interface unifiée ; la tarification de référence se trouve sur https://docs.apiyi.com/models.
📚 Références
- ArtificialWatch – Article sur la publication des poids ouverts de Kimi K3.1 Pro : fichiers de poids, licence et analyse du classement
- Lien :
artificialwatch.com/wire/kimi-k3-1-pro-open-weights-out -
Description : contient le nombre de fragments, les formats de précision, les conditions de licence et les données du Bench Index
-
ArtificialWatch – Bilan du respect des promesses de poids ouverts : chronologie de l’ouverture des poids par chaque laboratoire depuis juillet
- Lien :
artificialwatch.com/wire/open-weights-promises-five-for-five -
Description : utile pour évaluer le rythme auquel les éditeurs ouvrent leurs poids
-
Hugging Face – Dépôt du modèle Kimi K3.1 Pro : fiche du modèle, texte original de la LICENSE et fichiers de poids
- Lien :
huggingface.co/moonshotai/Kimi-K3.1-Pro - Description : les clauses de licence font foi selon le texte original de la LICENSE disponible à cet endroit
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via le site officiel d’APIYI, apiyi.com ; la documentation d’intégration se trouve sur docs.apiyi.com, et les modèles ainsi que les tarifs sur docs.apiyi.com/models